AI Agent:大模型应用的 “金钥匙”

【嵌入式Linux】EC20模块多运营商自适应PPP拨号实战:从IMSI识别到网络配置 本文详细介绍了在嵌入式Linux系统中,如何基于EC20 4G模块实现多运营商自适应PPP拨号。通过解析SIM卡的IMSI识别运营商,并动态配置对应的APN和拨号参数,结合AT指令交互与健壮的pppd脚本,解决了设备跨地域部署时的网络自动连接问题,提升了物联网设备的部署效率和稳定性。 阅读详情

近日,NVIDIA(英伟达)推出了一款开发安全、可信的 AI Agent 利器——NVIDIA NIM Al Guardrail 微服务,作为 NeMo Guardrails 软件工具系列的一部分,旨在帮助企业提高生成式AI应用的安全性、精准性和可扩展性。一时间,Agent再次被推上风口。

从 2023 年大模型爆发,到 2024 年大模型落地,人们逐渐意识到,大模型不仅要“强”,更要“用”,Agent 智能体作为连接大模型和场景的中介,逐渐成为实现大模型应用的关键。OpenAI CEO Sam Altman 曾预测,2025 年将是 AI Agent 的元年。

我们看到,这一预测正逐渐成为现实。

大模型行业:C 端与 B 端的差异化发展

2024 年,大模型在 C 端和 B 端走出了截然不同的落地路径。

在 **C 端市场,大模型技术主要应用于内容生成、智能客服、个性化推荐等领域。**比如智能手机中的语音助手就是 C 端大模型落地的一个典型应用,还有 AI 绘画工具,用户只需输入简单的文字描述,就能生成风格各异的精美画作。类似这些应用往往以用户为中心,注重提升用户体验和互动性。C 端大模型的落地路径相对较短,主要得益于其面向消费者的直接性和用户数据的丰富性,通过收集和分析用户行为数据,C 端大模型能够更快速地学习和优化,从而提供更加精准和个性化的服务。然而,这类应用的商业变现效果和用户规模参差不齐,多数移动 APP 的 DAU 仅徘徊在百万级别,与互联网巅峰时期的数亿 DAU 相去甚远。

相比之下,B 端大模型的落地路径则更为复杂,大客户成为大模型落地的先锋。比如国家电网积极与大模型公司合作,探索大模型在电力调度优化、设备故障预测等业务中的应用,期望借助前沿技术提升运营效率和决策水平。在企业级应用中,大模型往往需要满足更高的稳定性、安全性和可解释性要求,而企业数据往往更加复杂和多元,这就需要大模型具备更强的数据处理和融合能力。因此,B 端大模型的落地需要更多的技术积累和行业经验。

事实上,企业级大模型的发展并没有看起来那么顺利,从 demo 到生产级应用的转化是企业面临的重大挑战。一方面,大模型计算成本高、资源消耗大,在处理大规模数据时易出现性能问题,如跑不动或出现 bug;另一方面,数据推论与持续调优也是关键难题。随着业务发展与知识更新,模型效果易下降,企业需要通过构建数据驱动的调优机制,从用户标注、数据清洗到策略优化、效果评估,形成闭环,实现模型持续优化。

尽管面临诸多困难,2024 年企业级大模型的发展依旧呈现出蓬勃的态势。一方面,随着技术的不断进步和成本的降低,越来越多的企业开始有能力部署和运维大模型。另一方面,企业级大模型在提升业务效率、降低运营成本、增强竞争力等方面展现出巨大的潜力,吸引了越来越多的企业关注和投入。

AI 时代,Agent 是大模型应用主流形态

“不要卷模型,要卷应用!”在 2024 世界人工智能大会上,百度创始人、董事长兼首席执行官李彦宏表示,AI 技术发展路线发生了方向性改变,已从过去辨别式人工智能转向了未来生成式人工智能。

自 2024 年起,企业界纷纷开始关注大模型落地,大客户更是率先试水,中小客户则大多持观望态度。

在技术应用层面,检索增强生成(RAG)技术应用成熟度较高,因其类似传统搜索思路,易于理解与接受,在各行业问答场景广泛应用。而 Agent 智能体则承载着人类对 AI 的美好愿景,不仅是大模型迈向 AGI 的关键节点,也是衡量大语言模型 “从量变到质变” 的重要标志。它经历了从简单问答系统到具备复杂推理、多模态交互能力的发展过程。

早期,企业在引入 Agent 智能体时面临诸多挑战,如技术架构调整、知识库管理、多模态信息处理等。然而,随着技术的不断进步,百度等企业在大模型技术方面取得了显著进展,其企业级 Agent 智能体不仅在对话交互上表现出色,还具备了强大的工作流处理能力。通过引入工作流技术,企业可以更加稳定、可控地利用 Agent 智能体进行业务操作,有效避免了话题发散、系统级稳定性等问题。

在百度世界 2024 大会上,伴随着两大赋能应用的 AI 技术:检索增强的文生图技术(iRAG)和无代码工具“秒哒”的发布,李彦宏表示,在人类信息技术变革的不同历史时期,应用出现的样貌也不一样。在 AI 时代,应用最主流的形态就是智能体,即将迎来爆发点,它将成为AI原生时代,内容、信息和服务的新载体。

而据百度智能云千帆 AppBuilder 产品负责人朱广翔介绍,2024 年,百度对产品进行了全面升级,包括重构了智能体为核心的产品架构,RAG 融合百度搜索,发布企业级 RAG、企业级 Agent,推出多模态工作流及数字人 Agent,智能体分发全面打通百度和微信生态,并全面开放了 RAG、Agent、工作流、百度AI搜索等原子能力,更好的支持企业级集成。

此前,华人科学家翁丽莲提出“Agent=大模型+记忆+主动规划+工具使用”这一公式,为理解 Agent 提供了基础框架。朱广翔表示,**百度基于这一公式加入了知识库。**以智能客服 Agent 为例,它利用大模型理解用户问题,借助记忆功能回顾历史对话,通过主动规划生成合理回答,并使用知识库中的行业知识和企业数据,以及结合百度搜索从全网获取实时信息,为用户提供准确解决方案。在电商场景中,Agent 能根据用户的浏览历史和购买行为,主动规划推荐策略,调用商品信息数据库,结合全网信息,为用户精准推荐商品,极大地提升了用户体验和购买转化率。

从当前的发展趋势来看,企业 Agent 智能体正在经历从试水到全面应用的过程。据悉,从2024 年初开始,百度、阿里、腾讯、字节跳动等互联网大厂纷纷基于自家大模型应用开发平台,推出低代码、无代码的 Agent 开发平台,提供了完整的算力层和模型层服务。市面上如百度智能云千帆 AppBuilder、字节跳动扣子 Coze、腾讯云腾讯元器、阿里云大模型平台百炼、科大讯飞星火智能体平台等智能体开发平台百花齐放。

另外,一些软件厂商也在尝试以SaaS+AI的方式打造智能体。去年年底,在Agent OpenDay上,智谱AI展示了在AI Agent方面的最新成果,发布了用AI替代人类执行任务的三款智能体,分别是面向手机的phone use—AutoGLM,面向电脑的compute use——GLM PC,以及面向网页的GLM-Web能力。

👉[CSDN大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)]()👈
大模型应用开发:Agent的融合与挑战

如今,企业 Agent智能体在各领域应用广泛,深刻改变着企业的运营和业务模式。

在客户服务领域,银行、电信运营商等企业的智能客服系统借助 Agent智能体,实现全天候、个性化服务,显著提升服务效率和客户满意度。

在数据分析领域,Agent 智能体处理分析大量数据,为企业提供有价值的洞察和决策支持,如某电商企业借此成功预测市场趋势,调整营销策略。

在企业内部管理方面,Agent 智能体助力实现自动化办公和智能化管理,像智能体负责会议签到、安排和记录,提升会议效率和协同工作能力。

目前来看,企业业务与Agent的融合呈现两种主流形态:AI原生业务创新和传统业务智能化升级。

AI原生业务是企业Agent智能体创新的前沿阵地。比如百度文库利用Agent智能体技术,实现了PPT的自动生成,用户只需输入相关的文本内容,智能体就能够根据内容生成相应的PPT模板,并填充相应的文字和图片等内容,这其中是“创想即创作”的思考,我们也看到像百度文库这类产品正在从办公工具向创作力工具的转变,成为思想碰撞和灵感激发的媒介。还有拍照解题应用,学生拍照上传题目,Agent 能给出详细解题步骤和答案,助力学习等等。这些轻应用兼具对话与图形交互功能,极大地提升了用户体验。

用百度文库生成PPT

在传统业务场景中,以workplace + copilot模式为例,在企业审批流程中,当员工处理合同审批时,侧边栏的Agent能自动总结合同关键点,提示潜在风险,提高审批效率和准确性,这种模式实现了人机高效协作,提升了工作效率。此外,Agent在B端交付中发挥着关键作用,它统一了大模型落地的方式和话语体系,使交付更加标准化。例如,不同电力企业对大模型应用需求各异,但通过Agent,可基于统一框架,根据企业特定需求配置不同工具和功能,降低交付成本和难度。

Agent虽然带来了诸多想象力,但在真正的落地应用中还存在诸多挑战。比如,**可靠性、性能和成本依旧是一个大难题。**众所周知,LLM容易产生幻觉和不一致性,将多个AI步骤连接起来会加剧这些问题,尤其是对于需要精确输出的任务。同时,GPT-4、Gemini-1.5和Claude Opus在使用工具/函数调用方面表现不错,但它们仍然较慢且成本高,特别是需要进行循环和自动重试时。此外,Agent如何保护用户数据安全和隐私保护,也依旧是业界关注的重点。

风口之上,任何一家企业与个体都想要抓住这个机遇。CSDN看到,在Agent浪潮下,大模型应用即将迎来更广阔的发展前景,在应用场景拓展、技术创新融合和生态构建合作等方面不断突破。

应用场景方面,在C端市场,大模型将进一步拓展其应用场景,如智能家居、自动驾驶、虚拟现实等领域。在B端市场,大模型将更多地应用于业务流程优化、智能决策支持、风险管理等领域,为企业提供更全面、更智能的解决方案。

同时,基于技术的不断创新融合,大模型将与其他先进技术,如区块链、物联网、5G等相结合,形成更加完整和高效的解决方案。这将进一步推动大模型在企业级应用中的普及和深化。

此外,随着大模型应用的不断拓展和深化,将逐渐形成更加完善的生态体系。企业将通过合作与共享资源,共同推动大模型技术的发展和应用创新。

朱广翔表示,未来,百度智能云千帆计划在2025年上半年实现“上生产”无卡点,并提供应用飞轮与数据飞轮,帮助客户根据业务变化持续优化应用效果。技术层面,通过提性能、增效果、扩场景,提升Agent智能体竞争力,如采用前沿工程框架提升性能,探索慢思考应用场景增强效果,升级多模态能力拓展应用场景。

银河证券研报指出,**AI Agent的崛起正重塑AI产业链,带来投资新机遇。**预计到2028年,中国AI代理市场规模将激增至8520亿元,年复合增长率达72.7%。AI Agent推动App生态逐渐向端侧生态转变,有望成为AI应用发展的新趋势,解决传统端侧AI无法通过用户指令调用操作界面实现目标的痛点。

卷完了大模型,是时候开始卷Agent智能体了。

读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用

对于0基础小白入门:

如果你是零基础小白,想快速入门大模型是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。

包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!

😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
在这里插入图片描述

👉AI大模型学习路线汇总👈

大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)
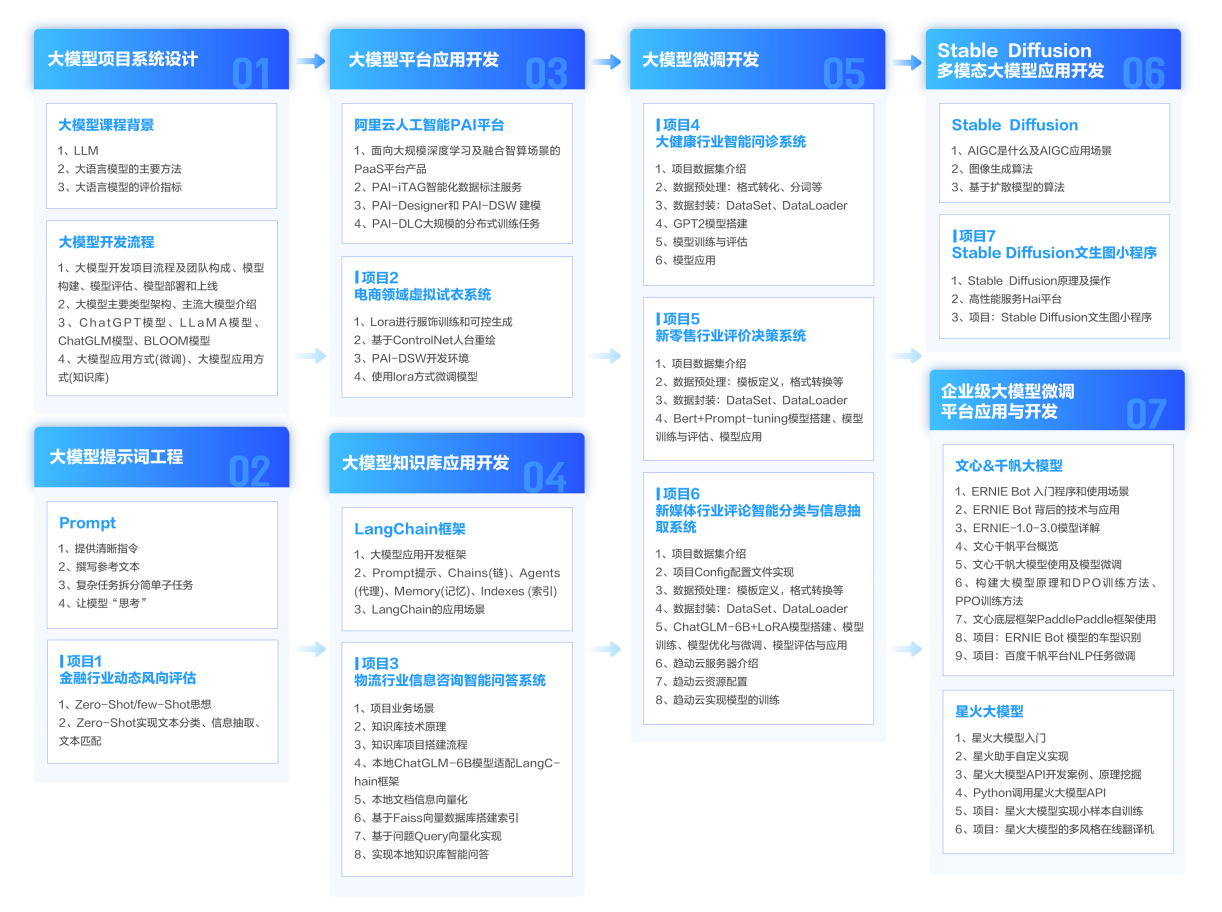
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;

第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;

第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;

第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;

第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;

第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

👉大模型实战案例👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

在这里插入图片描述

👉大模型视频和PDF合集👈

观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉获取方式:

😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
在这里插入图片描述

【ubuntu24.04】auto remove后,重启,kernel panic ,please reboot your computer vfs unable to mount root fs Ubuntu 24.04系统在运行auto remove后出现内核恐慌(kernel panic)无法启动,显示"VFS: unable to mount root fs"错误。该问题是由于当前内核被清除导致系统无法挂载根分区。解决步骤包括:1)尝试用GRUB菜单中的旧内核启动;2)在GRUB中临时编辑启动参数;3)使用Ubuntu启动盘进行chroot修复;4)使用Boot-Repair工具一键修复。成功启动后,需要重新安装linux-generic等元包,重建initramfs并更新 阅读详情

相关推荐

QCC5125/QCC5144----LDAC 44.1K 48K 96K 192K 输出

QCC5125/QCC5144----LDAC 44.1K 48K 96K 192K 输出。而且还不需要license限制。

Alex_886的博客 1961

百度秒哒负责人朱广翔:AI开发革命的终局,是让创意本身成为唯一的“代码”

分享嘉宾 | 朱广翔责编 & 采访 | 王启隆出品 | AI 科技大本营(ID:rgznai100)AI 爆发的这几年,程序员本都以为要解放了,但回首发现,传统的应用开发模式始终被一个“不可能三角”所困:低成本、高质量、个性化,三者似乎永远无法兼得。传统编码(Coding)能保证高质量与个性化,但成本高昂;模板化的低代码平台降低了成本,却牺牲了个性化;而一度兴起的聊天机器人(Chatbot)虽具个性化且成本较低,其简单的交互形式又往往达不到高质量应用的标准。今年,OpenAI 联合创始人 Andrej Ka

AI科技大本营 1615

基于Unity引擎利用OpenCV和MediaPipe的面部表情和人体运动捕捉系统

增加了模型的绑定,利用Mediapipe这个强大的库可以实现识别面部表情的捕捉和人体结构运动的捕捉,基于以上的特性加入到Unity的人物模型中,实现实时的面部表情和人体运行的捕捉

BIgbossyii的博客 1万+

产品经理视角来看——大模型应用生产工具的总结

随着chatgpt的横空出世,大家见识到了大模型的强大能力,因此催生了无数基于大模型能力的应用。

瓦罗兰特顶级C位的博客 1657

把 LDB 讲透:SAP ABAP 逻辑数据库的结构、事件模型、动态选择与现代替代方案

摘要:SAP中的Logical Database(LDB)是一种将表组织成树形结构并统一生成选择屏幕的技术,通过事件驱动方式向报表程序传递数据。虽然被标记为过时,但在理解标准代码和优化性能方面仍有价值。LDB通过SE36事务码创建,其结构包含层级关系、选择屏幕和数据库程序。报表通过NODES声明和GET事件处理数据,支持动态选择以减少数据库访问。在S/4HANA和ABAP Cloud环境下,建议使用CDS View和ABAP SQL等现代方案替代LDB,以提升可测试性和架构清晰度。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 200

Python全栈入门到实战【进阶篇 1】类与对象:面向对象编程的基石

Python中定义类使用**class关键字**,创建对象使用**类名()**(类似调用函数),语法简洁,我们从最基础的空类开始,逐步拆解。class# 定义空的学生类,pass表示占位,无实际内容 class Student : pass编码规范:类名遵循大驼峰命名法(每个单词首字母大写,无下划线),如StudentCarPhone,这是Python官方推荐的PEP8规范,便于区分类和其他标识符。实例方法必须定义在类内部;实例方法的第一个参数必须是self(名称可自定义,如this。

那些看似不起波澜的日复一日,会在某天让你看到坚持的意义 3385

大模型AI Agent的工作原理与安全挑战

相较于传统基于强化学习(RL)算法的AI Agent,以LLM为核心的智能体展现出显著的优势。传统强化学习方法依赖于明确定义的动作空间和奖励函数,泛化能力较弱,难以适应开放的动态环境,导致其迁移能力受限。而LLM驱动的智能体则具备更强的环境适应能力,能够通过多模态交互自主感知和理解环境,并借助LLM强大的语义生成与推理能力进行任务规划。此外,它们还具备调用外部工具的能力,以高效执行各类任务。同时,通过引入检索增强生成(RAG)技术,智能体能够存储并利用“记忆”,进一步提升其自主性与问题解决能力。

moresec的博客 1730

20-CUDA规约算法:并行求和优化策略-✨

本文介绍了GPU上高效并行规约(Reduction)算法的优化技巧。规约是将大量数据合并为单个值的基础计算模式,广泛应用于科学计算等领域。文章从基础并行规约实现出发,逐步讲解了三种关键优化策略:1)交错寻址减少共享内存bank冲突;2)循环展开降低分支预测开销;3)多级规约处理大规模数据。性能对比显示,优化策略可带来最高4.5倍的加速效果。最后总结了最佳实践,包括合理使用共享内存、循环展开和warp级优化等技巧。这些优化方法可显著提升GPU计算密集型应用的性能。

2301_79143213的博客 169

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3909

嵌入式软考必备知识点:嵌入式系统开发中的重要概念和示例代码

在嵌入式软考中,有一些重要的知识点需要掌握,包括嵌入式系统的基本概念、编程语言、实时操作系统和硬件接口等。实时操作系统是一种专门设计用于嵌入式系统的操作系统,可以提供对任务调度、中断处理和资源管理等方面的支持。GPIO(通用输入输出):GPIO是嵌入式系统中常用的硬件接口,用于连接外部设备和嵌入式系统。以上是嵌入式软考中的一些必备知识点,包括嵌入式系统的基本概念、编程语言、实时操作系统和硬件接口。通过配置串口的波特率、数据位数和校验位等参数,可以实现与其他设备的可靠通信。一、嵌入式系统的基本概念。

PixeGO的博客 310

ShardingSphere 分库分表避坑:扩容数据迁移时,如何做到“不停机、不丢数据”?

停机:发布公告,凌晨 0 点停止对外服务。洗数据:跑一个巨大的脚本,把旧库数据 Hash 算出新路由,写入新库。改配置:修改代码里的分片规则。重启:祈祷数据没丢,服务正常。这种“刀耕火种”的方式,风险极高,且随着数据量增大,停机时间会变得不可接受。我们需要的是Online Migration (在线迁移)。分库分表扩容不再是“听天由命”的赌博。通过,我们将一次高风险的“运维操作”变成了一个可控的、可视化的“数据流转过程”。方案停机时间复杂度回滚难度传统停机清洗。

BUG猿的博客 879

Agent 安全:大模型智能体的风险全景、防御体系与工程实践指南

Agent 安全是指在基于大模型构建的智能体系统中,通过技术手段与治理机制,确保其行为始终符合设计意图、遵守权限边界、可被监控审计、不可被恶意利用的一整套安全体系。✅核心目标:防止智能体成为攻击者的“合法代理”。维度传统 AI 安全Agent 安全作用对象静态模型输出(如分类结果、生成文本)动态行为链(Plan → Act → Observe → Reflect)攻击面输入/输出层工具调用接口、记忆存储模块、多轮上下文、外部 API、协作 Agent风险类型误分类、偏见、数据泄露。

吾为热爱计科,致力于知识分享的践行者,此博客是我在这条道路上留下的足迹。 1608

ComfyUI 汉化教程(中文界面)

如果你对翻译的结果不满意,还可以进行修改。首先,进入目录,可以看到该目录中有很多 JSON 文件:打开 JSON 文件,找到要修改的内容,修改对应的Value值即可:最后,重启 ComfyUI 即可。

水滴的博客 1万+

【收藏】AI大模型:程序员职业跃迁的金钥匙,年薪百万不是梦

AI大模型正成为未来5年程序员最佳发展方向,华为、美团、阿里等大厂岗位需求暴增,薪资普遍在60-100万。企业急需掌握Fine-tuning、Agent、RAG等技术的开发者,而非只会调用API的"调参侠"。市场饱和下,AI是技术人破局的关键机会。阿里MVP陈旸老师设计的"大模型应用开发实战营"课程,提供企业级实战项目、技能体系构建和大厂内推机会,帮助开发者从0-1构建应用开发路径,快速抓住AI技术红利,实现职业跃迁。

youmaob的博客 860

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

AI大模型:程序员未来5年最好的技术发展方向,高薪就业金钥匙!又一个AI大模型的新方向,彻底爆了!!

AI大模型正在重塑传统开发模式,大模型应用开发工程师岗位极度稀缺且高薪(78%年薪60-100万)。企业需要掌握Fine-tuning、Agent、RAG等技术,并能将业务场景与技术结合的开发者。"大模型应用开发实战营"课程帮助开发者从0-1构建应用开发能力,提供内推、直聘等权益,助力程序员抓住AI红利,实现职业升级。

Trb701012的博客 784

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

大模型应用工程师高薪秘籍,RAG、Agent、微调实战教程

大模型应用工程师是当前高薪热门岗位,字节等大厂开出的年薪高达85万-154万。传统程序员岗位需求下降,市场急需掌握RAG、Agent智能体、微调等大模型技术的应用开发工程师。通过系统学习大模型技术,构建企业级实战作品,可大幅提升就业竞争力,实现薪资40%-60%的增长。适合希望重构核心竞争力、避开裁员风险、延长职业发展期的程序员参与学习。

2401_84204207的博客 892

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

战略对齐、面向高管、Agent,企业成功落地大模型的三把“金钥匙”|爱分析报告

大模型是指通过在海量数据上依托强大算力资源进行训练后能完成大量不同下游任务的模型。大模型以其在模型精度和泛化能力等多个指标上超越传统AI模型的表现,以及赋能千行百业的巨大潜力,成为当今世界各国人工智能技术发展的核心方向。 大模型经过近一年半的高速发展,已在政府、医院、学校、企业等各类需求群体中建立初步认知。其中一部分需求群体设立专项预算、开放业务场景,对大模型进行试点应用。通过试点应用,需求群体加深了对大模型能力和价值的认同感,进而普遍希望在未来继续增加相关预算,将大模型与实际业务进行更深入、更广泛的融合

爱分析ifenxi 1009

Java开发者转型AI Agent:大模型相关岗位缺口达47万,字节跳动、腾讯等大厂纷纷设立AI Agent专项岗位!

2025年后端开发面临AI技术革命,传统CRUD岗位需求锐减40%,而掌握AI大模型技术的工程师薪资涨幅达150%。行业呈现两极分化:一方面大厂设立AI Agent专项岗位,缺口达47万;另一方面,坚持传统开发模式的工程师面临淘汰风险。后端开发者具有转型优势,其工程能力、工具链和业务抽象能力均可迁移至AI开发。系统学习路径分为四个阶段:Python基础、RAG/Agent核心技能、模型微调高阶能力和工程化实战。

嘴巴吃糖了 1536

学好AI Agent的6把“金钥匙”

这是LLM探索环境的一个方式,比如查询网页,读写文件等等都是通过这里面提供的工具来实现的。因为LLM的上下文是有限的,有的时候它对于一些事情只想要一个总结,不想让工具的输出占据太多的上下文,这个时候就可以发起sub agents,让这些子agent去执行这些任务,并汇报结果,整体可以起到节省上下文的作用。AI Agent领域发展的很快,天天会出现新的产品,新的概念,但深入了解这些产品背后的设计逻辑以及那么多概念后,会发现有那么6个概念是重中之重,可以说是学好AI Agent的6把“金钥匙”。

m0_37982378的博客 224

【收藏必学】AI大模型:程序员的未来5年高薪金钥匙,78%岗位年薪60-100万!

AI大模型正重塑传统开发模式,华为、美团、阿里等大厂纷纷布局,大模型应用开发工程师极度稀缺且薪资远超市场水平。企业需要掌握Fine-tuning、Agent、RAG等技术的开发者,而非只会调用API的"调参侠"。作者推出实战课程帮助开发者从0-1构建应用开发能力,提供内推机会,是程序员抓住AI红利、实现职业升级的关键路径。

m0_59162559的博客 558

收藏!未来5年程序员必学技能:AI大模型应用开发,高薪就业金钥匙!

AI大模型正成为程序员未来5年的最佳技术发展方向。华为、美团、阿里等大厂纷纷布局,相关岗位年薪破百万。企业需求已超越简单的API调用,要求开发者掌握Fine-tuning、Agent、RAG等技术,并结合业务场景进行开发。本文介绍了如何通过学习AI大模型技术,掌握应用开发逻辑、技术体系,并积累企业级实战项目,实现职业升级,抓住AI技术红利。不夸张的说,未来5年程序员最好的技术发展方向,一定是AI大模型!👉华为全面布局Agent,覆盖80%新业务系统;

qq_46094651的博客 353

收藏!2026 年,AI 大模型彻底迎来应用爆发之年!

脉脉高聘最新发布的数据显示,2025年1-10月国内AI相关岗位需求同比暴涨543%,其中AI科学家平均月薪突破12.7万元,更令人惊喜的是,应届生岗位中已有14.68%实现年薪百万。无论是小鹏、华为等科技巨头,还是字节跳动这类互联网领军企业,其新发岗位中每10个就有1个聚焦AI领域——这意味着,AI早已褪去“未来科技”的光环,成为像电力、互联网一样,深度渗透到工作与生活方方面面的核心生产力,更是程序员、职场人突破瓶颈的关键抓手。

大模型教程的博客 1385

【必学收藏】大模型应用开发实战:程序员抓住AI风口,实现职业跃迁

AI大模型正在重构技术开发范式,传统开发模式被AI原生应用取代。阿里、字节跳动等大公司80%技术岗与AI相关,AI技术岗薪资逆势上涨150%。传统程序员面临职业生存危机,急需掌握AI大模型原理、应用技术和项目实操经验。文章推广的大模型应用开发实战训练营旨在帮助程序员抓住AI风口,实现职业跃迁,应对行业转型挑战。

youmaob的博客 921

【珍藏】从“调参侠“到“大模型架构师“,掌握AI大模型技术,开启百万年薪之路!

AI大模型是未来5年程序员最佳发展方向,华为、阿里等大厂岗位需求暴增69%。企业急需掌握Fine-tuning、Agent、RAG等技术的专业人才,78%大模型应用开发岗年薪达60-100万。"大模型应用开发实战营"课程提供企业级实战项目拆解、AI技术体系构建及大厂内推机会,帮助开发者从0-1构建完整应用开发能力,抓住AI技术红利,实现职业跃迁。

datian1234的博客 493

【LLM大模型】解锁LLM的金钥匙(Prompt Engneering)

最近在学习AIGC时,总是会碰到一个关键词就是prompt,起初我还不以为意,这不就是我要向chatGPT问的话吗,让它帮我写点文章啥的,没什么好看的,是个人都会用。

2401_82469710的博客 1135

AI产品经理爆款课!助你从职场焦虑到掌控AI蓝海,转型必备金钥匙!

AI时代产品经理的转型之路:四大核心课程助力职业跃迁。课程体系聚焦产品思维与直觉培养、心智模型应用、领导力提升及AI产品开发能力,由联合国CIFAL中心认证,帮助从业者构建技术理解力与人性洞察力的双重优势。内容涵盖从需求判断到团队管理,再到AI技术落地的完整能力链,特别强调在数据缺失时的决策能力、用户心智把握等AI难以替代的核心竞争力。同步提供大模型微调、RAG应用开发等AI技术实战指南,助力产品经理从执行者转型为AI驾驭者,把握百万年薪机遇。

2401_84495872的博客 412
上一篇: 【AI Agent】从零写一个agent框架,打造最强开放agent编辑框架,拳打dify,脚踩coze
下一篇: 2025年,将是35岁以上程序员的新机会!
AI大模型学习不迷路
博客等级 码龄3年 8122粉丝 911原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值