2025年AI大模型终极指南:五款国产模型横向对比,程序员必备收藏

国内大语言模型对比评测(一) 针对国产大模型的横空出世并不断打磨其性能,这次评测我们将覆盖国内所有开源的大语言模型(如下),也针对大家常用功能的设计了测试问题,用于评测其生成结果的优劣。测试问题统一为中文,用于为国内用户使用大语言模型提供参考。、语言多样性和翻译、多学科知识融合、偏见和伦理、鲁棒性、数学推理、医学诊断、多模态理解和生成。 阅读详情

文章对比分析了DeepSeek、豆包、Kimi、智谱清言和通义千问五款国产AI大模型的特点与发展。DeepSeek推理能力强且性价比高;豆包功能全面多模态;Kimi擅长长文本处理;智谱清言知识图谱专业;通义千问行业应用广泛。文章从智能度、响应速度、准确率等多维度横向对比,并为不同用户群体提供针对性选择建议,帮助读者按需选择最适合的AI大模型。

一、DeepSeek:高性价比推理强者

DeepSeek是深度求索推出的大语言模型,堪称2025年AI界的“黑马”。它推理能力超强,表现和GPT-4不相上下。春节期间的爆火,使其成为史上用户增速最快的AI应用。

1、特点

语义理解能力强:

能吃透问题,给出精准答案。比如搞学术研究,我们问专业领域的复杂问题,它可以快速翻找资料,整理出关键信息,条理清晰地解答,帮我们省下不少时间。写论文时,还能帮着生成大纲、分析文献综述。

开源与本地化支持:

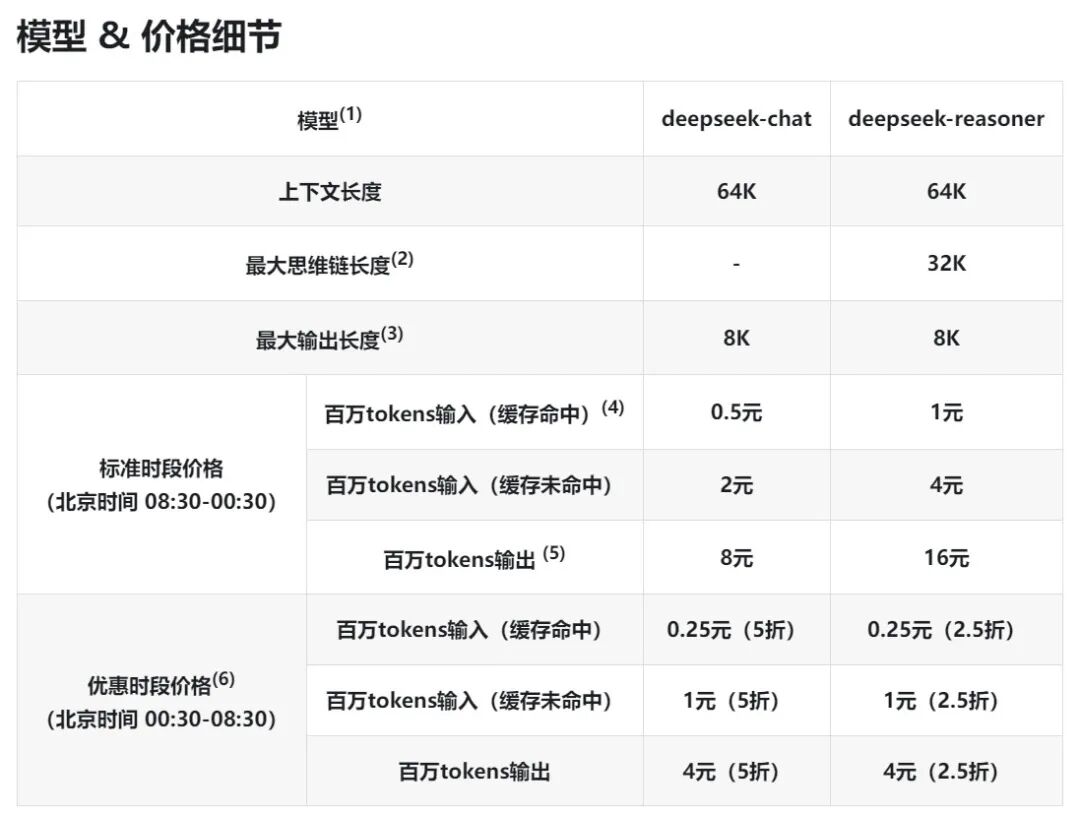
完全开源,支持本地部署,用户可以根据需求定制模型,同时完全掌控数据隐私。其API服务价格亲民,输入/输出每百万tokens的成本分别为2元和8元,适合中小企业和个人开发者使用。
高性能与低成本:

在多项基准测试中,DeepSeek的表现接近甚至超越了Claude-Sonnet和GPT-4o等国际顶尖模型。其训练成本仅为557万美元,远低于GPT-4o的1亿美元。其推理成本也极具竞争力,每百万tokens的输入/输出成本仅为Sonnet-3.5的1/10。

2、发展

DeepSeek深耕专业领域,特别是在科技、金融、数据分析等领域,可能推出更多垂直行业解决方案,吸引企业用户。同时,进一步优化模型的性能和成本,提升用户体验。

二、豆包:字节跳动的多面手

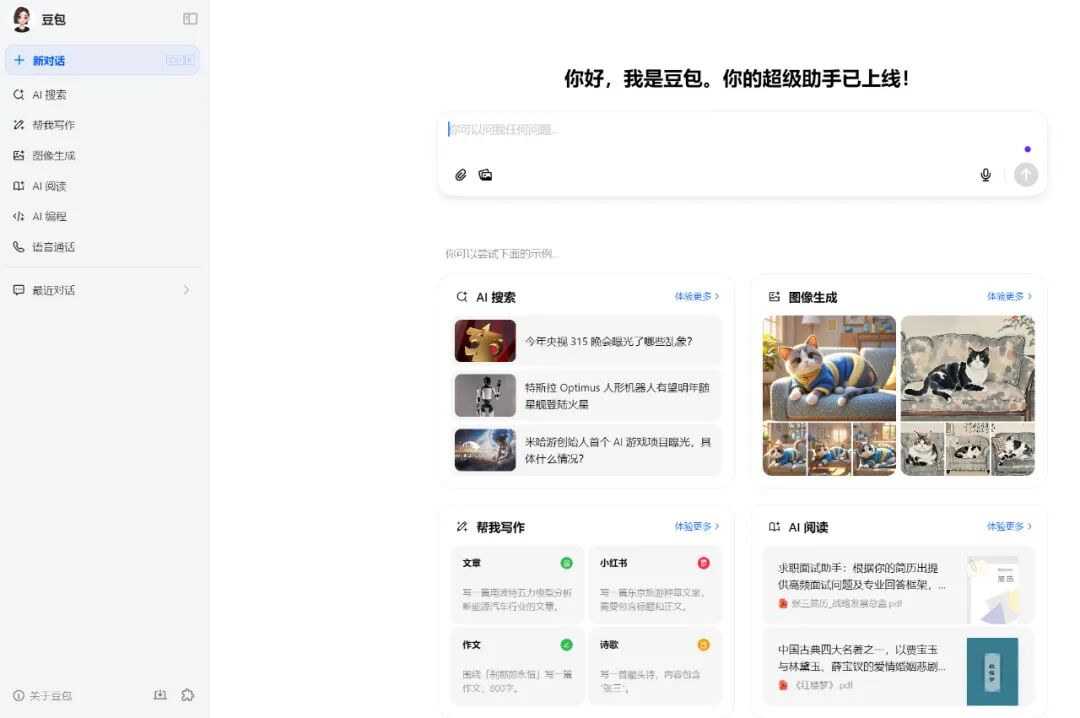
豆包是字节跳动开发的通用大模型,融合了自然语言处理、计算机视觉和语音识别等技术。靠着字节跳动的技术优势,豆包能快速写出论文框架、活动通知,语音识别很准,日常聊天也特别流畅。
1、特点

功能全面:

提供聊天机器人、写作助手以及英语学习助手等功能,可以回答各种问题并进行对话;支持网页、客户端、APP、插件等形式。

基于豆包大模型,字节跳动打造了AI对话助手“豆包”、AI应用开发平台“扣子”、互动娱乐应用“猫箱”,以及星绘、即梦等AI创作工具。并把大模型接入抖音、番茄小说、飞书、巨量引擎等50余个业务,用以提升效率和优化产品体验。

多模态能力:

豆包不仅在文本处理上表现出色,还具备强大的多模态交互能力。并且支持多风格、多比例的一致性多镜头生成,可应用在电商营销、动画教育、城市文旅、微剧本等领域。

高效推理与低成本:

通过字节跳动内部50+业务场景实践验证,每日千亿级tokens大使用量,使得豆包在推理效率和成本控制上具有明显优势。

2、发展

豆包背靠字节流量,继续拓展社交娱乐功能,比如虚拟偶像互动。风险是过度依赖抖音生态,可能陷入“工具化”瓶颈。

三、Kimi:长文本处理“学术助手”

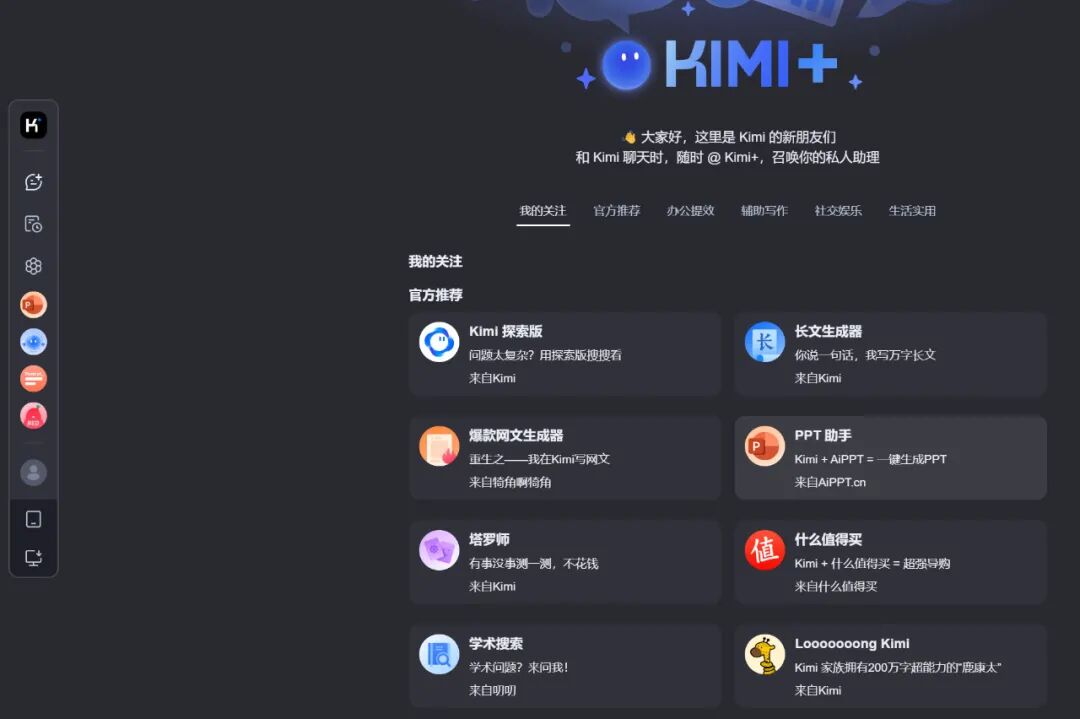
Kimi主打超长文本处理与深度推理能力,其创始团队由清华、卡内基梅隆等顶尖学府人才组成。Kimi从最初支持20万汉字输入,升级至200万字无损上下文处理能力,成为全球长文本赛道的标杆产品。
1、特点

Mooncake解耦架构:

采用以KVCache为中心的创新架构,分离预填充与解码集群,充分利用GPU资源,推理吞吐量最高提升525%,响应速度提升3倍。这一技术支撑了Kimi处理百万字文档的高效性。

长文本与多模态融合:

200万字无损上下文,可一次性解析长篇论文、法律合同,支持PDF、Word、Excel等文件格式。多模态升级,支持图文联合推理(如解析含数学公式的图片)、语音输入/播报功能,并开发浏览器插件实现网页划线提问和摘要生成。

深度推理与AIAgent:

2024年10月推出的Kimi探索版具备自主搜索能力,一次搜索可精读500个页面,结合思维链(CoT)技术实现复杂问题拆解与多步推理。例如律师用Kimi分析合同时,它能识别风险条款并给出法律建议。

2、发展

需要强化多模态能力,数学推理较弱,准确性低于其他竞品,例如解答数学题时常出现细节错误,还需要解决长文本处理的算力成本问题。

四、智谱清言:知识图谱的专家

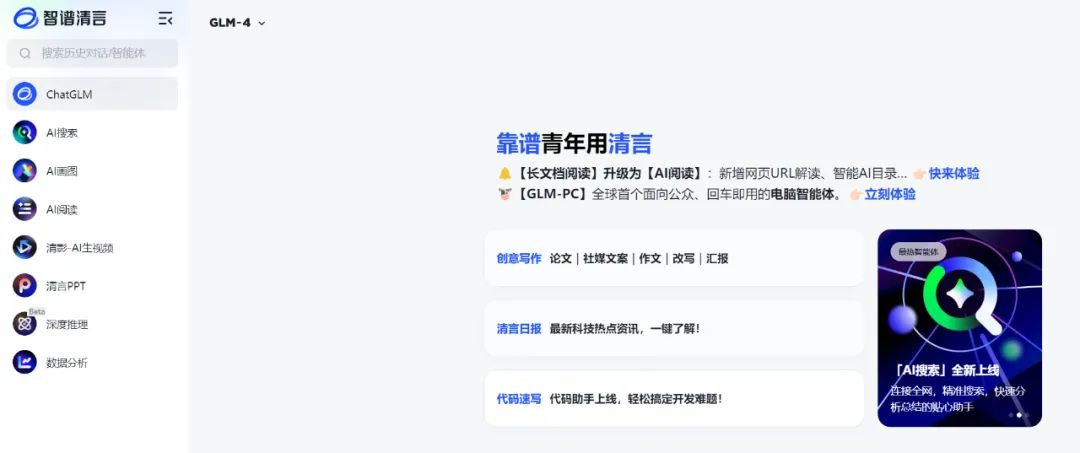
智谱清言是由清华大学实验室与智谱AI联合开发的千亿级参数大模型,技术源自清华团队。专注于知识图谱,在知识抽取、融合等方面有优势,知识的系统性和准确性较高。
1、特点

知识图谱构建:

智谱清言通过构建大规模的知识图谱,将海量的信息进行结构化处理,使得模型能够更好地理解和运用知识,为用户提供更准确、更有深度的回答。

专业领域应用:

在一些专业领域,如法律、金融等,智谱清言能够基于其知识图谱,提供专业的咨询和建议,帮助用户解决复杂的问题。

2、发展

2025年计划开源最新系列模型,包括端侧推理模型和多模态Agent框架;联合硬件厂商,开发智能家居控制中枢和车载语音助手,拓展物联网场景。

五、通义千问:阿里云“行业全能手”

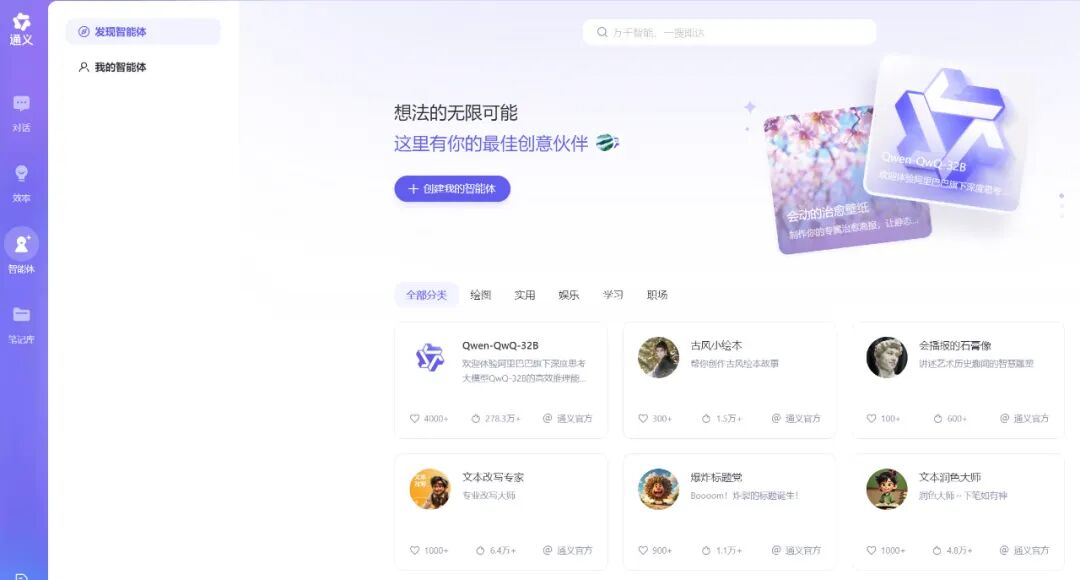
通义千问基于Transformer架构,通过创新的训练方法(如动态NTK感知插值、LogN-Scaling、窗口注意力机制)扩展上下文长度。

其千亿级参数规模(Qwen2.5-Max版本)结合混合专家模型(MoE)架构,在自然语言处理、多模态理解等任务中表现出色。
1、特点

通用性强:

通义千问适用于多种自然语言处理任务,包括文本生成、问答系统、机器翻译、文本分类等,在各个领域都能提供出色的表现。

多模态融合:

整合图文生成(通义万相)、音视频理解(通义星尘),支持PDF、Excel等多格式文件分析。

企业级服务闭环:

阿里云生态整合,无缝对接电商、物流、金融等行业解决方案(如天猫精灵智能客服)。私有化部署,支持本地服务器数据隔离,满足金融、政务等敏感场景需求。

开源影响力:

Qwen系列模型下载量突破1.8亿,衍生模型数达9万,超越Meta的Llama系列。

2、发展

推理模型升级,基于Qwen2.5-Max开发专用推理引擎,降低企业部署成本;多模态深度整合,推出支持4K视频生成、3D建模的“全能模型”(Omni-Models);AI-Agent生态,与Manus等平台合作开发智能体,实现复杂任务自动化。

六、横向对比:谁更适合你?

1、能力维度

智能度:DeepSeek≈通义千问>Kimi>智谱清言>豆包

响应速度:豆包≈Kimi>通义千问>DeepSeek>智谱清言

准确率:DeepSeek(专业领域)>智谱清言(学术)>通义千问(行业)>Kimi(长文本)>豆包(日常)

2、适用场景

企业用户:选DeepSeek(技术文档、金融分析)或通义千问(行业定制)。

学术党:Kimi读论文、智谱清言写报告,双剑合璧。

日常用户:豆包聊天、追热点,Kimi整理资料,轻松搞定。

3、用户群体

技术开发者:DeepSeek的开源属性和低成本是首选。

学生/研究员:智谱清言+Kimi,一个查资料一个写综述。

内容创作者:豆包的抖音生态整合能力无敌。

写作最后:按需选择才是王道

要专业:DeepSeek、通义千问。

要好玩:豆包。

要学术:Kimi、智谱清言。

要性价比:豆包(日常)、DeepSeek(企业)。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

在这里插入图片描述

为什么要学习大模型?

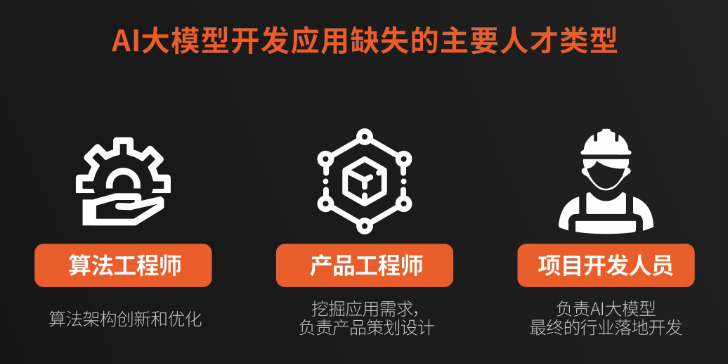
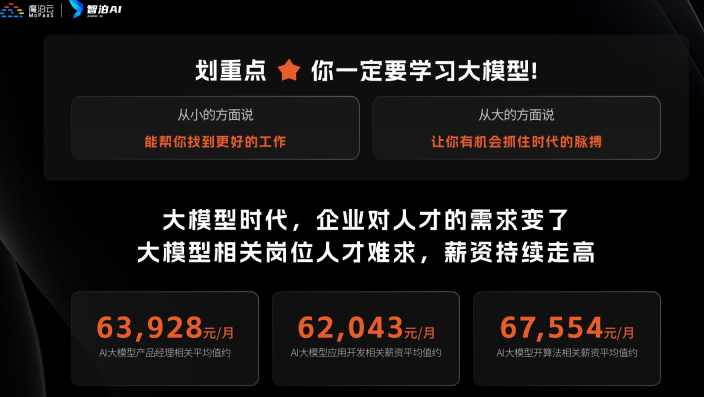
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。

在这里插入图片描述

在这里插入图片描述

大模型入门到实战全套学习大礼包

1、大模型系统化学习路线

作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!

img


2、大模型学习书籍&文档

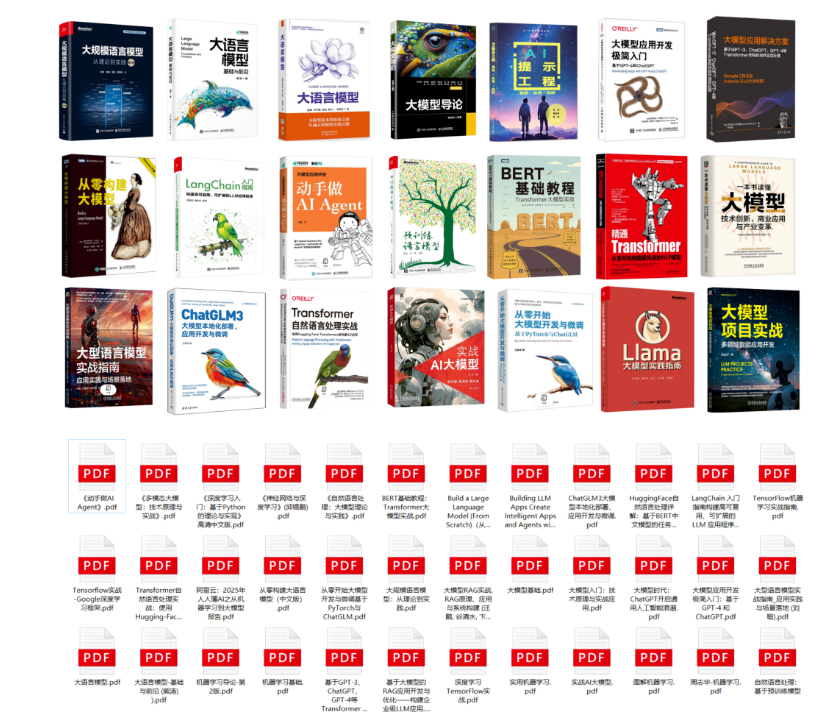
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。

在这里插入图片描述

3、AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

4、大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

img

5、大模型大厂面试真题

面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

img

适用人群

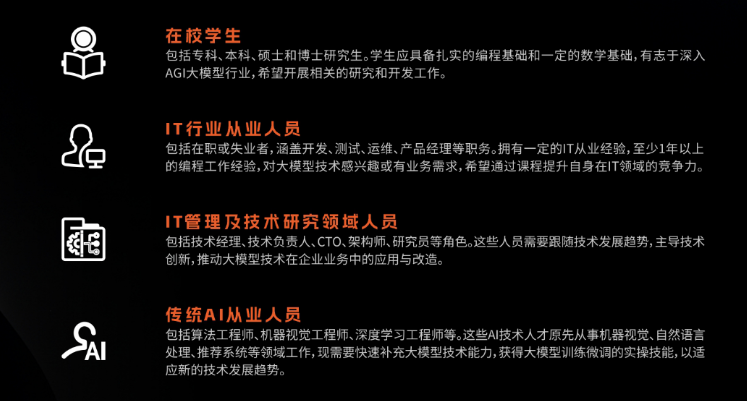
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

国内大语言模型对比评测(三) 针对国产免费使用的大语言模型,我们基于不同方面的问题去测试模型并给出一个基础结果和主观评价。希望通过该工作以帮助各位读者找到满足自己需求的大语言模型,提高大家的工作学习效率。对于大模型生成结果给出一个综合排档:第一档:阿里通义千问、百度文心、智谱清言、讯飞星火第二档:腾讯混元、百川智能、抖音云雀第三档:MINIMAX后续我们仍会继续精进测评结果!!! 阅读详情

相关推荐

5款国产大语言模型测评报告

ChatGPT的推出,对整个科技行业而言可谓“平地起惊雷”,正式拉开了大模型产业蓬勃发展的序幕。目前已有多款大模型上线并面向公众提供服务。不过,这些产品在性能、易用性等方面都有所不同。那么究竟哪个更好用呢?本文将从诗歌、作文、数学、专业领域(以计算机领域为例)这四个角度去分析各个国产大语言模型的特点,并结合一些工具和自己的主观感受来对各个大模型进行评测。

superheromen的博客 4700

九大国产AI大模型深度对比,第二款简直是宝藏!我和6亿人都在用

阿里家的这位,算是博学多才!文心一言的学习能力杠杠的,各种任务都能上手,算是 AI 界的全能选手。是:天工 AI 和讯飞星火虽然现在还在追赶,但是它们在各自的专攻领域已经展现出了惊人的潜力,估计再练练就能赶上来!是:文心一言,豆包,通义千问,秘塔和腾讯元宝就像是那种有特长的选手,某些领域特别在行,但可能不是样样都能拿第一。大全目前专注于小白 AI 入门领域的研究,分享从 0 到 1 入门 AI,ChatGPT 知识的系统性教程,但是,让它处理其他领域的问题,就有点像数学老师去教体育,可能就不那么在行了。

daniellq的博客 1万+

Petalinux实战:3种方法调试AXI UART Lite设备(含minicom/screen/直接寄存器操作对比)

本文详细介绍了在Zynq平台上使用Petalinux调试AXI UART Lite设备的三种实用方法:用户空间工具(minicom/screen)、应用层程序(termios配置)和底层寄存器直接操作。文章对比了各方法的优缺点与适用场景,并重点解析了设备树配置、驱动加载等关键环节,帮助开发者快速定位并解决串口通信中的常见问题。

weixin_29190169的博客 425

国产AI大模型哪家强?十大维度横评四款主流大模型!

这部分的最后,我们来看看四款大模型对文本的总结提炼能力。小编从IT之家随机选择了一篇新闻资讯,分别让四款大模型将这篇新闻总结成一句话的摘要。先看文心一言的表现,虽然是总结了,意思也正确,但总结得比较啰嗦,而且不符合“一句话”的要求:通义千问也有类似的问题,总结啰嗦,而且超过一句话的限制:360 智脑在这一项中表现不错,一句话准确总结了这段文章的大意:讯飞星火提炼得也很精炼,一句话搞定,而且意思准确。在这一环节,四款大模型产品的得分分别为:讯飞星火:10 分通义千问:8 分(摘要提炼 - 2)

2301_76161259的博客 4633

Minitab田口设计实战:如何用正交试验优化遗传算法参数(附完整操作步骤)

本文详细介绍了如何利用Minitab田口设计进行遗传算法参数优化,通过正交试验方法显著提升效率。文章涵盖实验设计、Minitab操作步骤、结果分析及高级技巧,帮助工程师快速掌握这一工业级优化技术,实现算法性能的显著提升。

wind6的博客 857

20个闭环渗透测试项目:从漏洞发现到简历突围

渗透测试不仅是工具使用,更是对系统设计缺陷与实现偏差的深度推演。理解OWASP Top 10、Burp Suite等基础能力只是起点,真正具备工程价值的是能复现、可验证、可协作的完整攻击链。本文聚焦真实业务场景下的SSRF协议绕过、JWT签名机制缺陷、Redis未授权利用、Kong网关配置风险及etcd存储结构分析等核心热词,揭示漏洞本质在于架构决策与配置偏差的叠加态。适用于红队实战、甲方安全建设与乙方渗透审计等多类岗位,帮助从业者将技术动作升维为技术叙事。

weixin_32234493的博客 410

2025年AI大模型终极指南:五款国产模型横向对比,程序员必备收藏(TaoToken统一Key接入版)

2025年程序员本地调用AI大模型常遇多平台Key混乱难题。本文提供TaoToken统一Key接入方案,一次配置Base URL即可切换DeepSeek、Kimi、通义千问等五款国产模型,附可复制配置片段、调用示例与报错排查,助你高效对比模型效果。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35752122的博客 17

保姆级教程:如何用Le2i Fall Detection Dataset训练你的跌倒检测模型(附数据集下载)

本文提供了一份详细的实战指南,教你如何使用Le2i Fall Detection Dataset训练跌倒检测模型。内容涵盖数据集的深度解析、预处理与工程化管道搭建、模型选择与训练策略,以及评估优化与部署考量,旨在帮助开发者从零构建高精度、可应用的跌倒检测系统。

assembly8low的博客 1283

国产大模型对比:文心、豆包、通义...哪家最好?基于最公允大模型排行榜细致整理

虽然国外模型的能力目前还领先4个月左右,但考虑安全性与响应速度等因素,在国内最好还是选择国内的模型。 不过,面对众多的大模型 : 如文心、豆包、通义等,市面上已经有好几百个国产大模型,如何挑选合适自己的模型就成为了一大难题。 同时,目前市场上关于大模型能力的排行榜种类繁多,不光有国外的各种模型评测,还有国内大学也都纷纷提出了自己的模型评测 ,但要找到一个准确且有区分度模型排名并不容易。 本文就是我调研的结果,主要回答两个问题: 1)国内大模型哪些比较好? 2)这些排名,是什么原理?哪个最值得参考

whisperzzza的博客 6万+

高通平台camera构架sensor驱动详解

优先阅读。

a5566255的专栏 3243

全面解读 SAP Business Data Cloud

SAP 在 2025 年初正式推出(简称BDC),它把、以及全新的统一封装为一项完全托管的 SaaS 服务,配套交付“语义层 + 数据产品 + 智能应用”三层能力,为企业构建真正贴近业务语境的 “Business Data Fabric”。这一方案不仅解决了跨系统数据碎片化、治理难及 AI 训练数据可信度低的问题,还为现有 BW 客户、S/4HANA以及第三方工作负载提供云上现代化路径和零拷贝数据共享机制。本文将围绕技术架构、核心组件、业务场景、迁移路线及未来展望展开,以 Henkel 等真实案例佐证。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 882

【程序员必看】5款国产AI大模型全方位对比:DeepSeek、豆包、Kimi、智谱清言和通义千问,谁才是你的最佳选择?(收藏版)

文章对比分析了五款国产AI大模型:DeepSeek(高性价比推理)、豆包(多面手)、Kimi(长文本专家)、智谱清言(知识图谱)和通义千问(行业全能手)。从特点、优势、适用场景和发展前景进行了详细阐述,并给出横向对比,帮助读者根据自身需求(专业、学术、日常或性价比)选择最适合的AI模型。

2301_76168381的博客 6769

(建议收藏)2024最新 URL Scheme大全APP跳转界面地址更新中 ios快捷指令快捷方式链接跳转微信小程序必备autojs可用免root (可定制开发和提取URL Scheme 参数提取)

(建议收藏)2024最新 URL Scheme大全APP跳转界面地址更新中 ios快捷指令快捷方式链接跳转微信小程序必备autojs可用免root (可定制开发和提取URL Scheme 参数提取)

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 1万+

【国产AI大模型横评】十大维度对比四款主流模型,哪家最强?

这部分的最后,我们来看看四款大模型对文本的总结提炼能力。小编从IT之家随机选择了一篇新闻资讯,分别让四款大模型将这篇新闻总结成一句话的摘要。先看文心一言的表现,虽然是总结了,意思也正确,但总结得比较啰嗦,而且不符合“一句话”的要求:通义千问也有类似的问题,总结啰嗦,而且超过一句话的限制:360智脑在这一项中表现不错,一句话准确总结了这段文章的大意:讯飞星火提炼得也很精炼,一句话搞定,而且意思准确。在这一环节,四款大模型产品的得分分别为:讯飞星火:10分通义千问:8分(摘要提炼-2)

2401_84204207的博客 6829

基于Scrapy+Playwright的学术会议信息智能爬取系统实战

本文详细介绍如何使用Python构建一个高效的学术会议信息爬取系统,结合Scrapy框架和Playwright无头浏览器技术,实现对全球学术会议数据的自动化采集、清洗和存储。文章包含完整的技术方案设计、代码实现细节以及性能优化策略,可帮助读者快速掌握现代网络爬虫开发的核心技术。关键词:Python爬虫、Scrapy、Playwright、学术会议、数据采集、反爬对抗python复制下载。

2201_76125261的博客 707

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

5个国产大模型实测对比2026:DeepSeek、Kimi、豆包、通义、智谱哪个好用

2024年大家关心"能不能用",2025年关心"好不好用",2026年关心的是"值不值得用这个而不用那个"。身高排序题的推理过程有跳跃,把小孙和小王的关系弄混了一次,虽然最终结论通过"重新检验"纠正了,但过程展示的可信度打折扣。脚本逻辑严谨,有完整的异常处理,输出报告格式做了对齐,注释清晰但不冗余。你让它"犀利",它能理解这个词,但输出出来更像是"理性批评"而非"犀利评论",情感温度不够。:结构输出还行,但"最大缺陷"这一项基本是在说废话,比如指出一篇学术文章"缺乏通俗化表达",这个反馈毫无洞察价值。

lzhdim的专栏 1万+

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

国产大模型盘点,到底谁才是老大?

DeepSeek后时代,中外AI大模型竞赛进入新一轮白热化阶段。XAI、OpenAI、谷歌、百度等主流AI大模型厂商先后官宣,旗下闭源高端AI模型将转向开源,而主流AI产品也计划免费向用户开放。这意味着,AI技术正逐渐打破以往的专业壁垒,真正的走近寻常百姓。但这些模型的真实水平究竟如何?它们的差距到底有多大?本文主要针对国内部分主流AI大模型技术特点、能力及应用场景进行梳理。

qq_46094651的博客 1878

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

国内12家主流大模型,谁是地表最强?亲测后发现是它!

大模型GPT-3.5,2022年11月发布。可谓春风化雨,雨后春笋一般。到现在2024年,国产大模型工信部注册的,已有几百家。国产大模型崛起速度之快,令人惊叹。在如此之多的大模型里面,如何选择好用的,还真是个问题。结合GPT4o和Claude3.5,加上自身的一定使用,总结了如下12家国产大模型:下面表格,排名不分先后各自产品对应的logo如下:文字版介绍:1 百度:推出了“文心一言”大模型,具备强大的自然语言处理能力,广泛应用于搜索、对话等领域。

2401_85373691的博客 1万+

大模型:国内主要大模型的对比及其特点总结

国产模型在长上下文、多模态对齐、行业适配等方面形成差异化优势,但复杂推理和创造性任务仍与GPT-4存在约12-18个月代差。:书生·浦语(工具调用)、InternLM(长文本):通义千问(全尺寸开源)、Yi系列(数学/代码)开源版本齐全(1.5B/7B/14B/72B):ChatGLM(端侧优化)、星火(语音交互):MoE混合专家模型(最大1.8万亿参数):文心一言(合规性强)、盘古(行业定制)多模态能力突出(文本、图像、视频生成)教育领域专用优化(试题解析、教案生成)支持超长上下文(百万token级)

meisongqing的博客 5982

国产大模型实测对比:深度测评 DeepSeek、Kimi、文心、智谱,哪款最适合程序员?

国产大模型实测对比显示,DeepSeek V4 Pro以92分综合成绩领先,在代码生成与Debug方面表现突出,API成本仅为GPT-5.5的1/10。Kimi K2.6擅长长文本处理,文心5.1专精中文技术写作,智谱GLM-5.1在开源生态和实时联网方面优势明显。测试覆盖20项程序员高频任务,包括代码生成、Bug定位等技术场景。建议开发者根据具体需求选择:代码开发首选DeepSeek,文档处理推荐Kimi,中文写作优选文心,开源项目适用智谱。国产模型在中文语境和本土化支持上已超越国外产品,性价比优势显著。

weixin_62242812的博客 3485

国内大语言模型的相对比较:ChatGLM2-6B、BAICHUAN2-7B、通义千问-6B、ChatGPT3.5

国产大模型有很多,比如文心一言、通义千问、星火、MOSS 和 ChatGLM 等等,但现在明确可以部署在本地并且开放 api 的只有 MOOS 和 ChatGLM。MOOS 由于需要的 GPU 显存过大(不量化的情况下需要80GB,多轮对话还是会爆显存),但 ChatGLM 可以在笔记本电脑部署(int4版本只需要6GB显存即可)。所以本文采用ChatGLM 与 ChatGPT 做对比,看看国产模型的优点和缺点。

qq_34717531的博客 5293

「小白必读」国内超火的 8 款 AI 大模型,你的副业都来自它

大家好,最近好多朋友在问我,国内是否有好用的大模型,今天我就整理好 8 款大模型,大家可以多尝试,一定会有不一样的感觉。01HOTSPOTKimiKimi 是由月之暗面科技有限公司开发的人工智能助手。它擅长中英文对话,能够提供安全、有帮助、准确的回答。同时能够阅读和理解用户上传的文件,访问互联网,并且结合搜索结果来回答问题。也能够处理多种文件格式,包括但不限于TXT、PDF、Word文档、PPT幻灯片和Excel电子表格。02HOTSPOT智普清言。

python12345678_的博客 5069

目前比较火爆的国产AI大模型有哪些?它们分别有什么特色和优缺点?

2023年被誉为AI大模型的元年,从OpenAI先后推出了多个版本的GPT,再到国内外大模型的密集发布、技术与应用的突破、行业生态的初步形成以及社会影响的广泛化。这一年标志着AI大模型的发展进入了一个新的阶段并将在未来继续引领人工智能技术的发展和应用落地。时至今日,目前有哪些国产AI大模型在激烈的竞争中脱颖而出了呢?今天一起来盘点一下。尽管AI大模型在技术和应用上取得了显著进展,但仍面临诸多挑战。例如,如何进一步提高模型的精度和效率、如何降低模型的训练成本、如何确保模型的安全性和可靠性等。

文章主要涉及嵌入式软件开发、测试、项目管理等,欢迎交流,共同进步。 6549

国产大模型崛起:2026年主流模型深度对比

2026年国产大模型格局已趋于成熟,形成差异化竞争态势。Kimi凭借200万字超长上下文窗口在长文档处理领域独占鳌头;阿里通义千问以免费策略和强大中文能力成为日常办公首选;DeepSeek则以超高性价比赢得开发者青睐。文心一言、智谱清言等产品也在特定场景建立优势。国产模型已从追赶者变为部分领域的引领者,用户可根据需求选择最适合的工具:Kimi适合法律合同、学术论文等长文本分析;通义千问擅长中文创作和办公场景;DeepSeek则是开发者的性价比之选。随着技术持续迭代和应用场景不断拓展,国产大模型正迎来黄金发展

AI 爪客,专注 AI 智能体与 Skill 研发落地,斩获腾讯云、讯飞、小米等多场 AI 赛事奖项,分享 Agent 实战干货与工程化经验。 3579

2023年6月 国内大语言模型对比【国内模型正在崛起】

先说一下这个文章怎么来的。因为朋友问我大语言模型可以生成公务员面试回答不,我说可以啊。之前看文心有这个服务。我想最近好几个模型也没用了测一把!结果!大吃一惊!我觉得我的三个傻孩子长大了!(chatglm130B才出的没算进去)你是一名参加公务员考试的考生,请根据公务员考试结构化面试的评分标准,口语化地回答以下问题,字数控制在400字左右。假如你上岗后,领导交代你和一位同事共同完成本单位的财务迎检工作,他自顾自干活,你会怎么做?国外的:claude。

QAQterrible的博客 2080
上一篇: 【收藏必看】小白也能懂的大模型工作原理:输入到输出全流程详解
下一篇: 【收藏必备】大模型原理解析:从Transformer架构到训练流程,一文彻底搞懂LLM核心技术
大模型教程.
博客等级 码龄5年 5269粉丝 2836原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值