


收藏必备!小白程序员轻松入门大模型:RAG技术全解析(从基础到前沿)
本文深入探讨了在大模型领域,如何通过检索增强生成(RAG)与模型微调提升模型的泛化能力及领域适应性。文章从RAG与微调的基本概念入手,逐步解析了传统RAG、T-RAG、GraphRAG、HippoRAG、KAG等技术的演进路径与核心优势,并分析了各技术的应用边界。此外,还讨论了RAG技术的缺点及优化方法,为读者提供了全面而系统的大模型学习框架。
Part1:先厘清核心问题 ——RAG 与微调,该选哪一个?
首先看看面对大模型的一些问题,通常情况下提出的两个解决思路,RAG 和微调,它们的区别是什么?简单来说 RAG 可以理解成是对照的书本找答案,微调是针对答案去学习。

Part2:回归本质 ——RAG 到底是什么?
从上文可以看出,RAG 的诞生就是其实为了尽量补充大模型的一些缺点,简单概括一下基础的 RAG 它的几个阶段:
1.检索(Retrieval): 从外部知识库中检索与用户查询相关的信息。
2.增强(Augmentation): 将检索到的信息与模型的内部知识结合起来,构建上下文。
3.生成(Generation): 基于增强后的上下文,生成最终的回答。

Part3 基于文档检索的 RAG 有什么缺点?
但基础的 RAG 技术还是有缺陷,从上面的步骤拆解去看,就能发现:
- 它难以容纳多模态数据。
- 检索到的上下文可能不够精准,导致生成的回答不够准确。
- 对于复杂的跨文档推理任务,传统 RAG 方法可能表现不足。
- 需要维护一个庞大的知识库,增加了存储和计算成本。

那么如何优化 RAG呢?
针对这些缺点再往前衍生,探索 RAG 与其他技术结合的方式,能不能继续增强 RAG 的能力,有几篇论文来介绍这种衍生,这里可以举几个例子如下。
Part4 T-RAG 是什么?
它的全称是 Tree-RAG(T-RAG),将检索增强生成(RAG)与经过微调的开源大型语言模型(LLM)相结合,以生成响应。 具体来说,T-RAG 在检索过程中,利用实体树来增强从向量数据库检索到的上下文。所以相比 RAG,它结合了树形结构,利用内部实体树增强上下文信息,适用与更复杂的场景。
它的原理简单概括就是:
1. 实体检测: 用户查询前扫描查询内容,识别出与组织内实体名称相对应的关键字。
2. 实体信息提取:从实体树中提取与匹配实体相关的详细信息。
3. 上下文构建: 将实体信息与从向量数据库检索到的文档块合并,构建更全面的上下文。
4. 生成回答: 基于增强后的上下文,生成最终的回答。
所以论文里有一个等式就是:T-RAG=RAG+微调+实体检测

Part5 GraphRAG 是什么?
如果说 T-RAG 是通过实体树增强,那 GraphRAG 就是通过整合知识图谱(KG)来增强 RAG。这里引入一个新概念知识图谱,它是一种基于关系存储和链接相关或不相关数据的数据结构,简单理解就是知识的动态网络。
它的原理简单概括就是:
- 索引过程:将文档中的实体和关系提取出来,构建知识图谱。
- 查询过程:在检索时,利用知识图谱中的关系信息,跨文档传播信息,生成更准确的回答
附上论文中对这个过程的概括:

Part6 HippoRAG 是什么
关于构建图的还有另一个代表,就是 **HippoRAG,它是一种受大脑海马体启发的 RAG 变体,旨在帮助大型语言模型跨段落整合新知识。**它是一个受神经生物学启发的大语言模型长期记忆框架,各个组件均旨在模拟人类记忆的不同侧面。主要由三个部分构成:人工新皮层(LLM)、旁海马区域(PHR 编码器)以及人工海马(开放知识图谱,Open KG)。就是图中的这 3 个大脑。
下面的过程就是它的检索原理:分两个路径,一是离线索引,LLM 将文段处理为知识图谱三元组,并将其整合到人工海马索引中;同时,PHR 负责检测同义关系以实现信息互联。二是在线检索,LLM(作为人工新皮层)从查询中抽取命名实体,而 PHR 编码器则将这些实体链接到海马索引上。随后,对知识图谱应用个性化 PageRank(PPR)算法,进行基于语境的检索。

简单示例:
查询:寻找一位从事阿尔茨海默症研究的斯坦福教授。
➡ 传统 RAG: 可能需要一个段落同时提到“斯坦福教授”和“阿尔茨海默症”才能识别出相关信息。
➡ HippoRAG: 通过关联图将“斯坦福教授”和“阿尔茨海默症”相关联,从而识别出托马斯教授。

Part7 GraphRAG 类的缺点?
- 依赖开放信息抽取方法,引入了大量的数据噪声,知识精准度差。
- 使用图结构实现跨文档的信息传播,缓解了向量召回的不足。例如需要多跳、复杂逻辑依然存在不足。LLMs推理能力有限。
- 检索到错误。噪声的信息后生成错误答案,仍然可能存在幻觉。
- GraphRAG 运行速度非常慢,因为它需要多个 LLM API 调用,可能会达到速率限制。
- 成本极高
- 以实体为中心的方法在索引和推理过程中导致语境信息的丢失,并且在语义匹配上存在困难。

Part8 KAG是什么?
KAG(Knowledge-Augmented Generation,知识增强生成)是一种结合知识图谱和生成模型的技术,通过引入结构化的知识,提升生成内容的准确性和相关性。
KAG 的核心功能包括:
- 知识与 Chunk 互索引结构,以整合更丰富的上下文文本信息
- 利用概念语义推理进行知识对齐,缓解 OpenIE 引入的噪音问题
- 支持 Schema-Constraint 知识构建,支持领域专家知识的表示与构建
- 逻辑符号引导的混合推理与检索,实现逻辑推理和多跳推理问答
可以看下这个官方简图:
看起来是 KBQA+HippoRAG 结合产出的一种技术,先看一下 KBQA 是什么

Part9 KBQA 是什么?
知识图谱问答(Knowledge-based Question Answering, KBQA)是指给定自然语言问题,通过对问题进行语义理解和解析,进而利用知识库进行查询、推理得出答案。
传统的基于搜索引擎的问答系统只能返回一些时效性的网页,以文档集合的形式呈现给用户,仍然需要用户阅读并分析文档以获取答案。而基于知识图谱的问答系统可以实现获取到更精确的答案,即在知识图谱中找到精确答案直接返回给用户,满足用户的精确信息需求,提供个性化知识服务。

KBQA 的缺点?
那 KBQA 有什么问题?
1.依赖高质量的知识图谱,图谱构建门槛高,高质量的知识图谱需要大量人力
2.信息损失大,知识图谱中只包含了实体、关系、属性等,相对信息丰富的原始文本,信息损失较大
3.可阅读性差,生成的答案包含关键事实,上下文信息较少

Part10 KAG 是怎么解决这些问题的?
这个图其实很好的说明了 KAG 的思路,就是在KBQA+HippoRAG情况下,再重点强调推理,所以它也重点强调它是应用于垂直问答领域,特点是:
- 兼容强Schema专业知识和弱Schema开放信息
- 图结构知识与文本知识的互索引结构
- 专业领域可平滑调节的专业决策与信息检索, 丰富知识完备性
- 通过开放信息+结构化构建做知识语义对齐,平衡信息抽取(低门槛)与专业构建,缓解开放信息抽取引入的噪声问题

Part11 HippoRAG2 是什么?
当然技术发展非常快速,重新搜索HippoRAG 的时候,发现最近也出了HippoRAG2 ,相比其他技术表现非常优异,它与 HippoRAG 1 相比在结构上遵循类似的离线索引与在线检索两阶段流程,但在此基础上引入了几个关键改进,以更好地契合人类记忆机制:
- 无缝整合开放知识图谱中的概念信息与语境信息,提升索引的完整性和粒度;
- 利用知识图谱结构中超出单一节点的信息,促进了更具语境敏感性的检索;
- 引入了识别记忆机制,以改善图搜索中种子节点的选择。

Part12 小结
还有很多Advanced RAG 感兴趣可以自己去看一下,比如,LightRAG、PIKE-RAG 等等,后续有机会再展开,本文参考文档如下:
1.TRAG 论文地址:https://arxiv.org/abs/2402.07483
2.GraphRAG 论文地址:https://arxiv.org/pdf/2404.16130
3.HippoRAG 论文地址:https://arxiv.org/pdf/2405.14831
4.HippoRAG2 论文地址:https://arxiv.org/pdf/2502.14802
5.KAG 论文地址: https://arxiv.org/pdf/2409.13731
6.KAG 的 github:https://github.com/OpenSPG/KAG/blob/master/README_cn.md
7.KAG 的用户手册:https://openspg.yuque.com/ndx6g9/0.6/quzq24g4esal7q17#JQH6Y
8.其他参考图片:

最后
近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!
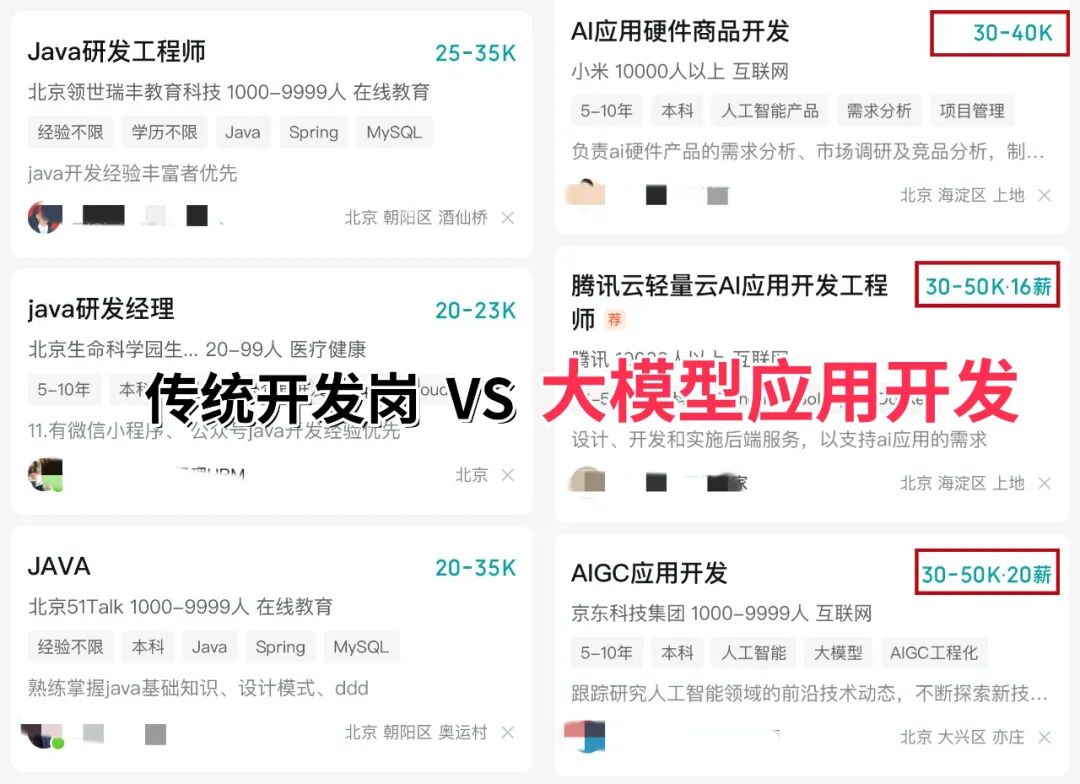
业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验,借行业风口实现职业翻盘!
深知技术人入门大模型时容易走弯路,我特意整理了一套全网最全最细的大模型零基础学习礼包,涵盖入门思维导图、经典书籍手册、从入门到进阶的实战视频、可直接运行的项目源码等核心内容。这份资料无需付费,免费分享给所有想入局AI大模型的朋友!
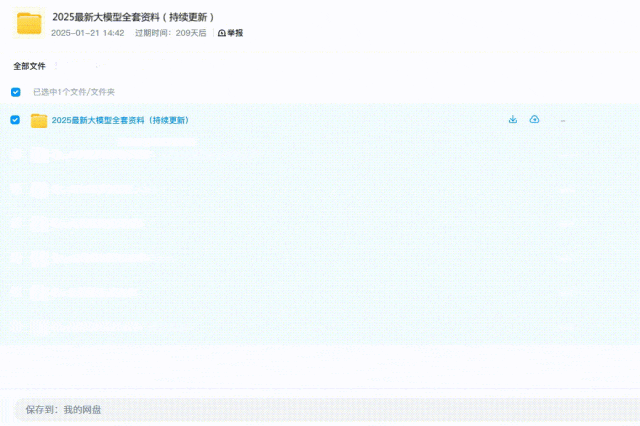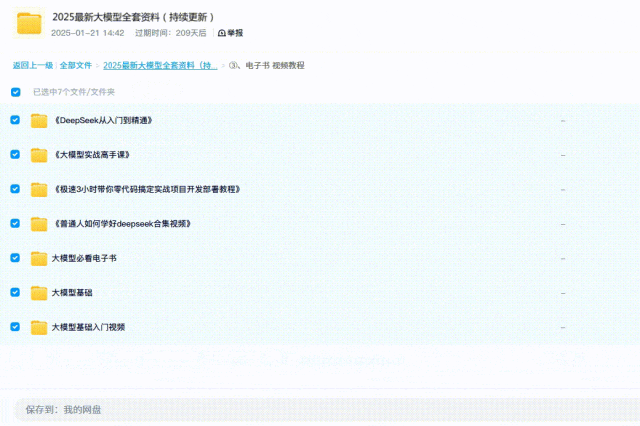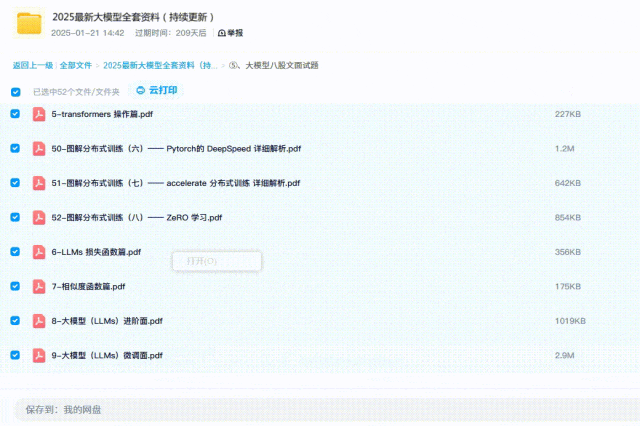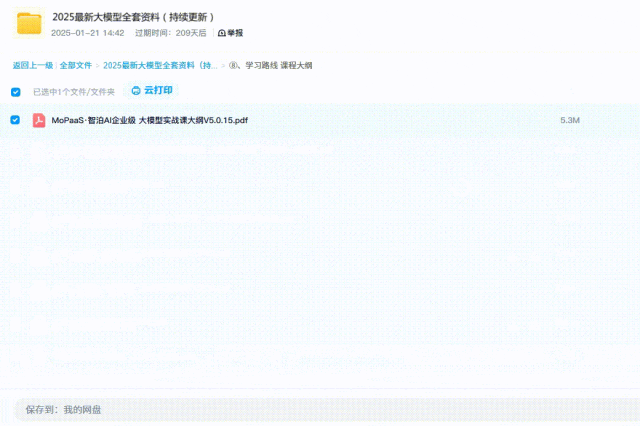
👇👇扫码免费领取全部内容👇👇
部分资料展示
1、 AI大模型学习路线图
2、 全套AI大模型应用开发视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
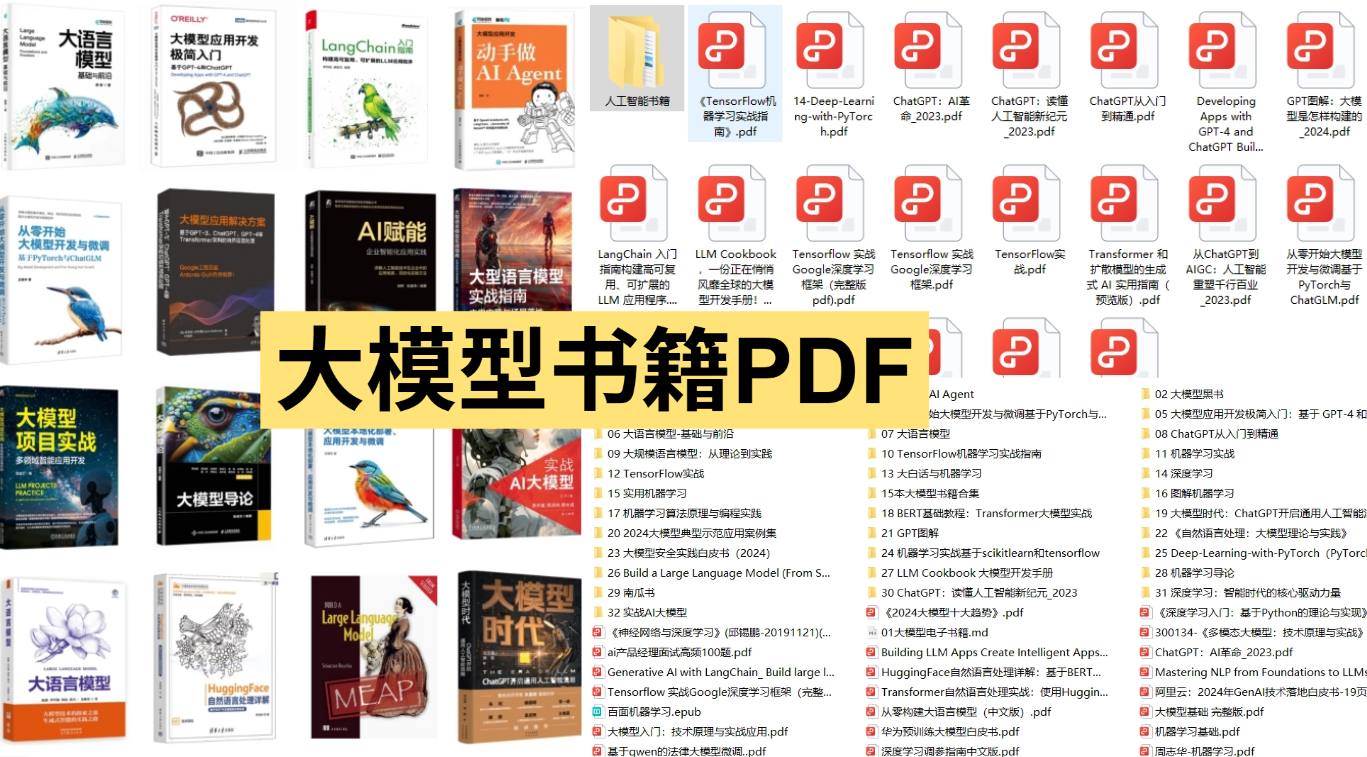
3、 大模型学习书籍&文档
4、 AI大模型最新行业报告
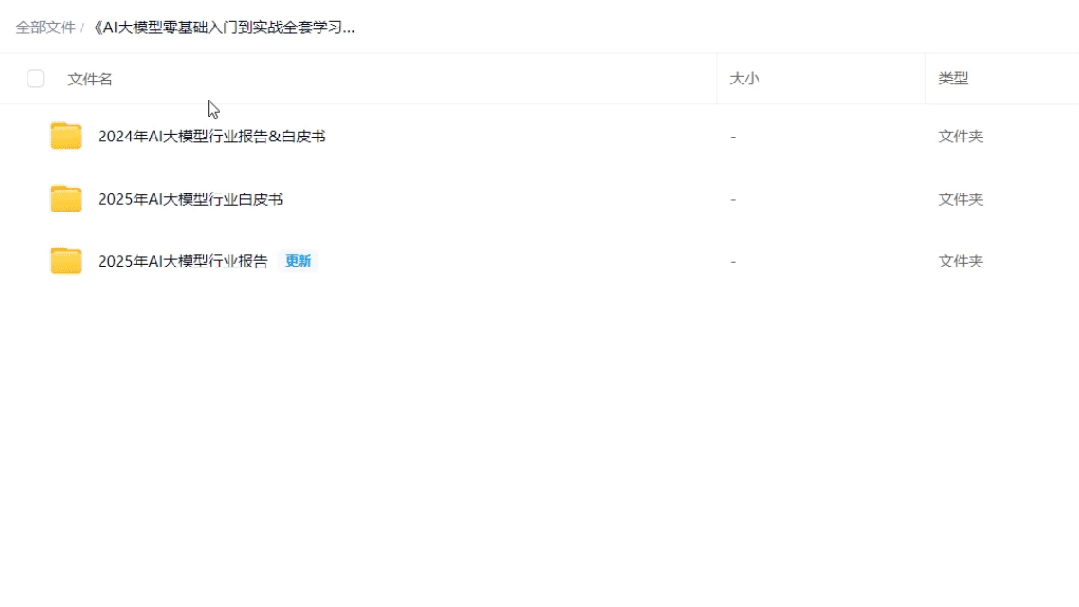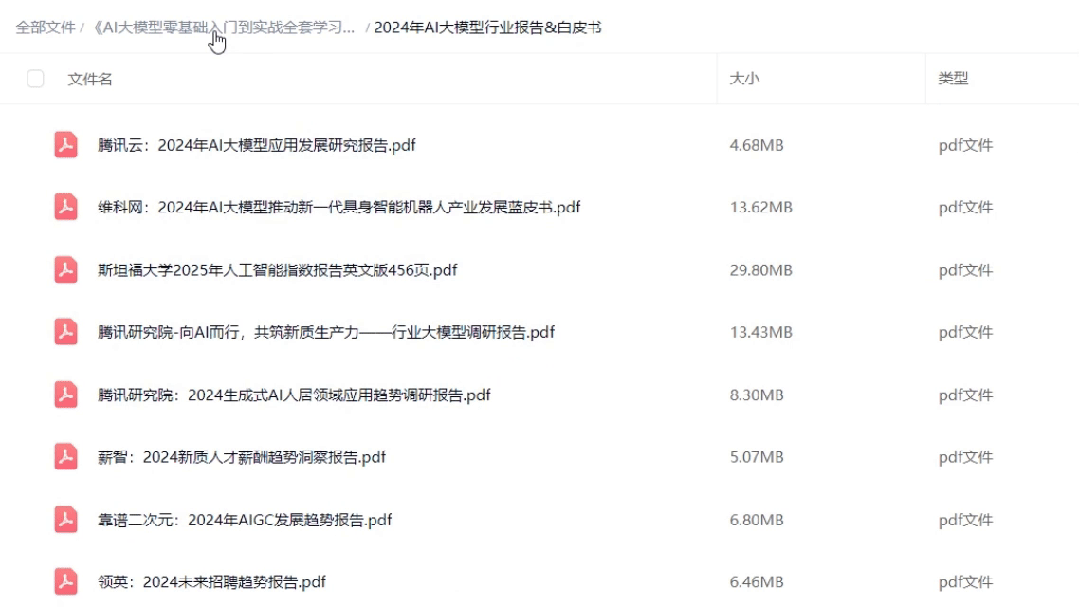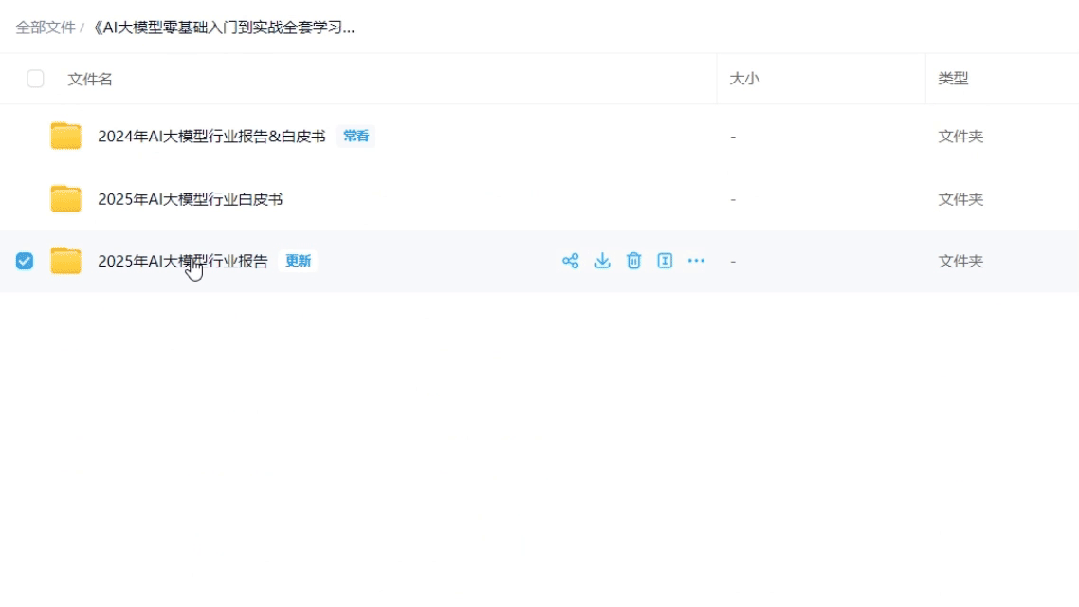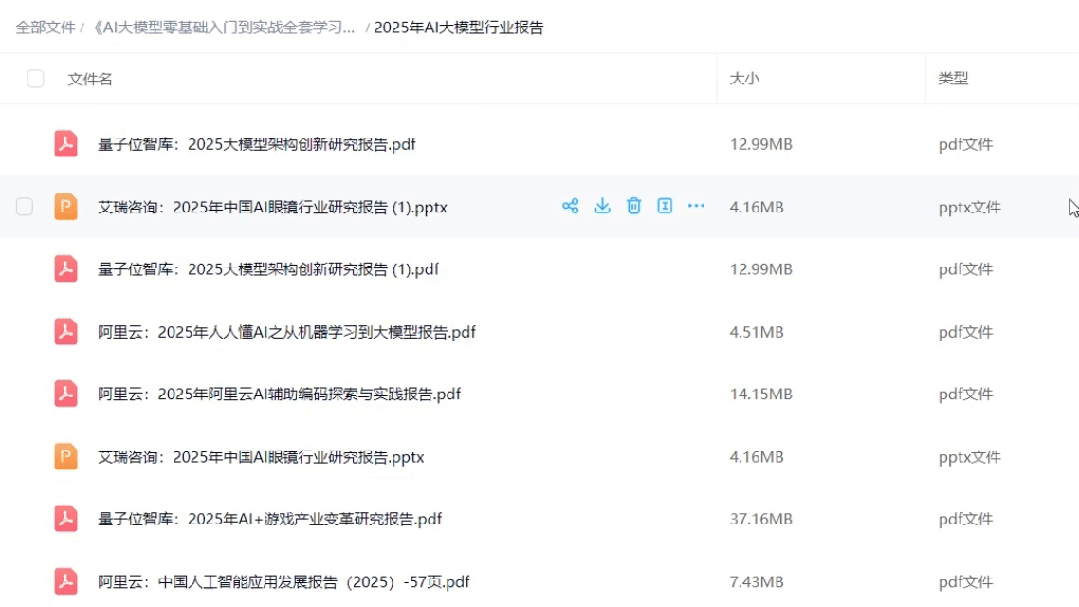
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、大模型大厂面试真题
整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。
6、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
- 👇👇扫码免费领取全部内容👇👇
这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
 5911


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


