


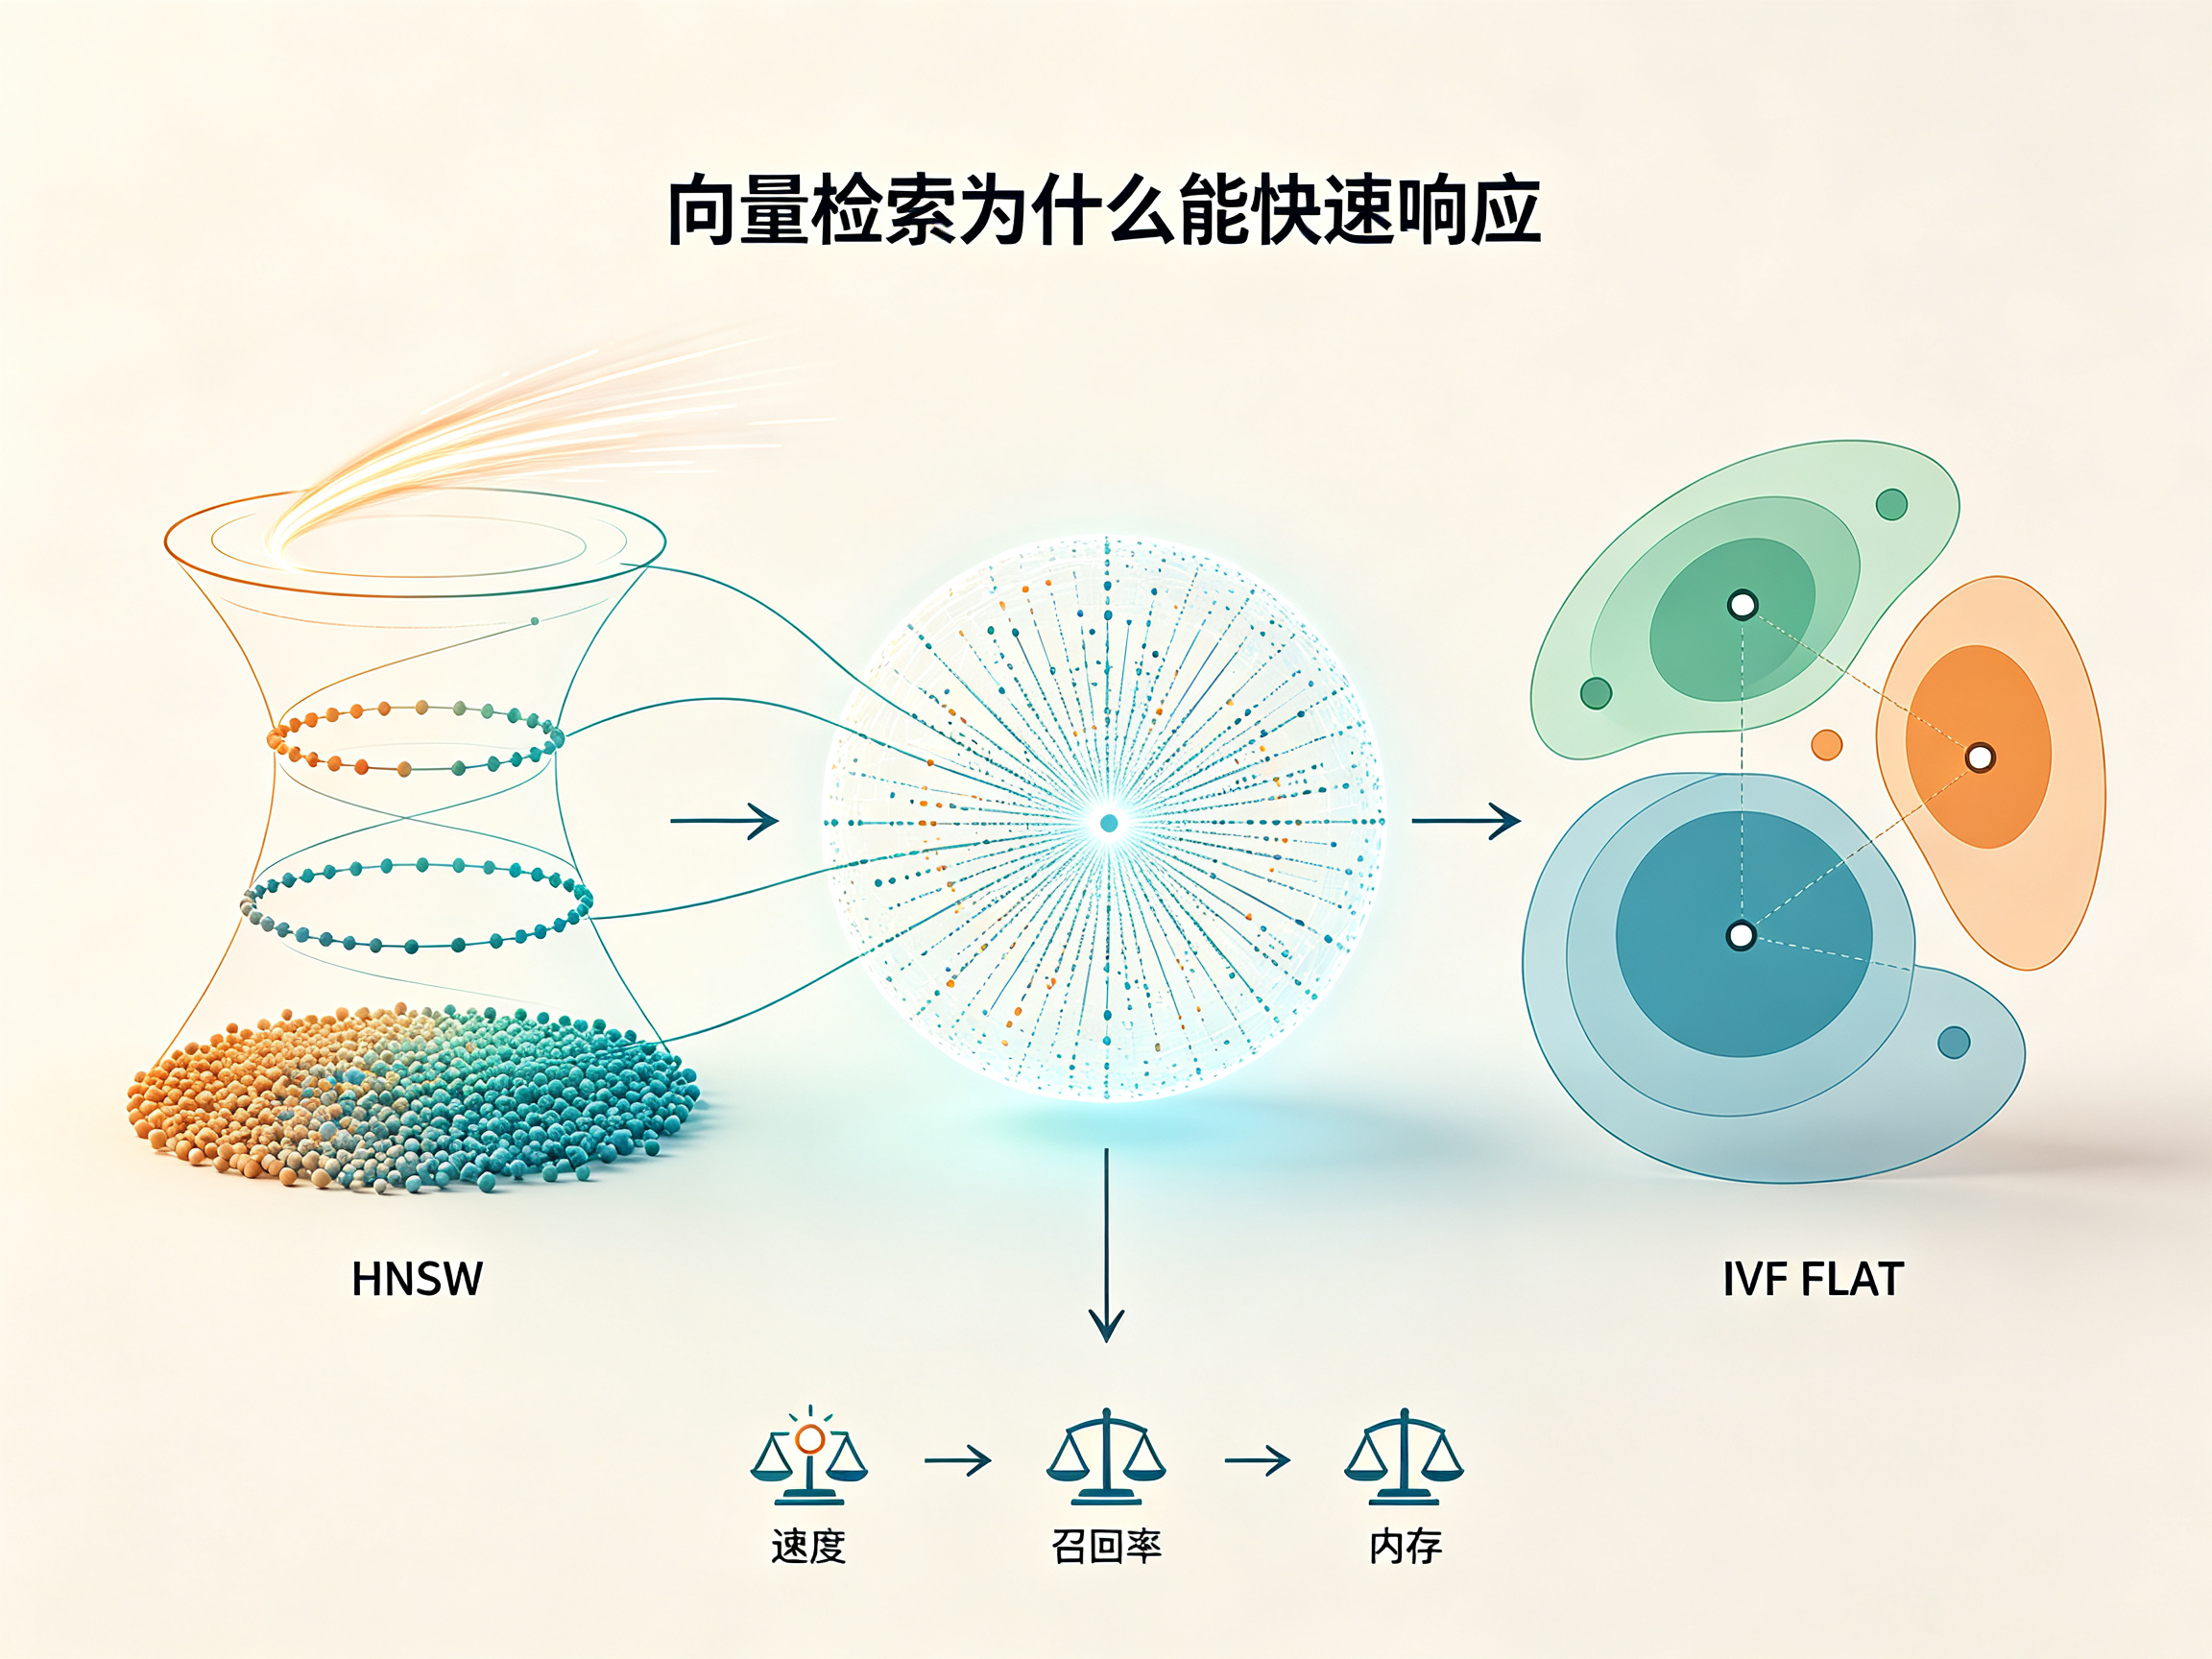
向量检索能在海量数据里快速响应,一个重要原因在于提前建好的向量索引。它把逐条比对换成结构化的局部查找:HNSW 用多层近邻图换查询速度,IVF_FLAT 用聚类换内存开销,两者在速度、召回率、内存之间各有取舍。
向量索引解决了什么
向量检索把文本、图片、音频变成高维向量之后做"近邻查找"。一段中文经 embedding 模型处理,会变成一串 768 维或 1024 维的数字。要找出与查询"最像"的 k 条,暴力做法是拿查询向量和库里每一条算距离,常用余弦相似度、内积或欧氏距离。
复杂度是 O(N·d)。当 N 到 1000 万、d 到 1024,单次查询要做上百亿次乘法,延迟可能达到秒级,线上服务难以支撑。向量索引用"空间换时间"的思路提前组织数据,把全量扫描降为局部游走或局部扫描。这里要盯住一个新指标:召回率(recall),它度量"索引找回的近邻占真实近邻的比例"。延迟再低,召回只有六成,返回的答案可能不准确,快也可能失去意义。
HNSW 原理
HNSW 全称 Hierarchical Navigable Small World,建的是一张多层跳表式的近邻图。第 0 层放全部向量,第 1 层往上逐层下采样,层数越高节点越稀疏。查询从最高层进入,找最近的邻居往下一层跳,像在跳表里从粗粒度快速逼近,最后在第 0 层精细定位。
每层只访问少数节点,整体复杂度约 O(log N)。它的长处是查询延迟低、召回率高,典型配置下 recall@10 可达到较高水平。短处是内存占用大:图既要存节点间的边(邻接表),又要存原始向量,实际内存通常是原始向量的数倍,构建也慢,需要逐条插入。
这类索引适合对响应速度和准确度都敏感的场景。企业知识库的语义问答、推荐系统的候选召回、以图搜图的商品匹配、日志里的异常模式检测,都常用 HNSW。
IVF_FLAT 原理
IVF_FLAT 全称 Inverted File with Flat storage,思路是先对全体向量做 k-means 聚类,查询时只搜最近的几个簇。训练阶段把 N 条向量聚成 nlist 个簇,记下每个簇中心。查询时先算查询向量与全部簇中心的距离,挑最近的 nprobe 个簇,只在选中的簇内做全量比对,其余簇直接跳过。
它的长处是内存省、构建快。额外只需存 nlist 个簇中心,数量远小于原始向量;一次 k-means 就能完成训练,原始向量原样保存(FLAT),不额外损失精度。短处是召回略低,近邻可能落在相邻却没被选中(nprobe 之外)的簇里,nprobe 调小会漏检。
数据规模上亿、内存只够存原始向量时,IVF_FLAT 更现实。大规模文本去重、人脸等生物特征检索、法律卷宗的相似案例匹配、离线批量的向量比对,都适合用它。
工程选型
中等数据量且追求召回,选 HNSW;超大数据量且内存吃紧,选 IVF_FLAT。数据在千万级以内、内存充裕(例如单机 64G 以上能放下图结构),HNSW 是常见选择之一。数据上亿、内存只够存原始向量,IVF_FLAT 更现实。
两个参数直接换来速度与召回的此消彼长。HNSW 的 ef 是查询时的候选集大小,越大召回越高、越慢;IVF_FLAT 的 nprobe 是查询时扫描的簇数,越大召回越高、越慢。nlist 决定簇的粒度,过大则每簇太小、过小则扫描成本高。
在典型配置下,调整参数可影响查询范围与召回率。电商商品向量的高精度检索常用 IVF 系列,内部知识库问答常用 HNSW,差异就在数据体量。
两个常见误区
第一个误区,只看查询速度不看召回率。压到 5 毫秒但 recall 0.6,召回的答案偏离真实近邻,速度快没有价值。
第二个误区,建完索引不随数据增长调参。数据量大幅增长后,原来的 nprobe、ef 可能不再适配,召回可能下降、延迟可能上升,需要重训或调参。数据分布一旦漂移,比如新增了一类文档,旧簇中心也会失效,索引不是一劳永逸。
小艾智能体里的索引实践
小艾智能体的文档处理引擎可选用 Milvus(Zilliz 开源向量数据库)存储向量,可支持 HNSW、IVF_FLAT 等多种索引,可根据数据规模灵活配置,切换算法通常无需改动业务代码。文本经 BGE-M3(北京智源研究院发布)模型可转为 1024 维向量写入 Milvus:知识库规模小、要高质量问答时可配置 HNSW;文档量持续扩张、内存受限时可切换 IVF_FLAT,通常调整一项配置参数即可完成。
这套设计有助于检索模块随业务增长逐步演进,研发团队可更专注于知识抽取与问答质量,减少底层索引的制约。
向量索引没有通用的优解,只有与你的数据规模、内存预算、召回要求相匹配的那一档。先量数据体量,再定索引类型,最后随增长持续调参,有助于保持检索性能稳定。


 扫一扫


 1011

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


