Kimi K3 vs GLM-5.3 vs DeepSeek V4-Pro:2026 年 Q3 三大旗舰模型深度测评

GLM 5.3 Flash前瞻:大模型轻量化、加速推理与本地部署实战 在人工智能领域,大语言模型(LLM)的推理速度和部署成本已成为影响其广泛应用的关键因素。其核心原理在于通过Transformer架构处理序列数据,而模型量化、注意力机制优化等技术能显著提升其工程效率。这些技术的核心价值在于降低计算资源消耗和显存需求,使高性能模型能在消费级硬件上运行,从而降低AI应用门槛。典型的应用场景包括需要实时交互的对话系统、高并发API服务以及本地快速原型开发。本文围绕GLM模型家族的演进,深入探讨了其可能推出的“Flash”轻量化版本所涉及的**模型量化**与**FlashAtten 阅读详情

发布日期:2026-08-20 | 适用人群:AI 开发者 / 产品选型团队 / 模型研究者 | 数据来源:各平台官网及官方发布公告(2026-08-20)

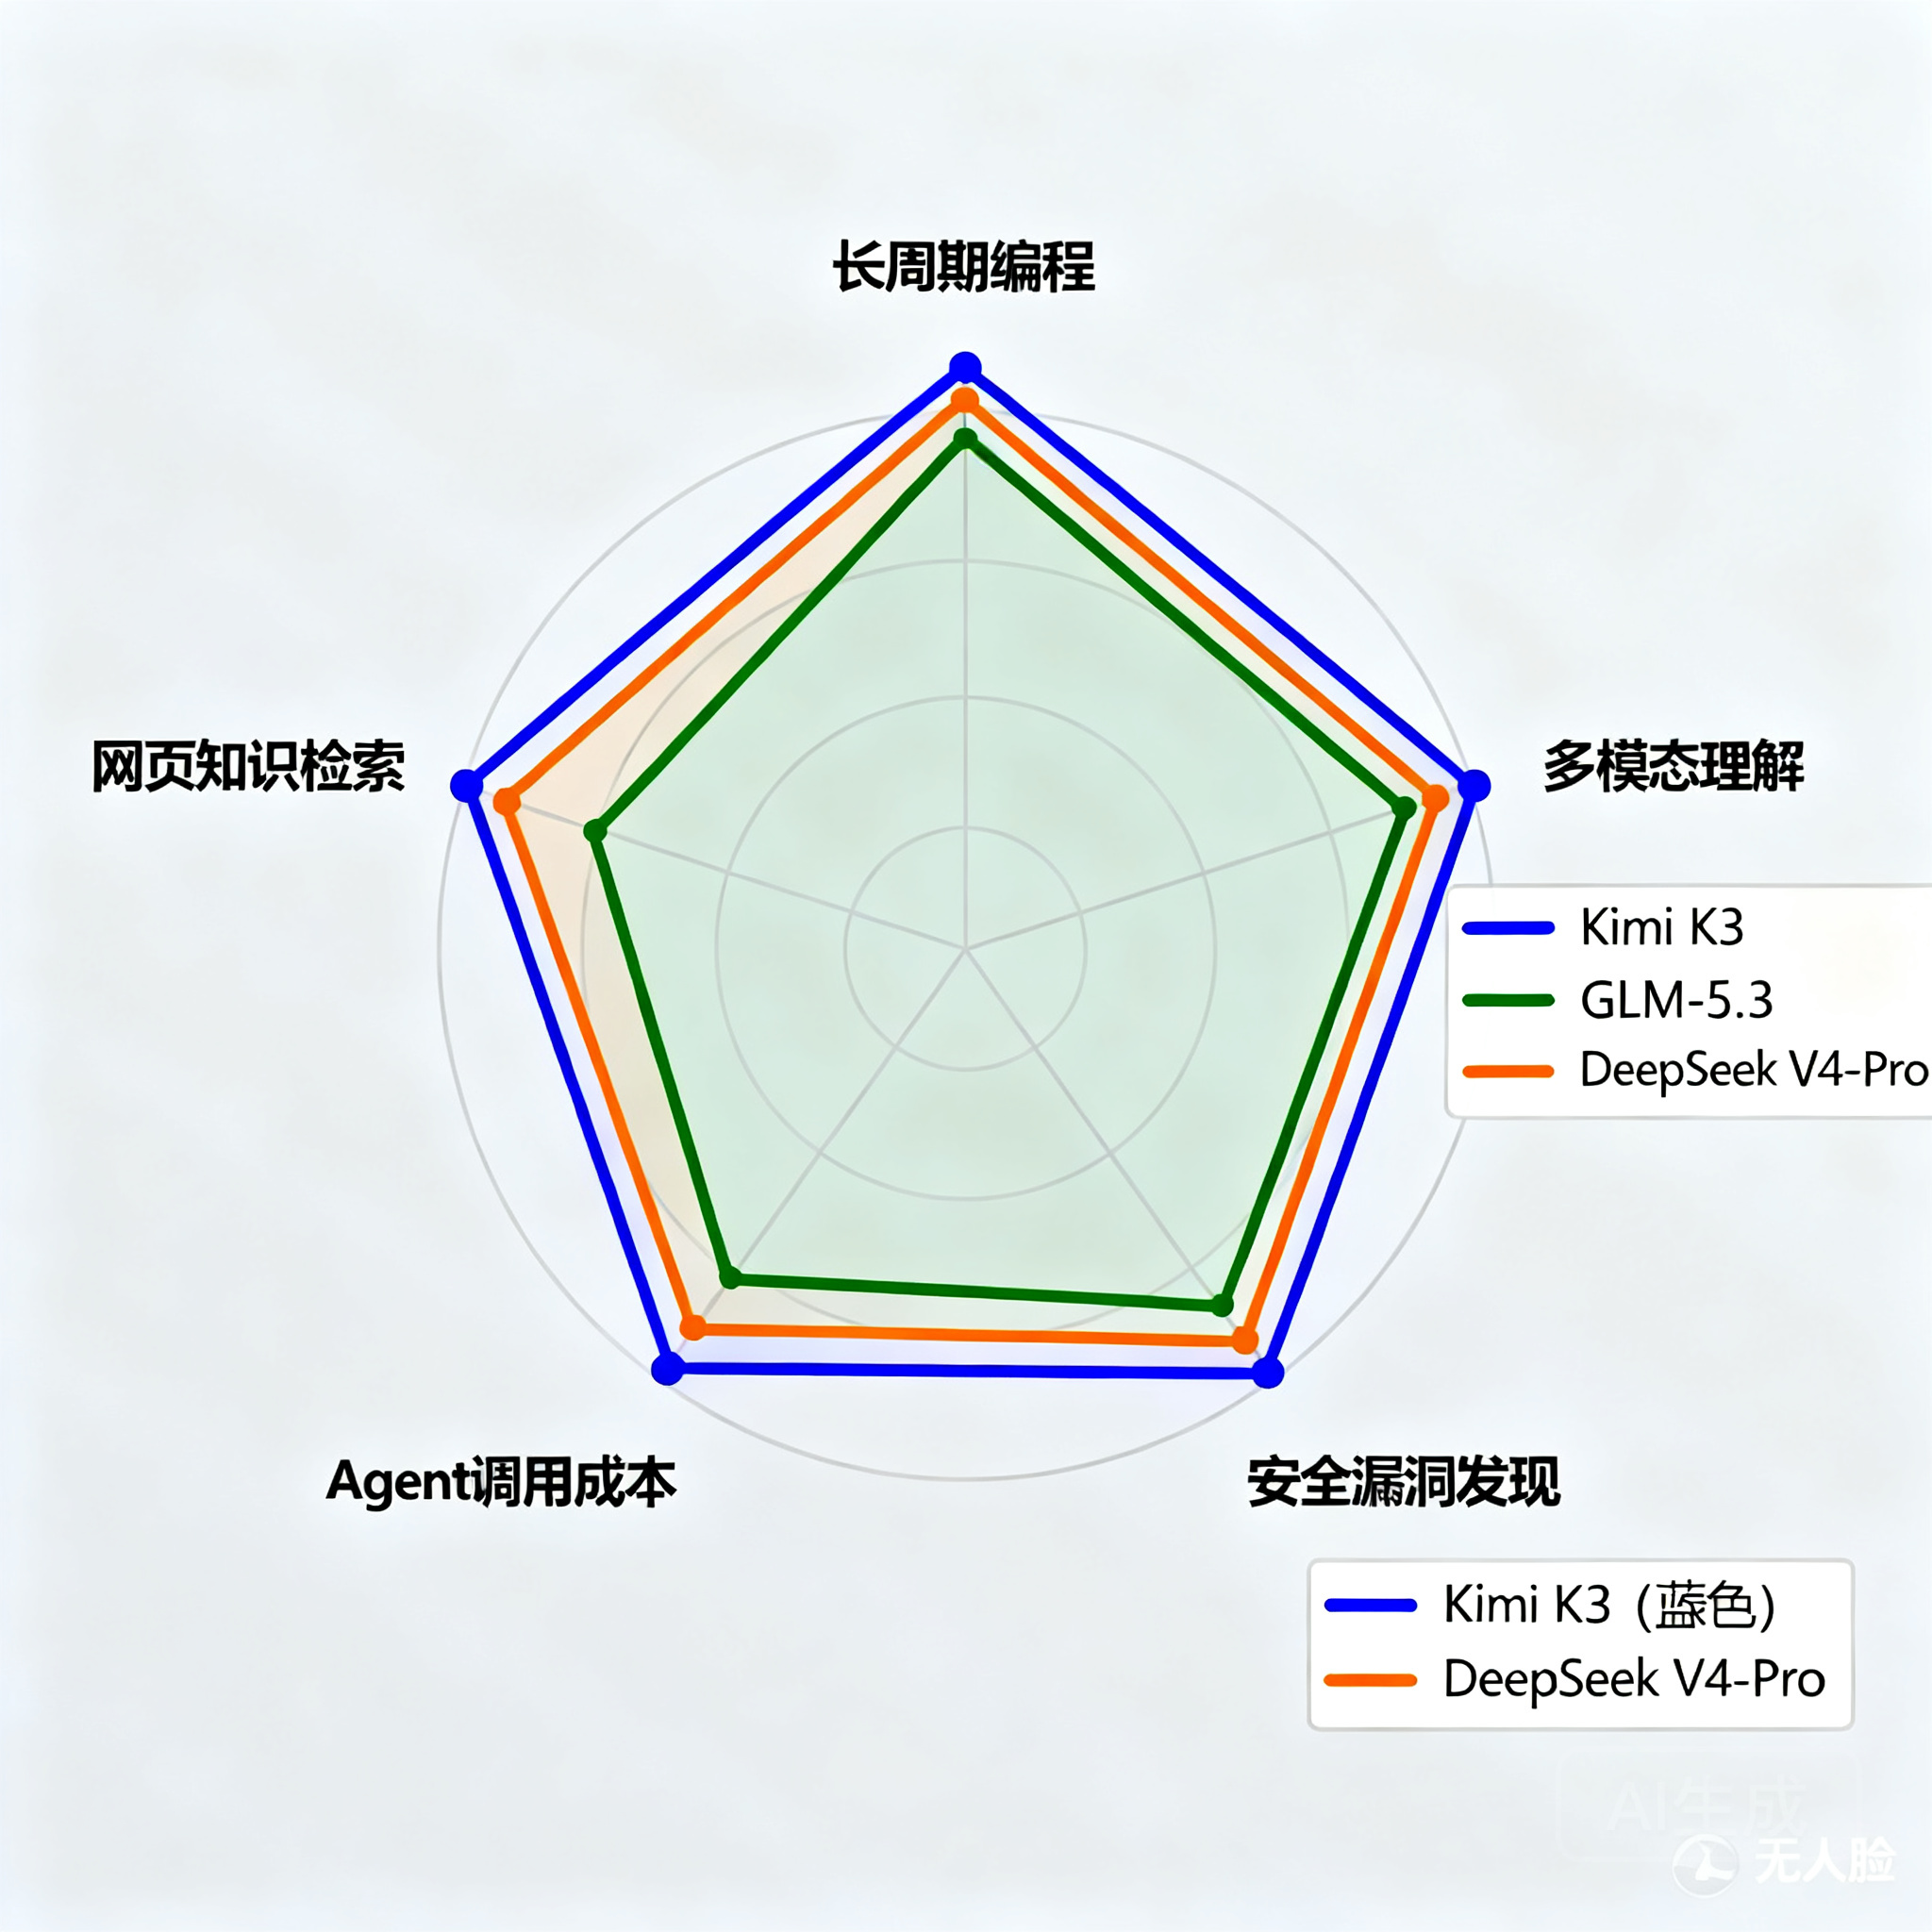
2026 年 8 月是国内大模型旗舰竞争最激烈的月份之一。Kimi K3(2026-07-17 发布,2.8 万亿参数)以 BrowseComp 90.4 和 DeepSWE 67.3 宣示长周期编程与知识工作的新基准;GLM-5.3(2026-08-14 发布,7530 亿 MoE 参数)以极致后训练 Scaling 实现能力跃升 50%,在 CyberGym 安全漏洞发现上登顶第一;DeepSeek V4-Pro(2026-08-13 正式版)引入三档推理强度和峰谷定价机制,原生支持 Responses API,正面对标 Agent 生产场景。三款模型均采用 1M token 上下文窗口,均支持 MoE 稀疏架构,但在能力重心、定价策略和场景适配上走向截然不同的三条路。本文基于官方文档和官方发布公告(2026-08-20 实时数据),完整呈现三款模型的核心参数、基准表现、定价对比与选型建议。


三大旗舰模型核心参数一览

维度Kimi K3GLM-5.3DeepSeek V4-Pro
发布时间2026-07-172026-08-142026-08-13(正式版)
参数规模2.8 万亿(MoE)7530 亿(MoE)未披露
上下文窗口1M tokens1M tokens1M tokens
最大输出未披露128K tokens未披露
推理强度控制low / high / maxlow / high / maxlow / high / max
多模态文本 + 图片 + 视频仅文本仅文本
开源状态权重 2026-07-27 开放两周后开放已开源(HuggingFace/ModelScope)
API 协议OpenAI 兼容OpenAI 兼容OpenAI 兼容

Kimi K3:2.8 万亿参数,长周期工程任务的新标杆

Kimi K3 是月之暗面(Moonshot AI)于 2026 年 7 月 17 日发布的旗舰模型,参数规模 2.8 万亿,采用 896 个专家中激活 16 个的 MoE 稀疏架构,被官方描述为"世界首个开源 3T 级模型"。

架构与技术特点

  • Kimi Delta Attention(KDA):新型注意力机制,提升长上下文处理效率
  • Attention Residuals(AttnRes):与 KDA 配合,降低长序列推理的注意力衰减
  • 1M token 上下文:支持超长文档、代码库、视频内容的统一输入
  • 原生视觉能力:原生支持文本、图像、视频多模态输入,无需外挂视觉适配器
  • 整体扩展效率提升约 2.5×(相比 Kimi K2,官方数据)

基准测试表现

基准Kimi K3 表现
DeepSWE(软件工程)67.3(mini-SWE-agent harness,官方排行榜)
BrowseComp(网页理解)90.4(无上下文压缩时)
内核优化任务与 Claude Fable 5 相当,大幅优于 GPT 系列旗舰
整体综合能力仍落后于 Claude Fable 5 和 GPT 5.6 Sol

Kimi K3 的差异化优势集中在长周期工程场景:可持续进行长时工程会话、在 GPU 内核优化任务(AttnRes、KDA、MLA)上与顶流比肩、自主构建 MiniTriton 编译器实现 Triton 对等性能、48 小时内完成 4mm² 芯片设计(8,700+ tokens/s)、支持 120+ 轮次递归自我改进的研究报告生成。

API 接入与定价

Base URL:https://api.moonshot.cn/v1
Model:kimi-k3
费用类型价格
输入(缓存未命中)$3.00 / MTok
输入(缓存命中)$0.30 / MTok
输出$15.00 / MTok

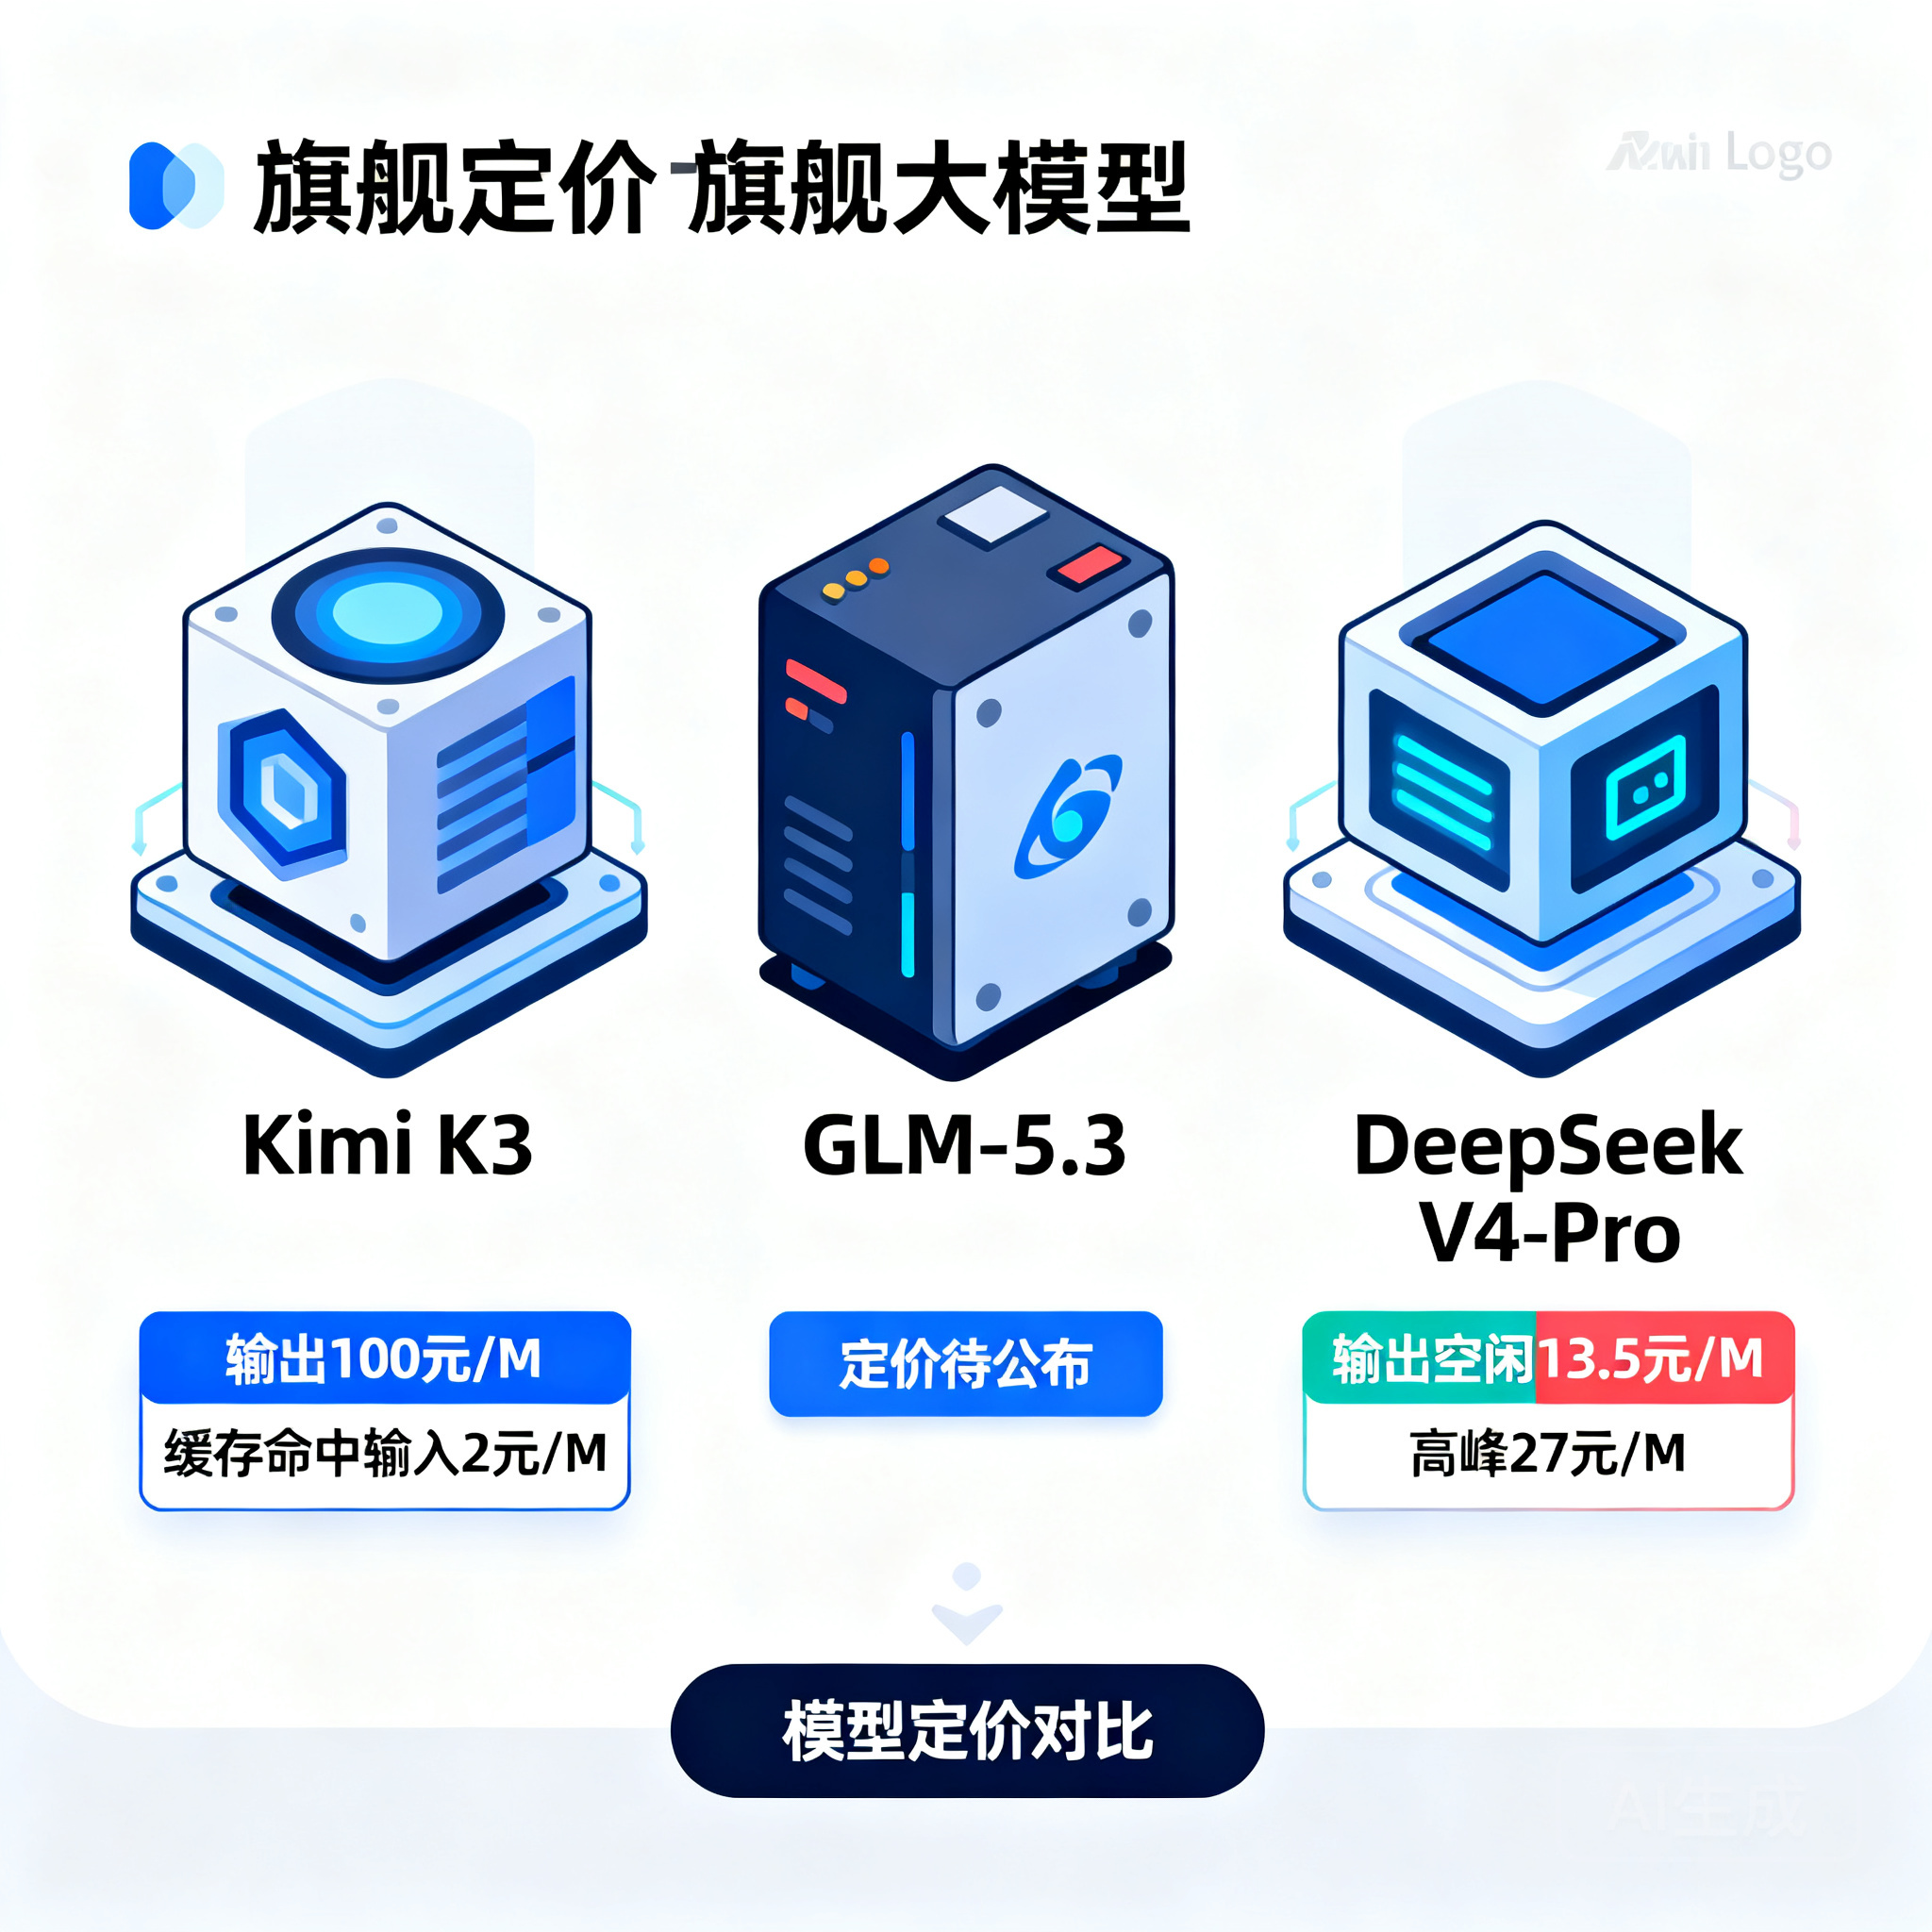
缓存命中后输入价格降至 $0.30/MTok(降幅 90%),是三款模型中缓存收益最显著的一个。人民币定价参考平台定价页:输入(未命中)20 元/M,输入(命中)2 元/M,输出 100 元/M。


GLM-5.3:后训练 Scaling 的能力跃升,安全漏洞发现登顶

GLM-5.3 是智谱 AI 于 2026 年 8 月 14 日发布的旗舰模型,参数规模 7530 亿(MoE),基座模型与 GLM-5.2 完全相同。能力跃升来源是"极致后训练 Scaling"——官方表述为"数十倍的长程任务环境训练",重心放在编程能力和网络安全漏洞发现两个方向。

架构与技术特点

  • 后训练 Scaling 驱动:基座不变,通过后训练实现能力跃升约 50%,路线与加大预训练参数不同
  • 强制推理(thinking always on):推理功能无法关闭,支持 low / high / max 三档强度,默认 max
  • 1M 上下文 + 128K 最大输出:是三款模型中唯一明确标注最大输出长度的
  • 纯文本:当前版本不支持图片/视频输入

基准测试表现

基准GLM-5.2GLM-5.3对比
Terminal-Bench 3.04.628.3+515%
DeepSWE v1.146.2%66.9%+44.8%
CyberGym(安全漏洞)77.2%84.5%(第一)+9.5%
ExploitBench(漏洞利用)24.4%54.4%+123%
Z.ai Code Bench(Max)23.4%34.5%+47.4%

GLM-5.3 在 CyberGym 评测中累计发现 2436 个漏洞,登顶排行榜第一位;Terminal-Bench 3.0 从 4.6 跃至 28.3 是三款模型中涨幅最大的单项基准改善。编程能力被多家媒体测评描述为"追平 Claude Fable 5"。

API 接入

端点:https://open.bigmodel.cn/api/paas/v4
Model:glm-5.3

官方文档暂未公开具体 API 定价,建议访问 bigmodel.cn 定价页确认。功能支持:Function Calling、流式输出、结构化输出、上下文缓存。

在这里插入图片描述

DeepSeek V4-Pro:正式版强化 Agent 能力,峰谷定价重塑成本结构

DeepSeek V4-Pro 于 2026 年 8 月 13 日正式发布(预览版为 2026 年 4 月 24 日),正式版相比预览版的最大变化是 Agent 能力的显著增强,以及三档推理强度(low/high/max)和峰谷定价机制的引入。

核心更新(正式版 vs 预览版)

维度V4 预览版(4月24日)V4-Pro 正式版(8月13日)
Agent 能力基础大幅增强,生产环境表现提升显著
推理档位未提及low(简单任务)/ high(日常 Agent)/ max(高复杂)
Responses API未提及原生支持(适配 Codex)
定价机制旧价格峰谷双轨,空闲为高峰半价

定价(元 / 百万 Token,2026-08-17 起生效)

类型V4-Flash 空闲V4-Flash 高峰V4-Pro 空闲V4-Pro 高峰
输入(缓存未命中)1.53.04.59.0
输入(缓存命中)0.050.100.150.30
输出4.59.013.527.0

高峰时段:北京时间 9:00–12:00 及 14:00–18:00,其余为空闲时段(价格为高峰半价)

V4-Flash 并发上限 2500,V4-Pro 并发上限 500。

竞争定位

DeepSeek V4-Pro 在官方发布时强调针对 Claude Code、OpenCode 等主流 Agent 产品做了专项优化,内部反馈"Agent 任务使用体验优于 Sonnet 4.5"。Responses API 原生支持使其在 Codex 生态中有直接接入优势,无需二次适配。架构层面引入新注意力机制(token 维度压缩 + DSA 稀疏注意力),降低算力与显存需求。


三款模型横向对比:按场景选型

定价对比(人民币,低估场景优先)

模型输出定价(正常/缓存命中输入)适合场景
Kimi K3输出 100 元/M,缓存命中输入 2 元/M高缓存命中率的长文档 RAG、知识工作
GLM-5.3待官方公布编程 / 网络安全专项任务
DeepSeek V4-Pro(空闲)输出 13.5 元/M,缓存命中输入 0.15 元/MAgent 任务、避开高峰的批处理
DeepSeek V4-Flash(空闲)输出 4.5 元/M,缓存命中输入 0.05 元/M大量调用、成本敏感场景

按场景快速选型

场景推荐模型核心理由
GPU 内核 / 编译器开发Kimi K3唯一在此类任务与 Fable 5 相当的开源模型
长周期工程 Agent(>50 步)Kimi K3120+ 轮递归自改进,长会话上下文稳定
网络安全漏洞发现GLM-5.3CyberGym 第一,ExploitBench 54.4%
编程 Agent + 极端速度提升GLM-5.3Terminal-Bench 3.0 涨幅最大(+515%)
多模型切换 + 成本控制DeepSeek V4-Flash空闲时段输出 4.5 元/M,并发上限最高
Codex / Responses API 深度集成DeepSeek V4-Pro原生 Responses API,官方针对 Claude Code 优化
图像/视频多模态输入Kimi K3唯一原生支持视觉输入的旗舰
超长文档 + 高缓存命中率Kimi K3缓存命中输入降 90%,BrowseComp 90.4

基准测试横向对比

基准Kimi K3GLM-5.3DeepSeek V4-Pro
DeepSWE(软件工程)67.366.9%未披露(官方图片形式)
CyberGym(安全漏洞)未披露84.5%(第一)未披露
BrowseComp90.4未披露未披露
Terminal-Bench未披露28.3(+515% vs 前代)未披露
Agent 能力综合领先开源,落后 Fable 5追平 Fable 5(编程专项)优于 Sonnet 4.5(官方)

三款模型各有基准侧重:Kimi K3 在网页理解和长周期任务上有独特优势,GLM-5.3 在安全和编程专项上取得最高分,DeepSeek V4-Pro 的综合基准以图片形式发布,开发者需参考官方原始表格。

在这里插入图片描述

FAQ

Q:三款模型都支持"推理强度"控制(low/high/max),有什么区别?

三款模型均引入了相同名称的推理强度参数,但含义略有差异。GLM-5.3 和 Kimi K3 的推理功能强制开启,low 档在简单任务上可大幅降低耗时和 token 消耗;DeepSeek V4-Pro 的 low 档官方建议用于简单问答,high 用于日常 Agent,max 用于高复杂度推理任务。实际成本差距:max 档 token 消耗通常是 low 档的 3-8 倍,按量计费场景选对档位对账单影响显著。

Q:Kimi K3 的 2.8 万亿参数和 GLM-5.3 的 7530 亿参数,哪个"更强"?

参数量不等于能力。Kimi K3 激活参数(每次推理实际使用)约为 2.8T × (16/896) ≈ 500 亿,GLM-5.3 同样是 MoE 稀疏架构,激活参数规模与总量差距很大。从实际基准来看,两者 DeepSWE 分数接近(67.3 vs 66.9%),但擅长方向不同:Kimi K3 长周期、视觉任务更强;GLM-5.3 安全漏洞发现和终端任务跃升更显著。

Q:DeepSeek 的峰谷定价对我的项目影响多大?

取决于任务时段分布。如果任务可以调度到空闲时段(非北京时间 9:00–12:00 及 14:00–18:00),V4-Pro 的实际输出成本为 13.5 元/M,V4-Flash 为 4.5 元/M;若任务主要发生在工作日高峰时段,成本翻倍。对于可预测的批处理任务(如夜间数据处理、周末报告生成),调度到空闲时段是最直接的降本手段。

Q:GLM-5.3 的定价什么时候会公布?

根据目前官方文档,bigmodel.cn 定价页暂未列出 GLM-5.3 价格,建议定期查看 docs.bigmodel.cn 或关注智谱 AI 官方公告。考虑到 GLM-5.2 的现有定价区间,以及市场竞争压力,预计定价不会超过 Kimi K3 的人民币标价。

Q:这三款模型都开源了,可以本地部署吗?

Kimi K3 权重已于 2026-07-27 正式开放;GLM-5.3 的官方公告提到两周后开放权重(即约 2026-08-28 前后);DeepSeek V4 权重已发布至 HuggingFace 和 ModelScope。但 2.8T 和 7530 亿参数级别的模型对显存要求极高,即使量化版本也需要多卡集群,本地部署适合研究机构和有充足 GPU 资源的企业。


结语

2026 年 Q3 的旗舰模型竞争正在从"谁的基准分最高"转向"谁的场景覆盖最精准"。Kimi K3 以 2.8T 参数和原生视觉能力覆盖最宽的输入模态,在长周期工程任务和网页理解上确立了开源阵营的新高度;GLM-5.3 以后训练 Scaling 实现了编程和安全漏洞发现的集中突破,用更小的基座参数换来了更有针对性的能力跃升;DeepSeek V4-Pro 以原生 Responses API 和峰谷定价直接切入 Agent 生产部署场景,空闲时段的价格竞争力在三款中最突出。选型的关键是任务场景的精确匹配:长周期 + 视觉选 Kimi K3,安全/编程专项选 GLM-5.3,Agent 大量调用 + 成本控制选 DeepSeek V4-Flash/Pro。

数据来源(均为官方渠道,2026-08-20):

  • Kimi K3 发布公告:kimi.ai/blog/kimi-k3 | 定价:platform.kimi.com/docs/pricing/chat-k3
  • GLM-5.3 模型文档:docs.bigmodel.cn/cn/guide/models/text/glm-5.3
  • DeepSeek V4-Pro 正式版公告:api-docs.deepseek.com/zh-cn/news/news260813 | 定价:api-docs.deepseek.com/zh-cn/quick_start/pricing

价格随平台政策变化,购买前请以各官网最新定价为准。


延伸阅读

  • Kimi K3 官方发布公告:https://www.kimi.ai/blog/kimi-k3
  • GLM-5.3 模型文档:https://docs.bigmodel.cn/cn/guide/models/text/glm-5.3
  • DeepSeek V4-Pro 正式版公告:https://api-docs.deepseek.com/zh-cn/news/news260813
  • DeepSeek 定价页:https://api-docs.deepseek.com/zh-cn/quick_start/pricing
  • 七牛云大模型广场(统一 API Key 接入多模型,含 Kimi/DeepSeek/GLM):https://www.qiniu.com/ai/models
Codex原生支持GLM-5.3 Flash与Kimi K3:企业级AI编程基础设施落地指南 代码补全模型是现代IDE智能开发的核心能力,其本质是基于大语言模型的序列生成任务,依赖低延迟推理、精准上下文建模与IDE深度集成。随着开源模型技术成熟,企业不再满足于API调用式接入,而是追求可审计、可嵌入CI/CD、支持私有化部署的生产级AI编程基础设施。GLM-5.3 Flash通过AST节点级微调与硬件感知量化,在4K上下文下实现87ms/token超低延迟;Kimi K3则依托CodeGraph Embedder与本地符号解析器,真正理解代码语义结构。二者在Codex中‘原生支持’,标志着从模型调用 阅读详情

相关推荐

Gazebo仿真平台模型搭建与修改

ROS里踩过的坑(一)Gazebo仿真平台模型搭建与修改文件讲解Models 文件World文件Launch文件模型编辑可视化编辑配置文件编辑模型展示如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出...

Redglass的博客 1万+

有没有一个订阅就能用多家 AI 模型的服务?在 Claude Code 里切 GLM-5.3、DeepSeek V4、Kimi K3 的三条路(2026 年 9 月实测)

有,而且不止一种。想在同一个 Claude Code 里按任务换模型,2026 年 9 月有三条路:① 去各家开放平台分别开户,每家现在都给了 Anthropic 协议兼容端点,改环境变量就能接;② 用本地切换工具管多份配置;③ 用聚合网关,一个 Key、一份包月额度,对话里一句/model切换。:用量集中在一两家、追求最低单价的,选①;已经有各家 Key、只是嫌手改 JSON 麻烦的,选②;一天里要在三四家之间来回切、不想管多个账号多份账单的,才值得选③。

qq_23829681的博客 308

基于STM32的最简易蓝牙遥控小车

基于STM32的蓝牙遥控小车,基于HAL库编写代码,具有移动功能,读者可自行添加其他扩展功能。按下状态的对应关系:2前进,4左转,5停止,6右转,8后退,松开状态都是5,都选择16进制。首先按照小车的图纸把小车的机械部分装好。做这个小车的成本在200元左右,包括焊接设备,杜邦线等。

weixin_43469377的博客 1万+

一把 Key 跑通 MiniMax M3 / Kimi K3 / DeepSeek V4 / GLM-5.3:国产编程模型实测与路由实战

四款模型没有一个能在所有场景通吃。GLM-5.3 是当下开源编程基准的第一梯队,Kimi K3 综合能力和工具调用最强但价格高一档,DeepSeek-V4-Pro-0813 胜在协议宽松和生态开放,MiniMax M3 是百万上下文里最省钱的选择。它们与海外旗舰的差距已经缩小到几分之内,而价格只有对方的几分之一到十几分之一。评测数据全部来自各厂商 2026 年 8 月至 9 月发布的模型卡,横向数字受评测框架影响,正式选型前建议用自己的仓库和真实任务复测一遍。

vibecoding77的博客 1385

【Docker】搭建一个媒体服务器插件后端API服务 - MetaTube

本教程基于群晖的NAS设备DS423+的docker功能进行搭建,DSM版为 7.2.1-69057 Update 5。MetaTube是一个媒体服务器插件,主要用于Emby和Jellyfin媒体服务器。它的主要功能是从互联网上抓取内容并响应 JSON 数据,然后通过预安装的 MetaTube 插件请求服务器并下载相应的元数据,以与 Jellyfin/Emby 服务器配合使用。使用 MetaTube 的步骤大致如下:部署后端:首先,需要部署一个名为​ 的后端 API 服务器来抓取内容。

小小笔记大大用处 1万+

在Windows 11上用VirtualBox搞定WRF-Hydro 5.2.0:一个水文模型小白的Ubuntu 22.04虚拟机避坑实录

本文详细记录了在Windows 11上使用VirtualBox和Ubuntu 22.04虚拟机成功编译安装WRF-Hydro 5.2.0水文模型的全过程。从虚拟环境配置、依赖库安装到环境变量设置,作者分享了针对Linux新手的实用避坑技巧和关键命令,帮助科研人员高效完成水文模型的环境搭建。

weixin_30733003的博客 348

智谱 GLM-5.3-Flash 深度解析:首个原生多模态 GLM-5 模型,视觉 Coding + 1M 上下文 + 国产芯片推理

极致低成本架构:320B 总参/18B 激活,首个稀疏+线性混合注意力架构,注意力成本相比旗舰版降低 3-4 倍

Rob__的博客 1071

贝塞尔曲线原理--曲线生成--路径规划--matlab代码

贝塞尔曲线有着很多特殊的性质, 在图形设计和路径规划中应用都非常广泛, 在路径规划中贝塞尔曲线完全由其控制点决定其形状, n个控制点对应着n-1阶的贝塞尔曲线,并且可以通过递归的方式来绘制.

bob595078694的博客 1万+

60分的Kimi K3 表现如何?和GLM-5.3、DeepSeek V4 Pro的7组实测对比

【摘要】国产大模型Kimi K3智能分突破60分,追平GLM-5.3,接近GPT-5.6 Sol,但实际选型需结合能力、速度和成本三维度。K3在长文档解析(1.05M上下文)和深度推理上表现突出,但速度较慢;GLM-5.3以85 token/秒的速度成为实时交互首选;DeepSeek V4 Pro则以0.05美元/百万token的极致性价比适合批量任务。业务场景建议混合调用:聊天用GLM-5.3,文档分析用K3,批量处理用DeepSeek。国产模型在价格和落地应用上已具备显著优势。

scarry2026的博客 671

YOLO26改进策略【Neck】| CVPR2025 LCA轻量交叉注意力 跨层级双向引导 + 分层降噪增强,提升微小目标特征表达

简单相加、拼接融合无法建立深浅层双向约束关系,浅层微小目标易被深层背景覆盖,深层全局信息难以修正浅层噪声;普通单路自注意力仅单一层内建模依赖,缺少跨层级特征互引导机制,深浅特征信息割裂;标准多头跨注意力计算量大、参数量高,轻量化单模态检测/分割网络部署困难,无法区分前景目标与背景噪声。为此设计单模态轻量化交叉注意力LCA,构建浅层细节、深层语义双分支双向引导结构,轻量完成跨层级特征交互,同步降噪并强化单模态微小目标特征。

Limiiiing的博客 508

tun虚拟网卡没有安装解决之道

目录 描述 过程 一、sstap 会提示你虚拟网卡没有安装; 二、还有会是这样的:病毒和威胁防护中无法启动;引擎不可以用等等,以及会显示需要IT管理员去处理;等等报错的信息; 系统升级地方会显示:Windows Defender Antivirus 的安全智能更新 - KB2267602 (版本 1.305.2147.0) - 错误 0xc8000442 Windows Defender报错; 三、还有就是会出现你搜自己家的WIFI搜不到,电脑端都不会显示WIFI名字; 解决方...

战神/calmness的博客 1万+

GLM 5.3 硬刚 Kimi K3:不换基座的极限压榨,能否打赢 3 万亿参数的新王者

GLM-5.3 和 Kimi K3 的这场对决,表面看是 66.9 对 67.5 的毫厘之争,实质是两种工程路线的正面验证:Kimi K3 用 2.8 万亿参数的新基座买来了原始智能上限,GLM-5.3 则证明了后训练 Scaling 的性价比和可复制性——在不换基座的前提下,把与 K3 的能力差距基本抹平,同时保住了快 3 倍的速度和低 2.8 倍的成本。两条路线殊途同归地把国产开源模型推到了世界编程能力的第一梯队边缘——都逼近 Claude Fable 5,都还差临门一脚。

JEECG官方博客 821

lammps案例:堆垛层错能的计算

大家好,我是小马老师。 本文介绍如何使用lammps计算晶体的堆垛层错能。 正常晶体中的原子按照一定的规律排列,原子面按ABCABC……的顺序排列,如下图所示: 当某个原子面被抽出后会形成堆垛层错,如图中的蓝色原子层被抽出,原子面排列变为ABCBCA……: 可通过计算堆垛层错能形成前后的能量差计算堆垛层错能,计算公式为: E0为初始能量 Ef为删除一个原子面后的能量 A为界面面积 下面分享一个lammps计算堆垛层错能的in代码,本代码由Richard Glaze完成,本文稍作修改并进行了注释,以供初

lammps_jiayou的博客 5428

【AI总结】2026年6月 主流国内外大模型总结

自2022年ChatGPT引爆生成式AI浪潮以来,全球大模型行业进入高速迭代周期。海外科技巨头依托先发优势持续夯实通用大模型底座,国内大厂立足中文场景、国产化算力与行业落地需求,快速补齐技术短板,形成了国内外双线并行、差异化竞争的行业格局。对于开发者、AI从业者以及普通用户而言,市面上大模型版本繁杂、配套Agent工具更新频繁,很难快速厘清各家产品迭代脉络与生态布局。

AlienProgrammer的博客 6662

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

【Reading Notes】(10.3)Favorite Articles from 2026 March

是目前很受国内欢迎的国产开源 AI 桌面客户端,它把 DeepSeek、Claude、Gemini、Ollama 等 300+ 模型一键接入,还原生支持 OpenClaw(小龙虾)快速安装,让你几分钟内就能拥有一个“有灵魂”的持久 AI 伙伴——它会记住你是谁、怎么说话、有底线,还能定时干活、管日程、写代码。他展示了一个实验室管理系统,包括数据分析、实验管理、采购等功能。2)网络安全,就是行业笑话:你以为你是在玩AI,其实,你是把GitHub、Slack、邮箱、API key、数据库的全部钥匙,都给了它。

bryant_meng 1041

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

GLM Coding(GLM 5.3)与 Kimi K3 的能力、价格与实战性价比全对比

最后把结论收拢成三句话。如果你的需求是"AI 帮我快速写代码"——单文件、单功能、追速度,GLM Coding 已经非常优秀,Lite 档完全够用,它的响应速度至今仍是国产第一梯队。但如果你的目标是"让 AI 参与真实企业项目开发"——维护几十万行的 Java + Vue 存量代码,那么Kimi K3 当前综合性价比明显更高。

JEECG官方博客 440

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

GLM-5.3-Flash基准测试全面解读:Coding与Agent能力距Claude Opus 4.8还有多远?

本文带你快速读懂 **GLM-5.3-Flash 基准测试**:这款智谱 GLM-5 系列首个**原生多模态**大模型(320B 总参数 / 18B 激活参数)在 Coding 与 Agent 基准测试中的表现究竟如何,与 Claude Opus 4.8 的差距到底还有多远,以及新手如何以约 1/10 的成本把它用起来。 ## 30秒看懂:GLM-5.3-Flash 是什么? GLM-5.3-

gitblog_00279的博客 615

智谱GLM-5.3 vs Kimi K3:2026-10-08深度对比分析:中文Agent生态...

最新版本:GLM-5.3(2026年9月24日发布)核心参数:7450亿参数、440亿激活MoE、200K上下文、原生视觉编码能力技术架构:基于清华大学KEG与智谱AI联合研发的自回归空白模型特色功能:支持1M无损上下文(GLM-5.2),针对长程Coding Agent强化训练生态绑定:ZCode、GLMCoding开发工具链企业服务:智谱Maas企业版提供私有化部署与模型微调能力。

417

跃升50%,与Kimi K3 并列第一!智谱GLM-5.3能力比肩Claude Fable 5?

GLM-5.3进入全球前沿模型能力区间,与 Claude Fable 5、GPT-5.6 Sol 等闭源旗舰模型处于同一水平(GPT-5.6 Sol 得分 61分 , Claude Fable 5 得分 62 分 ),与 Kimi K3 并列开源模型第一。它的综合能力是否真神?

suanlix的博客 563

GLM-5.3-Flash:真牛来,一折买进全球第8!

智谱这张 Flash 先以"牛来"(Ox-Alpha)的匿名身份当了一周调用量冠军,认领后亮出价格:输入 0.8 元、输出 2.8 元,正好是旗舰 5.3 的十分之一,分数却反超了自家上代旗舰 5.2。本文先用 AA 智能指数、Terminal-Bench 2.1 两份第三方榜单把成绩对齐,再逐项算 API 账、部署账与战略账。

792

GLM-5.3-Flash深度解读

智谱 GLM-5 系列的首个原生多模态模型,总参数 320B、激活仅 18B。它用「极低成本架构」打出了超越 GLM-5.2 的更强智能:Coding/Agent 基准逼近 Claude Opus 4.8,API 价格却只有旗舰的约 1/10,权重 MIT 开源,官方已在国内自研加速芯片集群上规模化跑通。本文从架构、基准、成本、部署到真实体验,完整拆解这款「前沿性能、Flash 成本」的模型。

缘友一世的博客 1827

从GLM-5.3到DeepSeek V4 Flash,后训练正在改写游戏规则

2026年8月,AI圈经历了一场密集的“模型雨”:· 8月1日,DeepSeek V4 Flash正式版API上线(小参数,激活仅130亿);· 8月13日,DeepSeek V4 Pro正式版转正(1.6万亿参数旗舰);· 8月14日,智谱发布GLM-5.3(参数与GLM-5.2完全一致,仅后训练优化);· 8月15日,阿里开源Qwen3.8-27B(270亿参数的稠密小模型)。但最反常的信号是:所有“小模型”都在疯狂逆袭,而旗舰要么没露面,要么令人失望。

lck5602的专栏 144

GLM-5.3-Flash 私有化部署全流程:vLLM + 昇腾 NPU 从下载到跑通

当智谱把 GLM-5.3-Flash 的权重以 MIT 协议开源时,社区立刻注意到两件事:一是这是 GLM-5 系列首个原生多模态模型,320B 总参数 / 18B 激活参数,编程与 Agent 基准直逼 Claude Opus 4.8;二是它把 **稀疏注意力与线性注意力(KDA)做进了同一个 45 层架构里**——这意味着传统的"下载即跑"经验在它身上全部失效,部署复杂度比同规模 Dense

gitblog_00449的博客 220

DeepSeek V4 Pro vs Kimi K3:国产大模型2026巅峰对决,开发者选型指南

2026年7月,国产大模型迎来关键对决:月之暗面发布KimiK3与DeepSeekV4Pro正面竞争。两款模型在编程能力(分别刷新FrontierSWE和LiveCodeBench记录)、API价格(10倍价差)和开源策略上形成鲜明对比。技术架构上,DeepSeek采用高效MoE+MLA设计(1.6T参数/49B激活),主打性价比;KimiK3以2.8T参数的Dense架构实现更强多模态能力。实测显示:KimiK3在复杂前端任务中表现稳定,DeepSeekV4Pro则在算法题和批量处理中更具成本优势。

小二丶的博客 2007

DeepSeek V4 Pro 对比 Kimi K3:实测设计和开发场景,谁更顺手?

从设计到开发的衔接来看,对研发团队来说,AI 生成 UI 只是第一步,关键是让设计结果能快速进入代码阶段。国产工具对国内企业的设计场景理解更深,像后台管理、电商平台、企业办公软件这些,国内团队做得最多,工具也更贴合实际。界面生成这块,传统流程里设计师拿到需求,得先分析业务目标,再规划页面结构、搭建组件、做视觉设计,很依赖经验,也花时间。这对设计开发结合的场景挺重要,设计师用 AI 工具生成 UI 后,开发者可以让 AI 理解设计稿结构,直接生成前端代码,还能结合现有组件库往下走。

ndsc_d的博客 320

GLM-5.3:国产模型跻身第一梯队,AA 智能指数 60 分、1M 上下文仅 $1.4/1M

智谱 GLM-5.3 在 Artificial Analysis 独立评测中拿到 60 分、并列开源模型第一,定价却仍是中端水平。但 '非常啰嗦' 的评测备注暴露了隐性成本——这篇文章拆解智能、价格、verbosity 之间的真实关系。

字与码 1120
上一篇: DFlash 2 是什么:并行草稿如何让大模型推理提速 2.7-4.6 倍
下一篇: Codex 总是重连 5/5?一文搞懂原因与修复顺序
七牛云行业应用
博客等级 码龄7年 716粉丝 555原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值