Erasure Coding(纠删码)深入分析 转

1.前言

Swift升级到2.0大版本后宣称开始支持纠删码,这其实是一个很有意义的特性,主要是能够在一定程度上解决3副本空间浪费太多的问题。因为3副本这一点是swift推广的最大障碍之一,成本的增加吓退了不少潜在客户。这次的改进有望消除客户顾虑,拓展更多用户

http://www.openstack.org/blog/2014/07/openstack-swift-2-0-released-and-storage-policies-have-arrived/


而回到存储领域来看,数据冗余机制其实这几十年来没有太多进展,RAID,副本一直是当仁不让的最终选择。而近几年,尤其是规模较大的应用场景下,纠删码越来越多的出现在选择的视野范围,成为RAID,副本之外的第三种选择,因此也获得了越来越多的关注。

纠删码(Erasure Code)本身是一种编码容错技术,最早是在通信行业解决部分数据在传输中损耗的问题,它的基本原理是把传输的信号分段,加入一定的校验再让各段间发生一定的联系,即使在传输过程中丢失掉部分信号,接收端仍然能通过算法把完整的信息计算出来。

如果严格的区分,实际上按照误码控制的不同功能,可分为检错、纠错和纠删三种类型。检错码仅具备识别错码功能 而无纠正错码功能;纠错码不仅具备识别错码功能,同时具备纠正错码功能;纠删码则不仅具备识别错码和纠正错码的功能,而且当错码超过纠正范围时,还可把无法纠错的信息删除。

前面曾提到过适用场景通常是大规模部署,这是有其缘由的。从传统情况来看,RAID通常用在企业级环境里较多,在几台和十几台存储设备规模的IT系统中,一向是使用稳定可靠历经数十年磨砺的RAID技术。而在数据中心级的大规模部署中,RAID不再受欢迎,大部分的分布式系统都偏好副本模式,看重的是其高可靠性和读性能优化的特点(关于副本的讨论我之前写过一篇:为啥大家都喜欢3副本,是拍脑袋的吗?http://blog.sina.com.cn/s/blog_57f61b490101a8ca.html)。然而副本带来的成本压力实在是有些吃不消,这时候Erasure Code适时出现,以更低成本和更高技术含量提供近似可靠性这几点,就吸引到了众多分布式存储/云存储的厂商和用户。


2. 纠删码理论分析


纠删码常见的有三类,Reed-Solomen类,级联低密度纠删码和数字喷泉码,后面两种的实现原理细节和优劣这里就不深入了,这里只简单介绍下目前在存储行业应用的Reed-Solomen类纠删码。

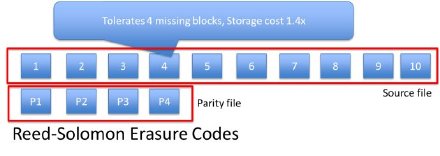
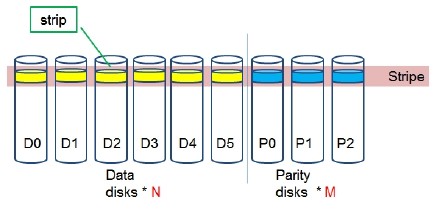
从纠删码基本的形态来看,它是N个数据+M个校验的结构,其中数据和校验的N和M值都能够按照一定的规则设定。在1~M个数据块(数据或校验都行)损坏的情况下,整体数据仍然可以通过计算剩余数据块上面的数据得出,整体数据不会丢失,存储仍然是可用。

         下面是纠删码的结构示意图。
         说明: C:\Users\Administrator\AppData\Roaming\Foxmail7\Temp-3940-20150121093525\Catch.jpg

从图中其实可以看出,纠删码和大家熟悉的RAID技术看起来是有些类似的,一个条带(Stripe)是由多个数据块(strip)构成,分为数据块和校验块。但与RAID5/RAID6不同的是,纠删码功能上来看最大的区分特点是校验和数据的比例按N+M可调整,并且校验块数量不再受限于两个,典型的如12+4,6+3等等。


校验块和数据之间是如何建立关系的呢?通信理论(鄙人专业)告诉我们纠删码是属于分组线性编码,编码过程用到的数学理论并不高深,数学关系其实是是矩阵乘法。具体来说是用编码矩阵和分块数据做乘法从而得到校验块,如下:
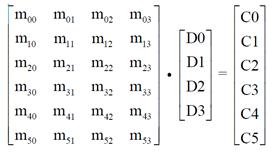
说明: 屏幕截图 2014-04-15 19.03.36

在建立完关联后,由于矩阵运算是可逆,系统就具备了容忍最大M个失效的能力。

(微软曾在一次演示中用两数之和等于第三个数来解释,但仅是为了方便理解,在真正实践的多校验情况下,还是使用编码矩阵的。)

https://www.usenix.org/conference/atc12/technical-sessions/presentation/huang


3. 纠删码的演化,RS->LRC


纠删码通过技术含量较高的算法,提供和副本近似的可靠性,同时减小了额外所需冗余设备的数量,从而提高了存储设备的利用率。但纠删码所带来的额外负担主要是计算量和数倍的网络负载,优缺点都相当明显。尤其是在出现硬盘故障后,重建数据非常耗CPU,而且计算一个数据块需要通过网络读出N倍的数据并传输,所以网络负载也有数倍甚至10数倍的增加。

整体来看,若采用纠删码技术,你能够得到了希望的容错能力和存储资源利用率,但是需要接受一定的数据重建代价,两者间做一个平衡。


难道事情就这个样子了吗?有没有优化改善的空间呢?答案是“有”。

如果仔细分析故障出现的情况,你将很容易发现两个特征:

特征一:所有的故障都将导致同样的重建代价,无论是一个盘,还是M个盘

特征二:单个磁盘故障的几率远远大于多个磁盘同时故障的几率,通常在90%以上


因此,优化的思路自然聚集到更容易出现的单个磁盘故障上来,如何更有效的处理这种概率较大的事件呢,直接出现的对策就是分组,把单个磁盘故障影响范围缩小到各个组内部,出坏盘故障时,该组内部解决,在恢复过程中读组内更少的盘,跑更少的网络流量,从而减小对全局的影响。


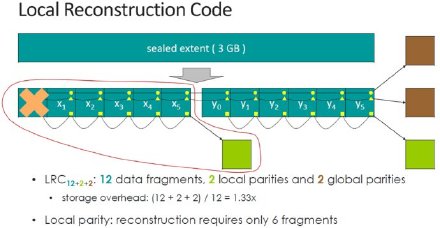
LRCLocally Repairable Codes,我理解为局部校验编码,其核心思想为:将校验块(parity block)分为全局校验块(global parity)、局部校验块(local reconstruction parity),故障恢复时分组计算。
说明: Microsoft、Google、Facebook的erasure <wbr><wbr>code技术进展及系统分析

微软Azure的云存储(Windows Azure Storage)实现为例,它采用LRC(12,2,2)编码,将12个数据块为一组编码,并进一步将这12个数据块平均分为2个本地组, 每个本地组包括6个数据块,并分别计算出一个local parity,之后把所有12个数据块计算出2个global parities。

当发生任何一个数据块错误时,只需用本地组内的数据和校验块用于计算,即可恢复出原始数据。而恢复代价(通过网络传输的数据块数量)就由传统RS(12,4)编码的12,变为6,恢复过程的网络I/O开销减半,同时空间冗余率保持不变,仍为(12+2+2)/12 = 1.33


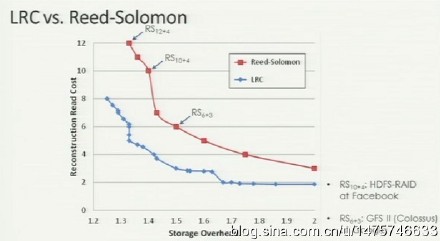
微软在介绍中有过一张图来对RS和LRC进行对比,我觉得描述的非常清楚,这里借用一下
说明: http://s2.sinaimg.cn/mw690/001BS573gy6OLq2vQVH71&690

图中,蓝色是LRC,红色是RS,可以很清楚的看到,使用LRC的编码方式后,虽然空间利用率(横轴)并没有提高,但是重建代价(纵轴)却有明显的改善。考虑到分布式系统里故障是一个常态,重建代价的降低和局部化就是非常有价值的一个技术改进了。


另外,有一点要特别注意,LRC并不是100%不丢数据的,4个块坏掉的情况下,只有86%的几率能找回数据,从可靠性排序来说,RS12+4 》 LRC12+2+2 》RS6+3。


但综合来说,LRC还是很有竞争力的技术,目前,Microsoft、Google、Facebook、Amazon、淘宝(TFS)都已经在自己的产品中采用了Erasure Code,并且大多都从经典RS转向LRC。虽然具体实现,但基本原理都是LRC的组内校验+全局校验。


4. 纠删码的实际案例

我们可以具体来看看在业界,各家优化版纠删码的实现是怎么样的。


Google RS(6,3) in GFS II (Colossus),

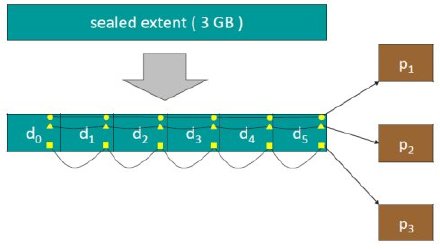
Google在04年发布GFS的经典论文后,09年开始开发第二代GFS(Colossus),它采用了最基本的RS(6,3)编码,将一个待编码数据单元(Data Unit)分为6个数据块, 再添加3个parity block,最多可容包括parity blocks在内的任意3个数据块错误。
说明: Microsoft、Google、Facebook的erasure <wbr><wbr>code技术进展及系统分析

数据恢复的网络I/O开销为:恢复任何一个数据块需要6次I/O,通过网络传输6个数据block,存储的空间冗余率 为(6+3)/6 = 1.5

由于Google的信息能查阅到的有限,我没找到近两年的情况介绍,但相信Google这样一家技术型的公司,应当也有类似的演进后的纠删码技术,不会止步于5年前的RS标准码。


Facebook:从RS(10,4)LRC10,6,5

Facebook早期在HDFS RAID中采用的编码方式RS(10,4)

说明: Microsoft、Google、Facebook的erasure <wbr><wbr>code技术进展及系统分析

如上图所示。将每个待编码的数据均分为10个数据块, 后面添加4个校验的parity校验块。这种RS编码方式的空间冗余率为(10+4)/10 = 1.4x,发生任何一个数据块错误的恢复代价为10,即发生任意一个块错误需要10次I/O操作,从网络传输的数据量为10个数据块。


同样为减少数据恢复的网络I/O代价, FaceBook在13年和加州大学共同发表了论文, XORing Elephants: Novel Erasure Code for Big Data,并把这一成果用在“进阶版HDFS”上

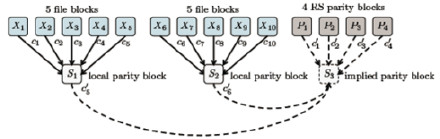
其LRC编码方法如下:
说明: Microsoft、Google、Facebook的erasure <wbr><wbr>code技术进展及系统分析

除了在原先的10个数据块之后添加4个校验块外,还将10个数据块均分为2组,每组单独计算出一个局部校验块(Parity),将数据恢复代价由原来的10降低为5.即恢复任何一个数据块错误只需要进行5次网络I/O,从网络传输5个数据块。此种编码方式的空间冗余率 为(10+4+2)/10 = 1.6。


4. 结论

相对副本而言,纠删码(erasure code)的编码技术无疑对存储空间利用率带来很大提升,但由于引入额外的编码、解码运算,对分布式系统的计算能力和网络都有一定额外的要求,简单的理解就是硬件性能要升级,网络环境也得要升级,升级的代价在目前阶段还是一笔不小的预算。

而由于性能损失的原因,用在本身压力已经很大,很“热”的在线存储系统明显不是很合适,所以目前大多数系统还是把erasure code用于冷数据的离线处理阶段。

LRC编码由于减少了网络I/O传输的数据量,参与数据恢复运算的数据量和重建时间都基本上能够缩短一倍,但却是以可靠性和空间利用率的一定牺牲为代价的。如何更加有效的实现还是要结合实际项目需求,综合考量,有更多的实际工作要做。


转载于:https://www.cnblogs.com/bodhitree/p/6378695.html

HadoopErasure Coding)简介 三副本机制 1、什么是三副本 默认情况下,HDFS会使用三副本机制来保证数据可用性,第一个副本存放在本地机架节点上,另一个副本存放在同一机架的另一个节点上,第三个副本存放在在不同机架的节点上。三副本机制可以减少机架间的数据传输,提高写操作的效率,保证数据的可用性,因为机架错误的概率要小于节点出错的概率 2、三副本带来的问题 三副本会造成存储空间200%的额外开销,还会在其他资源上造成浪费,比如在写数据时会造成额外的带宽消耗。尤其对于冷数据,因为查询的频率很低,第二个和第三个副本很少被访问,却依然占用了同样大 阅读详情

相关推荐

ceph 解读和实践

原理介绍 原理我们就直接引用网上一篇文章: 参考:Ceph的正确玩法之Ceph理论与实践 Erasure Coding,EC)是一种编容错技术,最早是在通信行业解决部分数据在传输中的损耗问题。其基本原理就是把传输的信号分段,加入一定的校验再让各段间发生相互关联,即使在传输过程中丢失部分信号,接收端仍然能通过算法将完整的信息计算出来。在数据存储中,将数据分割成片段,把冗余数据块扩展和编,并将其存储在不同的位置,比如磁盘、存储节点或者其他地理位置。如果需要严格区分,实际上按照误控制的不

zxycyj1989的博客 3614

学习总结 - Erasure Coding (分布式存储系统)

Erasure coding技术简称EC,是一种数据保护技术。最早用于通信行业中数据传输中的数据恢复,是一种编容错技术。他通过在原始数据中加入新的校验数据,使得各个部分的数据产生关联性。在一定范围的数据出错情况下,通过技术都可以进行恢复。 副本策略和是存储领域常见的两种数据冗余技术。相比于副本策略,具有更高的磁盘利用率 多副本策略即将数据存储多个副本(一...

tianyeshiye 4705

hadoop-3.0.0-beta1运维手册(011):HDFS Erasure Coding使用

写在前面的话 Hdfs采用分布式架构,为上层的应用和用户提供可扩展、高吞吐、高可靠的数据存储服务。在整个Hadoop生态系统中,hdfs处于最底层,也是最无可替代的一个基础设施。从2008年hadoop-0.10.1版本开始到现在的hadoop-3.0.0-beta1,hdfs已经走过了近10个年头,其架构和功能特性也发生了巨大的变化。特别是hdfs3.0.0系列,和hdfs2.x相比,增加了基

aishuc的博客 5304

HDFS的EC(Erasure Coding)和块管理

介绍了HDFS的块管理策略,既有基于复制的块管理,也重点介绍了HDFS的的具体实现,主要偏向于代解析,同时还有基于实验对一些问题的解答。

小昌昌的博客 3082

千云物流 - CM安装需要的服务

管理功能描述 Activiti Monitor:收集关于mr服务运行的活动信息,默认情况下不添加此角色,实际生产环境也是不需要的。 Host Monitor:收集有关主机的运行状况和指标信息。 Service monitor:从yarn和impala服务中收集关于服务活动信息的健康和度量信息。 Event Server:聚合组件的事情并将其用于报警和搜索。 Alert Publisher:为特定类型的事件生成和提供报警,实际情况下用的少。 授权目录安装 mkdir -p /var/lib/cloudera-

Hello Word 1001

【存储】什么是EC(与的区别)|与副本对比|LDPC

存储领域来看,数据冗余机制其实这几十年来没有太多进展,RAID,副本一直是当仁不让的最终选择。而近几年,尤其是规模较大的应用场景下,越来越多的出现在选择的视野范围,成为RAID,副本之外的第三种选择,因此也获得了越来越多的关注。 Erasure Code)本身是一种编容错技术,最早是在通信行业解决部分数据在传输中损耗的问题,它的基本原理是把传输的信号分段,加入一定的校验再让各段间发生一定的联系,即使在传输过程中丢失掉部分信号,接收端仍然能通过算法把完整的信息计算出来。如果严格的区分,实..

我的笔记本 1万+

【存储】EC2+1,EC2+2,EC4+1,EC4+2:1分别是什么意思?

简介:技术主要是通过算法将原始的数据进行编得到冗余,并将数据和冗余一并存储起来,以达到容错的目的。将n块原始的数据元素,通过计算(编)得到m块冗余元素(校验块)。也就是n+m份数据通过DHT算法分别存储不同硬盘中。当其中任意的m块元素出错(包括原始数据和冗余数据)时,均可以通过对应的重构算法恢复出原来的n块数据。在这种方式下,空间的利用率约为 n/(n+m),数据的可靠性由 m 值的大小决定,m越大可靠性越高。

我的笔记本 1万+

Minio Erasure Coding

minio 机制 数据冗余性保证

zhnagruihua的博客 3585

深入解析 HDFS 技术 ErasureCoding

HDFS引入技术(EC)作为副本机制的替代方案,显著降低存储开销。EC通过数据分块和校验单元实现冗余,在保持相同容错能力的同时,存储开销从副本机制的200%降至50%以下。HDFS 3.x对NameNode、客户端和数据节点进行了扩展,支持条带化存储和并行读写操作。系统提供多种内置EC策略,管理员可根据集群规模配置策略。EC要求更高的CPU和网络资源,并建议配置足够数量的机架以保障容错。HDFS提供完整的EC管理命令,支持策略设置、启用/禁用等操作。该技术特别适合访问频率低的冷数据存储场景。

pestar的博客 2428

HDFS Erasure Coding 技术详解:取代副本机制的新选择

Hadoop3.x引入技术(EC)替代传统副本机制,通过数据分块和校验编降低存储开销。相比3副本300%的存储空间,RS(6,3)方案仅需150%空间,但恢复速度较慢。EC适合冷数据存储,副本机制适用于热数据访问。该技术大幅提升了存储效率,但会增加计算复杂度和恢复时间,是HDFS在大规模冷数据场景下的经济高效容错方案。

weixin_53520202的博客 1295

erasure coding,EC)技术现状

技术作为大数据时代降低存储开销的核心方案,在RS优化、新型编体系构建和动态适配方面取得显著进展。研究对比了RS、MSR、LRC等方案的特性,并通过Python实现基础RS的编恢复流程。未来将向智能决策、边缘适配和跨技术融合方向发展,实现存储效率、性能与可靠性的动态平衡。

异构算力老群群(在读985计算机博士生)的技术博客 1283

Seaweedfs Erasure-coding 深度解析 里德所罗门 分布式对象存储 冗余错高可用测试

SeaweedFS 实现了RS(10,4),每 10 个硬盘中允许丢失 4 块仍可正常访问复制数据5次以实现相同的稳健性相比,它节省了3.6倍的磁盘空间。

马某人的博客 997

分布式存储系统 | Erasure Coding),以Reed-Solomon(RS)为例

Erasure Code)浅析。Reed-Solomon(RS)是存储系统较为常用的一种,它有两个参数n和m,记为RS(n,m)。n代表原始数据块个数。m代表校验块个数

南意的博客 5445

Erasure-Code() 最佳实践

该过程可行的核心保障就是需要确保矩阵A的任意5*5的子矩阵的可逆矩阵都是存在的,这样才能确保丢失8块数据中的任意3块数据都可以进行数据还原。一般情况下可以认为上层业务的大块连续IO读取都是满条带的读取,在Stripe Placement 情况下,满条带的读取在正常情况下和异常情况下从底层读取的数据量可以认为是一致的(如下图左侧图所示),而且当前一般来说EC 解有硬件加速,即计算层面不太容易成为瓶颈,所以Stripe Placement 在正常度和异常情况下的开销基本可以认为差不多。详见对象存储架构设计。

大隐隐于野 1083

再聊HDFS Erasure Coding

前言在之前我的一篇文章中,已经聊到过一次关于HDFS EC方面的内容(文章链接Hadoop 3.0 Erasure Coding 功能预分析),所以本文算是对其内容的一次补充.之前的文章中主要是从宏观的层面上阐述了HDFS EC的作用以及相应的使用场景,并没有深入到内部相关架构设计以及具体EC算法的的内容.本文主要=阐述的内容正在于这两方面.Erasure Coding技术EC是Erasure

走在前往架构师的路上 1万+

7_

2020/11/4 sunhaiqi@bonc.com.cn 文章目录一、Erasure Coding/EC)1.1背景1.2原理1.3块存储方式1.4NameNode端扩展1.5Client端扩展1.6DataNode扩展1.7策略1.8配置1.9使用Intel ISA-L1.10HDFS-EC子命令 一、Erasure Coding/EC) 1.1背景 ​ 从存储领域来看,数据冗余机制其实这几十年来没有太多进展,RAID,副本一直是当仁不让的最终选择。而近几年,尤其是规

nothair的博客 1768

HDFS技术深度解析

摘要:HDFS(EC)是一种高效的数据冗余技术,通过数学编将数据分块并生成校验块,相比传统副本机制显著降低存储开销(如RS-6-3策略仅需1.5倍存储)。采用(n,k)方案,可容忍m=n-k块丢失,通过有限域运算实现数据编解。该技术特别适合冷数据存储,但存在计算开销大、恢复成本高的缺点,需权衡性能与存储成本。HDFS通过条带化存储和分布式块部署实现EC功能,是优化大数据存储的重要解决方案。

weixin_51976489的博客 944

hdfs 的技术ErasureCoding

​一句话概括:​​(EC)是一种比传统多副本复制更高效的数据容错方法。它通过将数据块切割、编,生成奇偶校验块,并将所有这些块分散存储在不同的节点上。在发生故障时,即使丢失部分块,也可以通过数学计算完整地恢复出原始数据。​传统副本复制(Replication)​​•工作原理​:这是 HDFS 默认的容错机制。比如,你有一个 128MB 的数据块,系统会简单地将其复制 3 份(默认副本数),然后存储到 3 个不同的数据节点上。•​优点​:实现简单,读取性能高(可以从多个副本读取)。•缺点​:​。

二进制专栏 763
上一篇: s3cmd : Add a config parameter to enable path-style bucket access 当ceph rgw使用域名时,需要支持 path-style bu...
下一篇: Ceph 时钟偏移问题 clock skew detected 解决方案--- 部署内网NTP服务
amacql8633
博客等级 码龄10年 3粉丝 0原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值