使用蓝耘MaaS构建Markdown博文配图生成器:模型接入、并行任务与CORS处理

下一词预测(Next-token Prediction)深度解析:从 N-gram 到 GPT 的唯一目标函数 下一词预测(NTP)是自回归语言模型的核心训练目标,其本质为最小化交叉熵,等价于最大似然估计。通过链式法则将序列概率分解为条件分布,模型在无监督下学习语料中真实下一个 token 的高概率输出。从n-gram到Transformer,技术演进始终围绕提升上下文建模能力与并行效率。训练时利用因果掩码实现并行前向,推理则逐token采样生成。损失函数的下降揭示了规模定律下的通用智能涌现,但模型仍受限于生成能力,无法学习逻辑或常识。该目标统一了训练、评估与推理,构成大模型发展的基石。 阅读详情

写技术文章时,配图工作往往占用不少时间——封面需要概括主题,正文插图需对应具体段落,生成后还可能要调整标题、比例或局部元素。过去我的做法是逐段整理提示词,分别生成和修改图片,流程分散且重复。这次我尝试把这些步骤整合到一个工具中,记录下实现过程中涉及模型接入、任务编排和本地开发环境问题的处理方式。

工具概览

这个工具暂命名为「博文视觉生成器」。上传 Markdown 文档后,可以运行“AI 智能规划配图”,也可以单独选择全文或某个段落,生成封面或正文插图。

  • 文本模型:通过蓝耘MaaS接入 GLM5.3(控制台模型ID为 glm-5.3)。
  • 视觉模型:图像生成和编辑使用 Sense U1.5 Lite。

项目使用 Vue 3 + Vite 开发,是一个纯前端应用,不含业务后端。界面分左右两栏:左侧是博文文档区(支持上传、编辑、预览和段落选择),右侧是视觉创作区(可选择封面/插图、风格与比例)。

整体调用链路如下:

Markdown 全文或选中段落

蓝耘MaaS · GLM5.3

理解内容、抽取主题与信息层级
生成视觉指令

商汤 · Sense U1.5 Lite

根据视觉指令生成封面或正文插图

图片编辑器

上传或复用生成结果
继续通过自然语言改图

一、模型服务选型与接入配置

1.1 选型考虑

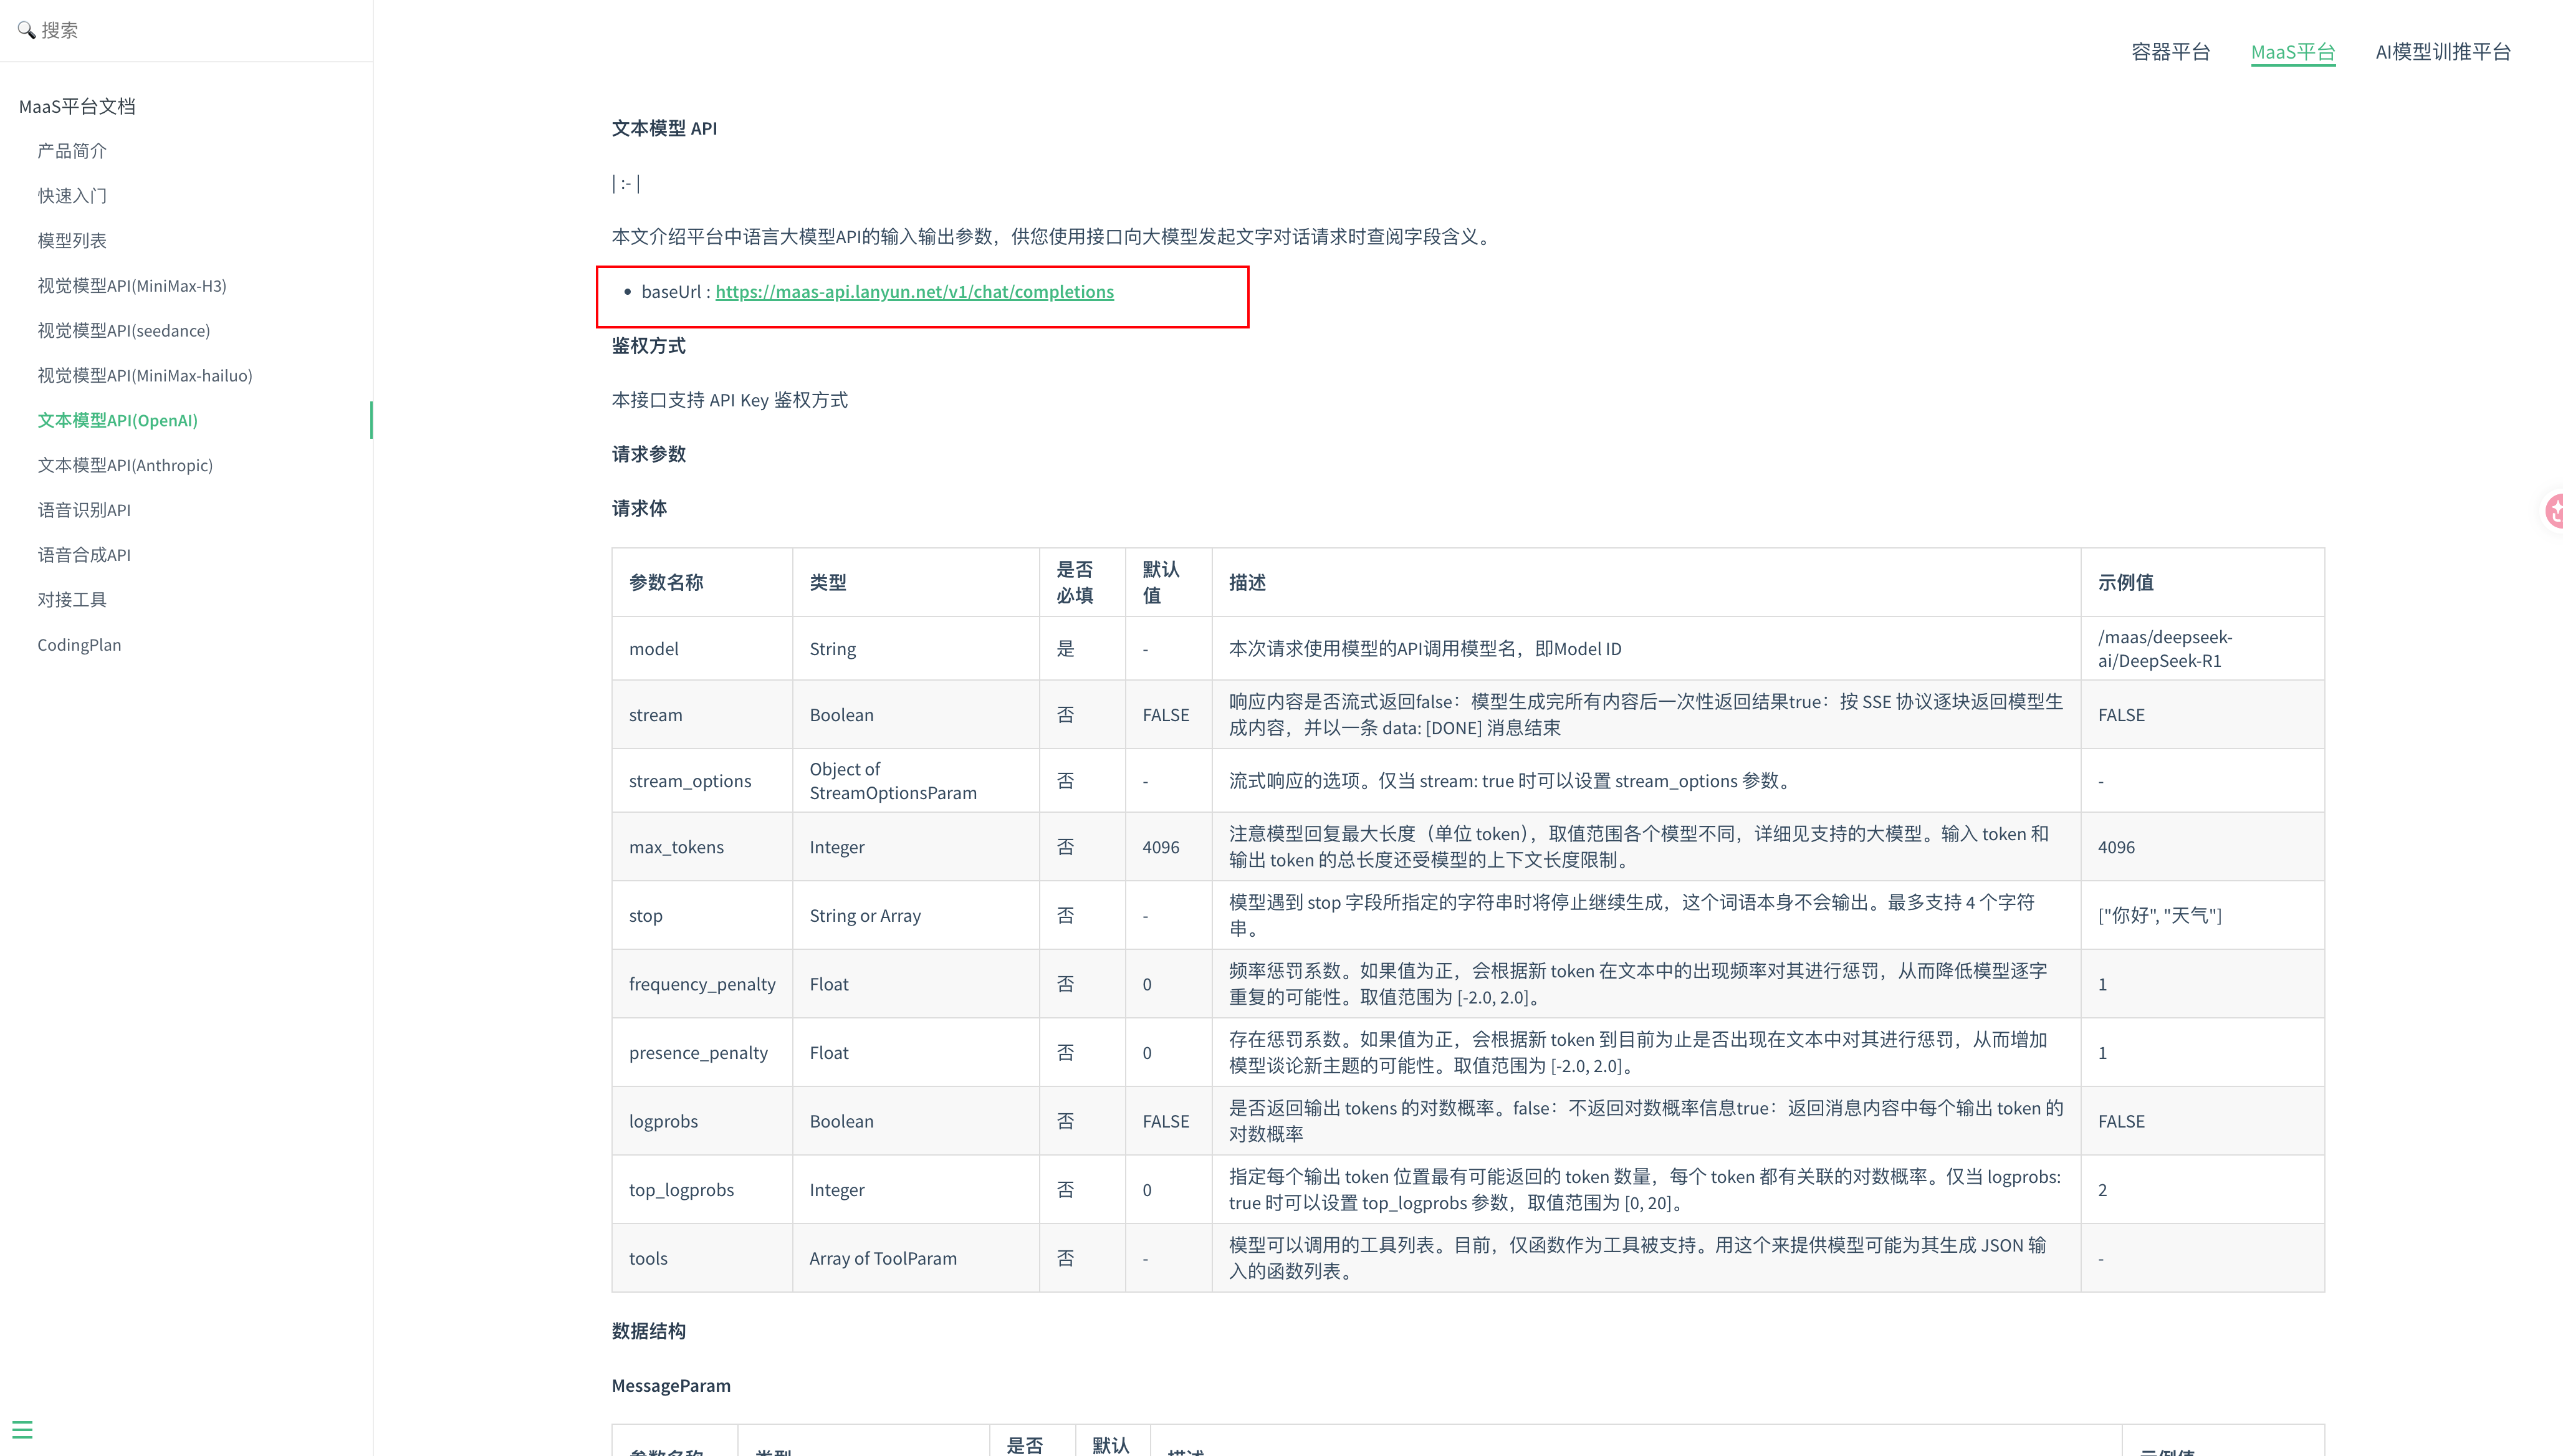
项目需要在Codex中开发,同时前端要调用文本模型分析长文章,因此接入方式、模型参数清晰度和排错便利性是主要考量。蓝耘MaaS提供OpenAI兼容接口,可以复用现有请求层,只需替换base_url、api_key和模型ID。

接入前检查了以下配置项:

  1. 接口协议:文档提供OpenAI兼容调用示例。
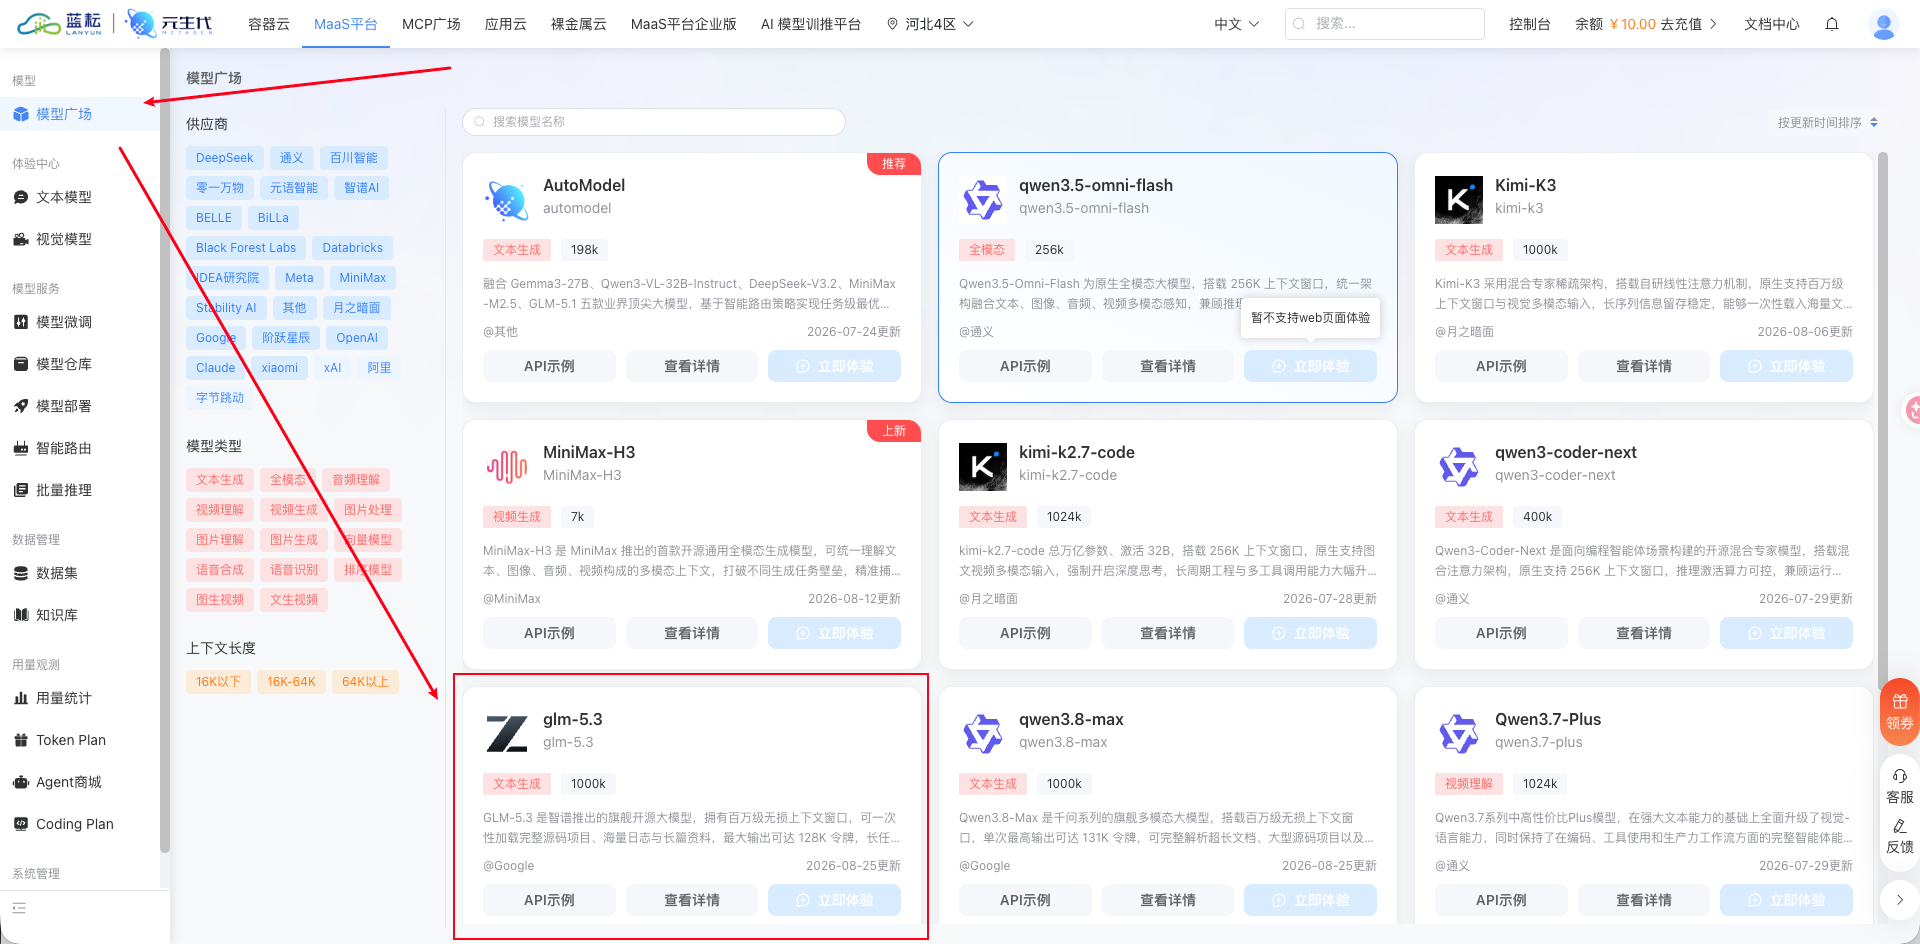
  2. 模型字段:确认上下文长度是否能覆盖长文任务,并记录实际调用ID glm-5.3。
  3. 模型切换方式:同类兼容接口便于后续对照测试。
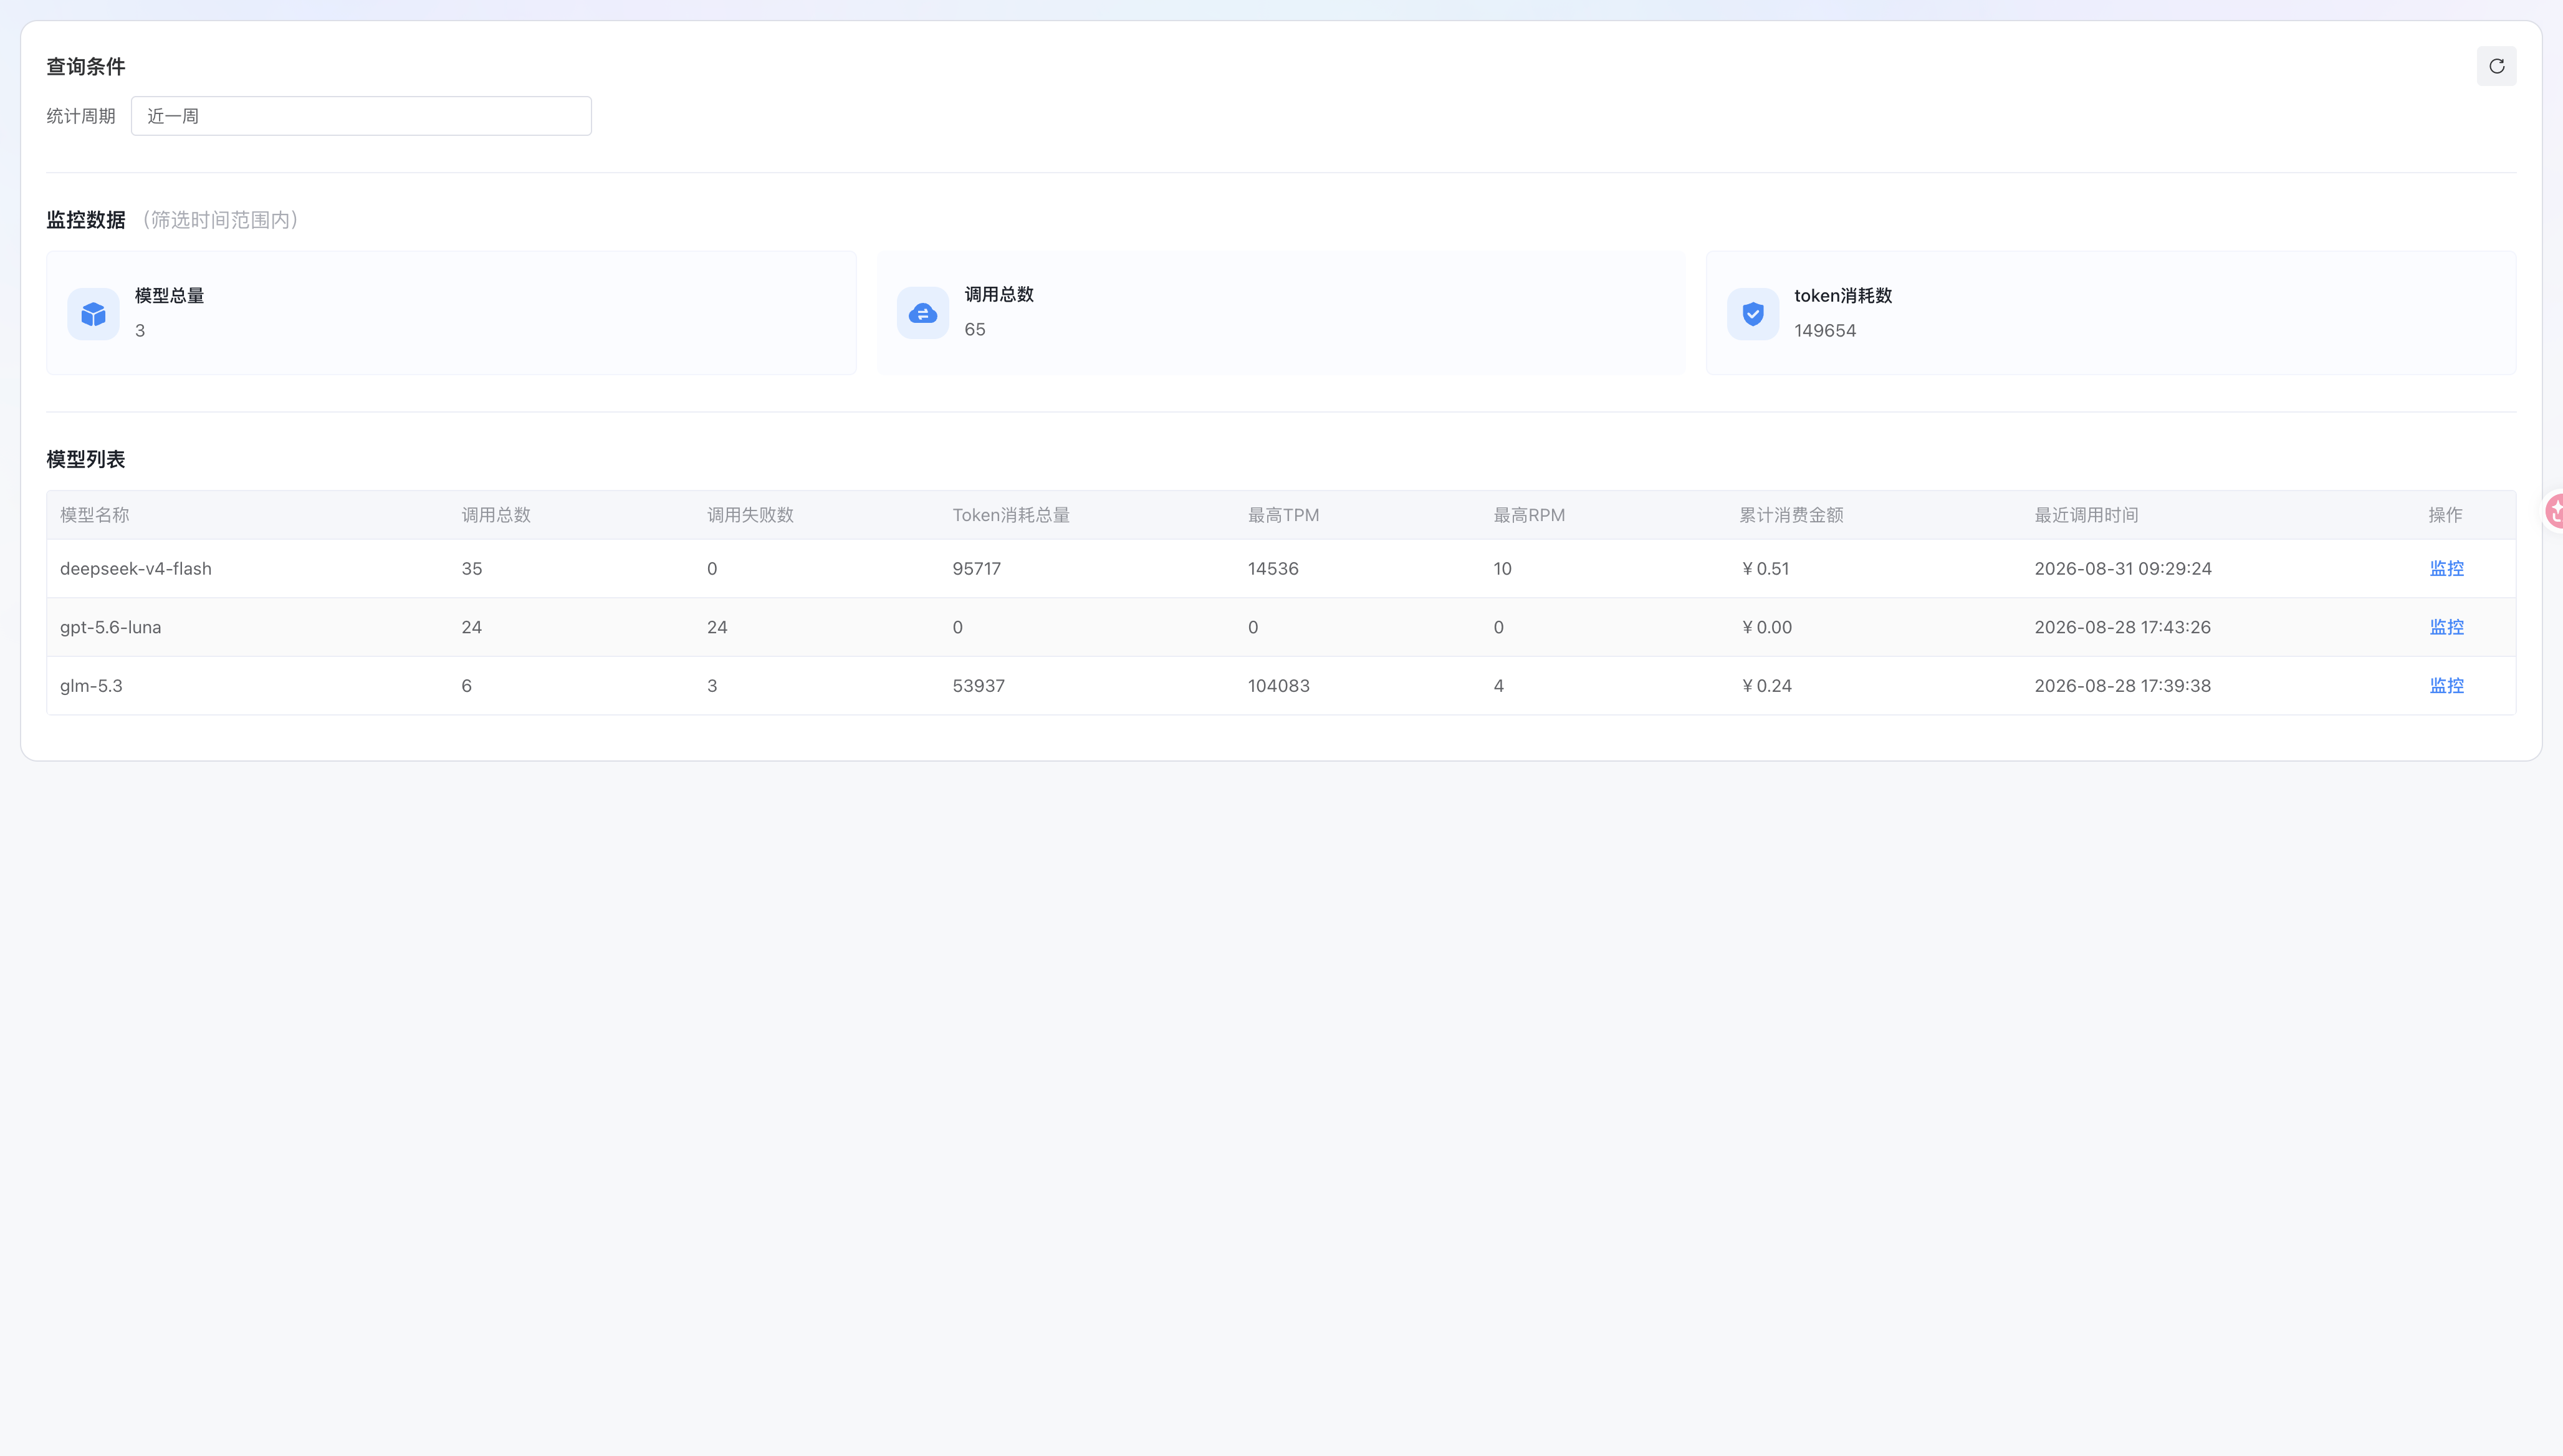
  4. 密钥与用量查询:API Key按项目创建,资源包页面可查看剩余量。

蓝耘接口文档
图1 蓝耘接口文档

蓝耘用量监控
图2 蓝耘用量监控

蓝耘模型列表
图3 蓝耘模型列表

1.2 Codex 与 CC Switch 配置

日常使用Codex时,有时额度用尽,需通过CC Switch切换其他模型服务。CC Switch可以保存多个供应商配置,在界面中切换Provider,更新Codex的模型、端点和认证信息,无需手工编辑配置文件。

Codex使用 ~/.codex/config.toml 保存Provider、模型与端点设置。对于只提供OpenAI Chat Completions接口的第三方服务,需要启用本地路由,将Codex的Responses请求转换为上游支持的格式。

1.3 创建项目专用API Key

在MaaS控制台创建仅限本项目的API Key,确认模型ID为 glm-5.3,并核对OpenAI兼容的基础地址。独立密钥便于隔离问题,测试结束后可停用。
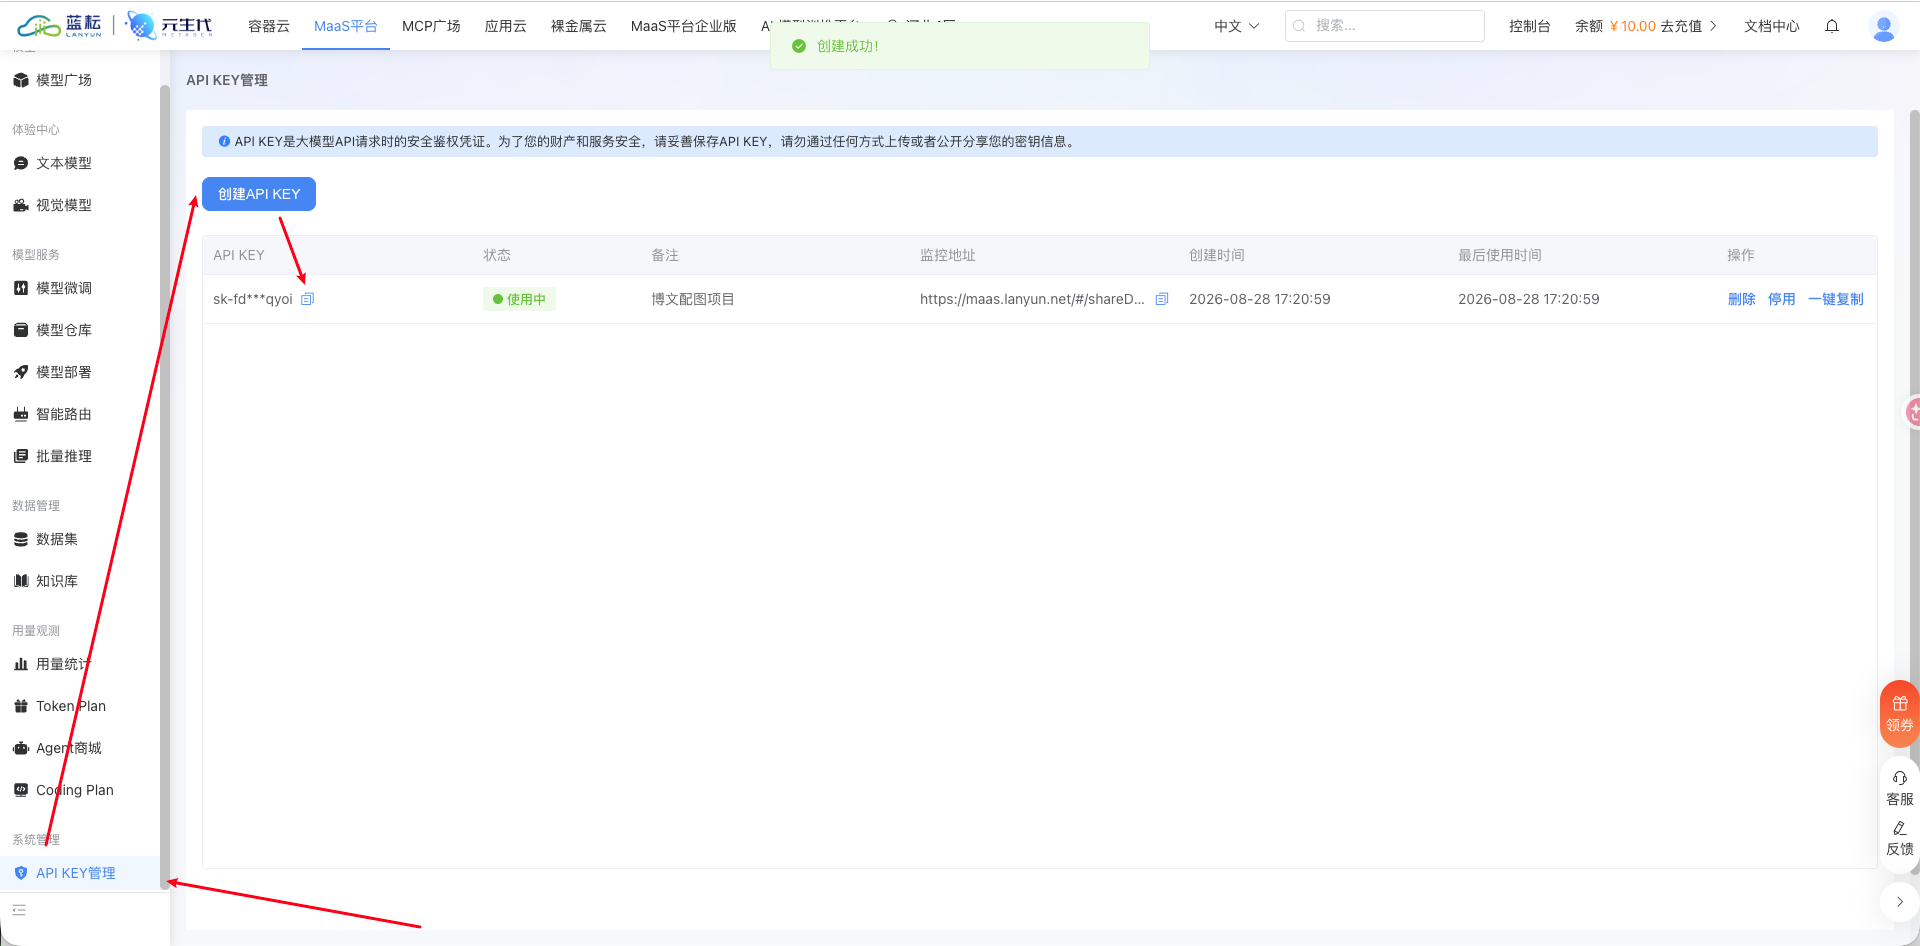
创建API Key
图4 创建API Key

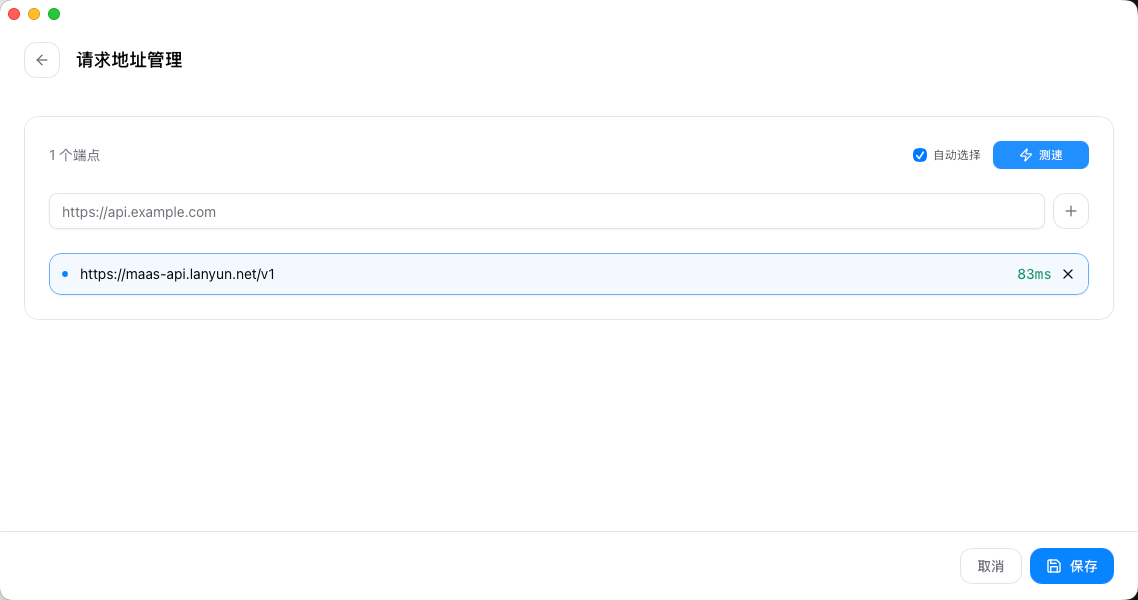
1.4 在CC Switch中配置Provider

CC Switch中新增自定义Provider,关键字段如下:

CC Switch 字段应填写的内容说明
Provider 名称蓝耘-GLM5.3仅用于识别
Base URL控制台提供的OpenAI兼容基础地址不是控制台网页地址
API Key项目专用Key不提交到仓库
模型glm-5.3实际调用ID
接口格式按接口文档选择若只有Chat Completions,需打开本地路由

注意:是否开启本地路由取决于上游接口格式,而非模型名称。配置后保存并启用,检查 ~/.codex/config.toml 确认 model_provider、model 和 base_url 已更新。
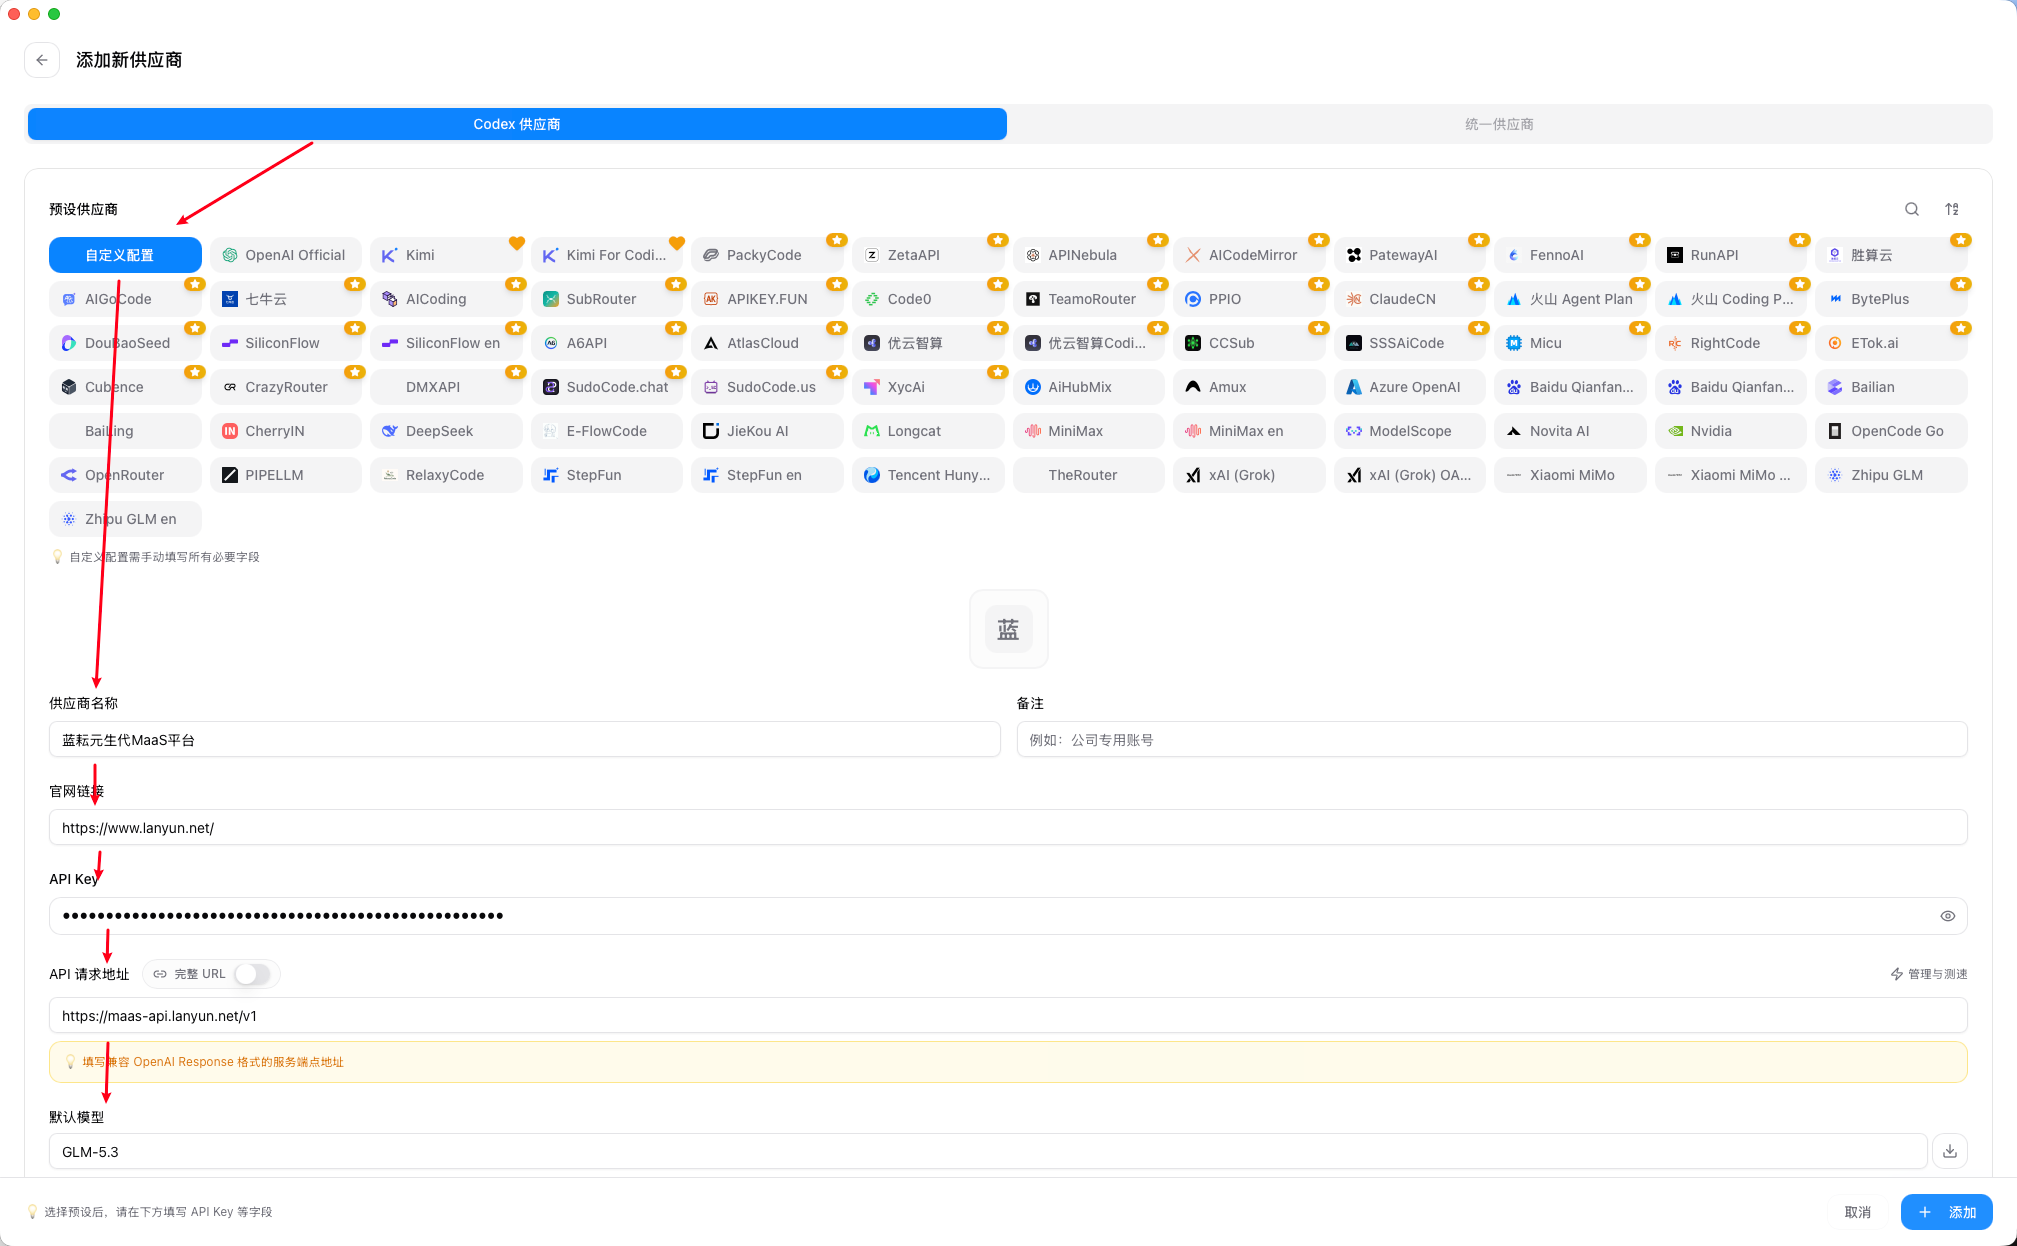
CC Switch配置
图5 CC Switch配置

配置后进行连通性测试,确保接口可用。

接口连通测试
图6 接口连通测试

1.5 验证Codex模型切换

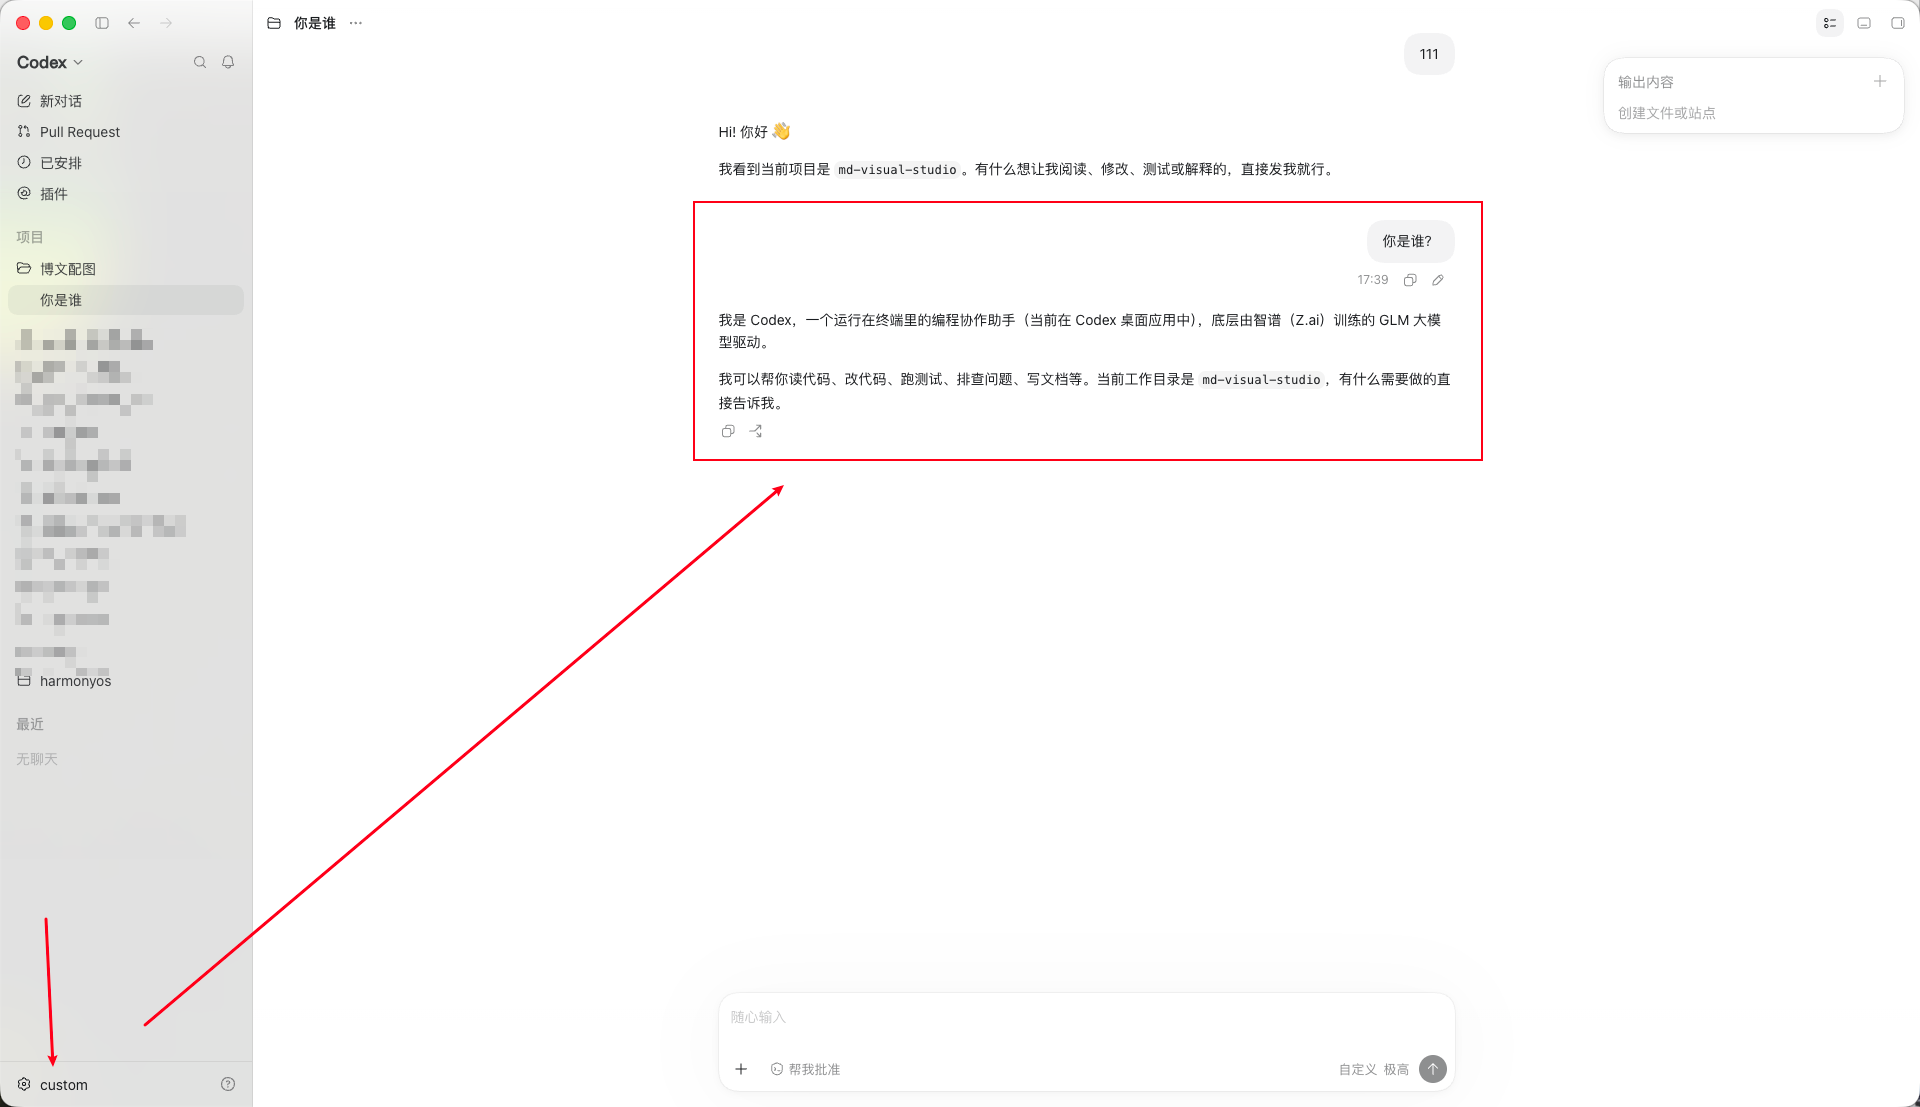
切换Provider后,重新打开Codex,给出一个具体但不消耗过多额度的任务,例如阅读Vue项目目录结构并给出状态管理建议。验证Codex能否响应、模型名是否来自当前Provider,以及项目上下文是否可读取。
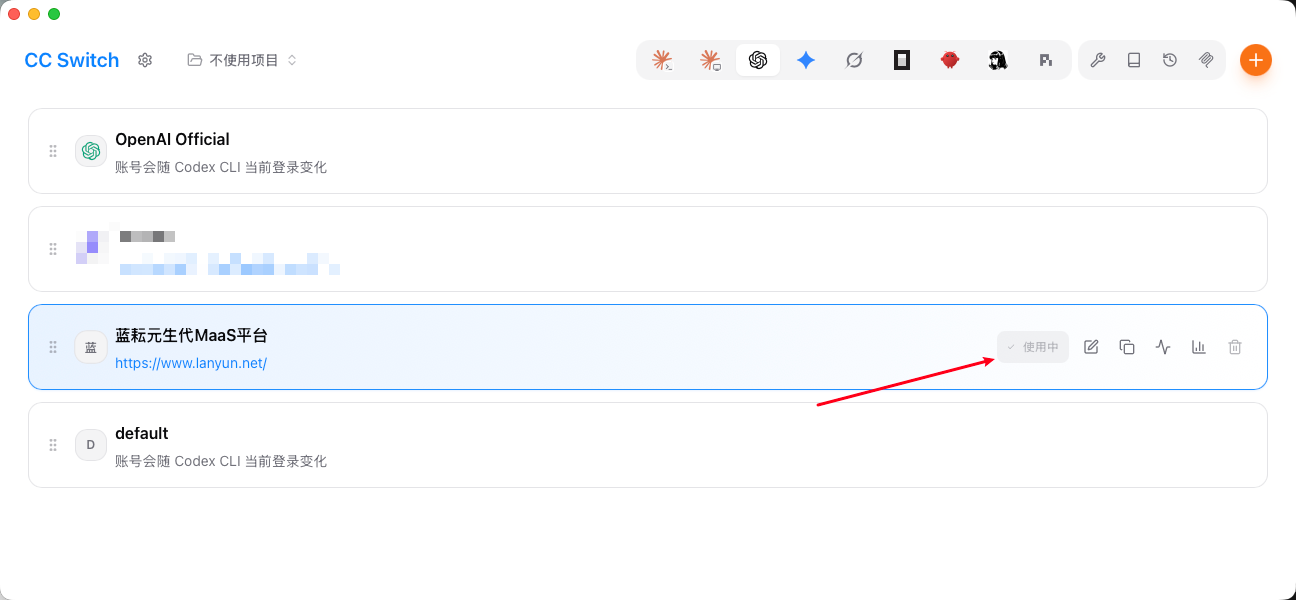
Codex模型验证
图7 Codex模型验证

Codex理解项目
图8 Codex理解项目

二、项目创建与初始化

2.1 创建项目

通过初始Prompt生成Vue 3 + Vite项目框架,后续多轮对话补充页面布局、并行任务、图片编辑和错误重试等功能。markdown-it 负责将Markdown转为HTML,dompurify 清理渲染结果。图片生成和编辑请求统一放在 src/services,页面组件只处理状态和交互。
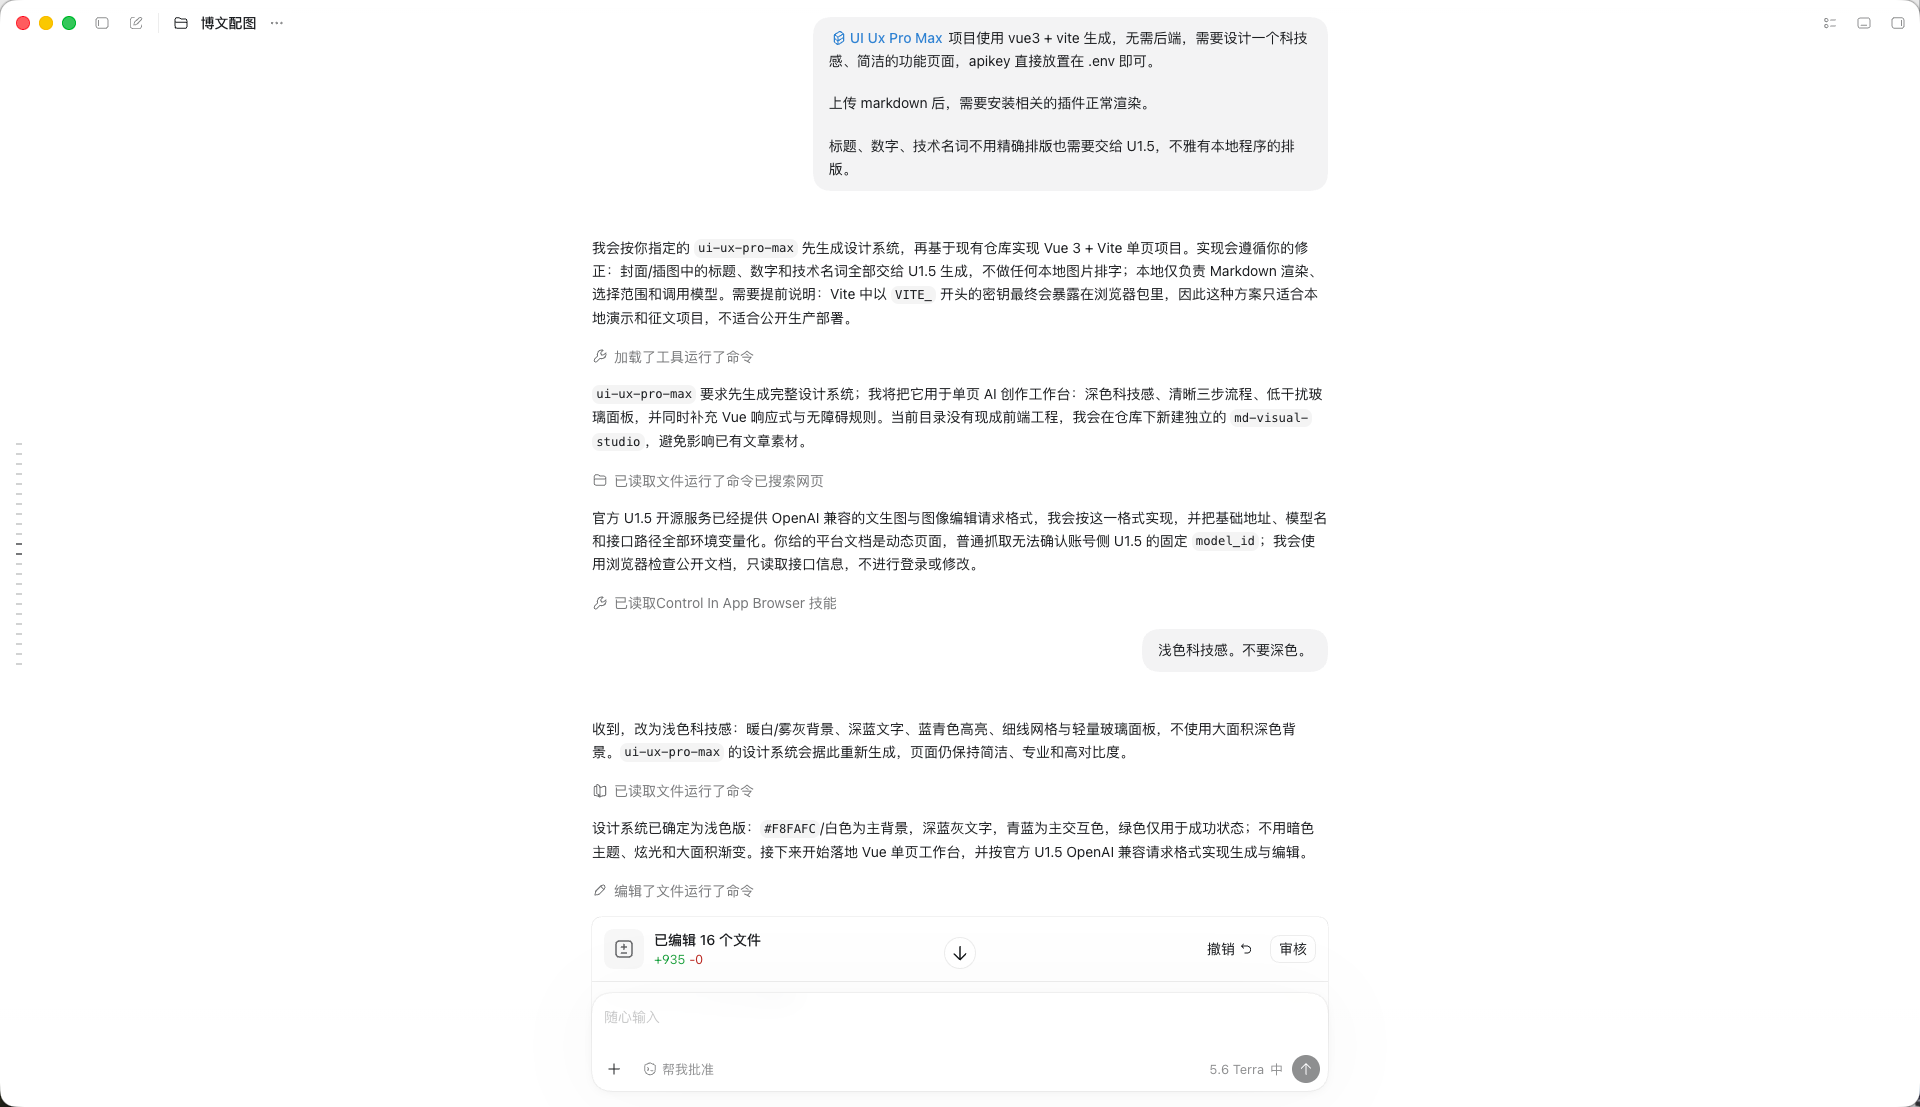
输入初始Prompt
图9 输入初始Prompt

追加开发Prompt
图10 追加开发Prompt

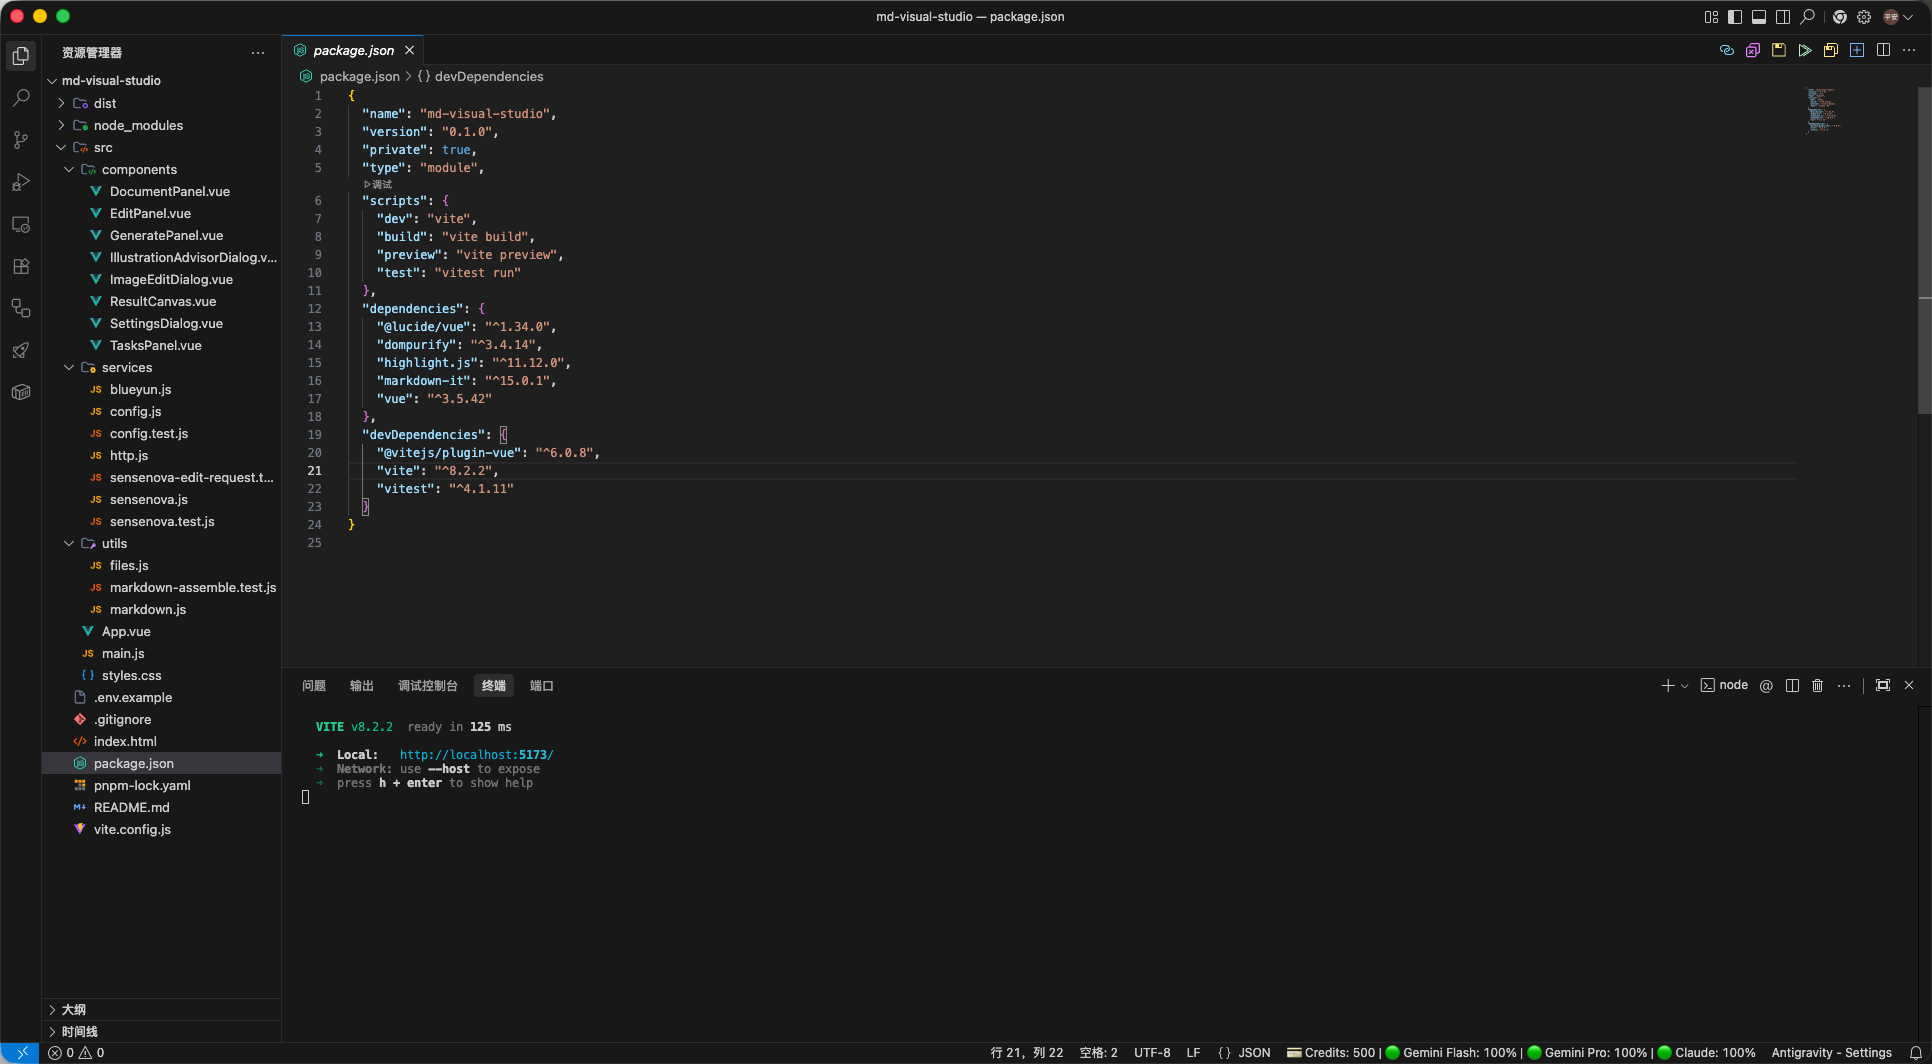
项目目录结构
图11 项目目录结构

2.2 页面模型配置

右上角“模型配置”弹窗中填写文本模型和图像模型的服务地址、接口路径、模型ID和API Key。保存后配置写入localStorage,页面顶部显示配置状态。

三、核心实现

3.1 文本模型做视觉策划,而非直接生图

直接让图像模型读全文,容易只抓住表面关键词。因此将“理解文章”和“生成图片”拆开。上传Markdown后,提取标题和内容块,用户可选择全文或段落。createImagePrompt 将选中内容、图片用途、比例和风格发送给GLM5.3,请求中的 model 为 glm-5.3。

核心调用(简化,省略错误处理):

const payload = {
  model,
  messages: [
    { role: 'system', content: visualDirectorPrompt },
    {
      role: 'user',
      content: `请根据以下${scopeName}生成一条${targetName}指令。

文章标题:${documentTitle}
画面比例:${ratio}
视觉风格:${style}

--- 内容开始 ---
${source}
--- 内容结束 ---`,
    },
  ],
  temperature: 0.45,
  stream: false,
}

visualDirectorPrompt 约束了输出内容:封面概括全文,插图解释段落;图片中的文字(标题、数字、技术名词)由图像模型生成;只保留一个主标题和不超过三项核心信息;描述构图、层级、配色和留白;不添加原文没有的事实;最终只返回图像指令,不含解释或JSON。

3.2 统一生图和改图工作流

右侧创作区没有将“智能生成”和“图片编辑”硬切为两个页面。用户生成图片后可点击“编辑图片”进入近全屏编辑器;也可先点击“编辑已有图片”上传本地图片。

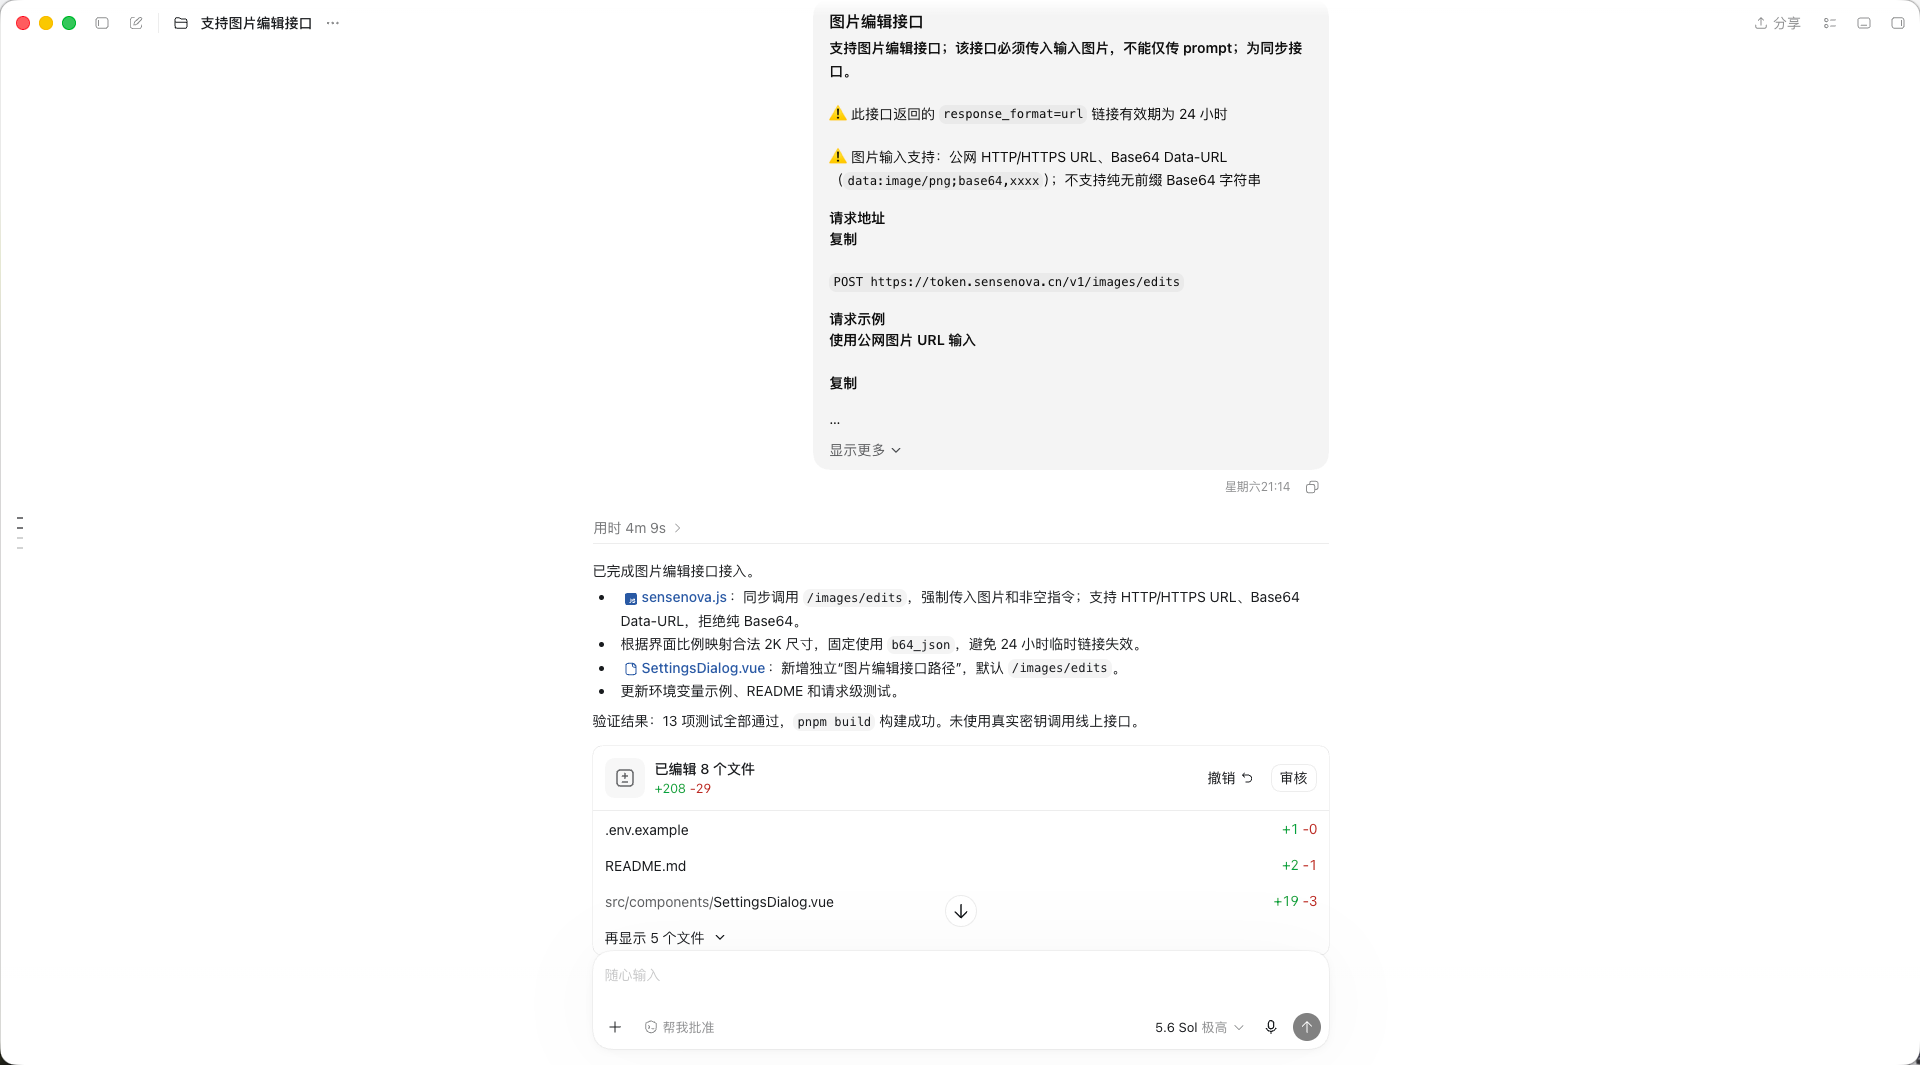
编辑器保留图片版本列表,编辑指令只描述“要改什么”,例如“把背景改成浅色网格,保留中间标题和流程结构”。编辑时把当前图片、修改要求和输出比例一起发送。

文生图请求:

const payload = {
  model,
  prompt,
  n: 1,
  size: editSizeByRatio[ratio] || 'auto',
  output_format: 'png',
  response_format: 'b64_json',
  watermark: true,
  prompt_extend: true,
}

图片编辑请求(/images/edits):

const payload = {
  model,
  images: [{ image_url: imageUrl }],
  prompt: instruction,
  n: 1,
  size: editSizeByRatio[ratio] || 'auto',
  response_format: 'b64_json',
  watermark: true,
  prompt_extend: true,
}

前端不负责二次排字,视觉指令、原图和比例交给模型,标题与技术名词与画面一同生成。

四、实际遇到的问题与处理

4.1 本地开发CORS限制

页面从 http://localhost:5173 直接请求图像接口时触发跨域错误。使用Vite代理解决:

const sensenovaProxy = {
  target: 'https://token.sensenova.cn',
  changeOrigin: true,
  rewrite: (path) => path.replace(/^\/api\/sensenova/, ''),
}

export default defineConfig({
  server: {
    proxy: {
      '/api/sensenova': sensenovaProxy,
    },
  },
})

请求层将目标地址改写为同源代理路径:

if (target.origin === 'https://token.sensenova.cn') {
  return `/api/sensenova${target.pathname}${target.search}`
}

修改后生图和改图接口正常。注意此代理仅开发预览有效,公开部署需服务端配置反向代理或后端代调。

4.2 并行任务提升效率

最初一次只能处理一张图,全篇配图耗时较长。改为独立任务并行执行——先为每条建议创建任务,再立即调用 executeTask,每个任务独立维护 prompting、generating、completed、failed 状态。

taskList.forEach((item) => {
  const newTask = {
    id: `task-${Date.now()}-${Math.random().toString(36).slice(2, 7)}`,
    title: item.title,
    status: 'pending',
    // ... 其他字段
  }
  tasks.value.unshift(newTask)
  executeTask(newTask)
})

单任务失败不阻塞其他任务。当前仅少量配图,直接并行足够;若需大规模生成,后续可加并发上限和等待队列。

4.3 失败任务保留与重试

生图接口偶发网络中断或服务端错误。失败后不删除任务,而是改为 failed 状态,显示错误信息,并提供“重试”和“重新下发”按钮。

async function executeTask(task) {
  task.status = 'prompting'
  task.error = ''
  try {
    task.prompt = await createImagePrompt(/* ... */)
    task.status = 'generating'
    task.imageUrl = (await generateImage(task.prompt)).imageUrl
    task.status = 'completed'
  } catch (error) {
    task.status = 'failed'
    task.error = toErrorMessage(error)
  }
}

function retryTask(taskId) {
  const task = tasks.value.find(item => item.id === taskId)
  if (task) executeTask(task)
}

重试沿用原文章、类型、风格和比例,无需重新填写。目前整条链路重跑,后续可缓存已成功的视觉指令,仅重试生图阶段。

五、效果实测

5.1 上传Markdown

上传包含多个章节、操作步骤和技术名词的Markdown文章,程序正确读取一级标题、字符数、文件大小和内容块数量。
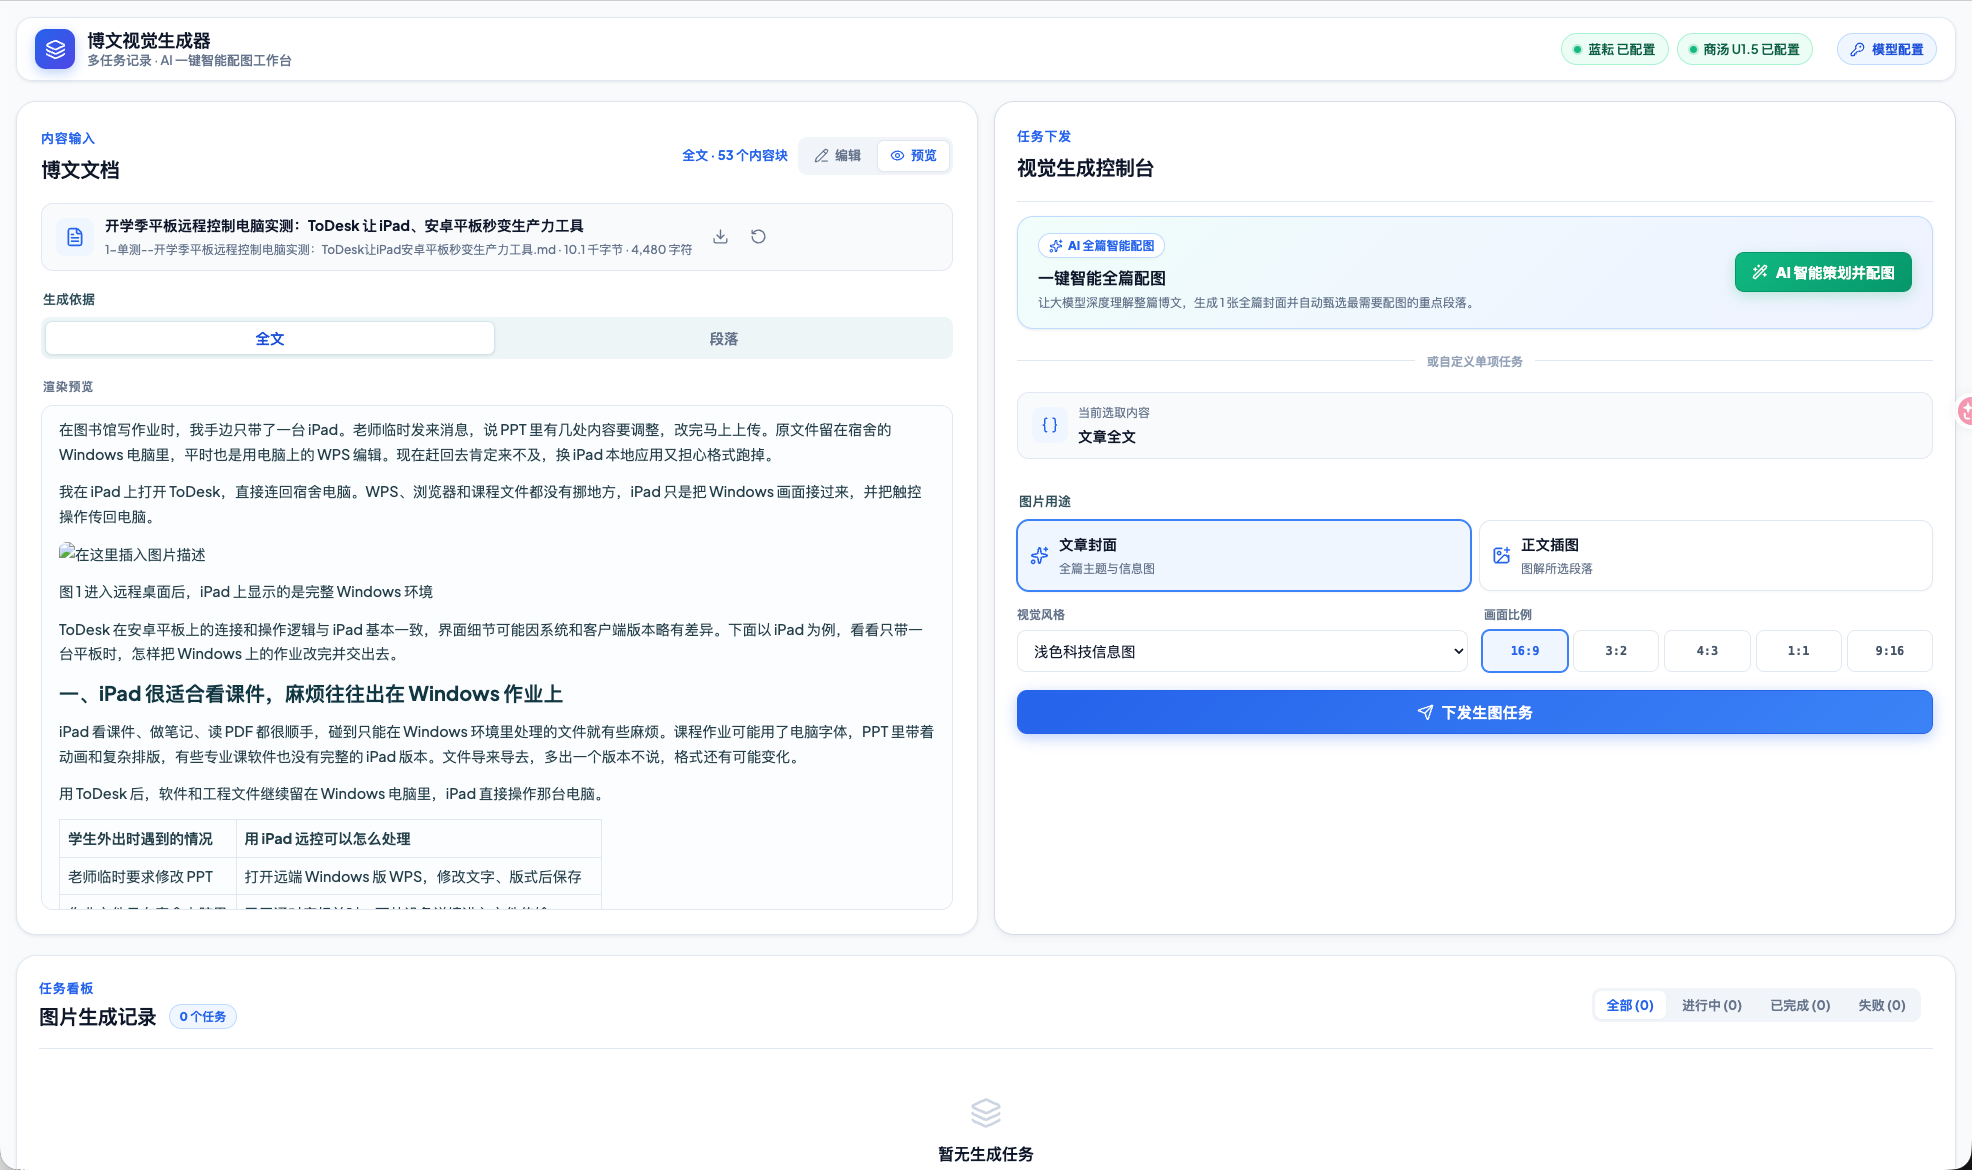
上传Markdown
图12 上传Markdown

界面分区清晰:顶部项目名和配置入口;中间左文档右视觉控制台;底部生图任务列表。文档区可在编辑和预览间切换。

5.2 AI智能策划全篇配图

点击“AI 智能策划全篇配图”后,GLM5.3通读文章,优先处理封面、核心流程、参数对比和操作重点,给出标题、理由及对应段落。
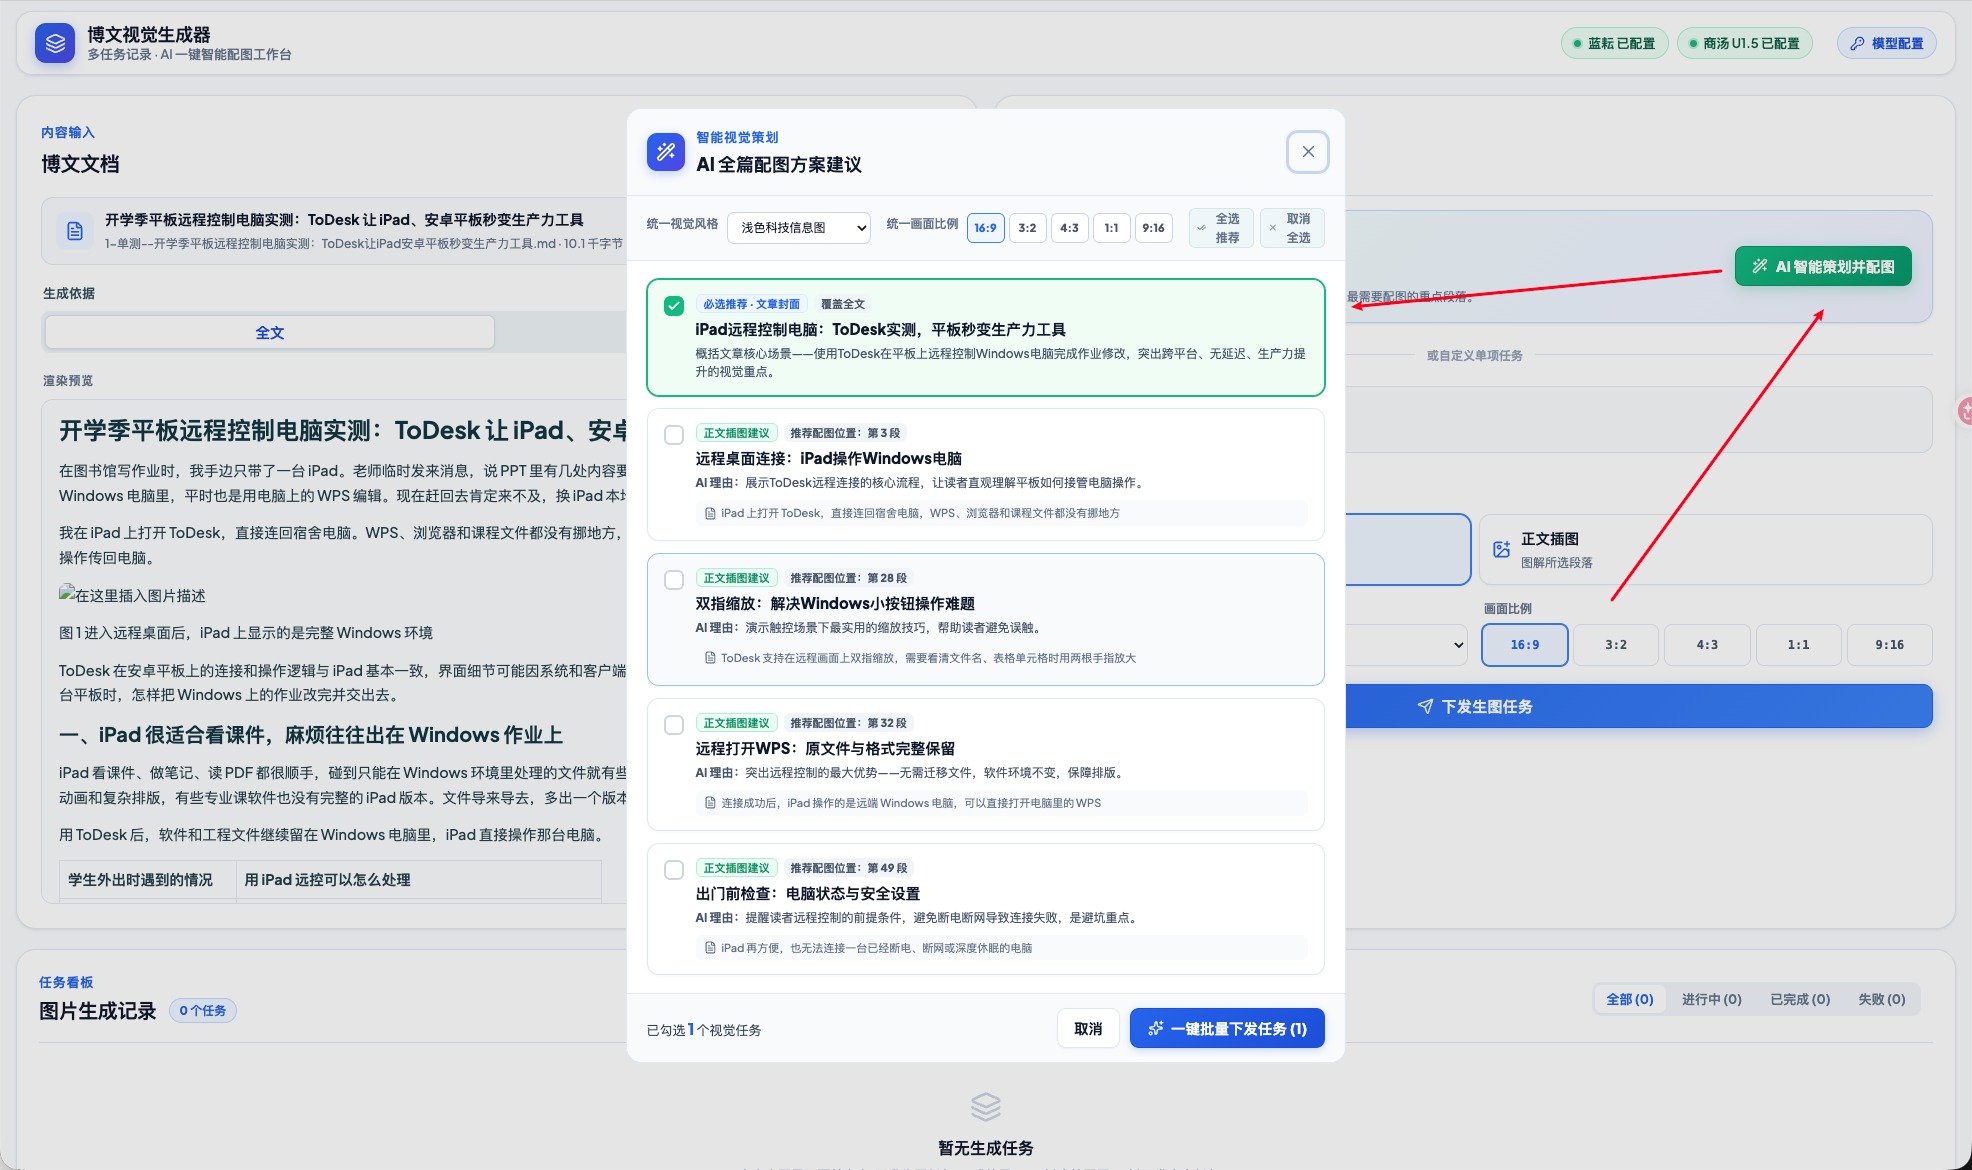
全文配图方案
图13 全文配图方案

确认方案后,并行创建所有任务,每项任务独立生成视觉指令并调用图像接口。
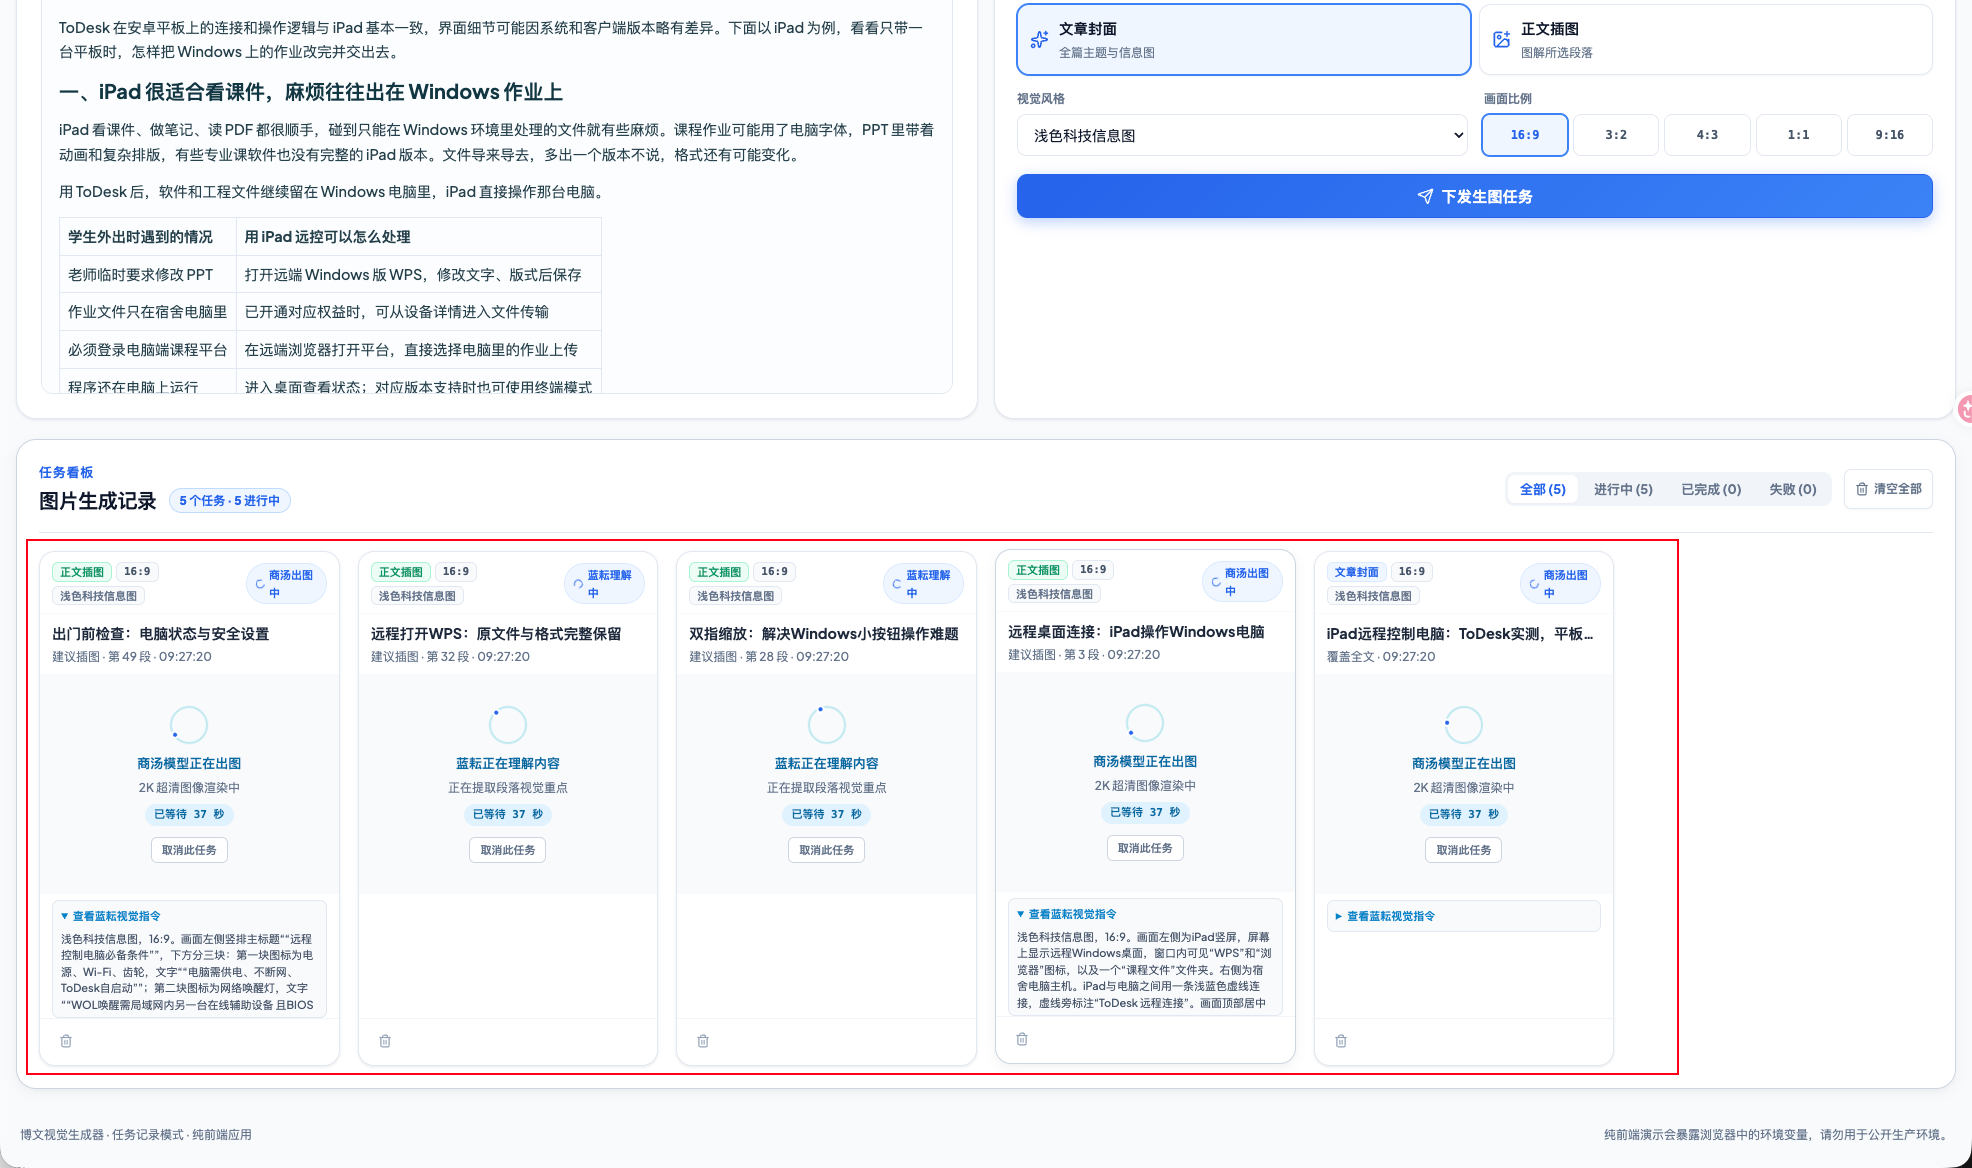
配图并行生成
图14 配图并行生成

任务卡片显示当前阶段和等待时间,图片完成后直接展示,并可展开查看视觉指令。
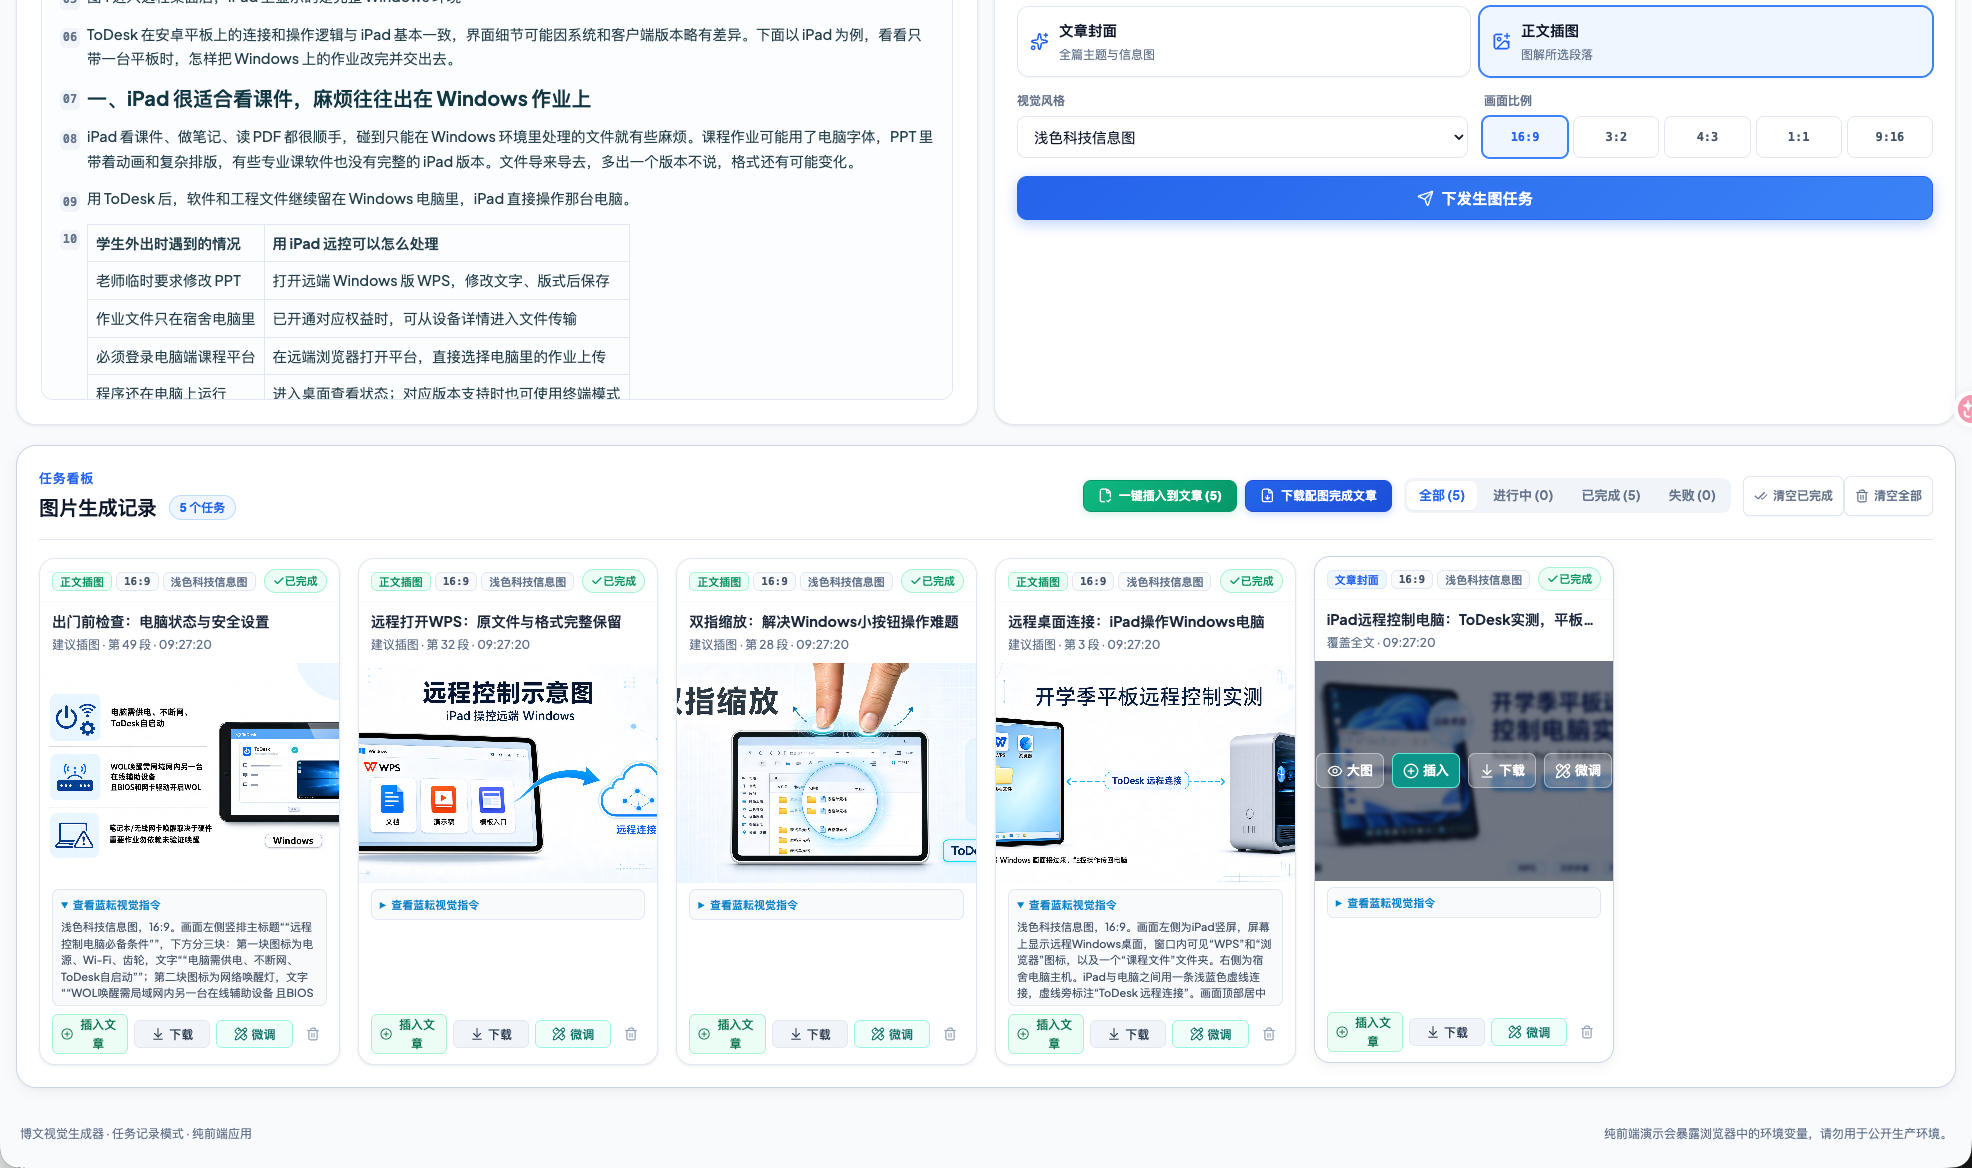
配图生成完成
图15 配图生成完成

此次生成的封面和正文插图均能对应文章主题与具体段落,未变成泛化的背景图。并行任务中个别失败不影响其他任务。

5.3 图片编辑

点击任务卡片中的“微调”或另行上传图片,用自然语言说明修改要求,无需重写整条生图提示词。
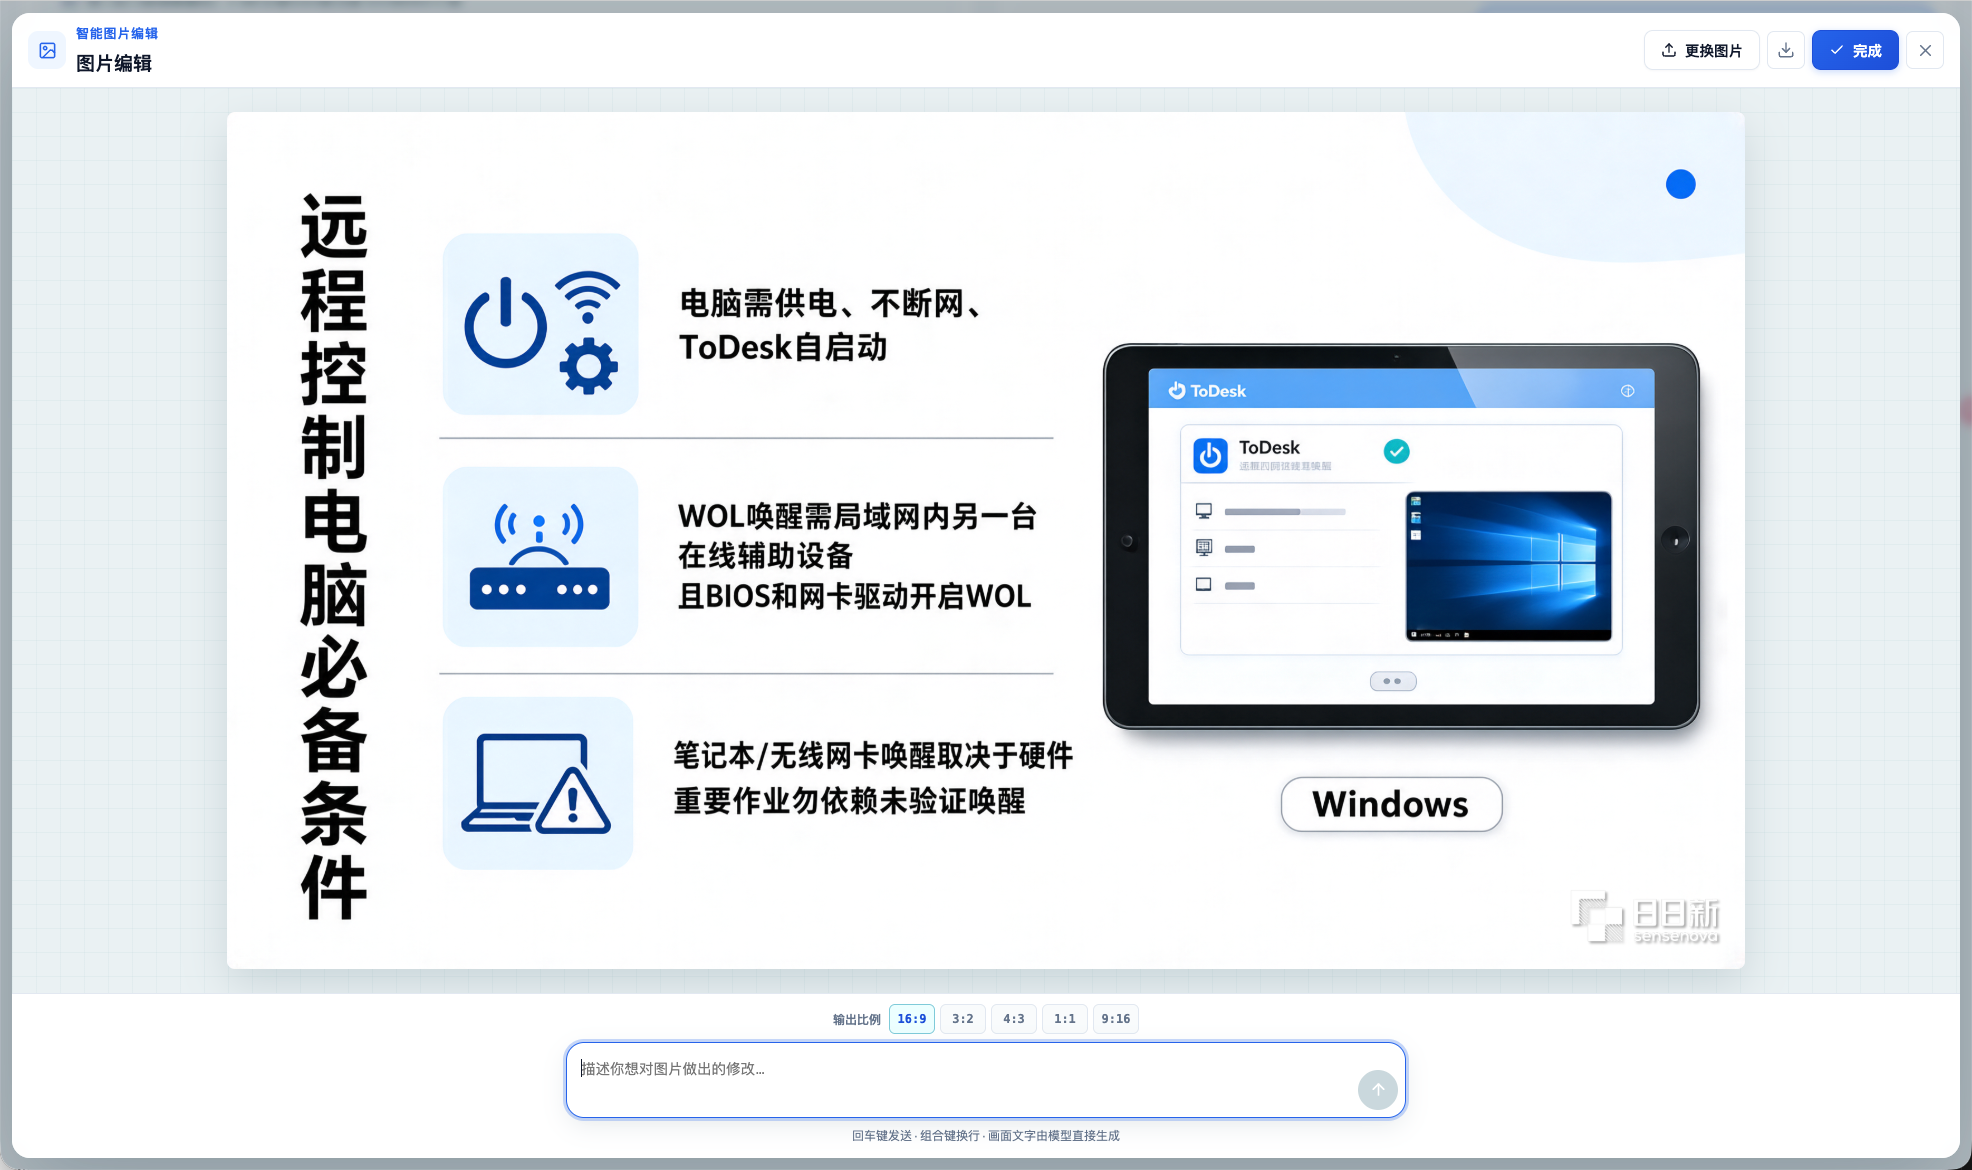
图片编辑窗口
图16 图片编辑窗口

例如要求将画面右侧的平板改成两台(安卓平板和iPad),同时保留标题、电脑主体、配色和整体构图。
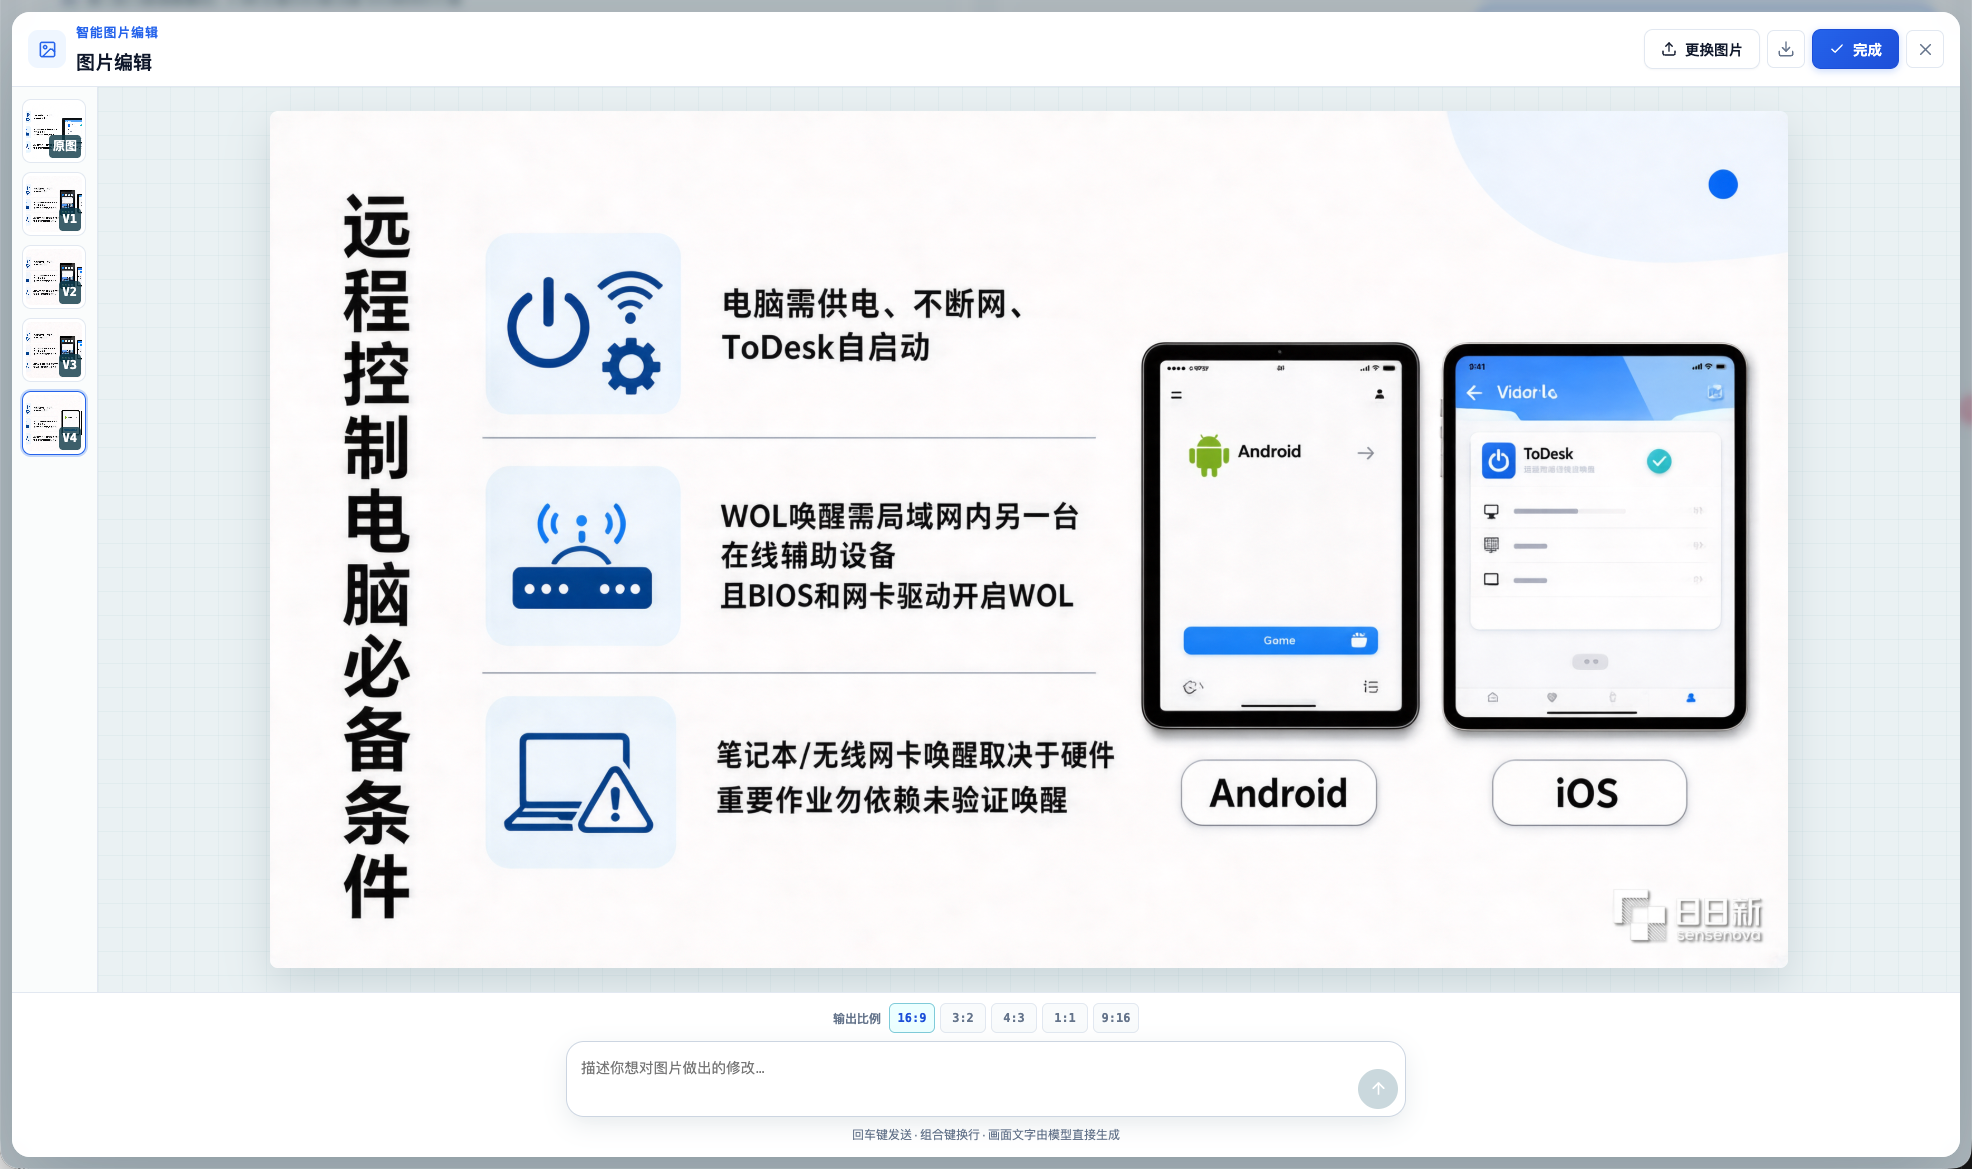
图片编辑结果
图17 图片编辑结果

每次编辑生成新版本,原图保留,版本列表可来回切换比较。

5.4 配图回填与导出

图片完成后可逐张插入对应段落,或点击“一键插入到文章”统一处理。封面放在标题附近,正文插图根据任务中保存的段落定位;匹配不到则追加到文末。
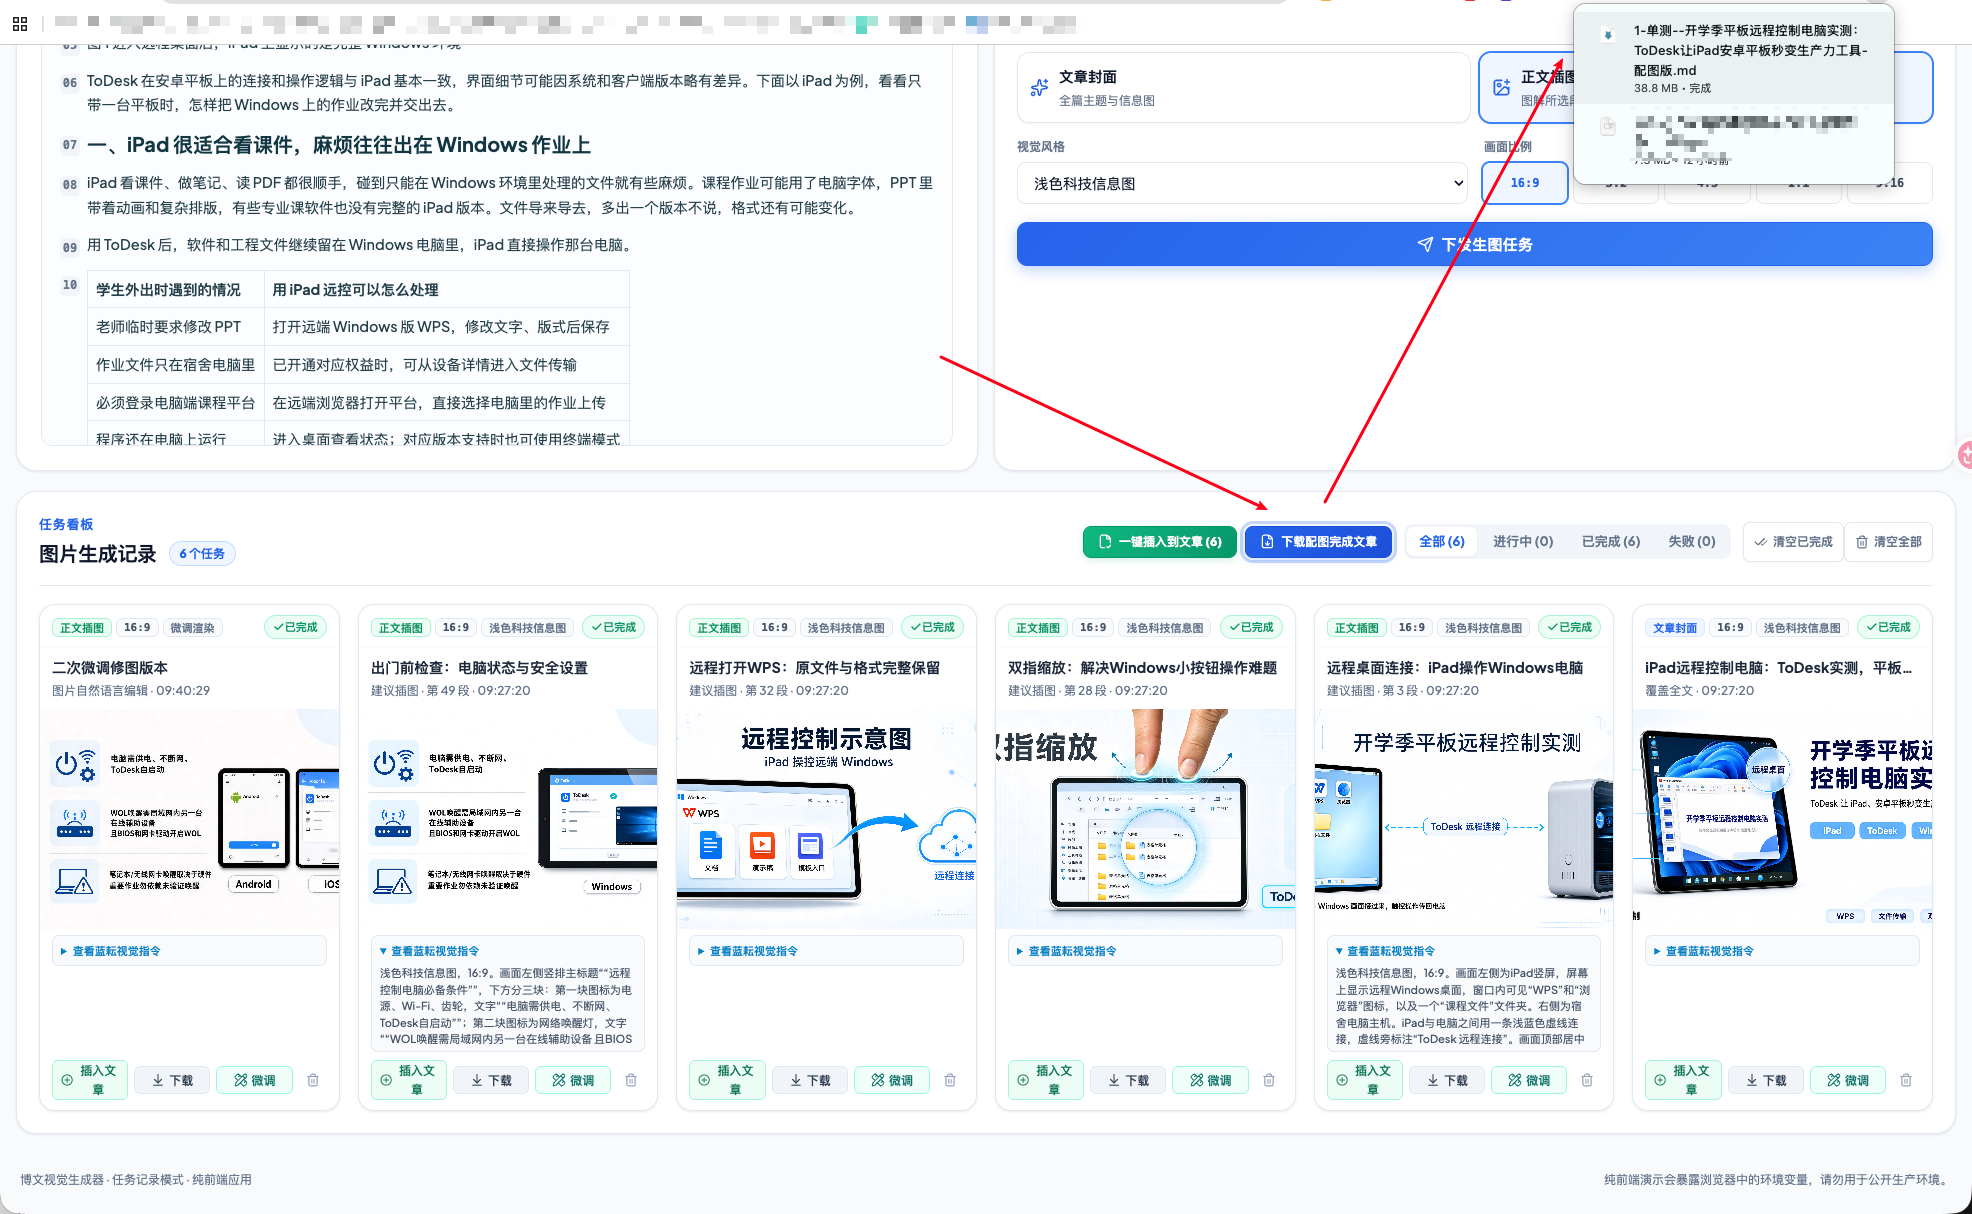
插入并导出文章
图18 插入并导出文章

导出文件在原名称后加“配图版”,不覆盖原始Markdown。图片集中放入 images 子目录。
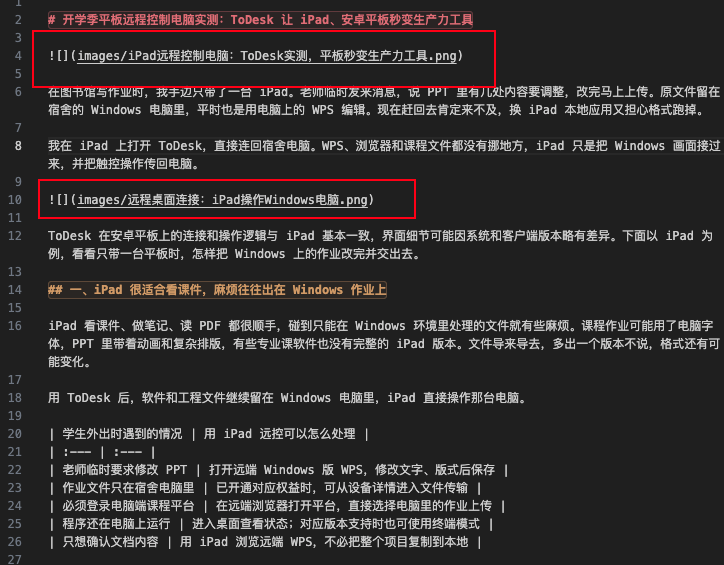
导出文章预览
图19 导出文章预览

重新打开导出的文章,封面和正文插图位置正确,原标题、段落和代码块未被改动。

六、总结与后续方向

本项目通过蓝耘MaaS接入GLM5.3作为文本模型,用于开发阶段(Codex协作)和运行阶段(将全文/段落转换为结构化图像指令),图像生成与编辑由Sense U1.5 Lite负责。两组接口独立,便于分别排查问题。

当前版本是可运行的MVP,后续计划:

  • 使用后端代理保护长期密钥;
  • 持久化生成记录、提示词对比和调用日志;
  • 利用调用记录比较不同文本模型在“长文理解→视觉指令”任务中的表现差异。
存储&AI行业每日要闻(2026-10-25 影响:这是市场对"烧钱就能赢"叙事的一次集体重估——Meta 主动设 C 类股稀释投票权也要融资,SpaceX 单季资本开支逼近营收 1.35 倍,叠加前一日博通 600 亿/SpaceX 400 亿芯片抵押融资,AI 基建已进入"股权+债务双管抽血"阶段;若指引保守,则昨日费半暴跌的余波将继续发酵。影响:DSX POD 的本质是把 AI 基建从"定制工程"变成"集装箱产品"——这与前一日"芯片抵押融资 5000 亿框架"形成闭环:英伟达不仅卖 GPU,还帮客户解决融资、集成、电力等全链条问题; 阅读详情

相关推荐

Mac上IDEA的PlantUML插件报错‘找不到Graphviz’?手把手教你用Homebrew搞定(附阿里云镜像避坑)

本文详细解决了Mac上IDEA的PlantUML插件报错‘找不到Graphviz’的问题,通过Homebrew安装Graphviz并配置阿里云镜像源,特别针对Apple Silicon芯片用户提供了优化方案。文章还涵盖了IDEA中PlantUML插件的正确配置和常见问题排查,帮助开发者高效使用PlantUML进行UML图表设计。

weixin_42619742的博客 465

CC Switch配置CodeX App第三方GLM模型“未生效”问题

文章摘要:作者遇到GLM-5.3模型未出现在CodeX可选列表中的问题,发现需要在CCSwitch中进行“加入映射”操作并配置模型映射。解决方法包括选择新模型、保存配置并重启应用,同时推测直接修改config.toml文件也可能生效。文章提醒开发者注意准确配置模型映射以确保请求正确路由,并附操作截图说明。

2601_96604977的博客 1253

在 Windows 10 中通过 WSL2 安装 vLLM 部署本地大模型的方法和步骤

通过 WSL2 在 Windows 10 中部署 vLLM 的核心优势是兼顾 Windows 生态与 Linux 环境的 GPU 加速能力,适合需要在 Windows 下开发但依赖 vLLM 高性能推理的场景。相比原生 Windows 部署(Ollama 等工具),该方案性能更优(接近原生 Ubuntu),且支持更大模型和量化优化。若追求极致性能,建议直接使用 Ubuntu 系统;若必须依赖 Windows 工具链,WSL2 + vLLM 是当前最优选择。

当 AI 开始写文章、绘星空,甚至预测未来,您还在旁观吗?这里将剖开人工智能的思考逻辑,拆解 AI 创作的底层密码,也聊聊人工智能里的人文温度。每篇都有让你拍案的细节,快来解锁 AI 时代的神奇世界! 3745

GLM-OCR保姆级入门指南:上传图片秒出识别结果

本文介绍了如何在星图GPU平台上自动化部署GLM-OCR镜像,实现高效的图片文字识别。该平台简化了部署流程,用户可快速搭建服务,将图片中的文字、表格或数学公式精准转换为可编辑的Markdown文本、结构化表格或LaTeX代码,极大提升了文档数字化与信息提取的效率。

weixin_35755434的博客 67

黑马Java第二阶段:JavaWeb(笔记)

黑马Java第二阶段:JavaWeb(笔记)

chen的博客 5632

UE4打包为Framework库嵌入iOS原生工程

UE4打包为Framework库嵌入iOS原生工程

tangfuling1991的博客 1291

使用蓝耘MaaS构建Markdown博文配图生成器:模型接入、并行任务与CORS处理_glm5.3 怎么传图片

本项目通过蓝耘MaaS接入GLM5.3作为文本模型,用于开发阶段(Codex协作)和运行阶段(将全文/段落转换为结构化图像指令),图像生成与编辑由Sense U1.5 Lite负责。两组接口独立,便于分别排查问题。使用后端代理保护长期密钥;持久化生成记录、提示词对比和调用日志;利用调用记录比较不同文本模型在“长文理解→视觉指令”任务中的表现差异。本文转自网络,如有侵权,请联系删除。

资料免费分享,点击名片 428

【100%通过率】华为OD机试真题 Python 实现【水库蓄水问题】【2022.11 Q4 新题】

给定一个长度为 n 的整数数组height。数组的元素表示山的高度,选择两个元素作为水库的边界,求蓄水量的最大值并输出蓄水量最大时的边界下标(蓄水量相同时输出下标较近的)。

MISAYAONE的博客 1万+

蓝耘MaaS实战——从Markdown到成套配图,GLM5.3接入、并行生图、失败重试与CORS代理全链路拆解

本文从一个真实需求出发:把 Markdown 长文自动拆解为封面与正文配图任务,并完成生成、微调、回填与导出。项目使用 Vue 3 + Vite 构建前端,文本侧通过蓝耘 MaaS 接入 GLM5.3 负责长文理解和视觉策划,图像侧负责生成与编辑。文章重点拆解模型配置、Prompt 约束、Markdown 安全预览、任务状态机、受控并发、失败重试、Vite 同源代理与生产环境密钥保护,并给出关键代码、排错路径和验证清单。读完可以直接复用这套“文本理解→视觉指令→并行生图→版本编辑→文章回填”的工程思路。

优质创作者: 人工智能技术领域 对于有一定基础的 MATLAB和Python带具体需求都可以详谈 MATLAB和Python可以提供代码调试服务加油 谢谢 你的鼓励是我前行的动力 谢谢支持 加油 谢谢 641

深入理解Android音视频同步机制(三)NuPlayer的avsync逻辑

本文深入介绍了NuPlayer的avsync逻辑和原理

张晖的专栏 1万+

AMBA-CHI协议详解(二)

读事务,写事务,原子事务,Stash事务,Dataless事务,DVM事务,Retry事务。

Crazzy_M的博客 6633

「大车小标」自动稽核怎么落地:识别车型与计费车型如何自动比对、争议如何排除

在高速公路货车逃费里,"大车小标"是最高频、也最难缠的一类:实际是更大车型、更多轴数的货车,却按更小车型交费,跑同样的路交更少的钱。单次差额可能不大,但放到长距离、高频次、规模化运营的路网里,累积的通行费流失相当可观。自动稽核"大车小标",核心不是"识别出这是什么车"这么简单,而是要把多个来源的车型判断和最终计费车型自动比对,并在大量正常交易里把真正可疑的少数挑出来,同时把设备误差、遮挡污染造成的误判排除掉。本文拆解这条链路的工程落地思路,全文定性,不涉及具体识别率与金额。

weixin_53898122的博客 374

杰理AC695N系列芯片 LED7数码管使用教程

杰理AC695N数码管使用摘要 本教程介绍了杰理AC695N芯片驱动LED7数码管的实现方法: 硬件配置:支持7/12/13脚三种数码管类型,详细说明了7脚数码管的标准段码定义和GPIO接线方式。 软件设置: 通过修改配置文件启用LED7功能 配置GPIO引脚映射(PORTC/PORTA组) 选择与硬件匹配的真值表 层次架构:包含硬件层、驱动层、UI层和应用层的完整设计,支持数字、字符和图标显示功能。 实现要点包括正确配置引脚类型、选择真值表,并通过UI风格设置为LED7模式。

qq_42014563的博客 1337

【技术拆解】配音工具选型评估方法论:用 6 个维度给 AI 配音软件打打分

✅ 测试方案:准备一段包含括号注释、数字、中英文混排的文案导入试听,校验读音、停顿是否合理。案例参考:逗哥配音配套了文案提取、自动对轴、人声分离、声音转换等附加工具,支持 wav /mp3 /mp4 格式导出,可附带字幕与 SRT 文件,在字幕对齐、文件导出这条链路具备对应的能力,适合批量生产场景的创作者在这个维度进行自测打分。同一款配音引擎,有人评价 “自然接近真人”,也有人反馈 “AI 感很重”,核心差异往往来自使用场景:30 字以内的短口播,和 3000 字小说章节朗读,对引擎能力要求完全不一样。

zhizhizhuzhuxia的博客 159

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

一文读懂 RSI:大模型递归自进化五大技术路线全景解析

在人工智能领域,递归自进化(RSI) 是指一个 AI 系统不仅能够自主提升自身的任务表现,还能够改进 ⌈产生这种改进的机制本身⌋,从而形成持续迭代的正向飞轮。为了通俗理解 RSI,可以将 LLM 系统下的 RSI 划分为三个递进层级(参考 https://github.com/lobehub/awesome-rsi 、 https://arxiv.org/abs/2607.07663、https://arxiv.org/abs/2607.07663):演进层级通俗比喻核心特征改了什么是否持久化。

分享AI前沿进展、底层原理和行业应用 236

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

外贸独立站 AI 爬虫日志分析:UA 清单、状态码分布与「爬取不等于引用」

日志可反映爬虫访问路径、状态码与UA,但无法证明内容是否被AI引用。需按UA、状态码、路径三层分析,识别可达性问题,避免误判“抓取=引用”。应结合实测验证引用效果,警惕日志误导。关键结论:抓取≠收录≠引用,技术优化仅解决可抓取性,不保证被引用。

mqhgeo的博客 356

LDR6100 智能遥控器精品软文:Type-C 充电口与低功耗量产维护

当 USB-C 接口从单纯的结构升级,变成整机供电稳定性、待机续航、量产一致性的核心瓶颈,智能遥控器、语音遥控器、手持控制器这类小型手持设备的硬件开发,早已不再是 “换一个 Type-C 座子” 那么简单。大量项目在试产阶段反复踩坑:不同品牌适配器识别失败、热插拔瞬间掉电死机、整机休眠待机电流超标导致电池续航缩水、产线测试时端口状态无法捕捉、兼容性参差不齐。乐得瑞 LDR6100 作为单路 USB-C/PD 专用控制芯片,专为小体积手持设备的 Type-C 供电入口量身打造。

LDR006的博客 419

电子厂用易特AI助理做BOM变更影响分析,改一处知道影响哪些单

电子厂BOM改了不知道影响哪些在制订单,容易用旧BOM做错返工。易特电子行业ERP加易特AI助理,改BOM后自动分析影响哪些工单哪些采购哪些物料,出报告通知车间采购。小厂要BOM变更建版本、工单绑定版本、AI报告老板决策、变更通知到人。上线后因变更没通知到位导致的返工降到零,BOM变了大家都知道怎么处理。

2602_96212498的博客 202

8G 显存本地部署 AI 漫剧流水线:分镜提示词版本管理、批量归档与角色提示词隔离实战教程

本文针对8G显存本地部署的AI漫剧生产中提示词混乱、版本丢失、角色画风漂移等痛点,设计并实现一套轻量化本地提示词管理系统。系统基于纯JSON文件存储,支持角色提示词隔离、分镜模板复用、项目版本快照、批量校验与导入导出,与ComfyUI流水线无缝对接,实现画风一致性与高效复现。所有功能均无需数据库,可常驻后台运行,显著提升红果短剧系列化生产的稳定性与可维护性。

2603_96706877的博客 169

32 分钟不是完成科研:多智能体读脑图谱,突破在哪里?

如果数千个 AI 智能体只用 32 分钟,就能梳理一份庞大的脑科学数据,我们应该惊讶什么?是模型终于能“独立做科研”,还是科研流程中的某个环节开始出现新的组织方式?10 月 21 日,OpenAI 公布了与 PerturbAI、Scripps Research 合作的研究:利用基于 GPT-Rosalind 的多智能体系统,解释一份已经存在的小鼠脑基因扰动数据,整理潜在研究线索。

weixin_44369324的博客 263

图像审核‑图片内容风控‑违规图像检测‑图片鉴黄鉴暴‑广告二维码识别‑图像风险筛查 API 接口介绍

名称类型必须说明imgBase64String否图像base64字符串imgFilefile否图像文件imgUrlString否图像url链接imgTypeString否图片类型 0: 静态图片(PNG、JPG、JPEG、BMP、GIF(仅对首帧进行审核)、Webp、TIFF)1: GIF动态图片 默认 0注意imgFile, imgBase64, imgUrl至少传入一个,优先级:imgBase64 > imgFile > imgUrl。

聚美智数 251

AI辅助逆向的完整链路——反汇编→特征提取→大模型重写

编译后的程序(PE/ELF/Mach-O)丢失了源代码几乎所有高层语义:变量名、注释、类型、函数命名、循环分支结构,只剩下CPU能识别的机器码。传统逆向链路:机器码 → 反汇编(汇编指令)→ 人工阅读 + 静态分析工具生成伪C → 人工梳理逻辑。优化编译、混淆、花指令会把控制流打碎,伪代码可读性极差;无符号剥离(stripped binary)下所有函数都是FUN_xxxx,变量全是v1、v2;单函数上下文有限,跨函数调用、数据依赖靠人脑记忆,效率极低;

weixin_43156294的博客 208

零信任架构实战:基于海宇全国车辆配置查验构建自动化智慧高速公路称重检测与ETC货车车型分类比对网关

破解高速公路货车车型分类与治超比对痛点:从人工目测验票到车管权威配置数据即时直连 在全国深化收费公路制度改革、全面取消省界收费站以及大力推行“入口称重检测、按车型分类计费(JT/T 489-2019《收费公路车辆通行费车型分类》)、ETC不停车电子收费”的智慧交通体系中,高速公路ETC自由流门架系统与入口动态称重治超检测中台承担着高速通行效率与道路交通安全治

haiyuzhicha的博客 193

我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内容,你们AI导出鸭可以吗?

很多人第一次听到“导出对话”,脑子里浮现的是打开某一条聊天记录,右上角点一下导出,保存成一份文件。这不是为了设门槛,而是因为批量导出背后的枚举、并发、格式渲染成本,和单条导出完全不是一个量级。AI导出鸭 不做格式绑架,这是它作为导出工具的基本修养。回到标题那个问题:我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内,你们AI导出鸭可以吗?批量导出和选择性导出并不冲突,工具的设计逻辑是先枚举、再选择、后导出。我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内容,你们AI导出鸭可以吗?

laoyunsi的博客 121

主机 Agent:用 AI 操作本地与远程主机

本章适合这样的任务:你已经在 aiopsterm 中保存并连接了一台主机,希望让 AI 帮你完成诊断、命令生成或多步运维,同时保留明确的目标主机和审批边界。

woai110120130的专栏 160

【工业AI实战】工业智能体如何打通RAG、工具调用与MOM?架构设计与落地避坑

麦肯锡与Anthropic研究揭示,AI虽提升个人效率,但企业级高绩效应用仍受限。工业智能体正从生成答案转向任务规划、工具调用与连续执行,推动制造业AI向系统化演进。其核心在于构建融合任务理解、知识检索、工具调用、权限控制与验证反馈的技术架构,并与MOM系统协同,实现自然语言交互与业务流程闭环。技术选型应基于场景需求,优先结合RAG与结构化查询,逐步引入知识图谱与微调。工业智能体落地关键在于真实环境中的可靠性、安全性和可验证价值,而非单一模型表现。

qq_40453532的博客 357
上一篇: 多智能体协作故障复盘,应该留下什么
下一篇: 图片、手写字、数学公式都能识别:本地部署 PaddleOCR-VL,搭一个自己的 OCR 工具
码龙大大
博客等级 码龄5年 1万+粉丝 2306原创
评论 164
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值