COD论文笔记VSCode: General Visual Salient and Camouflaged Object Detection with 2D Prompt Learning

VIPCOD论文笔记VSCode: General Visual Salient and Camouflaged Object Detection with 2D Prompt Learning
VSCode模型通过引入领域特定提示和任务特定提示,结合提示区分损失,成功地在单一模型中处理多个显著目标检测和伪装目标检测任务。这种方法不仅提高了模型的性能,还展示了其对未见任务的泛化能力。作者使用 Visual saliency transformer ICCV 2021 作为baseline model这张图展示了VSCode模型的整体框架,特别强调了2D提示学习方法。
开通可读全文 ·1.6k 人阅读
最低0.47元/天 解锁文章

论文概要

这篇论文提出了一个名为VSCode的通用模型,用于处理显著目标检测(SOD)和伪装目标检测(COD)任务。该模型采用了一种新颖的2D提示学习方法,通过在编码器-解码器架构中引入2D提示来学习领域和任务特定的知识,并通过提示区分损失来优化模型。VSCode在多个任务和数据集上超越了现有的最新方法,并展示了对未见任务的零样本泛化能力。

主要内容

  1. 引言:

    • SOD和COD都是二元映射任务,涉及多种模式,具有共同性和独特线索。
    • 现有研究通常使用复杂的任务特定模型,可能导致冗余和次优结果。
    • VSCode是一个通用模型,利用VST作为基础模型,并在编码器-解码器架构中引入2D提示,学习领域和任务特定的知识。
  2. 方法:

    • 基础模型:选用VST作为基础模型来捕获SOD和COD任务的共性。
    • 领域特定提示:在编码器中引入四种领域特定提示(RGB、深度、热图和光流)来突出不同领域的差异。
    • 任务特定提示:在编码器和解码器中引入任务特定提示,分别学习SOD和COD任务的特定特征。
    • 提示区分损失:提出了一种提示区分损失,以有效分离领域和任务的特定知识。
  3. 实验:

    • 进行了大量实验,验证了VSCode在多个任务和数据集上的性能优越性。
    • 通过消融研究评估了不同设计组件的有效性,证明了2D提示和提示区分损失的有效性。
  4. 结果和讨论:

    • VSCode在26个数据集上的表现优于现有的最新方法。
    • 展示了VSCode对未见任务(如RGB-D COD)的零样本泛化能力。

动机、贡献、创新点

论文动机

现有的显著目标检测(SOD)和伪装目标检测(COD)方法通常采用复杂的、特定任务的模型,导致冗余和性能次优。此外,单独为每个任务设计模型需要大量的数据和时间,且可能导致模型过拟合,泛化能力差。因此,需要一种通用模型来同时处理多个SOD和COD任务,从而充分利用所有数据,减少过拟合风险,并提高模型的泛化能力。

论文贡献

  1. 通用模型VSCode:提出了第一个能够处理多模态SOD和COD任务的通用模型VSCode。
  2. 基础分割模型:使用基础分割模型来聚合不同任务的共性,并引入2D提示来学习领域和任务的特性。
  3. 提示区分损失:提出了提示区分损失,有效增强了2D提示和基础模型对特性的学习能力。
  4. 性能超越现有方法:VSCode在26个数据集上的六个任务中表现超越了所有现有的最新方法,并展示了对未见任务的零样本泛化能力。

创新点

  1. 2D提示学习:首次在SOD和COD任务中引入2D提示学习方法,通过在编码器-解码器架构中引入领域特定和任务特定的提示,分别捕获不同领域和任务的特性。
  2. 提示区分损失:提出了提示区分损失,旨在最小化同类型提示之间的相关性,确保每个提示获取独特的领域或任务知识。
  3. 通用模型架构:设计了一个简单而有效的架构,通过联合训练多个任务,显著降低了模型的复杂性、计算成本和参数量。
  4. 零样本泛化能力:VSCode展示了强大的零样本泛化能力,可以通过组合不同的领域和任务提示,处理未见任务。

通过这些创新,VSCode不仅提高了SOD和COD任务的性能,还展示了其在处理多模态任务方面的潜力。

Methodology 概要

方法论概要

这篇论文提出了一种名为VSCode的通用模型,用于处理显著目标检测(SOD)和伪装目标检测(COD)任务。下面是其方法论的通俗总结:

  1. 基础模型:

    • 使用一种称为VST(视觉显著性转换器)的模型作为基础模型。这个模型通过编码器和解码器架构来处理图像,捕获图像中不同部分之间的关系。
    • VST模型能够同时处理多个任务,并且通过共享参数,能够学习到不同任务之间的共性。
  2. 领域特定提示:

    • 论文引入了四种领域特定的提示(RGB、深度、热图和光流),这些提示帮助模型理解来自不同领域(例如RGB图像、深度图像等)的特性。
    • 在编码器的每一层中,这些提示都会被添加到图像特征中,帮助模型更好地分离不同领域的特性。
  3. 任务特定提示:

    • 为了区分显著目标检测和伪装目标检测,模型在编码器和解码器中都引入了任务特定的提示。
    • 这些提示帮助模型在编码阶段理解哪些特征与任务相关(如显著目标或伪装目标),在解码阶段精确地重建目标的边界和区域。
  4. 提示区分损失:

    • 为了确保领域特定提示和任务特定提示能够分别学习到独特的知识,论文提出了一种提示区分损失。
    • 这种损失函数通过减少提示之间的相似性,确保每个提示都能专注于学习特定的领域或任务信息。
  5. 2D提示学习架构:

    • 在整个模型中,领域特定提示和任务特定提示在不同层次上被结合使用,以捕获低层次的特征(如边缘、颜色)和高层次的语义信息(如目标形状、位置)。
    • 编码器通过逐层引入领域特定提示,解码器通过任务特定提示精确重建目标,确保模型能够处理不同的SOD和COD任务。

总结

VSCode模型通过引入领域特定提示和任务特定提示,结合提示区分损失,成功地在单一模型中处理多个显著目标检测和伪装目标检测任务。这种方法不仅提高了模型的性能,还展示了其对未见任务的泛化能力。

作者使用 Visual saliency transformer ICCV 2021 作为baseline model

模型配图
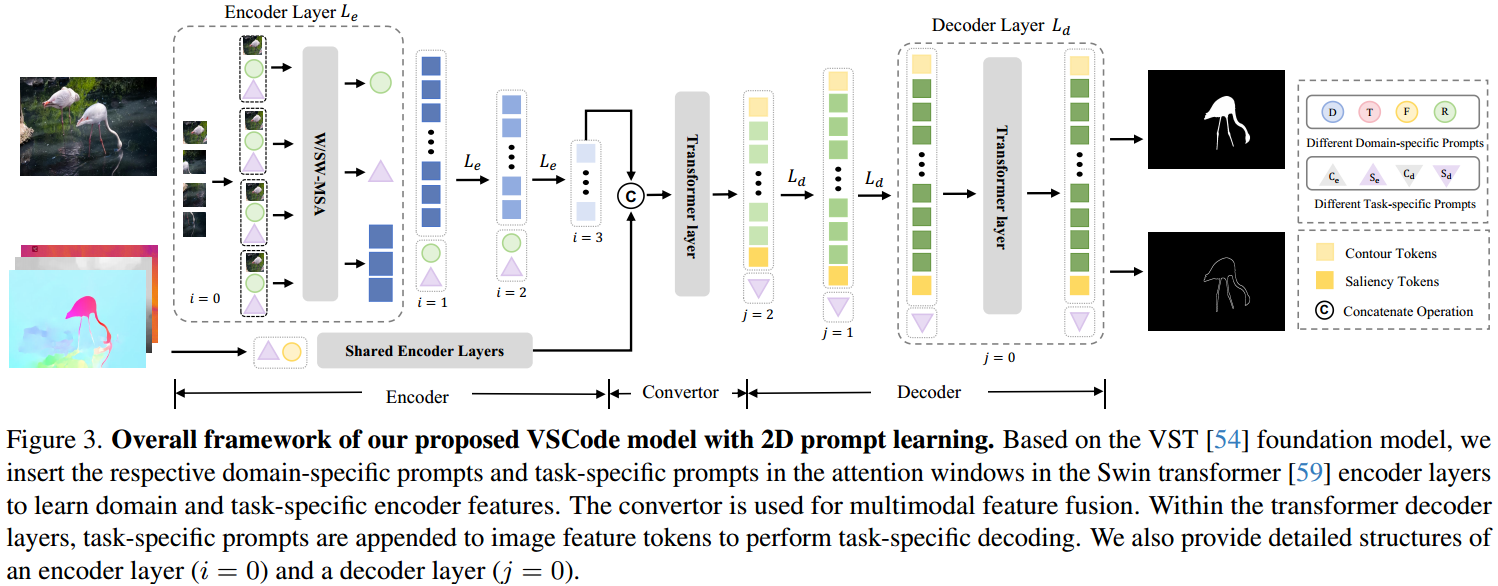
在这里插入图片描述

图3. VSCode模型的整体框架

概述

这张图展示了VSCode模型的整体框架,特别强调了2D提示学习方法。该模型基于VST(Visual Saliency Transformer)基础模型,采用Swin Transformer的编码器层进行领域和任务特定提示的学习。模型通过共享的编码器层、转换器和解码器层,最终实现显著目标检测和伪装目标检测的任务。

详细解释
编码器部分
  1. 输入图像:

    • 输入的图像可以是RGB图像、深度图、热图或光流图,代表了不同的领域。
  2. 领域特定提示 (Domain-specific Prompts):

    • 在Swin Transformer编码器层(LeL_eLe​)的注意窗口中插入了领域特定提示。这些提示帮助模型学习领域特定的编码器特征。
    • 图中用不同颜色和符号表示不同的领域提示,例如,D(深度)、T(热图)、F(光流)、R(RGB)。
  3. 任务特定提示 (Task-specific Prompts):

    • 在编码器层中还插入了任务特定提示,这些提示帮助模型学习任务特定的特征。任务特定提示包括显著目标检测(SeS_eSe​)和伪装目标检测(CeC_eCe​)。
    • 在图中,这些提示分别用不同的符号表示。
VIP 【SOD论文阅读笔记】Visual Saliency Transformer 开通可读全文·1.4k 阅读·2 点赞·12 收藏 阅读全文

相关推荐

Visual Saliency Transformer 读后感

最近一直在忙着搞各种杂活 好久没有认真的读文章了 之前做的是 SOD,因为transformer的兴起,就想试试它在SOD里的效果。因为论文审稿意见下来,拖了很久,一直没有实现,现在先读一下这篇paper,找找感觉。 paper: https://arxiv.org/pdf/2104.12099.pdf 摘要:近年来,基于CNN架构的海量显著性检测方法取得了很好的效果。或者,我们从无卷积的序列到序列的角度重新考虑这项任务,并通过对长期依赖关系进行建模来预测显著性,这不能通过卷积来实现。具体地说,我们开发了一

小桑泥‘s daily life 1621

[VST]Visaul Saliency Transformer网络结构 数据流

最后,将encoder提取的 rgb_fea_1_8, rgb_fea_1_4 ,和以上特征进行解码处理,获得最后原尺寸,1/4,1/8,1/16大小的预测图,包含边界预测图和显著预测图。最后提取的特征送入decoder进行解码。我们使用网络最深层提取的特征,也是网络提取的池逊最小的特征经过converter进行进一步处理,尺寸不变。其中,x的尺寸和另外两个尺寸最后一个维度不一样是因为经历了一个变换层,输出维度为384。其中,在经过T2T模块后,分别获得了几个不同尺寸的feature map。

qq_43742531的博客 257

VST SDK 3.x 开发(一):VST结构介绍

一、VST音频插件 VST(Virtual Sound

oursrabbit的专栏 7343

AMD硬件环境搭建SSD目标检测平台:Win10+VSCode+Tensorflow2.2-CPU版

AMD硬件环境搭建SSD目标检测平台:Win10+VSCode+Tensorflow2.2-CPU版环境SSD源码前言一、Anaconda安装1.简介2.下载3.安装二、TF2环境搭建三、VSCode安装1.安装2.设置个性化 环境 CPU:AMD Ryzen 7 4800H GPU:AMD Radeon™ Graphics Anaconda3-2019.10-Windows-x86_64.exe Tensorflow 2.2.0 SSD源码 源码链接:https://github.com/bubblii

weixin_50514036的博客 1663

TPAMI 2024 | VST++:高效且强大的视觉显著性Transformer

尽管先前的基于CNN的模型在显著目标检测(SOD)方面展现出了有希望的结果,但它们探索全局长距离依赖性的能力受到限制。我们之前的工作,视觉显著性变换器(VST),从基于变换器的序列到序列的角度解决了这一限制,统一了RGB和RGB-DSOD。在VST中,我们开发了一个多任务变换器解码器,可以同时预测显著性和边界结果,采用纯变换器架构。此外,我们引入了一种新颖的标记上采样方法,称为反向T2T,以轻松预测高分辨率显著性图,而无需在基于变换器的结构中进行复杂的操作。

小白学视觉 345

【深度学习新浪潮】显著性检测最新研究进展(2022-2025)

VST++作为当前SOTA方法,在多模态检测中表现优异,且通过SIA模块显著降低计算成本。其开源代码和预训练模型(GitHub)支持快速部署。对于工业场景,可进一步探索Samba等实时检测方案。

专注:太空算力、AI infra、异构调度、大模型成本工程 607

HFSS线圈仿真避坑指南:从建模到寄生参数分析的完整流程

本文详细介绍了HFSS线圈仿真的完整流程,从精准建模到寄生参数优化,特别针对Ansys Electronics Desktop用户提供实用指南。涵盖线圈几何构建、材料属性配置、端口激励设置及寄生电阻与电感分析等关键步骤,帮助工程师避免常见错误,提升仿真精度与效率。

weixin_29209801的博客 541

智能安防摄像头埋点实践:用户行为与设备状态的闭环监控(含AI事件)

智能安防摄像头埋点闭环体系设计及应用实践 摘要: 本文系统阐述了智能安防摄像头埋点闭环体系的设计与实践。首先分析了传统埋点的不足及闭环埋点的价值,提出由用户行为埋点、设备状态埋点和AI事件埋点构成的三维埋点体系框架。详细介绍了闭环监控的四大流程:数据采集、汇聚清洗、分析建模和智能决策。通过误报优化、个性化策略等案例展示了AI事件闭环的实际应用价值,并探讨了隐私合规、性能优化等关键挑战的解决思路。最后展望了端侧AI增强、预测型埋点等未来发展趋势。该体系实现了从数据采集到业务决策的完整闭环,有效提升了AI模型性

专注智能硬件软硬件产品经理成长与实战,分享从需求定义到量产落地的真实日记。涵盖IoT趋势洞察、研发协作经验、产品方法论与工具箱,用轻松有趣的“汪式”视角,陪伴产品经理成长、避坑与升级。 1039

STM32H7串口DMA避坑指南:如何解决RT-Thread默认驱动不支持的问题

本文针对STM32H7在RT-Thread系统中启用串口DMA时遇到的驱动不支持问题,提供了详细的解决方案。通过分析问题根源,指导修改驱动代码以适配H7的DMA Stream架构,并调整内存配置确保DMA可访问性,最终实现稳定高效的串口DMA通信。

weixin_29179311的博客 421

销售预测的方法与模型(三)丨安全库存与再订货(补货)

较高的 Z 值对应较高的服务水平(例如,服务水平 99% 对应 Z 值 2.33),意味着企业希望更低的缺货风险,因此需要更高的安全库存。在再订货点的管理中,考虑到供应商交货的不确定性,通常需要结合安全库存,以防止在交货期间库存用尽。要对L开根号,根号L表示交货周期越长,企业需要的安全库存越多,因为在较长的供应期内,需求波动的累积效应更明显。举例:供应商的交期服从标准差为2件/天的正态分布,顾客需求为50件/天的正态分布,若要客户服务水平达到 90%,安全库存量应该是多少?下面介绍几种核心的模型与公式。

weixin_45675709的博客 1524

手把手拆解固态电池成本:2030年真能比液态电池便宜30%吗?

本文深度解析固态电池成本结构,探讨2030年实现比液态电池便宜30%的可行性路径。通过拆解正极材料、负极材料和固态电解质的成本演变,分析关键技术对降本的影响,并预测产业链协同效应下的成本优化趋势。文章指出,在材料创新、设备国产化和政策支持等多重因素推动下,固态电池有望在2030年实现显著降本目标。

kite3的博客 384

WordPress插件depicter存在SQL注入漏洞(CVE-2025-2011)

Depicter 是一款功能强大的 WordPress 幻灯片插件,允许用户通过直观的拖放编辑器轻松创建响应式滑块、轮播和动态内容展示。该插件提供丰富的模板库、动画效果和图层控制,支持多媒体内容嵌入(如图片、视频、HTML),并优化了移动端显示和SEO性能。其无代码操作界面适合非技术用户,同时提供高级自定义选项,适用于产品展示、营销推广和视觉叙事等多种场景,是提升网站视觉吸引力的高效工具。

m0_50125527的博客 549

【Codecs系列】HEVC-SCC(一):核心技术介绍

DATE: 2020.6.4【Tags: HEVC SCC】 1、参考网址 2、SCC简介 3、HEVC-SCC核心技术

CSDN明星博主,认证博客专家,视频、Matlab领域优质创作者。 4791

流体动力学仿真软件:CFX_(10).案例实践:复杂流场分析

在“Phases”选项卡中,定义参与仿真的不同相。例如,如果您要分析气液两相流,可以定义“Air”和“Water”两个相。

kkchenjj的博客 1675

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

上一篇: 论文笔记 Explicit Visual Prompting for Low-Level Structure Segmentations
下一篇: COD论文笔记 CamoDiffusion: Camouflaged Object Detection via Conditional Diffusion Models_AAAI_2024

双11狂欢大促

盲盒赢 定制羽绒服

开启惊喜盲盒,抽取你的专属好礼

— 惊喜奖品抢先看 —
Wils0nEdwards
博客等级 码龄9年 2163粉丝 379原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值











