




目录
前言
登录认证、数据存储、消息通知、日志监控、配置管理、错误处理、性能优化——这七件事几乎在每个项目里都会出现,因此也被称为"通用功能"。通用功能有个迷惑性:它们看起来都不复杂,任何一个新手都能写出一个"能跑"的版本。但正是这种能跑的假象,让大量项目在用户量上来之后被安全漏洞、性能瓶颈和排查噩梦轮番教训。
通用功能还有一个共同特点:它们的失败模式高度重复。全世界的团队会犯几乎一模一样的错误——MD5存密码、密钥提交进Git、静默吞掉异常、凭感觉做优化。这意味着这些领域的经验可以最大程度地复用,新项目没有必要重新交一遍学费。
本文总结七条经过大量项目验证的注意事项,每条再分小节展开。核心精神可以概括为一句话:专业的事交给专业的库,显式的约定交给统一的规范,优化的决策交给真实的数据。
1. 用户认证:永远不要自己造轮子
1.1 密码存储:从MD5到慢哈希
认证系统是"自己写一个看起来能跑"和"实际安全"差距最大的模块。最常见的自造陷阱是用MD5或SHA-256直接哈希密码且不加盐。这里有两个独立的错误:MD5这类哈希设计目标是"算得快",攻击者拿到数据库后用显卡每秒可以尝试数十亿个密码,专门的彩虹表还能让常见密码瞬间现形;不加盐则让相同密码哈希值相同,破解一个等于破解一片,还可以用预计算表批量命中。
正确做法是使用专为密码设计的慢哈希算法bcrypt或argon2,它们自动处理加盐,并通过故意提高单次计算成本(可调节的工作因子)来抵抗暴力破解——慢一点反而是安全特性,随着硬件进步还可以调大成本参数。用法本身只有两行,复杂度全部封装在专业库里:
# 密码存储只需要两行,算法的安全性交给专业库
hashed = pwd_context.hash("用户密码")      # 注册时
ok = pwd_context.verify("用户密码", hashed) # 登录时
1.2 会话Token与配套安全纪律
第二个陷阱是手写Token:用base64编码一个JSON就当身份凭证,没有签名,任何人改一下用户ID就能伪造身份,而且永不过期、无法吊销。Token要用成熟的JWT库签发和验签,密钥从环境变量读取而非硬编码,过期时间、刷新机制、泄露后黑名单吊销都要考虑;权限敏感的操作还要二次验证,不能只凭Token放行。
除此之外还有几条不能省的配套纪律:所有认证请求强制HTTPS,防止凭证在网络中被截获;登录接口限制失败次数并叠加验证码和设备风控防暴力破解;OAuth第三方登录直接用Authlib等成熟库而不是自己拼签名协议;定期升级依赖版本——安全库的价值有一半来自及时补丁,一个锁死在三年前版本的加密库等于没设防。
2. 数据存储:让数据特性决定数据库,而不是习惯
2.1 五种数据,五种归宿
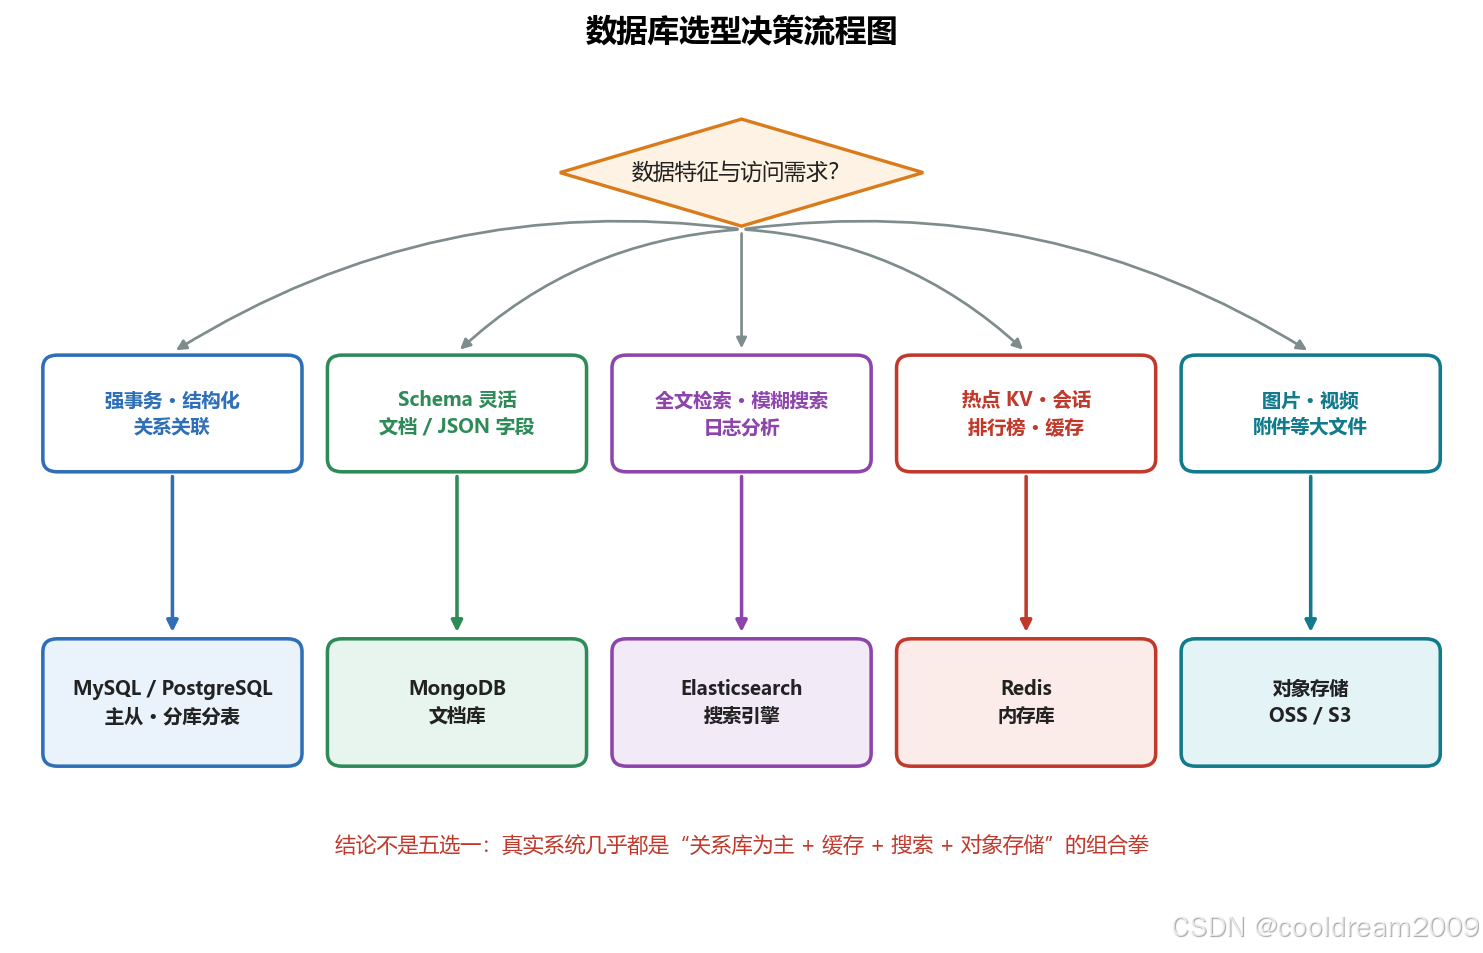
很多项目不管什么数据都往MySQL里塞:用户画像存成JSON文本字段,操作日志也拼成大文本,文件直接以二进制形式入库。初期确实省事,数据量一上来,画像无法按字段查询、日志表膨胀拖垮整库、备份窗口无限拉长,迁移代价远高于当初的选型成本。正确的思路是先分析数据的结构、访问模式和规模,再选存储:
| 数据类型 | 典型数据 | 推荐存储 | 选择理由 |
|---|---|---|---|
| 结构化、强一致 | 用户、订单、账户 | MySQL/PostgreSQL | 事务、外键、复杂查询 |
| 热点缓存、会话 | 会话、商品详情、计数 | Redis | 内存级读写,支持过期 |
| 半结构化、Schema多变 | 用户画像、配置 | MongoDB | 文档模型,字段可演进 |
| 全文检索、日志分析 | 文章、商品、操作日志 | Elasticsearch | 倒排索引,分词与聚合 |
| 大文件 | 图片、视频、附件 | 对象存储(OSS/S3) | 几乎无限容量,配合CDN |
现实系统几乎都是"Polyglot Persistence"(多形态持久化)的组合:订单在MySQL、商品详情缓存于Redis、画像落在MongoDB、日志进ES、文件存OSS,各司其职。
2.2 资金数据的红线
特别强调一点:钱和账相关的数据只能放在支持事务的关系库,不要为了性能用缓存当最终存储。缓存可以加速读、可以预扣库存,但每一笔资金变动的权威记录必须在带事务的数据库里有流水可查,缓存失效、重启、丢数据都不能影响账。这条红线没有商量余地,很多"先上Redis以后再说"的方案最后都以对账事故收场。
2.3 选型之后的四件配套事项
选完库不等于结束,后面还有四件事。读多写少做主从读写分离,但要接受主从延迟带来的短暂不一致并设计兜底;单表超量再考虑水平分库分表,分片键选错(比如后续大量跨片查询)后患无穷;备份必须定期做恢复演练——只备份不验证等于没备份,没人知道那份备份能不能用;慢查询、连接数、磁盘水位纳入日常监控,存储层的问题往往在业务洪峰到来时才暴露,平时没有监控就是裸奔。
3. 消息通知:多渠道、可降级、异步化
3.1 按重要性规划渠道与降级链
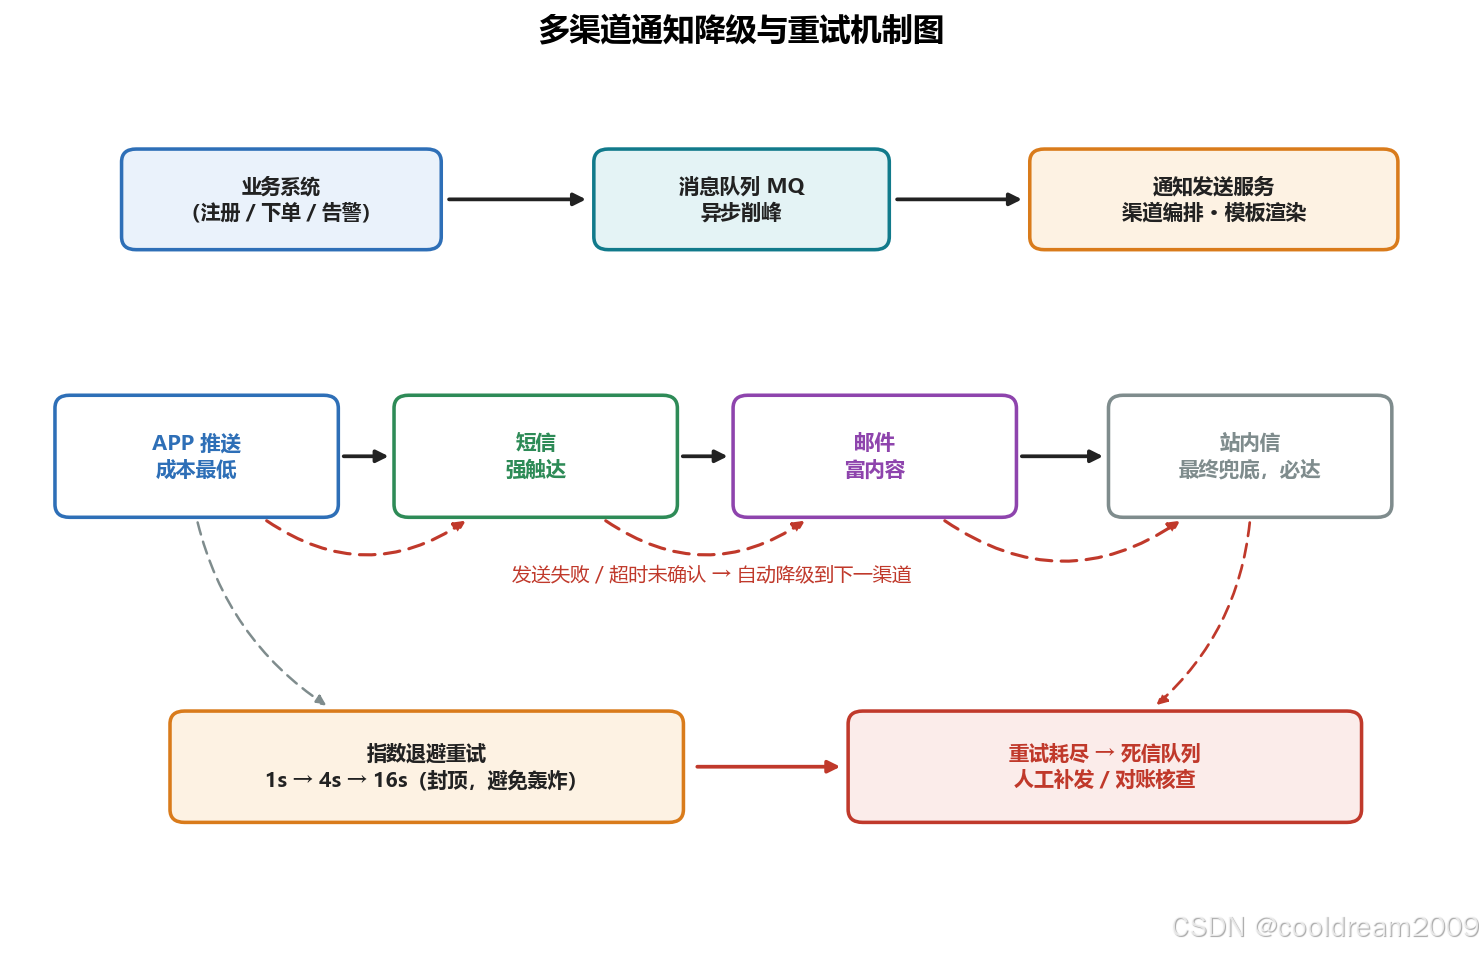
只接一个通知渠道(比如只发邮件)的系统,在渠道故障或邮件进垃圾箱时彻底失联。通知模块首先要按消息重要性规划渠道组合:验证码走短信,订单状态走APP推送加站内信,营销内容走邮件或订阅消息,紧急告警可以电话外呼。发送时采用降级链策略:主渠道失败自动尝试备用渠道,比如APP推送未送达转短信,短信失败再转邮件,任一渠道成功即止,避免对同一用户多渠道重复轰炸。
3.2 异步解耦、指数重试与通知台账
架构上通知发送必须与业务主流程解耦:业务系统只负责往消息队列投递"通知事件",通知服务异步消费,避免短信服务商卡顿拖慢下单接口——下单接口的耗时里绝不应该包含一次外部HTTP调用。发送失败按指数退避自动重试(2秒、4秒、8秒),超过次数进入死信队列人工介入;所有发送尝试都记录状态,形成可核对的通知台账,客诉"我没收到验证码"时一查便知是没发、被拦截还是用户填错号码。
3.3 用户侧治理:通知是服务,泛滥是骚扰
容易被忽视的是用户侧治理:尊重免打扰时段和渠道开关,营销短信必须给退订入口,推送频次按用户疲劳度控制——通知发得准是服务,发得滥就是骚扰,轻则用户关闭通知权限,重则触发渠道封号和监管投诉。营销通知与事务通知要走独立通道和独立签名,防止营销内容连累验证码的送达率。
4. 日志:分级、结构化、可追溯
4.1 五个级别,五种策略
日志的坑有两种极端:关键流程不打日志,出事时两眼一抹黑;或者用print到处输出,字符串拼接、格式各异,磁盘爆满也查不出东西。专业做法的第一个关键词是分级使用,不同级别对应不同处理方式,生产环境的默认级别和告警策略必须事先定好:
| 级别 | 用途 | 生产环境策略 |
|---|---|---|
| DEBUG | 调试细节、请求参数 | 默认关闭,需要时临时开启 |
| INFO | 关键业务节点:登录、下单、支付 | 正常记录 |
| WARN | 异常但可容忍:重试、降级触发 | 记录并观察趋势 |
| ERROR | 业务失败、外部依赖故障 | 记录全堆栈,触发告警 |
| FATAL | 系统不可用 | 立即告警,电话叫醒 |
级别使用要有纪律:异常被正常降级处理了就记WARN而不是ERROR(否则告警全是噪声),预期内的业务分支(密码错误)记INFO即可,真正的ERROR一条都不许漏。
4.2 结构化日志:让日志可被机器查询
第二个关键词是结构化。日志输出JSON而不是自由文本,user_id、order_id、action、cost_ms、trace_id都作为独立字段,才能在ELK或Loki里按字段检索、聚合和告警;一次请求贯穿多个服务时,靠trace_id把散落各处的日志串成完整链路。异常日志必须带堆栈和业务上下文(当时操作哪个订单、参数是什么),光记一句"处理失败"没有任何排查价值。
4.3 脱敏、轮转与集中收集
第三个关键词是脱敏与纪律:密码、身份证、银行卡、完整手机号绝不进日志,这条要在代码评审和日志采集侧双重把关,防止日志平台反而成为最大的敏感数据集散地。日志文件配置按大小轮转并保留有限份数,防止单机磁盘被打满;生产日志统一收集到中心平台后本地即可清理。日志还要讲"性价比":循环里打日志、把大对象整体序列化进日志,会在高并发下反过来拖慢系统。
5. 配置管理:环境隔离,密钥离库
5.1 从硬编码到环境变量、配置中心
把数据库密码和第三方API密钥写在代码里提交Git,是最普遍也最危险的坏习惯——代码仓库的可见范围往往远超生产环境的授权范围,历史记录里的密钥即使删除也永久可查,而代码一旦被推到公开仓库,自动化爬虫会在几分钟内扫描并利用其中的密钥。配置管理的标准方案分两个环境:开发阶段用.env文件存放配置并将其加入.gitignore(提交一份.env.example只保留键名),程序启动时加载;生产环境使用Apollo、Nacos等配置中心或容器环境变量注入,密钥还可进一步交给KMS托管,连配置中心里都不明文存放。
5.2 分门别类、启动即失败
配置本身要分门别类:连接信息、线程池参数、第三方密钥、功能开关各归其位;非敏感参数给合理默认值,必填项(如数据库地址)在服务启动时立即校验,缺失就拒绝启动——让配置错误在启动瞬间暴露,而不是在凌晨三点以空指针的形式暴露。布尔开关要防"配了个错别字被当成true"之类的解析陷阱。
5.3 热更新、灰度与回滚
配置中心还要支持灰度发布和一键回滚:运营类参数(活动开关、限流阈值)热更新生效无需重新部署,变更要有审计(谁改的、改了什么);但涉及连接重建的配置变更(数据库地址、线程池大小)仍需谨慎,最好提供"变更预览"确认影响面,并且配置中心本身要高可用——它一旦挂掉,所有依赖它启动的服务都会受牵连,客户端必须有本地快照缓存兜底。
6. 错误处理:统一体系,对用户温和、对日志诚实
6.1 三种混乱症状与统一异常体系
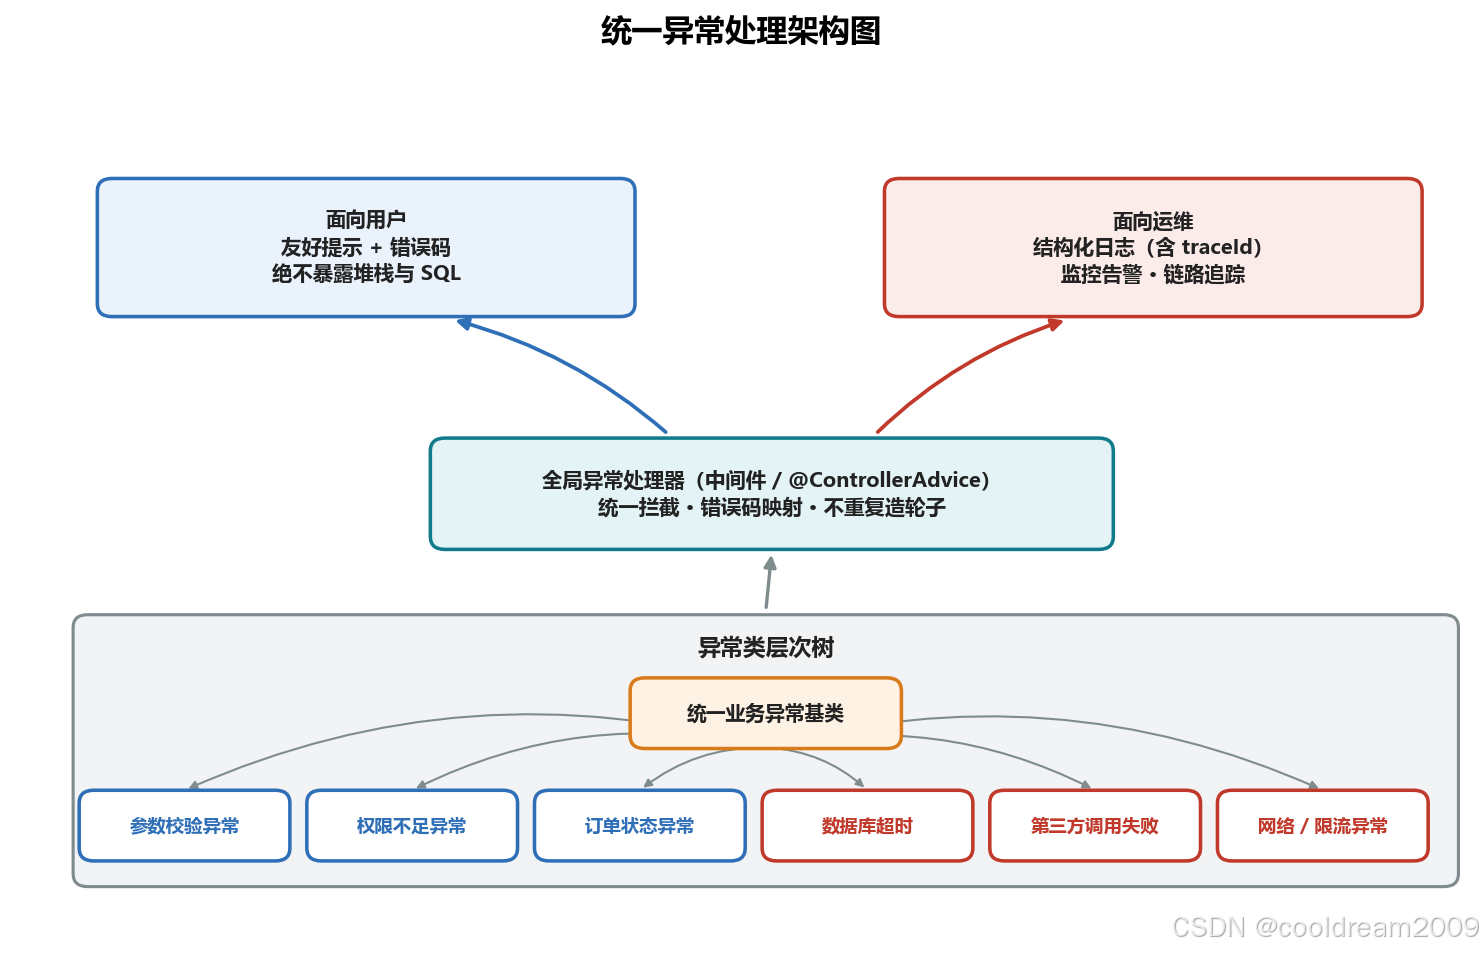
错误处理混乱的项目有三个典型症状:有的地方抛异常、有的地方返回错误码、有的地方返回None,调用方无所适从;前端直接把SQL syntax error之类的技术细节弹给用户;except: pass静默吞掉异常让问题消失在空气里。治理的第一步是建立统一异常体系:定义应用异常基类(携带错误码、用户可读信息、内部详情),再派生出参数校验异常、资源不存在异常、业务规则异常、权限异常等类别,每类有明确的语义和HTTP映射:
| 异常类别 | HTTP语义 | 对用户的提示 | 内部处理 |
|---|---|---|---|
| 参数校验异常 | 400 | 指出哪个字段不合法 | 记录请求摘要 |
| 未认证/无权限 | 401/403 | 引导登录或提示无权访问 | 记录安全审计 |
| 资源不存在 | 404 | 友好的空状态提示 | INFO级即可 |
| 业务规则异常 | 400/409 | 说明业务原因(如库存不足) | 记录业务上下文 |
| 未知系统异常 | 500 | 统一提示"系统繁忙,请稍后再试" | ERROR+全堆栈,触发告警 |
6.2 全局处理器:一处拦截,统一出口
第二步是在框架层注册全局异常处理器,所有异常在出口处统一转换为固定结构的响应(错误码、提示信息、追踪ID),业务代码因此只需抛出语义明确的异常,不必每个接口写重复的try-catch。错误码要全局唯一且分段规划(1xxxx参数类、2xxxx用户类、3xxxx订单类),客户端才能按码做差异化处理。
6.3 两条铁律:不吞异常,不泄细节
两条铁律必须守住。第一,异常要么处理、要么继续向上抛,禁止静默吞掉;实在要兜底也要记录日志并打点告警,“吞异常"等于给未来的自己埋定时炸弹。第二,面向用户的错误信息要说"怎么办”(网络异常请重试、库存不足请减少数量),但绝不暴露堆栈、SQL、内部地址、中间件版本等技术细节——那既是糟糕的体验,也是送给攻击者的侦察情报。
7. 性能优化:没有度量,就没有优化
7.1 四步闭环:监控、分析、优化、验证
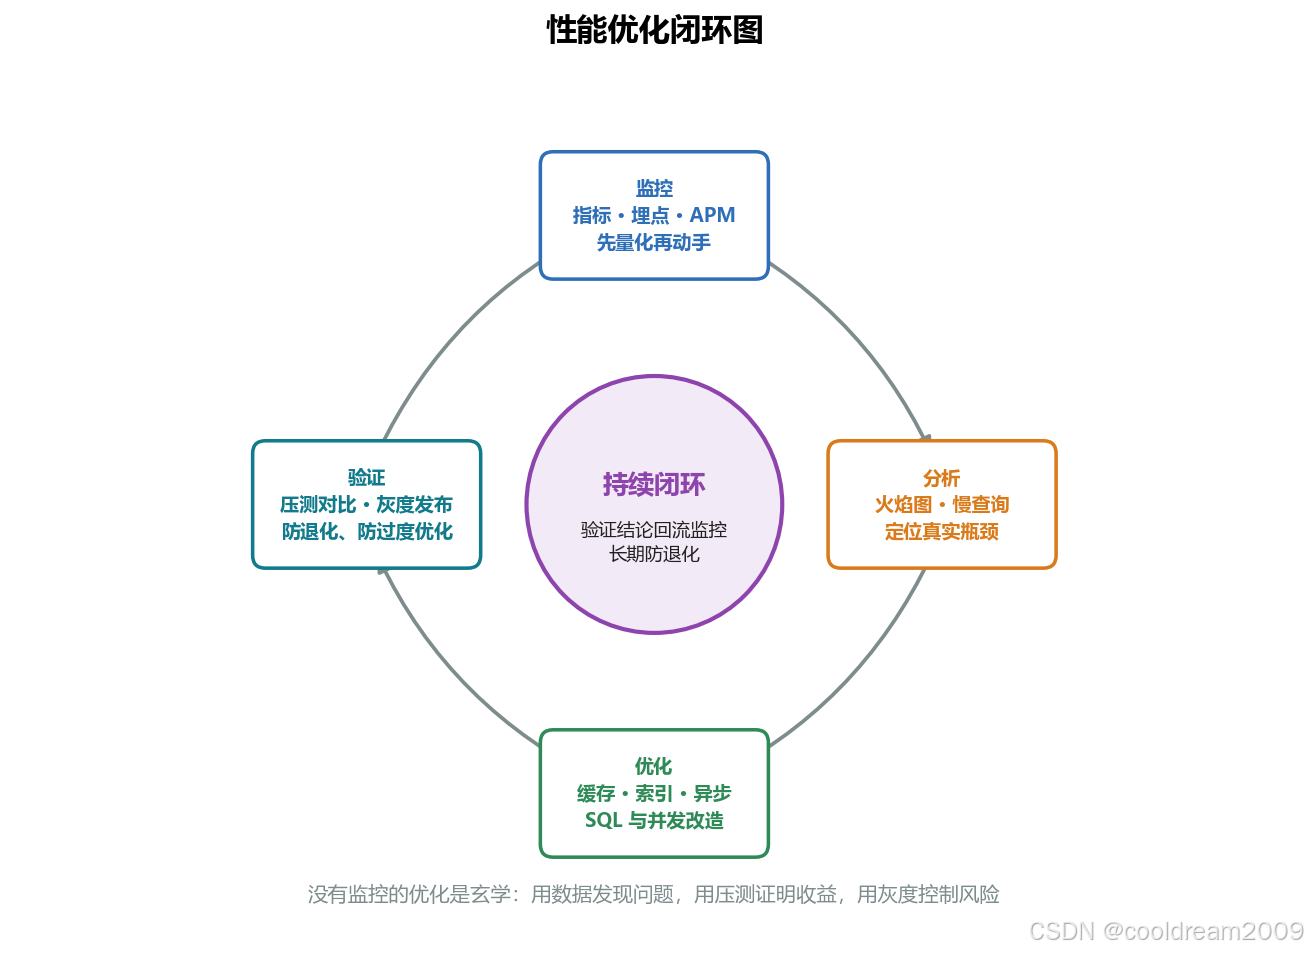
性能问题上最昂贵的错误是"凭感觉优化":觉得数据库慢就加索引,觉得调用多就上缓存,忙了一周接口延迟毫无变化——因为真正的瓶颈在一个外部HTTP调用上。科学优化是一个四步闭环:先监控、再分析、后优化、终验证。
第一步在没有性能问题时就要把度量埋好:接口P50/P95/P99延迟、错误率、依赖调用耗时进入Prometheus类监控系统,关键函数计时上报,并用真实用户监控覆盖线上环境。第二步用数据定位瓶颈,APM和分布式链路追踪(OpenTelemetry、SkyWalking)能把一次请求在各服务、各SQL上的耗时画成火焰图,最慢的那一段无所遁形。
7.2 常见真凶与对症手段
常见的真凶往往不是"数据库不行了",而是具体的写法问题:N+1查询(循环里逐条查库,一百条数据触发一百次SQL)、缺少索引的全表扫描、同步等待外部接口(三个无依赖的调用串行等待)、大批量数据一次性加载(不分页拉全表)。第三步才对症下手:用批量查询消灭N+1,加Redis缓存热点读,外部调用并行化或异步化,大列表改成分页和流式处理。缓存本身也要防穿透、击穿、雪崩,索引加完要用执行计划确认真的生效。
7.3 回归验证与常态化纪律
第四步必须用同样的指标回归验证——P95是否真的下降、下降了多少,有没有牺牲正确性(缓存脏读)或拖慢写入;并用基准测试守住底线,把核心接口的性能断言接进CI,防止下个迭代性能悄悄退化。最后把这条闭环常态化:性能不是一次性项目,而是持续监控下的日常纪律,容量规划(按业务增长预判什么时候该扩容)也建立在同一套数据之上。
结语
七条注意事项可以压缩成一张速查表,建议贴在每个新项目的启动文档里:
| 模块 | 一句话原则 | 绝对不要做 |
|---|---|---|
| 用户认证 | bcrypt/argon2存密码,成熟库管Token | 自造哈希和签名算法 |
| 数据存储 | 按数据特性选型,资金数据必进事务库 | 万物皆塞MySQL |
| 消息通知 | 多渠道降级、队列异步、失败重试 | 主流程同步发送、渠道单点 |
| 日志记录 | 分级、JSON结构化、敏感脱敏 | print调试、吞异常、记密码 |
| 配置管理 | 环境变量加配置中心,启动即校验 | 密钥硬编码并提交Git |
| 错误处理 | 统一异常体系,全局拦截出口 | 裸字符串报错、静默catch |
| 性能优化 | 监控先行,数据驱动,闭环验证 | 凭感觉加缓存、优化不验证 |
这些经验有一个共同的来源:通用功能的失败模式是高度重复的,所以与其重新发明一个注定要补课的"简易实现",不如在项目第一天就把成熟方案和工程纪律铺好。好系统与能跑的系统之间,差的往往不是智商,而是对这些"不性感的基础设施"是否心存敬畏。
参考资料
- OWASP Top 10,https://owasp.org/www-project-top-ten
- 《十二要素应用》,https://12factor.net/zh_cn
- 《Google SRE工作手册》(监控与告警章节)
- OpenTelemetry 官方文档,https://opentelemetry.io
- 《数据密集型应用系统设计》,Martin Kleppmann


 扫一扫


 389

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


