


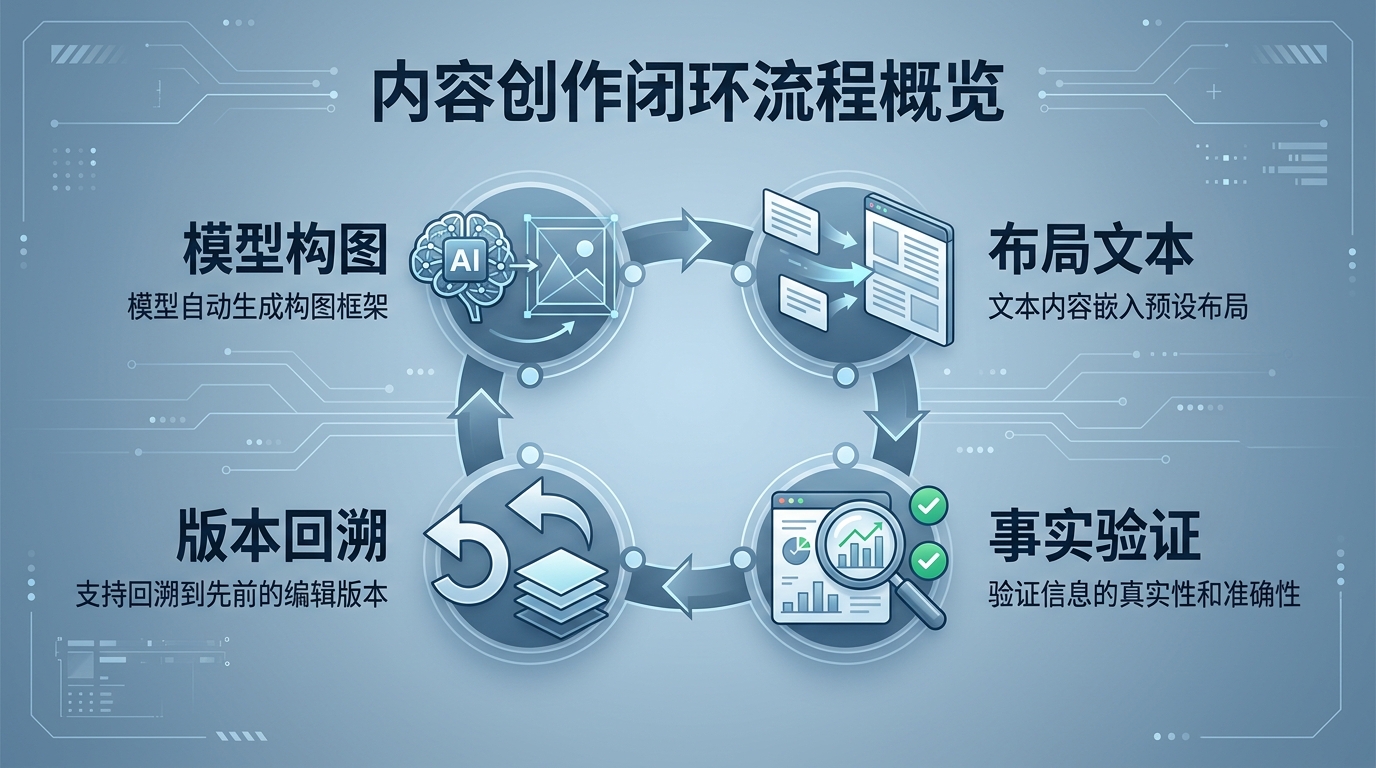
AI生成图片里的中文出现错字、缺字、镜像字或无意义符号时,不要继续无止境地堆提示词。把“画面生成”和“文字排版”拆开,先生成可用底图,再用排版工具叠加文字,最后按清单核对,通常比强行让模型一次性生成完整文案更容易控制。
一、这个问题适合谁
这篇文章适合需要制作文章配图、教程封面、信息卡片、活动说明图或产品示意图的开发者、内容创作者和小团队。文章讨论的是通用工作流,不绑定某个具体模型或平台;不同模型对中文的支持程度会变化,不能把本文流程理解为对任何模型输出的保证。
核验日期: 2026年9月16日
环境说明: Windows 文件管理与浏览器工作流;具体图像模型、版本和字体环境未指定,因此本文不把某个模型的当前能力写成固定结论。
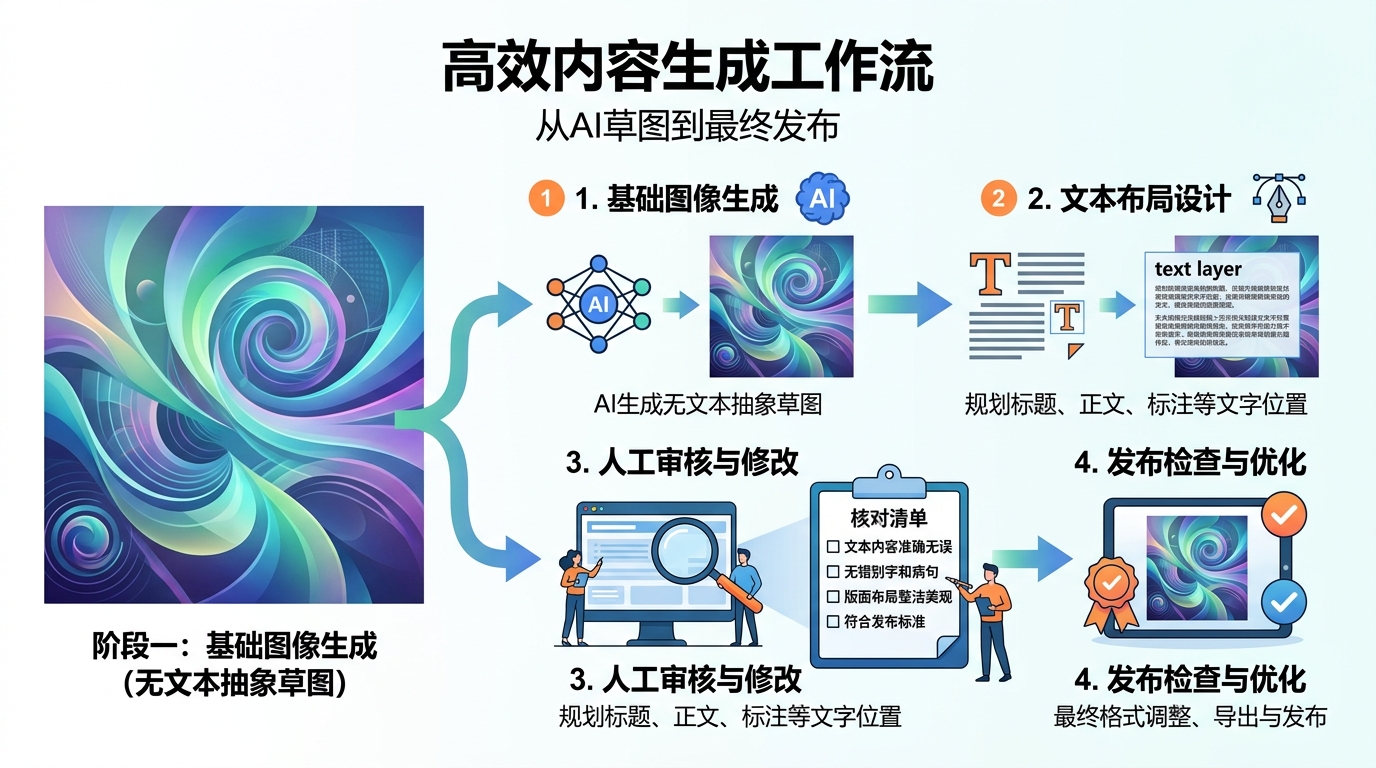 对应“问题表现与分层流程”
二、为什么中文容易在图片里出错
1. 图像模型首先在预测画面,不是在排版
生成模型更擅长处理“颜色、构图、物体关系和整体风格”,而复杂中文需要同时满足字形、顺序、间距、标点和语义。文字越长、字体越小、布局越密集,出错机会越多。
2. 短词和长段落的风险不同
一个两到四字的短词,有时可以作为视觉元素尝试生成;但菜单、步骤说明、参数表、长标题和多行段落,不适合直接交给图像模型完成。这里的“有时”是经验判断,不代表任何模型都能稳定输出。
3. 参考图中的文字可能被重新解释
即使上传了含文字的参考图,模型也可能只保留大致布局和色块,把原字形改写成新的符号。因此,参考图可以帮助确定构图,不应自动视为文字内容的可靠来源。
三、先做一个判断:文字是否必须进入底图
可以先把文字分成三类:
| 文字类型 | 建议处理方式 | 原因 |
|---|---|---|
| 单个短词、装饰性英文或数字 | 可以尝试让模型生成 | 文本短,错位后修复成本相对低 |
| 文章标题、章节名、少量说明 | 优先后期叠字 | 需要保证字形和语义准确 |
| 参数表、操作步骤、免责声明、品牌或型号 | 不要依赖模型直接生成 | 错一个字就可能改变事实或含义 |
关键原则: 只要文字承担信息传递功能,就应该把它当作排版对象,而不是普通画面纹理。
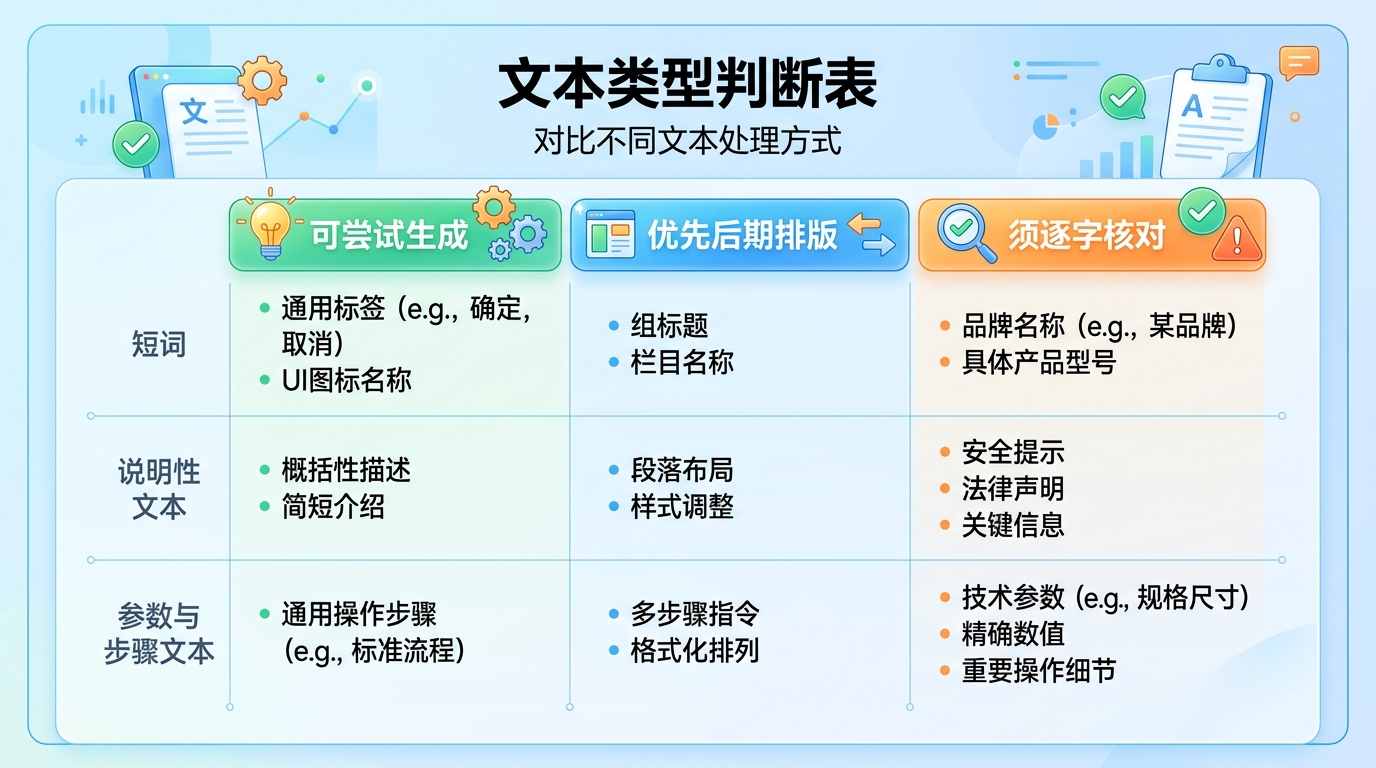
对应“文字类型判断表”
四、推荐的四段式修正流程
第一步:生成“无文字或少文字”的底图
提示词先描述主体、视角、背景、留白、光线和层次,不要把整段文章文案塞进画面。可以这样组织:
横版16:9教程封面,左侧放置抽象的图像生成工作流卡片,右侧保留干净的大面积留白用于后期排版,主体边缘清晰,背景简洁,避免任何可读文字、乱码、随机字母、随机数字和水印,信息图风格
这里的“避免任何可读文字”是为了减少底图中出现错误文字,并不是要求模型在所有情况下都完全不生成字符。生成后仍要检查画面边缘、屏幕、书本和标签区域。
第二步:单独确定文字层
把最终标题、图注、编号和来源说明整理成独立文本。建议至少保存以下字段:
主标题:AI生成图片里的中文总是乱码怎么办?
副标题:从生成、排版到发布的修正流程
图注:先生成底图,再完成文字排版
版本:v01
不要直接从模型输出的图片中“猜回”原文;原文应来自自己的稿件或事实台账。
第三步:后期排版并控制文字区域
后期叠字时,先确定文字框的位置、宽度、字号、行距和对齐方式,再导出预览图。长标题要允许换行,中文标点不要贴到边缘,数字、单位和括号要单独检查。
如果使用脚本排版,至少要确认:
- 字体文件确实支持中文;
- 图片颜色模式和导出格式正常;
- 文字框没有超出画布;
- 缩小到发布尺寸后仍然可读;
- 没有把密钥、客户资料或内部信息写入图片。
下面是一个最小示例。它只演示“在底图上叠加中文”,不是某个图像模型的调用代码,且当前未在本机运行验证。运行前需要把字体路径改成电脑上真实存在的中文字体文件。
from PIL import Image, ImageDraw, ImageFont

image = Image.open("base.png").convert("RGB")
draw = ImageDraw.Draw(image)
font = ImageFont.truetype("C:/Windows/Fonts/msyh.ttc", 56)

title = "AI生成图片里的中文总是乱码怎么办?"
draw.text((80, 80), title, font=font, fill=(20, 35, 55))
image.save("output.png", quality=95)
第四步:发布前做文字核验
建议把核验拆成四遍,而不是只看一眼:
- 字形核验: 是否有错字、缺笔、镜像、重复字或随机符号;
- 顺序核验: 标题、编号、步骤和标点是否与源稿一致;
- 事实核验: 型号、参数、单位、日期和限制条件是否被改写;
- 缩放核验: 在文章正文、手机预览和封面缩略图中是否仍能看清。
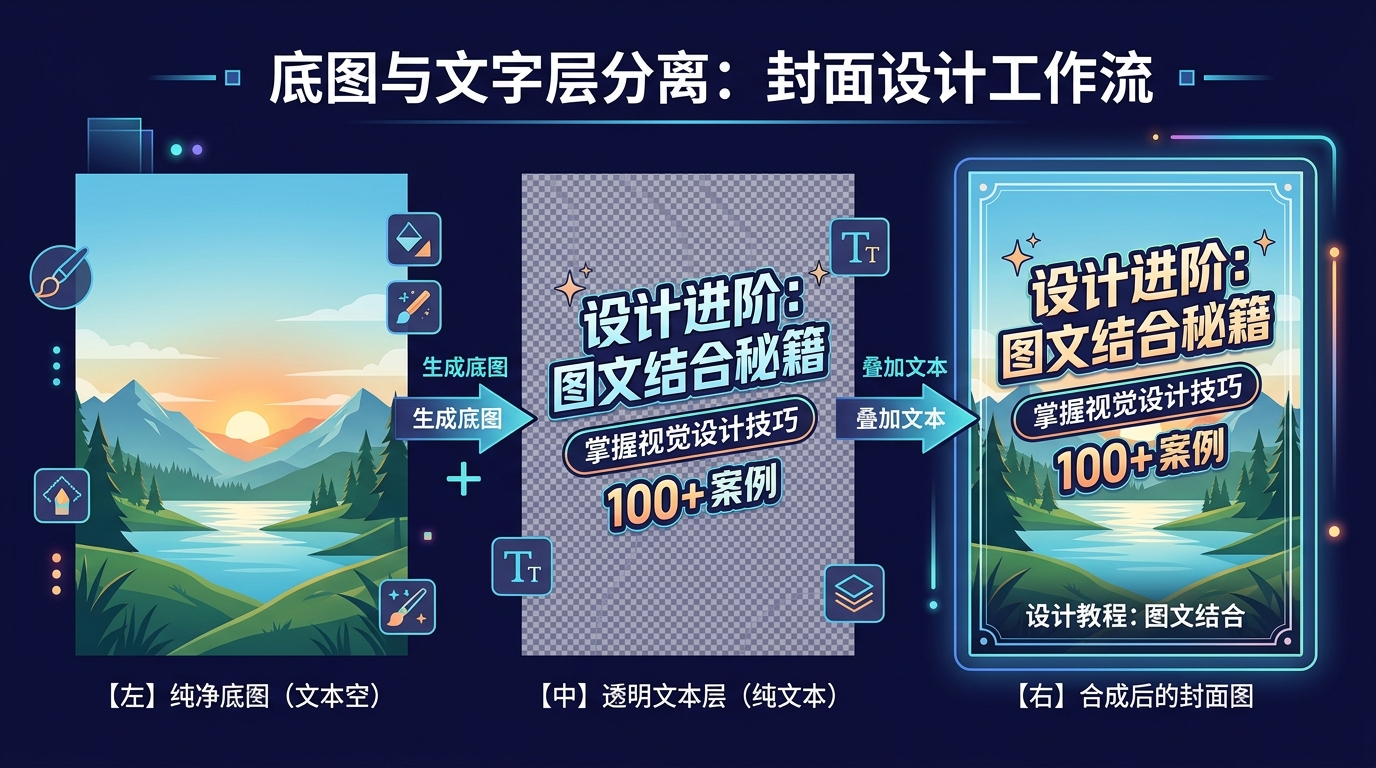 对应“底图与文字层分离”
五、如果必须让模型直接生成中文,怎么降低风险
有些场景确实希望文字成为画面的一部分,例如手写便签、书法装饰或街景招牌。此时可以尝试以下做法,但要把结果当作草稿:
- 把文字缩短到最少字符,避免整句长文;
- 明确文字位置、方向、大小和颜色;
- 一次只要求一种文字,不要同时混合中文、英文、数字和复杂符号;
- 先用低信息密度构图验证文字区域,再补充其他视觉细节;
- 生成后仍按原稿逐字核对,不要因为“看起来像”就直接发布。
如果文字是事实、警示、医疗健康、价格、法律条款或产品参数,建议直接采用后期排版。此时视觉上的自然感要让位于信息准确性。
六、常见失败方式
失败方式1:不断追加“文字必须正确”
重复强调可能改变构图,却不一定能改善字形。更有效的动作是减少底图文字,建立独立文字层。
失败方式2:把错误文字当作设计效果
当图片用于装饰时,随机字符可能不明显;当图片用于教程或说明时,读者会把它理解成真实内容。用途不同,容错标准也不同。
失败方式3:只检查原图,不检查发布后的尺寸
平台展示通常会缩小图片,细小文字和边缘文字可能在上传后不可读。至少检查原图、正文宽度和移动端缩略图三个尺寸。
失败方式4:为了修字而重新生成整个画面
如果底图构图已经可用,重新生成可能引入新的主体、颜色或事实问题。优先局部修复或后期叠字,并保留原始版本,便于回退。
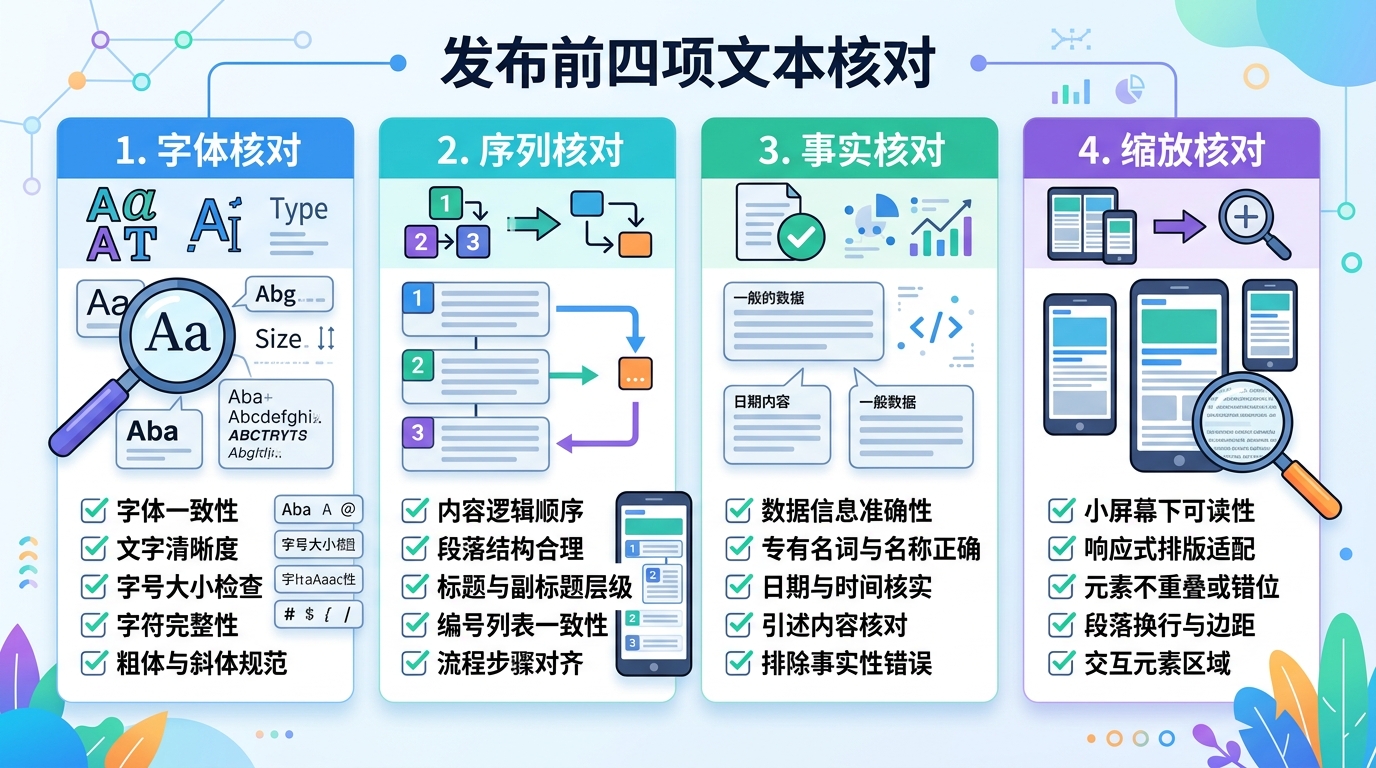
对应“发布前四遍文字核验”
七、发布前的最小检查清单
[ ] 底图中是否出现了不需要的随机文字
[ ] 标题和图注是否来自最终稿,而不是凭记忆重写
[ ] 中文字体是否支持目标字符和标点
[ ] 文字框是否超出安全区域
[ ] 数字、单位、日期和型号是否逐项核对
[ ] 缩小到正文和手机预览后是否仍清晰
[ ] 是否包含未经授权的第三方Logo、客户资料或隐私信息
[ ] 是否保留可回退的底图、文字稿和最终导出版本
八、结论
AI图片中的中文乱码,核心不是“提示词写得不够长”,而是任务分工不合理。把模型用于构图,把排版工具用于准确文字,把人工或OCR用于最终核验,工作流会更容易复现,也更容易定位问题。
最小可行流程可以压缩成一句话:先生成干净底图,再独立排版文字,最后按字形、顺序、事实和缩放四个维度检查。
#AI生成图片 #中文排版 #提示词工程 #图像后期 #内容发布


 扫一扫


 413

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


