AI新智力 | AI | 大模型入门(八):​蒸馏、量化、MoE、MHA

【LLM基础知识点整理】大模型的量化和蒸馏 大模型量化是指将深度学习模型中使用的浮点数表示转换为低精度整数表示的过程。这通常涉及选择合适的量化比特数和方法,以减少内存占用和推理时间,同时尽量不损失太多准确性。 阅读详情

本文来源公众号“AI新智力”,仅用于学术分享,侵权删,干货满满。

原文链接:AI | 大模型入门(八):​蒸馏、量化、MoE、MHA

“ 什么是蒸馏、量化、MoE架构、MHA。”

highway of Los Angeles

知识蒸馏(模型压缩)技术

上一章节AI新智力 | AI | 大模型入门(七):​参数量、Token、上下文窗口、上下文长度、温度-CSDN博客中讲解了大模型的“参数量”、“Token”、“上下文窗口”、“上下文长度”和“温度”等术语。

一、什么是知识蒸馏

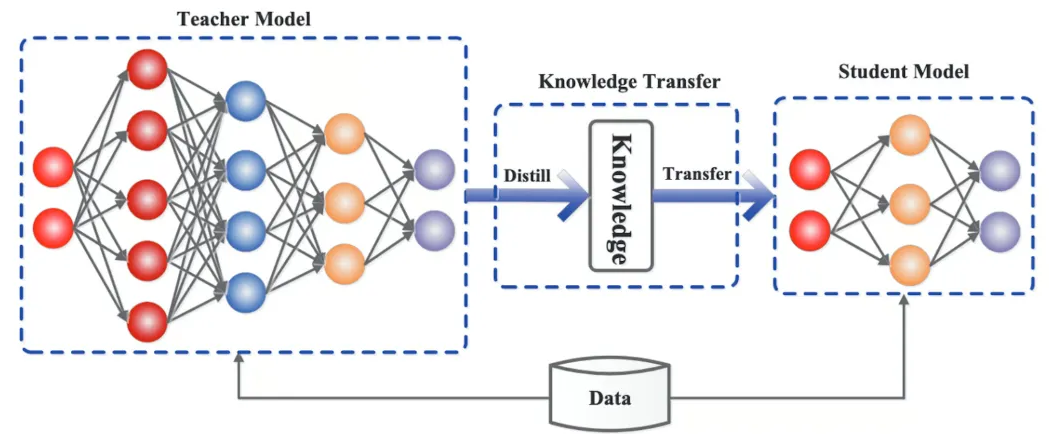
知识蒸馏(Knowledge Distillation)是一种模型压缩技术,通过训练小型“学生模型”模仿大型“教师模型”的输出分布,实现知识迁移。其核心在于利用教师模型的软标签(概率分布)而非硬标签,传递更丰富的类别间关系信息。14年NIPS上由Google 的Hinton发表的《Distilling the Knowledge in a Neural Network》是首次提出知识蒸馏这个概念。
图片

蒸馏过程通常包括以下几个步骤:

  1. 教师模型训练:首先,训练一个性能强大的大模型,这个模型通常具有大量的参数,能在各种任务上提供优异的性能。这个大模型即为“教师模型”。

  2. 学生模型设计:学生模型通常较小,参数量比教师模型少得多。其目的是在保证模型精度的同时,减少计算资源消耗,提高推理速度。

  3. 蒸馏过程:在训练学生模型时,采用教师模型的输出作为监督信号。不同于传统的监督学习,蒸馏技术利用教师模型的软标签(Soft Labels)而非硬标签。软标签通常是教师模型的输出概率分布,它携带了更多的信息,例如类别之间的相似度,这使得学生模型能够在较少的数据和参数的情况下,学到更加丰富的知识。

  4. 优化与精炼:学生模型通过模拟教师模型的行为,逐渐学习到其潜在的知识结构。通过反复训练,学生模型在大部分情况下能够接近或达到教师模型的性能,同时具有更高的计算效率和更小的内存占用。

二、主要作用

模型压缩:蒸馏技术可以将大型模型压缩成较小的模型,使得其在移动设备或计算资源有限的环境中依然可以发挥较高的性能。

知识迁移:学生模型不仅继承了教师模型的知识,还能在一些情况下进行自我优化,提升性能。

推理效率:由于学生模型的规模较小,它在推理时所需的计算资源和时间都显著减少,有助于加速推理过程,尤其适用于实时应用场景。

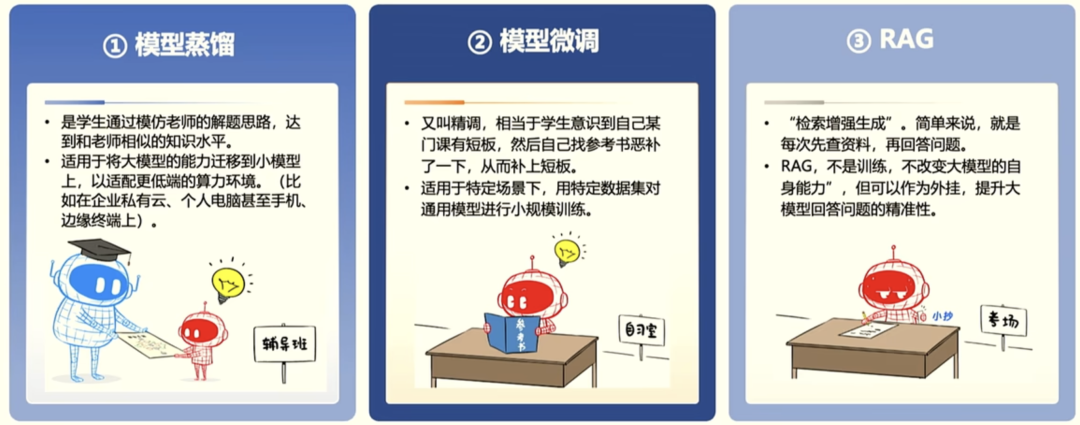
大模型在场景落地时,会存在部署推理成本高、专业知识不足、幻觉问题严重等问题,因此在专业级市场,需要基于蒸馏、微调、RAG等手段,提升大模型在垂直领域的表现。
图片

模型量化

一、什么是模型量化

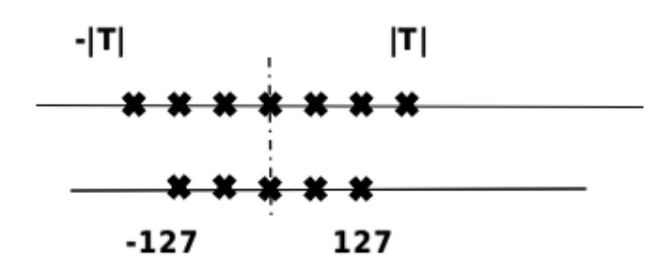
模型量化(Quantization)是指以较低的推理精度损失将连续取值(通常为float32或者大量可能的离散值)的浮点型权重近似为有限多个离散值(通常为int8)的过程。通过以更少的位数表示浮点数据,模型量化可以减少模型尺寸,进而减少在推理时的内存消耗,并且在一些低精度运算较快的处理器上可以增加推理速度。具体如下图所示,[-T, T]是量化前的数据范围,[-127, 127]是量化后的数据范围。
图片

量化将模型参数的表示从浮点数精度降低为整数或低精度形式,以减小模型的存储和计算开销。

二、主要作用

  • 减小模型大小

    如 int8 量化可减少 75% 的模型大小,int8 量化模型大小一般为 32 位浮点模型大小的 1/4:

    • 减少存储空间:在端侧存储空间不足时更具备意义。

    • 减少内存占用:更小的模型当然就意味着不需要更多的内存空间。

    • 减少设备功耗:内存耗用少了推理速度快了自然减少了设备功耗;

  • 加快推理速度

    访问一次 32 位浮点型可以访问四次 int8 整型,整型运算比浮点型运算更快;CPU 用 int8 计算的速度更快

  • 某些硬件加速器如 DSP/NPU 只支持 int8

    比如有些微处理器属于 8 位的,低功耗运行浮点运算速度慢,需要进行 8bit 量化。

模型量化主要意义就是加快模型端侧的推理速度,并降低设备功耗和减少存储空间。

MoE混合专家模型技术

训练大型语言模型(LLM)通常需要大量的计算资源,这对许多组织和研究人员来说是一个很高的门槛。混合专家(MoE)技术通过将大型模型分解成更小的、专门的网络来解决这一难题。

MoE(Mixture of Experts,混合专家模型)是一种通过动态选择子模型(专家)处理输入数据的深度学习架构,旨在提升模型性能与效率。其核心思想是“术业有专攻”,即让不同专家专注于特定任务,通过门控网络动态调度专家资源,在降低计算成本的同时实现高性能输出。

一、什么是MoE

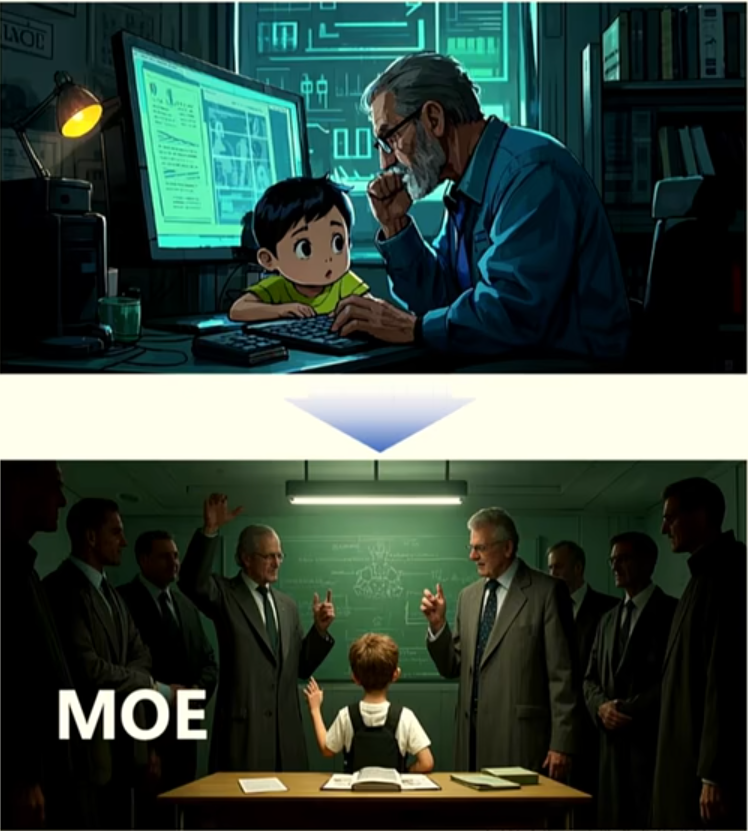
想象一个人工智能模型是一个专家团队,每个人都有自己独特的专业知识。混合专家(MoE)模型通过将复杂任务划分为(称为专家的)更小的专业网络来运行这一原则。每个专家专注于问题的一个特定方面,使模型能够更有效、更准确地解决任务。就像医生负责医疗问题,技师负责汽车问题,厨师负责烹饪一样,每个专家都有自己擅长的事情。通过合作,这些专家可以更有效地解决更广泛的问题。
图片

二、主要作用

计算高效性。MoE通过动态分配任务,减少冗余计算。例如,DeepSeek-MoE 16B的推理仅激活2.8B参数,计算量比同等性能的稠密模型降低60%。

参数可扩展性。一是专家的多样化能力使MoE模型具有高度的灵活性,通过召集具有专业能力的专家,MoE模式可以承担更广泛的任务。二是将复杂的问题分解成更小、更易于管理的任务,有助于MoE模型处理日益复杂的输入。三是支持扩展到数百甚至上千个专家,模型容量大幅提升(如谷歌的Switch Transformer达1.6万亿参数),同时保持分布式并行计算的可行性。

任务适应性。一是MoE的“分而治之”方法,其中任务分别执行,增强了模型对故障的容错弹性。如果一个专家遇到问题,并不一定会影响整个模型的功能。二是在多模态、复杂推理等场景中,MoE通过专家分工实现精准处理,例如GPT-4的MoE架构能分别处理文本生成、逻辑推理和图像分析任务。

MHA多头注意力机制技术

多头注意力机制(Multi-Head Attention)是深度学习领域中一种重要的技术,最早由Vaswani等人在2017年的论文《Attention is All You Need》中提出。

多头注意力(Multi-Head Attention)是一种在Transformer模型中被广泛采用的注意力机制扩展形式,它通过并行地运行多个独立的注意力机制来获取输入序列的不同子空间的注意力分布,从而更全面地捕获序列中潜在的多种语义关联。
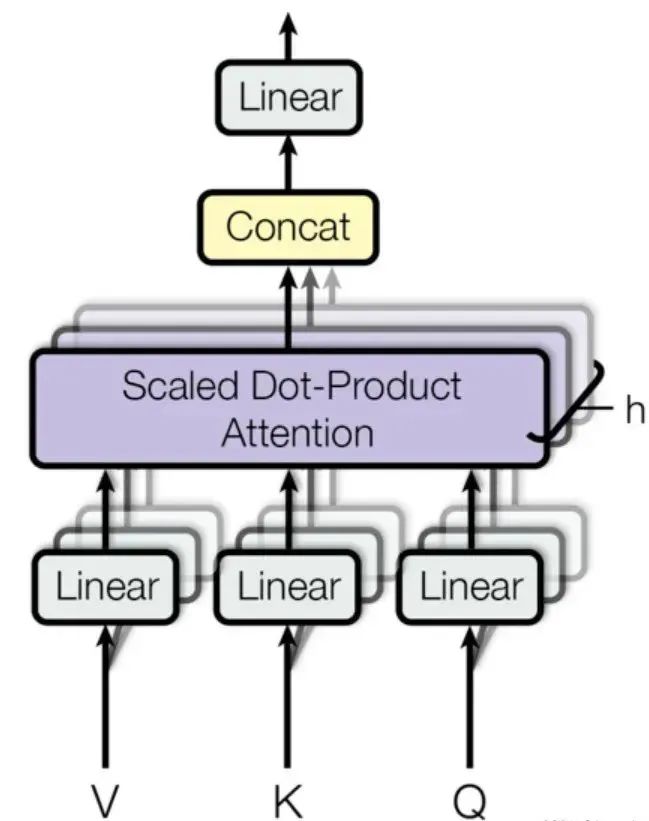
image.png

在多头注意力中,输入序列首先通过三个不同的线性变换层分别得到Query、Key和Value。然后,这些变换后的向量被划分为若干个“头”,每个头都有自己独立的Query、Key和Value矩阵。对于每个头,都执行一次Scaled Dot-Product Attention(缩放点积注意力)运算,即:
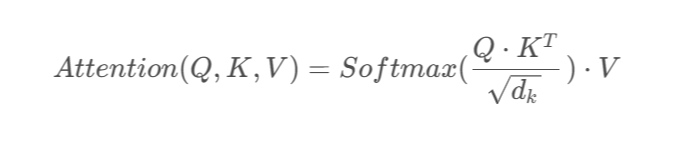
image.png

最后,所有头的输出会被拼接(concatenate)在一起,然后再通过一个线性层进行融合,得到最终的注意力输出向量。

通过这种方式,多头注意力能够并行地从不同的角度对输入序列进行注意力处理,提高了模型理解和捕捉复杂依赖关系的能力。在实践中,多头注意力能显著提升Transformer模型在自然语言处理和其他序列数据处理任务上的性能。
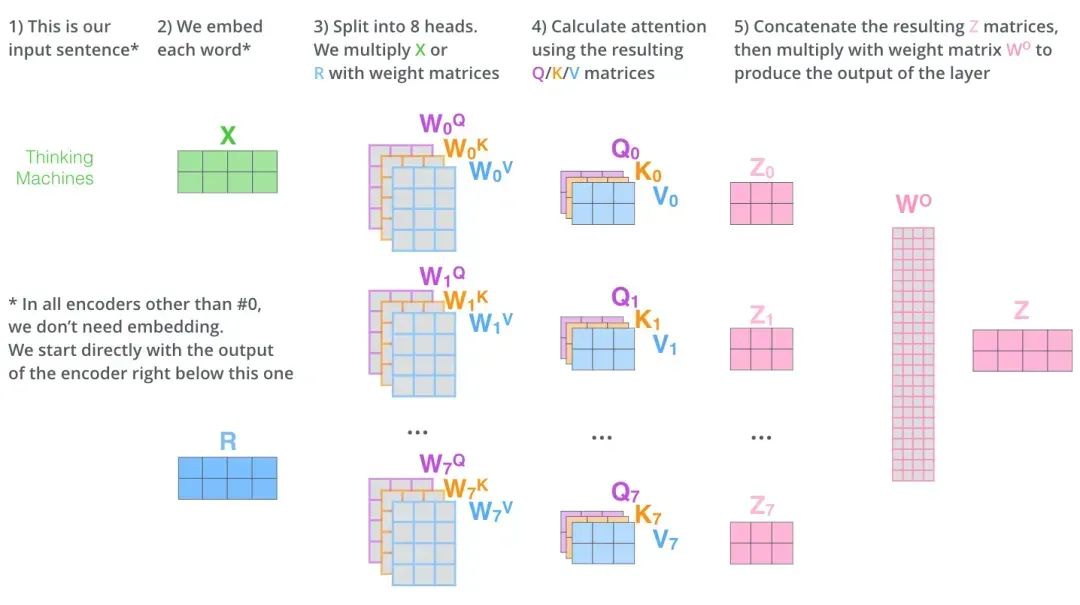
image.png

参考文献:

1. Distilling the Knowledge in a Neural Network:https://arxiv.org/abs/1503.02531

2. 深入剖析Transformer架构中的多头注意力机制:https://developer.aliyun.com/article/1649746

3.  TensorFlow 模型优化:模型量化-张益新

4. 模型压缩-神经网络量化基础:https://zhuanlan.zhihu.com/p/505570612

THE END !

文章结束,感谢阅读。您的点赞,收藏,评论是我继续更新的动力。大家有推荐的公众号可以评论区留言,共同学习,一起进步。

大模型 - 知识蒸馏原理解析 知识蒸馏通过教师模型提供的软标签引导学生模型,使得学生模型不仅关注硬标签的分类准确性,还能从软标签中学习更丰富的类别间关系,从而在模型压缩的同时尽量保留性能。这种方法特别适用于在资源受限的环境中部署高效的深度学习模型。 阅读详情

相关推荐

【大模型】知识蒸馏(knowledge distillation)算法详解

虽然基于特征的知识转移为学生模型的学习提供了更多信息,但由于学生模型和教师模型的结构不一定相同,如何从教师模型中选择哪一层特征激活(提示层),从学生模型中选择哪一层(引导层)模仿教师模型的特征激活,是一个需要探究的问题。作者提出了一种称为知识蒸馏的策略,它学习的是教师模型(结构较为复杂的模型)的输出分布(logits),这种分布信息比原始的(0-1)label具有更加丰富的信息,能够让学生模型(架构较为简单的模型)取得更好的效果。上面一种方法学习目标非常直接,学生模型直接学习教师模型的最后预测结果。

酒酿小圆子呀~ 3697

大模型的蒸馏和量化有什么区别?

大模型的蒸馏和量化

ChinaLiaoTian的博客 1952

zemax双透镜公差分析

蒙特卡罗分析: 评估公差的整体影响,模拟过程中产生一系列随机的lens,满足指定的公差,然后再按照标准评估。公差分析,就是在设计了一个理想的系统后,想看看实际生产过程中如果产生公差(误差),系统会坏到什么程度,也就是光学性能受到多大影响。反灵敏度分析:分别对每个公差在性能方面的一个给定的最小允许减少量来计算公差,也就是限制了系统性能的变化,和灵敏度分析方向相反。灵敏度分析对每个公差单独求值,分别计算每个公差操作数的最大、最小、标准值(如上图)所有设计上可能的公差都列出来了。注意要固定透镜的口径。

fendoudecheng的博客 3204

AI | 大模型入门:​蒸馏、量化、MoE、MLA

蒸馏、量化、MoE架构、MLA。

2401_85390073的博客 1359

S32K344 Flash Driver实战:手把手教你实现任意字节写入与扇区解锁(含C40_Ip避坑指南)

本文深入解析S32K344微控制器的Flash驱动开发,重点解决C40_Ip驱动库的8字节对齐限制和扇区保护锁问题。通过实战案例和代码示例,详细介绍了如何实现任意字节写入、扇区解锁及性能优化策略,为Bootloader和OTA升级等应用提供可靠解决方案。

weixin_33713707的博客 427

ImageNet分类实战:用PyTorch复现AlexNet的5个关键技巧(附代码)

本文详细介绍了使用PyTorch复现经典AlexNet模型进行ImageNet图像分类的五个关键工程技巧。内容涵盖模型架构的现代重构、训练策略优化、核心组件实现与替代方案,以及实用的训练调试方法,并提供了完整的代码示例,帮助开发者深入理解深度卷积神经网络的实现细节与优化思路。

i0j1k2l3m的博客 86

AI | 大模型入门(八):​蒸馏、量化、MoE、MHA

蒸馏、量化、MoE架构、MHA。

kukule520129的博客 194

Evolution of Heuristics: Towards Efficient Automatic Algorithm Design Using Large Language Model

启发式算法广泛用于处理复杂的搜索和优化问题。然而,启发式算法的手动设计通常非常耗费人力,需要丰富的工作经验和知识。本文提出了启发式算法的进化 (EoH),这是一种新颖的进化范式,它利用大型语言模型 (LLM) 和进化计算 (EC) 方法进行自动启发式设计 (AHD)。EoH 代表自然语言中的启发式概念,称为思想。然后由 LLM 将它们转换为可执行代码。进化搜索框架中思想和代码的演变使其在生成高性能启发式算法方面非常有效和高效。

weixin_43961909的博客 2144

AI新智力 | AI | 大模型入门(九):RAG​数据库

本文介绍了RAG(检索增强生成)技术在大模型应用中的重要作用。RAG通过外挂知识库解决大模型知识更新难、生成结果不可解释和数据安全三大问题。文章分析了实现RAG的四种主要数据库类型:1)向量数据库(如Chroma),适用于非结构化数据语义检索;2)图数据库(如Neo4j),擅长处理结构化关系数据;3)知识图谱,增强推理能力和答案可解释性;4)混合架构数据库(如Elasticsearch+Neo4j),可综合多种检索方式。

csdn_xmj的博客 1434

CAN总线错误帧全解析:从数据包到硬件层的故障树分析

本文深入解析CAN总线错误帧的故障树分析方法,从数据包到硬件层全面剖析错误机制。通过物理层信号测试、数据链路层错误解码和应用层协议排查,提供系统化的诊断框架。结合CANoe配置和示波器波形分析,帮助工程师快速定位总线故障,提升系统可靠性。

weixin_26742753的博客 477

文本纠错项目代码调试

文本纠错项目调试

m0_67084346的博客 864

周报 | 25.7.21-25.7.27文章汇总

本周技术周报汇总了多篇AI与Python领域的优质文章:1)机器学习入门教程;2)Transformer模型解析;3)大模型蒸馏、量化技术详解;4)Python实用库sh介绍;5)KimiK2大模型技术报告;6)X光安检图像识别比赛方案;7)视觉语言模型压缩新方法;8)交互式修图Agent;9)主流大模型架构对比;10)具身智能训练新范式;11)Python内存优化技巧。这些文章涵盖AI基础、前沿研究和工程实践,适合不同层次开发者学习参考。欢迎推荐优质技术公众号,共同进步。

csdn_xmj的博客 365

【图像去噪】论文复现:大道至简!NAFNet的Pytorch源码复现!跑通NAFNet源码,补充PlainNet,由大到小拆解NAFNet网络结构,由小到大实现结构组合,逐行注释!

论文题目:Simple Baselines for Image Restoration —— 图像恢复的简单基线【图像去噪】论文精读:Simple Baselines for Image Restoration(NAFNet)本文以SIDD数据集为例,跑通NAFNet源码,详解NAFNet网络结构与实现。建议与KBNet和CGNet的复现文件综合查看。训练和测试代码解析见单独的BasicSR源码精读(后续会出)。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 2983

GPT-4参数真相:1.8万亿与2%激活率的技术解构

大语言模型中的‘参数量’和‘稀疏激活’是理解现代MoE架构的核心概念。参数量反映模型的知识容量上限,而稀疏激活率则决定实际推理的计算开销与硬件适配性。其技术原理源于混合专家(Mixture of Experts)架构中路由器(Router)对token的动态路由机制,通过Top-k选择、负载均衡损失与容量因子等设计,在保持高能力的同时显著降低单次计算量。这一范式不仅重塑了模型训练与部署的成本结构,更直接影响API计费、边缘推理、量化压缩等工程实践。本文聚焦GPT-4广为流传的‘1.8万亿参数’与‘2%激活率

weixin_33801856的博客 319

深度学习流体力学:基于PyTorch的物理信息神经网络(PINN)完整实现

本文介绍了基于物理信息神经网络(PINN)的深度学习流体力学求解器实现。首先阐述了Navier-Stokes方程的理论基础,包括连续性方程和动量守恒方程,并解释了PINN的核心原理:将物理方程作为约束条件嵌入神经网络损失函数。以经典的lid-driven cavity流动为例,详细展示了使用PyTorch实现的全流程,包括神经网络架构设计、自动微分求解Navier-Stokes方程、多约束条件优化训练等关键环节。该求解器通过将物理方程、边界条件和初始条件整合到损失函数中,实现了对流体力学问题的端到端求解,为

源代码杀手的博客 9819

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

什么是大模型的量化和蒸馏?

什么是大模型的量化和蒸馏?通俗版

铁马冰河入梦 669

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

DeepSeeK-V3中核心技术详解:什么是FP8?什么是MLA?什么是MOE?

### DeepSeeK-V3中核心技术详解:什么是FP8?什么是MLA?什么是MOE? > **关键词**:FP8、MLA、MOE、DeepSeeK-V3、核心技术 > **亮点**:细致拆解,直击技术本质,助你快速掌握核心概念! --- #### 🚀 **前言** AI领域的创新从未停止,每一代新技术都在突破硬件极限和算法瓶颈。在DeepSeeK-V3中,有三大核心技术尤为引人注目:**FP8**、**MLA** 和 **MOE**。这些技术不仅提升了模型性能,还在推理效率、能耗优化上展

猫头虎:授渔优于赠鱼,兴趣引领智慧,探索之乐尤显珍贵。商务合作+:Libin9iOak ,万粉变现+:CSDNWF,猫头虎承诺每年免费为100名C站创作者做账号流量诊断服务! 4696

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

万字长文详解大模型知识蒸馏指南

模型蒸馏即知识蒸馏(Knowledge Distillation),是一种模型压缩和加速技术。在深度学习中,大型深度神经网络虽性能优异,但因计算复杂度高、存储需求大,难以部署在资源受限设备上。模型蒸馏通过构建师生架构,让小的学生模型学习大的教师模型的知识,使学生模型在保持较小规模的同时,尽可能接近教师模型的性能。其核心组件包括知识(如教师模型的 logits、中间层特征等)、蒸馏算法(用于指导知识转移)和师生架构(决定知识传递方式)。

2401_85325726的博客 7720

一文搞懂大模型最容易混淆的概念 | 量化、剪枝与蒸馏

大模型的量化、剪枝和蒸馏是三种常见的模型压缩技术,它们各自有不同的目标和实现方法,但。它们之间既有区别,又有联系,非常容易混淆。量化是将模型中的浮点数权重和激活值转换为低精度的整数表示(如从32位浮点数转换为8位整数)。这种转换可以显著减少模型的存储空间和计算复杂度,同时在某些硬件上加速推理过程。实现方法:1. 权重量化:将模型权重从高精度浮点数转换为低精度整数。2. 激活量化:将激活值也进行低精度表示。3. 量化感知训练(QAT):在训练过程中加入量化操作,使模型在训练时就适应低精度计算。

2401_85373691的博客 2748

小白程序员必看!大模型四大核心技术:蒸馏、量化、MoE、MHA,一次讲透!

本文详解大模型四大核心技术:知识蒸馏通过学生模型模仿教师模型实现知识迁移与压缩;模型量化将浮点参数转为低精度离散值,减小模型尺寸并提升推理速度;MoE混合专家模型动态选择专业子模型提高计算效率;多头注意力机制并行处理序列信息,增强模型捕捉复杂依赖关系的能力。这些技术共同优化大模型的性能、效率和实用性。

m0_56255097的博客 750

大模型知识蒸馏概述

来自:吃果冻不吐果冻皮进NLP群—>加入NLP交流群近年来,随着Transformer、MOE架构的提出,使得深度学习模型轻松突破上万亿规模参数,从而导致模型变得越来越大,因此,我们需要一些大模型压缩技术来降低模型部署的成本,并提升模型的推理性能。而大模型压缩主要分为如下几类:剪枝(Pruning)知识蒸馏(Knowledge Distillation)量化(Quantization)低秩分...

zenRRan的博客 4142

大模型的蒸馏​​和量化技术

​​量化(Quantization)​​​​定义​​:通过降低模型权重和激活值的数值精度(如从FP32→INT8),减少计算复杂度和存储需求。​​目标​​:直接优化数值表示效率,适用于硬件加速(如GPU/TPU)和边缘设备部署。​​蒸馏(Distillation)​​​​定义​​:通过教师模型(大模型)指导学生模型(小模型)训练,传递知识(如软标签、中间层特征)。​​目标​​:通过知识迁移压缩模型结构,提升小型模型的性能和泛化能力。​​蒸馏≠量化​。

xuukai的博客 710

一文通透让Meta恐慌的DeepSeek-V3:在MoE、GRPO、MLA基础上提出Multi-Token预测(含FP8训练详解)

他们的MTP策略主要旨在提高主模型的性能,因此在推理过程中,可以直接丢弃MTP模块,主模型可以独立正常运行此外,还可以重新利用这些MTP模块进行推测性解码,以进一步提高生成延迟// 待更。

结构之法 算法之道 1万+

简单带你了解大模型时代的知识蒸馏方法

知识蒸馏作为一种高效的模型压缩和知识转移技术,能够在保持模型性能的前提下,大幅降低计算成本和资源需求。无论是在边缘计算、移动设备,还是在大规模机器学习任务中,知识蒸馏都将发挥越来越重要的作用。通过不断的研究与实践,知识蒸馏有望为AI的发展带来更多的创新与突破。

IT枫斗者的博客 4003

模型压缩:量化、剪枝和蒸馏

点击上方“小白学视觉”,选择加"星标"或“置顶”重磅干货,第一时间送达编者荐语近年来,BERT 系列模型成了应用最广的预训练语言模型,随着模型性能的提升,其参数规模不断增大,推理速度也急剧提升,导致原始模型必须部署在高端的GPU 显卡上,甚至部分模型需要多块显卡才能正常运行。转载自丨博文视点Broadview前言 在移动智能终端品类越发多样的时代,为了让预训练语言模型可以顺利部署在算力和存储空间...

小白学视觉 3898

AI学习_模型优化:剪枝、蒸馏、量化

模型优化:剪枝、蒸馏、量化

qq_41848886的博客 5449
上一篇: 周报 | 25.7.14-25.7.20文章汇总
下一篇: python | Github 7.4k star,一个强大的 Python 库--sh!
双木的木
博客等级 码龄8年 1万+粉丝 1458原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值