AI新智力 | 大模型入门15:GraphRAG、LightRAG、AgenticRAG

下一词预测(Next-token Prediction)深度解析:从 N-gram 到 GPT 的唯一目标函数 下一词预测(NTP)是自回归语言模型的核心训练目标,其本质为最小化交叉熵,等价于最大似然估计。通过链式法则将序列概率分解为条件分布,模型在无监督下学习语料中真实下一个 token 的高概率输出。从n-gram到Transformer,技术演进始终围绕提升上下文建模能力与并行效率。训练时利用因果掩码实现并行前向,推理则逐token采样生成。损失函数的下降揭示了规模定律下的通用智能涌现,但模型仍受限于生成能力,无法学习逻辑或常识。该目标统一了训练、评估与推理,构成大模型发展的基石。 阅读详情

本文来源公众号“AI新智力”,仅用于学术分享,侵权删,干货满满。

原文链接:大模型入门15:GraphRAG、LightRAG、AgenticRAG
“传统RAG存在某些局限性,比如对于知识图谱支持准确性很差,同时还面临歧义查询或需要深入理解上下文的查询方面的困难。但是大模型私有化部署通常依赖于多个外部来源,这些来源可能具有不同的格式、标准和可靠性水平。我们需要更多的方案解决这些难题。”

为什么需要多类型RAG

之前的文章AI新智力 | AI|大模型入门(四):检索增强生成(RAG)_检索增强生成场景-CSDN博客提到了,RAG是大模型定制化或者私有化部署时知识增强方法的最便捷、成本最低的方式,是一种新数据引入大模型的经济高效的方法,它大模型私有化部署必备的步骤。

之前的文章AI新智力 | AI | 大模型入门(九):RAG​数据库-CSDN博客提到了,我们为什么需要RAG,同时指出RAG数据库有多种,如向量数据库、图数据库、知识图谱等。
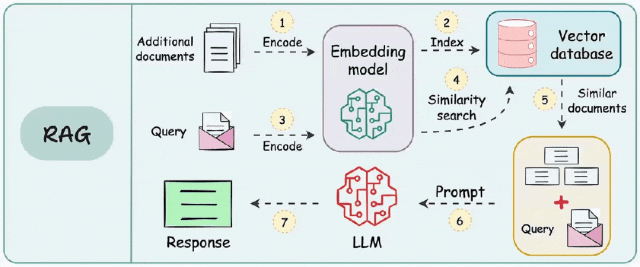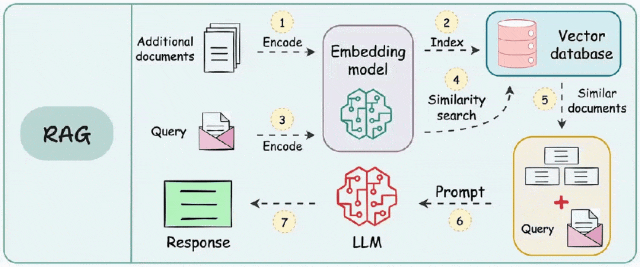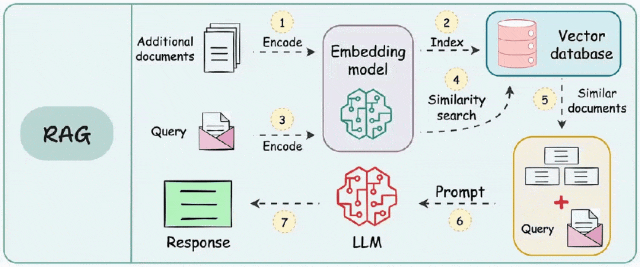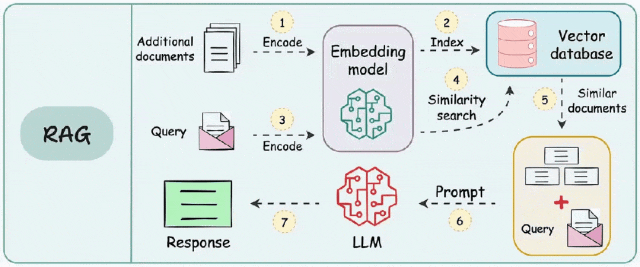
传统RAG工作流程图

但是,传统RAG在支持多类型数据源时存在一定的不足,比如:

一是大模型私有化部署过程中通常依赖于多种类型的外部数据源。这些数据源可能具有不同的格式、标准和可靠性水平,例如PDF、平面文件、Markdown、CSV、网页内容、拓扑图、思维导图等等;

二是传统RAG在实施过程中还面临歧义查询或需要深入理解上下文的查询方面的困难。传统RAG在设计上是将文档分块以便进行检索,然而这种方法忽略了这些块之间的上下文关系。如果意义或上下文跨越多个块,就很难准确回答复杂的问题。

这些问题是传统RAG技术设计天然短板,主要源于信息检索过程,但是该过程有时会忽略精确响应所需的细微差别。为了支持更广泛的外部数据,提升检索准确性,本文将继续探讨常用的其他RAG实现框架。

GraphRAG

1. 什么是GraphRAG

GraphRAG(Graph-based Retrieval Augmented Generation,图检索增强生成)是由微软于2024年7月2日开源的图检索增强生成框架,其目标是要提升大模型在处理私有数据时的理解和推理能力,是一种结合了知识图谱和检索增强生成(RAG)技术的新方法。

传统的RAG技术通过从外部知识库中检索相关信息,增强生成模型的输出质量。而GraphRAG则进一步引入了知识图谱,将信息以节点和边的形式存储,提供更丰富的上下文和关系信息,从而提升生成效果。

2. 工作原理

其工作原理是将知识图谱中的结构化数据整合到大语言模型的处理过程中,为模型的响应提供更细致、更全面的信息基础。知识图谱是对现实世界中的实体及其关系的结构化表示。它主要由两个部分组成:节点和边。节点代表单个实体,如人、地点、物体或概念。而边则表示这些节点之间的关系,表明它们是如何相互连接的。
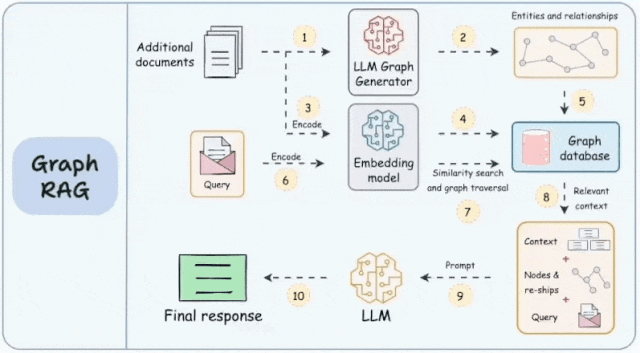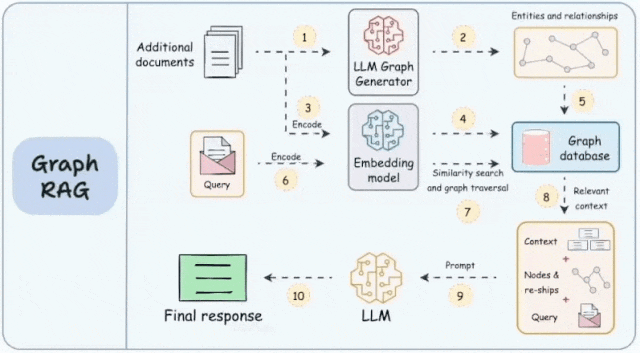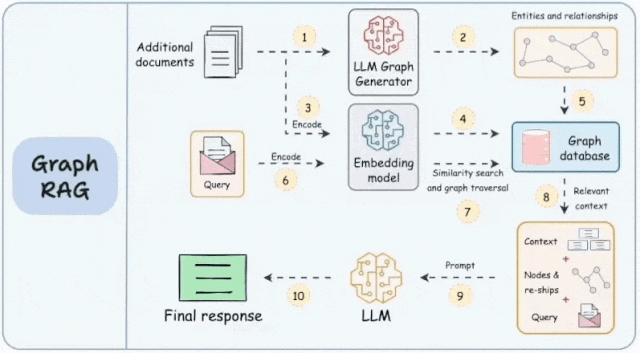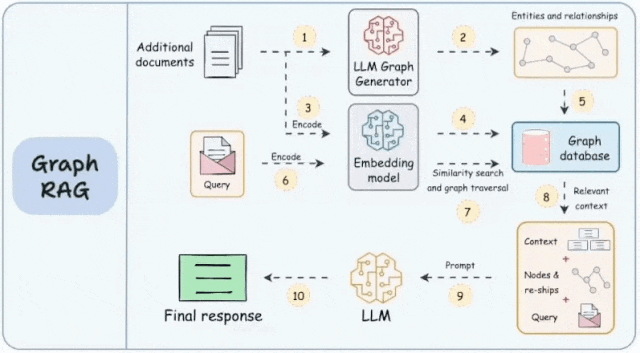
知识图谱构建:GraphRAG的核心在于其能够将非结构化的文本数据转换为结构化的图谱形式。在这个过程中,文本中的每个实体和概念都被视为图中的节点,而它们之间的关系则构成了节点之间的边。这种方法不仅增强了模型对数据的理解能力,也为模型提供了更丰富的信息检索和推理路径。

图机器学习:利用图神经网络(GNN)等图机器学习技术,GraphRAG能够进一步挖掘知识图谱中的深层信息和复杂关系,从而提升模型在问答、摘要和推理任务中的表现。

3. 技术优势

多维度问答能力:GraphRAG能够理解并回答涉及复杂关系和多步骤推理的问题,提供全面且准确的答案。

自动知识图谱更新:随着新数据的输入,GraphRAG能够自动更新知识图谱,保持信息的时效性和准确性。

跨领域信息整合:能够处理跨领域的数据集,整合不同来源和类型的信息,提供全面的视角和深入的分析。

高效的信息检索:通过社区检测算法和图检索技术,GraphRAG能够快速定位到相关信息,提高检索效率。

定制化摘要生成:根据不同的查询需求,GraphRAG能够生成定制化的信息摘要,提供个性化的信息服务。

但是,GraphRAG构建成本高、扩展性差,不支持知识图谱的增量更新,限制了它的应用场景,尤其是对于要求灵活多变的中小企业助手类、专家类应用场景不够友好。

LightRAG

1. 什么是LightRAG

LightRAG 是香港大学和北京邮电大学联合科研团队开发和开源的一款新型的图检索增强生成框架,其主要目标是通过使用知识图谱和嵌入来检索相关知识块以生成响应。传统的 RAG 系统通常将文档拆分成孤立的块,但 LightRAG 更进一步——它通过构建实体关系对的形式将文本中的单个概念连接起来。

LightRAG是一种基于GraphRAG的创新方法,它将知识图谱的属性与基于嵌入的检索系统相结合,使其既快速又高效,达到了最先进的结果。它在各种基准测试中都优于简单的RAG和GraphRAG。
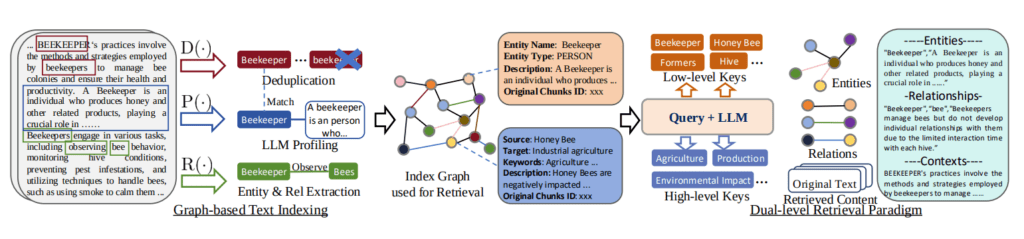
LightRAG Architecture showing Graph Based Indexing and Dual Level Retrieval

LightRAG架构图

2. LightRAG相比于GraphRAG的优势

虽然GraphRAG是开创性技术,但是它资源消耗太大。每一次运行往往需要数百次大模型API调用,通常用于像DeepSeek-R1这样昂贵的大型模型,这显然不适用于本地部署私有大模型的大多数场景。另外,每次更新外部数据源时GraphRAG都必须重建整个图谱,从而增加了成本。而LightRAG则不同:

  • 使用更少的API调用,可以适用于更加轻量级的模型,如QwQ-32B。据测试,LightRAG的Token消耗仅为微软GraphRAG的1/6000,API调用次数减少约 90%。

  • 允许对图形进行增量更新,而无需完全重新生成。

  • 支持双层检索,如局部检索和全局检索,增强了检索信息的能力。它能够从低级别(具体细节)和高级别(宏观主题)两个层次全面检索信息,充分利用基于图的文本索引,捕获查询的完整上下文,从而生成更为丰富的回答。
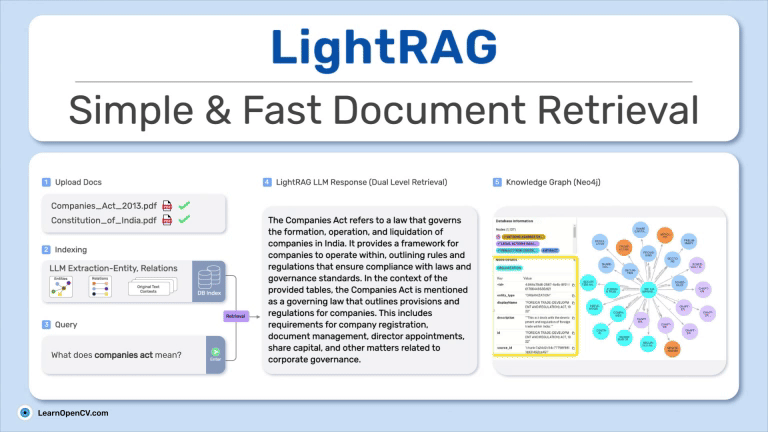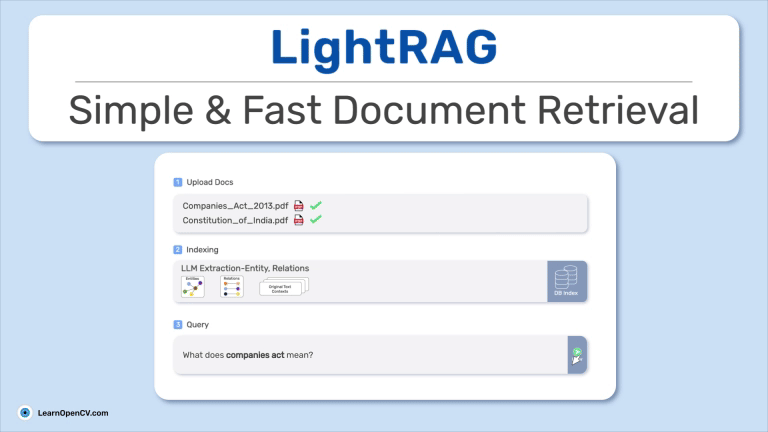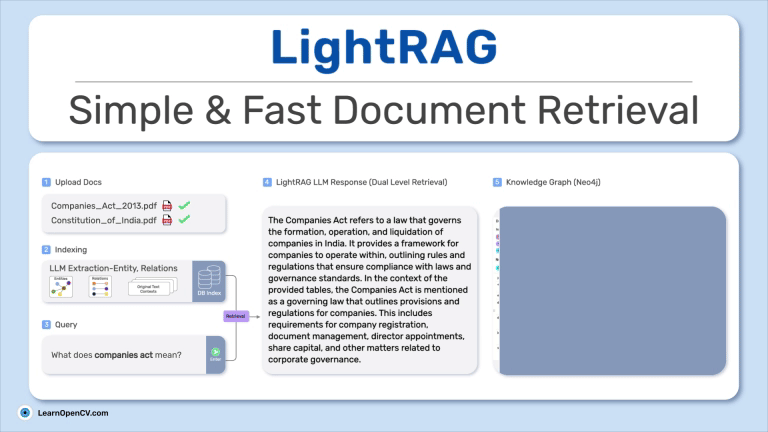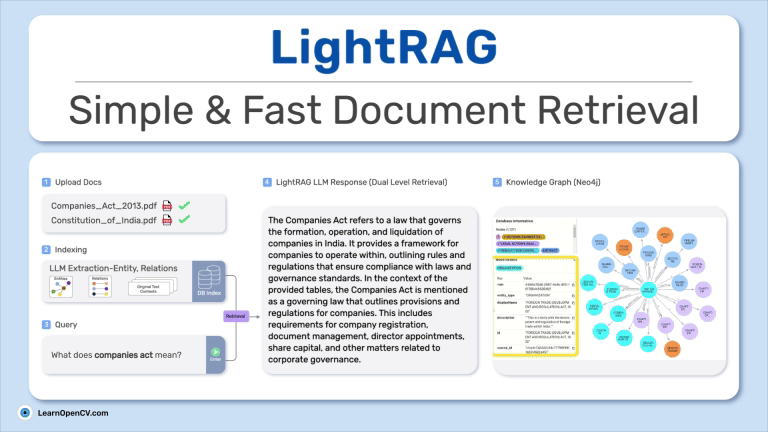
LightRAG: Simple and Fast Alternative to GraphRAG

一句话,LightRAG更快、更经济,并且允许对图进行增量更新,无需完全重新生成整个图谱。

AgenticRAG

1. 什么是AgenticRAG

AgenticRAG的核心思想是在每个阶段引入自主智能体Agent。

其工作的主要步骤有:

第一步:查询重写。智能体对用户查询输入信息进行重写,例如修正拼写错误。

第二步:额外信息获取。智能体判断是否需要额外的信息,比如通过搜索引擎或者调用工具获取必要的数据。

第三步:内容检查。在生成内容后,智能体会检查答案的相关性和有效性。如果不符合要求,系统会返回第一步,修改查询并继续迭代,直到找到相关内容或告知用户问题无法回答。

下图为AgenticRAG的工作流程图。
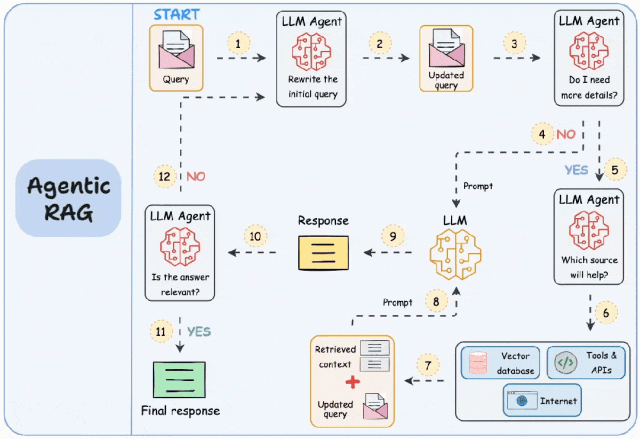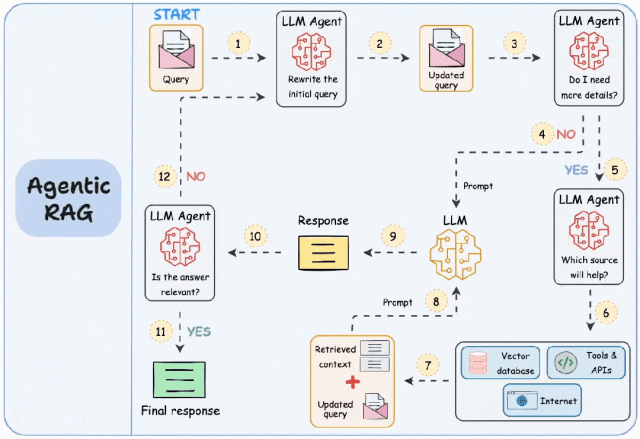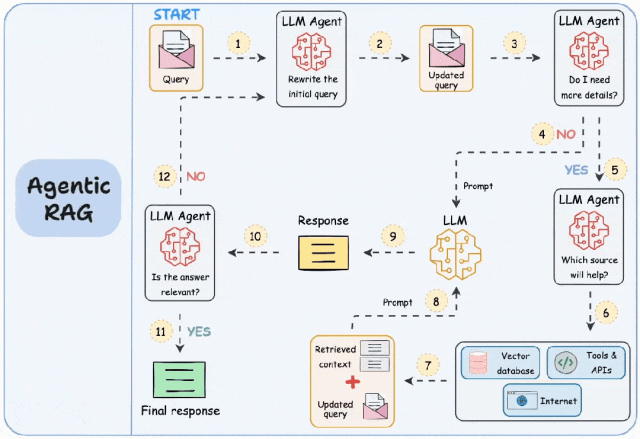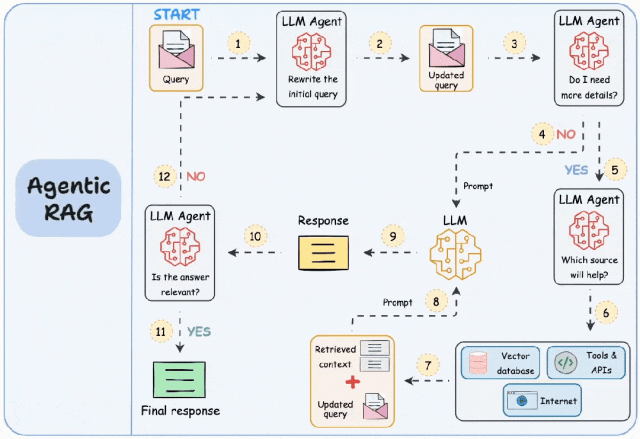
Agentic RAG工作流程图

2. 技术优势

AgenticRAG在传统RAG的基础上引入了AI Agent(智能体),强调自主决策和动态交互能力。能够处理复杂的对话、多轮交互和动态调整检索策略,适应用户复杂需求。Agentic也是未来智能体开发的一个重要基础型技术思路。

但是相较于传统RAG,它的成本更高,处理时间更长,更适合用于复杂对话系统、虚拟助手等场景,能够有效处理多轮对话和复杂查询。

随着大模型技术的逐步成熟,生态逐步完善,人们对大模型需求的进一步提高,AgenticRAG将会有更大的发展空间,有望成为基础设施级别的技术需求,比如AgenticRAG功能直接融入基础大模型,成为大模型功能必备的能力之一。

技术选型

前文AI新智力 | AI | 大模型入门(十):RAG vs. KAG-CSDN博客我们也提到过阿里推出的知识图谱解决方案KAG。因此对于知识图谱的检索增强生成场景,我们有众多的解决方案可以选择。在技术选型时建议选择合适的解决方案:

1. 如果是搭建简单的企业内部办公问答助手客服机器人,外部数据源是表格、word文本等纯文本类型,可以选择传统RAG。

2. 如果是用于专业领域的知识关联分析的行业专家机器人,外部数据源非常庞大,并且是逻辑关系极高的知识图谱等内容,且不会轻易更新,比如医疗诊断图谱、法律条款关联分析等,可以选择GraphRAG或者KAG。

3. 如果是用于专业领域的知识关联分析的行业专家机器人,外部数据源不会太大,而且是逻辑关系极高的知识图谱等内容,并且具有实时更新需求,比如医疗案例分析、审判案件分析等,可以选择LightRAG。

4. 如果是用于解决复杂的开放型问题,需要主动检索外部数据、多轮交互,推理过程等功能,可以选择AgenticRAG。

总结:简单问答直接用传统RAG(简单好用),有知识图谱需求用LightRAG(便宜轻便好用),更加复杂的需求用AgenticRAG(复杂但功能强大)。

注:目前,大模型技术还处于初始发展阶段,各种思路、技术架构野蛮生长,不断推陈出新,各种应用、框架还处于还在快速迭代过程中。今天选择了一种技术,明天可能就会有更好的解决方案。今天遇到无法逾越的障碍,明天解决方案可能就已经集成到大模型中。

参考文献:

1.https://arxiv.org/pdf/2404.16130

2.https://arxiv.org/pdf/2410.05779

3.https://learnopencv.com/lightrag/

4.https://github.com/HKUDS/LightRAG

THE END !

文章结束,感谢阅读。您的点赞,收藏,评论是我继续更新的动力。大家有推荐的公众号可以评论区留言,共同学习,一起进步。

存储&AI行业每日要闻(2026-10-25 影响:这是市场对"烧钱就能赢"叙事的一次集体重估——Meta 主动设 C 类股稀释投票权也要融资,SpaceX 单季资本开支逼近营收 1.35 倍,叠加前一日博通 600 亿/SpaceX 400 亿芯片抵押融资,AI 基建已进入"股权+债务双管抽血"阶段;若指引保守,则昨日费半暴跌的余波将继续发酵。影响:DSX POD 的本质是把 AI 基建从"定制工程"变成"集装箱产品"——这与前一日"芯片抵押融资 5000 亿框架"形成闭环:英伟达不仅卖 GPU,还帮客户解决融资、集成、电力等全链条问题; 阅读详情

相关推荐

第33章 YOLO+OpenCV:视频流网络传输

本案例演示用视觉处理库连接网络视频流并逐帧显示画面。程序先打开流地址,再循环取帧、显示、等待按键退出,并用重试计数应对连接失败与读取中断。验证时关注窗口能否稳定出画、是否长时间卡顿黑屏、退出后终端有无报错。🌈

小哥谈 515

LightRAG: Simple and Fast Retrieval-Augmented Generation——简单高效的检索增强型生成模型

LightRAG: Simple and Fast Retrieval-Augmented Generation——简单高效的检索增强型生成模型

Together_CZ的博客 1899

电商数据分析19——数据分析在电商平台价格弹性研究中的应用

价格弹性是一个衡量产品价格变化对销量影响的经济学指标,对于电商平台而言,深入理解和有效运用价格弹性,对于制定竞争策略、优化产品定价具有重要意义。随着大数据时代的到来,通过数据分析研究产品的价格弹性,成为了电商企业制定价格策略、调整市场定位、优化促销活动的重要依据。

theskylife的博客 2829

LLMs之RAG:《LightRAG: Simple and Fast Retrieval-Augmented Generation》翻译与解读

​ LLMs之RAG:《LightRAG: Simple and Fast Retrieval-Augmented Generation》翻译与解读 目录 《LightRAG: Simple and Fast Retrieval-Augmented Generation》翻译与解读 Abstract 1 Introduction Conclusion 《LightRAG: Simple and Fast Retrieval-Augmente

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 3333

基于NXP i.MX RT1180的无传感器FOC电机驱动实战指南

磁场定向控制(FOC)是一种先进的电机控制技术,它通过精密的数学变换,将三相交流电机的控制解耦为独立的转矩和磁场分量,从而实现高效、平稳、低噪音的驱动。其核心原理在于利用Park/Clark变换,在旋转坐标系下对电流进行线性控制。这项技术的价值在于显著提升了永磁同步电机(PMSM)的效率与动态性能,广泛应用于机器人、无人机和工业自动化等高精度场景。本文聚焦于利用NXP i.MX RT1180跨界处理器及其MCUXpresso SDK,快速实现一套完整的无传感器FOC解决方案。通过解析硬件平台选型、软件架构,

weixin_33925615的博客 295

Apollo 9.0 参考线生成器 -- ReferenceLineProvider

在基于参考线的规划算法中,参考线是Planning一切工作的基础和前提,所以搞清楚参考线怎么来的就变得很重要。为此,首先需要了解Planning 与 Routing的交互,通过交互得到路径片段,这些路径片段就告诉我们该怎么走,再在此基础上生成参考线,最后使用不同的平滑算法对参考线进行平滑,得到一条光滑的参考线。

WaiNgai 1656

使用LightRAG构建基于ollama deepseek-r1:32b 本地大模型的知识检索系统

在知识密集型应用场景中,如何快速从海量文本中提取关键信息是关键挑战。库结合本地大模型(通过OLLAMA部署),实现一个轻量级的知识检索与生成系统。

东方佑 2074

从 Chat 提示词到可运行 Fiori 应用,ADT for VS Code 正在把 RAP 开发带进 Agent 时代

本文探讨了在VS Code中使用AI辅助进行ABAP RAP开发的新模式。文章指出,传统RAP开发需要手工创建数据库表、CDS视图、行为定义等十多个关联对象,命名和关联关系容易出错。现在通过GitHub Copilot Agent Mode配合ADT MCP Server,开发者可用自然语言描述业务场景直接生成完整的RAP业务对象。这种生成式开发的核心价值在于:1)通过标准化工具接口(MCP)连接ABAP后端,确保生成符合规范的RAP对象;2)能正确处理多实体组合场景下的命名一致性和关联关系;3)保持生成结

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 74

「大车小标」自动稽核怎么落地:识别车型与计费车型如何自动比对、争议如何排除

在高速公路货车逃费里,"大车小标"是最高频、也最难缠的一类:实际是更大车型、更多轴数的货车,却按更小车型交费,跑同样的路交更少的钱。单次差额可能不大,但放到长距离、高频次、规模化运营的路网里,累积的通行费流失相当可观。自动稽核"大车小标",核心不是"识别出这是什么车"这么简单,而是要把多个来源的车型判断和最终计费车型自动比对,并在大量正常交易里把真正可疑的少数挑出来,同时把设备误差、遮挡污染造成的误判排除掉。本文拆解这条链路的工程落地思路,全文定性,不涉及具体识别率与金额。

weixin_53898122的博客 355

PCL 点云格式转换【2024最新版】

常见点云格式转化汇总包括txt、stl、csv、ply、obj、xyz、las等。博客长期更新,本文最近一次更新时间为:2024年9月14日,代码更新至PCL1.14.1版本。

点云侠的博客 39万+

使用Simulink进行四足机器人的非线性动力学建模与仿真

四足机器人的运动包含多个自由度(DOF),包括腿部的摆动和支撑阶段的动力学特性。由于存在接触力、摩擦以及不同地形的影响,四足机器人的动力学行为呈现出高度的非线性特征。因此,构建准确的非线性动力学模型对于研究机器人的运动学和动力学特性至关重要。定义代表机器人状态的变量,如位置、速度、角度和角速度。matlab深色版本通过本指南,我们介绍了如何基于Simulink搭建一个四足机器人的非线性动力学模型,并进行了详细分析。

xiaoheshang_123的博客 308

【技术拆解】配音工具选型评估方法论:用 6 个维度给 AI 配音软件打打分

✅ 测试方案:准备一段包含括号注释、数字、中英文混排的文案导入试听,校验读音、停顿是否合理。案例参考:逗哥配音配套了文案提取、自动对轴、人声分离、声音转换等附加工具,支持 wav /mp3 /mp4 格式导出,可附带字幕与 SRT 文件,在字幕对齐、文件导出这条链路具备对应的能力,适合批量生产场景的创作者在这个维度进行自测打分。同一款配音引擎,有人评价 “自然接近真人”,也有人反馈 “AI 感很重”,核心差异往往来自使用场景:30 字以内的短口播,和 3000 字小说章节朗读,对引擎能力要求完全不一样。

zhizhizhuzhuxia的博客 147

不同IP网段的PLC进行S7通信(PUT_GET)的具体步骤

不同IP网段的PLC进行S7通信(PUT_GET)的具体步骤 一般情况下,我们使用西门子的S7通信时都是将网络中的PLC的IP设置在同一网段,那么如果涉及到旧项目改造时,不方便修改IP地址,只能进行2个网段通信时,可以参考以下步骤: 准备条件: 2个路由器 CPU 1212C 主动连接 CPU 314C-2PN/DP 被动连接 网络搭建如下图所示: S7-1212C一侧 建立S7主动连接 ,IP地址:192.168.5.40,编写get/put 通信程序 S7-300 IP地址:192.168.0

Robot_PLC_HMI_Automation 2万+

外贸独立站 AI 爬虫日志分析:UA 清单、状态码分布与「爬取不等于引用」

日志可反映爬虫访问路径、状态码与UA,但无法证明内容是否被AI引用。需按UA、状态码、路径三层分析,识别可达性问题,避免误判“抓取=引用”。应结合实测验证引用效果,警惕日志误导。关键结论:抓取≠收录≠引用,技术优化仅解决可抓取性,不保证被引用。

mqhgeo的博客 345

手把手教你使用 YOLOv11/v8 算法 + PaddleOCR 算法完成车牌检测和车牌识别系统,AI智能体,毛玻璃系统,包括PaddlePaddle安装、数据集预处理、模型训练、AI大模型应用等

手把手教你使用 YOLOv11/v8算法 + PaddleOCR算法完成车牌检测和车牌识别系统,AI智能体,毛玻璃系统,包括PaddlePaddle安装、数据集预处理、模型训练、AI大模型应用等。车牌识别系统支持 蓝牌、绿牌、黄牌、双层车牌等车牌识别。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 2764

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

把GeoReady九维当工程项做:储能管理官网的AI就绪度改造笔记

GeoReady把1900多个网站的审计数据摊开,做成实时基准(State of GEO):AI搜索就绪度平均56.7/100,中位数59,一半以上卡在地基档。这篇用工程视角拆解这份基准:九维权重分别对应哪些工程项(robots.txt放行AI爬虫、llms.txt部署、Schema JSON-LD注入、Meta标签规范化、品牌实体清晰),哪些是「白给的分」,以及怎么把就绪度检查纳入CI流水线。先说结论——56.7分测的是机器可读性,是卫生指标不是排名;工程上先补最便宜的两块(llms.txt+JSON-L

RoseMarketing的博客 252

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

LDR6100 智能遥控器精品软文:Type-C 充电口与低功耗量产维护

当 USB-C 接口从单纯的结构升级,变成整机供电稳定性、待机续航、量产一致性的核心瓶颈,智能遥控器、语音遥控器、手持控制器这类小型手持设备的硬件开发,早已不再是 “换一个 Type-C 座子” 那么简单。大量项目在试产阶段反复踩坑:不同品牌适配器识别失败、热插拔瞬间掉电死机、整机休眠待机电流超标导致电池续航缩水、产线测试时端口状态无法捕捉、兼容性参差不齐。乐得瑞 LDR6100 作为单路 USB-C/PD 专用控制芯片,专为小体积手持设备的 Type-C 供电入口量身打造。

LDR006的博客 407

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

什么是AI、模型和token、vibecoding介绍、ClaudeCode环境搭建

AI是用计算机模拟人类思维与行为的技术,不具意识,仅作为能力放大器。模型是其核心,参数量决定智能水平,大模型历经文本、多模态到全模态演进。大模型按任务表现排名,如千问、DeepSeek等。收费以token为单位,按使用量或套餐计费。Vibecoding通过自然语言生成代码,工具包括ClaudeCode、Cursor等。安装可选CLI或GUI版本,需配置Python、Git、Node及大模型账号,提升开发效率。

2501_91966873的博客 259

Python 浏览器自动化:Selenium vs Playwright 底层原理、实现细节 + Codex 大模型为什么能自主操控浏览器登录填表

Selenium。缺点维护成本高,不适合对接 AI。Playwright,CDP+AX 语义树是核心优势。用自然语言代替硬编码选择器,让 AI 看懂网页语义,自主完成多步网页任务。传统自动化是 “人告诉程序每一步点击哪里”;AI 浏览器 Agent 是 “人告诉程序目标,AI 自己观察页面,决定点哪里,自主完成任务”。

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 327

【论文解读】DMH-Net:用深度曼哈顿霍夫变换从全景立方图估计3D房间布局

想象一个空房间,把所有面都去掉,只剩下棱┌─────────────┐ ← 墙与天花板的交界线/│ /│/ │ / │ ← 墙与墙的交界线(竖直)│ │ │ ││ / │ /└─┘───────────┘ ← 墙与地板的交界线论文的房间线框只有三类线线类型是什么在 3D 空间中的方向墙-天花板交界线​墙顶那条边水平,在天花板平面上墙-地板交界线​墙脚那条边水平,在地板平面上墙-墙交界线​两面墙相交的竖棱竖直​为什么用线框?​ 论文给的动机很有说服力:人类感知 3D 世界时,靠的是。

拜小白的成长之路,告别小白 354

8G 显存本地部署 AI 漫剧流水线:分镜提示词版本管理、批量归档与角色提示词隔离实战教程

本文针对8G显存本地部署的AI漫剧生产中提示词混乱、版本丢失、角色画风漂移等痛点,设计并实现一套轻量化本地提示词管理系统。系统基于纯JSON文件存储,支持角色提示词隔离、分镜模板复用、项目版本快照、批量校验与导入导出,与ComfyUI流水线无缝对接,实现画风一致性与高效复现。所有功能均无需数据库,可常驻后台运行,显著提升红果短剧系列化生产的稳定性与可维护性。

2603_96706877的博客 153

纳米 AI 搜索实战应用场景指南

在数字化运营的日常工作中,我们常常面临这样的困境:海量信息扑面而来,但真正能转化为决策依据的却寥寥无几。无论是电商团队需要精准锁定潜力爆款,还是市场部门急需捕捉转瞬即逝的热点,亦或是研究人员需要在浩如烟海的文献中梳理脉络,传统的人工检索与整理方式不仅效率低下,还极易遗漏关键细节。很多时候,我们花费了数小时甚至数天去收集数据,最后却发现信息滞后、来源单一,甚至存在事实偏差,导致后续的strategy制定建立在沙滩之上。这种“信息过载”与“价值稀缺”的矛盾,正在成为制约个人与企业成长的核心瓶颈。

llhllq2015的博客 213

32 分钟不是完成科研:多智能体读脑图谱,突破在哪里?

如果数千个 AI 智能体只用 32 分钟,就能梳理一份庞大的脑科学数据,我们应该惊讶什么?是模型终于能“独立做科研”,还是科研流程中的某个环节开始出现新的组织方式?10 月 21 日,OpenAI 公布了与 PerturbAI、Scripps Research 合作的研究:利用基于 GPT-Rosalind 的多智能体系统,解释一份已经存在的小鼠脑基因扰动数据,整理潜在研究线索。

weixin_44369324的博客 254

图像审核‑图片内容风控‑违规图像检测‑图片鉴黄鉴暴‑广告二维码识别‑图像风险筛查 API 接口介绍

名称类型必须说明imgBase64String否图像base64字符串imgFilefile否图像文件imgUrlString否图像url链接imgTypeString否图片类型 0: 静态图片(PNG、JPG、JPEG、BMP、GIF(仅对首帧进行审核)、Webp、TIFF)1: GIF动态图片 默认 0注意imgFile, imgBase64, imgUrl至少传入一个,优先级:imgBase64 > imgFile > imgUrl。

聚美智数 238

我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内容,你们AI导出鸭可以吗?

很多人第一次听到“导出对话”,脑子里浮现的是打开某一条聊天记录,右上角点一下导出,保存成一份文件。这不是为了设门槛,而是因为批量导出背后的枚举、并发、格式渲染成本,和单条导出完全不是一个量级。AI导出鸭 不做格式绑架,这是它作为导出工具的基本修养。回到标题那个问题:我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内,你们AI导出鸭可以吗?批量导出和选择性导出并不冲突,工具的设计逻辑是先枚举、再选择、后导出。我需要批量导出Poe左边栏所有对话,而不是一条具体的对话内容,你们AI导出鸭可以吗?

laoyunsi的博客 116

AI辅助逆向的完整链路——反汇编→特征提取→大模型重写

编译后的程序(PE/ELF/Mach-O)丢失了源代码几乎所有高层语义:变量名、注释、类型、函数命名、循环分支结构,只剩下CPU能识别的机器码。传统逆向链路:机器码 → 反汇编(汇编指令)→ 人工阅读 + 静态分析工具生成伪C → 人工梳理逻辑。优化编译、混淆、花指令会把控制流打碎,伪代码可读性极差;无符号剥离(stripped binary)下所有函数都是FUN_xxxx,变量全是v1、v2;单函数上下文有限,跨函数调用、数据依赖靠人脑记忆,效率极低;

weixin_43156294的博客 197
上一篇: 马哥Linux运维 | KVM虚拟化环境部署与性能优化:从入门到生产实践的完整指南
下一篇: 周报 | 25.9.1-25.9.7文章汇总
双木的木
博客等级 码龄8年 1万+粉丝 1458原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
