Raft一致性算法

Raft算法详解 Raft算法属于Multi-Paxos算法,它是在Multi-Paxos思想的基础上,做了一些简化和限制,比如增加了日志必须是连续的,只支持领导者、跟随者和候选人三种状态,在理解和算法实现上都相对容易许多 从本质上说,Raft算法是通过一切以领导者为准的方式,实现一系列值的共识和各节点日志的一致 1、领导者选举 1)、成员身份 Raft算法支持领导者(Leader)、跟随者(Follower)和候选人(Candidate)3种状态: 跟随者:接收和处理来自领导者的消息,当等待领导者心跳信息超时的时候,就主 阅读详情

Why Not Paxos

Paxos算法是莱斯利·兰伯特(LeslieLamport,就是 LaTeX 中的”La”,此人现在在微软研究院)于1990年提出的一种基于消息传递的一致性算法。由于算法难以理解起初并没有引起人们的重视,使Lamport在八年后1998年重新发表到ACM Transactions on Computer Systems上(The Part-TimeParliament)。即便如此paxos算法还是没有得到重视,2001年Lamport 觉得同行无法接受他的幽默感,于是用容易接受的方法重新表述了一遍(Paxos MadeSimple)。可见Lamport对Paxos算法情有独钟。近几年Paxos算法的普遍使用也证明它在分布式一致性算法中的重要地位。2006年Google的三篇论文初现“云”的端倪,其中的Chubby Lock服务使用Paxos作为Chubby Cell中的一致性算法,Paxos的人气从此一路狂飙。Lamport 本人在 他的blog 中描写了他用9年时间发表这个算法的前前后后。

“There is only one consensus protocol, and that’sPaxos-all other approaches are just broken versions of Paxos.” –Chubby authors

“The dirtylittle secret of the NSDI community is that at most five people really, trulyunderstand every part of Paxos ;-).” –NSDI reviewer

Notes:回想当年,我不知翻阅了多少资料,才勉强弄明白“Basic Paxos”,由于缺乏实践体会,至今对于“Multi-Paxos”仍如云里雾里,不得要领。反观本文的主角Raft,《InSearch of an Understandable Consensus Algorithm》,从它设计之初,作者就将Understandable作为最高准则,这在诸多决策选择时均有体现。

问题描述

分布式系统中的节点通信存在两种模型:共享内存(Shared memory)和消息传递(Messages passing)。基于消息传递通信模型的分布式系统,不可避免地会发生以下错误:进程可能会慢、垮、重启,消息可能会延迟、丢失、重复(不考虑“Byzantinefailure”)。

一个典型的场景是:在一个分布式数据库系统中,如果各节点的初始状态一致,每个节点都执行相同的操作序列,那么它们最后能得到一个一致的状态。为保证每个节点执行相同的命令序列,需要在每一条指令上执行一个「一致性算法」以保证每个节点看到的指令一致。一个通用的一致性算法可以应用在许多场景中,是分布式计算中的重要问题。从20世纪80年代起对于一致性算法的研究就没有停止过。
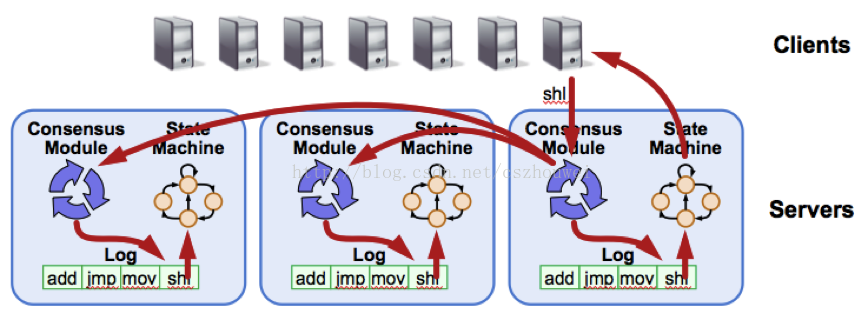
图 1Replicated State Machine Architecture

Raft算法将这类问题抽象为“ReplicatedState Machine”,详见上图,每台Server保存用户命令的日志,供本地状态机顺序执行。显而易见,为了保证“Replicated State Machine”的一致性,我们只需要保证“ReplicatedLog”的一致性。

算法描述

通常来说,在分布式环境下,可以通过两种手段达成一致:

1.       Symmetric, leader-less

所有Server都是对等的,Client可以和任意Server进行交互

2.       Asymmetric, leader-based

任意时刻,有且仅有1台Server拥有决策权,Client仅和该Leader交互

“Designing for understandability”的Raft算法采用后者,基于以下考虑:

1.       问题分解:Normaloperation & Leader changes

2.       简化操作:Noconflicts in normal operation

3.       更加高效:Moreefficient than leader-less approaches

基本概念

Server States

Raft算法将Server划分为3种角色:

1.       Leader

负责Client交互和log复制,同一时刻系统中最多存在1个

2.       Follower

被动响应请求RPC,从不主动发起请求RPC

3.       Candidate

由Follower向Leader转换的中间状态
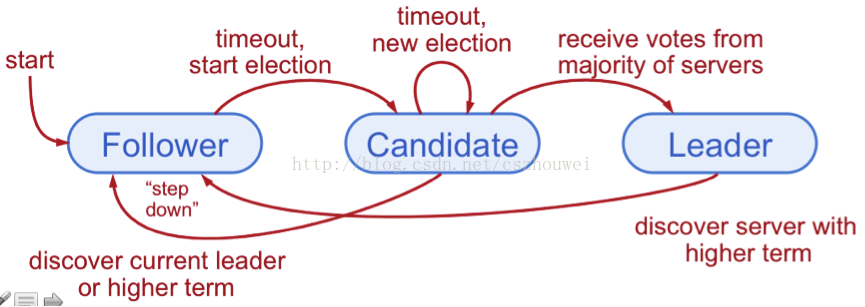
图 2Server States

Terms

众所周知,在分布式环境中,“时间同步”本身是一个很大的难题,但是为了识别“过期信息”,时间信息又是必不可少的。Raft为了解决这个问题,将时间切分为一个个的Term,可以认为是一种“逻辑时间”。如下图所示:

1.       每个Term至多存在1个Leader

2.       某些Term由于选举失败,不存在Leader

3.       每个Server本地维护currentTerm
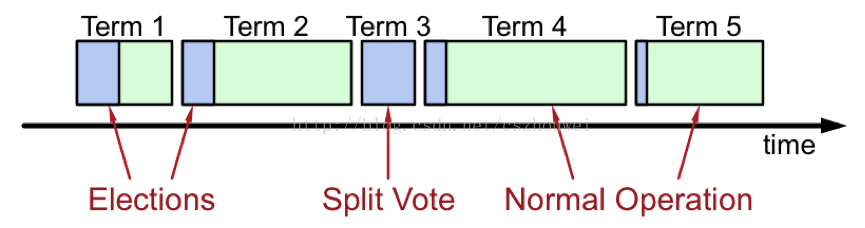
图 3Terms

Heartbeats and Timeouts

1.       所有的Server均以Follower角色启动,并启动选举定时器

2.       Follower期望从Leader或者Candidate接收RPC

3.       Leader必须广播Heartbeat重置Follower的选举定时器

4.       如果Follower选举定时器超时,则假定Leader已经crash,发起选举

Leader election

自增currentTerm,由Follower转换为Candidate,设置votedFor为自身,并行发起RequestVote RPC,不断重试,直至满足以下任一条件:

1.       获得超过半数Server的投票,转换为Leader,广播Heartbeat

2.       接收到合法Leader的AppendEntries RPC,转换为Follower

3.       选举超时,没有Server选举成功,自增currentTerm,重新选举

细节补充:

1.       Candidate在等待投票结果的过程中,可能会接收到来自其它Leader的AppendEntries RPC。如果该Leader的Term不小于本地的currentTerm,则认可该Leader身份的合法性,主动降级为Follower;反之,则维持Candidate身份,继续等待投票结果

2.       Candidate既没有选举成功,也没有收到其它Leader的RPC,这种情况一般出现在多个节点同时发起选举(如图Split Vote),最终每个Candidate都将超时。为了减少冲突,这里采取“随机退让”策略,每个Candidate重启选举定时器(随机值),大大降低了冲突概率


Log replication
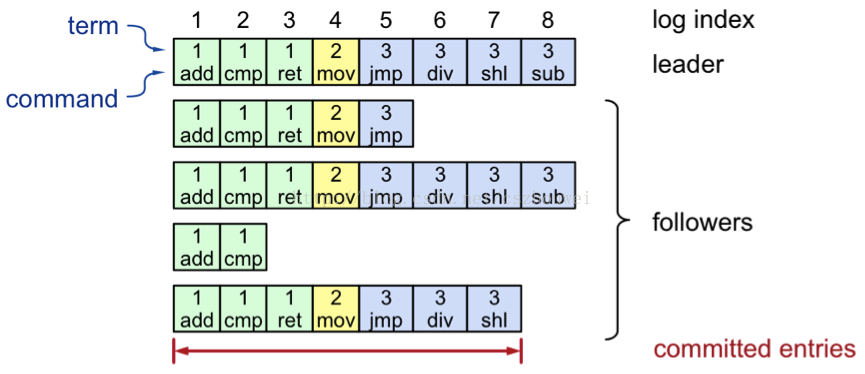
图 4Log Structure

正常操作流程:

1.       Client发送command给Leader

2.       Leader追加command至本地log

3.       Leader广播AppendEntriesRPC至Follower

4.       一旦日志项committed成功:

1)     Leader应用对应的command至本地StateMachine,并返回结果至Client

2)     Leader通过后续AppendEntriesRPC将committed日志项通知到Follower

3)     Follower收到committed日志项后,将其应用至本地StateMachine

Safety

为了保证整个过程的正确性,Raft算法保证以下属性时刻为真:

1.       Election Safety

在任意指定Term内,最多选举出一个Leader

2.       Leader Append-Only

Leader从不“重写”或者“删除”本地Log,仅仅“追加”本地Log

3.       Log Matching

如果两个节点上的日志项拥有相同的Index和Term,那么这两个节点[0, Index]范围内的Log完全一致

4.       Leader Completeness

如果某个日志项在某个Term被commit,那么后续任意Term的Leader均拥有该日志项

5.       State Machine Safety

一旦某个server将某个日志项应用于本地状态机,以后所有server对于该偏移都将应用相同日志项

直观解释:

为了便于大家理解Raft算法的正确性,这里对于上述性质进行一些非严格证明。

“ElectionSafety”:反证法,假设某个Term同时选举产生两个LeaderA和LeaderB,根据选举过程定义,A和B必须同时获得超过半数节点的投票,至少存在节点N同时给予A和B投票,矛盾

LeaderAppend-Only: Raft算法中Leader权威至高无上,当Follower和Leader产生分歧的时候,永远是Leader去覆盖修正Follower

LogMatching:分两步走,首先证明具有相同Index和Term的日志项相同,然后证明所有之前的日志项均相同。第一步比较显然,由Election Safety直接可得。第二步的证明借助归纳法,初始状态,所有节点均空,显然满足,后续每次AppendEntries RPC调用,Leader将包含上一个日志项的Index和Term,如果Follower校验发现不一致,则拒绝该AppendEntries请求,进入修复过程,因此每次AppendEntries调用成功,Leader可以确信Follower已经追上当前更新

LeaderCompleteness:为了满足该性质,Raft还引入了一些额外限制,比如,Candidate的RequestVote RPC请求携带本地日志信息,若Follower发现自己“更完整”,则拒绝该Candidate。所谓“更完整”,是指本地Term更大或者Term一致但是Index更大。有了这个限制,我们就可以利用反证法证明该性质了。假设在TermX成功commit某日志项,考虑最小的TermY不包含该日志项且满足Y>X,那么必然存在某个节点N既从LeaderX处接受了该日志项,同时投票同意了LeaderY的选举,后续矛盾就不言而喻了

StateMachine Safety:由于LeaderCompleteness性质存在,该性质不言而喻

Cluster membership changes

在实际系统中,由于硬件故障、负载变化等因素,机器动态增减是不可避免的。最简单的做法是,运维人员将系统临时下线,修改配置,重新上线。但是这种做法存在两个缺点:

1.       系统临时不可用

2.       人为操作易出错
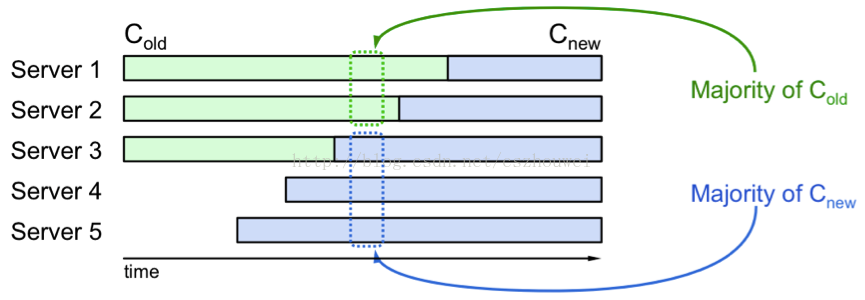
图 5Online Switch Directly

失败的尝试:通过运维工具广播系统配置变更,显然,在分布式环境下,所有节点不可能在同一时刻切换至最新配置。由上图不难看出,系统存在冲突的时间窗口,同时存在新旧两份Majority。

两阶段方案:为了避免冲突,Raft引入Joint中间配置,采取了两阶段方案。当Leader接收到配置切换命令(Cold->Cnew)后,将Cold,new作为日志项进行正常的复制,任何Server一旦将新的配置项添加至本地日志,后续所有的决策必须基于最新的配置项(不管该配置项有没有commit),当Leader确认Cold,new成功commit后,使用相同的策略提交Cnew。系统中配置切换过程如下图所示,不难看出该方法杜绝了Cold和Cnew同时生效的冲突,保证了配置切换过程的一致性。

图 6Joint Consensus

Log compaction

随着系统的持续运行,操作日志不断膨胀,导致日志重放时间增长,最终将导致系统可用性的下降。快照(Snapshot)应该是用于“日志压缩”最常见的手段,Raft也不例外。具体做法如下图所示:
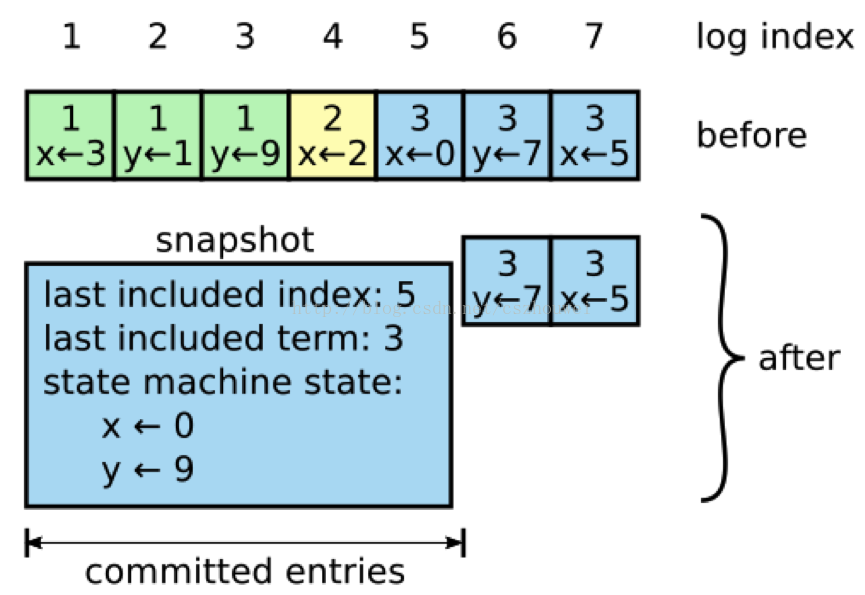
图 7S基于“快照”的日志压缩

与Raft其它操作Leader-Based不同,snapshot是由各个节点独立生成的。除了日志压缩这一个作用之外,snapshot还可以用于同步状态:slow-follower以及new-server,Raft使用InstallSnapshot RPC完成该过程,不再赘述。

Client interaction

典型的用户交互流程:

1.       Client发送command给Leader

            若Leader未知,挑选任意节点,若该节点非Leader,则重定向至Leader

2.       Leader追加日志项,等待commit,更新本地状态机,最终响应Client

3.       若Client超时,则不断重试,直至收到响应为止

细心的读者可能已经发现这里存在漏洞:Leader在响应Client之前crash,如果Client简单重试,可能会导致command被执行多次。

Raft给出的方案:Client赋予每个command唯一标识,Leader在接收command之前首先检查本地log,若标识已存在,则直接响应。如此,只要Client没有crash,可以做到“Exactly Once”的语义保证。

个人建议:尽量保证操作的“幂等性”,简化系统设计!

发展现状

Raft算法虽然诞生不久,但是在业界已经引起广泛关注,强烈推荐大家浏览其官网http://raftconsensus.github.io,上面有丰富的学习资料,目前Raft算法的开源实现已经涵盖几乎所有主流语言(C/C++/Java/Python/Javascript …),其流行程度可见一斑。由此可见,一项技术能否在工业界大行其道,有时“可理解性”、“可实现性”才是至关重要的。

应用场景

timyang在《Paxos在大型系统中常见的应用场景》一文中,列举了一些Paxos常用的应用场合:

1.       Database replication, logreplication …

2.       Naming service

3.       配置管理

4.       用户角色

5.       号码分配

Note:对于分布式锁、数据复制等场景,非常容易理解,但是对于“Naming Service”一类应用场景,具体如何实操,仍然表示困惑。翻阅一些资料发现,借助Zookeeper的watch机制,当配置发生变更时可以实时通知注册客户端,但是如何保证该通知的可靠送达呢,系统中是否可能同时存在新旧两份配置?烦请有相关经验的高人私下交流~

一文彻底搞懂Raft算法,看这篇就够了!!! 分布式系统通常由异步网络连接的多个节点构成,每个节点有独立的计算和存储,节点之间通过网络通信进行协作。分布式一致性指多个节点对某一变量的取值达成一致,一旦达成一致,则变量的本次取值即被确定。在大量客户端并发请求读/写的情况下,维护数据多副本的一致性无疑非常重要,且富有挑战。因此,分布式一致性在我们生产环境中显得尤为重要。数据不能存在单个节点(主机)上,否则可能出现单点故障。多个节点(主机)需要保证具有相同的数据。 阅读详情

相关推荐

二十张图带你一次性学懂Raft算法

一文带你领略Raft算法的魅力

weixin_45563088的博客 1769

Raft算法 应用于etcd和Mongodb主从集

Paxos算法详解一文讲述了晦涩难懂的Paxos算法,以可理解性和易于实现为目标的Raft算法极大的帮助了我们的理解,推动了分布式一致性算法的工程应用,本文试图以通俗易懂的语言讲述Raft算法。 一、Raft算法概述 不同于Paxos算法直接从分布式一致性问题出发推导出来,Raft算法则是从多副本状态机的角度提出,用于管理多副本状态机的日志复制。Raft实现了和Paxos相同的功能,它将一致性分解为多个子问题:Leader选举(Leader election)、日志同步(Log replication)

qq_36414739的博客 663

一致性算法之Raft算法

一致性raft算法简单理解

aichojie的博客 2355

Raft 一致性算法论文

本篇博客为著名的 RAFT 一致性算法论文的中文翻译,论文名为《In search of an Understandable Consensus Algorithm (Extended Version)》(寻找一种易于理解的一致性算法)。 Raft 是一种用来管理日志复制的一致性算法。它和 Paxos 的性能和功能是一样的,但是它和 Paxos 的结构不一样;这使得 Raft 更容易理解并且更易...

跨链技术践行者 1万+

Raft 一致性算法

RaftRafthttp://thesecretlivesofdata.com/raft/

Tom的专栏 6000

强一致性算法Paxos、Raft、ZAB

在B站上一个讲这三个算法的视频网址https://www.bilibili.com/video/av21667358 Paxos协议 Basic paxos算法中,分为4种角色: Client: 系统外部角色,产生议题者,像民众 Proposer :接收议题请求,像集群提出议题(propose),并在冲突发生时,起到冲突调节的作用,像议员 Acceptor:提议的投票者和决策者,只有在形...

ystyaoshengting的专栏 3762

一致性算法Raft详解

原文出处:http://www.solinx.co/archives/415?utm_source=tuicool&utm_medium=referral 一致性算法Raft详解 背景   熟悉或了解分布性系统的开发者都知道一致性算法的重要性,Paxos一致性算法从90年提出到现在已经有二十几年了,而Paxos流程太过于繁杂实现起来也比较复杂,可能也是以为过于复杂

小小本科生成长之路 1万+

python 中心线提取_二值分析 | OpenCV + skimage如何提取中心线

点击上方蓝字关注我们微信公众号:OpenCV学堂关注获取更多计算机视觉与深度学习知识问题前几天有个人问了我一个问题,问题是这样的,他有如下的一张二值图像:怎么得到白色Blob中心线,他希望的效果如下:显然OpenCV中常见的轮廓分析无法获得上面的中心红色线段,本质上这个问题是如何提取二值对象的骨架,提取骨架的方法在OpenCV的扩展模块中,另外skimage包也支持图像的骨架提取。这里就...

weixin_42204453的博客 4283

一致性算法 - Raft

一致性算法 - Raft Raft 状态 一个 Raft 集群包含若干个服务器节点;通常是 5 个,这允许整个系统容忍 2 个节点的失效,每个节点处于以下三种状态之一: follower(跟随者) :所有结点都以 follower 的状态开始。如果没收到 leader消息则会变成 candidate状态。 candidate(候选人):会向其他结点“拉选票”,如果得到大部分的票则成为lea...

我不是大牛 5564

基于Matlab与Gurobi的园区微电网风光储协同规划:从独立运营到联合优化的建模实战

本文详细介绍了如何利用Matlab与Gurobi进行园区微电网的风光储协同规划建模实战。通过构建从独立运营到联合优化的数学模型,结合Yalmip工具箱,旨在解决源荷不匹配问题,实现储能系统的最优配置与运行,从而降低总供电成本并提升新能源利用率。

weixin_29053073的博客 139

从零构建EtherCAT从站:SSC工具配置与TwinCAT3 PDO/SDO调试实战

本文详细介绍了从零构建EtherCAT从站的完整流程,重点讲解SSC工具配置与TwinCAT3 PDO/SDO调试实战。通过解析EtherCAT通信机制、PDO与SDO的核心概念,提供SSC工具配置技巧、XML文件生成与校验方法,以及TwinCAT3环境下的调试经验,帮助开发者高效完成EtherCAT从站开发与优化。

weixin_42520573的博客 328

Nacos的Raft一致性算法

(ps:如果是遇到平票现象,则会增加系统不可用时间,因此,raft中引入了randomized election timeouts,尽量避免出现平票现象的产生)一旦选举完毕,leader节点会给所有其他节点发消息,避免其他节点触发新的选举。多副本服务就会出现副本的一致性问题,比如client1将replica1的X值设置为1,而client2将replica2的X值设置为2,这样如果另一个客户client3从不同的副本获取到的X值可能是1也可能是2,这就导致了副本的一致性问题。

m0_59877551的博客 1430

Android车载桌面开发实战:从CarLauncher源码解析到自定义Launcher开发(Android 11)

本文深入解析了Android 11中CarLauncher的源码架构与核心模块,并提供了从零开始定制开发车载Launcher的完整实战指南。内容涵盖车载桌面的独特定位、驾驶场景优化、多屏协同、动态内容嵌入等核心挑战,以及如何构建符合安全规范、体验流畅的自定义车载桌面应用,是车载应用开发者提升系统级定制能力的实用参考。

weixin_29266647的博客 511

一致性算法Raft

在分布式系统中,一致性算法允许机器集群在部分成员故障时作为一个协调一致的整体工作,对构建可靠大规模软件系统至关重要。Raft 通过选举领导者来管理复制日志,将共识问题分解为领导者选举、日志复制和安全性等子问题。

xxz610的博客 949

WPF基础系列六:MVVM框架

MVVM框架 文章目录MVVM框架前言一、MVVM框架简介1. 什么是MVVM?2. MVVM的优势3.MVVM的应用场景二、MVVM使用及示例 前言 在WPF开发中,经典的编程模式是MVVM,是为WPF量身定做的模式,该模式充分利用了WPF的数据绑定机制,最大限度地降低了Xmal文件和CS文件的耦合度,也就是UI显示和逻辑代码的耦合度,如需要更换界面时,逻辑代码修改很少,甚至不用修改。 与WinForm开发相比,我们一般在后置代码中会使用控件的名字来操作控件的属性来更新UI,而在WPF中通常是通过

iceberg7012的博客 2万+

当我们谈论Unidbg时我们在谈什么

文章目录一、前言二、使用Unidbg的工作量是什么三、补环境补的是什么3.1 运行环境缺失3.2 上下文缺失四、Unidbg 不是所有情况下最优的解决方案五、Unidbg在大多数情况下是好的方案六、Unidbg和风控无关七、尾声 一、前言 这是一篇漫谈Unidbg的文章,我对Unidbg的使用和理解都还很浅,日后会更新或修改看法,欢迎大佬指点,也期待同侪讨论。 二、使用Unidbg的工作量是什么 我们常规使用Frida + IDA的动静态分析中,工作可能是这样的 找线索→Frida Hook验证→验证成功继

lilac的博客 5781

强一致性算法:Raft

raft算法

2301_80926085的博客 2730

claude code desktop中出现Doesn‘t look like an Anthropic model - expected a gateway model route 解决方案

本文主要介绍了claude code desktop中出现Doesn’t look like an Anthropic model - expected a gateway model route referencing an Anthropic model和Server is busy. Retrying的解决方案,希望能对使用claude code desktop的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 9万+

分布式一致性算法——Paxos 和 Raft 算法

本文主要围绕Paxos算法和Raft算法进行了讨论。我们首先介绍了分布式一致性算法的概念和必要性,然后分别从算法基本原理、角色和状态、基本流程、选举过程、优缺点等方面详细介绍了Paxos算法和Raft算法。同时,我们也对这两种算法进行了比较和区分,并讨论了如何选择合适的算法以满足不同场景下的需求和限制。为了更加清晰地描述算法的流程,我们也对Paxos算法和Raft算法的基本流程和选举过程进行了图形化展示。本文将对从事分布式系统相关工作的人员有所帮助,有助于更好地理解分布式一致性算法。

Shockang的博客 6680

Python FastAPI 面试题及参考答案

FastAPI 的路由机制是其核心功能之一,用于将不同的 URL 路径映射到相应的处理函数。通过定义路由,可以构建出功能丰富的 API。在 FastAPI 中,使用装饰器来定义路由。在这个示例中,是一个装饰器,它将根路径"/"的 GET 请求映射到read_root函数。当客户端发送一个 GET 请求到根路径时,FastAPI 会调用read_root函数并返回结果。

大模型大数据攻城狮的专栏 2234

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

对标Eureka的AP一致性,Nacos如何实现Raft算法

一、快速了解Raft算法 Raft 适用于一个管理日志一致性的协议,相比于 Paxos 协议 Raft 更易于理解和去实现它。为了提高理解性,Raft 将一致性算法分为了几个部分,包括领导选取(leader selection)、日志复制(log replication)、安全(safety),并且使用了更强的一致性来减少了必须需要考虑的状态。 相比Paxos,Raft算法理解起来更加直观。 Ra...

互联网架构师笔记 3219

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

Raft一致性算法,绝对好理解!!!

如图所示,这就是Raft的初次选举,在最开始的时候所有节点都是Follower,每个Follower都有一个定时器,当收到Leader的信息之后会更新定时器,当定时器结束时没有收到Leader发来消息,证明Leader已经死亡或者根本不存在,这个时候该节点就会变成Candidate,通过投票选举(该节点向其他节点发出投票信息,如果超过一半以上即通过选举,该节点成为Leader),成功成为Leader之后,新的Leader会向其他Follower发送心跳信息,方式其他节点成为Leader节点。

zihenzzz的博客 1402

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Golang实现Raft一致性算法

Golang实现Raft一致性算法前言流程分析功能实现运行步骤与测试参考资料 前言 本文在理解raft算法的基础上,实现了简易版的raft算法 github源码地址 流程分析 //TODO 明天再优化流程图,累了 功能实现 节点状态分为Leader(领导者)、Follower(追随者)、Candidate(候选人) 节点间随机成为candidate状态并选举出Leader,且同时仅存在一个Leader Leader节点定时发送心跳检测至其他Follower节点 Follower节点们超过一定时间未收到心

清风 2272

Raft -【go一致性算法】

介绍 Raft 状态 一个 Raft 集群包含若干个服务器节点;通常是 5 个,这允许整个系统容忍 2 个节点的失效,每个节点处于以下三种状态之一: follower:所有结点都以 follower 的状态开始。如果没收到leader消息则会变成candidate状态。 candidate:会向其他结点“拉选票”,如果得到大部分的票则成为leader。这个过程就叫做Leader选举(L...

rayylee 495
上一篇: 基于Boost.MultiIndex实现的Session管理器
下一篇: Cached VS Buffers
cszhouwei
博客等级 码龄18年 102粉丝 17原创
评论 12
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值