


项目背景介绍
Forecast sales using store, promotion, and competitor data
Rossmann operates over 3,000 drug stores in 7 European countries. Currently,
Rossmann store managers are tasked with predicting their daily sales for up to six weeks in advance. Store sales are influenced by many factors, including promotions, competition, school and state holidays, seasonality, and locality. With thousands of individual managers predicting sales based on their unique circumstances, the accuracy of results can be quite varied.
In their first Kaggle competition, Rossmann is challenging you to predict 6 weeks of daily sales for 1,115 stores located across Germany. Reliable sales forecasts enable store managers to create effective staff schedules that increase productivity and motivation. By helping Rossmann create a robust prediction model, you will help store managers stay focused on what’s most important to them: their customers and their teams!If you are interested in joining Rossmann at their headquarters near Hanover, Germany, please contact Mr. Frank König (Frank.Koenig {at} rossmann.de) Rossmann is currently recruiting data scientists at senior and entry-level positions.
数据
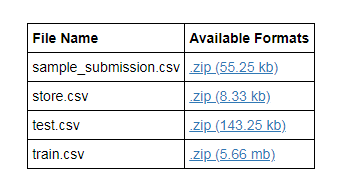
You are provided with historical sales data for 1,115 Rossmann stores. The task is to forecast the “Sales” column for the test set. Note that some stores in the dataset were temporarily closed for refurbishment.
Files
train.csv - historical data including Sales
test.csv - historical data excluding Sales
sample_submission.csv - a sample submission file in the correct format
store.csv - supplemental information about the stores
Data fields
Most of the fields are self-explanatory. The following are descriptions for those that aren’t.
Id - an Id that represents a (Store, Date) duple within the test set
Store - a unique Id for each store
Sales - the turnover for any given day (this is what you are predicting)
Customers - the number of customers on a given day
Open - an indicator for whether the store was open: 0 = closed, 1 = open
StateHoliday - indicates a state holiday. Normally all stores, with few exceptions, are closed on state holidays. Note that all schools are closed on public holidays and weekends. a = public holiday, b = Easter holiday, c = Christmas, 0 = None
SchoolHoliday - indicates if the (Store, Date) was affected by the closure of public schools
StoreType - differentiates between 4 different store models: a, b, c, d
Assortment - describes an assortment level: a = basic, b = extra, c = extended
CompetitionDistance - distance in meters to the nearest competitor store
CompetitionOpenSince[Month/Year] - gives the approximate year and month of the time the nearest competitor was opened
Promo - indicates whether a store is running a promo on that day
Promo2 - Promo2 is a continuing and consecutive promotion for some stores: 0 = store is not participating, 1 = store is participating
Promo2Since[Year/Week] - describes the year and calendar week when the store started participating in Promo2
PromoInterval - describes the consecutive intervals Promo2 is started, naming the months the promotion is started anew. E.g. “Feb,May,Aug,Nov” means each round starts in February, May, August, November of any given year for that store
简单说明:
本项目根据给定的训练数据及各商店的一些基本信息,提取相关特征,从而构建训练数据集。给定的有1115家商店的历史销售数据,来预测未来6周的销量,以给商店销售作为参考。
导入数据
#导入需要的库
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
import xgboost as xgb
from time import time

#导入数据集
store=pd.read_csv(r'E:\python\data\store.csv')
train=pd.read_csv(r'E:\python\data\train.csv',dtype={

   'StateHoliday':pd.np.string_})
test=pd.read_csv(r'E:\python\data\test.csv',dtype={

   'StateHoliday':pd.np.string_})
#可以看前几行观察下数据的基本情况
store.head()
train.head()
test.head()
查看数据缺失情况:
#train数据无缺失
train.isnull().sum()

#test数据Open列有缺失
test.isnull().sum()
'''
Id                0
Store             0
DayOfWeek         0
Date              0
Open             11
Promo             0
StateHoliday      0
SchoolHoliday     0
dtype: int64
'''
#查看test缺失列都来自于622号店
test[test['Open'].isnull()]
#通过查看train里622号店的营业情况发现,622号店周一到周六都是营业的
train[train['Store']==622]
#所以我们认为缺失的部分是应该正常营业的,用1填充
test.fillna(1,inplace=True)

#store列缺失值较多,但数量看来比较一致,看一下是否同步缺失
store.isnull().sum()
'''
Store                          0
StoreType                      0
Assortment                     0
CompetitionDistance            3
CompetitionOpenSinceMonth    354
CompetitionOpenSinceYear     354
Promo2                         0
Promo2SinceWeek              544
Promo2SinceYear              544
PromoInterval                544
dtype: int64
'''
#下面是观察store缺失的情况
a1='CompetitionDistance'
a2='CompetitionOpenSinceMonth'
a3='CompetitionOpenSinceYear'
a4='Promo2SinceWeek'
a5='Promo2SinceYear'
a6='PromoInterval'
#a2和a3是同时缺失
store[(store[a2].isnull())&(store[a3].isnull())].shape
'''
(354, 10)
'''
#a4,a5,a6也是同时缺失
store[(store[a4].isnull())&(store[a5].isnull())&(store[a6].isnull())].shape
'''
(544, 10)
'''
#a4,a5,a6列缺失是因为没有活动
set(store[(store[a4].isnull())&(store[a5].isnull())&(store[a6].isnull())]['Promo2'])
'''
{0}
'''
#下面对缺失数据进行填充
#店铺竞争数据缺失,而且缺失的都是对应的。原因不明,而且数量也比较多,如果用中值或均值来填充,有失偏颇。暂且填0,解释意义就是刚开业
#店铺促销信息的缺失是因为没有参加促销活动,所以我们以0填充
store.fillna(0,inplace=True)
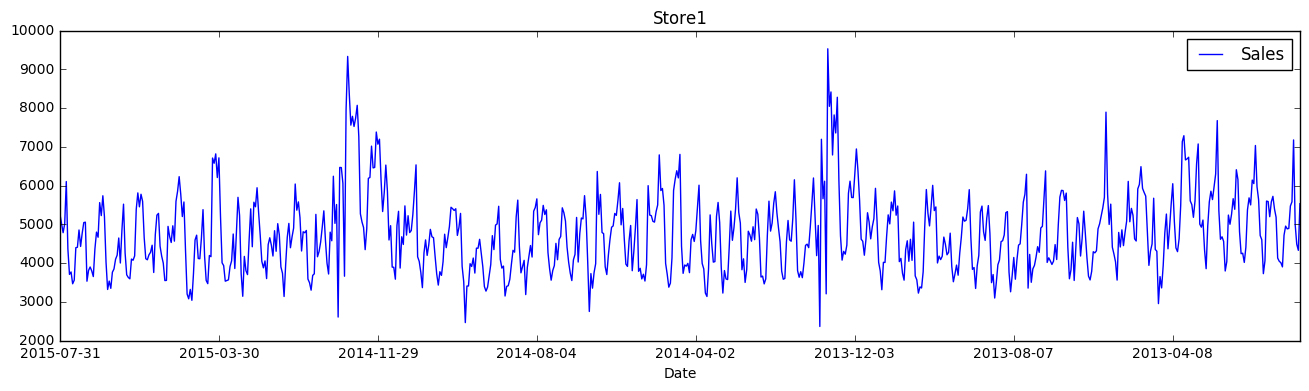
下面了解下销量随时间变化的情况:
#分析店铺销量随时间的变化
strain=train[train['Sales']>0]
strain.loc[strain['Store']==1,['Date','Sales']].plot(x='Date',y='Sales',title='Store1',figsize=(16,4))
#从图中可以看出店铺的销售额是有周期性变化的,一年中11,12月份销量相对较高,可能是季节因素或者促销等原因
#此外从2014年6-9月份的销量来看,6,7月份的销售趋势与8,9月份类似,而我们需要预测的6周在2015年8,9月份,因此我们可以把2015年6,7月份最近6周的1115家店的数据留出作为测试数据,用于模型的优化和验证
合并数据集:
上面需要的三个数据集缺失值也都处理完了,下面进行合并
#我们只需要销售额大于0的数据
train=train[train['Sales']>0]
#把store基本信息合并到训练和测试数据集上
train=pd.merge(train,store,on='Store',how='left')
test=pd.merge(test,store,on='Store',how='left')

train.info()
'''
<class 'pandas.core.frame.DataFrame'>
Int64Index: 844338 entries, 0 to 844337
Data columns (total 18 columns):
Store                        844338 non-null int64
DayOfWeek                    844338 non-null int64
Date                         844338 non-null object
Sales                        844338 non-null int64
Customers                    844338 non-null int64
Open                         844338 non-null int64
Promo                        844338 non-null int64
StateHoliday                 844338 non-null object
SchoolHoliday                844338 non-null int64
StoreType                    844338 non-null object
Assortment                   844338 non-null object
CompetitionDistance          844338 non-null float64
CompetitionOpenSinceMonth    844338 non-null float64
CompetitionOpenSinceYear     844338 non-null float64
Promo2                       844338 non-null int64
Promo2SinceWeek              844338 non-null float64
Promo2SinceYear              844338 non-null float64
PromoInterval                844338 non-null object
dtypes: float64(5), int64(8), object(5)
memory usage: 122.4+ MB
'''
特征工程
for data in [train,test]:
	#将时间特征进行拆分和转化
    data['year']=data['Date'].apply(lambda x:x.split

 2901


 扫一扫


&spm=1001.2101.3001.11974&articleId=102809572&d=1&t=3&u=de859abc055a42f8afc1b44346616e18)


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


