


“深度人工智能”是成都深度智谷科技旗下的人工智能教育机构订阅号,主要分享人工智能的基础知识、技术发展、学习经验等。此外,订阅号还为大家提供了人工智能的培训学习服务和人工智能证书的报考服务,欢迎大家前来咨询,实现自己的AI梦!
目标检测技术在过去十年间经历了显著的发展,从基于传统机器学习的方法逐步过渡到深度学习驱动的解决方案。在深度学习兴起之前,目标检测主要依靠人工设计的特征和机器学习算法。典型的方法包括:使用滑动窗口配合特征提取(如HOG特征)、SVM(支持向量机)AdaBoost等分类器、特征选择和组合(如Haar特征、LBP特征)等。
2012年,AlexNet在ImageNet竞赛中的胜利标志着深度学习在图像分类任务上的突破,这也促进了后续目标检测技术的发展。随后,深度学习开始在目标检测领域崭露头角,目标检测领域的技术发展经历了从基于卷积神经网络(CNN)的架构到基于Transformer架构的重要转变。最初的突破来自于基于CNN的模型,如R-CNN系列(包括R-CNN、Fast R-CNN和Faster R-CNN),这些模型通过引入区域提议网络(RPNs)和端到端的训练方式,大幅提升了目标检测的准确性。
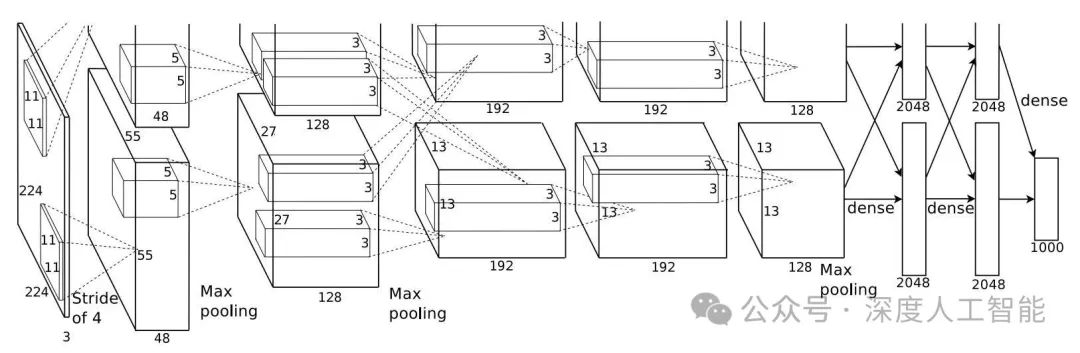
然而,这些模型在计算效率方面存在局限,特别是在实时应用中。随后,YOLO(You Only Look Once)系列模型的出现,以其一次性的检测方式和高效的性能,迅速成为实时目标检测的标准之一。YOLO模型通过直接从图像中预测边界框和类别概率,大大简化了检测流程,提高了速度,但早期版本在小目标检测和边界框精度上仍有不足。
随着深度学习技术的进步,基于Transformer架构的DETR(DEtection TRansformer)模型系列开始崭露头角。DETR利用了Transformer的强大序列建模能力,通过自注意力机制处理图像特征,理论上能够更好地捕捉全局上下文信息。
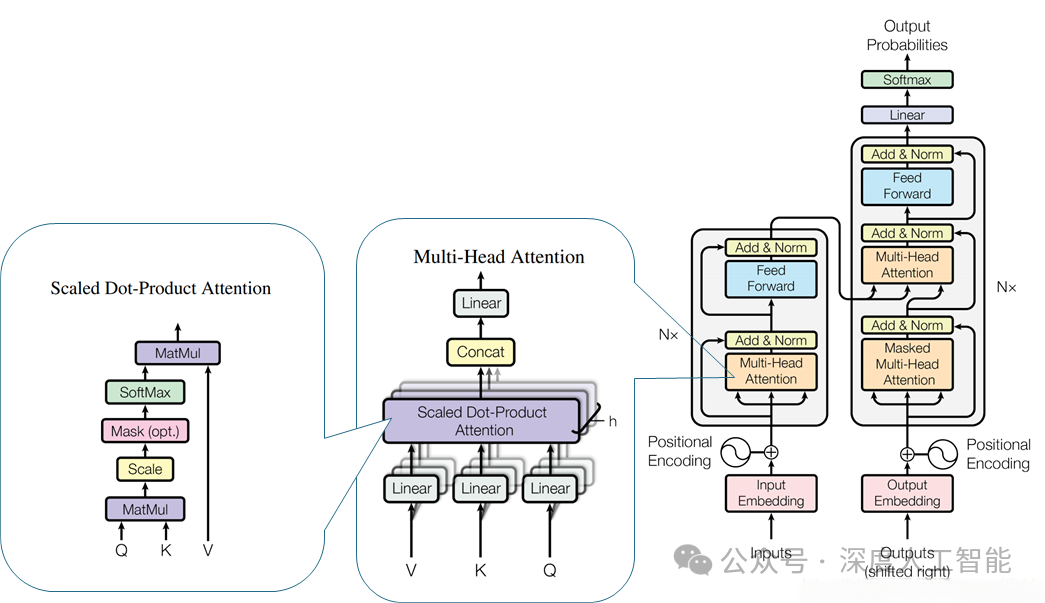
尽管DETR在初始版本中表现出色,但由于其较长的训练时间和对小目标检测能力的限制,后续的研究者对其进行了多种改进。DINO(DETR with Improved deNoising AnchOr Boxes)系列模型通过改进去噪锚框机制、引入混合查询以及其他优化手段,提高了模型的收敛速度和检测性能,尤其在小目标检测方面取得了显著进步。
从CNN到Transformer的转变,不仅是网络架构的变化,更是对目标检测任务本质理解的深化。Transformer架构因其在处理长距离依赖关系上的优势,成为自然语言处理领域的主流架构,并逐渐渗透到计算机视觉领域,特别是在需要理解全局上下文的任务中展现出了强大潜力。此外,随着视觉和语言模型的融合加深,如Grounding DINO等模型的出现,未来的检测模型将更加注重跨模态的信息融合,以实现更灵活、更强大的视觉理解能力。
一
R-CNN(Region-based Convolutional Neural Networks)
1、R-CNN的发展历程
R-CNN(Region-based Convolutional Neural Networks)的发展史是目标检测领域的一个重要组成部分。R-CNN的演变体现了从传统的基于手工特征的目标检测方法向基于深度学习的方法转变的过程。下面是R-CNN及其衍生模型的发展历程概述:
(1). R-CNN (2014)
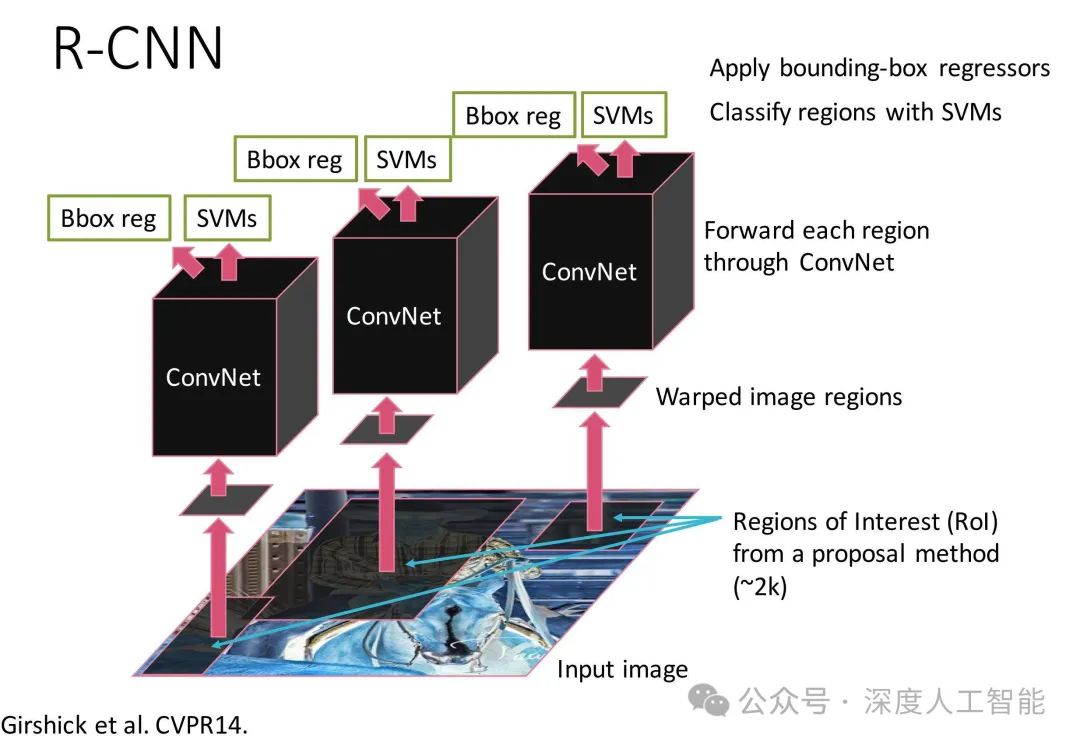
R-CNN是由Ross Girshick等人提出的,它是首个将深度学习应用于目标检测的重要模型。R-CNN的主要特点包括:
-
使用选择性搜索(Selective Search)来生成候选区域(Region Proposals)。
-
对每个候选区域单独裁剪,并通过预先训练好的CNN提取固定大小的特征图。
-
利用SVM进行分类,并通过线性回归修正边界框的位置。
R-CNN在当时达到了非常高的检测精度,但它也有明显的缺点,如训练和推断速度慢,因为每次检测都需要运行选择性搜索,并且分类和边界框回归需要额外的步骤。
(2). SPP-net (Spatial Pyramid Pooling Network, 2014)
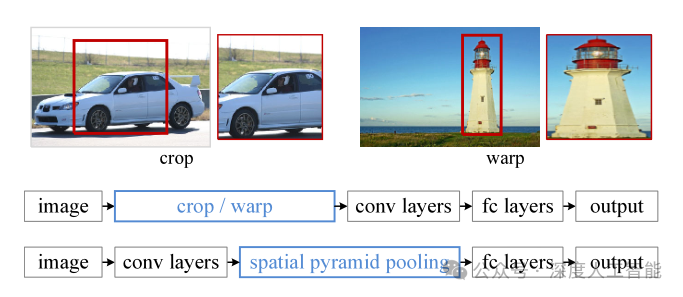
为了解决R-CNN中重复计算的问题,何凯明等人提出了SPP-net。SPP-net引入了空间金字塔池化(Spatial Pyramid Pooling, SPP)层。
-
允许输入图像的尺寸可以是任意。
-
同时只在整张图像级别上运行一次CNN,减少了计算量。
(3). Fast R-CNN (2015)
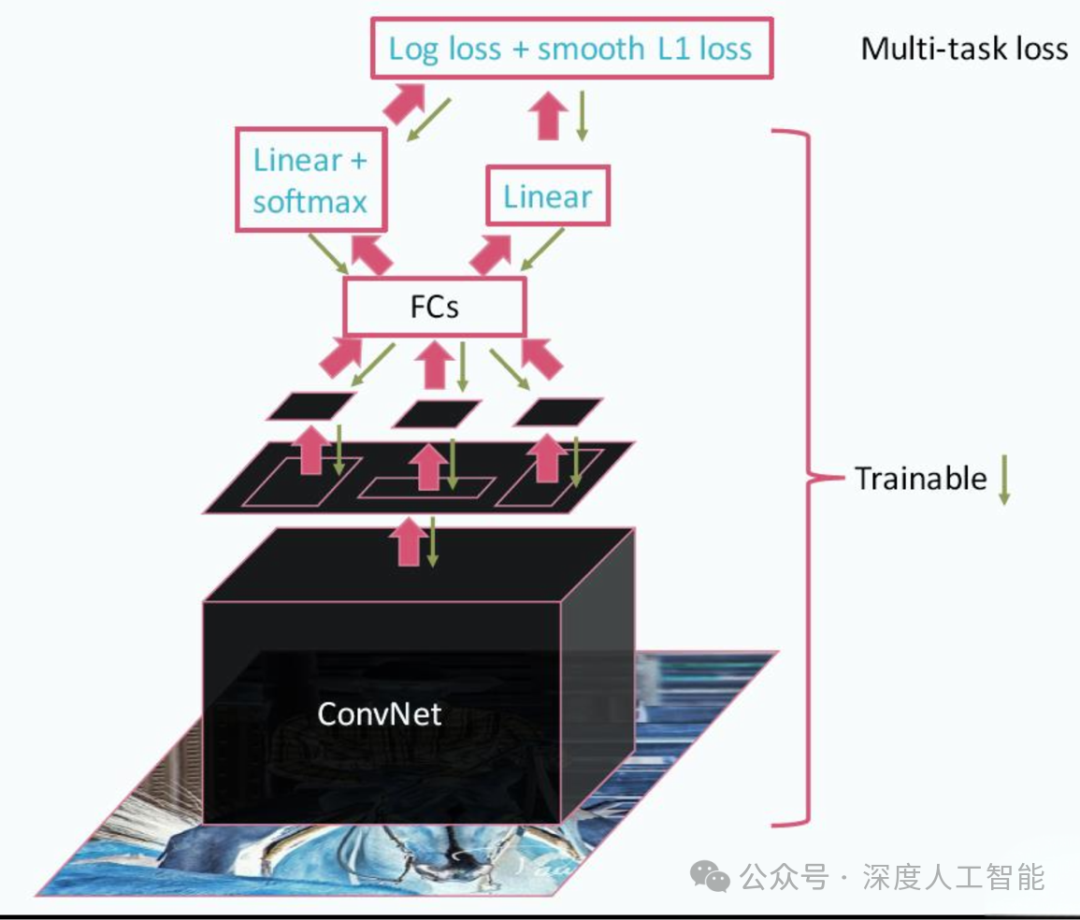
Fast R-CNN进一步简化了R-CNN的流程,它将分类和边界框回归集成到了同一个网络中,共享卷积特征,大大加速了训练和推断速度。
-
采用了RoI Pooling层,将不同大小的候选区域映射到固定大小的特征图上。
-
将分类和边界框回归任务整合到一个多任务框架中。
(4). Faster R-CNN (2015)
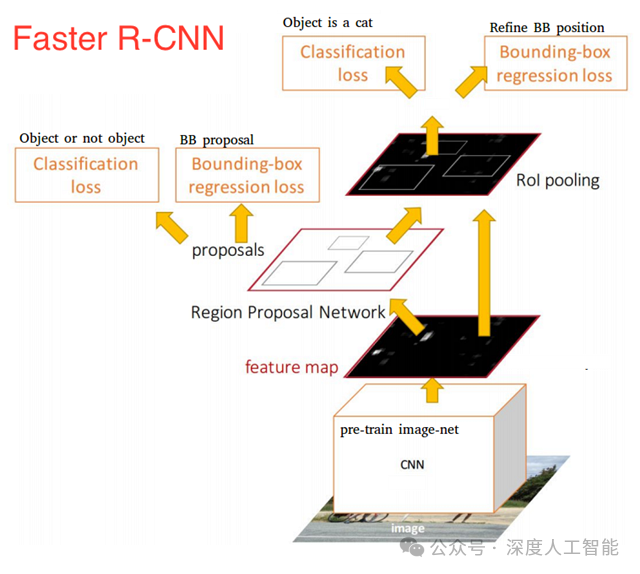
Faster R-CNN是R-CNN系列中的一个重要里程碑,它引入了区域提议网络(Region Proposal Network, RPN),代替了外部的选择性搜索工具。
-
RPN是一个完全卷积网络,可以预测出一组候选区域及其对应的前景/背景概率。
-
RPN和Fast R-CNN共享卷积特征,进一步加速了检测过程。
(5). Mask R-CNN (2017)
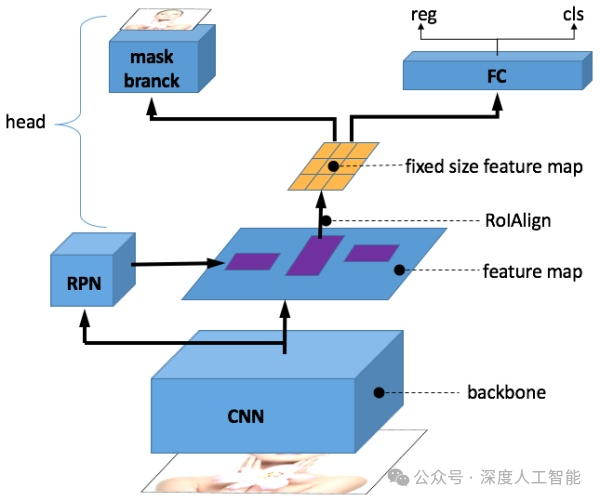
Mask R-CNN是Faster R-CNN的一个扩展,它增加了第三个分支用于像素级的实例分割。
-
在Faster R-CNN的基础上添加了一个用于生成分割掩码的分支。
-
使得模型不仅能检测目标的位置和类别,还能生成每个目标的精确轮廓。
2、R-CNN的核心技术
R-CNN系列模型(包括R-CNN、Fast R-CNN、Faster R-CNN等)在目标检测领域发挥着举足轻重的作用,它们通过一系列关键技术的革新,逐步解决了早期模型中存在的问题,推动了目标检测技术的发展。
最初的R-CNN(Region-based Convolutional Neural Networks)由Ross Girshick等人在2014年提出,它开创性地将深度学习技术应用于目标检测任务。R-CNN的核心技术之一是区域提议(Region Proposal),它使用选择性搜索(Selective Search)来生成候选区域。这些候选区域随后被裁剪并调整大小,以便输入到预先训练好的卷积神经网络(CNN)中提取特征。
提取的特征被用于训练支持向量机(SVM)分类器,以对每个候选区域进行分类。此外,R-CNN还通过线性回归模型来调整边界框的位置,以更精确地匹配实际目标的位置。然而,R-CNN的多阶段处理方式导致了训练和推断速度较慢的问题,因为每个候选区域都需要单独处理,并且分类和边界框回归需要额外的步骤。
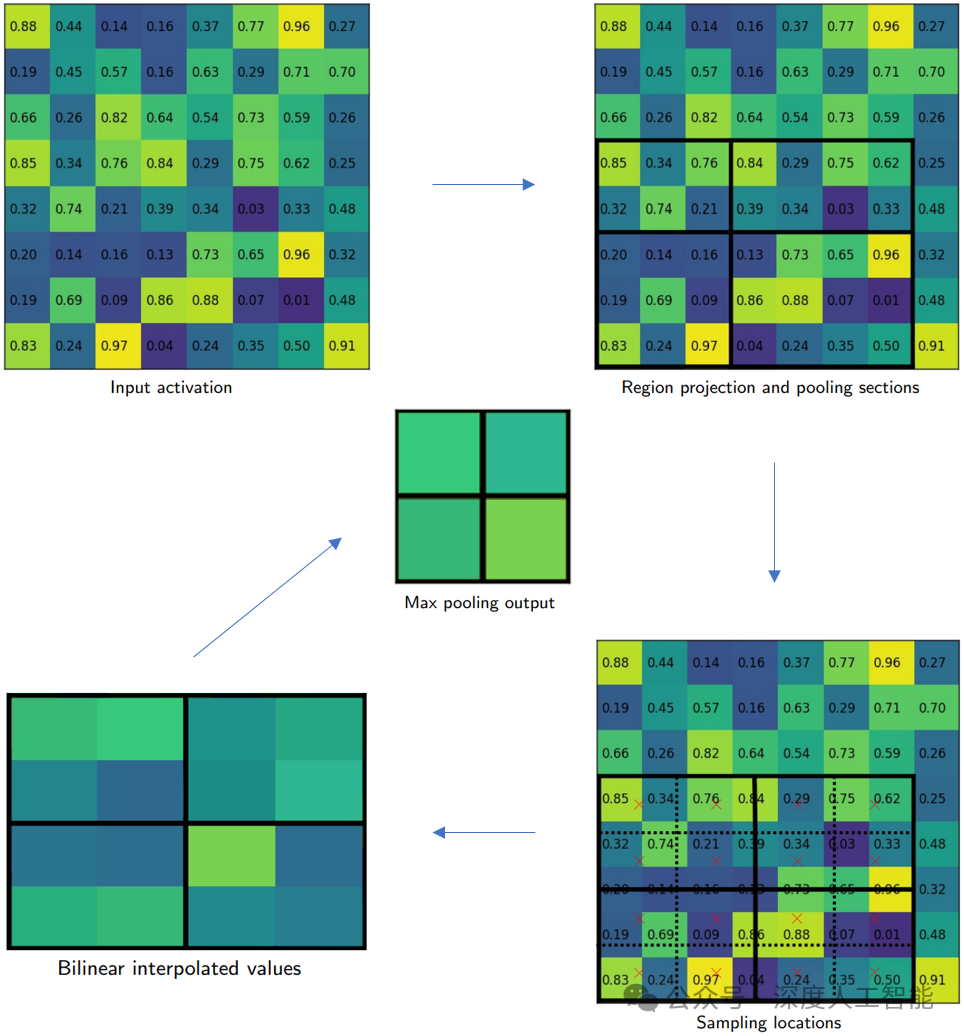
为了解决R-CNN存在的问题,Fast R-CNN在2015年应运而生。Fast R-CNN引入了RoI Pooling层(改进为RoI Align层),该层允许网络直接从候选区域提取特征,并将分类和边界框回归任务整合到一个多任务框架中。这意味着整个过程只需要一次卷积计算即可完成特征提取,从而大大提高了训练和检测的速度。Fast R-CNN不仅提高了效率,还在一定程度上改善了检测精度。
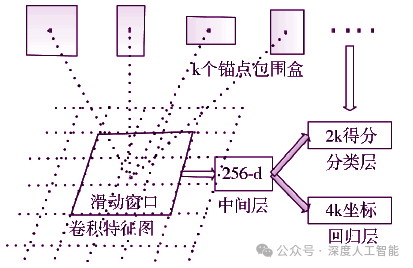
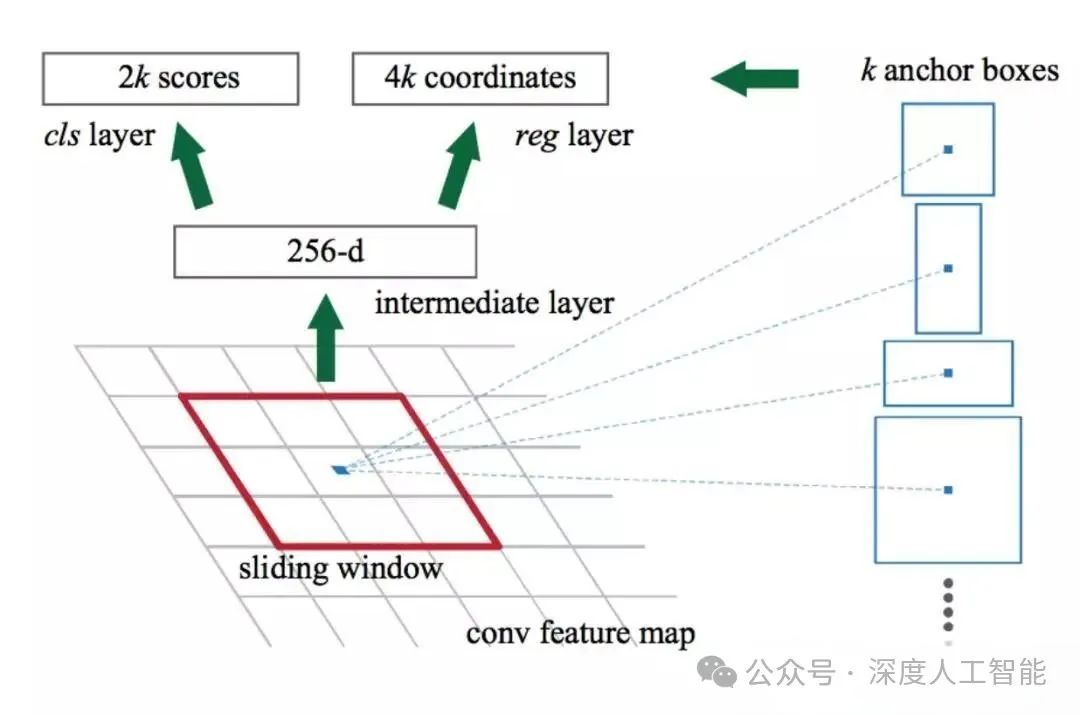
紧接着,Faster R-CNN进一步优化了候选区域的生成过程。它引入了区域提议网络(Region Proposal Network, RPN),这是一个完全卷积网络,用来替代选择性搜索工具,实现候选区域的实时生成。RPN网络使用滑动窗口在特征图上生成候选区域,并通过softmax层预测每个区域是否包含目标。RPN与检测网络共享卷积特征,进一步提高了系统的效率。Faster R-CNN不仅继承了Fast R-CNN的优点,还在速度和精度之间找到了更好的平衡。
随着R-CNN系列模型的发展,检测精度和速度得到了显著提升,同时也为后续的目标检测技术如YOLO(You Only Look Once)、SSD(Single Shot MultiBox Detector)以及基于Transformer架构的DETR(DEtection TRansformer)等提供了重要的参考和发展方向。这些模型继续推动着目标检测技术的进步,使之在自动驾驶、安防监控、医疗诊断等多个领域得到广泛应用。
3、R-CNN存在的问题
R-CNN系列网络(包括R-CNN、Fast R-CNN、Faster R-CNN等)虽然在目标检测领域取得了显著的进步,但仍然存在一些固有的问题,这些问题限制了它们在某些特定应用中的表现。下面详细探讨这些问题:
(1). 训练和推理速度慢
R-CNN:R-CNN需要为每个候选区域分别执行CNN特征提取,并且使用支持向量机(SVM)进行分类,这导致了非常高的计算成本。在实际应用中,每张图片可能产生数百个甚至上千个候选区域,这意味着每次检测都需要多次运行CNN,导致训练和推断速度极慢。
Fast R-CNN:虽然Fast R-CNN通过共享卷积特征和引入RoI Pooling层来简化流程,从而提高了处理速度,但仍然需要处理大量的候选区域。特别是当候选区域数量较多时,计算量仍然较大,这影响了实时性的应用。
(2). 复杂的训练流程


 3万+


 扫一扫















 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


