


Lvs+Keepalived高可用集群 由于lvs调度器无法做高可用 于是keepalived可以实现调度器的高可用
但是keepalived不是专门为lvs服务的 也可以做其他代理服务器的高可用
Lvs的高可用集群:主调度器和备调度器(可以有多个 一般是一主两备)
主调度器能够正常运行时 由主调度器进行后端真实服务器的分配处理 其余的备调度器都处在冗余状态 不参与集群的运转 主调度器出现故障无法运行 备调度器才会主动承担主调度器的工作 一旦主调度器恢复工作 继续由主调度器进行处理 备调度器又成了冗余
VRRP:keepalived是基于vrrp协议实现的lvs服务的高可用 解决了调度器单节点的故障问题
VRRP:提高网络路由器的可靠性开发的一种协议
选举出主和备 预先设定好了主和备的优先级 主的优先级较高 一旦服务器开启 优先级高的会自动抢占主的位置
VRRP组播通信 224.0.0.18 VRRP协议当中主备服务器通过组播地址进行通信 交换主备服务器之间的运行状态 主服务器会周期性发送VRRP报文 以告知其他服务器 主服务器现在的状态
主备切换:主服务器发送故障或不可达 VRRP协议会把请求转移到备服务器 通过组播地址 VRRP可以迅速通知其他服务器发生了主备切换 确保新的主服务器可以正常处理客户端请求
故障恢复:一旦主服务器恢复通信 由组播地址进行通信 发现恢复的主服务器优先级更高 会抢占原主服务器的位置 成为主服务器 调度和接受请求
Lvs-DR模式结合keepalived
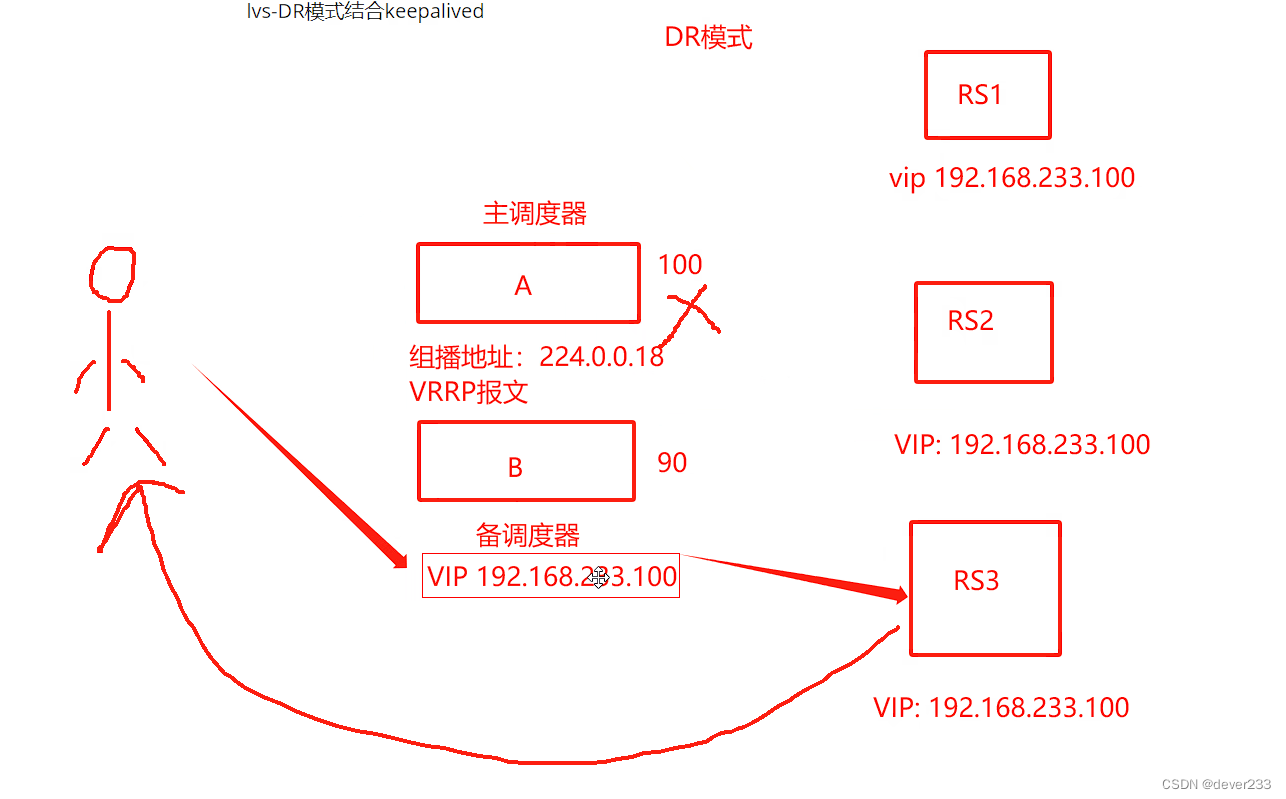
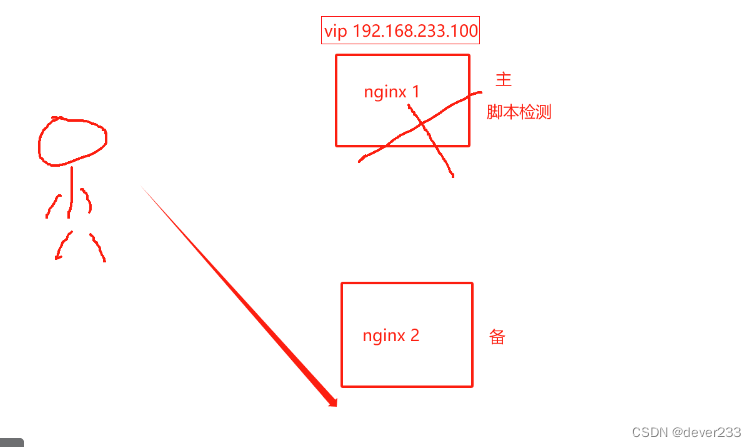
VIP地址只有一个 主挂了 VIP地址会转移到备服务器
Keepalived的体系模块:
全局模块 core模块 负责整个keepalived启动加载和维护
VRRP模块 实现VRRP协议 主备切换
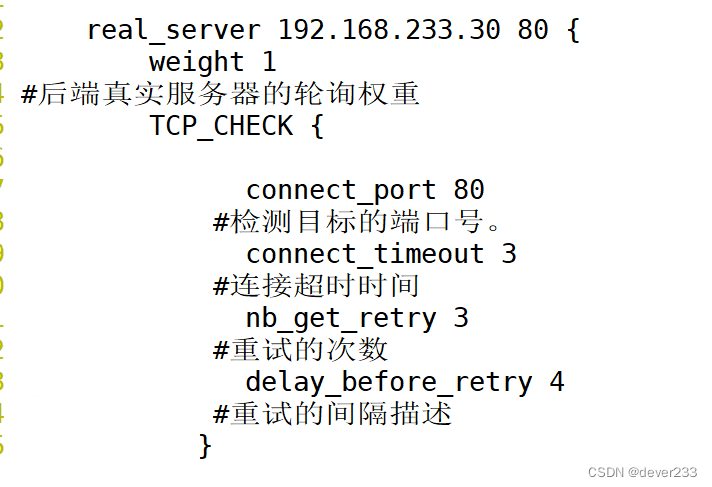
Check模块 负责健康检查 检查后端真实服务器的健康 配置在真实服务器的模块中
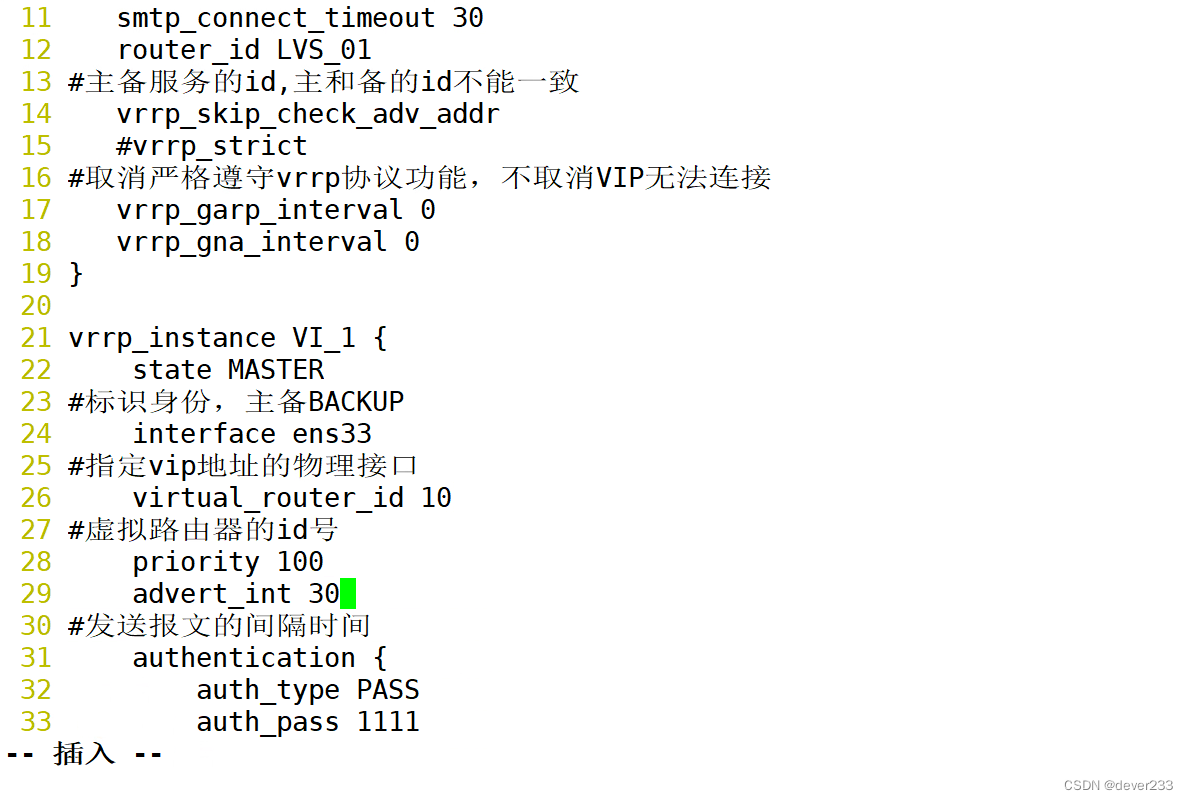
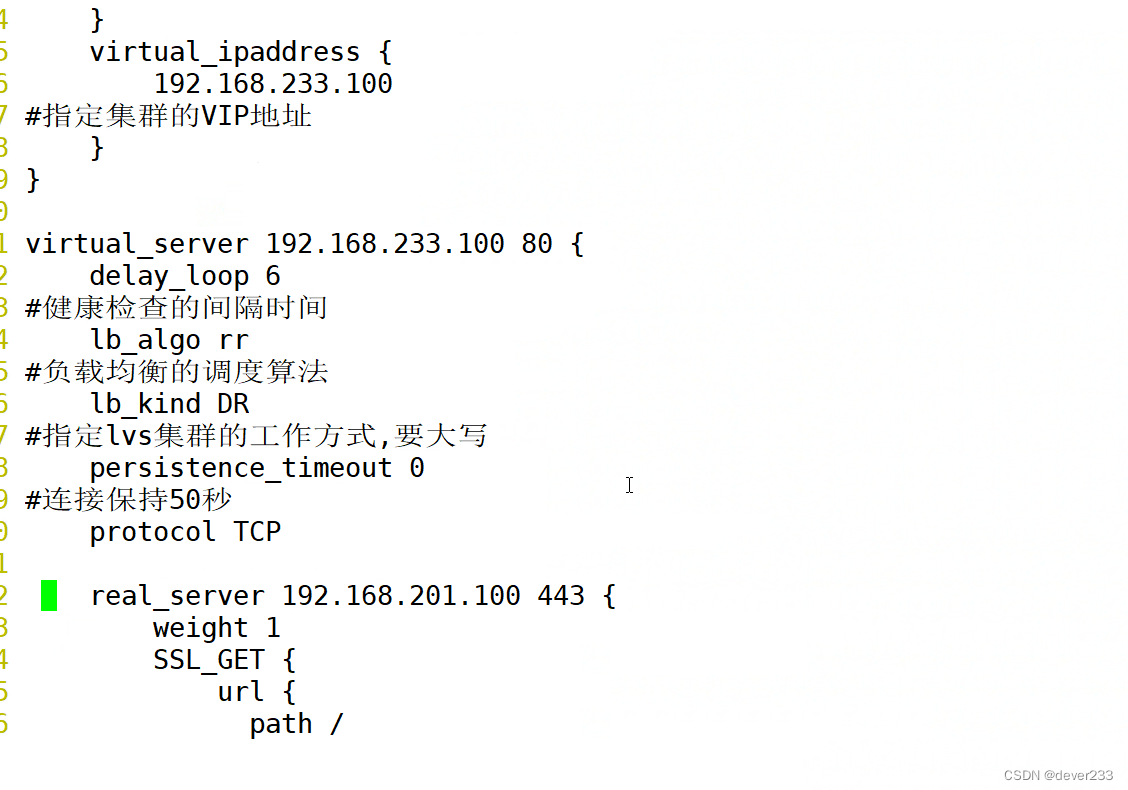
有几台真实服务器就配几个server
Keepalived脑裂:
主和备同时拥有VIP地址 在高可用系统当中 联系两个节点的心跳线 本来是一体的 动作协调的高可用系统 心跳线断开后 分裂成两个独立的个体 主备之间失去联系 都以为是对方出现了故障 两个调度器就像脑裂人一样开始抢占主的位置 抢占VIP 主也有VIP 备也有VIP 导致整个集群失败
解决办法:
软件层面:主要是优先级配置
- 配置文件 IP地址配置冲突
- Tcpdump抓包分析
- 两边服务器重启 先重启主 再重启备
网络层面:
- 高可用服务器之间心跳线检测失败 主备之间无法通信
硬件层面:
- 连接主备之间的心跳线老化
- 网卡或相关驱动失效
- 防火墙没有配置心跳线消息的传输通道 导致检测失败
- 后端服务器的配置问题 心跳方式不同 心跳广播冲突 软件bug等等
如何解决keepalived脑裂问题
- 准备两条心跳线 断了一条依然能够传送心跳消息
- 设置防火墙 一定要让心跳消息通过
- 依靠监控软件 实时检测(zabbix)
生产环境介绍::
Dev 开发环境
Sit 测试环境
Pre 预生产环境(和最终生产环境保持一致)
Prd 生产环境
总结:
工作方式基于VRRP协议
- 确定主备
- VIP地址只能有一个 出现在主服务器上
- VRRP 224.0.0.18组播地址 双方发送VRRP报文 检测主的心跳
- 主备切换 主出现故障 VIP地址会漂移到备服务器
- 主恢复 VIP地址要回到主服务器
- 脑裂 主备都有VIP 上面有详细介绍
- Keepalived不是只能和lvs搭配 也可以和其他服务配合 实现高可用
Tcpdump -i ens33 vrrp -n 动态获取vrrp所有网络数据包
 1814


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


