【Linux系统】【从菜鸟驿站到操作系统:一节课打通Linux重定向与缓冲区真相】流食般投喂

FreeRTOS 与 Linux 调度差异|顺带讲 MMU、虚拟内存、SRAM/DRAM FreeRTOS与Linux的根本差异源于内存模型:前者无MMU、平坦内存,任务共享物理地址空间,调度基于优先级抢占,上下文切换仅需保存寄存器,延迟可控,适合硬实时;后者依赖MMU实现虚拟内存与进程隔离,支持缺页和交换,但缺页中断引发磁盘IO阻塞,导致延迟不可预测,属软实时。二者调度设计的底层根基不同,决定了适用场景——嵌入式控制用FreeRTOS,通用系统用Linux。 阅读详情

从菜鸟驿站到操作系统:一节课彻底打通 Linux 重定向、VFS 与缓冲区

少年们,如果你曾疑惑过:为什么 ./a.out > log.txt 时错误信息依然赖在屏幕上?为什么 fork() 之后文件里突然冒出 7 行输出?为什么 printf 明明返回了,数据却可能没落盘?这节课的目标,就是把这些黑盒砸碎,把从 C 语言标准库到操作系统内核的数据流动路线,彻彻底底地画在你的脑子里。


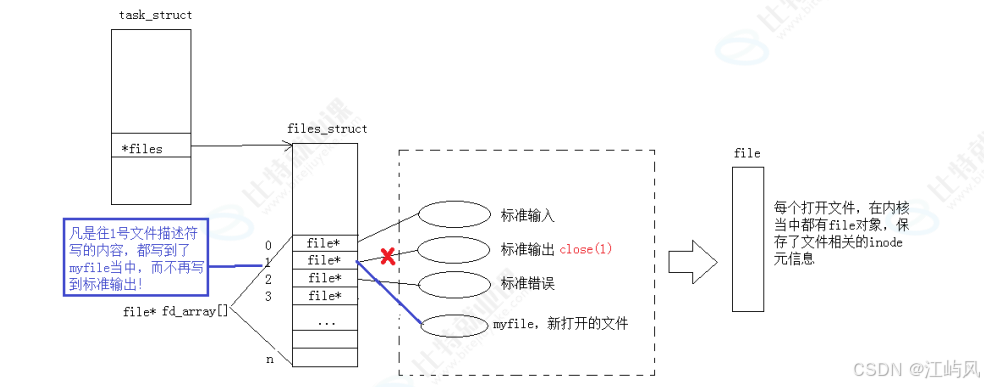
一、重定向的本质:不是“箭头”,而是文件描述符的“偷天换日”
在这里插入图片描述

1.1 “标准输出”和“标准错误”为什么分得那么清?

每个进程启动时,操作系统都会默默打开三个文件描述符(fd):

  • 标准输入(stdin):fd = 0
  • 标准输出(stdout):fd = 1
  • 标准错误(stderr):fd = 2

重点来了: stdout 和 stderr 默认都指向你的显示器,但它们是两个独立的 fd,就像两个不同的水龙头,只不过都接到了同一个水池里。

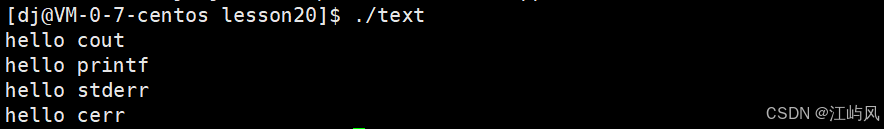
课上老师写了一段 C/C++ 混编代码来验证:

#include <iostream>
#include <cstdio>

int main() {
    std::cout << "hello cout" << std::endl; // 标准输出,fd=1
    printf("hello printf\n");               // 标准输出,fd=1
    fprintf(stderr, "hello stderr\n");      // 标准错误,fd=2
    std::cerr << "hello cerr" << std::endl; // 标准错误,fd=2
    return 0;
}

编译运行后,屏幕上理所当然地打印了 4 行内容。在这里插入图片描述
此时,如果你执行:

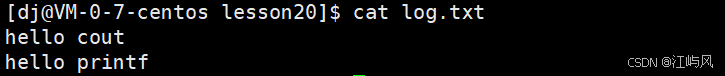
./a.out > log.txt

你会发现,只有 stdout 的内容被写进了文件,stderr 的内容依旧大摇大摆地显示在屏幕上。在这里插入图片描述

为什么? 因为 > 的本质是:打开新文件,拿到一个新的 fd(比如 3),然后把这个 fd 里的指针内容拷贝到 fd=1 中。它只动了 1,没动 2。所以 fd=2 仍然指着显示器。(前两个都是属于标准输出那的库函数,直接写向显示器的,现在1号那里被拷贝成log.txt的指针,指向log.txt,原本写向显示器的就变成写向log.txt的了)在这里插入图片描述
1.2 合并重定向的正确姿势与深坑

📌单看这个"1>log.txt":本质是把指向log.txt的指针拷贝到文件描述符表,下标为1的那个空内。

如果你想把 stdout 和 stderr 分别存到不同文件,可以:
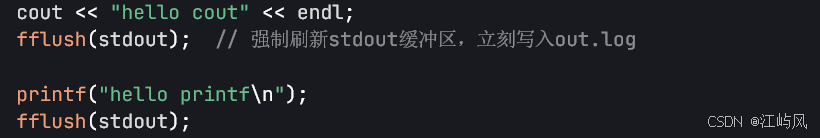
(前两个要立即刷新缓冲区)在这里插入图片描述
./a.out 1> out.log 2> err.log

如果想合并到同一个文件,很多同学会本能地写:

./a.out > log.txt 2>> log.txt

老师在这里敲了黑板:这很危险! 第一次重定向打开文件时会清空文件内容;第二次以追加方式打开,虽然内容能进来,但两次独立的 open 会导致文件偏移量和写入顺序不可控,可能出现数据覆盖或乱序。

推荐的正确写法是:
(注意不要手误打空格,把一个命令拆掉了)

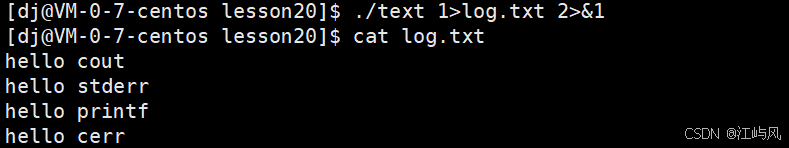
./a.out 1> log.txt 2>&1
在这里插入图片描述

它的语义是:先把 fd=1 指向 log.txt;再把 fd=2 指向 fd=1 当前指向的那个文件。这样,1 和 2 最终指向了同一个文件实体,避免了两次打开带来的竞争问题。

1.3 为什么要搞出 stderr 这个东西?

这是很多同学(包括当年听课的我)的疑问:不都是往显示器上打吗?分那么清干嘛?

答案是:为了把常规消息和错误消息做分离。

程序打日志有两种需求:一是业务必须输出的正常信息;二是为了 debug 的错误信息。如果混在一起,你找bug时得在一堆正常日志里淘金。有了 stderr,我们就可以通过重定向能力,让正确流和错误流“物理隔离”,形成独立的日志文件。这也是 perror、cerr 存在的设计根基。


二、“一切皆文件”的底气:VFS (Virtual File System”(虚拟文件系统)) 与 C 语言写出的“多态”

2.1 从 PCB 到 file(FILE* 那个返回值) 结构体

上节课我们知道了 fd 的本质是数组下标。这节课老师带我们打开了 Linux 2.6 内核源码(task_struct → files_struct → file),验证了这个数组里存的是指向 struct file 的指针。

struct file 里有什么关键信息?

  • 引用计数(f_count):记录多少个 fd 指向了这个文件对象;
  • 读写位置(f_pos):老师在这里说了一句非常醍醐灌顶的话——“无论文本文件还是二进制文件,在我看来都是 char 类型的一维数组!” f_pos 就是你当前读写到这个数组的第几个元素;
  • 内核缓冲区:通过 struct file 能找到文件对应的内核级缓冲(page cache 相关);
  • inode 指针:文件的硬属性(大小、权限、ACM 时间)并不直接放在 file 里,而是放在 inode 中,通过 file 间接找到。

2.2 不同硬件的读写方法天差地别

操作系统底层面对的是什么?磁盘、显示器、键盘、鼠标、网卡……每种硬件的 I/O 方法完全不同:

  • 读磁盘:磁头寻道、旋转、DMA……
  • 写显示器:往显存映射区写数据……
  • 读键盘:扫描码、中断……

问题来了: 如果让用户进程直接面对这些差异,那每访问一种硬件就得换一套接口,程序没法写了。

2.3 VFS(Virtual File System”(虚拟文件系统)):加一层软件层,屏蔽一切差异

这里老师引用了软件工程里的一句经典名言:

“任何计算机问题都可以通过增加一层软件层来解决。”

Linux 在内核中加了一层 VFS(Virtual File System,虚拟文件系统)。
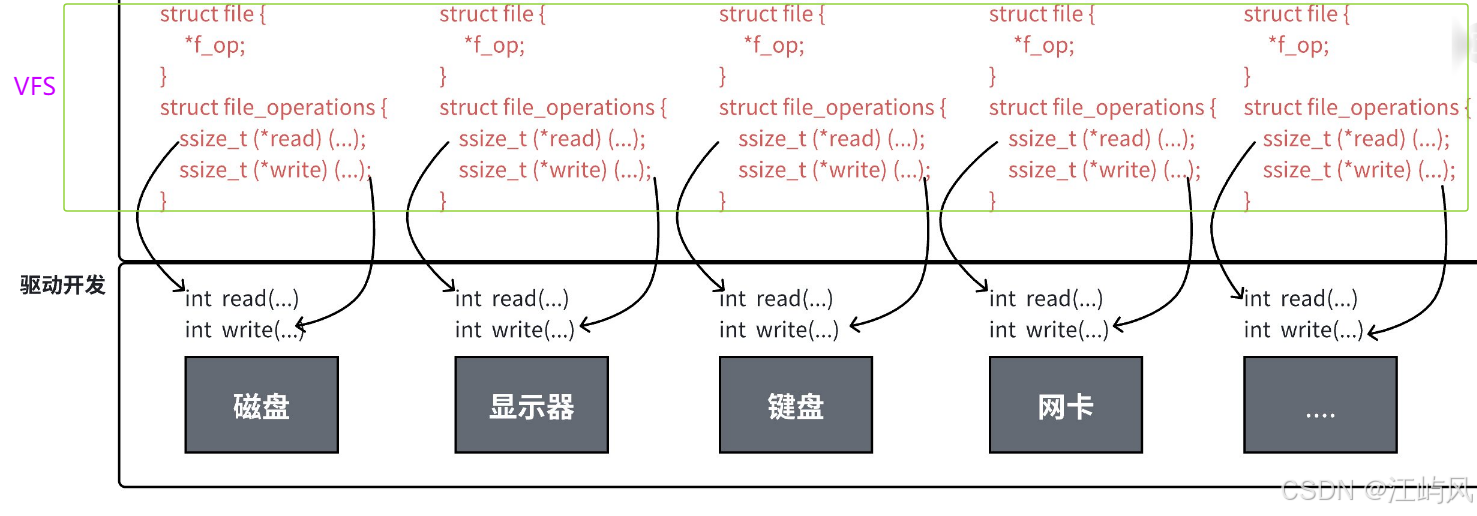
在这里插入图片描述

在 struct file 中,有一个成员叫 f_op,它是一个指针,指向 struct file_operations:

struct file {
    // ...
    const struct file_operations *f_op;
    // ...
};

struct file_operations {
    ssize_t (*read)(struct file *, char __user *, size_t, loff_t *);
    ssize_t (*write)(struct file *, const char __user *, size_t, loff_t *);
    // ...
    //存的是I/O方法的函数指针
};

当进程打开一个设备文件时,内核会根据设备类型,把 f_op 指向该设备驱动提供的具体函数:

  • 打开磁盘文件 → f_op->read 指向磁盘的读方法;
  • 打开显示器 → f_op->write 指向显存的写方法;
  • 打开键盘 → f_op->read 指向键盘驱动的读方法……

上层用户只调用统一的 read、write,底层通过函数指针动态绑定到不同的硬件实现。

2.4 C 语言实现的多态

老师在这里激动地敲了一行结论:“这就是多态!”

C 语言没有 class,没有虚函数,但它用结构体 + 函数指针完美实现了面向对象里的多态特性。C++ 的虚函数表,本质上也是一张函数指针表;操作系统内核早在 C++ 普及之前,就用这套办法把硬件差异抹平了。

所以,“一切皆文件”不是一句口号,而是说:进程被骗过去了——它以为自己在操作“文件”,其实操作的是 VFS 层统一抽象出来的 struct file;内核再通过函数指针,把请求分发到磁盘、显示器、网卡等完全不同的驱动上。


三、缓冲区机制:藏在 printf 背后的速度与陷阱

3.1 什么是缓冲区?

老师的定义极简有力:

缓冲区,就是内存中的一段空间。

但关键在于:缓冲区不止一层。从用户代码到硬件,数据要经历两个主要缓存站:

  1. 用户级缓冲区:由 C 标准库(glibc)维护,藏在 FILE 结构体里。printf、fprintf、fwrite 先把数据写到这里;
  2. 内核级缓冲区:由 OS 内核维护,与 struct file 关联。write 系统调用把数据从用户空间拷贝到这里,再由 OS 决定何时刷到硬件。

3.2 为什么需要缓冲区?菜鸟驿站模型

老师为了讲清这个问题,举了一个生活化的例子——菜鸟驿站。

假设没有菜鸟驿站(没有缓冲区):

  • 你是用户,快递员(OS)每次来一个包裹(数据),都必须在楼下打电话等你,你得立刻下楼取。如果你在做更重要的事(CPU 在执行计算),你就被频繁打断。
  • 快递员每次也要等你,一天发不了几个件。

有了菜鸟驿站(引入缓冲区)后:

  • 快递员把包裹批量丢进驿站,不用等你;
  • 你什么时候有空,下楼一次性拿一堆。

映射到计算机:

  • 用户级缓冲区:减少你的系统调用次数。printf 十次,可能只触发一次 write;
  • 内核级缓冲区:操作系统也不用每次都去骚扰硬件,攒够一波再统一写盘。

结论:缓冲区存在的根本目的,是提高使用者和系统的效率。

3.3 三种刷新策略

策略触发条件适用场景备注
无缓冲/立即刷新写立即刷stderr(默认)错误信息要尽快让人看到
行缓冲遇到 \n 或缓冲区满标准输出到显示器尊重人类“一行一行阅读”的习惯
全缓冲缓冲区写满才刷普通文件操作效率最高,系统调用次数最少

一个隐藏极深的知识点:重定向会改变缓冲策略!

当你把 stdout 重定向到文件时,它的缓冲模式会从行缓冲悄悄变成全缓冲。这个细节,是理解下面这个经典案例的钥匙。


四、经典案例:Fork 之后为什么打印了 7 条?

这是本节课最核心、最考察理解深度的例子。老师现场写了一段代码:

#include <stdio.h>
#include <unistd.h>
#include <string.h>
#include <sys/types.h>

int main() {
    printf("hello printf\n");               // 库函数(行缓冲/全缓冲取决于目标)
    fprintf(stdout, "hello fprintf\n");     // 库函数
    const char* msg1 = "hello fwrite\n";
    fwrite(msg1, 1, strlen(msg1), stdout); // 库函数

    const char* msg2 = "hello write\n";
    write(1, msg2, strlen(msg2));          // 系统调用!

    fork();  // 在程序结尾 fork
    return 0;
}

4.1 现象差异

场景 A:直接运行(向显示器打印)

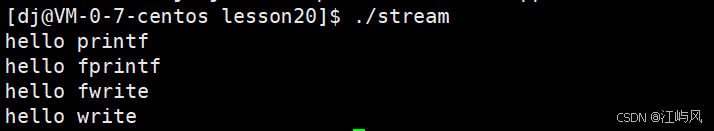
./a.out
在这里插入图片描述

输出 4 条。因为显示器是行缓冲,\n 触发了刷新,fork 之前用户缓冲区已经空了。

场景 B:重定向到文件

./a.out > log.txt
cat log.txt

输出 7 条! 而且你会发现:在这里插入图片描述
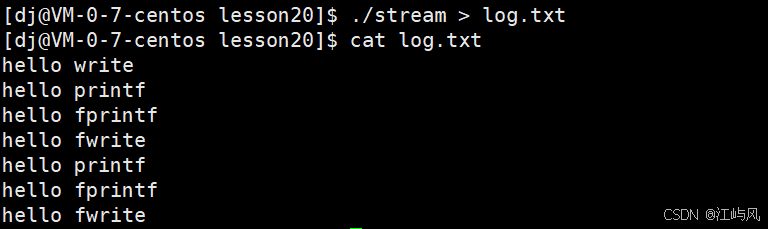
  • write 的内容只出现 1 次;
  • printf、fprintf、fwrite 的内容各出现了 2 次。

4.2 原因剖析

write 为什么只打印 1 次?
write 是纯系统调用,它直接把数据拷贝进了内核级缓冲区。fork 之前,数据已经属于操作系统了,不属于进程的用户态内存空间。所以 fork 之后,无论父子进程,这份数据都不会被复制,自然只出现一次。

printf/fprintf/fwrite 为什么打印 2 次?
这三个都是C 标准库函数,它们先把数据写进了用户级缓冲区。当执行到 fork() 时:

  • fork 会复制父进程的地址空间,其中包括用户级缓冲区的内容;
  • 父子进程各自拥有了一份相同的缓冲区副本;
  • 进程退出时,C 库会自动刷新缓冲区,父进程刷一次,子进程刷一次,于是同样的内容就被写了两次。

为什么显示器是 4 条,文件是 7 条?
因为重定向到文件时,缓冲策略由行缓冲降级(升级)为全缓冲。数据遇到 \n 不会立即刷新,而是继续留在了用户级缓冲区里,直到 fork 后才被各自刷出,于是发生了复制。

4.3 补充验证:提前关闭 fd 导致数据丢失

老师还回顾了一个上节课的例子:

close(1);                           // 关闭 stdout
int fd = open("log.txt", O_CREAT|O_WRONLY|O_APPEND, 0666);
printf("hello bit\n");
// close(fd);  // 如果在 fflush 之前关闭

如果你先 printf,再 close(fd),最后才进程退出——你会发现 log.txt 是空的!
📌这里给用户级缓冲区刷到内核级缓冲区的三个条件:

  1. 强制刷新
  2. 刷新条件满足
  3. 进程退出
  • 因为 printf 的数据还在用户级缓冲区,你提前把 fd 关了(刷新要用到fd);
  • 进程退出时想刷新,但 write(fd, ...) 发现 fd 已失效,刷新失败,数据就丢了。
  • 修复方法:在 close 前调用 fflush(stdout),强制把语言层缓冲区先刷进内核。

五、手撕 C 标准库:模拟 fopen / fwrite / fflush

理解了原理后,老师带领我们自己封装了一个 my_stdio 库。目的不是替代 glibc,而是让你亲眼看到:库函数的底层逻辑,不过如此。

5.1 数据结构:MyFILE

#define MAX_BUFFER_SIZE 1024

// 刷新策略标志位
#define FLUSH_NONE   0        // 无缓冲(立即刷新)
#define FLUSH_LINE   (1<<0)   // 行缓冲
#define FLUSH_ALL    (1<<1)   // 全缓冲

typedef struct {
    int fd;                   // 封装的文件描述符
    int flag;                 // 打开方式(r/w/a)
    int flush_method;         // 刷新策略
    char outbuffer[MAX_BUFFER_SIZE]; // 用户级缓冲区
    int size;                 // 当前缓冲区有效长度
} MyFILE;

5.2 关键接口实现逻辑

my_fopen:

  • 底层调用系统调用 open() 获取 fd;
  • malloc 一个 MyFILE 对象;
  • 初始化 outbuffer,设置 size = 0;
  • 根据文件类型设置刷新策略:如果是显示器(isatty),默认设成行缓冲;如果是普通文件,设成全缓冲。

my_fwrite:

  • 写入的本质是什么?老师说:是拷贝(memcpy);
  • 把用户要写的字符串,按长度 memcpy 到 MyFILE->outbuffer 的尾部;
  • 更新 size;
  • 尝试判断刷新条件:
    • 如果是行缓冲,检查缓冲区最后一个字符是不是 \n,是则调用 my_fflush;
    • 如果是全缓冲,检查 size 是否达到 MAX_BUFFER_SIZE,是则调用 my_fflush。

my_fflush:

int my_fflush(MyFILE *fp) {
    if (fp->size > 0) {
        write(fp->fd, fp->outbuffer, fp->size); // 系统调用,入内核!
        fp->size = 0;                           // 清空用户缓冲区计数
        // 可选:fsync(fp->fd) 强制刷到硬件
    }
    return 0;
}

my_fclose:

  • 必须先 my_fflush,再 close(fd),最后 free(fp)。
  • 这对应了 glibc 在进程退出前自动扫描链表、释放 FILE 对象的逻辑。

5.3 金句:数据流动的本质只有“拷贝”

老师在课上反复强调,不要迷信 read、write 这种名字:

“在我看来,这个世界上只有拷贝。read 是拷贝,write 也是拷贝。数据从用户缓冲区拷贝到内核缓冲区,再从内核缓冲区拷贝到硬件,一切都是拷贝。”

计算机数据流动的本质,就是数据在各级缓冲区之间的拷贝。


六、那些不容忽视的小知识点

除了主线脉络,老师还穿插了不少容易忽略但极有价值的细节:

  1. fd 的上限:默认 fd 表大小是 32 或 64,但可以通过配置扩展到 65535,这在后面学网络时会遇到;
  2. 文件是一维数组:fseek、ftell、rewind 本质上都是在操作数组下标 f_pos;
  3. 引用计数:struct file 里的 f_count 让你可以进行“一个文件被多个 fd 指向”的操作(比如 dup2);
  4. 内存管理:操作系统的物理内存以 4KB(页) 为单位管理。文件的内核缓冲区也和页缓存(page cache)紧密关联;
  5. 算法题超时与缓冲区:如果你在做 OJ 时,同样的逻辑在 C++ 里用 std::cout << ... << std::endl 狂刷新导致超时,换成 printf 或者关闭同步/减少 endl(因为 endl 会强制刷新),效率可能大幅提升;
  6. 进度条实验:当年写进度条时,不加 \n 不显示,就是因为行缓冲在等换行符;程序退出时才一次性刷出来。

七、总结:把这节课压缩成三句话

  1. 重定向玩的不是文件名,而是文件描述符的指向关系。1> file 是拷贝指针;2>&1 是让错误流追随输出流。
  2. 一切皆文件的背后,是 VFS 层通过结构体 + 函数指针实现的多态,让进程以为全世界都是 struct file,从而屏蔽了硬件差异。
  3. 缓冲区有两级:C 库的"用户缓冲区"是为了减少你的系统调用次数;内核的"文件缓冲区"是为了减少操作系统骚扰硬件的次数。理解刷新策略和fork 复制用户空间的机制,是你未来排查诡异 I/O Bug 的终极武器。
Visionpro 使用CogPMAlignTool工具提取匹配轮廓点 【代码】Visionpro 使用CogPMAlignTool工具提取匹配轮廓点。 阅读详情

相关推荐

单总线CPU设计(变长指令周期3级时序)(HUST)(头歌实验)

利用比较器等功能模块将32位MIPS 指令字译码生成LW、SW、BEQ、SLT、ADDI、OtherInstr信号也就是利用比较器将指令字转换为译码信号,OP与不同信号对应(查询MIPS手册得知) 16 进制 :23 是 2进制: 00100011 ,把获得的OP,Func,和常数比对,相同输出1.按照题目要求填写表格,使用logisim的组合逻辑电路分析功能,当然也可以直接再logisim中写真值表。单总线采用变长指令周期,不同指令周期数不同,节拍数可变化。写的excel表格最终生成电路(当然 需要先把

xuxuaifeifei的博客 1万+

Linux Day23——第三部分复习补充

知道 `--list-boots`、`--disk-usage` | ✅ 写出并跑通 `-u systemd-resolved`、`-b`、`-p err`、`--since "10 min ago"`,组合命令 `-u ... -p err -b --since ...` 跑通(`-- No entries --` 是空结果,不是报错);`start`/`enable`、`stop`/`disable`/`mask`、`Requires`/`After` 全部答对,明确「两个都要写」 |

2503_94114317的博客 202

深入解析report_timing:从基础参数到高级时序路径分析技巧

本文深入解析了静态时序分析(STA)中`report_timing`命令的核心用法与高级技巧。作为芯片设计的关键诊断工具,它能根据SDC约束精准定位时序路径问题。文章从基础参数过滤讲起,详细介绍了如何通过`-from`、`-through`、`-to`等选项定位关键路径,并深入讲解了`-input_pins`、`-nets`、`-transition_time`等高级选项如何揭示延迟细节,以及`-nworst`、`-slack_lesser_than`等过滤排序技巧,旨在帮助工程师高效解读时序报告,优化设计

h6i7j8的博客 1098

【Linux】线程安全进阶:单例模式、可重入函数与死锁排查

本文从线程池的单例管理出发,介绍饿汉模式与懒汉模式,并进一步分析多线程环境下单例创建的线程安全问题。随后区分线程安全与可重入函数的概念,结合多锁场景讲解死锁产生的四个必要条件及常见规避方法,最后补充 STL 容器、unique_ptr、shared_ptr、CAS、自旋锁和读写锁在线程并发中的使用边界,帮助建立更完整的 Linux/C++ 并发安全认识。

2402_87731470的博客 666

一口气看完TransformerXL详细解释带代码一:相对位置编码

相对位置编码(Relative Position Encoding)是Transformer模型中用于捕捉序列元素间相对位置关系的一种方法,与绝对位置编码(如BERT中的固定位置嵌入)不同,它直接建模元素之间的相对距离,从而更灵活地处理长序列或不同长度的序列。1. 为什么需要相对位置编码?​。

m0_73426548的博客 1421

三维重建Fusion中的TSDF算法通俗描述

看个视频 https://www.youtube.com/watch?v=8M_-lSYqACo 这是mobilefusion的视频,大家先了解一下,看到在三维重建的时候外面有个长方体包围盒了吗? 数据准备: 我们不同角度拍摄的RGB图、深度图和相应的pose.txt。 步骤: 1.建立长方体包围盒 要建立一个长方体包围盒。让所有的三维点都在这个长方体里面。 假设z方向垂直相机。 很明显,x,y方...

qq_30339595的博客 1万+

系统活动一抓留存!深入 Linux C/C++ 调试工具之 sysdig

sysdig是开源的Linux系统可见性工具,通过内核探针捕获系统调用与事件,支持实时监控、离线回放(.scap)、过滤分析及Chisel脚本聚合。相比strace仅跟踪单进程,sysdig可全机/容器级观测,适用于故障复盘、安全排查、容器诊断等场景。核心能力包括事件捕获、灵活过滤、eBPF支持与Chisel统计,与Falco协同实现“可观测+安全告警”。推荐工作流:捕获→回放→过滤→分析,结合-topprocs_cpu、netstat等Chisel快速定位问题。

coder_zjy的博客 351

[UVM]UVM TLM2.0简介及应用实例分析

本文介绍了TLM2.0在UVM中的实现与应用。TLM2.0作为SystemC模型间的核心传输机制,相比TLM1.0提供了更丰富的特性,包括双向阻塞/非阻塞接口、时间标记和统一数据包。文章详细解析了TLM2.0在UVM中的接口实现方式,包括socket类型定义、数据传输机制以及时间标记处理。通过一个具体实例,展示了如何在UVM组件中使用TLM2.0的initiator和target socket进行数据传输,并说明了标准数据包格式和精确时间标记的优势。最后指出TLM2.0在UVM中的实现主要是为了与Syste

元直的博客 5385

Linux端口与连接排查:ss、lsof、nc、telnet、curl

端口被占用了」「服务起不来报地址已被使用」「防火墙开了但连不上」——端口问题几乎每个部署日都会遇到。。这一篇用sslsofnctelnetcurl五把工具,串成一套端口排查的完整流水线,并讲清端口占用、连接拒绝、超时这几类问题的处理套路。

m0_66083353的博客 274

秃鹰搜索优化算法(BES)详解:从自然捕食到全局优化

秃鹰搜索优化算法(Bald Eagle Search Optimization Algorithm,BES)是由马来西亚学者Alsattar等人于2020年提出的一种新型元启发式优化算法。该算法灵感来源于秃鹰在自然界中高超的捕食行为,特别是其独特的狩猎策略和卓越的视觉搜索能力,模拟了秃鹰捕食鲑鱼等猎物的完整过程。

qq_42212808的博客 1335

[Dify实战] 解决 Dify 导入 DSL 文件时报 “DSL 版本差异” 的兼容性问题

摘要:本文针对Dify开发者在导入.dsl文件时遇到的版本警告提示问题,分析其根源在于DSL文件与当前系统版本不一致。解决方案是通过导出当前Dify应用的DSL文件查看版本号,手动修改待导入文件的version字段以匹配。文章详细说明了操作步骤,并给出使用专业编辑器、避免修改其他字段等实用建议,帮助开发者规避版本不兼容问题,提升多模态AI应用开发效率。

技术小甜甜:传播可落地技术,帮助个人和企业降低解决真实场景问题的成本 950

【Linux】文件系统(二)

管理员拿出。

2501_93780105的博客 217

详细解读经典跨模态对齐技术Q-Former代码

介绍BLIP2的博客层出不穷,介绍Q-Former的博客也不少,但是详细解读Q-Former代码的博客很少。这篇博客希望以代码为基础,讲明白Q-Former的原理和核心思想,并详细解读一些值得注意的细节。希望读者们能从这一经典技术中朝花夕拾,得到启发。

沉迷单车的追风少年 2444

Linux-进程池

本文实现了一个功能完整的C++进程池,通过管道通信实现父进程与子进程的协作。核心内容包括:头文件分离设计、使用std::function实现回调机制、封装Channel类管理信道、轮询调度任务并随机分配任务码,结合fork()创建子进程,利用read/write进行通信。关键优化点在于正确处理子进程退出问题——通过关闭所有写端描述符并分步等待,避免因文件描述符继承导致僵尸进程。最终实现任务均衡分配、子进程自动回收,具备可扩展性与实用性,适用于高并发场景下的任务分发。

博客是在C++/Java/Liunx/算法的学习阶段所写的博客,内容可能不是很全面 207

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Linux 进程——从 PCB 到僵尸进程

从冯诺依曼体系讲到 PCB 与 task_struct, Linux 进程是什么、fork 怎么创建进程、进程有哪几种状态,以及僵尸进程和孤儿进程的成因与区别

暖焰核心的博客 441

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Linux Gstreamer深度解析之gst_video_info_init调用流程与实战(九十三)

本篇目的:理解如何把调用者提供的结构初始化为默认状态,并通过设置视频格式观察初始化和视频布局配置的区别。处理视频帧之前,代码需要用记录格式、宽高、帧率、像素宽高比、平面偏移和行跨度等信息。只初始化这组元数据,不会选择具体像素格式,也不会分配视频帧内存。fill:#333;important;important;fill:none;color:#333;color:#333;important;fill:none;fill:#333;height:1em;调用者提供GstVideoInfo存储空间。

Android系统攻城狮 245

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

蓝队笔记整理03 Windows / Linux 入侵排查与溯源

先定性再动手:Web 入侵翻中间件日志、系统入侵做主机排查、网络攻击看流量——三篇笔记正好各管一线。排查就是翻六个藏身处:账户、进程/端口、启动项、计划任务、服务——恶意代码想活下来,逃不出这几处。黑客账户四个破绽:名字怪、权限高、登录时间/地点不对、想隐藏。隐藏账户认结尾net user看不到,要到里对。克隆账户比 F 值000001F4(RID 500 = Administrator)的 F 值是基准,相同即克隆;D 盾可自动检测。删影子账户要删注册表清不掉注册表残留;WMIC 已弃用,用。

Simple_Pure的博客 461

Linux iwd 连 WPA3-SAE 反复掉线:SA Query timed out 降级 WPA2 解决

很多家用光猫的后台并不单独暴露 PMF 开关,5G 的基本配置和高级配置里只有信道、带宽、功率、WMM 这些,找不到独立的"管理帧保护 / 802.11w"选项,所以没法单独把 PMF 关掉。WPA3 默认还强制开启 PMF(802.11w,受保护管理帧),用来防止伪造的解除关联帧把设备踢下去。它不是信号问题,也不是省电,而是无线协商阶段的一个"安全查询"在规定时间内没等到回应,iwd 判定这条连接无效,主动断开。数字如果是几百上千,且时间均匀分布,基本就是这个问题,而不是偶发掉线。

2601_96158891的博客 197

Linux远程传输命令:SCP、SFTP、Rsync增量同步实战

本文详解 scp、sftp、rsync 三款文件传输工具的适用场景与核心差异:scp 简单快速,适合小文件;sftp 支持交互与断点续传;rsync 凭借增量同步、断点续传和高效压缩,成为大目录同步、备份与部署的首选。重点解析 rsync 的 -a, -P, --exclude, --delete, --dry-run 等实战参数,强调末尾斜杠、限速、安全试运行等关键细节,揭示其基于滚动校验的增量原理,避免常见错误,提升运维效率。

m0_66083353的博客 340

流量一涨 Pod 扩不出来?K8s HPA 弹性伸缩配置避坑指南

Kubernetes HPA弹性伸缩核心在于requests配置准确、metrics链路通畅、behavior策略合理。HPA基于requests计算CPU利用率,未配requests则显示<unknown>;默认15秒同步周期与metrics-server 60秒采集延迟导致扩容慢。生产级配置应启用behavior精细控制:扩容立即响应(stabilizationWindowSeconds:0),缩容设300秒防抖动,并显式设置selectPolicy:Min避免默认Max导致缩容过快。多指标

kguogao的博客 180

RK3576+FPGA 数控机床控制器方案优势详解|CODESYS vs LinuxCNC怎么选

RK3576+FPGA方案凭借8nm算力、6TOPS NPU与DSMC高速接口,实现显控一体、视觉联动与弹性降本,适用于雕铣机、非标专机等场景。对比Zynq与RK3568,其优势在于独立架构带来的软硬解耦与高扩展性。软件选型上,CODESYS适合批量量产、标准化控制器,支持PLC+CNC一体化与稳定售后;LinuxCNC则适合自研样机、小批量项目,但存在GPL合规风险与开发门槛。选型核心应基于商业模式:卖控制器选CODESYS,自用研发选LinuxCNC。

szxinmai的博客 289

Linux 学习笔记(三十二):线程控制——创建、等待与分离

本文系统讲解线程的终止(return、pthread_exit、pthread_cancel)、等待(pthread_join)与分离(pthread_detach)机制,并通过实战代码验证线程ID本质为虚拟地址,指向TCB。强调线程使用后必须join或detach,否则导致资源泄漏。四个实验分别演示了带参返回、强制取消、分离线程及线程地址空间特性,深入理解多线程编程基础。

一名在 Linux 与 C/C++ 世界里打怪升级的开发者。持续输出系统编程、网络编程、数据结构与算法的高质量学习笔记与实战总结 256

Linux 地址空间与 mremap:从页表、VMA 到 MREMAP_DONTUNMAP

本文从页表与VMA的分工出发,构建地址空间三层模型,揭示mremap的本质:其行为取决于缺页机制、物理页来源及VMA合并规则。核心结论包括:共享映射(B/C)可多VA共用同一物理页;私有映射(A/D)仅在COW前共享;VMA合并需满足VA与文件偏移连续性;THP要求连续且属性一致的VMA。这些机制共同决定mremap是否复制数据、新旧地址是否一致、性能开销及内核拒绝场景。

图形/计算GPU的驱动与虚拟化技术分享园地 240

容器虚拟化基础--CGroups资源控制

本文通过pidstat与stress工具,介绍了cgroups的基本使用,涵盖版本查看、子系统管理及资源控制。实操中演示了对内存(20M限制)和CPU(30%限速)的cgroupv1/v2配置,揭示容器化技术依赖操作系统内核的资源管控能力,凸显cgroups在容器资源隔离中的核心作用。

2201_75600170的博客 158

Linux与Shell总结

掌握Linux基础命令是AI工程岗位必备技能。熟练使用文件操作(如ls、cd、cp)、日志查看(cat、tail -f、grep)、进程管理(ps、top、kill)及资源监控(df、free、nvidia-smi)可高效排查服务问题。通过管道与重定向实现日志筛选与输出控制,结合端口检查(ss)和环境变量配置(export),快速定位程序异常,保障模型服务稳定运行。

炘爚的博客 153

Linux --- 虚拟内存 1.fork、2.COW、3.mmap、4.page fault、5.TLB、6.页表

在Linux系统编程与内核学习中,`fork`、`mmap`、`page fault`、`TLB`、页表、Copy-on-Write(写时复制,简称COW)是**CPU硬件、内存管理单元(MMU)、Linux内核内存管理子系统、进程模型**协同工作所构成的一整套虚拟内存运行机制。真正打通这条链路后,会发现从用户态的一次内存访问,到物理页的最终落地,每一步都有清晰的硬件与软件协作逻辑。

MzKyle的博客 743
上一篇: 【Linux系统】【cd失效背后的进程真相:内建命令的正确打开方式】流食般投喂
下一篇: 【Plain Language Large Model】【理清常见国内外大模型的定位和特长】流食般投喂
江屿风
博客等级 码龄1年 1407粉丝 72原创
评论 62
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值