



嵌入式开发里最让人抓狂的崩溃,不是"崩了",而是"崩了却看不出在哪崩的"。
某 BLE SoC 项目(AnyMicro1037,RISC-V 架构)出过一个偶发崩溃:主机连接→快速断开→重连时,ez_rf_t 任务触发 double-free。日志打印了 mcause、mepc、ra、sp 一堆寄存器,唯独最关键的 Call Trace: 后面一片空白。没有调用栈,就不知道是谁调了 vPortFree、释放的是哪块内存、为什么重复释放。
这个空白让定位绕了三天弯路,先后误判成 stale work、authTimer 双路径。直到搞清楚"为什么 Call Trace 是空的",才拿到铁证,一次定位根因。
下面把这次排障从头拆开。先讲栈和返回地址这些基础——不懂它们,"空 Call Trace"就只是个玄学现象。再讲 RISC-V 无帧指针时回溯靠什么工作,然后推到病根:sp_top 算错了,扫描循环一次都不执行。最后给修复,和拿到铁证后怎么一次推翻之前那几个误判。如果你也遇到过崩溃日志里 Call Trace 一片空白,这篇应该能帮上忙。
一、函数调用在内存里留下了什么
要理解回溯,先得理解程序运行时"调用"这件事在内存里留下了什么痕迹。
栈:一摞盘子
函数调用是嵌套的:A() 调 B(),B() 调 C(),C() 返回到 B(),B() 再返回到 A()。CPU 得记住"返回到哪儿",这靠栈实现。
栈可以想象成一摞盘子。每调一个函数,往上摞一个盘子(压栈);函数返回,拿掉一个盘子(出栈)。栈顶有个指针(RISC-V 里是 sp 寄存器)始终指着最上面那个盘子。
多数架构栈是往下长的:函数进来时 sp 减小(往低地址走),返回时恢复。听起来反直觉——盘子不是往上摞吗?但内存地址"高"和"低"只是个数字方向,往下长和往上长在数学上等价,选哪个是约定。
高地址  ┌──────────────┐
        │  ...          │
        ├──────────────┤ ← 栈缓冲区顶(最高地址)
        │  A 的栈帧     │
        ├──────────────┤
        │  B 的栈帧     │
        ├──────────────┤
        │  C 的栈帧     │ ← 当前 sp(最低地址,最新)
        ├──────────────┤
        │  (未使用)     │
低地址  └──────────────┘ ← 栈缓冲区底(最低地址)
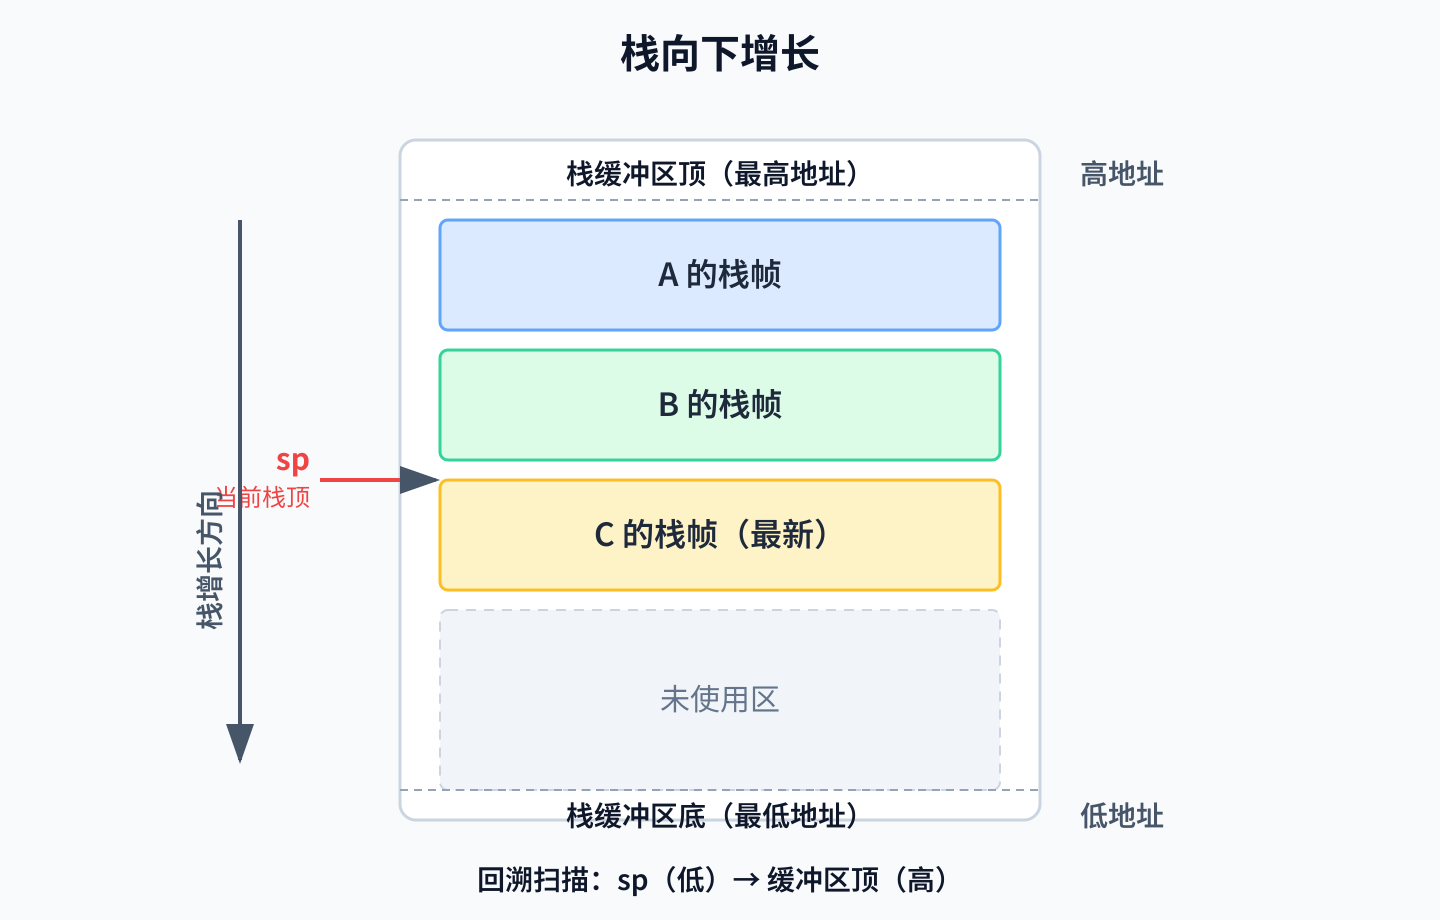
栈往哪长,不是天经地义
"往下长"看起来理所当然,但它和大端小端一样,是架构/ABI 约定,不是硬件唯一选择。
往下长(descending)是主流:x86、ARM(AAPCS 规定满递减 full-descending)、RISC-V、MIPS、PowerPC、SPARC 都是。往上长(ascending)是少数派,教科书常举的例子是 HP 的 PA-RISC,还有 Intel 8051 这类经典 8 位 MCU——PUSH/CALL 让 SP 自增。
一个容易混淆的点:ARM 硬件层面其实两种方向都支持,LDM/STM 指令有四种寻址模式(FD/FA/ED/EA)。但 AAPCS 标准化成了满递减,所以实际 ARM 程序都是往下。这说明"增长方向"是 ABI 约定,不一定是硬件唯一选择。
还有个正交概念——满栈/空栈(full/empty):sp 指向最后压入的数据(满)还是下一个空闲槽(空)。和增长方向组合出四种模式,RISC-V 和 ARM AAPCS 都是"满递减"(FD)。
为什么往下长成了主流?常被提到的实用理由是:单一地址空间里,栈放顶部往下长、堆放底部往上长,两者相向而行,共享中间的空闲区,不容易撞到一起。经典 Unix 进程内存布局就是这样。往上长就没这个便利,堆和栈得另想办法隔开。
对本文的意义:整个推导都建立在"栈往下长"上——sp_cur 是低地址(当前 sp),sp_top 是高地址(缓冲区顶),回溯扫描方向是 sp_cur → sp_top(往高地址扫)。FreeRTOS 移植里 portSTACK_GROWTH = -1 就是"往下"的显式声明。如果栈往上长,这套全得反过来。所以"增长方向"不是细节,它决定了回溯代码里所有方向判断的根基——这也是 portSTACK_GROWTH 这个宏要显式声明、移植时不能想当然的原因。
栈帧:每个函数在栈上的档案
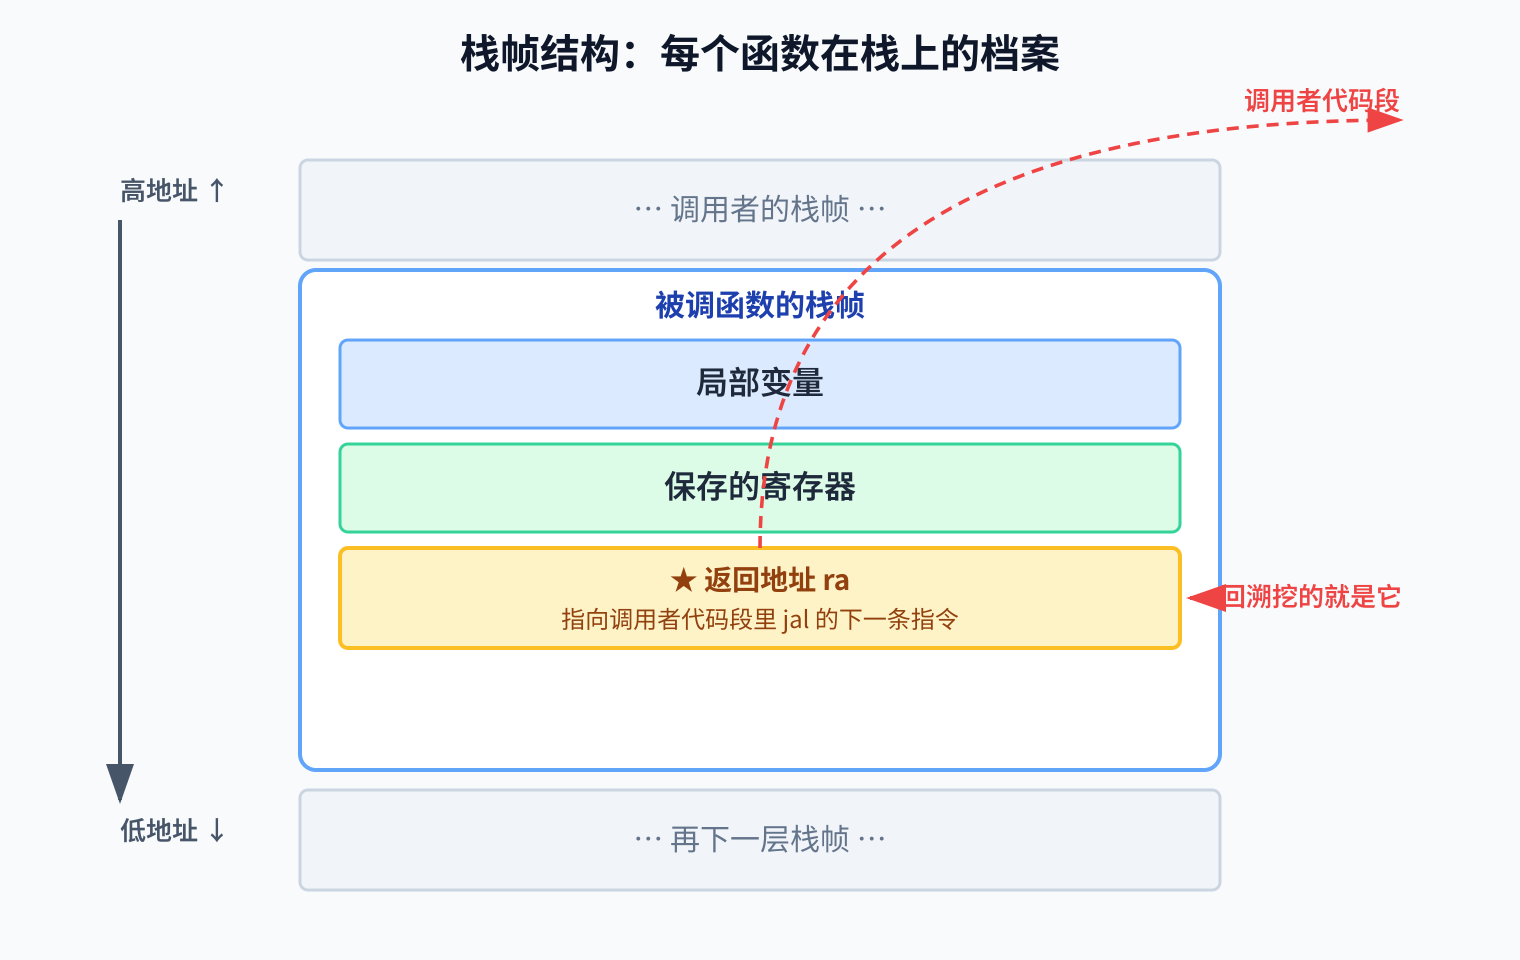
每次函数调用,会在栈上开辟一块区域叫栈帧(stack frame),存放这个函数的局部变量、保存的寄存器,以及最关键的——返回地址(return address,ra)。
ra 记录了"这个函数执行完,该回到调用者的哪一条指令继续"。RISC-V 里 jal(jump and link)指令在跳转的同时,把"下一条指令的地址"写进 ra 寄存器。被调函数入口处会把 ra 压栈保存——因为如果它再调别的函数,ra 会被覆盖。返回时用 ret(也就是 jr ra)跳回去。
所以栈上每个栈帧里都埋着一个 ra,它指向调用者代码段里的某条指令,具体是 jal 的下一条,也就是调用点之后那个地址。
回溯:顺着脚印往回走
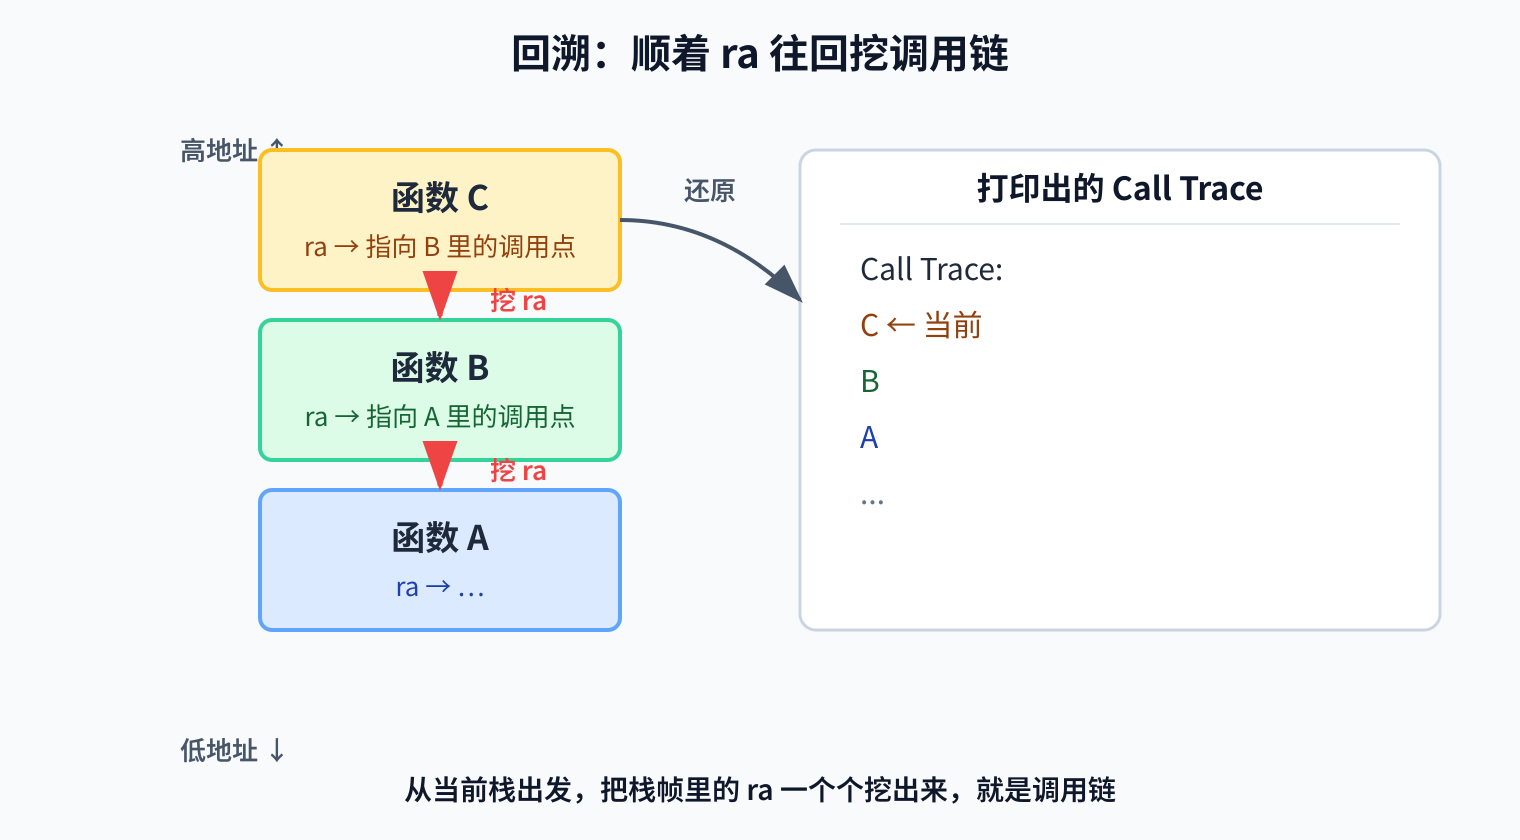
"回溯"就是从当前栈出发,把这些埋在栈帧里的 ra 一个个挖出来,还原出调用链:
当前函数 C ← 它的 ra 指向 B 里的调用点
       B ← 它的 ra 指向 A 里的调用点
       A ← ...
打印出来就是 Call Trace。GDB 里 bt 命令做的是这件事,嵌入式崩溃日志里的 Call Trace: 也是同一回事——只是没有 GDB,得靠裸栈扫描自己挖。
二、RISC-V 的特殊之处:没有帧指针怎么回溯
有帧指针 vs 无帧指针
回溯的关键是"怎么找到上一层栈帧"。有两种思路。
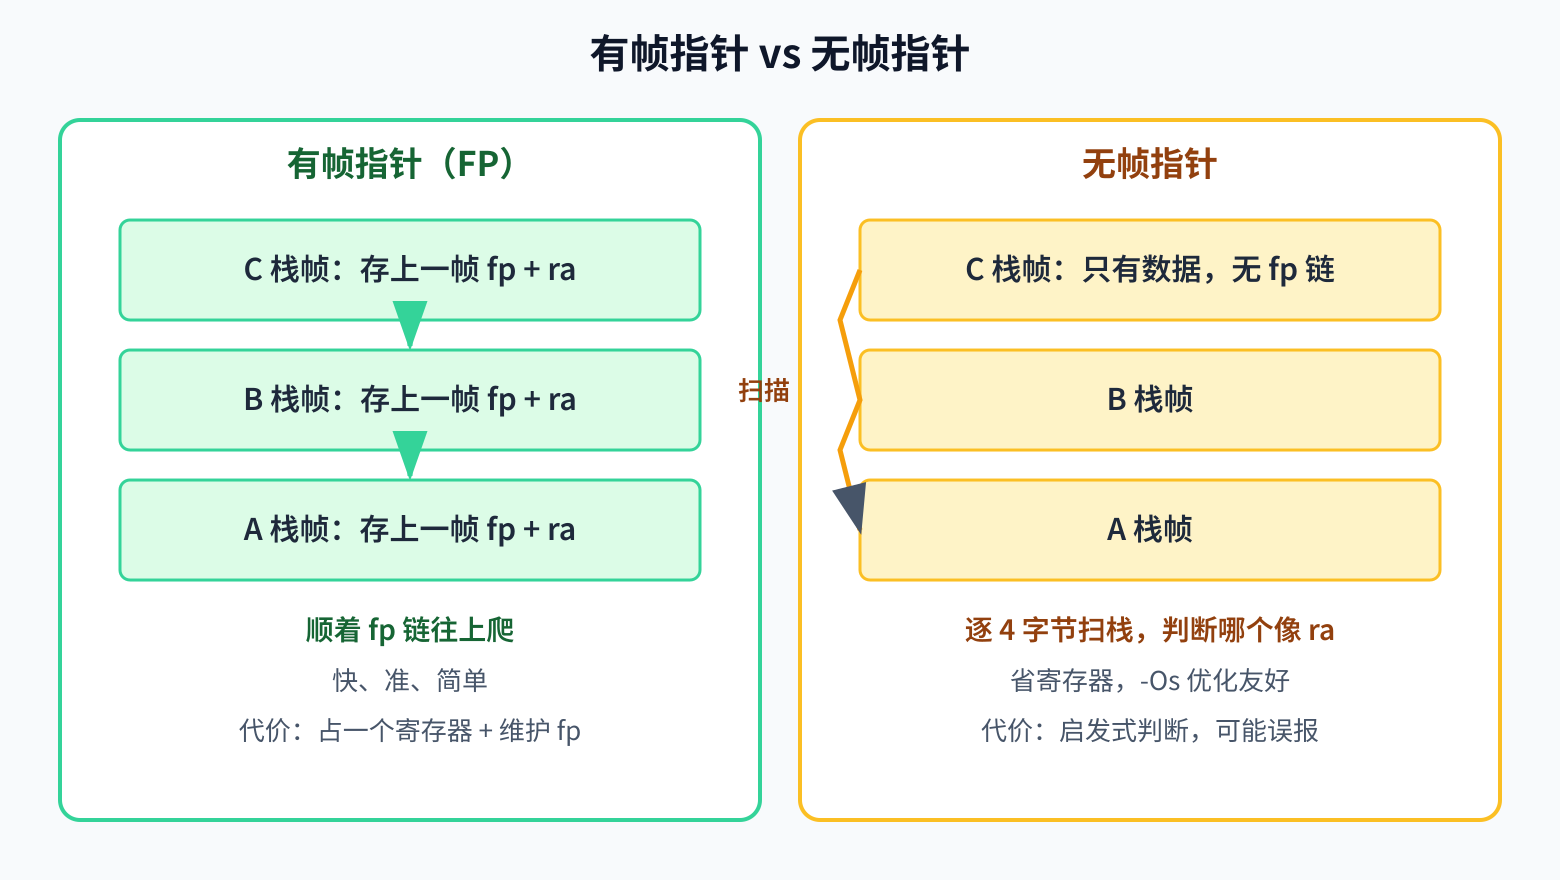
有帧指针(Frame Pointer, FP):约定用一个固定寄存器(ARM 的 r11/fp,RISC-V 的 s0/x8)始终指向当前栈帧的基址,且每个栈帧开头存了"上一帧的 fp"。回溯时顺着 fp 链一路往上爬就行——快、准、简单。代价是占用一个寄存器,每个函数进出都要维护 fp。
RISC-V 官方调用约定(psABI)里写得很清楚:帧指针是可选的,如果存在,必须放在 x8(s0)。用帧指针的代码会在栈上构造一条"帧记录"链表,每条记录两个指针——返回地址和上一帧的链接。
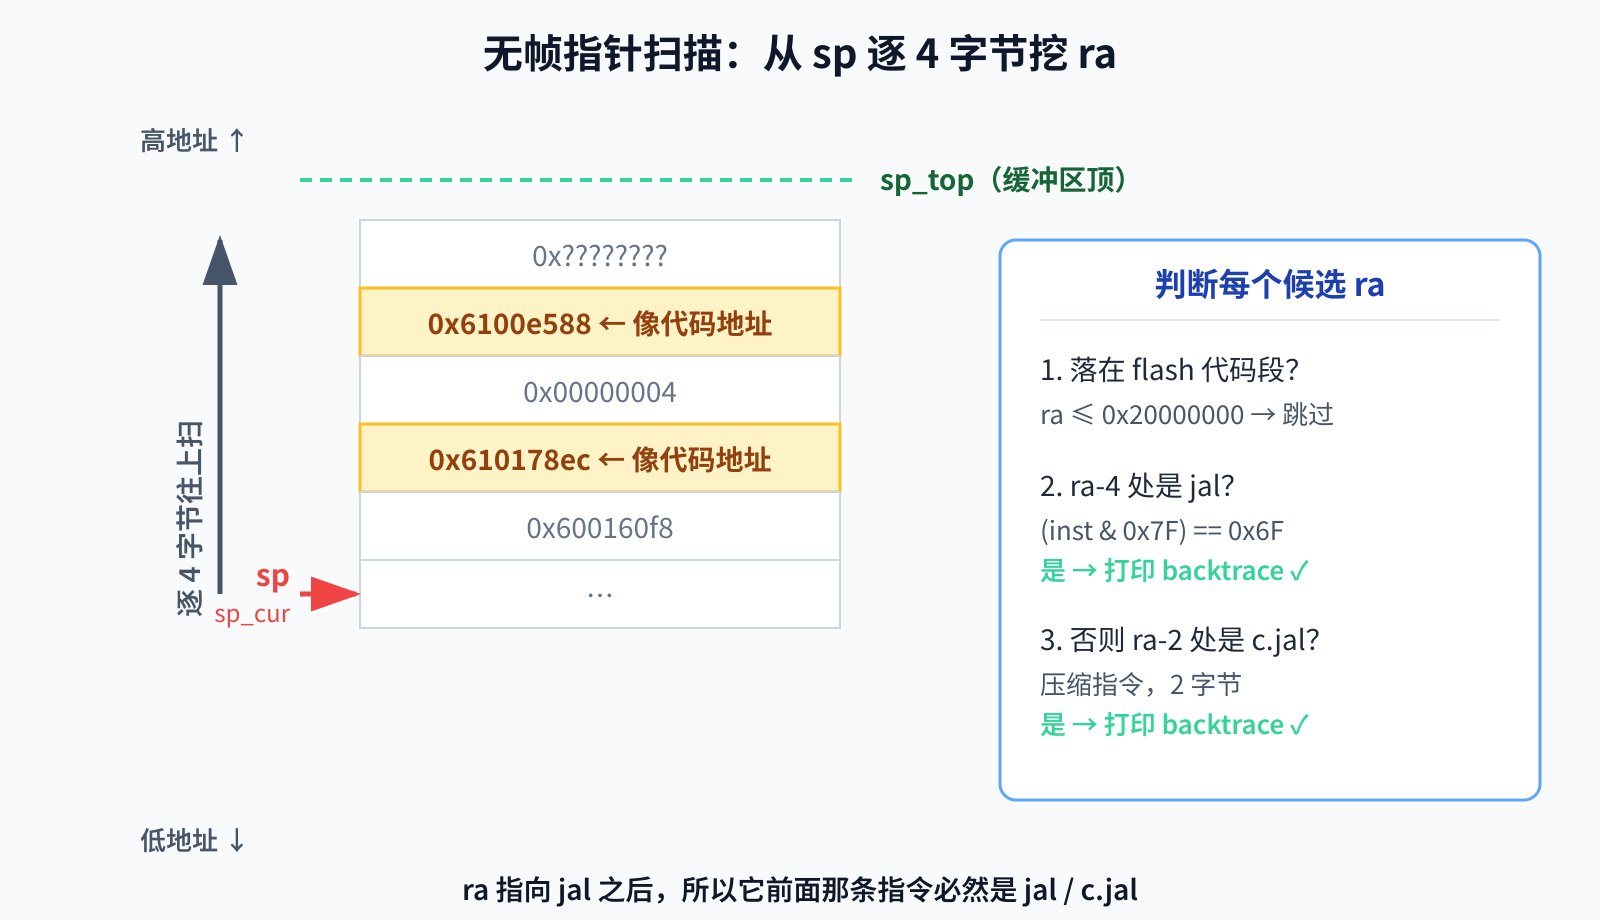
无帧指针:不维护 fp 链,所有寄存器都给优化器用。回溯时只能扫描栈内存:从当前 sp 往上(高地址)逐个 4 字节读,判断"这个值像不像一个 ra"——落在代码段、且它前一条指令是 jal/c.jal 调用指令。这种叫非帧指针扫描(non-FP stack scanning)。
psABI 同样允许"不维护帧链、把帧指针寄存器当通用寄存器用"——这正是 -fomit-frame-pointer(以及 -Os 优化)走的路径。
本项目的选择:无帧指针
本工程编译时开了 -fomit-frame-pointer(省寄存器、-Os 优化),走无帧指针路径。回溯代码在 hal_interrupt.c,编译宏 SUPP_BACKTRACE 已定义、BACKTRACE_BASE_FP 未定义,进入非 FP 扫描分支:
void hal_core_backtrace(uint32_t* sp_top, uint32_t* sp_cur)
{
    unsigned int flash_text_end = (unsigned int)(&_end);
    uint32_t *ptmp = AK_NULL;
    uint32_t ra = 0;
    uint16_t inst = 0;

    ak_print_info(MODULE_ID_DRV,"\r\nCall Trace:\r\n");

    ptmp = (uint32_t*)((uint32_t)sp_cur);     // 从当前 sp 开始
    while (ptmp < sp_top)                      // 往上扫到栈顶
    {
        ra = *ptmp++;                          // 把栈上每个 4 字节当候选 ra
        if (ra <= 0x20000000 || ra > flash_text_end)
        {
            continue;                          // ra 必须落在 flash 代码段,否则跳过
        }
        ra -= 4;                                // 往前看一条指令
        inst = *((uint16_t*)ra);
        if (0x6F == (inst & 0x7F))             // ra-4 处是 jal 指令?
        {
            ak_print_info(MODULE_ID_DRV, "backtrace:%08x\r\n", ra);
        }
        else                                   // 再试 c.jal(压缩指令)
        {
            ra += 2;
            inst = *((uint16_t*)ra);
            if ((0x1 == ((inst>>13)&0x7)) && (0x1 == (inst&0x3)))
            {
                ak_print_info(MODULE_ID_DRV, "backtrace:%08x\r\n", ra);
            }
        }
    }
}
逻辑用大白话讲:栈往下长,函数调用时 ra 会被压进栈帧。从当前 sp 往高地址扫,把每个 4 字节值当候选 ra,若它落在 flash 代码段、且它前一条指令是 jal/c.jal(调用指令),就认定它是某函数的返回地址,打印出来。
为什么判断"前一条是 jal"
这是无帧指针回溯的经典启发式判断,值得单独说清。
ra 指向的是 jal 之后的那条指令——因为 jal 在跳转的同时,把"下一条指令地址"写进 ra。所以如果某个栈上的值真的是某个函数的返回地址,那它前面那条指令必然是一个 jal(或压缩的 c.jal)。
普通 jal 是 4 字节,所以往前看 4 字节(ra-4);压缩 c.jal 是 2 字节,所以往前看 2 字节(ra-2)。代码里先试 ra-4 判 jal(opcode 0x6F),不中再试 ra-2 判 c.jal。
这个判断不是 100% 准——栈上某个局部变量恰好长得像个代码地址、且它前面恰好是 jal,就会误报。但在实际工程里误报率很低,是裸机无帧指针回溯的常用折中。
一个关键前提:sp_top 必须是栈缓冲区的顶
扫描循环是 while (ptmp < sp_top),从 sp_cur(当前 sp,低地址)往上扫到 sp_top(高地址)。sp_top 必须是栈缓冲区的最高地址——栈帧分布在"当前 sp"和"缓冲区顶"之间,扫描方向 sp_cur → sp_top 才能覆盖所有已压入的栈帧。
如果 sp_top 算错了,扫不到该扫的区间,回溯就空。这正是 ble-D51 的病根。
三、病根:sp_top 算错了
sp_top 怎么算的
trap handler(hal_core_trap_intr,hal_interrupt.c:489)在异常入口算 sp_top:
stack_addr = osThreadGetStackAddr(tid);   // 应是栈缓冲区基址
stack_size = osThreadGetStackSize(tid);   // 应是栈总大小
sp_top = (uint32_t*)(stack_addr + stack_size);  // 基址 + 大小 = 缓冲区顶
hal_core_backtrace(sp_top, (uint32_t*)param);  // param 是异常帧 = 当前 sp
它把"算 sp_top"这件事委托给了 CMSIS-RTOS2 的两个函数:osThreadGetStackAddr(应返回基址)和 osThreadGetStackSize(应返回大小)。只要这两个函数语义正确,sp_top = 基址 + 大小 就是缓冲区顶,回溯正常。
FreeRTOS 栈的三个字段
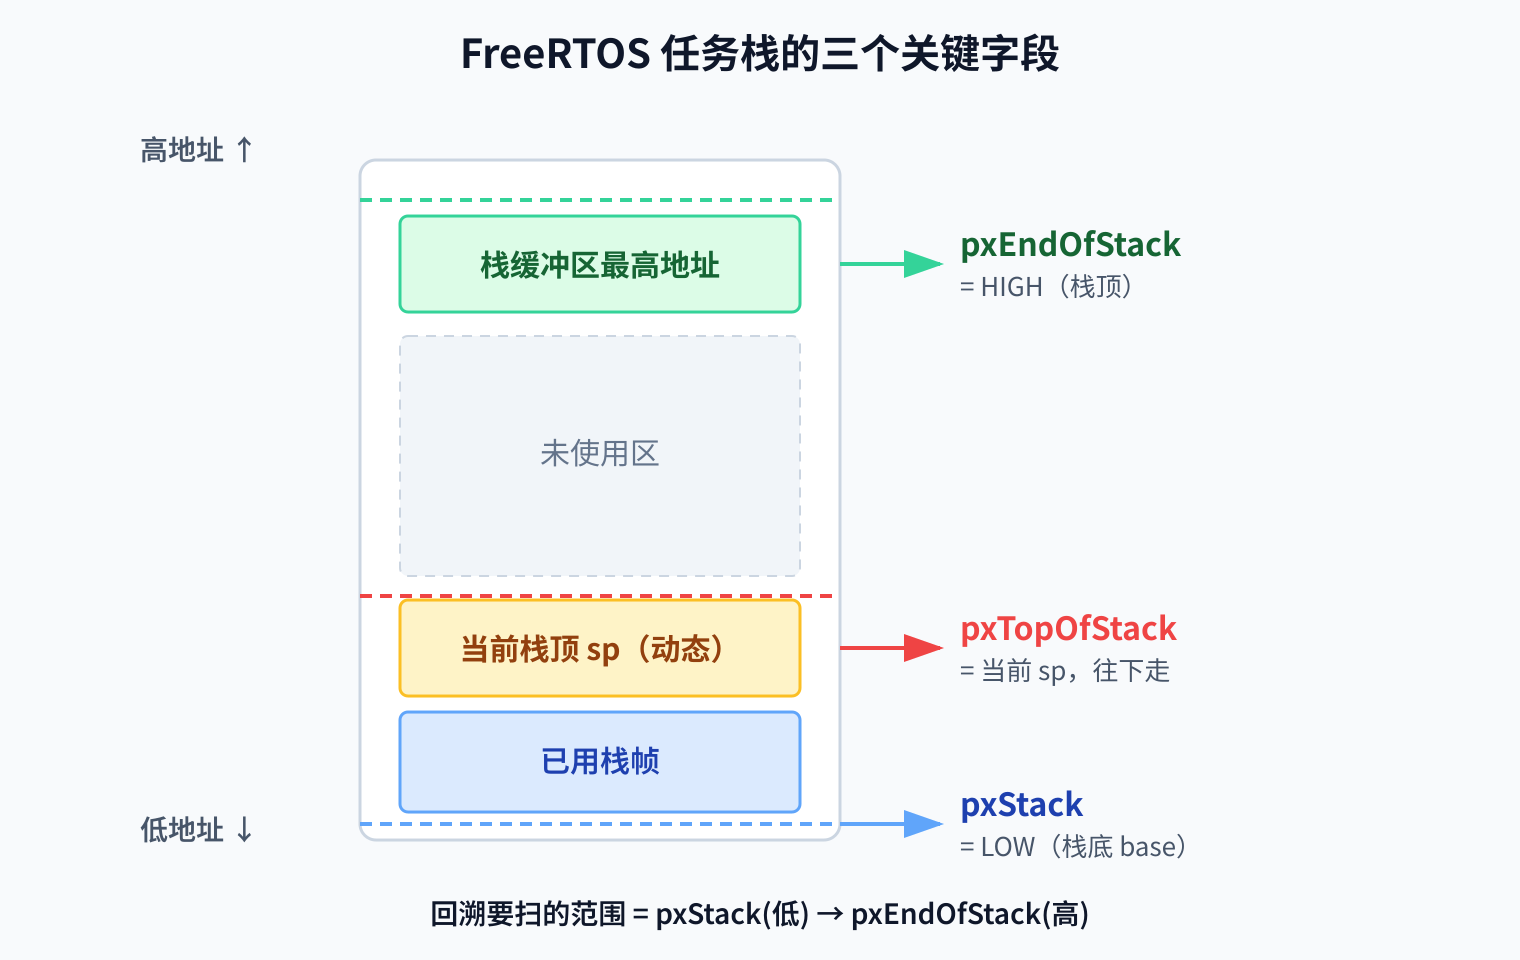
RISC-V FreeRTOS 移植里,任务创建时(tasks.c:856-870)给 TCB 填三个栈相关字段:
| TCB 字段 | 赋值 | 地址端 | 含义 |
|---|---|---|---|
pxStack | 缓冲区起始 | LOW(最低地址) | 栈缓冲区基址 |
pxEndOfStack | pxStack + (depth-1) | HIGH(最高地址) | 缓冲区顶 |
pxTopOfStack | 初始 &pxStack[depth-1],运行中随压栈下降 | LOW(动态) | 当前 sp |
关键:pxTopOfStack 是动态值——它代表"当前栈顶 sp",任务运行中每次压栈都让它下降。它不是缓冲区基址,是基址往下走了多少之后的那个"当前指针"。
栈向下增长(portSTACK_GROWTH = -1),configRECORD_STACK_HIGH_ADDRESS = 1(FreeRTOS.h 默认)。
高地址  pxEndOfStack = pxStack + depth - 1   (HIGH, 固定)
            │
            │  栈帧区(已用)
            │
        pxTopOfStack                         (动态当前 sp, LOW)
            │
            │  未用区
低地址  pxStack                              (LOW, 固定, 基址)
两个 CMSIS 函数的语义错误
platform/os/FreeRTOS/cmsis_os2.c 原实现:
// cmsis_os2.c:432  文档注释写 "stack base addr",base 应是缓冲区基址(LOW)
uint32_t osThreadGetStackAddr(osThreadId_t thread_id)
{
    return (uint32_t)uxTaskGet_pxTopOfStack((TaskHandle_t)thread_id);
    //      ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ 错:返回当前 sp(LOW),不是基址
}

// cmsis_os2.c:445  应返回栈总大小(正数)
uint32_t osThreadGetStackSize(osThreadId_t thread_id)
{
    return uxTaskGet_pxTopOfStack(...) - uxTaskGet_pxEndOfStack(...);
    //     LOW(动态)         -        HIGH(固定)
    //     = 负值,uint32 下回绕成接近 0xFFFFFFFF 的巨大数 错
}
两个函数都错。
osThreadGetStackAddr 返回 pxTopOfStack(当前 sp,LOW),但文档写 "stack base addr",base 应是 pxStack(缓冲区最低地址)。
osThreadGetStackSize 返回 pxTopOfStack - pxEndOfStack = LOW - HIGH,uint32 下回绕成巨大值。本该返回一个正数(栈大小),结果返回了一个接近 40 亿的数。
sp_top 落到了 sp 以下,循环一次都不执行
trap handler 里:
sp_top = stack_addr + stack_size; // = LOW(pxTopOfStack) + (LOW - HIGH)
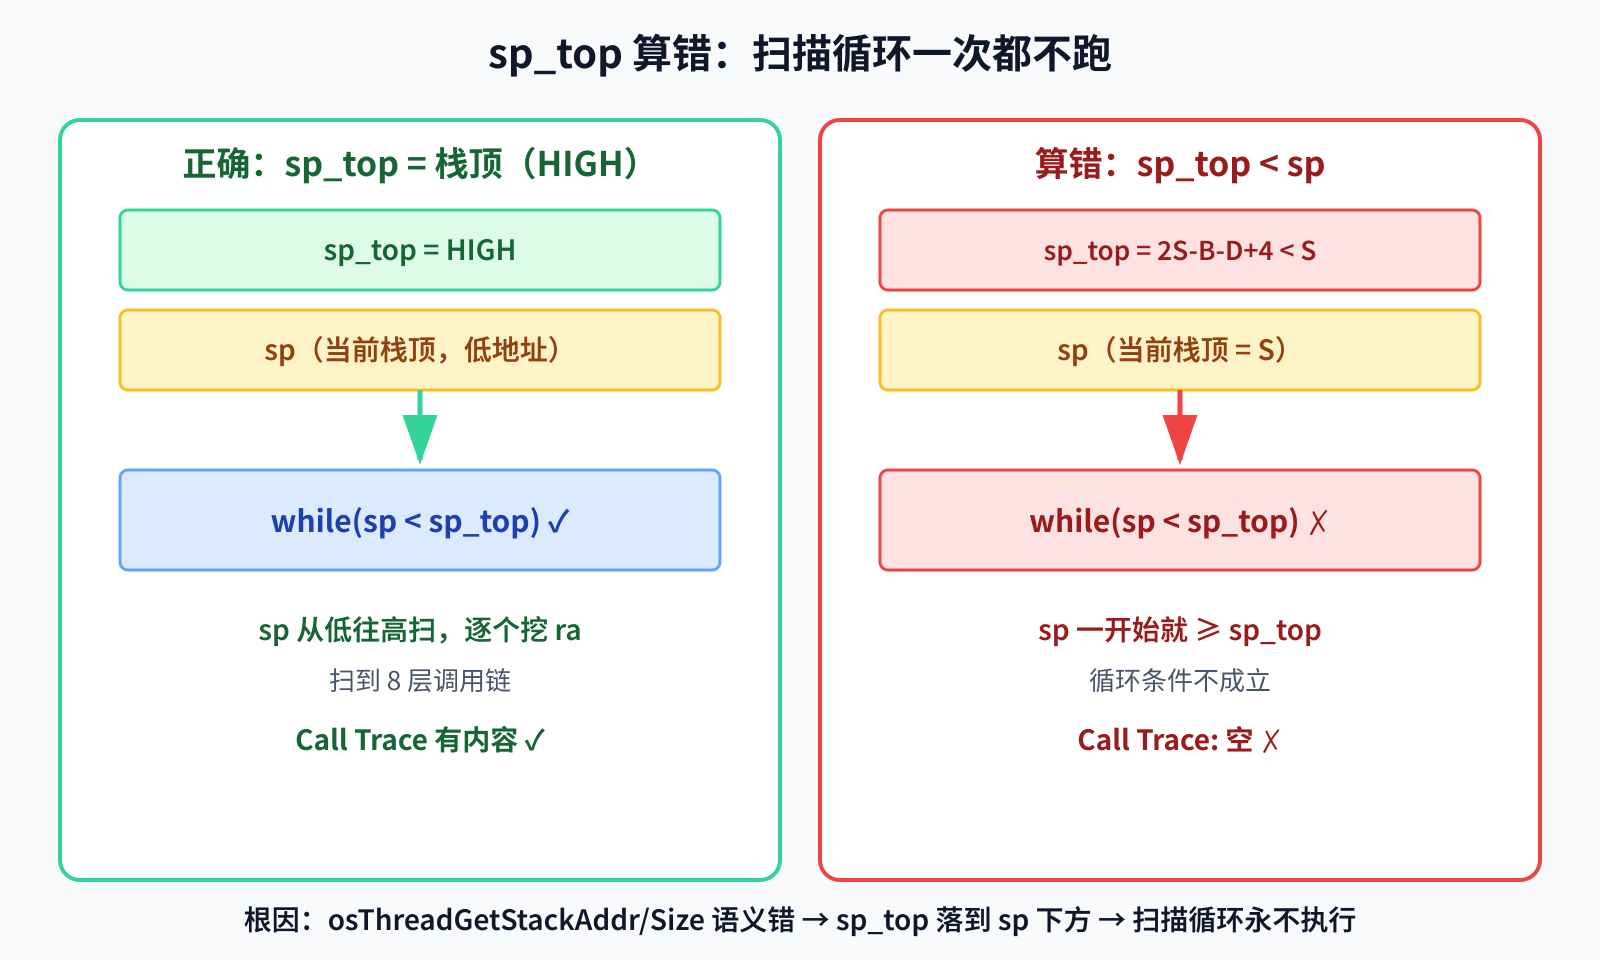
设缓冲区基址 pxStack = B,深度 D 字节,当前 sp = pxTopOfStack = S(S ≤ B+D)。
一步步推:
stack_addr = S(osThreadGetStackAddr返回了当前 sp)stack_size = S - (B + D - 4)(osThreadGetStackSize返回LOW - HIGH,uint32 回绕,代数上就是S - B - D + 4,为负)sp_top = S + (S - B - D + 4) = 2S - B - D + 4
因为 S 远小于 B + D(栈已使用,sp 已下降),sp_top = 2S - B - D + 4 < S,也就是 sp_top 落在 sp_cur 以下。
回溯循环 while (ptmp < sp_top) 里 ptmp 从 sp_cur = S 开始,而 sp_top < S,条件首次求值即为假,循环体一次都不执行 → Call Trace 为空。
这就是"空 Call Trace"的数学根因:不是回溯代码写错了,是喂给它的 sp_top 算错了,导致扫描区间为空。
与崩溃日志的吻合
日志里 stack_addr:0x600160f8 == sp:0x600160f8 直接证实 osThreadGetStackAddr 返回的是当前 sp(pxTopOfStack),而非缓冲区基址。若返回基址,stack_addr 应小于 sp(基址在低地址)。两者相等就是 bug 铁证。
对照参考:rtthread 版是对的
platform/os/rtthread/cmsis_os2.c:1393 的回溯调用:
sp_top = (uint32_t*)(stack_addr + stack_size);  // stack_addr=基址LOW, stack_size=真实大小
sp_cur = (uint32_t*)(rt_thread->sp);            // 当前 sp
hal_core_backtrace(sp_top, sp_cur);
rtthread 的 stack_addr 是缓冲区基址(LOW),stack_size 是真实大小,sp_top = LOW + size = HIGH,从 sp_cur(LOW)往上扫到 HIGH,覆盖真实栈帧。rtthread 路径回溯正常,证明回溯逻辑本身没问题,问题在 FreeRTOS 版两个函数返回了错误语义的值。
四、真实案例:空 Call Trace 怎么导致误判
间接推断的陷阱
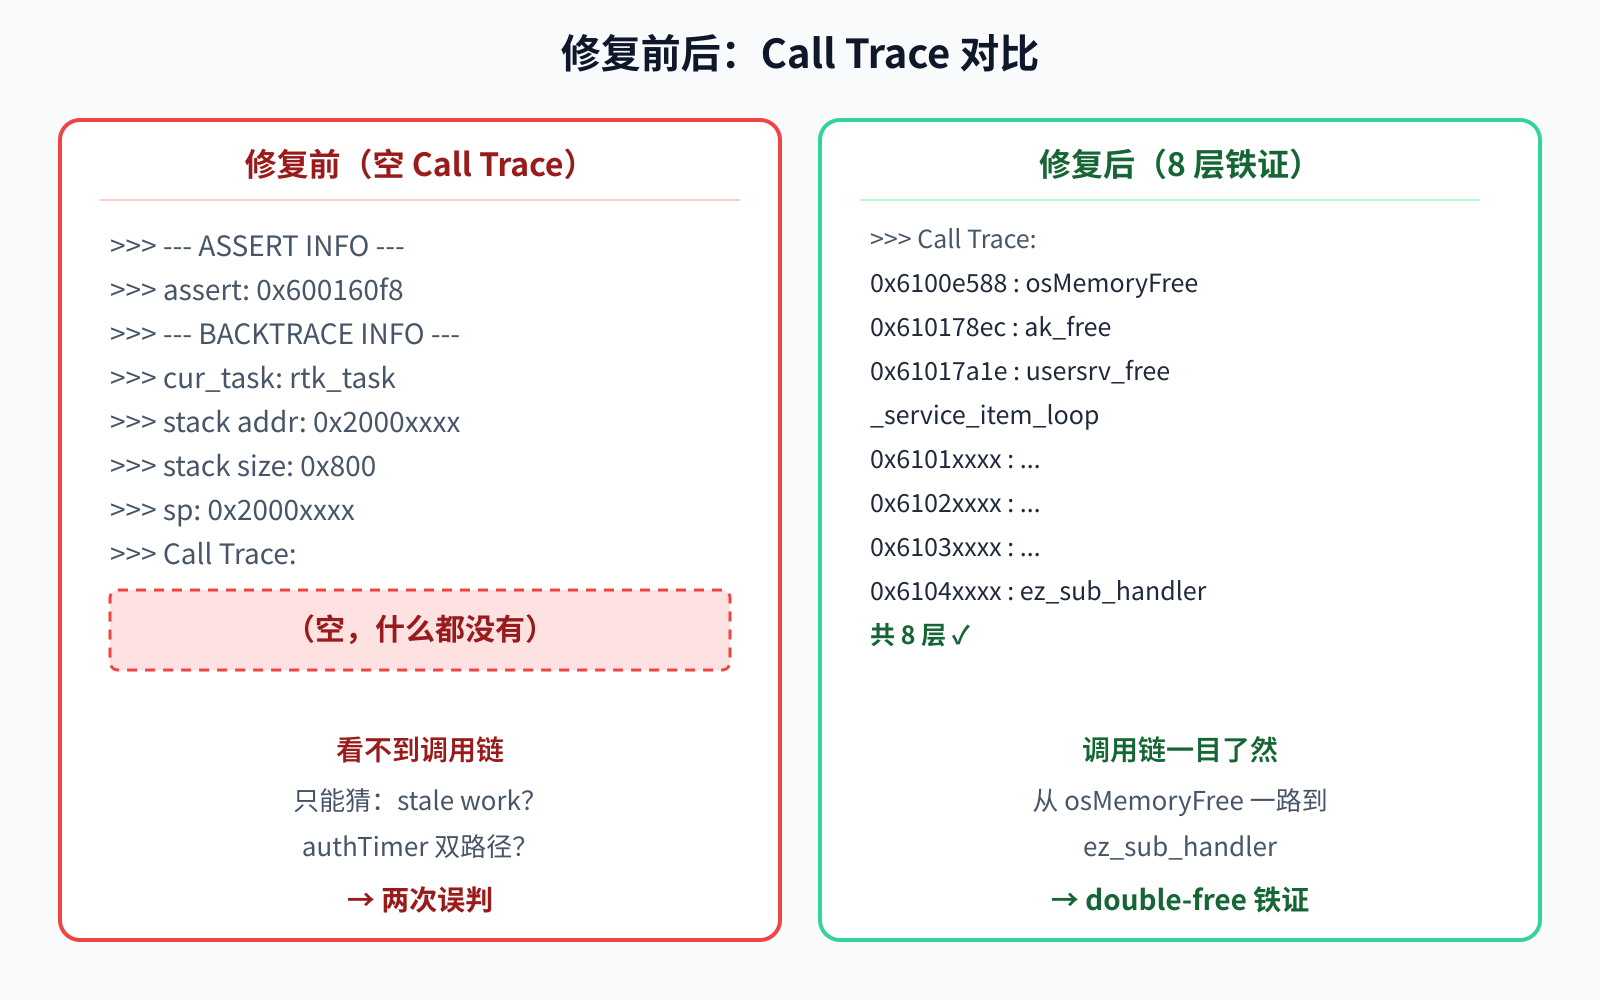
没有 Call Trace,定位只能靠寄存器加反汇编间接推断。ble-D51 崩溃时寄存器:
a0 = 0x600166bc(被释放的堆块地址)a5 = 0x00000124(xBlockSize = 292 字节,bit31=0 表示已释放 → double-free)ra = 0x61023366(osMemoryFree 的返回地址)s1 = a0 + 0x20
这些只能推断"释放了哪块、块多大、大概在内存哪",无法确定是哪个函数调的 free。
关键陷阱在尾调用:EzSys_Free 是尾调用(j ak_free,不压栈),ak_free 的 ra 是 EzSys_Free 的调用者,与"厂商代码直接调 ak_free"在寄存器层面无法区分。尾调用不压栈,所以 ra 指向的是"调用者的调用者",少了一层,间接推断就断了链。
两次误判
Call Trace 修复前,靠间接推断拼出过两个错误理论。
一个是 stale work 理论。当时看 s1 = a0 + 0x20 的偏移,觉得像某个 work 结构体里 data 字段的位置,就猜崩溃在 ez_master_conn_done_handler 释放 work->data。但偏移推断这东西很脆——取决于结构体怎么对齐、字段多长,换个编译选项偏移就变。而且真正的崩溃点比这个 handler 早得多。
另一个是 authTimer 双路径理论。CONFIG_MEM_DEBUG 的追踪表里抓到过一个 4 字节 authTimer 的 double-free(size:4),就以为找到了崩溃块。可崩溃块明明是 292 字节(a5=0x124),4 字节那条是表里另一条记录,地址还差了 0x10,根本是两个不同的块。
两个理论各自都"看起来合理",但没有 Call Trace 这种直接证据来证伪。间接推断就像拼图少了几块硬拼,拼出来的图自洽,但可能是错的。
修复回溯后:铁证
修好两个 CMSIS 函数后,2026-08-17 的崩溃日志首次输出完整调用栈:
[D51-AKF] addr:0x600166bc blksize:0x124 caller:0x6100e588   ← ak_free 插桩, bit31=0=已释放
task name:ez_rf_t, stack_addr:0x600156e8                    ← stack_addr≠sp, 回溯修复生效
mepc:0x61021682, ra:0x61023368, sp:0x600160f8
Call Trace:
backtrace:61023364  osMemoryFree          (cmsis_os2.c:661)
backtrace:610178ec  ak_free              (com_malloc.c:132)
backtrace:6100e584  usersrv_free_service_item_loop (ble_gatt.c:976)  ← ak_free(pData)
backtrace:6100e5ec  ble_gatt_usersrv_unregister    (ble_gatt.c:1128)
backtrace:6100ef7e  ble_gatt_deserialize_peer_service (ble_gatt.c:2550)
backtrace:61011458  com_ble_set_discovered_service  (com_ble.c:2437)
backtrace:61024250  ez_ble_gatt_subscribe_internal (ez_ble_adapt.c)
backtrace:610244c2  ez_sub_handler        (ez_ble_adapt.c)
两个铁证确认回溯修好了。一是 stack_addr:0x600156e8 不等于 sp:0x600160f8——修复前两者相等,修复后 stack_addr 返回的是缓冲区基址(低地址),小于 sp。二是 Call Trace: 后面出现了 8 条 backtrace,修复前是空的。
Call Trace 一读就清楚了:崩溃发生在 ez_sub_handler → subscribe_internal → set_discovered_service → deserialize → usersrv_free_service_item_loop → ak_free(pData),不是之前猜的 ez_master_conn_done_handler,也跟 authTimer 没关系。前面两个误判一次推翻,根因(p_user_service 跨任务无锁竞态)马上就清楚了。
五、修复
改什么
仅 platform/os/FreeRTOS/cmsis_os2.c(OS 适配层,非原厂蓝牙代码)。把两个函数改为与 rtthread 版一致的正确语义:
/// Get stack addr of a thread.
/// \return stack base addr.
uint32_t osThreadGetStackAddr(osThreadId_t thread_id)
{
    /* 返回栈缓冲区基址(最低地址 pxStack), 而非 pxTopOfStack(动态当前sp)。
     * hal_core_trap_intr 用 stack_addr + stack_size 算回溯上界 sp_top(栈缓冲区最高地址)。
     * 栈向下增长(portSTACK_GROWTH=-1), 栈帧位于 [当前sp, 缓冲区顶] 之间, 故 base 必须取
     * pxStack(缓冲区最低地址)。原实现返回 pxTopOfStack(当前sp), 致 sp_top = sp + size
     * 落到 sp 以下, hal_core_backtrace 的 while(ptmp < sp_top) 永假, Call Trace 为空。 */
    return (uint32_t)uxTaskGet_pxStack((TaskHandle_t)thread_id);
}

/// Get stack size of a thread.
/// \return stack size in bytes.
uint32_t osThreadGetStackSize(osThreadId_t thread_id)
{
    /* 返回栈缓冲区总大小(字节) = (pxEndOfStack - pxStack + 1) * sizeof(StackType_t)。
     * pxEndOfStack = pxStack + (depth-1)(高地址, 缓冲区顶), pxStack = 缓冲区基址(低)。
     * 原实现 pxTopOfStack - pxEndOfStack = LOW - HIGH = 负值回绕成巨大 uint32, 致
     * sp_top = stack_addr + size 越界, Call Trace 为空。与 rtthread 版语义对齐。 */
    uint32_t high = (uint32_t)uxTaskGet_pxEndOfStack((TaskHandle_t)thread_id);
    uint32_t low  = (uint32_t)uxTaskGet_pxStack((TaskHandle_t)thread_id);

    return high - low + sizeof(StackType_t);
}
修复后 sp_top 计算
设缓冲区基址 B = pxStack,深度 D 字节。
stack_addr = B(LOW)stack_size = (pxEndOfStack - pxStack + 4) = (B+D-4 - B + 4) = Dsp_top = B + D= 缓冲区最高地址(顶)
hal_core_backtrace 从 sp_cur(异常帧,当前 sp)往上扫到 sp_top(缓冲区顶),覆盖 [当前sp, 缓冲区顶] 区间内所有栈帧 → 回溯正常。hal_interrupt.c 现有 sp_top = stack_addr + stack_size 无需改动,自动正确。
影响范围
grep 确认 FreeRTOS 版 osThreadGetStackAddr / osThreadGetStackSize 的唯一调用者是 hal_interrupt.c(崩溃回溯),无其他调用者,修复这两个函数无副作用。uxTaskGet_pxStack / uxTaskGet_pxEndOfStack 在 tasks.c 无条件编译、task.h 无条件声明,可直接使用。
验证
编译通过无警告。反汇编确认 osThreadGetStackAddr 尾调用 uxTaskGet_pxStack 返回基址,osThreadGetStackSize 算出 (pxEndOfStack+4) - pxStack = depth*4 = 栈缓冲区总字节数,正确。
设备验证待测:烧录后制造一次崩溃,预期 stack_addr 不再等于 sp(应小于 sp),Call Trace: 后出现真实 backtrace 列表。
六、几点启示
第一,调试基础设施得先于业务定位。ble-D51 绕了三天弯路,根因不在业务多复杂,而在调试工具本身坏了——Call Trace 一空,所有定位都退化成间接推断。回溯修好后,一份日志就定位了根因。所以遇到"崩溃但看不出在哪崩的",先别急着查业务,先怀疑调试工具。Call Trace 空、打印不出、断点不命中,这些"工具异常"往往比业务 bug 更值得先动手修。
第二,间接推断要警惕"看起来合理"。拿寄存器加反汇编推断内存 layout,很容易拼出"自洽但错误"的理论。s1 = a0 + 0x20 推断成 work 结构体、trace 表里 4 字节那条被当成崩溃块,都是间接证据拼出来的假象。间接证据只能提假设,证不了伪。一旦拿到直接证据(Call Trace、插桩 caller),别犹豫,用它推翻间接推断。
第三,接口语义要对齐文档。osThreadGetStackAddr 注释写 "stack base addr",实现却返回 pxTopOfStack(当前 sp),文档和实现对不上,就埋了雷。这种"函数名/注释跟实际行为不符"的隐性 bug,在调用者用错之前不会暴露。移植层、适配层的接口尤其要注意语义对齐,必要时找个对照参考(比如本例的 rtthread 版)交叉验证一下。
第四,通用修复惠及全局。这是崩溃调试基础设施的修复,惠及所有任务的异常回溯,不限于 ble-D51。修复前任何任务崩溃 Call Trace 都是空的,只能靠寄存器间接推断;修复后崩溃日志直接给调用栈,是后续所有崩溃定位的前提。改动本身不碰任何业务逻辑,只修正两个 OS 适配函数的返回值语义,风险很低。
下一篇会展开讲 p_user_service 跨任务无锁竞态这个根因本身——Call Trace 修好后,它是怎么被一次定位的。
有用的话点个在看,让更多做嵌入式调试的工程师看到。
标签:
嵌入式RISC-VFreeRTOS调试栈回溯崩溃定位


 扫一扫


 485

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


