



孩子手里的小米手表,怎么和同桌的华为手表加上好友?
放在三年前,答案基本是"不能"。小天才封闭社交、各家碰一碰只认自家。直到 2025-12-02,GB 46859-2025《儿童手表安全技术要求》正式发布,2027-01-01 强制实施——跨品牌加好友从一个"看厂商心情的功能",变成了一条写进国家标准的硬性要求。而且不是说说而已,头部几个大厂拿出了一个连通方案。
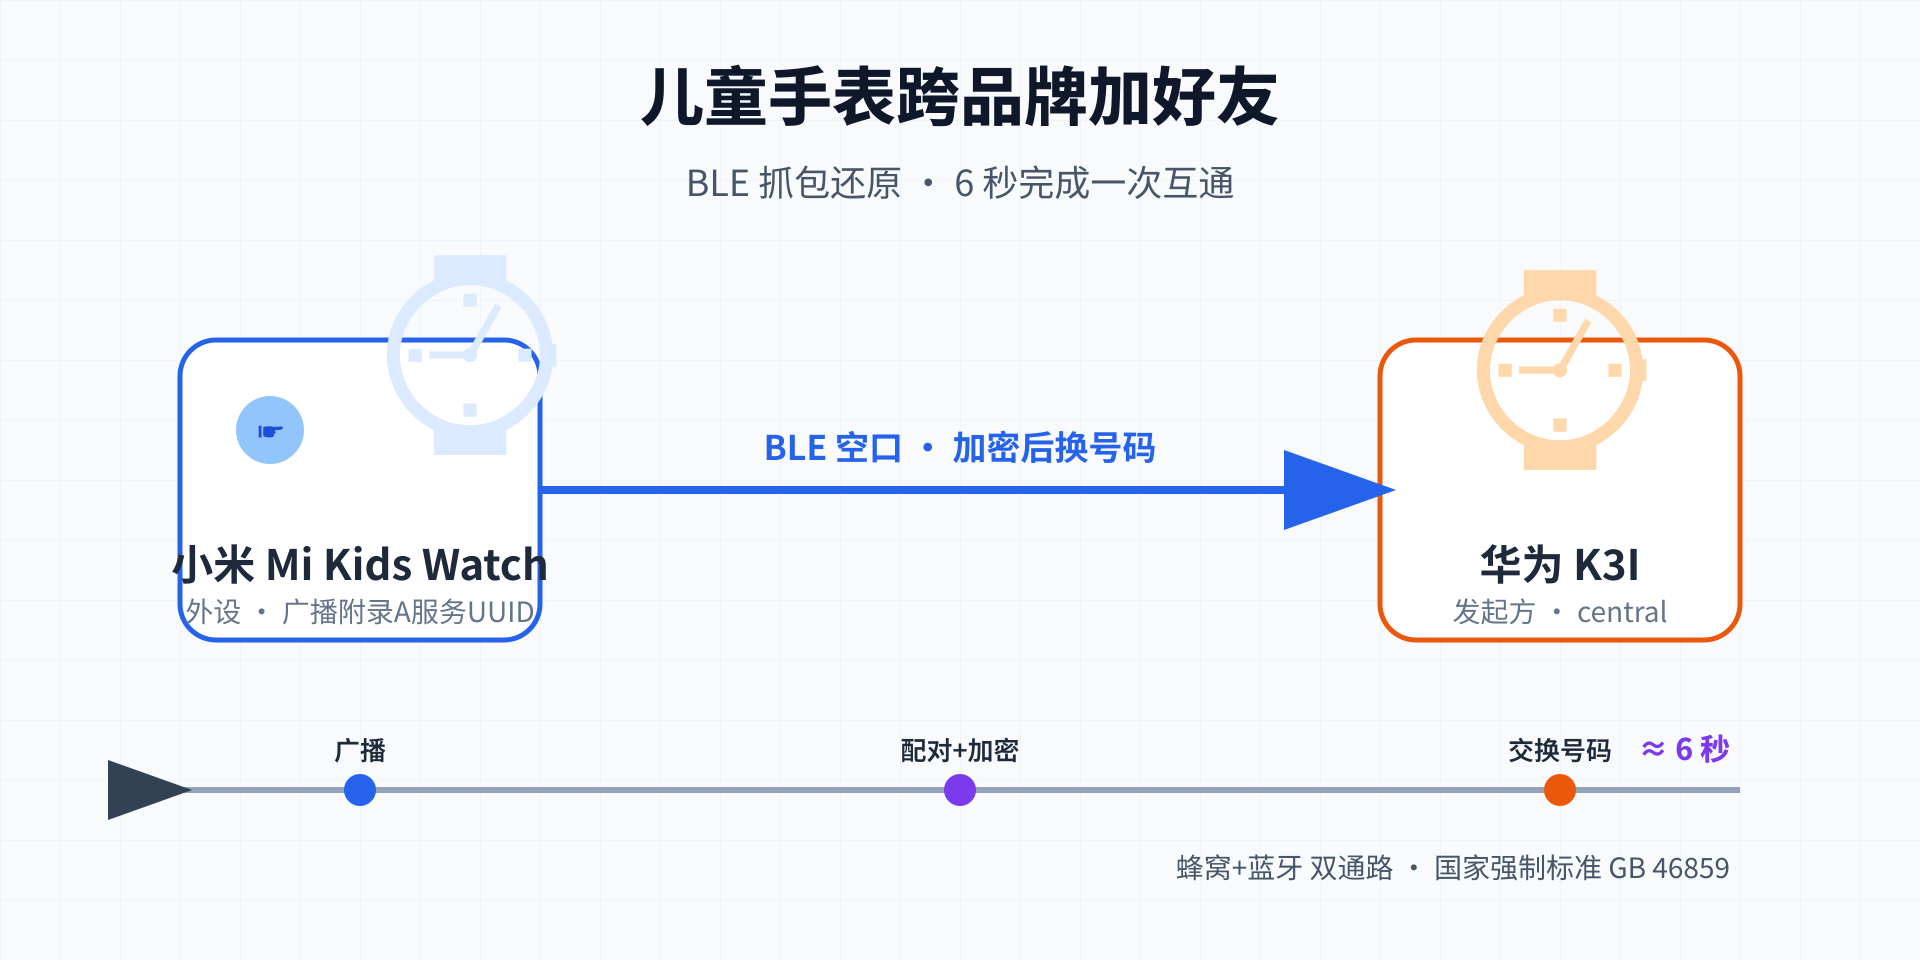
这篇文章不是复述规范条文。我手上有一份真实的 nRF 抓包(儿童手表小米&华为.pcapng,56098 帧,27.7 秒),里面正好是一台小米 Mi Kids Watch 和一台华为 K3I 完成一次完整加好友的全过程。我把它逐帧拆开,让你看清:标准里那一两百字的"交换电话号码",落到空口上到底是什么字节流。
先说结论:跨品牌加好友是有强制标准的
GB 46859-2025 的第 4.18 条,标题就叫"交换电话号码",原文是要求 "儿童智能手表允许不同品牌手表之间交换电话号码和昵称"。这是这份国标里最"拆生态墙"的一条——只要双方都是合规儿童手表,就必须能换联系方式,厂商不能拿"我家封闭"当理由。
几个关键时间点:
- 发布 2025-12-02,实施 2027-01-01;
- 实施之日前已生产/进口的产品,自实施起第 13 个月(约 2028-01)起也必须满足——给存量留了升级窗口;
- 小米、华为、小天才、360 全部是起草单位。标准是这几位老对手一起写的,这是"跨品牌互加"能落进强制标准的关键。
一句话概括它的技术路线:BLE 广播一个服务 UUID → 连接 → GATT 服务发现 → 数字比对配对 → 链路加密 → 在加密的 GATT 读写里换掉电话号码和昵称。
下一个问题是:不同品牌的表,靠什么"认出彼此能加好友"?
互操作的两把钥匙:一模一样的 UUID
跨品牌互通最怕的两个字是"私有"。A 牌私有格式,B 牌根本不认。国标解决这个问题的办法特别"嵌入式":用两个固定 UUID + 一个 20 字节格式,把整个行业的数据面拉平。
- 附录 A,规定一个 128 位服务标识:
6d293d29-cee2-4ace-aa7a-1909e34e4298。手表要把它塞进 BLE 广播包,让对方扫到就知道"这是一块支持国标加好友的儿童手表"。 - 附录 B,规定这个服务里一个特征的 UUID:
4a3510a8-b8f5-42b7-9870-8901807b229f,以及它的属性值格式——一个 TLV 自描述结构:
+----------------+-------------------+----------------+----------------+
| 号码长度(1B)   | 电话号码(E.164)   | 昵称长度(1B)    | 昵称(UTF-8)      |
+----------------+-------------------+----------------+----------------+
标准示例就一行:15 008613912345678 2 张三。意思是"号码长 15 字节,号码 008613912345678,昵称长 2 字节,昵称 张三"。
两个不同品牌的手表,不需要任何私有协商:central 去读对端这个特征,按固定格式一解,号码和昵称就到手了。这就是"20 字节拉平全行业"的工程含义——也是最"漂亮"的设计点,实现成本低到任何有 BLE 栈的团队都接得起。
主角登场:抓包里那一对陌生表
继续往下之前,先交代清楚这份抓包到底是什么。
设备:外设是一台小米 Mi Kids Watch(地址 7e:a7:0d:3e:f7:d4),它一直在广播,广播里就带着附录 A 的服务 UUID。发起方是一台华为 K3I,它的地址是轮换的(RPA),是靠 CONNECT_REQ 里留下的地址 + 它停止广播的时间点交叉推断出来的。
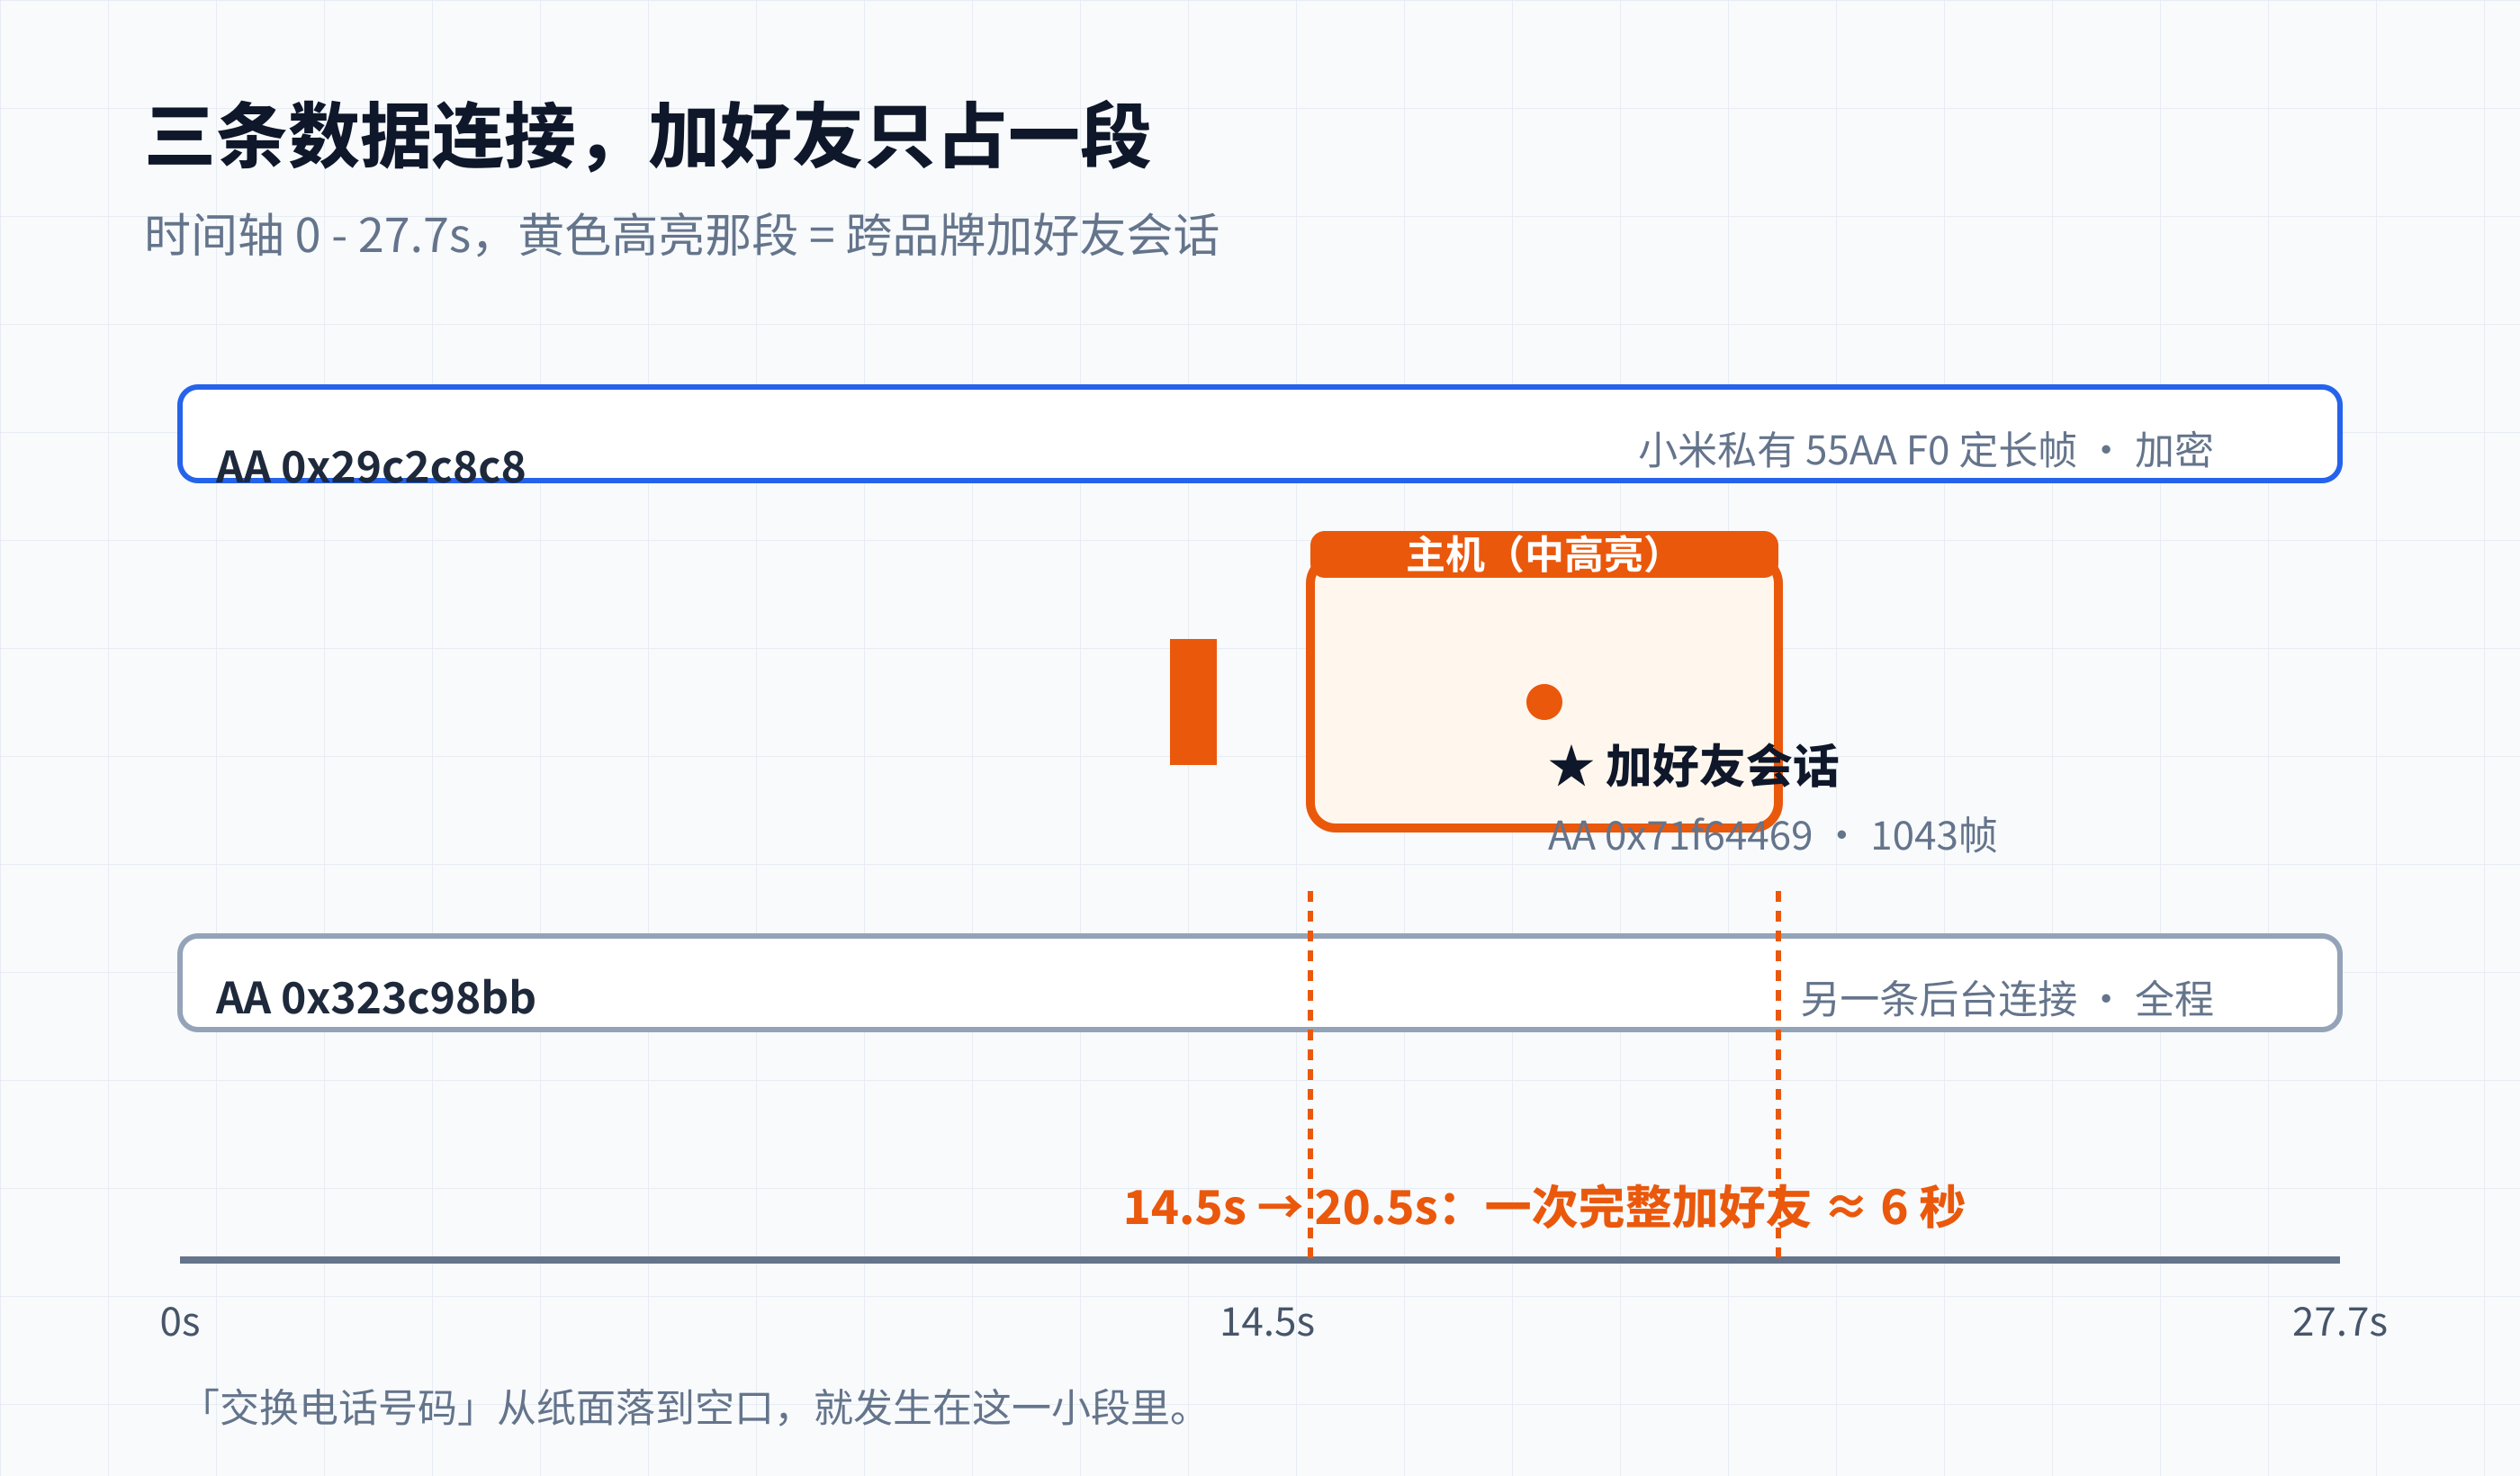
数据连接一共三条,加好友会话只是其中一条——注意它的 Access Address 和属性:
| Access Address | 报文数 | 时间窗口 | 性质 |
|---|---|---|---|
0x29c2c8c8 | 6145 | 全程 | 小米私有 55 AA F0 定长帧,已加密 |
0x71f64469 | 1043 | 14.5~20.5s | ★ 跨品牌加好友会话(本文主角) |
0x323c98bb | 1033 | 全程 | 另一条后台连接 |
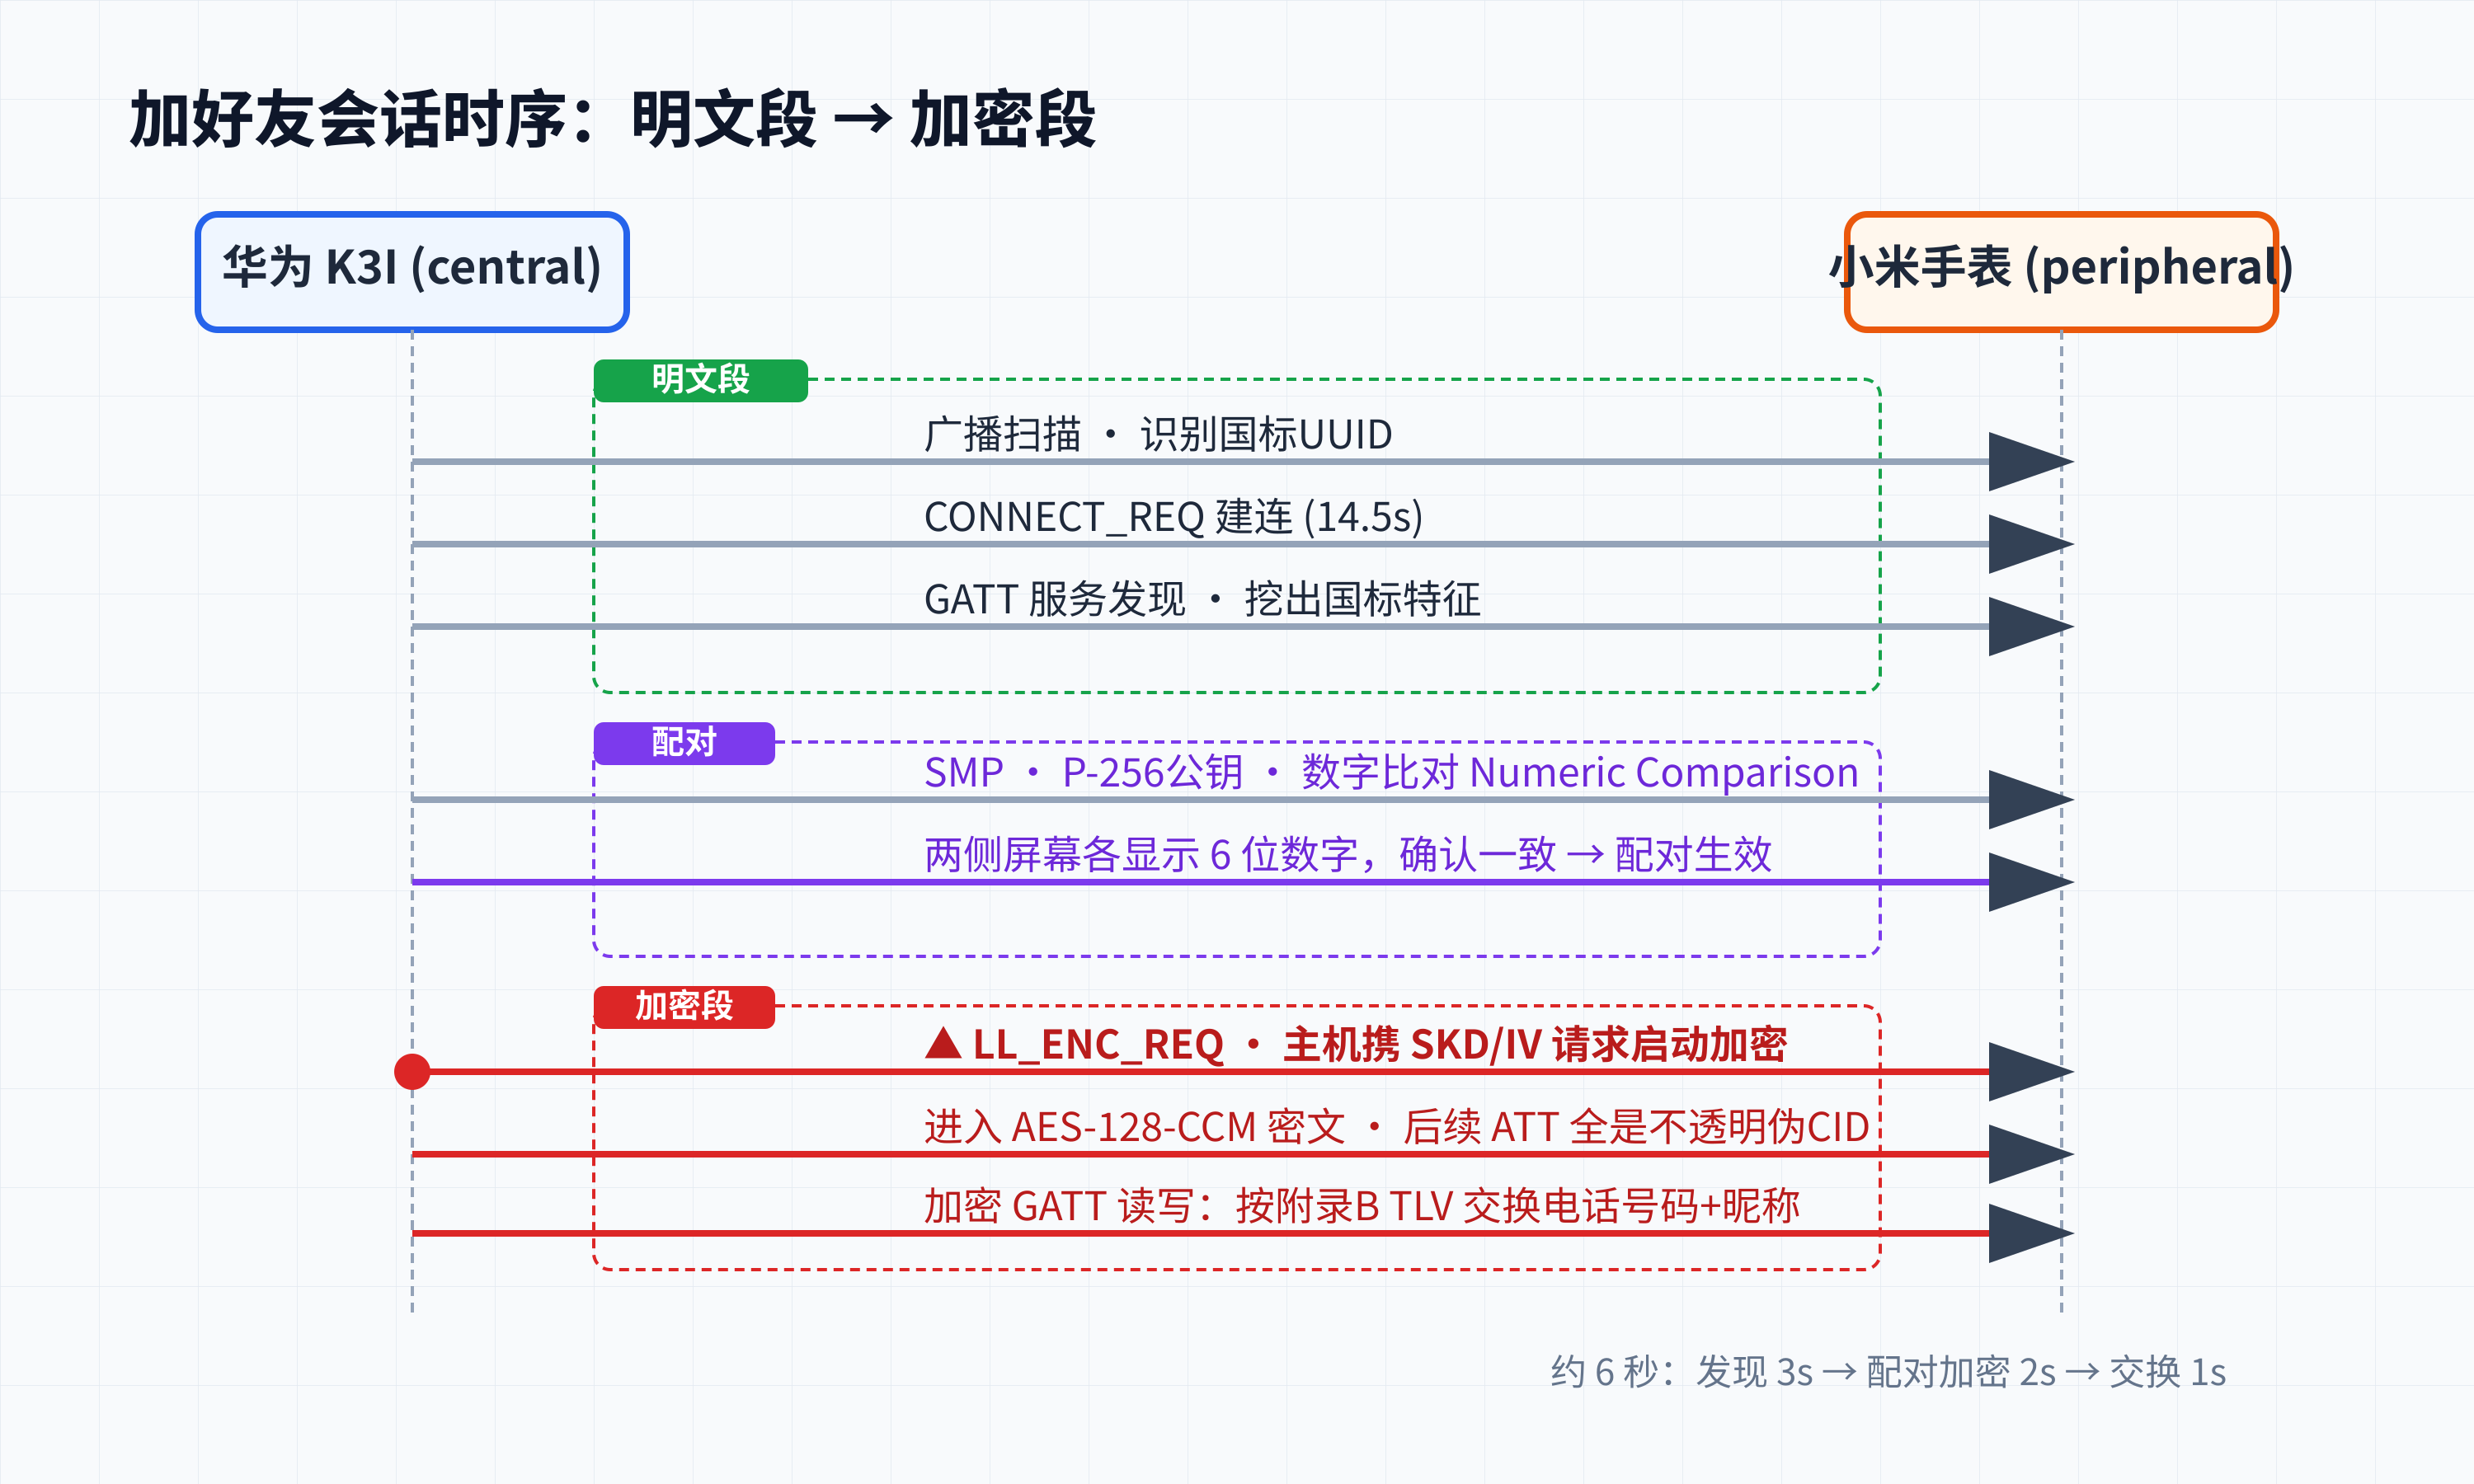
那个时间窗口很关键:一次完整的加好友只花约 6 秒,从 14.5s 建立连接到 20.5s 结束。这一小段,就是国标从纸面落到空口的全过程。
逐帧拆包:6 秒里到底发生了什么
照 GB 4.18 的要求顺序,一帧一帧看。
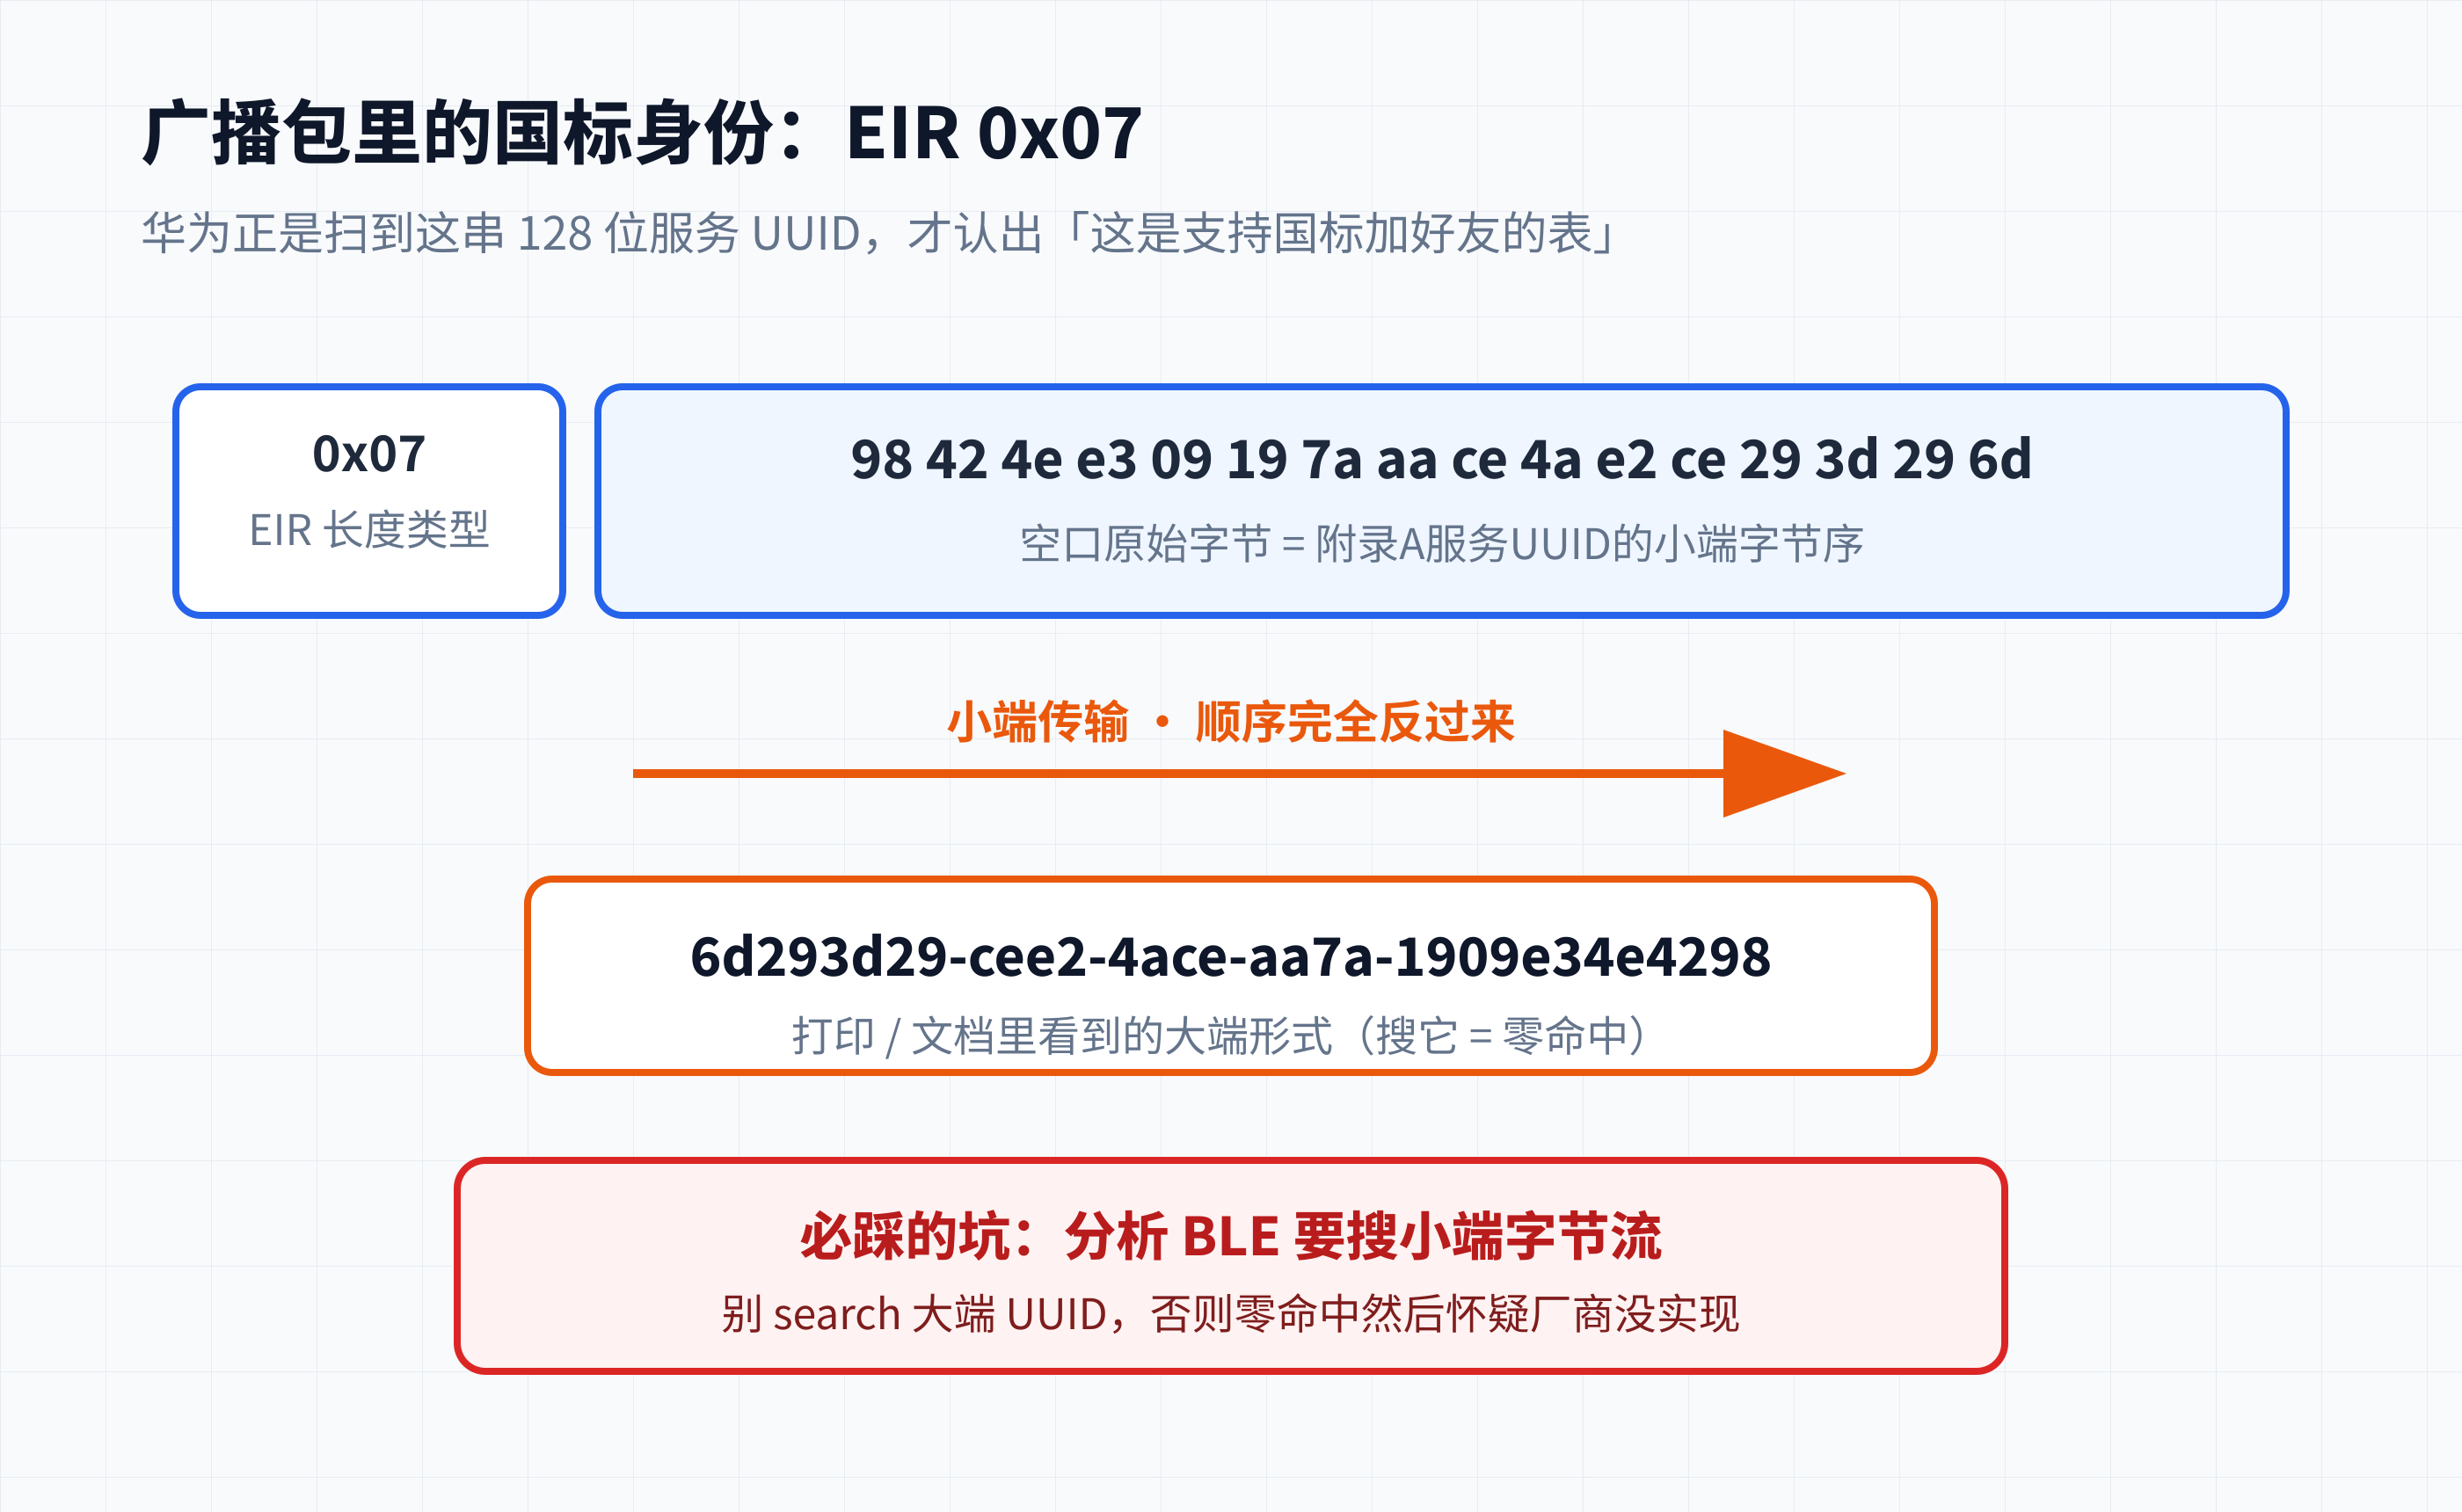
第 ① 步:广播里藏着国标身份(pkt185)
小米手表的广播包(ADV_IND,信道 39)里有一串 EIR:
EIR 0x07  Complete List of 128-bit Service Class UUIDs:
     6d293d29-cee2-4ace-aa7a-1909e34e4298
华为手表正是扫到这串 UUID,才认出"这是支持国标加好友的儿童手表",于是发起连接。
这里有个必踩的坑:BLE 在空口传输 128 位 UUID 用的是小端字节序。6d293d29-... 在空口原始字节里长这样:
11 07 98 42 4e e3 09 19 7a aa ce 4a e2 ce 29 3d 29 6d
98 42 4e e3 ...——完全反着的顺序。你要是按打印出来的大端去搜,结果是零命中,然后就开始怀疑"是不是厂商没实现"。我在分析时就踩过这个坑折腾了一阵,写出来给各位避雷:分析 BLE 时,search 小端字节流,别 search 大端 UUID。
第 ② ③ 步:建连 + 能力协商
CONNECT_REQ 由华为发起,连接间隔 30ms。随后是常规的 LL 层握手(LL_FEATURE_REQ/RSP、CONNECTION_PARAM),协商链路特性。这一段相对朴素,真正精彩从 GATT 发现开始。
第 ④ 步:GATT 服务发现,挖出国标那两把钥匙
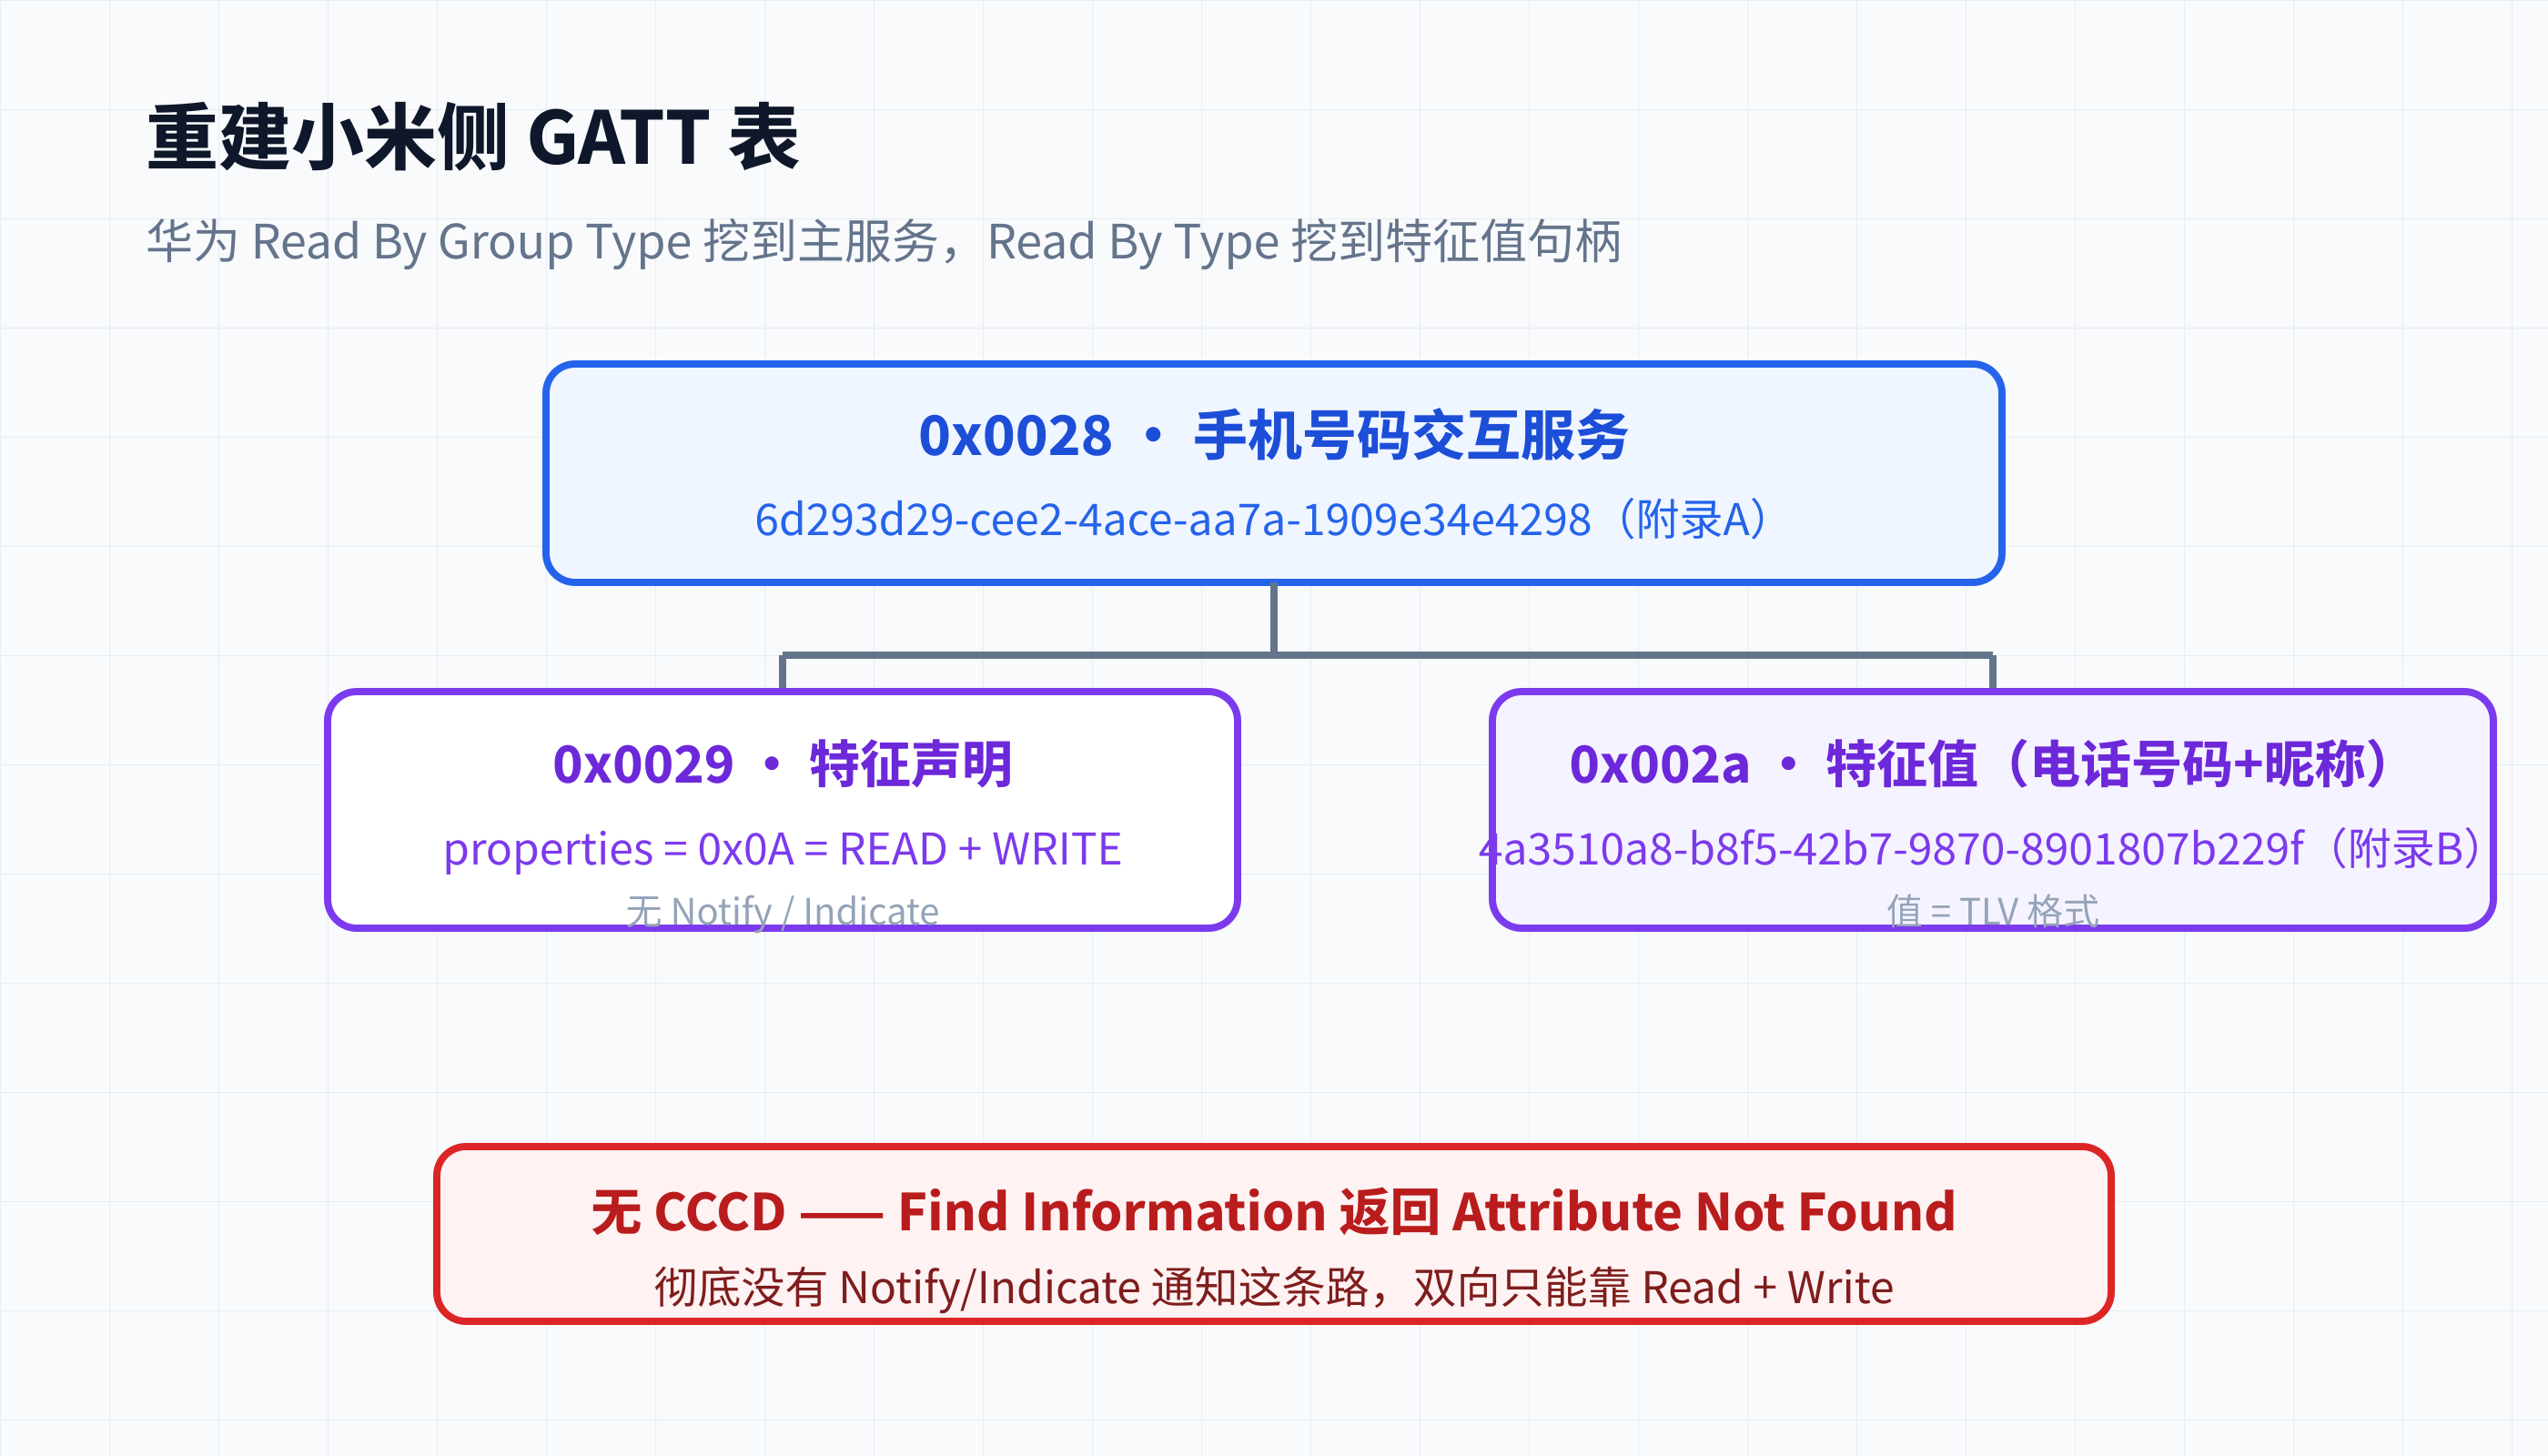
华为作为 central,先发 Read By Group Type 遍历主服务,在 pkt27479 里挖到了目标:
主服务 @ 句柄 0x0028-0xFFFF, UUID = 6d293d29-cee2-4ace-aa7a-1909e34e4298
紧接着 Read By Type 在服务内发现特征(pkt28529),关键字节是这一行:
09 15 2900 0a 2a 00 9f227b80 0189 7098 b742f5b8 a810354a
└op└len└声明句柄└props└值句柄└──── 属性UUID = 附录B ────┘
这里那个 0a 是 properties 位,0x0A = 00001010 → READ(0x02) + WRITE(0x08),不含 Notify/Indicate。也就是说小米手表把这个特征暴露成"可读可写"。
再往后华为用 Find Information 探测特征之后有没有描述符,得到一个 Attribute Not Found——意思是这个特征没有 CCCD,彻底没有 Notify/Indicate 通知这条路。重建出来的小米侧 GATT 表:
0x0028-0xFFFF  电话号码交互服务 (6d293d29-...)            ← 附录A
  └ 0x0029      特征声明  (properties = READ+WRITE = 0x0A)
  └ 0x002a      特征值: 电话号码+昵称 (4a3510a8-...)       ← 附录B
                (无 CCCD → 无 Notify, 双向只能靠 Read+Write)
第 ⑤ 步:数字比对配对,然后链路加密
配对走的是 LE Secure Connections。抓包看到 SMP 交换了 P-256 公钥;配对方法解析为 Numeric Comparison——两张表屏幕上各显示一个 6 位数字,由佩戴的孩子/家长确认一致后配对生效。这有两层含义:防中间人(攻击者没法让两侧数字一致),又保留"人"的确认环节。
随后进入链路层加密握手:
| pkt | LL 控制报文 | 含义 |
|---|---|---|
| 36166 | LL_ENC_REQ(0x03) | 主机携带 SKD/IV 请求启动加密 |
| 36185 | LL_ENC_RSP(0x04) | 从机回应 |
| 36187 | LL_START_ENC_REQ(0x05) | 从机确认启动 |
| 之后 | LL_START_ENC_RSP | 进入 AES-128-CCM 密文阶段 |
加密之后,scapy 等通用解析器只能看到乱码化的 L2CAP(伪 CID)——那些其实是密文 ATT 帧,内容正是按附录 B 格式交换的电话号码和昵称。
这一点非常关键,也容易误解:这"乱码"不是抓包失败,恰恰是 GB 4.18.2"电话信息加密传输"达标的证据。空口视角下,号码和昵称的明文从头到尾没出现过——这正是这份国标想要的效果:号码可以当面换,但绝不在无线空口裸奔。
第 ⑥ 步:收尾
t≈20.5s 后连接无新报文,会话结束。全程约 6 秒:发现 3s → 配对加密 2s → 交换 1s。一次"跨品牌加好友",比想象中快得多,也安静得多——不值得在隔壁都能用手机抓到的时间窗里拖泥带水。
一个我把结论改了三遍的疑点:信息到底怎么"双向"交换?
写到这里,有个问题一直缠着我:听起来是发起方读了被加方的号码,小米这边算是把信息给过去了,可华为怎么把自己的信息给小米?
看来方向很明确:华为 central 读小米 peripheral。那小米怎么读华为?答案有点意外——查遍了这份实际抓包,华为根本没法往小米"写"。
这个疑点我最初跑偏过两次。第一次想:既然从机特征可能只读,那从机是不是回头"反向连一次主机"把信息送出去?也就是"角色反转"。对照真实时间线后我否定了它:这个加好友会话全程只有一次加密握手、没有第二段 CONNECT_REQ、没有反向连接。
第二次想:会不会是同一条连接里,靠"其他可写/可通知通道"偷偷送?也否定了:华为在可读阶段对小米的写请求是 0 次(Write Request 0x12、Write Command 0x52、Prepare/Execute Write 全都为 0),而小米侧除了标准电话号码服务,没有第二个两厂商共通的私有可写句柄。写都没地方落。
于是我把它拆成三层诚实地看:
A. 抓包可证的事实 - 华为 central 在可读阶段对小米 0 次写入,只做服务/特征发现 + 读; - 会话只有一次加密握手,没有第二次连接,没有角色反转。
B. 抓包可证的排除 - 排除"华为从 BLE 写号码给小米"; - 排除"反向连接/角色反转"。
注意:排除了 X ≠ 证明了 Y。 走到"BLE 这条路被堵死",就到头了。信息到底走哪条路,只能算推测:
C. 推测(标注置信度:中高)——"华为→小米"那一向,走云端 最合理的解释是那块手表把华为的号码经蜂窝网络上报云端,云端再异步处理好友关系。间接佐证有几个:华为官方明确"加好友需网络+SIM 卡";"好友关系在云端落地、家长可云端拒绝、跨品牌需互联互通认证"。如果这个转发本就走蓝牙空口,为什么强制要求插 SIM 卡?——这是"必须插卡"最强的合理解释。
但我必须诚实:没有任何公开规范或官方文档,直接白纸黑字陈述"跨品牌加好友时联系人数据经厂商云在两品牌间转发"。这一环节的具体实现,我无法从已拿到的证据直接确认,所以它只能是"推测/最可能",不是定论。要把它做实,得用带 LTK 的嗅探器解密密文段、或逆向手表固件。在此之前,我不给"华为→小米走云端"这个说法盖上"事实"的戳。
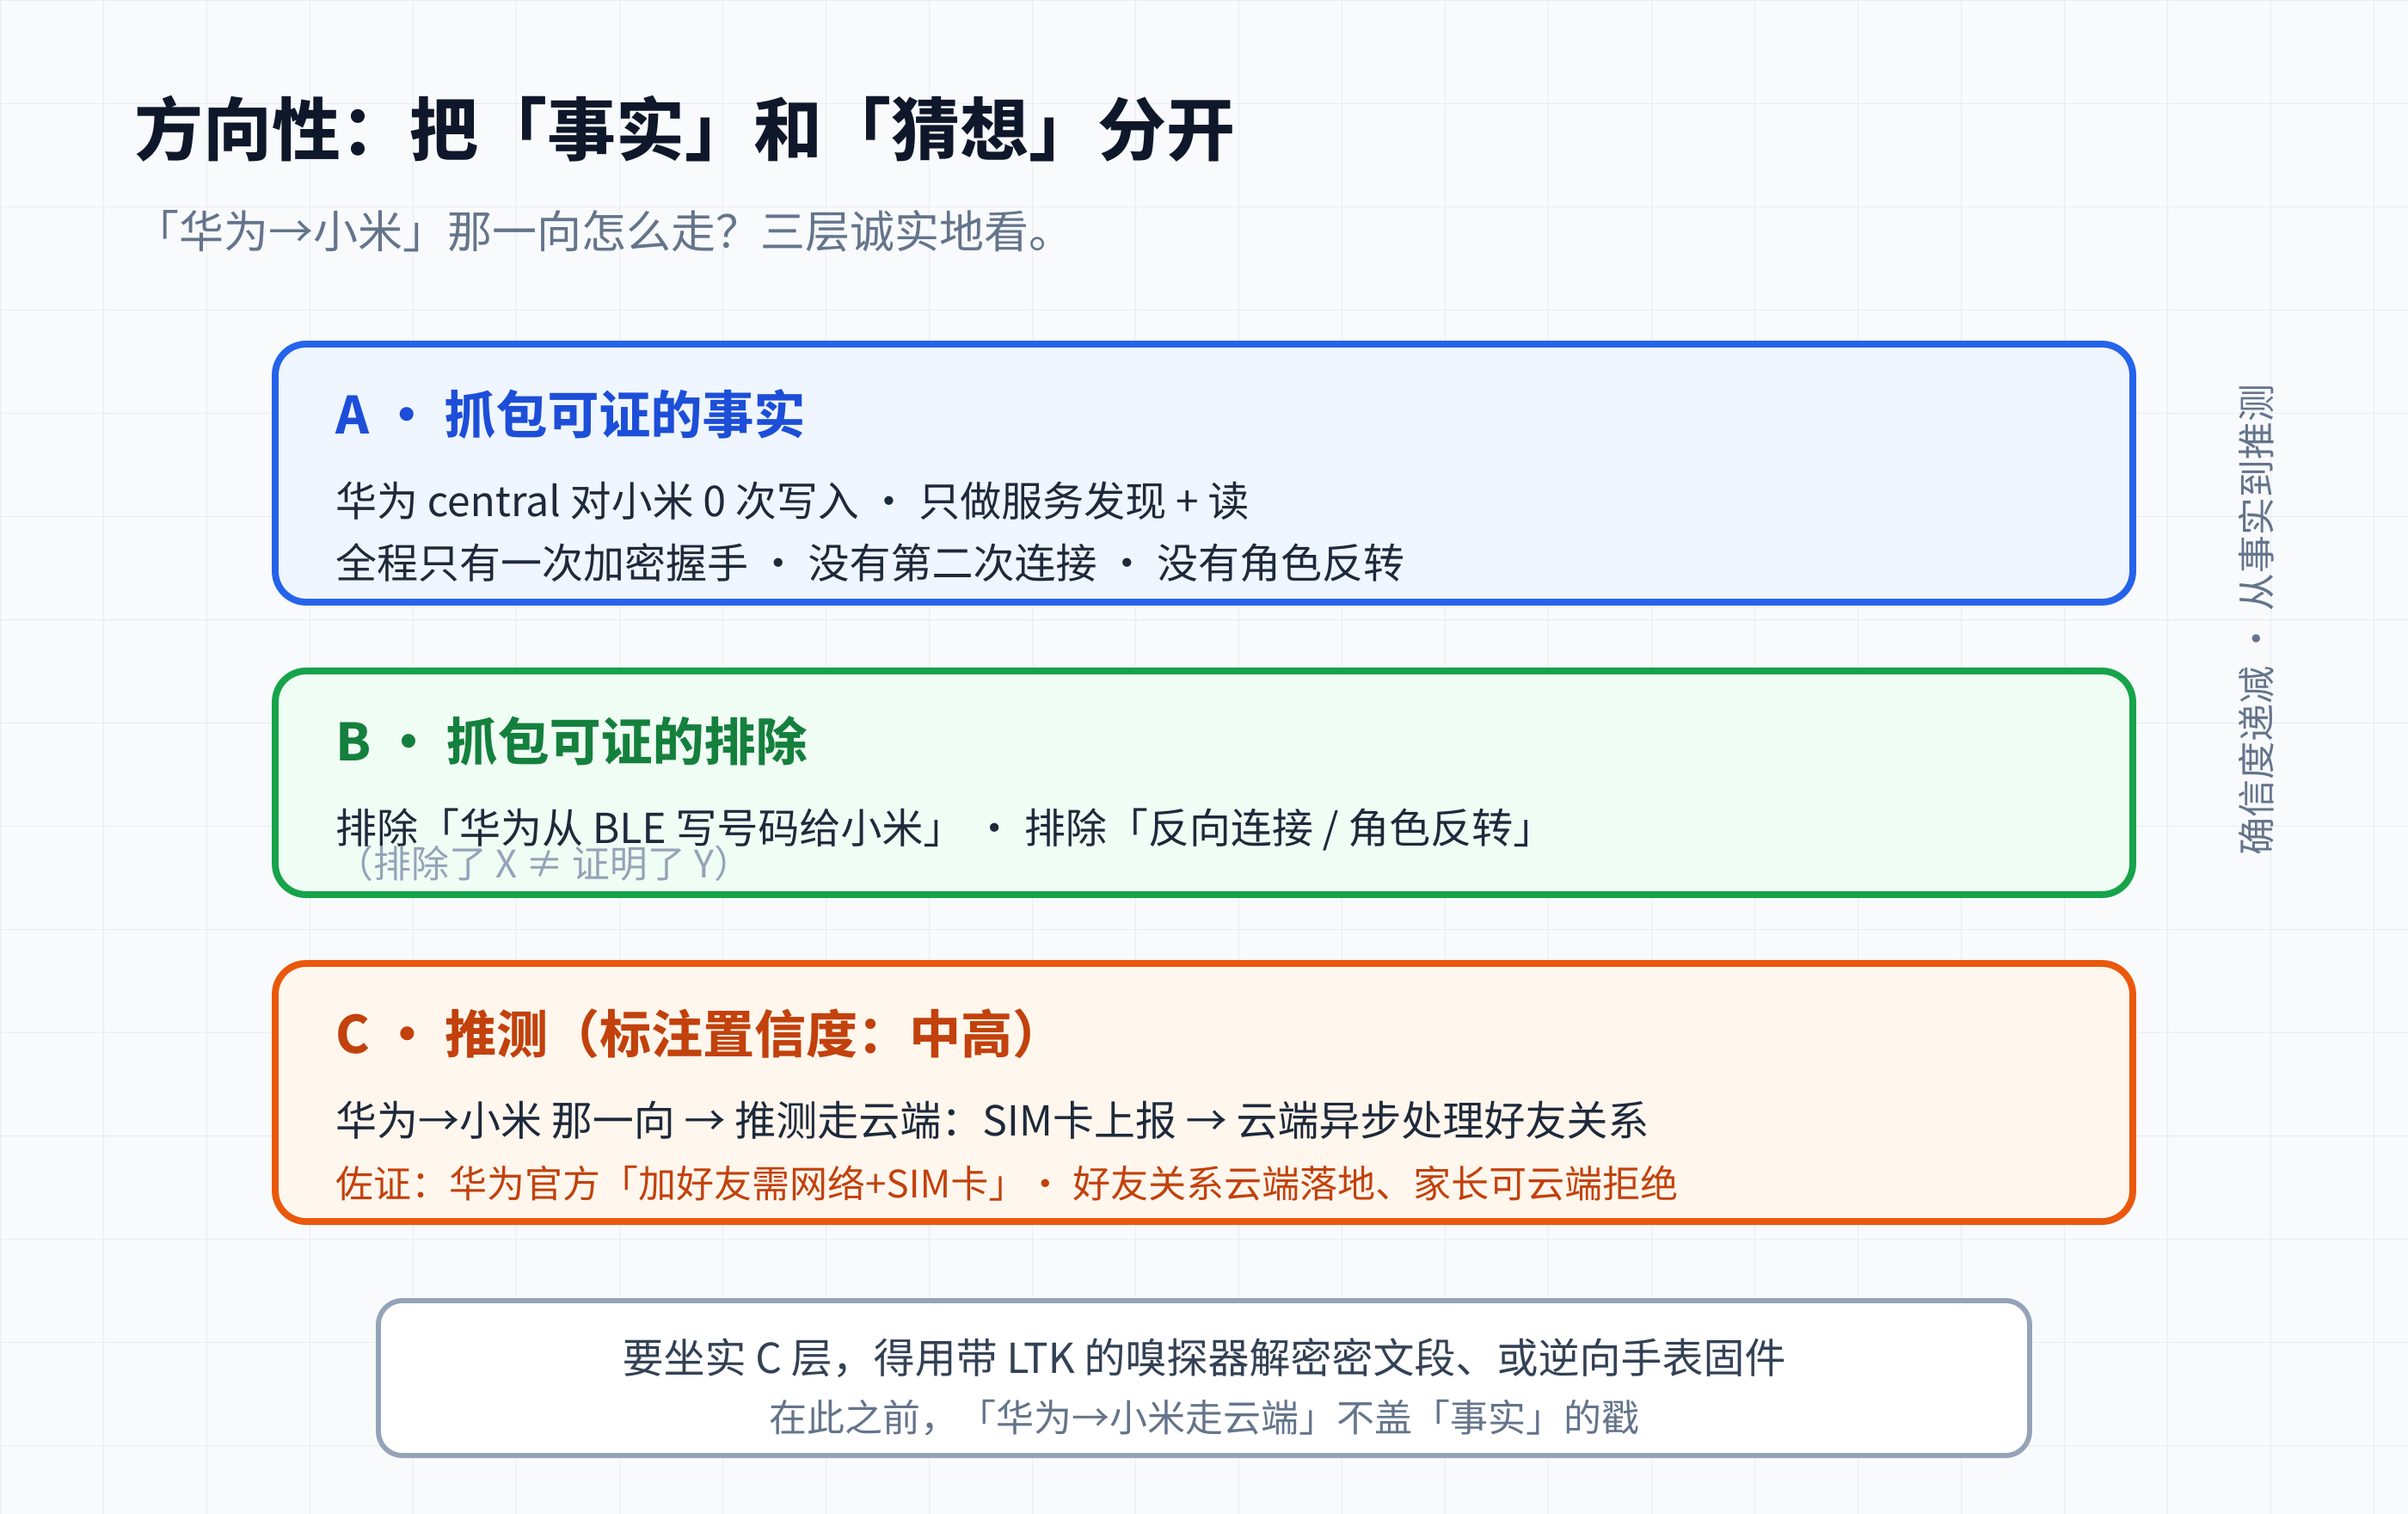
这一段特别想传达给同行的是一个方法论:做协议分析,最该警惕的是把"排除了 A"顺嘴讲成"那就是 B"。分析可以大胆,下结论要能分清"抓到的事实"和"推出来的猜想"。
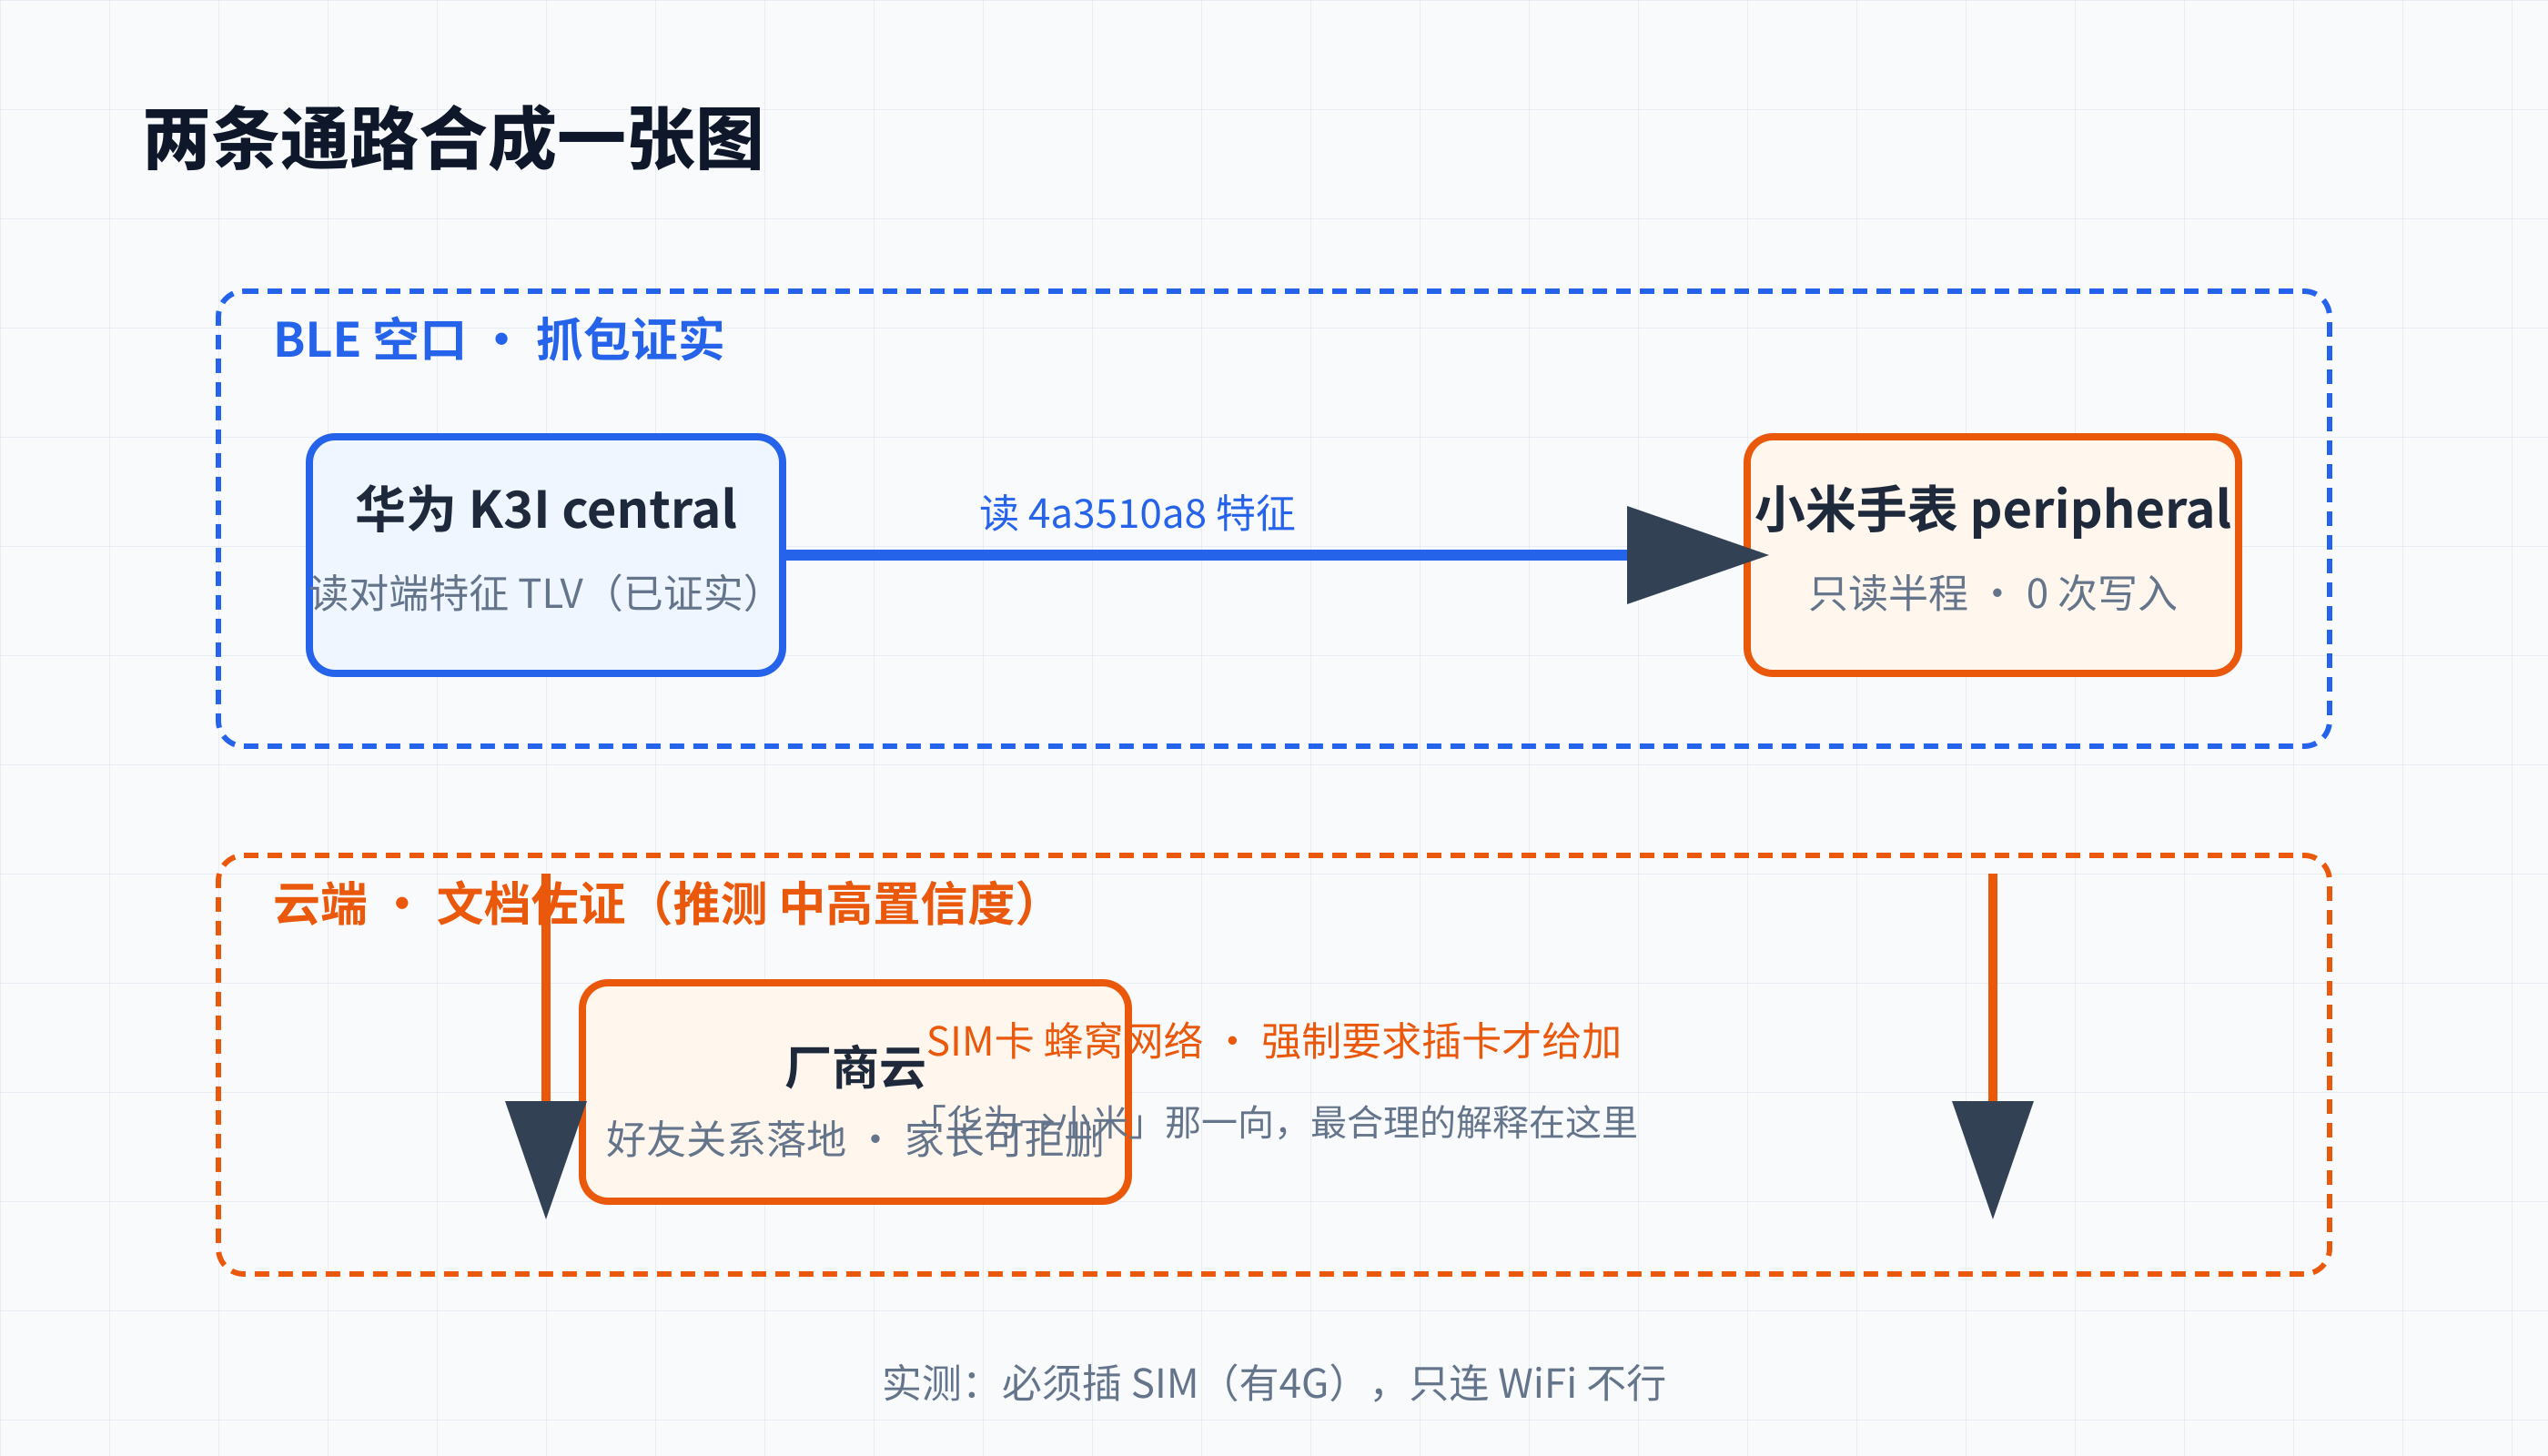
为什么加好友"离不开 SIM 卡"?
顺着上一节的推测,实测情况是:两台表互加好友,必须插 SIM(有 4G),只连 WiFi 不行。这和"走云端"的推测高度咬合。
华为官方文档给了三处佐证(2026-09 查证):
- 摇一摇加好友:"使用前请确保手表蓝牙已开启、网络连接正常、且已安装 SIM 卡"——同品牌加好友三件套,缺一不可;
- 跨品牌添加联系人:"使用前请确保蓝牙已开启,且网络连接正常";添加成功后"家长在智能关怀的消息通知可看到添加联系人通知";
- 失败排查:第一步就是"确保网络正常后重新摇一摇"。
蜂窝网络在这套流程里大概要干三件事。我说"大概",因为每一条都有置信度差别,别当铁律看:
- 云端好友关系落地(置信度高):家长能云端拒绝、删除好友,说明好友关系记录在云端账号体系,手表本地只是缓存;
- 家长管控通知通路(置信度高):这也是标准明文要求——4.18.1a 规定"受手表管理端管理",家长不在孩子身边,管控指令只能云端中转;
- 身份合法性校验(置信度中):附录 B 交换的是 E.164 号码,本地 SIM 无号时流程直接失败(官方"提示号码为空"的排查项侧面印证)。
至于"为什么 WiFi 不行"的具体机制(云端长连接绑定蜂窝身份 / 手表 WiFi 阉割 / 流程硬校验),目前都只是推断,要抓手表↔云端的蜂窝流量或逆向固件才能实锤。这里我给的都是"最可能",不给"一定"。
行业坐标:国标出台前,跨品牌社交怎么活?
没人喜欢被一个国标从头上套下来,但加好友这个需求一直在。国标之前,市场上有三种自发方案:
- 腾讯系儿童 App(360、荣耀、REDMI 的路子):手表 QQ 碰一碰互加,跨品牌靠腾讯账号体系,但依赖网络和腾讯生态;
- 电话号码通讯录(小天才的路子):管理员从 App 把任意品牌号码存进通讯录,互通靠电话+短信;
- 完全封闭(部分品牌):只能和自家玩。
GB 46859 的策略很聪明:不是取缔这些,而是强制加一条不依赖任何第三方生态的设备直连通道(蓝牙 GATT 交换号码)。结果就是——任何两块国标合规的表,哪怕都没装微信、都没插流量卡,也能面对面完成基础互加。
现在的生态信号:小天才 Z12 从 1.1.0 起支持"蓝牙添加联系人",机制与国标 4.18 高度同源;华为跨品牌文档里的互联互通认证名单(小天才 Z12 / 小米 / 360 12X / 荣耀 WhizKid / 小寻 M7 等)就是这套服务在产业侧的实际落地。抓包时间在 2026,功能上线早于 2027 强制实施,说明头部厂商选了提前合规——商战归商战,该接的底线谁也没含糊。
给嵌入式同行的实现清单
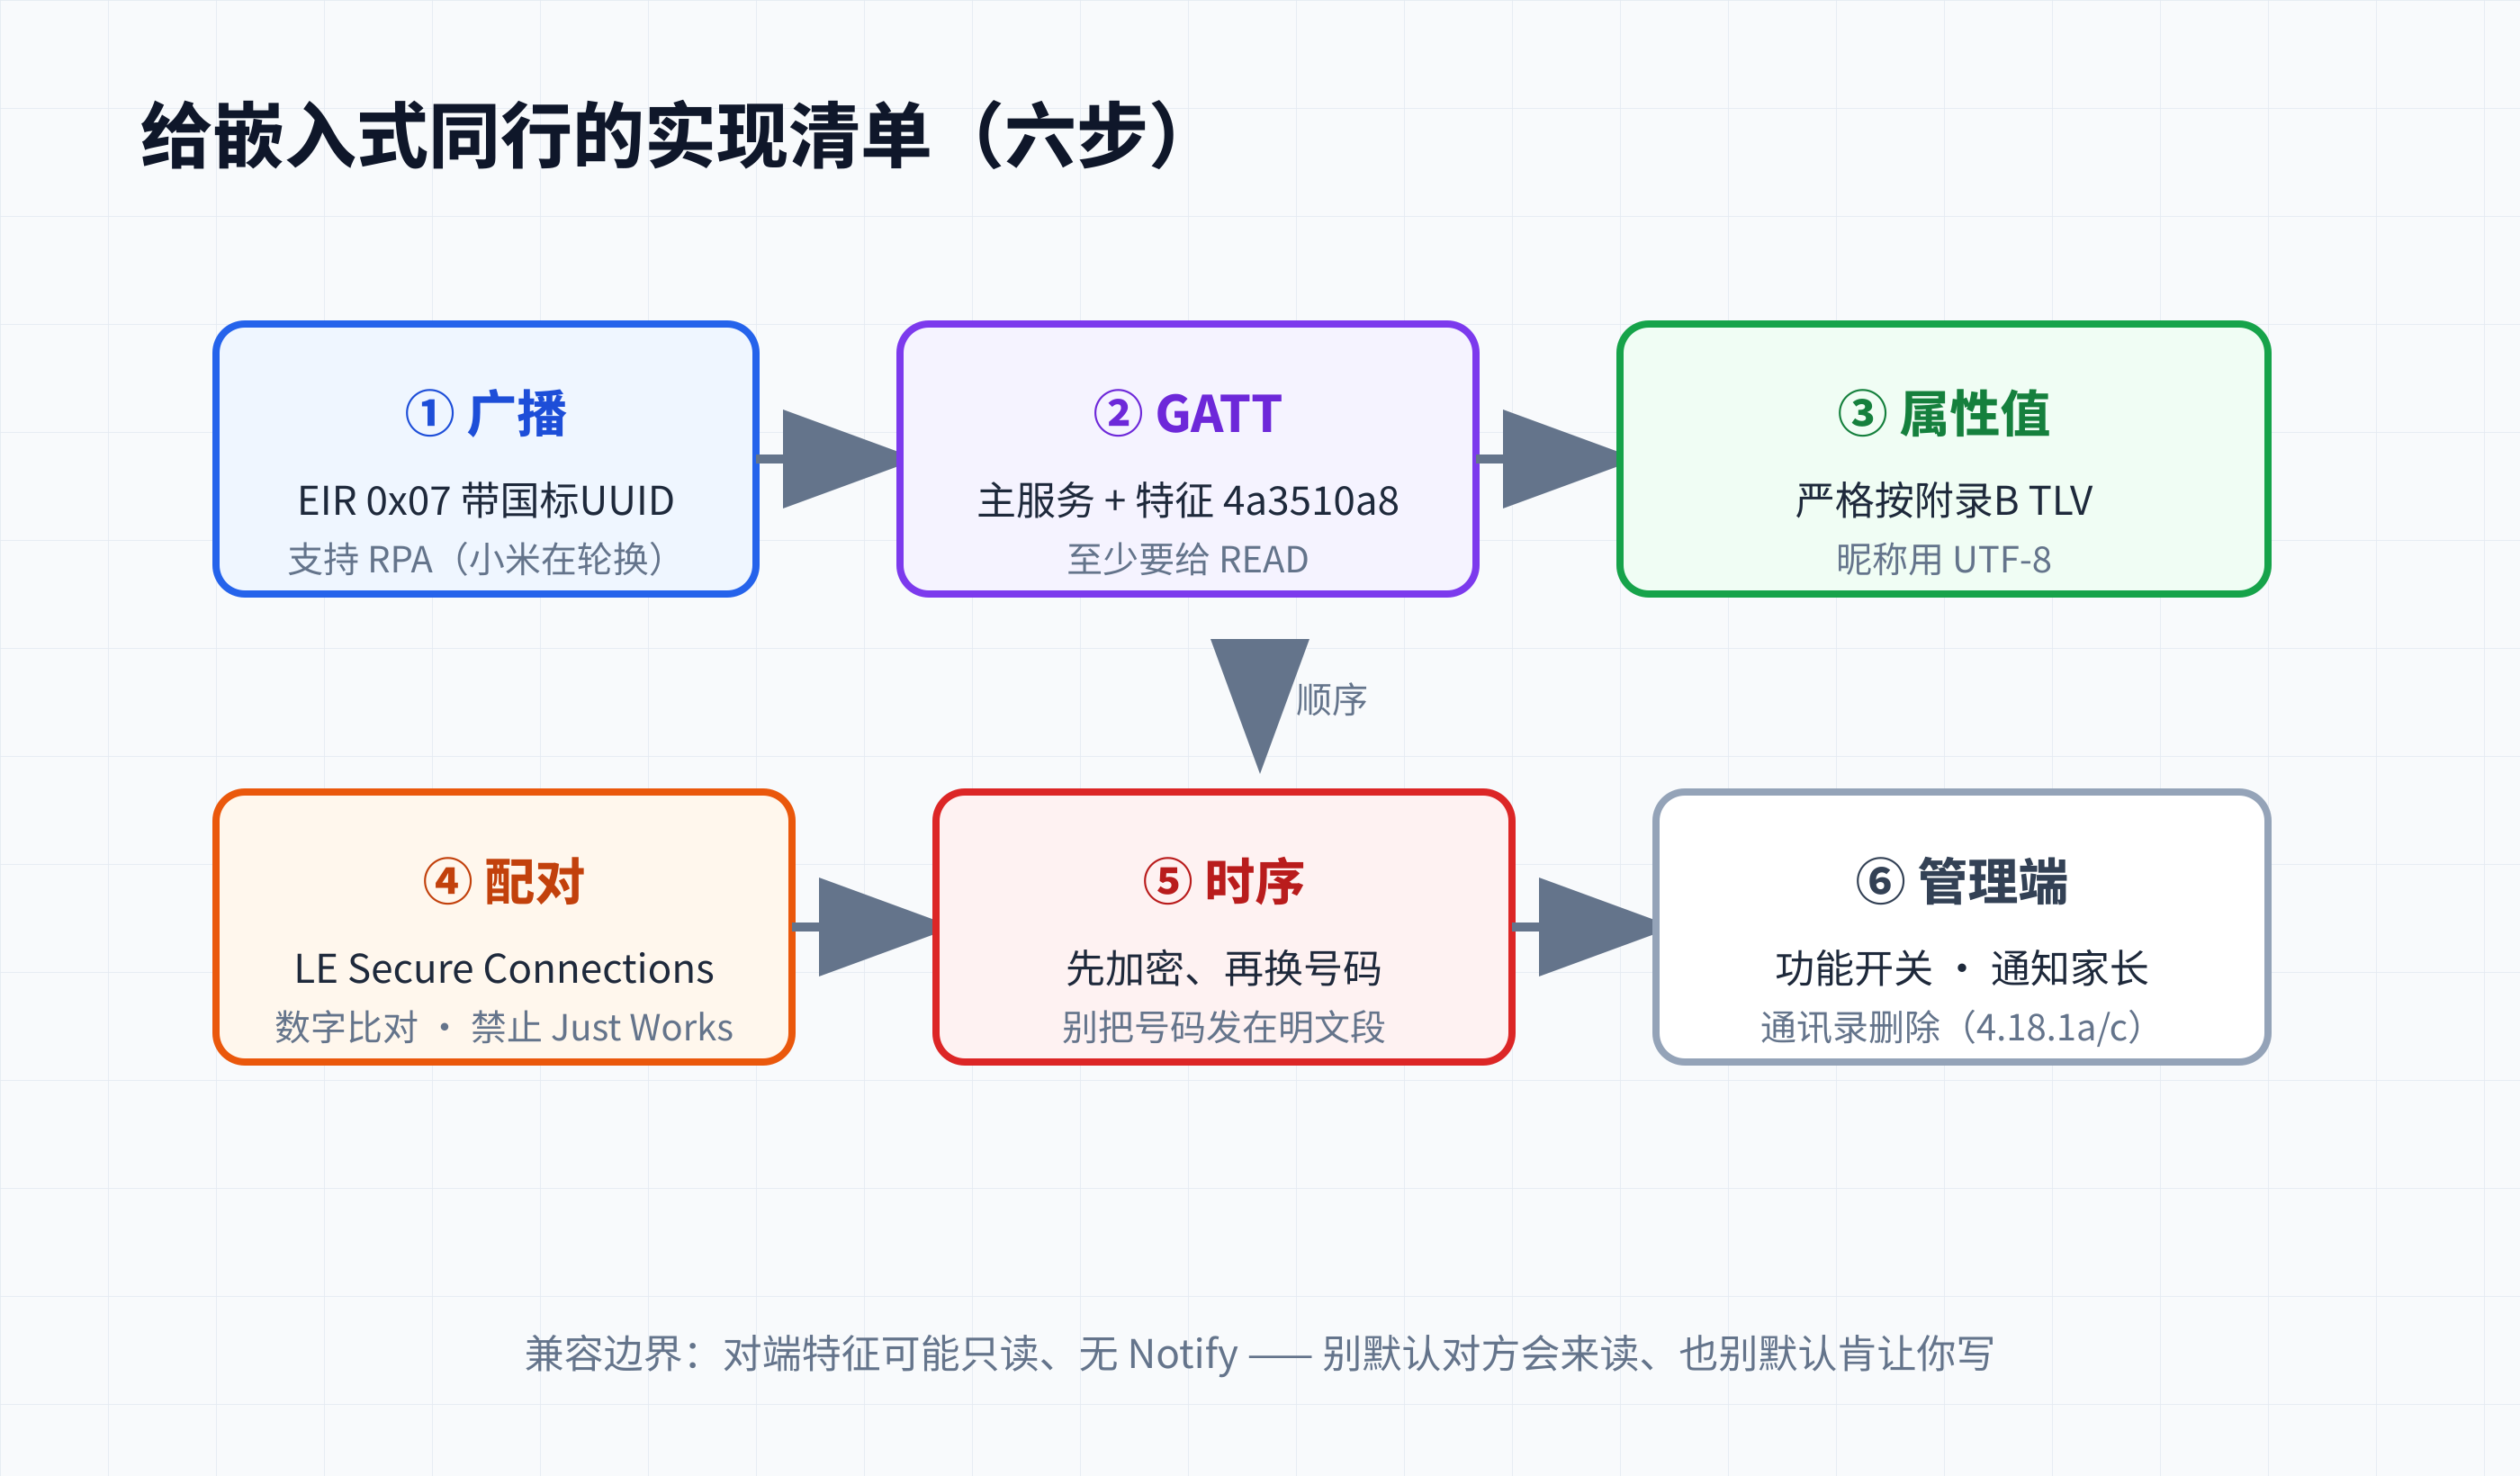
如果你现在要在自家手表上把这套国标功能做出来,这份从抓包逆向出的清单可以直接抄:
- 广播:EIR 0x07 携带
6d293d29-...,记得支持 RPA(抓包证实小米在轮换); - GATT:主服务 + 特征
4a3510a8-...,properties 至少要有 READ;想走 Notify 推送当面交换,得加 CCCD,并处理好"华为实测从机特征只读、无 Notify"这个兼容边界——别默认对方一定会来读,也别默认对方肯让你写; - 属性值:严格按附录 B TLV,昵称用 UTF-8;
- 配对:LE Secure Connections + Numeric Comparison,禁止 Just Works(防中间人全靠它);
- 时序:先完成加密、再交换号码——实测小米/华为就是这个顺序,别把号码发在明文段;
- 管理端:功能开关、加好友通知家长、通讯录删除,一个不能少(4.18.1a/c 是硬要求)。
收尾:20 字节,和一颗敬重事实的心
回头想想这件"小事"其实挺震撼:一个影响全行业、牵扯 14 岁以下儿童个人信息安全的标准功能,它的递物层就 20 个字节——一个长度字节、一个 E.164 号码、一个长度字节、一个昵称。而它背后,是要被强制执行的数字比对、链路加密、家长管控三条安全底线。
至于"另一向到底怎么走",我保留推测,也明确告诉读者它哪里没被证实。这趟抓包分析最大的收获不是解出了某个手表的私有实现,而是学会了对证据链诚实——抓到什么说什么,没抓到的,明明白白标成"还没抓到"。
你要是也在做嵌入式或 BLE,欢迎聊聊:你遇到过哪些"因为可以看出细节、实则串了同一套标准"的互通坑?觉得有用的话点个在看,让更多做硬件协议的工程师看到这份实拍。
本文基于作者独立采集与分析的 BLE 空口抓包数据写成;文中对标准条文的理解参考 GB 46859-2025;对无法直接查证方向的部分已如实标注为推测,欢迎批评指正。


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


