智谱GLM-5.1实测

电子取证之服务器取证思路 服务器取证是一个技术性很强的领域,涉及到多个环节,包括网站重构、网站代码分析、容器分析等。数据库密码的获取通常通过查看配置文件、日志文件、备份等途径,同时可以通过一些绕过技术如禁用身份验证来获取权限。对于不同的数据库,需要根据其特性采取相应的应对方法和命令。 阅读详情

智谱在GLM-5发布不到两个月后,迅速推出了迭代版本GLM-5.1。官方将其定位为"面向长程任务的开源第一模型",核心升级方向集中在代码工程能力和长程Agent任务上——GLM-5.1能够在单次任务中独立、持续工作超过8小时,在SWE-Bench Pro等代码基准上取得了全球模型第三、开源模型第一的成绩。我们对其API版本GLM-5.1进行了全面评测,测试其在准确率、响应时间、token消耗和花费等关键指标上的表现。

需要说明的是,本次评测侧重中文场景下的综合能力考察。GLM-5.1此次迭代的核心发力点——8小时级长程代码工程、SWE-Bench Pro实战修Bug、从零构建完整代码仓库等能力,在当前评测框架中并未得到充分体现。对这些能力感兴趣的读者,可参考文末的官方评测数据获得更全面的了解。

GLM-5.1版本表现:

  • 测试题数:约1.5万
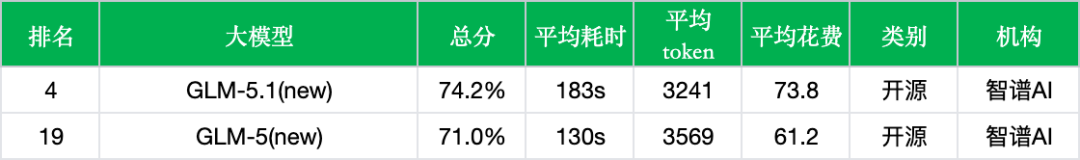
  • 总分(准确率):74.2%
  • 平均耗时(每次调用):183s
  • 平均token(每次调用消耗的token):3241
  • 平均花费(每千次调用的人民币花费):73.8

1、新旧对决

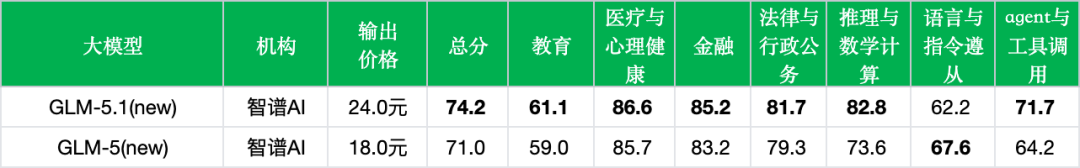
对比上一代版本(GLM-5),GLM-5.1在多个维度上实现了能力提升,但也伴随着响应时间和成本的上涨,数据如下:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark

*输出价格单位: 元/百万token

  • 整体性能提升:新版本准确率从71.0%提升至74.2%,提升了3.2个百分点,排名从第19位升至第4位,进入榜单头部。
  • 推理与数学计算提升幅度最大:从73.6%提升至82.8%(+9.2%),这一维度的进步最为突出,与GLM-5.1主打的深度推理方向高度一致。
  • Agent与工具调用显著增强:从64.2%提升至71.7%(+7.5%),与官方强调的长程Agent任务能力形成呼应。
  • 法律与行政公务稳步提升:从79.3%提升至81.7%(+2.4%),属于小幅改善。
  • 教育领域略有提升:从59.0%提升至61.1%(+2.1%)。
  • 金融与医疗保持稳健:金融从83.2%提升至85.2%(+2.0%),医疗与心理健康从85.7%提升至86.6%(+0.9%),均保持了较高水准。
  • 语言与指令遵从出现回调:值得注意的是,该维度从67.6%下降至62.2%(-5.4%),是唯一出现下降的领域。这可能与模型在强化推理链路时,在指令格式遵从上产生了一定的权衡取舍有关。
  • 响应时间明显延长:平均耗时从130s增加至183s,增幅约41%。
  • Token消耗与成本分析:平均Token消耗从3569降至3241,减少了约9.2%,但输出价格从18.0元/M token上调至24.0元/M token(+33.3%),导致每千次调用的费用从61.2元增加至73.8元,成本上涨约20.6%。

2、横向对比

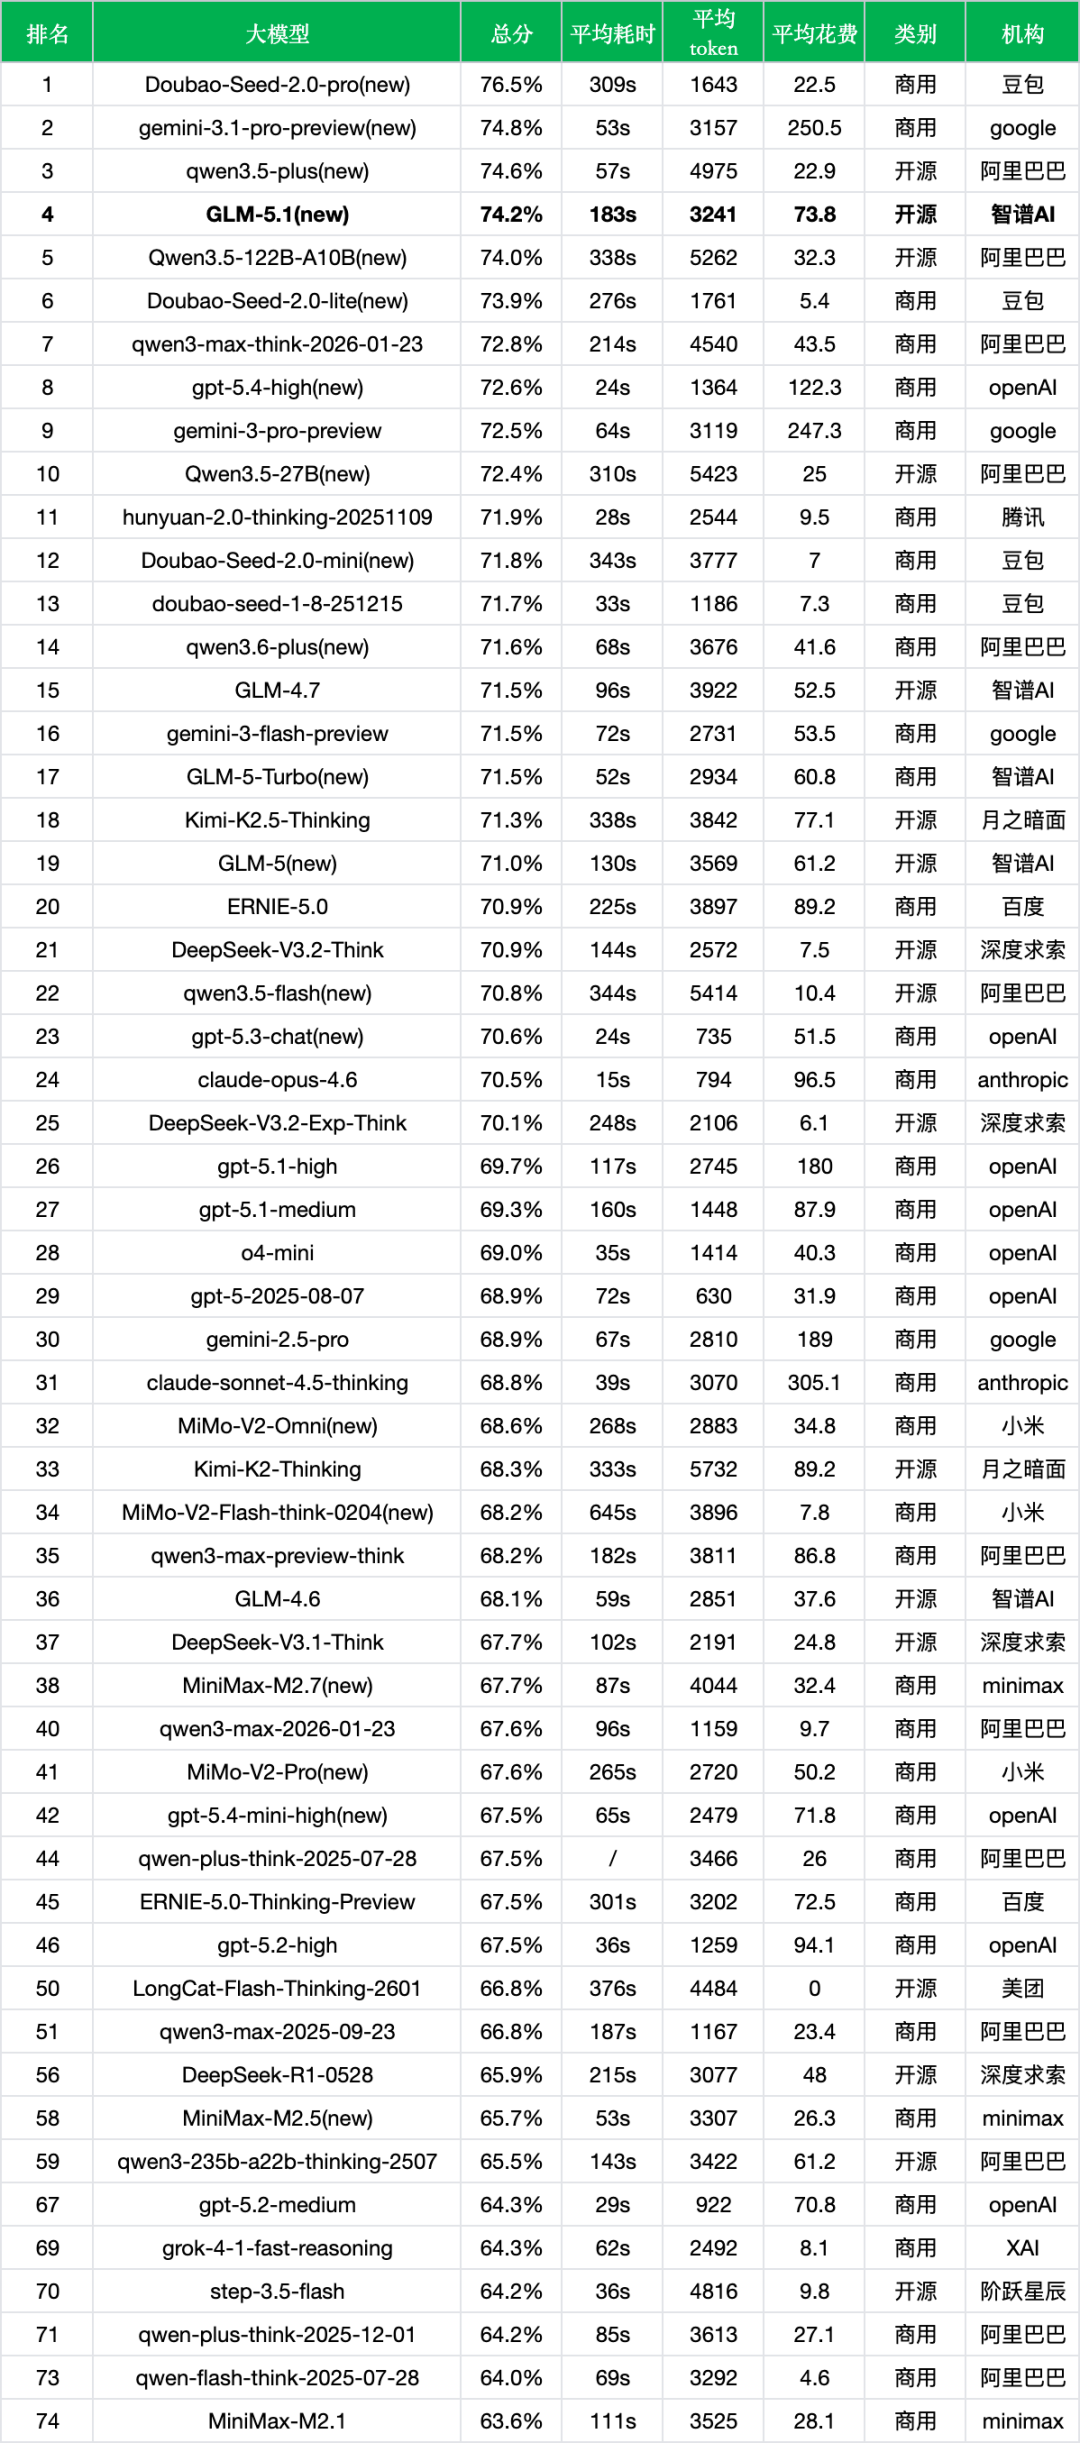
在当前主流大模型竞争格局中,GLM-5.1作为智谱最新开源旗舰模型表现如何?我们从三个维度进行横向对比分析:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark

同成本档位对比

  • 中高成本区间的竞争力:在花费60至80元/千次的区间内,GLM-5.1以74.2%的准确率和73.8元的花费,位列该档位的领先位置。同档位的Kimi-K2.5-Thinking(71.3%,77.1元)在准确率上低了2.9个百分点,且花费略高。GLM-5(71.0%,61.2元)作为上一代版本,虽然花费更低,但准确率存在3.2个百分点的差距。
  • 向上看——更高成本档位:gpt-5.1-high(69.7%,180元)和claude-opus-4.6(70.5%,96.5元)虽然花费更高,但在当前中文场景下的准确率反而不及GLM-5.1,这在一定程度上体现了GLM-5.1在中文综合能力测试中的竞争力。
  • 向下看——更低成本档位:值得关注的是,GLM-4.7(71.5%,52.5元)以更低的花费提供了与GLM-5.1相差不大的准确率。而Doubao-Seed-2.0-pro(76.5%,22.5元)和qwen3.5-plus(74.6%,22.9元)则在远低于GLM-5.1的成本水平上实现了相近甚至更高的准确率,成本效率比优势明显。

新旧模型对比

  • 智谱产品线梯队清晰:GLM-5.1(74.2%,第4位)领衔,GLM-5-Turbo(71.5%,第17位)和GLM-5(71.0%,第19位)紧随其后,GLM-4.7(71.5%,第15位)作为上一代产品仍保持竞争力,GLM-4.6(68.1%,第36位)则定位于入门级。从GLM-5到GLM-5.1,3.2个百分点的提升和15个名次的跃升,此次迭代在中文综合能力上取得了实质性的进步。
  • 对比其他厂商的新模型:GLM-5.1(74.2%)超过了ERNIE-5.0(70.9%)、DeepSeek-V3.2-Think(70.9%)等厂商近期发布的新模型,但与榜首的Doubao-Seed-2.0-pro(76.5%)仍有2.3个百分点的差距,与qwen3.5-plus(74.6%)基本处于同一水平线。
  • 榜单头部格局:当前榜单前四位分别为Doubao-Seed-2.0-pro(76.5%)、gemini-3.1-pro-preview(74.8%)、qwen3.5-plus(74.6%)和GLM-5.1(74.2%),头部竞争极为激烈,四者之间的差距仅为2.3个百分点。

开源VS闭源对比

  • 开源阵营的新标杆:GLM-5.1以74.2%的总分位列开源模型第二,仅次于qwen3.5-plus(74.6%)。两者差距仅0.4个百分点,共同构成了开源阵营的第一梯队。
  • 对闭源模型的施压:从总分来看,GLM-5.1已经超过了多个闭源商用模型,包括gemini-3-pro-preview(72.5%)、gpt-5.4-high(72.6%)、claude-opus-4.6(70.5%)、gpt-5.1-high(69.7%)等。开源模型在中文综合能力上对闭源模型的追赶态势已十分明显。

3、官方评测

GLM-5.1此次迭代的核心升级集中在代码工程能力和长程Agent任务两个方向,以下为官方公布的Benchmark数据。

编码能力

官方选取了业内最具代表性的三个代码评测基准进行综合评估,GLM-5.1取得全球模型第三、国产模型第一、开源模型第一的成绩。
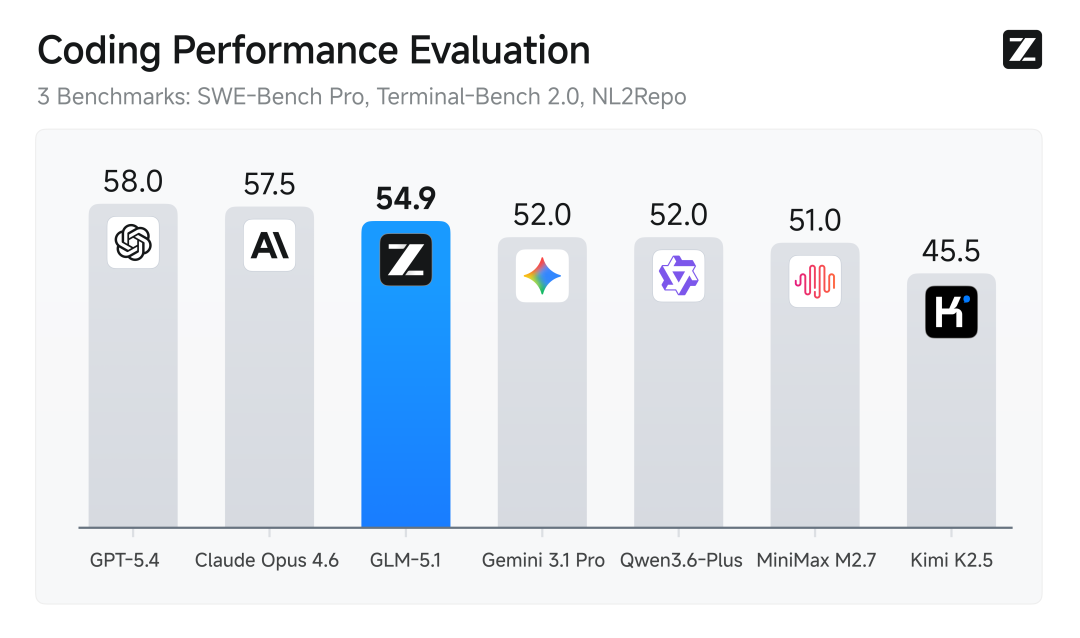
具体来看:

  • SWE-Bench Pro:衡量模型在真实GitHub仓库中定位并修复高难度工程Bug的能力。GLM-5.1得分58.4,全球最高,超过GPT-5.4(57.7)和Claude Opus 4.6(57.3)。
  • NL2Repo:要求模型根据自然语言描述从零构建完整代码仓库,测试系统级工程能力。GLM-5.1得分42.7,对比GLM-5的35.9,提升19%。与Claude Opus 4.6(49.8)仍有7分差距。
  • Terminal-Bench 2.0:让模型在真实终端环境中解决系统管理、运维和开发任务。GLM-5.1得分63.5,对比GLM-5的56.2。
  • CyberGym:网络安全编码基准,要求完成渗透测试、漏洞分析等安全工程任务。GLM-5.1得分68.7,对比GLM-5的48.3,提升42%,是进步最大的单项。

智能体能力
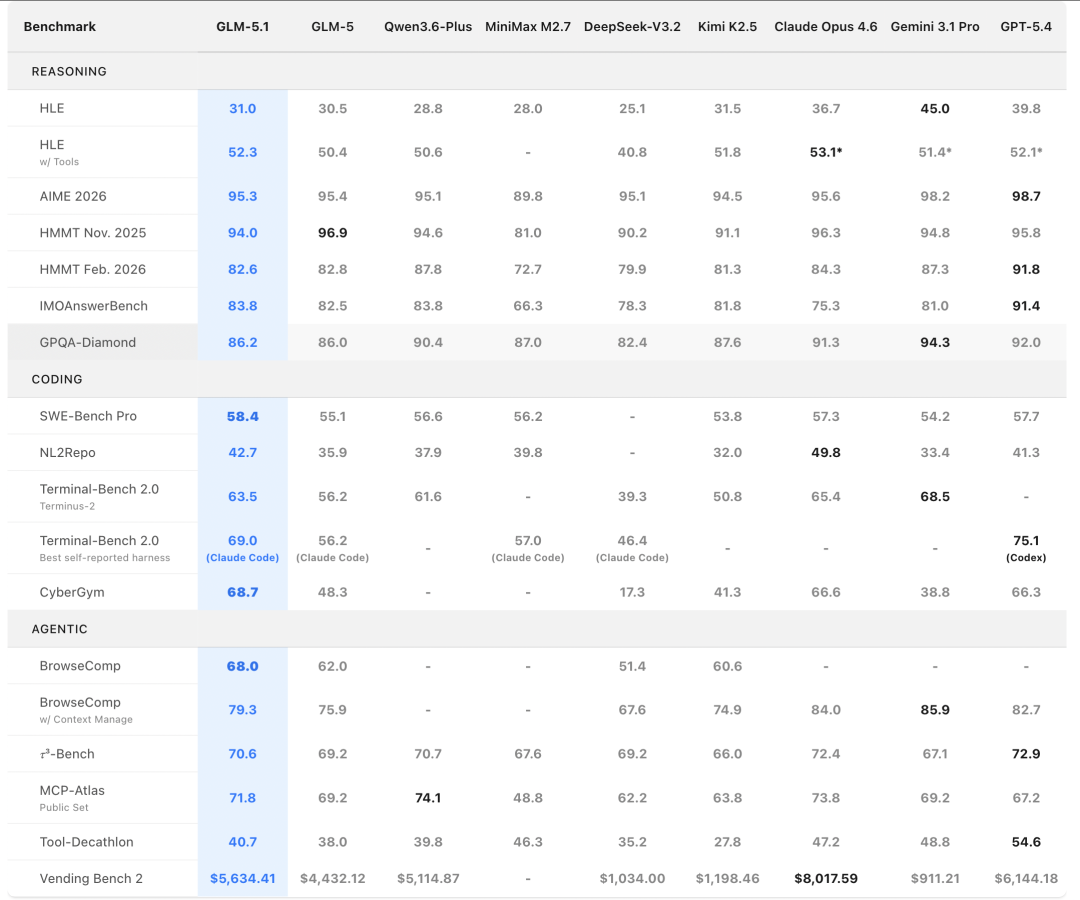
  • BrowseComp:测试模型通过自主浏览网页解决复杂信息检索问题的能力。GLM-5.1带上下文管理得分79.3。
  • τ³-Bench:在模拟客服场景中测试对话式Agent的双向控制能力。GLM-5.1得分70.6。
  • MCP-Atlas:衡量模型在多步骤工作流中调用外部工具(MCP服务器)的能力。GLM-5.1得分71.8。
  • Vending Bench 2:让模型经营一年的模拟自动售货机生意,测试长期规划和资源管理。GLM-5.1最终账户余额$5634.41,对比GLM-5的$4432.12。与Claude Opus 4.6($8017.59)仍有明显差距。

长程任务能力
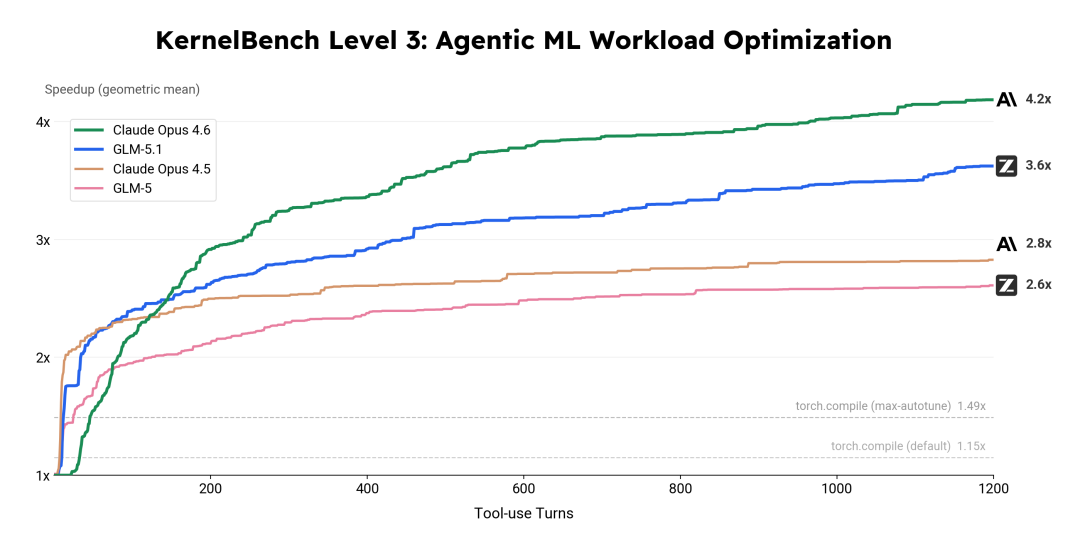
GLM-5.1的核心差异化在于长程任务的执行能力。在METR榜单的同等评估标准下,GLM-5.1是唯一达到8小时级持续工作的开源模型。官方展示了三个典型场景:8小时从零构建Linux桌面系统、655次迭代优化向量数据库(查询吞吐从3108 QPS提升至21472 QPS)、1000轮工具调用优化50个真实机器学习模型负载(达到3.6倍加速比)。

目前所有大模型评测文章在公众号:大模型评测及优化NoneLinear

BLDC&PMSM电机控制器硬件设计工程(八)72V 10kW电机控制器原理图工程及库文件 电机控制器基本需求:接口类型;MCU平台;通信接口;供电;信号采集;信号输出;功率;EMC或者认证需求。 阅读详情

相关推荐

Win11注册表没有MMC的解决方法

本文详细介绍了在Win11系统中解决注册表没有MMC项的问题的方法。通过创建并导入注册表修复文件,我们可以成功地在注册表中添加缺失的MMC项。在操作过程中,需要注意备份注册表、以管理员身份运行工具以及系统更新等事项。希望本文能够帮助到遇到类似问题的用户,提高系统管理的效率和便捷性。如果你还有其他关于Windows操作系统的问题或疑问,欢迎随时提问并寻求帮助。

nntxthml的博客 1545

智谱GLM5.1重磅上线!深度测评+全维度解析,对比GLM5到底进化了什么?

智谱GLM5.1深度解析:国产大模型的编程与智能体突破 智谱AI最新发布的GLM5.1在短短一个月内完成了对GLM5的重大升级,成为国产大模型的标杆之作。该模型在编程能力上提升30%,逼近Claude Opus 4.6水平,支持200K长上下文和128K输出,优化了稀疏注意力机制和异步强化学习框架,显著提升推理效率和任务稳定性。实测显示,GLM5.1能自主完成复杂编程任务和长文本处理,智能体执行能力实现质的飞跃。其核心优势在于顶尖的编程与智能体能力、低成本部署、合规性及开源生态,适合开发者、企业和学术用户。

weixin_69359007的博客 1万+

保姆级教程:用Docker Compose在Linux上一键部署Milvus 2.5.8(附配置文件详解)

本文提供了一份详细的Milvus 2.5.8安装指南,通过Docker Compose在Linux系统上一键部署这款高性能向量数据库。教程涵盖环境准备、配置文件解析、服务启动验证及常见问题解决,帮助开发者快速搭建AI应用所需的基础设施。

weixin_28829629的博客 265

智谱 GLM-5.1 正式开源并上线 AtomGit AI!

全球开发者可直接克隆、下载、二次开发、部署落地,开启长程自治 AI 工程时代。作为迄今最智能的旗舰模型、全球最强开源大模型,GLM-5.1 彻底打破分钟级交互限制,

白天写代码,晚上追AI大模型,偶尔搞点八卦 开源动态|技术干货|实习机会|生态活动 我负责分享,你负责变强 2691

关于石墨烯费米能级和偏置电压之间的关系问题

石墨烯费米能级与电压的关系问题

qq_37946542的博客 3509

踩坑记录:Clawdbot 对接 Minimax 报错 “401 token is unusable (1004)“ 的终极解决方案

如果你也在配置 Clawdbot 对接 Minimax 模型时,明明 API Key 是新申请的,却死活报错 `401 Unauthorized`,错误码 `1004`,提示 `token is unusable`——那么恭喜你,来对地方了。

hampeter的博客 1989

太强了!GLM-5.1 第一手实测,平替Claude Opus 4.6?

AI Coding正在经历一条非常清晰的能力跃迁路径。最早的AI coding,本质上是程序员的效率工具。模型学会写代码、调用工具,但它主要还是一个辅助者,服务对象是专业开发者,作用方式是局部提效。而之后的,Coding从专业行为变成一种更大众的表达方式。人们不需要理解每一行代码,但可以借助更好的,把想法快速变成产品原型。在这个阶段,,拥有好的idea的值开始凸显。

测试开发技术 3907

NotImplementedError: Cannot copy out of meta tensor; no data! Please use torch.nn.Module.to_empty()

Please use torch.nn.Module.to_empty() instead of torch.nn.Module.to()输出(llama) (base) [root@localhost home]# nvidia-smi Unable to determine the device handle for GPU0000:09:00.0: Unknown Error。这是典型的“孤儿进程”,但它还是。(僵尸进程),占用 GPU 资源。如果进程仍然不消失,并且。,这意味着它的父进程是。

m0_61636632的博客 2084

免费使用 GLM-5.1 模型并配置在 Claude Code 进行实战的完整指南

结合 Ollama 的便捷性和 Claude Code 的强大功能,你现在拥有了一个。让我们通过一个完整的实战案例,展示 GLM-5.1 在 Claude Code 中的强大能力。GLM-5.1 模型页: https://ollama.com/library/glm-5.1。Ollama 文档: https://docs.ollama.com。Z.AI 博客: https://z.ai/blog/glm-5.1。是 Z.AI(智谱AI)推出的下一代旗舰级大语言模型,专门为。

Honmaple的博客 2517

手把手教你用LTspice仿真扬声器阻抗曲线(附Dayton/Focal型号库)

本文详细介绍了如何使用LTspice仿真软件构建高精度扬声器模型,包括获取Dayton/Focal等厂商的SPICE模型库、模型导入方法、阻抗测试电路搭建及仿真设置。通过手把手教学,帮助读者快速掌握扬声器阻抗曲线的仿真技术,提升音响系统设计效率。

weixin_26897585的博客 380

主成分分析(Principal Component Analysis,PCA)

主成分分析1.主成分分析1.1 降维(Dimensionality Reduction)1.2 均值(Mean)1.3 方差(Variance)1.4 协方差(Covariance)1.5 协方差矩阵(Covariance Matrix)1.6 线性变换(Linear Transformation)1.7 主成分分析(PCA)1.8 PCA和SVD的关系 1.主成分分析 关于PCA的介绍:用最直观的方式告诉你:什么是主成分分析PCA 笔记来源:Principal Component Analysis (PC

一个搬运知识的笨小孩 3221

GLM-5.1 炸裂上线!编程能力 94.6% 逼近 Claude Opus 4.6,价格只要 1/3(深度评测)

智谱AI发布GLM-5.1模型,在Claude Code测试框架下获得45.3分,接近Claude Opus 4.6的47.9分,性能达94.6%但价格仅为1/3。该模型采用744B参数MoE架构,支持200K上下文,在编程、安全编码等任务表现出色。GLM-5.1仅用1个多月就实现28%性能提升,兼容主流开发工具,提供高性价比的订阅方案,适合日常编程场景。

tigerhhzz的博客 2190

【图像超分】论文复现:CVPR 2024 | 轻量化超分 | 窗口注意力改进 | CAMixerSR的Pytorch源码复现,跑通源码,获得指标和超分结果,计算复杂度,架构梳理拆解,逐行注释!

本文介绍了超分辨率重建方法CAMixerSR的代码实现与运行指南。文章亮点包括:完整跑通源码获取PSNR/SSIM指标和可视化结果;详细解析模型架构与关键代码注释,帮助快速复现基线模型。实验部分提供了测试配置文件和训练设置说明,支持2K/4K/8K大图像超分和x2/x4轻量化超分。环境依赖PyTorch和BasicSR框架,数据集包含DIV2K等常用基准。测试结果与论文指标一致,可视化输出保存至指定目录。训练配置可自定义数据集路径、GPU数量等参数。该实现突出了CAMixerSR在降低W-MSA复杂度方面的

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 423

智谱突发更新,GLM-5.1直接上线,实测 1 个小时从零搭了一个内容付费系统

但到了十几步左右,问题开始出现:数据库表结构在后端实际写的和前面设计阶段定义的对不上,字段名变了,类型也变了,需要我手动纠正。它先是按照我的猜测去检查问题去了,但是,它发现数据库设计的时候字段并没有限制,它就开始自查了,查了路由跳转的时候是不是截断了,发现也不是,最后它发现是文章付费解锁的逻辑导致的。当然了,当我深度体验之后,也并不是没有任何 Bug ,其中还是有一个 Bug 的,就是发布文章的时候,可以选择锁定和不锁定,我发现当我选择不锁定,发布了一个长文之后,点击文章详情页,文章只显示了一半。

非著名程序员 1372

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

智谱 GLM-5.1 开源实测:编程能力登顶 SWE-bench Pro

需求:当用户输入灵感选题时,全网搜索并调研抖音、小红书上相关讨论的热度、热门角度、常见观点、读者最关心的问题,以及同类内容是否已经同质化,结合热度、竞争情况、内容差异化空间和传播潜力,对该选题值不值得写给出明确判断(评分0-100)。要求支持新增、编辑、删除 API 配置,保存 Base URL、API Key、模型名、请求头等信息;但 GLM-5.1 的长文本记忆和目标感极其稳定,经过一个半小时的极限抗压,完美展现了它从多步任务规划到、复杂联网检索、逻辑综合、代码编写、本地文件I/O 的全链路能力。

weixin_49199926的博客 654

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

实测GLM-5.2-智谱新旗舰1M上下文加MIT开源这套组合拳

GLM-5.2 值不值得上车?如果你是 Coding Plan 用户,今晚就切到 max 模式试试​——编码和长时程任务的体感提升是实打实的。​如果你在意私有部署和成本,等下周权重开源​,自己跑一遍再下结论。从"写代码"到"写工程",从"能用"到"开源能用",国产旗舰这一步迈得很扎实。至于那句"AI 属于人民"——当权重真的以 MIT 协议交到你手里的时候,它就不再是一句口号了。

gxy03的博客 500

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

智谱GLM-5.1工程交付实测:SWE-Bench Pro 8小时连续任务与TaoToken统一Key接入

GLM-5.1 开源大模型实测 8 小时连续工程交付,SWE-Bench Pro 58.4 分登顶。本文给出 auth.json 与 settings 可复制配置,用 TaoToken 统一 Key 接入,一套 Base URL 管住多模型,附 401、local proxy failed 等报错排查。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42360846的博客 174

智谱 GLM-5.1 开源,深度实测,跑分超 Claude Opus 4.6

GLM-5.1 首次在权威榜单 Artificial Analysis 上对齐 Opus 4.6,还在高难度的 SWE-bench Pro 基准测试里,刷新了全球最佳成绩,超越了行业标杆 Claude Opus 4.6!要知道,这个测试考的可是解决真实复杂工程的能力,含金量极高。同时 GLM-5.1 还包揽 Coding 综合榜单开源第一,国产第一!全球第三。

suzhan123456的博客 1234

智谱 GLM-5.1 开源上线 AtomGit AI:TaoToken 统一 Key 接入实测

GLM-5.1 开源上线 AtomGit AI 后,用 TaoToken 统一 Key 即可接入现有开发流程。本文给出可复制的配置片段,覆盖 Cline、Claude Code、Codex 等工具,并附 curl 与 Python 验证示例,一次配置稳定调用。官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35755562的博客 18

智谱GLM-5.1深度评测:8小时连续工作,开源大模型进入“工程交付“新纪元|TaoToken统一Key实测

用 TaoToken 统一 Key 接入 GLM-5.1,实测开源大模型长程工程交付能力。本文给出可复制的 Base URL、Key 配置与连续任务脚本,并验证耗时、成功率、Token 三项指标,附 401、local proxy failed、reading choices、OAuth 等常见报错排查。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42594427的博客 14

智谱 GLM-5.2 + ZCode 3.0 发布:1M 上下文实测与 TaoToken 统一 Key 接入

GLM-5.2 搭配 ZCode 3.0 发布,1M 上下文实测可用。本文用 OpenAI SDK 只改 model 字段,通过 TaoToken 统一 Key 接入 GLM-5.2,含 Base URL 配置、长文档验证与 401 报错排查。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42376614的博客 62

智谱GLM-5.2刚开源我就连夜实测了——1M上下文+MIT协议,这5个变化让我连夜换了模型方案

智谱GLM-5.2刚开源我就连夜实测了——1M上下文+MIT协议的国产开源模型,FrontierSWE仅差Claude Opus 4.8一个百分点,Code Arena全球可用模型第一。本文从架构解析到实测对比到私有化部署,完整还原这代模型的真实水平。

weixin_50937681的博客 1326

实测智谱 GLM-5.1 的 token 花费对不上?把 Base URL 改到 TaoToken 通道再对账

GLM-5.1 花费对不上时,先把脚本 base_url 切到 TaoToken 通道,用 usage_log.jsonl 落盘 token;再到 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 核对用量,按模型 ID/Key 对账 3241 token/73.8 元基线。

weixin_35414484的博客 37

智谱 GLM-5.1 开源实测:用 Claude Code 接入 TaoToken 跑 SWE-bench Pro 的配置与验证

在 Claude Code 的 settings.json 里把 Sonnet/Opus 指向 glm-5.1,即可通过 TaoToken 统一 Key 接入智谱 GLM-5.1 并跑 SWE-bench Pro 验证。本文给出可复制配置骨架、/status 校验方法与同题对比 Claude Opus 4.6 的实测流程,附常见报错排查。官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35750483的博客 11

智谱 GLM-5.1 新旗舰实测:开源 SOTA 级大模型,注册即领 2000 万 Tokens,开发者必冲!

近期大模型圈重磅更新!智谱大模型开放平台BigModel.cn正式上线新一代旗舰模型 GLM-5.1,凭借推理、代码、智能体三大核心能力的 SOTA 级表现,迅速成为开发者首选工具。通过我的专属邀请链接注册BigModel.cn,新用户可免费领取 2000 万 Tokens 大礼包,无需充值,直接解锁 GLM-5.1 旗舰模型体验,零成本测试 AI 应用、打磨项目方案。结合 2000 万 Tokens 专属福利,无论是个人开发者练手、大学生竞赛备赛,还是企业项目落地,都能大幅降低开发门槛、提升效率。

pblh123的专栏 1149

智谱GLM-5.1工程交付实测:用TaoToken统一Key跑通8小时连续任务链

用TaoToken统一Key接入GLM-5.1,通过auth.json三件套配置跑通8小时连续任务链。本文给出Claude Code、Cline、Codex可复制配置片段与endpoint,实测100步连续成功率约82%、中断恢复约90%,并附401、local proxy failed等常见报错排查路径。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42603332的博客 12
上一篇: 谷歌Gemma 4 MoE实测
下一篇: 大模型表格识别能力实测:Gemma 4排名倒数,开源之王也有软肋
easyllm
博客等级 码龄2年 252粉丝 82原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值