


构建面向终端的 AI 编程智能体:脚手架、运行时编排、上下文工程与经验教训
原文:arXiv:2603.05344v1
原文标题:Building AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned
摘要
AI 编程辅助的格局正在经历一场根本性转变:从复杂的 IDE 插件转向通用的、终端原生的智能体(agent)。直接在开发者管理源代码版本控制、执行构建和部署环境的终端中运行,基于 CLI 的智能体为长程开发任务提供了前所未有的自主性。本文介绍 OpenDev——一个专为这一新范式打造的开源命令行编程智能体。有效的自主辅助需要严格的安全控制和高效的上下文管理,以防止上下文膨胀和推理退化。OpenDev 通过以下手段克服这些挑战:复合 AI 系统(compound AI system)架构与工作负载特化的模型路由;将规划与执行分离的双智能体架构;惰性工具发现;以及渐进式削减旧观测信息的自适应上下文压缩。此外,它采用自动化记忆系统跨会话积累项目特定知识,并通过事件驱动的系统提醒来对抗指令衰减(instruction fade-out)。通过强制执行显式的推理阶段并优先保障上下文效率,OpenDev 为终端优先的 AI 辅助提供了一个安全、可扩展的基础,为稳健的自主软件工程提供了一份蓝图。
1. 引言
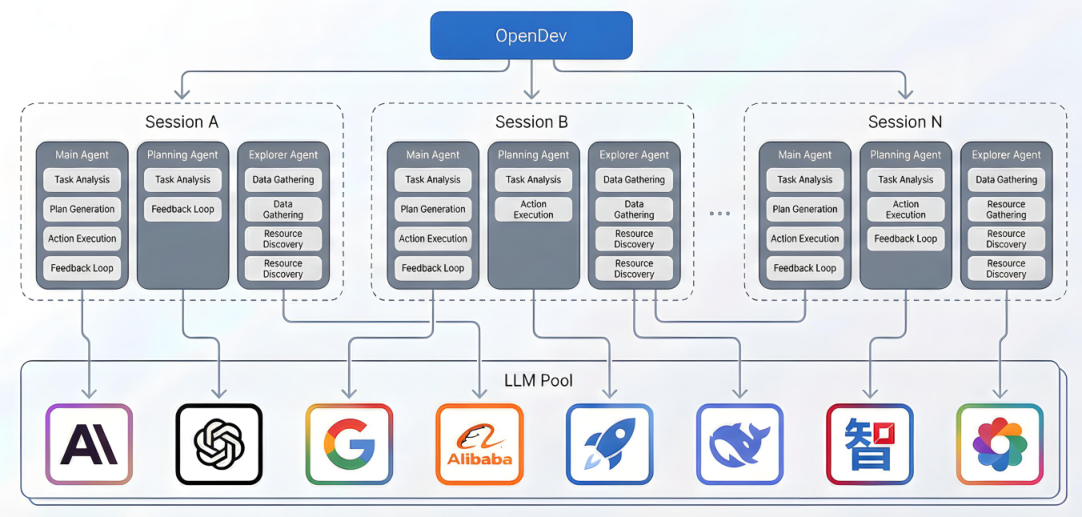
图 1:OpenDev 概览。 工作被组织为并发会话,每个会话由多个特化子智能体组成;每个智能体执行带类型的工作流(Execution、Thinking、Compaction),这些工作流独立绑定到用户配置的 LLM。这种四级层次结构(会话 → 智能体 → 工作流 → LLM)支持细粒度的模型选择,使成本、延迟和能力之间的权衡可以按工作流优化。
大语言模型(LLM)的迅猛发展催生了软件开发的新范式:以自主智能体形式运作的 AI 编程助手。与仅能建议内联代码片段的传统代码补全工具不同,智能体化编程助手能够对复杂任务进行推理、执行多步计划,并通过工具使用与开发环境交互。综合性综述记录了代码智能研究的爆炸式增长,智能体软件工程(Agentic Software Engineering)路线图也确立了规范人-AI 协作的方法论原则。SWE-Agent、OpenHands 和 HyperAgent 等系统已在标准化基准上展示了自主智能体的潜力。商业影响同样引人注目:GitHub Copilot 用户超过 1500 万开发者,AI 原生编辑器收入快速增长,各大实验室纷纷推出自主编程智能体——这些都表明智能体编程已从研究原型走向工业部署。
终端原生智能体的崛起
过去几年,AI 编程助手被紧密集成在 IDE 中,扮演需要人类持续监督的响应式副驾驶角色。最近,一场重大转变已经开始:从复杂的 IDE 插件转向更简洁的命令行界面。Claude Code 引领了这一转变,证明了终端原生智能体在真实软件工程任务中能够匹敌甚至超越 IDE 集成工具。终端是软件开发的运行中枢,原生支持版本控制、构建系统、远程 SSH 会话和无头服务器环境。Aider、CodeAct 和 Open Interpreter 等早期系统证明了基于终端的 AI 结对编程和可执行代码动作的可行性。如今,每个主要 AI 实验室都提供 CLI 智能体,同时也有 Goose、OpenCode 和 Crush 等开源替代品。然而,实现这一潜力并非易事。Terminal-Bench 和 LongCLI-Bench 等基准表明,即使是前沿模型也难以胜任持续的终端操作,这凸显了专门工程化解决方案的必要性。
这些基准结果指出了任何长时间运行的终端智能体都必须解决的三个基本工程挑战:在经常超出模型 token 预算的会话中管理有限的上下文窗口;在智能体可以执行任意 shell 命令时防止破坏性操作;以及在不压垮智能体提示预算的前提下扩展能力。我们围绕两个阶段组织架构应对:脚手架(scaffolding)——在第一个提示到来之前组装智能体(系统提示、工具模式、子智能体注册);运行时编排(harness)——在运行时协调工具分发、上下文管理和安全执行(见 2.2 节)。然而,终端原生智能体工具的设计空间在很大程度上仍未被探索:大多数生产系统是闭源的,架构决策未见诸文档;现有的开源框架要么面向基准测试而非交互式使用,要么缺乏公开的技术报告。三个关键的开放问题推动了本工作:多模型架构应如何在不同认知任务之间平衡成本、延迟与能力?什么样的安全机制能在不妨碍开发者生产力的前提下防止破坏性操作?系统又如何能在有限的上下文限制内维持长时间对话?
本文介绍 OpenDev——一个开源的 AI 驱动命令行软件工程智能体。据我们所知,这是第一份针对开源、终端原生、交互式编程智能体的综合性技术报告。现有系统分属两类之一:面向基准的框架(如 SWE-Agent)发表了研究论文,但主要为自动化评测而非日常交互使用而设计;OpenHands 兼具生产级质量和完善文档,但通过浏览器 UI 而非终端界面运作;CLI 原生智能体(如 Aider、Goose、OpenCode、Crush 和 Gemini CLI)缺乏记录其设计决策的公开技术报告;Claude Code 是 CLI 原生的,但既不开源,也没有公开的技术报告。本文的目的不是提出新颖的算法突破,而是分享在设计一个生产就绪的智能体编程系统过程中的设计决策、权衡与经验教训,以弥合闭源工业实践与开放学术讨论之间的鸿沟。
OpenDev 的一个核心设计原则是:它是一个复合 AI 系统——不是单一的单体 LLM,而是由智能体和工作流组成的结构化集合,每个工作流独立绑定到用户配置的 LLM(见 2.2.5 节)。这一由 Zaharia 等人阐述的观点认为,最先进的 AI 成果越来越多地由组合多个模型、检索器和工具的系统取得,而非依赖单次模型调用。OpenDev 将这一原则落地:其解耦架构使系统天然与模型无关,学习式模型路由等技术可以应用在工作流级别。更换提供商或优化成本只需修改配置,无需修改代码。因此,系统的能力在部署时并非固定,而是随着更好模型的出现可持续升级。
设计原则与贡献
OpenDev 的设计遵循三条总体原则。第一,关注点分离:每个架构决策(模型选择、上下文管理、安全执行、工具分发)都应可独立配置和替换,互不影响。第二,渐进式降级:系统应在资源耗尽时优雅运行,无论是 token 预算、迭代次数还是网络连接。第三,透明优于魔法:每个系统动作(工具调用、安全否决、上下文压缩、记忆更新)都应可被开发者观察并覆盖。这些原则体现为五项具体贡献:
-
通过复合架构实现按工作流的 LLM 可配置性。 不同的执行阶段对模型能力、延迟和成本有不同的要求。我们提出按工作流绑定 LLM 的架构:每个认知工作流通过用户配置独立选择模型(见 2.2.5 节),该设计受复合 AI 系统观点和模型路由研究启发。
-
扩展的 ReAct 执行流水线。 我们用显式的思考(thinking)阶段和可选的自我批判(self-critique)阶段扩展标准 ReAct 循环,将深思熟虑与行动分离(下文简称 ReAct 循环;见 2.2.6 节),并借鉴上下文工程研究的洞见,将分阶段的上下文压缩直接集成到推理循环中。
-
长程行为引导。 我们提出事件驱动的系统提醒:通过在决策点注入针对性引导(而非仅依赖初始系统提示),对抗长时间会话中的指令衰减(见 2.3.4 节)。一个条件化的提示组合流水线从独立的、按优先级排序的段落组装智能体指令,这些段落仅在上下文相关时才加载,在保留全面引导的同时降低提示开销(见 2.3.1 节)。
-
token 高效的可扩展性与纵深防御安全。 我们提出基于注册表的工具架构,通过 MCP 惰性发现外部工具(见 2.4.7 节);以及五层安全架构,在逐级降低的抽象层次上施加约束:提示级护栏、通过双智能体分离实现的模式级工具门控(见 2.2 节)、带持久权限的运行时审批系统、工具级校验,以及用户定义的生命周期钩子(见 2.1 节)。
-
上下文工程作为一等工程问题。 我们将上下文管理视为一等工程问题,提出自适应上下文压缩(见 2.3.6 节)、对抗注意力衰减的事件驱动系统提醒(见 2.3.4 节),以及积累项目特定知识的经验驱动记忆流水线。我们的压缩与记忆策略与近期上下文工程理论工作中提出的熵减(entropy-reduction)和最小充分性(minimal-sufficiency)原则相一致。
论文结构
本文其余部分遵循从构建到反思再到定位的路径。第 2 节详述构建了什么:横跨智能体推理、上下文工程、工具系统和持久化的四层系统架构。第 3 节审视学到了什么:迭代开发过程中浮现的五个跨领域设计张力及其可迁移的经验。第 4 节将这些决策置于更广阔的研究版图中,第 5 节指出未来方向。附录提供工具、提示、配置模式和实现常量的参考级目录。
2. 系统架构
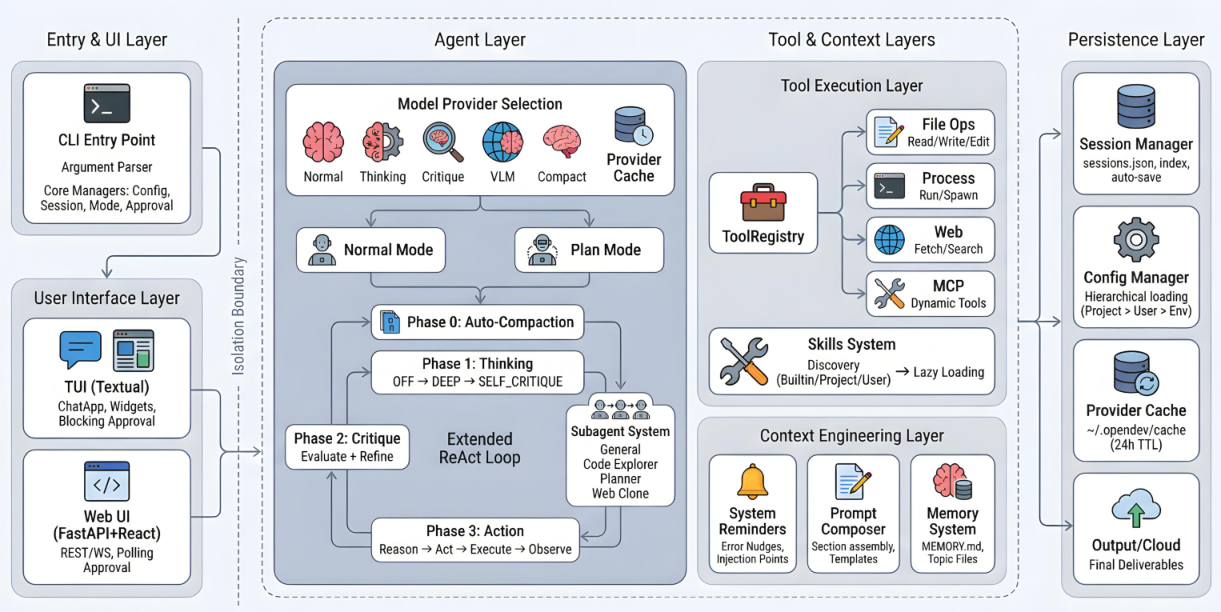
图 2:OpenDev 系统架构,组织为四层:入口与 UI 层、智能体层、工具与上下文层、持久化层。箭头指示主要数据流方向。
2.1 概览
图 2 展示了 OpenDev 的四个主要层次:入口与 UI、智能体、工具与上下文、持久化。用户查询顺序流经这条流水线:从入口点经过智能体推理和工具执行,最终结果在渲染前被持久化。
入口与 UI 层。 CLI 入口点解析参数并引导四个共享管理器(ConfigManager、SessionManager、ModeManager 和 ApprovalManager),它们被注入到所有下游组件中。OpenDev 支持两种前端:基于 Textual 构建、使用阻塞式模态审批的 TUI,以及基于 FastAPI 和 WebSocket、使用异步轮询审批的 Web UI。两者实现共享的 UICallback 契约,使智能体层与 UI 无关。
智能体层。 OpenDev 将五个特化模型角色分配给不同的 LLM(见 2.2.5 节),每个角色惰性初始化,并由本地缓存的能力注册表提供信息。系统以两种模式运行:**普通模式(Normal Mode)**拥有完整的读写工具访问权限用于执行;规划模式(Plan Mode)限制为只读工具以安全规划(见 2.2 节)。推理通过扩展 ReAct 循环(见 2.2.6 节)进行,每轮运行四个阶段:token 预算接近耗尽时的自动上下文压缩;可选的、深度可配置的行动前思考阶段;可选的自我批判阶段;以及标准的"推理-行动-执行-观察"动作阶段。
工具与上下文层。 工具执行层围绕 ToolRegistry 构建,它将调用分发到覆盖文件操作、进程执行和 Web 访问的类型化处理器,支持批量并行执行和按需 MCP 工具发现(见 2.4.7 节)。Skills 系统从三层层次结构(内置、项目、用户)中惰性注入可复用的领域特定提示模板。上下文工程层通过四个子系统管理 LLM 上下文窗口:用于上下文感知行为引导的系统提醒(见 2.3.4 节)、模块化系统提示组装的 Prompt Composer、跨会话连续性的记忆系统,以及回收 token 预算的压缩子系统(见 2.3.6 节)。
持久化层。 OpenDev 在四个存储中持久化状态:通过"项目本地、用户全局、环境变量、内置默认"层次结构解析设置的 Config Manager;将完整对话历史保存为 JSON 的 Session Manager;本地存储模型能力元数据的 Provider Cache;以及跟踪文件变更以支持回滚的操作日志。
安全架构。 由于智能体可以执行任意 shell 命令、覆写文件并派生持久进程,单一安全机制是不够的。OpenDev 因此采用纵深防御架构,包含五个相互独立的安全层(图 3),每层独立防止一类危害,从而不存在单点故障:
图 3:纵深防御安全架构。 五个独立层在逐级降低的抽象层次上拦截危险动作,从模型推理(第 1 层)到用户定义脚本(第 5 层)。每层独立运作;任一单层失效都不影响其余四层。
| 层级 | 内容 |
|---|---|
| 第 1 层:提示级护栏(2.3.1 节) | 安全策略、动作安全、先读后改、git 工作流、错误恢复 |
| 第 2 层:模式级工具限制(2.4.1 节) | 规划模式白名单、按子智能体的 allowed_tools、MCP 发现门控 |
| 第 3 层:运行时审批系统(2.4.1 节) | 手动/半自动/自动级别,模式/命令/前缀/危险规则,持久权限 |
| 第 4 层:工具级校验(2.4.2、2.4.3 节) | DANGEROUS_PATTERNS 阻止列表、陈旧读取检测、输出截断、超时 |
| 第 5 层:生命周期钩子(2.4.1 节) | 工具前阻塞(退出码 2)、参数改写、JSON stdin 协议 |
在建立四层概览之后,我们现在逐层详细考察,从实现推理循环、驱动所有智能体行为的智能体核心开始。
2.2 智能体核心层
智能体层位于 UI 层与工具执行层之间(图 2)。其中心是单一入口点 MainAgent,接收每个用户提示并决定如何处理。理解这一层需要两个视角:智能体在第一个提示到来之前如何组装(脚手架),以及组装好的智能体在运行时如何处理用户消息(harness)。在本文语境中,harness 是包裹核心推理循环的运行时编排层,围绕它协调工具执行、上下文管理、安全执行和会话持久化。脚手架关注第一个提示之前的智能体构造,而 harness 关注之后发生的一切:分发工具、压缩上下文、执行安全不变量、跨轮次持久化状态。以下小节按顺序呈现这两个阶段,然后逐一详述每个支撑组件。
2.2.1 智能体脚手架
在智能体能够处理用户提示之前,它必须被完整组装。OpenDev 中的每个智能体都在对话生命周期开始之前完成构造(系统提示编译、工具模式构建、子智能体注册)(见 2.2.3 节)。理解这条构造流水线,就能明白为什么运行时可以统一对待所有智能体,无论其角色如何。
类型基础:BaseAgent 与 AgentInterface。 所有智能体继承自 BaseAgent——一个抽象基类,接受三个构造参数(config、tool_registry、mode_manager)并定义四个抽象方法:build_system_prompt() 组装系统提示字符串;build_tool_schemas() 返回 OpenAI 格式的工具模式;call_llm() 执行单次 LLM 调用;run_sync() 运行完整的 ReAct 循环。关键设计选择是急切构造(eager construction):BaseAgent.__init__() 在构造函数返回前调用 build_system_prompt() 和 build_tool_schemas()。当 __init__() 完成时,智能体已完全就绪、可以服务请求——没有惰性提示组装,没有首次调用延迟。具体的 refresh_tools() 方法在工具注册表变化时(如 MCP 服务器发现或动态技能加载之后)重新调用两个构建方法。下游代码不直接依赖 BaseAgent,而是依赖 AgentInterface——一个 @runtime_checkable Protocol,要求相同的接口面(system_prompt、tool_schemas、refresh_tools、call_llm、run_sync),从而将工厂与具体智能体类解耦。
单一具体智能体类。 系统中不存在智能体类型的类层次结构。MainAgent 是 BaseAgent 唯一的具体子类,系统中的每个智能体(主智能体、所有内置子智能体、任何用户定义的自定义智能体)都是这个单一类的实例。行为差异完全来自构造参数:allowed_tools(过滤哪些工具模式出现在智能体模式中的列表,None 表示完全访问)、_subagent_system_prompt(构造后设置的覆盖提示),以及由 allowed_tools 是否非空推导出的 is_subagent 标志。在 __init__ 内,MainAgent 将四个 HTTP 客户端槽位设为 None 以惰性初始化——分别对应 normal、thinking、critique 和 VLM 提供商——将 API 密钥校验推迟到首次 LLM 调用。它创建 ToolSchemaBuilder(registry, allowed_tools) 用于模式生成,以及一个有界 Queue(maxsize=10) 用于来自 Web UI 的线程安全消息注入。惰性客户端槽位对应 2.2.5 节描述的模型角色:每个槽位在首次访问时实例化特定提供商的 HTTP 客户端,允许智能体在凭据配置完成之前构造。
工厂组装。 AgentFactory 是智能体构造的单一入口点。TUI 和 Web UI 都调用同一个 create_agents() 方法,确保无论前端如何都有相同的设置。工厂严格按顺序执行三个阶段:
- 阶段 1(Skills)。 工厂从三个目录发现技能定义(内置
swecli/skills/builtin/、用户全局~/.opendev/skills/、项目本地.opendev/skills/),创建 SkillLoader,并注册到工具注册表,使use_skill工具可用。 - 阶段 2(子智能体)。 工厂创建 SubAgentManager,调用
register_defaults()编译内置子智能体规格,然后调用_register_custom_agents()从配置文件加载用户定义的智能体。最后通过set_subagent_manager()将管理器注册到工具注册表,使spawn_subagent工具可用。 - 阶段 3(主智能体)。 工厂构造一个无工具过滤的 MainAgent(完全访问所有已注册工具,包括阶段 1 和 2 添加的工具)。
顺序约束至关重要:阶段 2 必须在阶段 3 之前完成,因为 spawn_subagent 工具描述是从已注册智能体集合动态构建的,必须出现在主智能体的模式中。工厂返回一个 AgentSuite 数据类,打包主智能体、SubAgentManager 和 SkillLoader。
子智能体编译。 每个子智能体始于一个 SubAgentSpec——一个 TypedDict,包含名称、描述、系统提示、可选工具白名单、可选模型覆盖和可选 Docker 配置。调用 SubAgentManager.register_subagent(spec) 时执行四步流水线:(1) 解析工具列表,未指定时默认使用硬编码的安全工具集;(2) 如提供模型覆盖则创建带覆盖的 AppConfig 副本;(3) 以解析后的列表设置 allowed_tools 构造 MainAgent,触发过滤后的系统提示与工具模式的急切构建;(4) 将 agent._subagent_system_prompt 设为规格的提示覆盖。结果存储为 CompiledSubAgent(名称、描述、智能体实例、工具列表)。构造开销很低,因为所有子智能体共享同一个工具注册表引用,没有克隆或深拷贝。运行时隔离来自两个机制:构建时的模式过滤(子智能体永远看不到白名单之外的工具)和执行时的 message_history=None(每次调用以全新上下文开始,详见 2.2.7 节)。
依赖注入。 智能体构造产生智能体;运行时执行需要服务。AgentDependencies 是一个 Pydantic 模型,携带工具在执行时需要的七个字段:mode_manager、approval_manager、undo_manager、session_manager、working_dir、console 和 config。REPL 或 Web UI 用所有管理器构造该对象并传给 agent.run_sync()。在 ReAct 循环内(2.2.6 节),各个管理器从依赖对象中解包,作为关键字参数传给 execute_tool(),保持工具注册表接口扁平——它不直接依赖 AgentDependencies 模型。子智能体接收轻量级的 SubAgentDeps 数据类,仅有三个字段:mode_manager、approval_manager 和 undo_manager。被省略的字段构成隔离边界:子智能体没有 session_manager(其消息不持久化)、没有 console(输出流经 ui_callback)、没有 config(每个子智能体携带自己构造时的配置)。
设计演进。 三次设计转向塑造了当前的脚手架架构。第一,早期的类层次结构(为规划智能体、代码探索智能体和 Web 生成智能体设置单独类)被单一参数化 MainAgent 取代。当子智能体需要混合能力时(例如既要生成 Web 又要规划),层次结构会产生菱形继承问题,参数化方法彻底消除了该问题。第二,惰性提示构建(在首次 run_sync 调用时构造系统提示)被急切构建模式取代。惰性方法引入了用户可见的首次调用延迟,并与 MCP 服务器发现产生竞态条件:首次调用后注册的工具要手动刷新才会出现在提示中。急切构建保证每个智能体在构造时即完整。第三,内联子智能体定义(在主智能体代码中硬编码智能体构造)被 SubAgentSpec 注册系统取代。这一重构使配置文件中定义的自定义智能体与内置智能体走同一条编译路径,统一了两条代码路径。
2.2.2 智能体运行时架构
脚手架完成后,组装好的智能体即可处理用户消息。运行时行为由智能体 harness 支配——这是 2.2 节介绍的编排基础设施,将无状态 LLM 转变为持久的、使用工具的、自我纠正的智能体。图 4 描绘了 harness 架构:中心是 ReAct 执行循环,周围是向它供给、约束它并持久化其工作的各子系统。
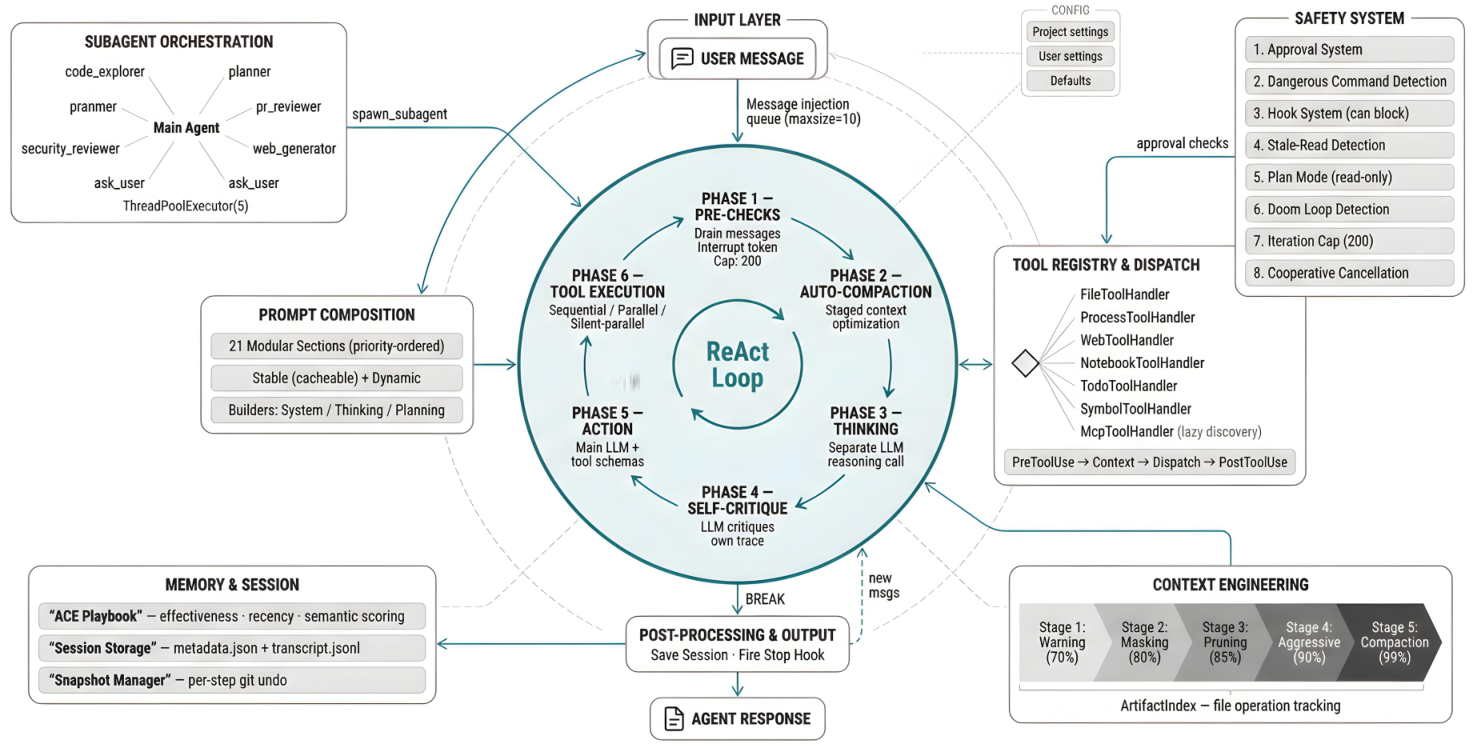
图 4:智能体 harness 架构(图 2 中智能体层的详图)。中央的 ReAct 循环(六个阶段:预检查与压缩、思考、自我批判、动作、工具执行、后处理)被七个支撑子系统环绕。用户消息经消息注入队列(顶部)进入。提示组合引擎按优先级将模块化段落组装为系统提示。工具注册表分发到特化处理器,MCP 工具惰性发现。安全系统执行多个独立层(审批、危险命令检测、钩子、陈旧读取检测、规划模式限制、死循环检测、迭代上限、协作式取消)。上下文工程随对话增长施加五阶段渐进压缩。记忆与会话服务提供持久策略记忆(playbook)、会话存储和基于 git 快照的逐步撤销。子智能体编排派生具有过滤工具访问权限的隔离智能体实例,用于并行探索或专门任务。
中央执行循环。 图 4 中心的 ReAct 循环每次迭代执行六个阶段:预检查与压缩、思考、自我批判、动作、工具执行和后处理。每个阶段是执行器流水线中的独立环节:预检查排空注入的消息并在内存压力下压缩;思考和自我批判产生可选的思维链轨迹;动作阶段携带完整工具模式调用 LLM;工具执行经注册表分发调用并附带审批检查;后处理决定继续迭代还是返回。循环重复,直到智能体产生不含工具调用的最终文本响应,或达到安全上限。2.2.6 节详述各阶段算法与控制流。
输入与输出边界。 在图 4 顶部,输入层通过线程安全的有界队列接收用户消息,允许后续消息在智能体执行中途到达。配置和设置与消息队列一起流入,为智能体提供运行时参数(模型选择、审批级别、工作目录)。在底部,后处理路径在循环终止后承担三项职责:将更新后的对话持久化到会话存储、执行已注册的 Stop 钩子、将智能体的最终响应返回 UI 层渲染。
支撑子系统。 图 4 的外围展示七个子系统,各自解决不同问题并在专门小节详述:提示组合引擎(2.3.1 节)从模块化段落(身份、安全策略、工具引导、工作流规则、动态上下文)组装系统提示,分为可缓存与不可缓存段以高效利用 API 缓存;工具注册表(2.4.1 节)将每个工具调用分发到特化处理器,MCP 工具运行时惰性发现;安全系统(2.1 节)通过多个独立层提供纵深防御,每一层捕获不同的失效模式;上下文工程(2.3.6 节)将对话作为有限资源管理,随 token 用量增长施加渐进激进的压缩;记忆与会话服务(2.5 节)持久化对话记录和随反馈演化的学习策略 playbook;子智能体编排(2.2.7 节)使主智能体能将专门任务(代码探索、安全审查、Web 生成)委托给隔离的智能体实例——它们共享同一工具基础设施,但以过滤的工具访问和独立的对话历史运行。
关键的架构决策是系统以两种不同模式运行——规划模式与普通模式——智能体基于用户命令或提示触发器在两者之间转换。图 5 展示了这种双模式流程。
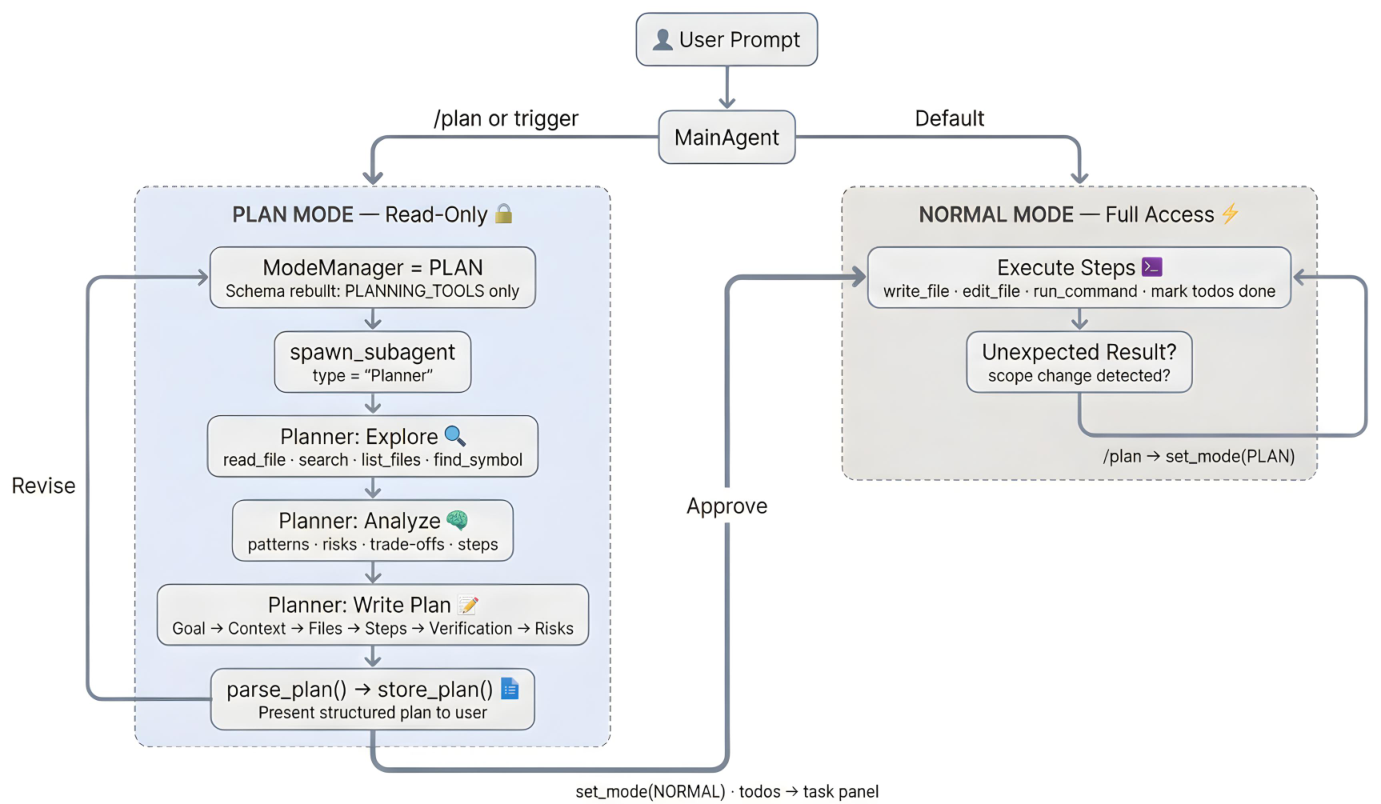
图 5:智能体层内的双模式运行(图 4)。用户提示进入 MainAgent,路由到规划模式(左,只读)或普通模式(右,完全访问)。规划模式派生 Planner 子智能体探索代码库、分析模式并产出结构化计划供用户批准。批准后,系统转换到普通模式,智能体以完整工具访问执行计划步骤。若意外结果需要重新规划,用户可随时重新进入规划模式。
路由:规划还是执行。 当用户提示到达时,MainAgent 检查应进入规划模式还是直接以普通模式处理。两个触发器激活规划模式:用户显式的 /plan 命令,或检测提示中规划意图的启发式规则(如要求"设计"、"架构"或"规划"某项变更)。所有其他提示默认以普通模式处理。该路由是每个提示一次性的决策;除非用户显式要求,智能体不会在执行中途切换模式。
规划模式:基于子智能体的规划。 OpenDev 不通过专门的计划管理工具将主智能体切换到受限模式,而是将规划委托给一等的 Planner 子智能体。需要规划时,主智能体调用 spawn_subagent(type="Planner"),启动一个拥有只读工具和专门规划提示的子智能体。写操作被完全排除在子智能体的工具模式之外:LLM 永远看不到它不能使用的工具定义,消除了规划期间尝试写入的可能。
Planner 子智能体按图 5 所示的三个阶段执行。第一,用只读工具探索代码库:读文件、搜索代码、列出目录内容、解析符号定义。第二,分析发现:识别模式、评估风险、考虑权衡、确定所需变更的序列。第三,将结构化计划写入暂存目录的文件,包含七个部分:目标、上下文、待修改文件、待新建文件、实现步骤、验证标准和风险。
完成后,Planner 将计划文件路径返回主智能体。主智能体随后调用 present_plan(plan_file_path),向用户展示计划以供审查。用户有两个选择:修改(主智能体可携带反馈再次派生 Planner)或批准(智能体进入普通模式执行)。该设计消除了对单独模式管理器状态的需求:主智能体全程保持普通模式,规划只是一次子智能体委托。
普通模式:完整执行。 普通模式是默认且唯一的运行状态。智能体拥有所有工具的完全访问权,包括读文件、写文件、编辑代码、执行命令和派生子智能体。计划经 present_plan 批准后,智能体使用任务管理工具跟踪进度,逐步完成计划步骤。
执行期间,若智能体遇到意外结果(如测试失败暴露出更深层问题、依赖冲突或范围变更),它可以携带当前代码库状态作为上下文再次派生 Planner 子智能体,产出考虑到原计划批准以来变化的修订计划。
基于子智能体规划的理由。 最初的设计使用四工具状态机(enter_plan_mode、exit_plan_mode、create_plan、edit_plan)将主智能体切换到受限规划状态。这很脆弱:智能体有时无法退出规划模式,使系统卡在需要人工干预的只读状态。
当前设计完全消除了这个状态机。规划被委托给 Planner 子智能体,其模式只包含只读工具,在模式级别(而非运行时权限检查)强制分离。Planner 不能写入是因为写工具不存在于其模式中,而非运行时检查阻止了尝试。这带来三个优势:(1) 没有状态机就没有卡在规划模式的风险;(2) Planner 可与其他子智能体(如用于并行分析的 Code Explorer)并发派生;(3) 工具面从四个工具缩减为一个(present_plan),降低了 LLM 的认知负担。
2.2.3 对话生命周期
图 6 追踪单条用户消息从初始输入到最终会话持久化的端到端路径。
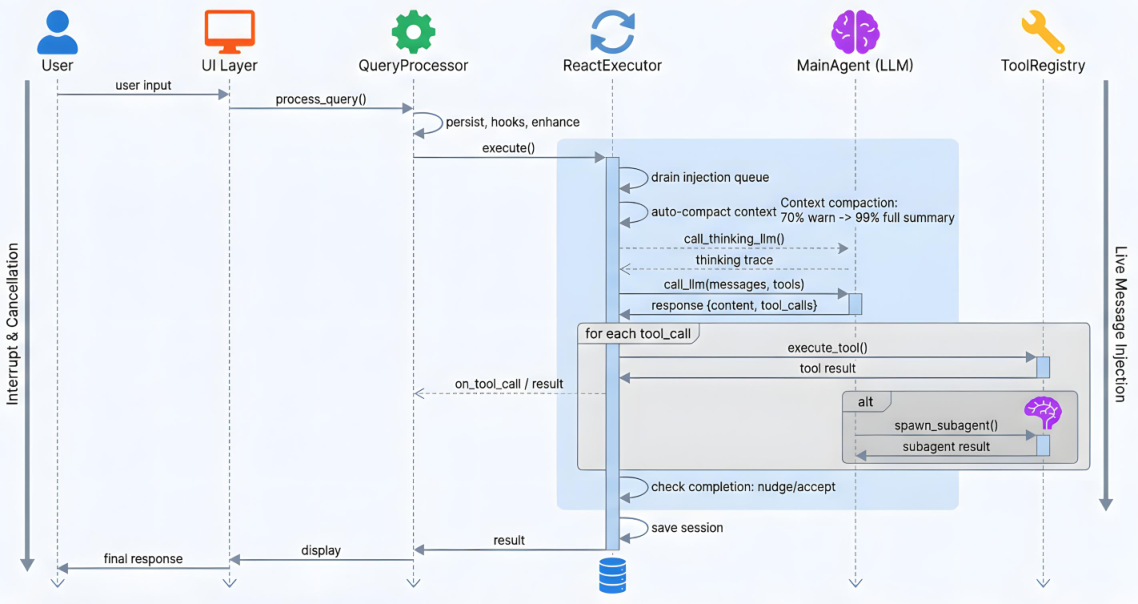
图 6:OpenDev 单个对话轮次的时序图。 用户消息经三种界面之一进入,经过查询处理,进入 ReAct 迭代循环。每次迭代包括上下文管理、可选思考、动作 LLM 调用和经注册表的工具分发。循环持续,直到智能体发出完成信号或满足终止条件,随后对话状态被持久化。
输入摄取与查询处理。 用户输入经三条入口路径之一到达:创建一次性会话的非交互式 CLI 调用、包裹交互式 REPL 的 TUI,或通过 WebSocket 接收消息的 Web UI。三条路径汇聚到同一个智能体执行核心。TUI 路径在进入 ReAct 循环前应用预处理阶段:将消息持久化到会话存储、触发可检查或修改查询的生命周期钩子、将内联文件引用(如 @file)展开为其内容、组装 LLM API 期望格式的消息列表。Web 和 CLI 路径不做预处理,直接调用智能体。
迭代循环。 ReAct 循环的每次迭代遵循固定序列。第一,执行器排空自上次迭代以来 UI 线程注入的任何消息,如经线程安全队列送达的后续指令或系统信号。第二,上下文压缩器检查 token 利用率相对上下文窗口的情况,在压力上升时应用削减策略(2.3.6 节描述压缩机制)。第三,若启用思考模式,一次单独的 LLM 调用在无工具访问的情况下产生推理轨迹,防止过早行动。第四,动作模型接收完整对话(包括任何思考轨迹)及可用工具模式,返回可能包含文本、工具调用或两者的响应。存在工具调用时,执行器经工具注册表分发:只读工具经线程池并行运行(最多 5 个并发调用),写工具顺序运行。若工具调用委托给子智能体,该子智能体在隔离上下文中以过滤的工具访问运行,并向父智能体返回摘要。
完成与持久化。 循环经四条路径之一终止:智能体以文本响应且无工具调用(隐式完成);智能体通过完成工具显式发出完成信号;错误恢复预算耗尽(系统对每段错误序列最多注入三条针对性恢复消息,见 2.3.5 节);或迭代次数达到安全上限。接受终止前,系统检查未完成任务项和注入队列中的待处理消息(UI 可在执行中途送达消息的线程安全通道),任一条件成立则推迟完成。接受后,最终对话状态保存到会话存储。
生命周期钩子。 OpenDev 暴露外部脚本可观察或拦截的生命周期事件:SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、PostToolUseFailure、SubagentStart、SubagentStop、Stop、PreCompact 和 SessionEnd。钩子命令通过全局或项目设置中的 JSON 配置,以 JSON 形式从 stdin 接收事件上下文。阻塞事件(PreToolUse、UserPromptSubmit、SubagentStart)可以阻止操作(退出码 2 向智能体返回阻塞原因)、改写工具参数(stdout JSON 中的 tool_input 键)或覆盖审批决定。非阻塞事件在操作完成后异步触发。全局和项目钩子按事件类型合并——项目匹配器追加在全局匹配器之后——使组织级策略可与仓库特定钩子结合(如"文件编辑后运行 eslint")。
横切关注点。 三个机制贯穿生命周期的所有阶段:
- 中断令牌将取消请求从 UI 传播到智能体线程,在每次迭代内的六个阶段边界轮询(思考前后、动作前、工具执行期间和迭代边界)。中断系统通过针对性修复解决若干竞态条件:模态控制器(ask-user 对话框、计划批准)优先于智能体中断,防止产生孤儿 UI 状态;子进程创建使用进程组(
start_new_session=True),使os.killpg可靠终止子进程;一次性守卫防止快速按键产生的重复中断消息。 - 线程安全注入队列允许用户在智能体执行中途发送后续消息;这些消息在迭代边界排空并在完成前检查,确保没有用户输入被静默丢弃。
- 会话成本跟踪在每次 LLM 调用后通过 CostTracker 服务记录累计 token 用量和成本——根据 API 报告的 token 计数和模型定价元数据计算;运行总计显示在 TUI 状态栏,并持久化在会话元数据中,供
--continue调用跨次恢复。
2.2.4 REPL 命令分发
上述对话生命周期假设用户输入进入智能体推理循环。然而,并非所有输入都需要 LLM 参与。会话管理、模式切换、模型选择和 MCP 服务器配置是确定性操作,REPL 可以直接处理而无需调用智能体。系统因此在输入边界实现双路径分发:若输入以"/"前缀开头,路由到已注册的命令处理器;否则进入查询处理器并进入智能体循环。图 7 展示了该架构。
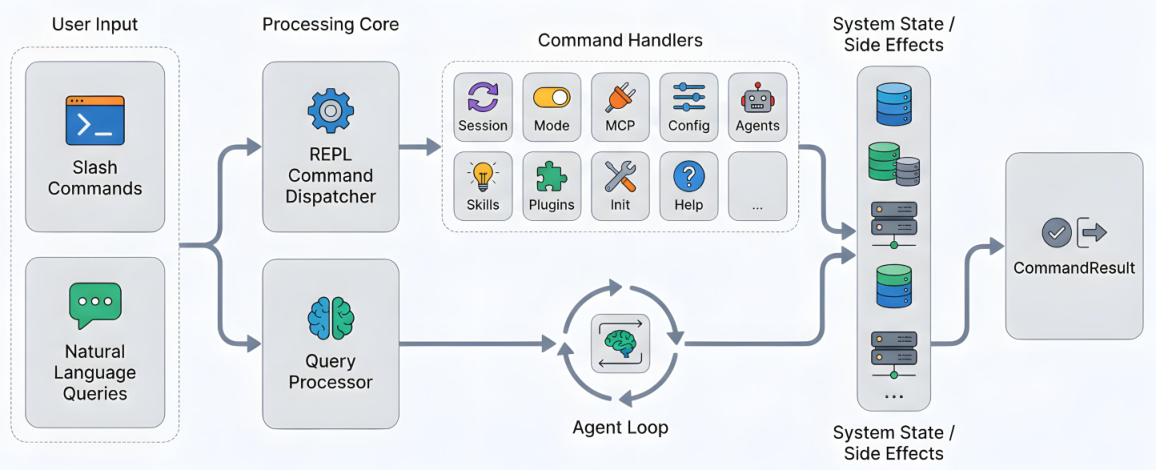
图 7:OpenDev 中的双路径输入分发。 用户输入在 REPL 边界分类:斜杠命令(上路径)经 REPL 命令分发器路由到九个已注册命令处理器之一,每个处理器直接修改系统状态并返回 CommandResult;自然语言查询(下路径)经查询处理器进入智能体循环,通过工具执行与系统状态交互。两条路径最终都对共享系统状态产生副作用,但通过根本不同的机制:命令无 LLM 参与地确定性执行,查询经完整推理循环处理。
命令处理器抽象。 所有命令处理器扩展共同的抽象基类,提供处理器接口和标准化输出格式。每个处理器在构造时接收 REPL 实例引用,通过显式依赖注入(而非全局状态)访问共享管理器(会话、模式、配置、MCP)。处理器的 handle(args) 方法执行参数解析、执行操作并返回 CommandResult——包含成功标志、人类可读消息和可选结构化数据。带子命令的命令(如 /mcp connect、/agents create)对参数字符串做二级拆分并内部分发到相应方法。
处理器类别。 如图 7 所示,九个处理器类覆盖系统的交互控制面。会话命令(/clear、/compact)管理对话状态:清除会保存当前会话并重新开始,压缩则按需触发上下文削减。模式命令(/mode)通过设置待处理标志在普通与规划模式间切换,查询处理器在下一次用户查询时读取该标志。配置命令(/models)呈现交互式模型选择器,选择后触发以新模型配置的完整智能体重建。MCP 命令(/mcp)暴露十一个子命令用于管理模型上下文协议服务器:连接、断开、列出工具、测试服务器健康。智能体、技能与插件命令分别管理自定义智能体定义、可复用提示模板和第三方扩展。工具命令(/init)初始化代码库上下文,帮助命令列出所有可用命令。
对系统状态的副作用。 命令不产生孤立的输出;它们修改后续智能体交互所依赖的共享状态。如图 7 右列所示,命令处理器和智能体循环汇聚到同一系统状态。例如,/models 触发智能体工厂的完整重建,以新模型的能力重建工具注册表和系统提示;/mcp connect 从连接的服务器发现并注册新工具,扩展智能体下一轮可用的工具模式;/mode plan 设置标志,使查询处理器在下一次查询时激活规划行为。这些副作用是命令不直接进入推理循环而影响智能体行为的主要机制。
与智能体工具的分离。 REPL 命令与智能体工具的区别是架构性的,而非偶然的。命令由用户键入斜杠前缀触发,由 REPL 同步执行,无需 LLM 参与、无工具使用钩子、无审批门、无撤销跟踪。相比之下,智能体工具由 LLM 在推理中选择,经带前后执行钩子的工具注册表执行,根据配置的自治级别接受用户审批,并由撤销管理器跟踪。命令作用于 REPL 实例;工具在携带智能体依赖的运行上下文中运作。这种分离确保系统级操作(更换模型、管理服务器、重置会话)保持快速和可预测,同时将开放式问题求解委托给智能体循环。
2.2.5 工作负载优化的多模型架构
复合 AI 系统范式的一个核心认识是:不同执行阶段受益于不同的模型能力。推理任务受益于无工具干扰的扩展思考;视觉任务需要视觉-语言模型;批量摘要受益于更便宜、更快的模型。所有任务用单一模型,要么浪费成本(简单任务用昂贵模型),要么牺牲质量(复杂推理用廉价模型)。考虑过三种方案:单一模型处理一切(简单但不灵活);任务特定路由(本文采用,在选择逻辑上引入复杂性,但实现工作负载优化);集成执行(质量最高但延迟和成本过高)。
五个模型角色与回退链。 五类不同的工作负载路由到特化模型:
- 动作模型(Action):基于工具的推理的主要执行模型。未指定特化模型时所有工作负载的默认。
- 思考模型(Thinking):可选模型,用于无工具访问的扩展推理。专注于战略规划而无工具调用压力。回退:动作模型。
- 批判模型(Critique):可选模型,用于自我评估。受 Reflexion 启发,但有选择地应用而非每轮都用。回退:思考模型 → 动作模型。
- 视觉模型(Vision):处理截图和图像的视觉-语言模型。对视觉调试任务必不可少。回退:具备视觉能力时的动作模型。
- 压缩模型(Compact):上下文压缩期间用于摘要的更小、更快模型。优先考虑速度和成本而非推理深度。回退:动作模型。
提供商抽象与缓存。 每次模型选择触发提供商特定 API 客户端的惰性初始化,降低启动延迟,因为只有会话中实际使用的模型会被初始化。模型能力(上下文长度、视觉支持、推理特性)以 TTL 刷新机制缓存到本地,支持离线启动和遵循 stale-while-revalidate(旧数据先用、后台刷新)模式的后台更新。缓存以潜在的陈旧性换取启动可靠性,后台刷新确保最终一致性。
2.2.6 扩展 ReAct 执行循环
模式选定后,智能体通过 ReactExecutor 处理每个用户查询——它实现了 Reason-Act 循环的扩展版本(本文简称 ReAct 循环)。图 8 展示了完整执行流水线。
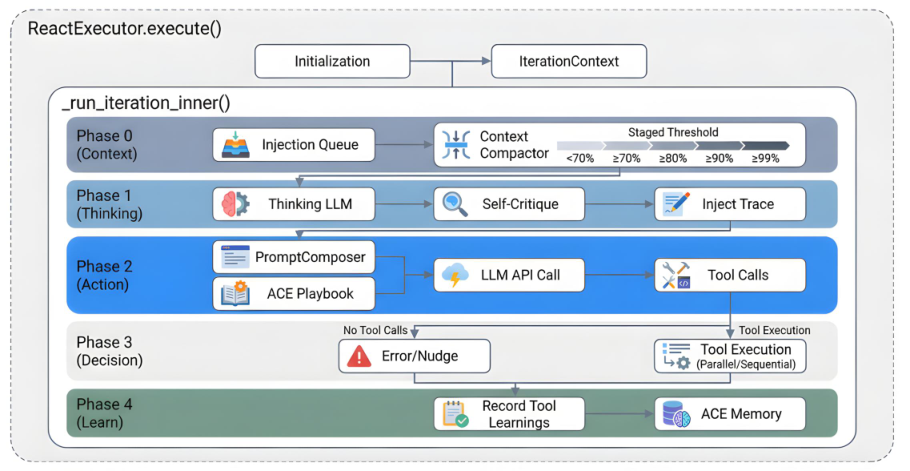
图 8:图 4 中心 ReAct 循环的详图。 每个用户查询经过创建 IterationContext 的初始化阶段,然后进入由四个阶段组成的迭代循环(_run_iteration_inner):上下文管理、思考、动作和决策。循环持续,直到智能体产生最终响应、显式发出完成信号或耗尽迭代预算。
标准 ReAct 在同一轮次中交替推理与行动,这限制了深思熟虑。工具模式消耗上下文并制造"快速行动而非深入思考"的压力。考虑过四种方案:纯 ReAct(简单但偏向过早行动);思维链提示(不灵活,无法让深度适配任务复杂度);独立的思考阶段(可控制深度并防止过早工具使用);Reflexion 启发的自我批判循环(质量最高但思考延迟翻倍)。OpenDev 结合后两者:行动前的显式思考阶段,加上面向复杂任务的可选自我批判。
算法 1:带五阶段压缩与死循环检测的扩展 ReAct 循环
输入:用户消息 m,智能体 𝒜,工具注册表 𝒯,会话 𝒮
输出:响应摘要、错误状态、延迟
𝒮.add(m);nudge_count ← 0;fingerprints ← deque(maxlen=20)- 重复:
- // 阶段 0:分阶段上下文管理
p ← token_count(𝒮) / max_context▷ 上下文压力- 若 p > 0.99:
𝒮 ← compact(𝒮)▷ 完整 LLM 摘要- 否则若 p > 0.85:
prune_old_tool_outputs(𝒮)▷ 快速修剪- 否则若 p > 0.80:
mask_old_observations(𝒮)▷ 以引用替换旧工具结果- 否则若 p > 0.70:
log_warning(p)- // 阶段 1:思考(若启用)
- 若 thinking_level ≠ OFF:
trace ← 𝒜.call_thinking_llm(𝒮)▷ 无工具- 若 thinking_level = HIGH: ▷ HIGH 含自我批判
critique ← 𝒜.call_critique_llm(trace)trace ← 𝒜.refine(trace, critique)𝒮.add_trace(trace)- // 阶段 2:动作
response, tool_calls ← 𝒜.call_llm(𝒮, 𝒯)▷ 带工具- 若 tool_calls ≠ ∅:
- // 死循环检测
- 对每个 tc ∈ tool_calls:
fingerprints.append(md5(tc.name, tc.args))- 若 max(Counter(fingerprints).values()) ≥ 3:
approval_pause("检测到重复工具调用")- 否则对每个 tc ∈ tool_calls:
result ← 𝒯.execute(tc);𝒮.add(tc, result)- 否则:
- 若上一工具失败 且 nudge_count < 3:
𝒮.add(get_smart_nudge(error));nudge_count += 1- 否则跳出 ▷ 隐式完成
- 直到 task_complete 被调用 或 达到最大迭代次数
- 返回 摘要、错误、延迟
初始化。 查询到达时,执行器清空任何待处理注入队列,创建支持取消的中断令牌,将对话历史包装进 ValidatedMessageList(强制正确的消息交替),并将一切打包为 IterationContext。该上下文对象携带所有按查询的状态:迭代计数器、一次性守卫标志(防止重复信号),以及工具注册表和审批管理器等共享服务的引用。
阶段 0:分阶段上下文管理。 每次迭代开始,执行器排空注入队列并运行分阶段压缩器。压缩器监控 token 利用率相对上下文窗口的情况,随压力上升应用五种渐进激进的削减策略:警告(70%)、观测遮蔽(80%)、快速修剪(85%)、激进遮蔽(90%)和完整的基于 LLM 的压缩(99%)。2.3.6 节详述各阶段;关键性质是更便宜的策略(遮蔽、修剪)常常能回收足够空间,避免完整 LLM 摘要的成本。
阶段 1:思考。 若启用思考模式,执行器以对话的无工具副本调用单独的思考 LLM。该模型产生推理轨迹(对当前状况、潜在方法和风险的结构化分析),因无工具访问而不能过早行动。将思考与行动分离可防止过早工具使用:当工具可用时,模型倾向于快速行动而非深入思考。四个可配置深度级别(OFF、LOW、MEDIUM、HIGH)让用户按任务平衡延迟与深思熟虑的质量。在 HIGH 级别,自我批判自动包含:批判模型评估初始轨迹,思考模型以批判为额外输入精炼推理。早期设计将自我批判暴露为独立的第五级,但用户觉得区分令人困惑;将其并入 HIGH 简化了界面而不降低能力,因为想要深度思考的用户总是也能从批判受益。最终轨迹作为系统提醒注入对话,使推理对下一阶段的动作模型可见。
阶段 2:动作。 执行器组装完整的动作提示:系统提示(由 PromptComposer 从按优先级排序的段落组合)、从 ACE playbook 选取的记忆条目(2.3.6 节)、所有工具模式,以及包含任何注入思考轨迹的对话历史。该提示发送给动作 LLM,返回可能包含文本、工具调用或两者的响应。API 报告的 token 计数用于校准下一次迭代阶段 0 中压缩器的利用率估计。
阶段 3:决策、分发与死循环检测。 执行器根据动作模型是否产生工具调用而分支。若无工具调用:当上一工具失败时,执行器对错误分类(权限拒绝、文件未找到、语法错误、速率限制等)并注入针对性恢复提示(2.3.5 节);存在未完成待办时,提示智能体继续;否则,无错误的纯文本响应表示任务完成,循环终止。
若有工具调用,执行器首先执行死循环检测,采用两级升级:每个工具调用以工具名和参数的 MD5 哈希生成指纹,指纹在最近 20 次调用的滑动窗口中跟踪。若任一指纹出现 3 次及以上,系统向对话注入 [SYSTEM WARNING] 消息(例如"智能体已用相同参数调用 read_file 3 次;请尝试不同方法")并跳过该轮的工具执行。若警告后相同指纹再次出现,系统升级为经 ApprovalManager 的基于审批的暂停,向用户呈现"智能体正在重复相同动作。允许 / 中止?"选择"允许"则以一次性守卫恢复执行——允许该动作一次后重新武装检测;选择"中止"则向对话注入引导消息并重置循环。
这种两级方法比仅警告更稳健:LLM 可以忽略注入的文本,但无法绕过真正的执行停止。已有的防护措施(迭代上限、连续读取计数器)过于粗糙:它们对任何重复的工具类型触发,而非对相同的(工具,参数)对,且在多得多的迭代后才激活。基于指纹的检测在 3 次重复内即可捕获卡住的循环。
未检测到死循环时,执行器选择执行策略(独立调用经线程池并行、依赖调用顺序执行),经注册表运行工具并记录每个结果。执行后,结果进入 ACE 记忆流水线:Reflector 分析哪些做法有效,Curator 用新经验更新 playbook 供未来查询使用。循环随后回到阶段 0 开始下一次迭代。
终止与完成检测。 循环经四条路径之一结束:智能体显式调用完成工具并附摘要和状态(成功或失败);智能体产生无工具调用且无错误条件的文本响应(隐式完成);错误恢复提示预算耗尽(连续三次失败尝试);或迭代次数达到可配置安全上限。若智能体发出完成信号时仍有未结任务项,系统注入额外提示以处理它们,然后才接受终止,防止工作未完成时过早完成。所有情况下,最终对话状态都持久化到会话存储。
设计演进。 早期实验对每次思考输出都应用自我批判;这对常规操作太慢,促成了仅在 HIGH 思考级别选择性激活。死循环检测是在观察到智能体反复以相同参数调用同一工具(如循环读取不存在的文件)后添加的;基于迭代计数和连续读取计数器的现有防护措施过于粗糙,无法捕获该模式。分阶段压缩(2.3.6 节)和基于待办的完成验证(2.3.4 节)解决了该阶段发现的其他失效模式。
2.2.7 子智能体编排
某些任务受益于专门技能(代码库探索、用户澄清),另一些需要与主智能体状态协调(任务管理)。主智能体可为特定子任务派生特化子智能体,每个都有过滤的工具访问和专门提示。子智能体在隔离上下文中以自己的迭代预算执行,防止无界执行。
子智能体专门化。 不同子智能体承担不同角色:
- 代码探索者(Code explorer):只读工具,用于代码库导航。专门理解既有代码结构。
- 战略规划者(Strategic planner):只读工具加扩展推理。专注高层规划而不执行。
- Web 工具:Web 抓取加文件写入,用于克隆 Web 内容。结合检索与持久化。
- 用户澄清:最小工具集,用于收集输入。专注无干扰地引出信息。
工具过滤的理由。 子智能体能力被有意限制,原因有三。第一,任务管理工具被排除在子智能体之外,只有主智能体协调待办列表,防止竞态条件和状态不一致。第二,有限的工具访问减少上下文大小,让每个子智能体聚焦其特定角色——探索子智能体不需要写能力。第三,受限工具限制错误的爆炸半径:探索子智能体不会意外修改文件。
并行执行。 主智能体可并发派生多个子智能体(各自在自己的线程中),处理独立查询,如并行文件搜索、代码库探索或 Web 抓取。系统提示显式指导智能体何时以及如何并行化:当用户请求多个独立分析、探索大型代码库,或任务间无数据依赖时。在同一响应中进行多个 spawn_subagent 调用会触发自动并行执行。完成后,智能体被指示将所有子智能体结果综合为按主题组织的单一统一响应,而非分别总结每个智能体。这以线程开销换取独立操作的延迟降低。
子智能体提示改进。 子智能体提示包含显式终止条件,防止过度探索。Code Explorer 子智能体有停止条件(“证据明确时停止”、“进展停滞时停止”、“深度优先于广度”)和反循环指令(“重读同一文件立即触发停止”)。Planner 子智能体被指示在完成摘要中包含 plan_file_path,使主智能体能立即将其传给 present_plan。思考模式提示鼓励对需要深度代码库分析的任务派生 Code Explorer 子智能体。
设计演进。 早期版本给子智能体与主智能体相同的工具。这导致上下文污染、角色混淆,以及两个智能体同时更新待办时的冲突。将每个子智能体的工具集限制到其特定角色改善了专注度和效率。早期子智能体提示缺少明确停止条件,导致无界探索——Code Explorer 会反复读取相同文件;添加显式停止条件和反循环指令解决了此问题。
智能体核心产生推理轨迹和工具调用;接下来描述的上下文工程层管理模型在每一步看到什么,塑造决定智能体每个决策的输入。
2.3 上下文工程层
基于 LLM 的智能体并非简单地将用户消息发给模型并接收响应。每个响应的质量主要取决于模型在其上下文窗口中被允许看到什么:接收哪些指令、保留多少对话历史、从先前交互中学到了什么、以及每次调用前如何组装相关外部信息。我们将管理这个窗口的机制集合统称为上下文工程层。
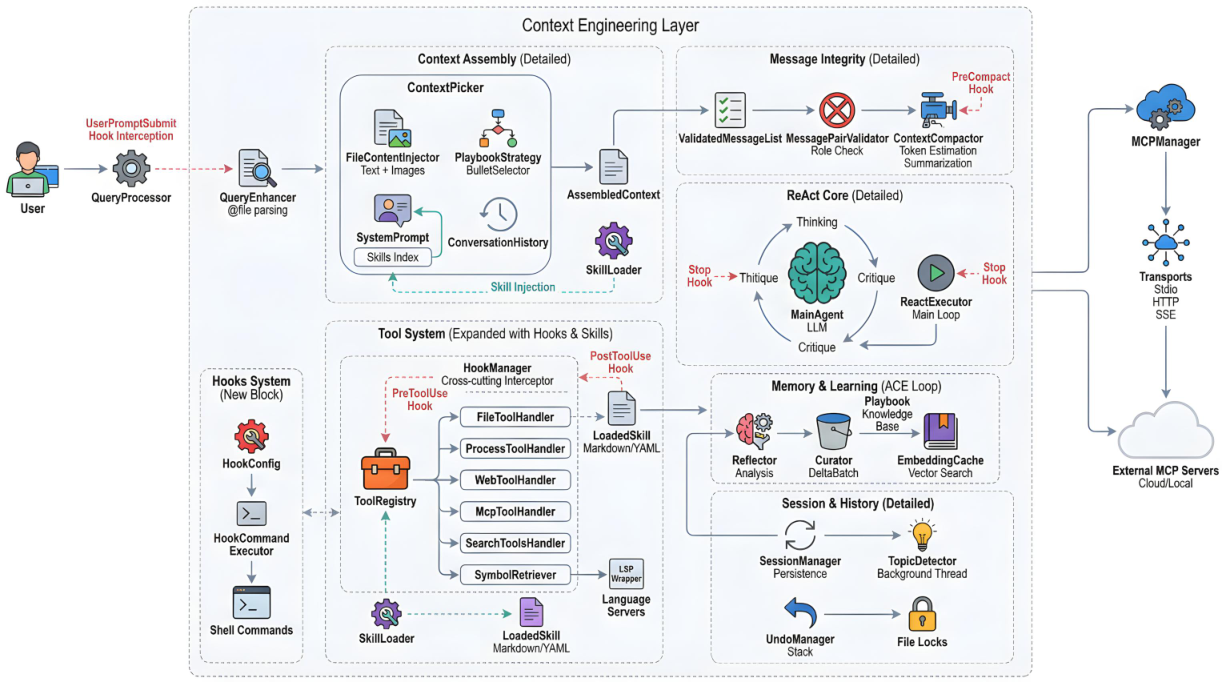
图 9:图 2 中工具与上下文层的展开图。 六个子系统协作,在会话期间填充和维护模型的上下文窗口。子系统按生命周期顺序呈现:动态系统提示构造初始化行为指令;双记忆与工具结果优化塑造进入上下文的内容;系统提醒和错误恢复在运行时注入针对性引导;自适应上下文压缩在 token 预算接近耗尽时管理溢出。
图 9 展示了各子系统及其交互。用户查询经 QueryProcessor 进入,交给 ContextPicker 进行上下文组装。组装好的上下文经 ContextCompactor 执行 token 预算后进入 ReAct 推理循环。每轮,结果流回 SessionManager 持久化,代表学习机会的工具结果由自适应记忆子系统处理。本节的其余部分按各子系统在会话中首次影响上下文窗口的顺序逐一呈现。最后一小节(2.3.7 节)将这些组件综合为从用户查询到 LLM API 调用的统一端到端流水线。
2.3.1 动态系统提示构造
在基于 LLM 的智能体中,系统提示是行为控制的主要工具:它编码智能体的身份、能力边界、安全约束和任务约定。每个无法通过代码强制的行为属性——智能体如何推理、偏好哪些工具、如何从错误中恢复——都以自然语言表达在系统提示中。因此,在启动时正确构建该提示不是次要的配置细节,而是核心的初始化问题。
朴素的做法是加载包含所有可能指令的单体提示。这有两个叠加的成本。第一,与当前会话无关的段落(如非仓库目录中的 git 工作流规则、未使用子智能体时的子智能体编排指南、功能禁用时的任务跟踪指令)消耗上下文窗口预算而不贡献任何行为价值。第二,无关指令稀释了真正重要的段落,使智能体行为更嘈杂。解决方案不是手工裁剪提示,而是从一开始就使加载上下文敏感。
优先级排序的条件组合。 OpenDev 通过图 10 所示的流水线在运行时组装每个智能体的系统提示。行为指令被分解为独立的段落(section),每个段落存储为单独的 markdown 文件,并注册两个元数据字段:条件——对运行时上下文字典的谓词(None 表示总是包含);优先级——控制阅读顺序的整数。初始化时,PromptComposer 执行四个步骤:
- 过滤。 针对当前环境快照评估每个段落的谓词。返回 False 的段落在任何文件 I/O 发生前被排除。例如,
main-git-workflow.md以in_git_repo为门控条件;工作目录不是仓库时从不加载。 - 排序。 按优先级升序排列存活的段落:较小值出现更早,将身份与人格规则置于环境派生上下文之前。
- 加载。 读取每个 markdown 文件,剥离人类可读的 frontmatter,并通过集中式名称注册表解析
${VAR}占位符——该注册表将模板行文与具体工具标识符解耦。 - 连接。 拼接已加载段落,附加到核心角色文本和动态收集的环境块之后,产出完整系统提示。
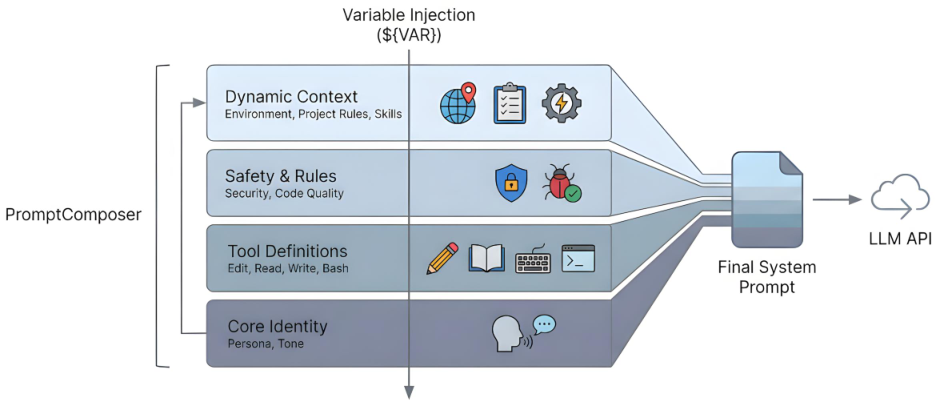
图 10:图 9 中提示组合子系统的详图。 段落注册时附带可选条件谓词和优先级值。智能体初始化时,PromptComposer 针对运行时环境评估每个谓词,按优先级升序排列存活段落,加载其 markdown 模板,并连接为最终系统提示。四个逻辑层——核心身份、工具定义、安全与规则、动态上下文——按功能组织段落。虚线边框表示仅在谓词满足时才包含的条件加载段落。
默认动作模式智能体注册横跨五个功能层的模块化段落:核心身份(人格和不可协商的约束)、工具定义(执行期间所需的工具使用与代码质量引导)、安全与规则(条件加载的策略,如 git 约定和任务跟踪指令)、提供商特定引导(LLM 提供商特定的行为提示)、动态上下文(会话特定元数据)。思考模式智能体注册更少段落,有意省略工具使用引导,避免将无工具推理带向过早行动。附录 C 提供所有主段落和思考段落的完整注册表(含条件和摘要);附录 K 逐字重现每个模板的内容。
模式特定变体与变量替换。 不同推理阶段需要根本不同的提示。普通(动作)模式加载跨五层的所有已注册段落。思考模式——无工具的推理预阶段——只加载少量专门构建的段落:可用工具感知(让模型知道哪些动作可行而不被诱惑去调用)、子智能体引导、代码引用约定和输出格式规则。规划模式使用针对只读探索优化的独立模板。这种模式专门化通过工厂函数实现:create_composer(templates_dir, mode="system/main") 返回完整动作组合器,mode="system/thinking" 返回最小思考组合器。
模板使用 ${VAR} 占位符,由 PromptRenderer 在渲染时解析。集中式 PromptVariables 注册表将符号名映射到具体工具标识符;例如 ${EDIT_TOOL.name} 解析为 edit_file。这种间接层将模板行文与工具命名解耦:重命名工具只需改一处注册表条目,而非编辑每个模板。
提供商特定的条件段落。 不同 LLM 提供商有显著不同的能力和约定:Anthropic 模型支持 tool_use 内容块和扩展思考,OpenAI 模型使用带结构化输出支持的函数调用,Fireworks 等推理提供商有不同的上下文窗口限制。没有提供商特定引导,智能体可能引用自己不具备的能力。PromptComposer 用以 model_provider 字段(来自运行时环境上下文)为门控的互斥条件段落解决此问题:每个提示根据活动提供商恰好包含一个提供商段落(OpenAI、Anthropic、Fireworks),未知提供商不包含任何段落(优雅降级)。
提供商级提示缓存。 对支持输入缓存的提供商(目前是 Anthropic),PromptComposer 提供 compose_two_part() 方法,将组装好的提示拆分为稳定部分和动态部分。每个段落标注 cacheable 标志(默认 True);标记为可缓存的段落(基础指令、工具描述、安全策略)拼入稳定部分,其余(环境元数据、会话特定上下文)进入动态部分。AnthropicAdapter 将它们组织为两元素内容数组:稳定块携带 cache_control: {"type": "ephemeral"} 头,动态块不携带。由于系统提示在每次 LLM 调用时重发,而稳定部分通常占总量 80–90%,缓存它在多轮会话中产生可观的成本节省(缓存部分的输入 token 成本降低约 88%)。不支持该机制的提供商收到完整拼接的单字符串提示,行为无差异。
两级回退。 若单个段落文件缺失,组合器跳过它并继续,智能体以略微缩减的提示启动而非失败。若模块化组合整体失败(如模板目录不存在),构建器回退到单体核心模板。这保证智能体在部分部署条件下也能启动。
2.3.2 工具结果优化
原始工具输出消耗的 token 远超其信息价值。单次 read_file 可能返回 2,000–3,000 token 的源代码;目录列举可能枚举数百条目;测试运行器调用可能产生数千行 TAP 输出。不加约束时,冗长结果在几次迭代内就会主导上下文窗口,挤掉驱动智能体行为的用户查询和系统指令。工具结果优化通过在原始输出进入对话历史前,将其转换为紧凑、语义保留的表示来解决此问题。
按工具类型的摘要。 每个工具结果经过专门的摘要器,将工具名和原始输出映射为简洁摘要(通常 50–200 字符)。摘要器按工具名分发,应用类型特定的压缩策略:
- 文件读取替换为元数据:“✓ 已读取文件(142 行,4,831 字符)”。完整内容仍可通过重读获得,但上下文只携带读取发生过的证明和文件大致大小。
- 搜索结果报告匹配数而非匹配行:“✓ 搜索完成(23 个匹配)”。搜索无结果时,摘要显式反映,使智能体能重定向。
- 目录列举折叠为条目数:“✓ 已列出目录(47 项)”。常含深层嵌套路径的原始列举被单行摘要替换。
- 命令执行适配输出长度:短输出(≤100 字符)逐字保留;较长输出行数:“✓ 命令已执行(312 行输出)”。
- 错误截断到 200 字符并带分类前缀:“× Error: FileNotFoundError: …”。这确保智能体获得足够的错误恢复信息(2.3.5 节),而不在堆栈跟踪上消耗过多上下文。
大输出卸载。 对超过 8,000 字符(约 2,000 token)的输出,摘要器不够用:即使摘要后完整输出仍会主导上下文。这些输出在进入对话历史前被卸载到暂存文件。系统将完整输出写入会话特定暂存目录(~/.opendev/scratch/<session_id>/),并将对话中的输出替换为 500 字符预览加引用路径:"[输出已卸载:2,341 行,48,203 字符 → <路径>]。如需完整输出请使用 read_file。"这形成自然的分层系统:智能体看到足以理解内容的信息,并可按需 read_file 完整输出——该操作本身也受同样的卸载阈值约束。
智能体感知的截断提示。 输出被卸载到暂存文件时,截断消息包含基于当前智能体能力定制的恢复提示。若智能体可委托子智能体(拥有 spawn_subagent 工具),提示建议:"委托给 Code Explorer 子智能体,通过搜索和读取工具处理完整输出。"若智能体缺乏子智能体能力(如它本身就是子智能体),提示则建议:"使用带 offset/limit 参数的搜索工具增量处理输出。"这种智能体感知的建议防止了常见失效模式:智能体尝试其工具集中不可用的恢复策略——例如 Code Explorer 子智能体试图再派生一个子智能体。
与压缩的交互。 工具结果摘要和卸载的输出扮演互补角色。摄取时,它们通过替换对话历史中的完整结果提供即时的上下文节省。压缩期间(2.3.6 节),压缩器在为基于 LLM 的摘要消毒消息时优先使用预计算的摘要,避免冗余的重复处理。这种协同意味着即使触发紧急压缩,摘要 LLM 的输入也已大幅压缩,改善压缩输出的速度和质量。
设计演进。 早期版本无论长度都将完整工具输出存入对话历史。单个长时间运行的测试套件一次工具调用就能消耗 30,000 token 上下文。按工具的摘要器在多数情况下将其降到 100 token 以下。添加 8,000 字符卸载阈值解决了超出摘要器压缩比的剩余离群值(大文件读取、冗长命令输出),将典型会话长度从 15–20 轮(上下文溢出前)延长到 30–40 轮无需压缩。
2.3.3 有界思考的双记忆架构
思考阶段(ReAct 循环的阶段 1,2.2.6 节)需要对话上下文进行战略推理,但完整对话历史可能增长到数十万 token。给思考模型提供无界历史不可行:会超出模型上下文窗口,并在陈旧细节上浪费预算。只提供近期消息又会丢失战略上下文,使智能体"忘记"总体目标。我们通过受人类认知科学启发的双记忆架构解决这一张力,将压缩的长程上下文与详细的短程上下文分离。
情景记忆(Episodic memory)。 由 LLM 生成的完整对话历史摘要,捕获战略性长程上下文:已做出的决定、总体目标、关键发现和重要文件路径。摘要器被指示保留可行动标识符(文件路径、函数名、变量名、错误码),同时省略冗长工具输出和冗余往来。该摘要定期重新生成(每 5 条新消息,由 regenerate_threshold 参数控制),而非每轮都生成。定期再生有两个目的:摊销摘要调用的成本;防止摘要漂移——迭代地对摘要再做摘要导致失真累积的现象。通过从完整历史重新生成,每个情景记忆快照都是全新压缩,而非"压缩的压缩"。
工作记忆(Working memory)。 最近若干消息对(默认最近 6 次交换,由 exclude_last_n 控制)逐字重现。这些近期消息包含即时决策所需的细粒度操作细节:最近几轮读取的确切文件内容、具体错误消息、精确行号、最近一次工具调用的结果。摘要恰恰会摧毁对下一动作最重要的细节。
组合注入。 每次思考 LLM 调用前,系统通过拼接构造思考上下文:(1) 情景记忆摘要,提供"大局";(2) 工作记忆消息,提供操作细节;(3) 当前用户查询。该结构映射认知架构中情景记忆与工作记忆的区分:情景记忆存储过去经验的要义用于长程规划,工作记忆保存近期获取的详细信息供即时使用。无论对话多长,思考 token 预算都保持有界,因为情景摘要有固定最大长度(500 字符),工作记忆窗口恒定。
设计演进。 早期尝试对整个历史用纯摘要,但关键标识符(文件路径、变量名)丢失,导致智能体引用不存在的文件或记错函数名。相反的极端——只用近期消息——丢失长程战略上下文:智能体在 10 轮后会"忘记"用户的原始目标。混合架构解决了两种失效模式。我们还发现,对先前的摘要做摘要(增量摘要)在多轮后累积误差;定期从完整历史重新生成纠正了这种漂移。
2.3.4 上下文感知的系统提醒
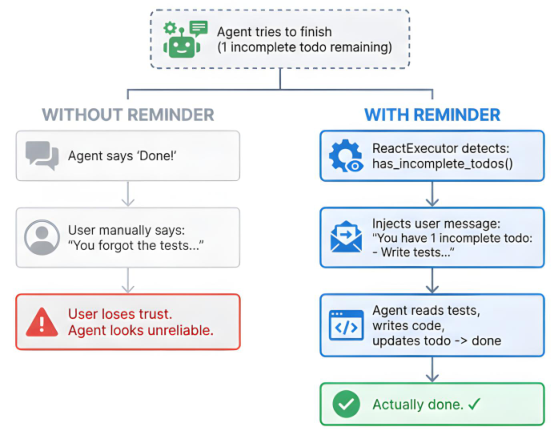
图 11:图 9 中提醒子系统的详图。 没有提醒时(左),有一个未完成待办的智能体宣告完成,迫使用户干预并导致信任损失。有提醒时(右),ReactExecutor 检测到未完成状态,注入列出未完成事项的针对性 user 角色消息,智能体恢复工作并正确完成任务。
系统提醒解决长时智能体会话中的一个基本可靠性问题:随着对话增长,模型的注意力从初始系统提示指令上漂移,导致静默失效——如过早的任务完成、放弃错误恢复、不受控的探索螺旋(图 11)。
设想一个编码智能体在系统提示中被告知:编辑代码后总要运行测试。最初几轮它照做了。但 20 次工具调用之后,文件内容、搜索结果和命令输出在对话中堆积,它悄悄停下了。指令仍在系统提示中,但模型不再注意它。同样的模式以其他形式出现:被告知"停止前完成所有任务"的智能体在清单一半未完成时就宣告胜利;遇到文件编辑错误的智能体放弃而非重读文件重试——尽管指令要求重试。
根本原因很简单:系统提示位于对话的最开头。随着对话变长,模型的注意力转向近期消息,远离那块初始指令。规则仍在上下文窗口中,但其影响随距离衰减。这不是假设性的担忧;它是我们在超过 15 次工具调用的会话中持续观察到的、可预测、可复现的失效模式。
将所有指令前置起初有效,但在长会话中退化。每隔几轮重新注入整个系统提示,则在智能体当前不需要的指令上浪费 token。OpenDev 用系统提醒解决:简短的、单一用途的消息,恰在智能体需要时注入——就在它本来会出错的决策点之前。每个提醒是一条简短的 role: user 消息,置于对话中最近性的最高位置,紧邻下一次 LLM 调用之前。图 12 展示了该架构。
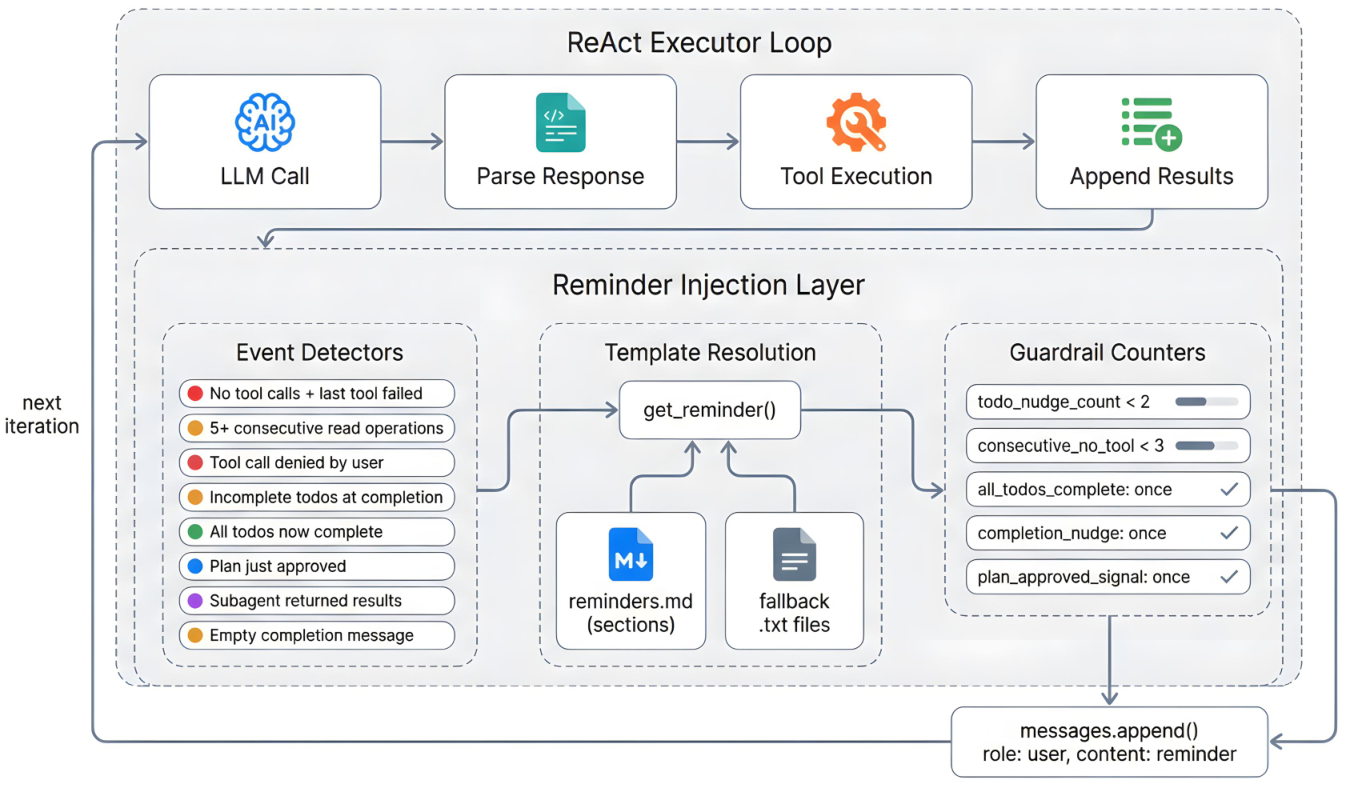
图 12:提醒注入层架构。 ReAct 执行器循环的每次迭代之后(顶部),八个事件检测器检查对话状态。检测器触发时,相应提醒模板经
get_reminder()从 reminders.md 解析(较长提示回退到 .txt 文件),对照限制每种提醒触发次数的护栏计数器检查,并作为role: user消息追加到消息列表。下一次 LLM 调用将此提醒视为最新输入,最大化其对模型下一决策的影响。
事件检测器。 如图 12 所示,注入层在工具执行与下一次 LLM 调用之间的边界监控八种情况:工具失败未重试(带六种错误特定的恢复模板)、探索螺旋(连续 5 次以上读取)、被拒工具的重试、待办未完成时的过早完成、所有待办完成后继续工作、计划批准后未跟进、未处理的子智能体结果、空的完成消息。每个检测器从按类别组织的命名提醒目录中触发相应模板:阶段控制、任务生命周期、待办强制、错误恢复、行为纠正、JSON 重试(附录 F 提供完整目录和注入时机)。
模板解析。 所有提醒文本位于源代码之外。单一文件(reminders.md)以 --- section_name --- 标记分隔的命名段落存储短模板。较长提示回退到独立 .txt 文件。入口点 get_reminder(name, **kwargs) 首次调用时将文件一次性解析到模块级缓存,按名查找段落,并通过 str.format() 填充占位符(如 {count}、{todo_list})。模板以纯文本保存使其可审计、可编辑,无需触碰 Python 代码。
护栏计数器。 每次迭代都触发的提醒不再有帮助,反而成为模型学会忽略的噪声。为防止这种情况,每种提醒类型由计数器或一次性标志管理,跟踪于按会话的 IterationContext 中(图 12 右列)。未完成待办提示最多触发两次(MAX_TODO_NUDGES = 2);错误恢复提示最多三次(MAX_NUDGE_ATTEMPTS = 3);计划已批准、所有待办完成、完成摘要信号各恰好触发一次。若智能体不响应已达上限的提示,系统接受智能体的判断并继续,而非循环。
采用 role: user 的理由。 提醒以 role: user 消息注入,而非 role: system。40 轮对话之后,又一条 system 消息会融入模型已部分遗忘的背景。user 消息出现在对话流中最近性最高的位置;模型将其视为刚刚发生的、需要响应的事情。早期用 role: system 注入的实验证实了这点:user 角色提醒产生了明显更高的遵从率。
优雅降级。 若提醒模板缺失或检索失败,智能体仍有其系统提示。提醒强化既有指令,不引入新指令。系统没有它们也能工作,但有它们明显工作得更好。
设计演进。 初始系统完全依赖系统提示。在长会话(30+ 次工具调用)中,智能体可靠地表现出注意力衰减失效:过早完成、探索循环、无法从错误恢复。添加即时提醒解决了每种失效模式。早期错误恢复用单一的通用"再试一次"消息;将错误分为六类并配具体引导大幅提高了恢复率——"重新读取文件"比"修复问题"更具可行动性。在一次性标志和尝试预算之前,有些提醒每次迭代都触发,导致智能体在提示本身上打转;守卫对稳定性必不可少。早期实验还以 role: system 消息注入提醒,效果较差,因为模型将其视为背景指令而非需要响应的对话提示。
2.3.5 上下文注入的错误恢复
工具调用失败时,原始错误消息作为工具结果进入对话。没有干预时,智能体常以道歉而非恢复尝试响应,因为错误消息本身并不传达如何恢复。基于模板的错误恢复通过将针对性恢复引导直接注入上下文窗口解决此问题,把错误消息变成模型可以遵循的可行动指令。
该机制分四步运作:(1) 通过模式匹配将错误归入六类之一(权限错误、文件未找到、编辑不匹配、语法错误、速率限制、超时);(2) 从集中式模板库检索相应恢复模板;(3) 用上下文特定细节(失败的文件路径、不匹配的内容、具体错误消息)格式化模板;(4) 将格式化后的模板作为系统消息注入,紧邻下一次 LLM 调用之前,置于对话最近性最高位置。例如,编辑不匹配错误产生引导:"文件自你上次读取后已变化;重新读取文件并以当前内容重试你的编辑。"这比通用的重试指令明显更具可行动性,因为它告诉模型什么变了和下一步做什么。
每段错误序列 3 次提示尝试的预算防止无限重试循环:对同一错误连续三次恢复尝试失败后,系统接受失败,允许智能体继续或向用户求助。模板以源代码之外的纯文本存储,使恢复策略可扩展(新错误类别只需添加模板,无需改代码)且可定制(用户可为项目特定的恢复模式覆盖模板)。
2.3.6 自适应上下文压缩
智能体在 ReAct 循环中运行时,工具观测(如文件内容和命令输出)不断累积,很快主导上下文窗口,经常消耗可用 token 预算的 70–80%。标准系统依赖二元的紧急压缩阈值(通常在 95–99% 容量触发),对对话历史执行有损摘要。这种方法导致激活过晚、严重信息丢失,以及后续压缩时的误差叠加。
为缓解这些问题,OpenDev 增量监控 token 用量——以 API 报告的 prompt_tokens 计数为校准锚点——并实现自适应上下文压缩(ACC):通过五阶段渐进激进削减策略流水线管理上下文压力的框架(图 13)。
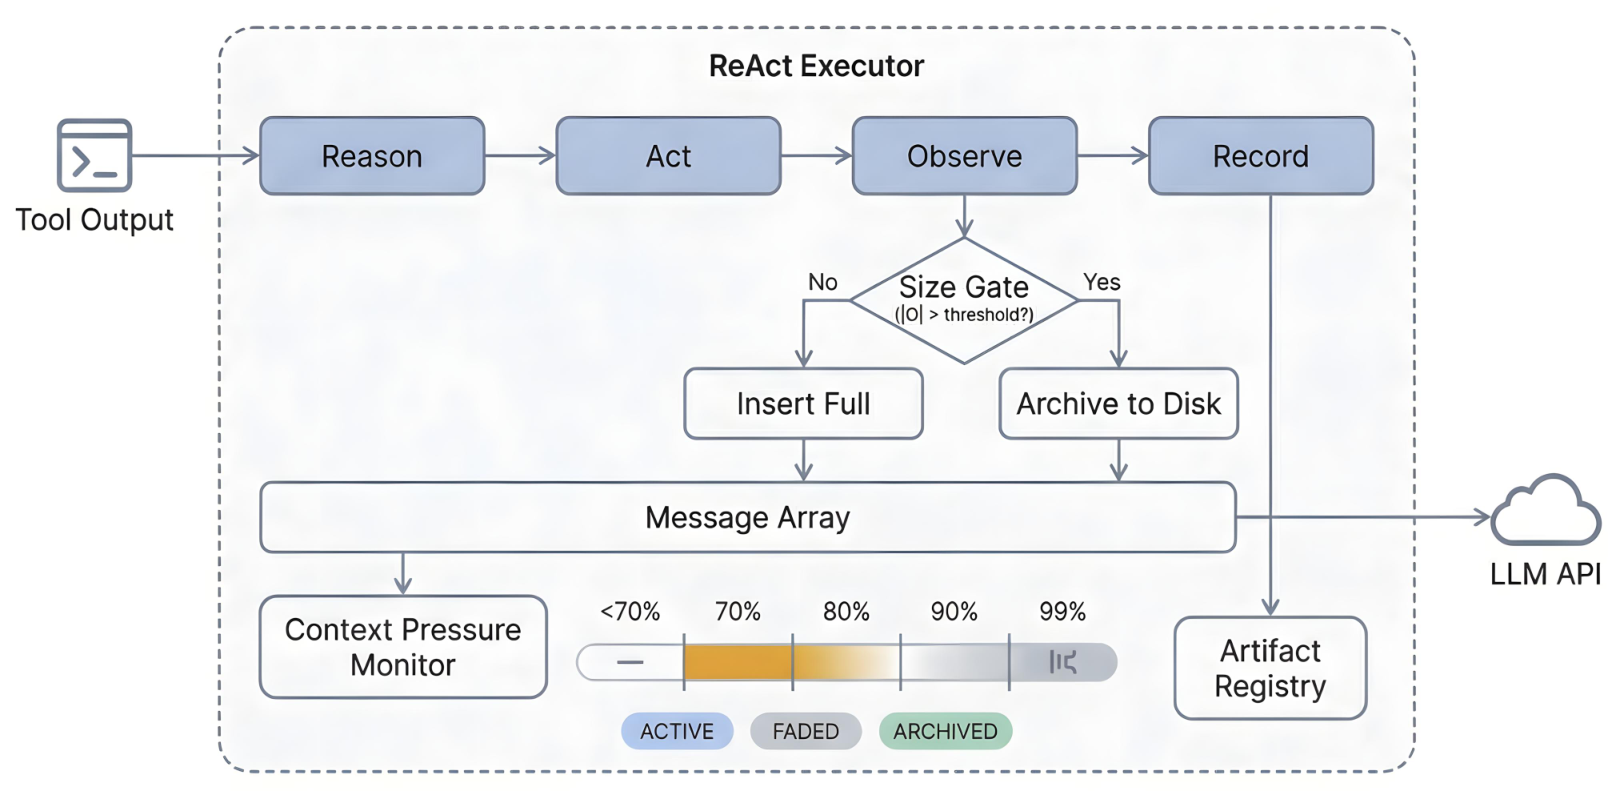
图 13:图 9 中压缩子系统的详图。 五个阶段在渐进压力阈值(70%、80%、85%、90%、99%)激活,使观测在活跃、淡化、归档状态之间转换,直到需要紧急摘要。
ACC 不等待上下文窗口填满,而是在每次 ReAct 迭代开始时监控上下文压力,应用五个渐进阶段:
- 阶段 1 - 警告(70%):记录上下文压力用于监控。不发生数据削减,但系统开始跟踪利用率趋势。
- 阶段 2 - 观测遮蔽(80%):较旧的工具结果消息被原位替换为紧凑的引用指针(如"[输出已卸载到暂存文件]"),保留 LLM API 要求的对话结构,同时将每个观测的 token 占用从数千降到约 15。最近的工具输出保持完整保真度。
- 阶段 2.5 - 快速修剪(85%):在诉诸激进遮蔽前,轻量修剪遍历工具结果消息向后回溯。受保护的新近预算内的结果被保留;更旧的结果替换为 [pruned] 标记。与观测遮蔽(替换为指向卸载文件的引用指针)不同,修剪是删除类操作(内容被丢弃而非卸载),但只针对远超新近窗口的输出。这比基于 LLM 的压缩便宜得多,且常回收足够空间,完全避免更具破坏性的阶段。
- 阶段 3 - 激进遮蔽(90%):保留窗口缩减到仅最近的工具输出。所有其他观测被遮蔽。
- 阶段 4 - 完整压缩(99%):整个对话历史序列化到暂存文件(确保历史细节不永久丢失),基于 LLM 的摘要器压缩对话的中间部分,同时逐字保留近期消息。
ACC 的压缩流水线还维护工件索引(Artifact Index)——会话期间触及的所有文件和执行的所有操作(读取、创建、修改、删除)的结构化注册表。该索引序列化进压缩摘要,确保智能体即使在上下文压缩后仍记得自己处理过哪些文件。历史归档路径也注入摘要(“完整对话历史已归档于 <路径>。如需恢复细节请使用 read_file。”),使压缩实际上无损:智能体可通过读取归档恢复任何细节。定量评估表明,ACC 将观测的峰值上下文消耗降低约 54%,在典型 30 轮会话中常常完全消除紧急压缩的需要。
自适应记忆。
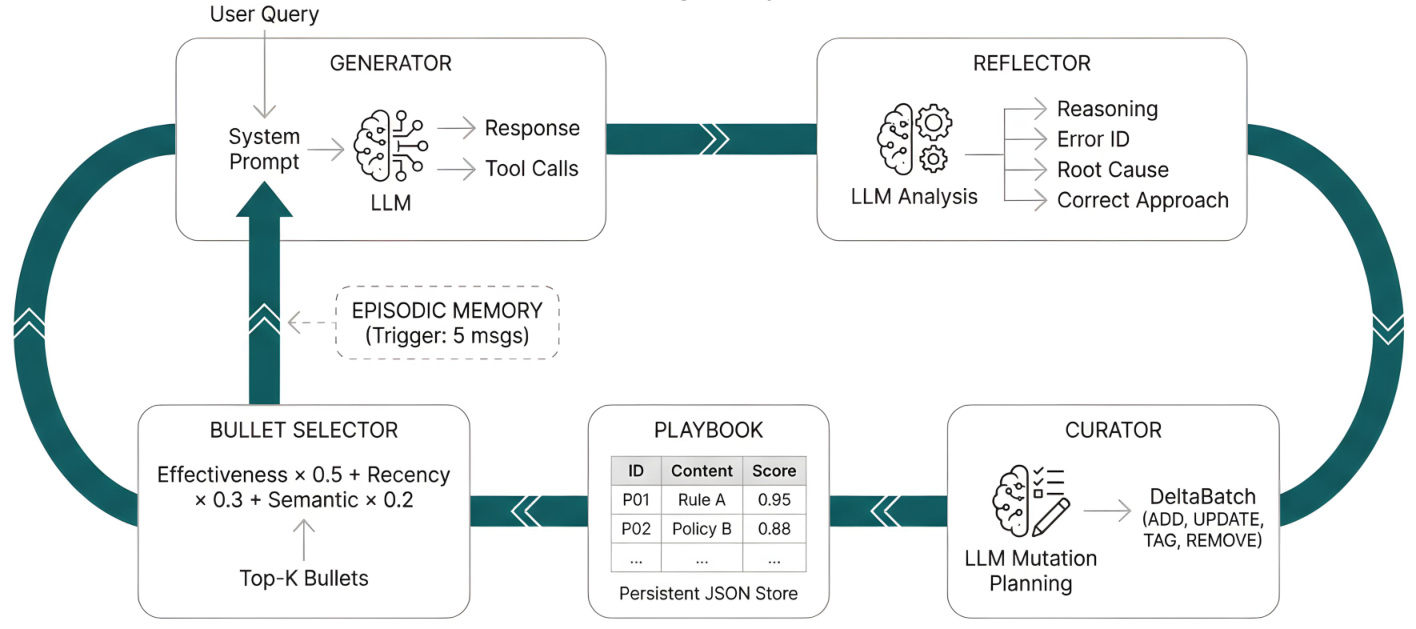
图 14:图 9 中记忆子系统的详图。 阶段 1:BulletSelector 按有效性、新近度和与当前查询的语义相似度为 playbook 条目打分,入选条目与用户查询一起注入生成器的系统提示。阶段 2:情景记忆机制每 5 条交互消息触发一次 Reflector;Reflector 分析累积的经验,产出推理轨迹、错误识别、根因分析和正确做法。阶段 3:Curator 阅读反思并规划具体的 playbook 变更(添加、更新、打标签或移除条目)。阶段 4:变更应用到 Playbook 的条目表,并持久化到会话作用域的 JSON 文件。
在项目中跨多个会话工作的智能体会积累关于哪些方法成功、哪些失败的经验。智能体上下文工程(ACE)子系统将这些经验捕获为 playbook:自然语言条目的集合,每条带有有效性计数器(helpful、harmful 或 neutral)和创建时间戳。图 14 展示了保持 playbook 更新的四阶段流水线。阶段 1,BulletSelector 按加权分数为每个条目排序——组合有效性(0.5)、新近度衰减(0.3)、经缓存嵌入的余弦相似度得出的与当前查询的语义相似度(0.2);排名靠前的条目注入生成器的系统提示,使智能体能依据先前经验行动。阶段 2由情景记忆机制管理:每 5 条智能体交互消息,系统激活 Reflector 分析累积的经验。Reflector 产出推理轨迹、错误识别、根因分析和正确做法,随后蒸馏为条目级有效性标签(helpful / harmful / neutral),不对 playbook 提出任何结构变更。阶段 3 的 Curator 阅读反思并规划具体变更:添加新条目、更新现有条目、重打有效性计数标签、移除陈旧条目——以 DeltaBatch 形式发出。阶段 4,变更应用到 Playbook 的条目表,更新后的状态持久化到会话作用域 JSON 文件,为下一查询周期就绪。
2.3.7 上下文检索与组装流水线
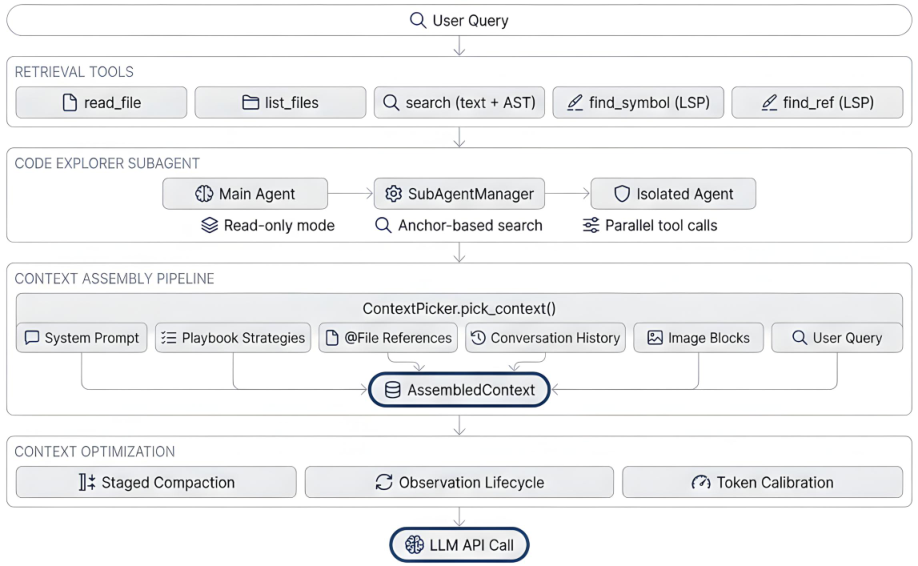
图 15:图 9 中检索与上下文组件的端到端综合。 四层将用户查询转换为完整组装的 LLM API 调用:(1) 检索工具收集原始代码工件;(2) Code Explorer 子智能体在隔离上下文中编排多步搜索;(3) 上下文组装器将检索到的材料与对话历史和系统指令合并;(4) 上下文优化器在最终 API 调用前通过分阶段压缩执行 token 预算。
上下文检索是编程智能体最重要的单一能力:每个下游动作(编辑、测试、规划)的质量都受限于智能体是否一开始就定位到了正确的代码。在传统 RAG 流水线中,检索是静态的、一次性的操作:嵌入查询、取回 top-k 文档、生成。这对同质语料上的事实问答效果尚可,但代码库根本不同。单个用户请求(“修复登录 bug”)可能需要交叉引用认证处理器、数据库模式、测试文件和配置模块——它们与查询都没有明显的词汇重叠。近期智能体式搜索(agentic search)研究表明,复杂环境中的有效检索要求智能体动态控制何时、检索什么、如何检索,将推理与搜索交织,而非把检索当作预处理步骤。OpenDev 通过一个四层流水线(图 15)将该原则落地到软件工程,从简单查找逐步升级到多步智能体式搜索,再到完整的上下文组装与优化。
第 1 层:基于锚点的检索工具选择。 五个工具构成检索面:read_file 用于定点文件访问,list_files 用于基于 glob 的发现,text_search(ripgrep)用于模式匹配,find_symbol 用于基于 LSP 的语义解析,ast_search(ast-grep)用于结构模式匹配(见 2.4.2 和 2.4.5 节)。核心设计问题不是提供什么工具,而是智能体如何在它们之间选择。朴素智能体对每次查找都默认文本搜索——类似于传统 RAG 中"检索一切"反模式的失效模式。有效检索始于识别查询中的最强锚点:约束搜索空间的最具体、最高信号元素。符号名(如 AuthController.validate)路由到 find_symbol,经 LSP 语义解析定义;字符串字面量和错误消息路由到 text_search,执行精确模式匹配;结构模式(如"所有检查 is_admin 的 Python if 语句")路由到 ast_search,匹配语言感知模板;文件路径约定路由到 list_files 做 glob 发现。通过将检索工具匹配到锚点类型,智能体避免嘈杂的低精度搜索,以更少步数到达相关代码。这是 Self-Ask 分解策略在编程智能体上的对应:智能体不用原始用户查询搜索,而是推理自己需要哪类信息,并相应选择检索机制。
第 2 层:经 Code Explorer 的多步智能体式搜索。 当智能体确切知道要找什么时,单工具检索足够;但许多任务需要探索式检索:智能体必须跟踪交叉引用、发现意外依赖、迭代缩小宽泛的搜索空间。这正是系统从静态工具调用过渡到智能体式搜索特有的"推理-检索交织循环"之处。当主智能体需要宽泛的代码库理解而非定点查找时,它委托给 Code Explorer 子智能体(2.2.7 和 2.4.8 节),后者在隔离上下文窗口中以只读模式访问同样的五个检索工具运行。子智能体自主执行多步搜索:可能先用 find_symbol 定位类定义,读文件发现其依赖,再用 text_search 追踪这些依赖在项目中的使用。每一步都由子智能体自己对"目前发现了什么、还需要什么"的推理引导,体现"检索与思维链交织"模式。上下文隔离至关重要:中间搜索结果(可能数千行代码)留在子智能体窗口中,只有蒸馏后的摘要返回主智能体。这防止检索过程本身消耗主智能体推理和行动所需的上下文预算。
第 3 层:上下文组装。 仅有检索到的代码工件不够;智能体还需要其行为指令、积累的经验和对话历史。每次模型调用前,ContextPicker 从六个有序来源组装最终消息列表:(1) 用自适应记忆(2.3.6 节)中选定 playbook 策略增强的系统提示;(2) 项目级和用户级持久规则;(3) 用户提供的内联 @file 引用和图像块;(4) 从 SessionManager 检索的对话历史;(5) 在决策点注入的系统提醒(2.3.4 节);(6) 当前用户查询。每块上下文包装在 ContextPiece 中,跟踪其来源(源子系统、优先级、token 成本),使下游组件在预算紧张时能做出知情的保留决策。组装结构由 ValidatedMessageList 验证,强制结构完整性(每条带工具调用的 assistant 消息必须在下一 user 轮次前跟有匹配的工具结果),并用合成错误占位符自动修复违规,而非直接失败。
第 4 层:上下文优化。 组装好的上下文经过 2.3.6 节描述的分阶段压缩流水线。观测遵循从活跃(近期,完整保留)到淡化(80% 阈值后可遮蔽)再到归档(序列化到磁盘并替换为引用)的生命周期。token 预算对照上一轮 API 报告的 prompt_tokens 校准,而非本地估计——纠正客户端不可见的提供商侧注入(安全前言、工具模式)。这最后的优化步骤确保无论检索和组装了多少上下文,提交给 LLM 的负载都尊重模型的上下文窗口,同时保留最具决策相关性的材料。
端到端流程。 四层形成的检索流水线映射智能体式搜索系统中的升级模式:简单查询在第 1 层以单次工具调用解决;复杂查询升级到第 2 层的多步搜索;所有结果汇聚到第 3 层组装;第 4 层执行 token 预算。这种渐进升级意味着直接查找(“读文件 X”)开销最小,而开放式探索(“认证系统如何工作?”)可利用完整的智能体式搜索循环,且成本不会渗入主智能体的上下文。
上下文工程层塑造模型看到什么;工具系统定义模型能做什么:智能体修改代码、运行命令、与开发环境交互的具体动作。
2.4 工具系统
智能体与开发环境交互的工具构成一个可扩展生态,在全面能力与上下文效率、安全与灵活、内置工具与动态发现之间取得平衡。附录 A 的表 1 提供全部 35 个内置工具的完整目录;本节的其余部分描述将它们组织为处理器类别的注册表架构,然后详述每个类别:文件操作、shell 执行、Web 交互、经 LSP 的语义代码分析、用户交互与任务管理、经 MCP 的外部工具发现、子智能体委托。纵深防御安全架构横跨所有类别。
2.4.1 注册表架构与模式构造
扁平的工具命名空间随能力增长变得难以管理:硬编码的分发逻辑不灵活,无结构的动态插件加载不安全。备选方案从硬编码工具集(简单但无法在不改代码的情况下增加能力)到扁平动态加载(灵活但混乱,导致命名空间冲突、缺乏组织、安全管理困难)。OpenDev 采用带处理器类别的注册表,将工具组织进带模式注册的处理器类。
三个分离的关注点。 图 16 展示了该架构。工具系统将模式构造、分发路由和生命周期钩子分离为不同组件。
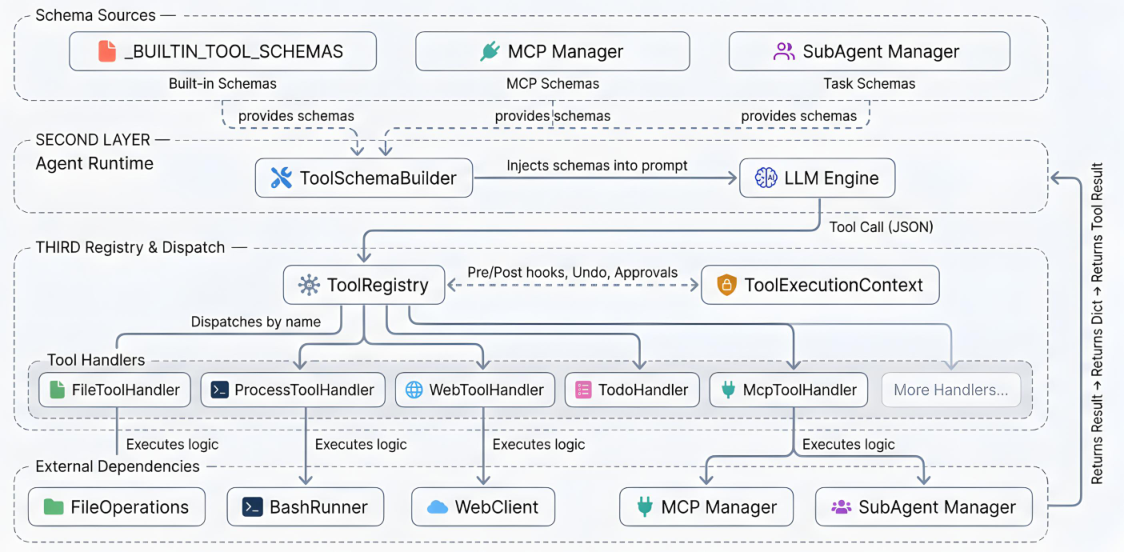
图 16:图 2 中工具层的展开图。 ToolSchemaBuilder 从三个来源(静态内置定义、动态发现的 MCP 工具、子智能体模式)组装 JSON 模式并注入 LLM 提示。ToolRegistry 将工具调用分发到基于类别的处理器,每个处理器接收带横切服务的 ToolExecutionContext。前/后生命周期钩子拦截调用,用于安全执行和可扩展性。
ToolSchemaBuilder 从三个来源组装 JSON 模式:(1) 静态 _BUILTIN_TOOL_SCHEMAS 定义约 40 个内置工具,描述经 load_tool_description() 从 markdown 模板加载;(2) 动态发现的 MCP 模式——仅包含 _discovered_mcp_tools 集合中的工具,避免上下文膨胀;(3) SubAgentManager 在场时注入的子智能体模式。组装好的模式注入 LLM 提示,使模型知晓可用能力。
ToolRegistry 作为中央分发器,将工具名映射到按类别组织的 12 个处理器类的处理方法(文件、进程、Web、笔记本、用户交互、任务管理、思考、MCP 发现、批量执行;完整映射见附录 A 表 1)。每个处理器接收打包横切服务的 ToolExecutionContext:模式管理器、审批管理器、撤销管理器、任务监控器、会话管理器、UI 回调和文件时间跟踪器。注册表执行模式限制:在规划模式中以信息性错误阻止写操作,然后再分发到处理器。
生命周期钩子无需修改处理器代码即可提供可扩展性。钩子系统定义十个生命周期事件(SESSION_START、USER_PROMPT_SUBMIT、PRE_TOOL_USE、POST_TOOL_USE、POST_TOOL_USE_FAILURE、SUBAGENT_START、SUBAGENT_STOP、PRE_COMPACT、SESSION_END、STOP),覆盖从会话初始化到关闭的完整智能体生命周期。PreToolUse 钩子在执行前同步触发:返回退出码 2 的钩子硬阻塞工具调用,向模型返回错误——任何提示工程或审批配置都无法覆盖。钩子也可通过返回带 updatedInput 字段的 JSON 对象改写工具参数,实现透明的命令重写(如注入 --dry-run 标志)。PostToolUse 和 PostToolUseFailure 钩子在执行后经线程池异步触发,适合审计和日志而不拖慢智能体。注册为钩子的外部脚本以 JSON 形式从 stdin 接收完整事件上下文(包括会话 ID、工作目录、工具名、工具输入,以及后钩子的工具响应),支持项目特定策略,如阻止对受保护路径的写入、强制命名约定、将审计日志流式发送到外部系统。钩子匹配器对工具名使用编译后的正则模式,允许从单工具规则到全捕获策略的细粒度定向。
设计演进。 早期版本在全局命名空间直接注册工具,导致命名冲突和复杂的按工具安全配置。基于类别的处理器同时解决两者:安全规则应用在类别级别,每个类别提供隐式命名空间。
运行时审批。 任何工具调用到达其处理器前,运行时审批系统基于用户配置的信任边界门控执行。三个自治级别控制默认姿态:**手动(Manual)**要求每个工具调用显式批准;**半自动(Semi-Auto)**自动批准只读操作(精选命令白名单,如 ls、cat、git status),写操作则提示;**自动(Auto)**为受信工作流批准所有操作。除默认级别外,ApprovalRulesManager 针对优先级规则集评估每条命令,含四种规则类型:Pattern(对完整命令字符串正则匹配)、Command(精确匹配)、Prefix(前缀匹配,如 git 匹配 git push)、Danger(正则匹配并自动拒绝)。优先级 100 的默认危险规则(匹配 rm -rf /、rm -rf *、chmod 777 等模式)始终激活,不能被用户配置或审批级别变更覆盖。规则按优先级顺序评估;首个匹配决定动作(自动批准、自动拒绝、要求审批,或要求用户编辑命令后执行)。
审批规则经两个 JSON 存储跨会话持久化:用户全局规则 ~/.opendev/permissions.json 和项目作用域规则 .opendev/permissions.json。两者并存时,同一模式的项目规则优先,实现按仓库的信任边界(如共享项目可限制用户个人配置允许的 docker 命令)。审批流程适配活动前端:TUI 呈现带键盘导航的阻塞式 prompt_toolkit 菜单;Web UI 广播 approval_required WebSocket 事件并以 300 秒超时轮询线程事件,在浏览器中渲染审批对话框。每个审批决定(命令、所采取动作、匹配规则、时间戳)记录在 CommandHistory 中以供审计。
2.4.2 文件操作
五个工具处理所有文件系统交互(见表 1 文件操作类别),从读写到结构化编辑和搜索。它们共同构成智能体操纵代码的主要手段。
read_file:带行号的文件读取。 以 cat -n 风格行号读取文件内容,为智能体后续编辑提供精确位置引用。三个参数控制读取窗口:file_path(必需)、offset(1 基行起点,默认 1)、max_lines(默认 2000)。处理器在将内容返回智能体前应用若干输出变换:
- 二进制检测:非文本文件被检测并以描述性错误拒绝,而非返回损坏的字节序列。
- 输出截断:超过 30,000 字符的内容用头尾策略截断,保留前 10,000 和后 10,000 字符,中间放截断标记。这确保智能体看到长文件的开头(导入、类声明)和结尾(近期添加)。
- 按行截断:超过 2,000 字符的单行被截断,防止压缩代码或数据文件消耗过多上下文。
- 陈旧读取跟踪:FileTimeTracker 记录每次读取的时间戳。跟踪器在每次成功读取时以 (session_id, file_path) 为键记录
datetime.now()。任何编辑前,assert_fresh()验证os.path.getmtime(file_path) ≤ read_time + 50ms——50ms 容差适应文件系统时间戳粒度(FAT32 以 2 秒为界取整;NTFS 和 ext4 提供亚毫秒精度,但网络文件系统引入抖动)。断言失败时,编辑被拒绝并指示智能体重读文件,防止静默覆盖并发的用户编辑。每个文件路径的 threading.Lock 串行化对同一文件的并发写尝试。
write_file:新文件创建。 仅创建新文件——拒绝覆盖现有文件的尝试,引导智能体改用 edit_file。该约束防止意外的全文件覆盖——这是智能体凭记忆重建文件而非施加定点编辑时的常见失效模式。参数:file_path、content、create_dirs(设置时自动创建父目录)。处理器对写操作运行审批工作流,向撤销管理器记录动作以支持回滚,成功时返回文件路径和字节数。
edit_file:9 遍模糊匹配。 当基于 LLM 的智能体编辑文件时,它指定要查找的 old_content 和用于替换的 new_content。实践中,LLM 经常产生与实际文件略有差异的 old_content:尾随空白差异、缩进不匹配、转义序列差异,或凭记忆而非逐字复制重建代码时的细微重排。严格精确匹配的编辑工具会在这些情况失败,产生"内容未找到"错误,用错误消息和恢复尝试消耗上下文。
编辑工具以责任链模式实现九个替换器类,各自解决一类特定不匹配——从精确匹配到空白规范化、缩进灵活、转义处理、上下文感知锚点匹配(附录 D 列举全部九遍及说明)。每个替换器返回在原文件中实际找到的子串(而非搜索查询),使替换保留文件原始格式。调试日志记录哪一遍成功。链条在首次匹配时短路,因此精确匹配不会因模糊遍产生任何开销。
除匹配外,编辑处理器执行若干安全和可观测措施:陈旧读取验证拒绝编辑自智能体上次读取后被修改的文件;唯一性验证确保匹配无歧义——多个匹配产生错误而非静默误编辑;创建备份状态用于撤销跟踪。编辑成功后,处理器调用 lsp.touch_file(filepath) 通知运行中的语言服务器变更,然后(去抖后)最多等待 3 秒获取诊断。只包含 Error 严重级诊断;警告和提示被抑制以避免上下文噪声。最多 20 条诊断作为结构化反馈附加到工具输出(如"LSP 检测到错误:第 42 行:未定义变量 ‘foo’"),给智能体即时反馈,使其能在同一轮自我纠正。若文件类型没有运行中的 LSP 服务器,检查被静默跳过。生成统一 diff 展示给用户。
list_files:目录列举与 glob 搜索。 列出目录内容或执行基于 glob 的文件搜索。参数:path(要列举的目录)、pattern(过滤的 glob 表达式)、max_results(默认 100)。结果以显示目录结构的树形展示。常见忽略模式默认排除:node_modules、.git、__pycache__、.venv、.DS_Store 及其他平台特定产物。输出上限 500 条目,防止大型仓库导致上下文溢出。
search:双模式内容搜索。 支持两种互补的搜索模式。type="text" 时,工具委托 ripgrep 做高性能正则内容搜索,支持可配置上下文行和完整 PCRE2 模式语法。type="ast" 时,工具委托 ast-grep 做结构代码搜索,使用带 $VAR 通配符的语言感知模式模板(如 if $COND: $BODY 匹配任何 Python if 语句,无论具体条件或主体内容)。参数:pattern(正则或 ast-grep 模板)、path(搜索根)、type(“text” 或 “ast”)、lang(ast 模式的语言提示)。结果上限 50 个匹配、总输出 30,000 字符。
设计演进。 最初的编辑工具用两遍策略(精确匹配,然后剥离空白匹配)。这是"内容未找到"错误的最大单一来源。分析失败日志发现,LLM 格式漂移落入不同且可预测的类别(空白规范化、缩进偏移、转义序列差异、部分上下文锚定),每类都可由针对性匹配遍解决。将该观察推广为带九个渐进放宽替换器的责任链架构,解决了绝大多数编辑失败,同时通过短路评估保持精确匹配的性能。
2.4.3 Shell 执行与后台任务
四个工具处理 shell 执行和后台任务管理(见表 1 进程类别)。智能体需要为测试、构建和系统交互运行任意 shell 命令,但必须安全执行;开发服务器等长时间运行的进程需要带输出捕获的后台执行。
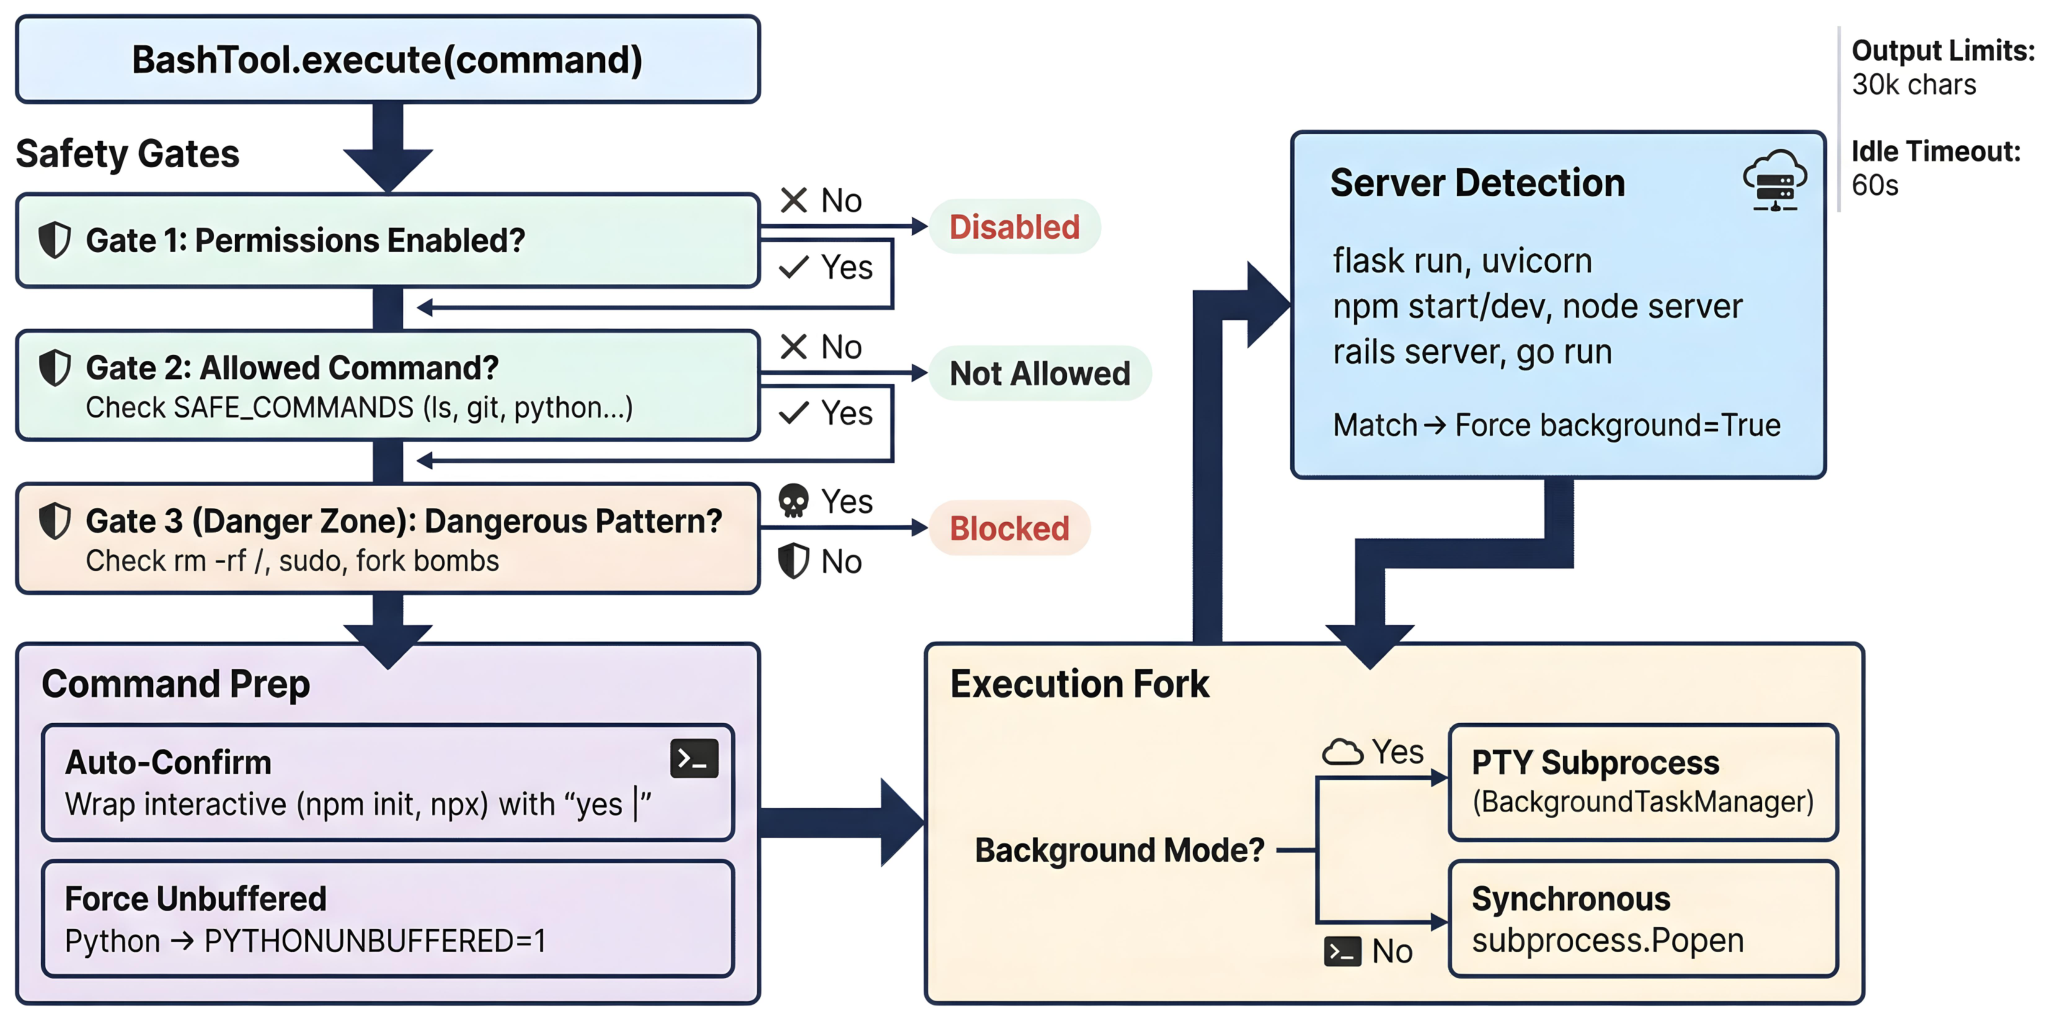
图 17:进程处理器的详细流水线(图 16)。 命令经过三道安全门(权限配置、允许命令匹配、危险模式阻止),然后命令准备(自动确认、无缓冲 Python)、服务器检测(对 16 个模式正则匹配以自动提升为后台)、执行分叉(基于 PTY 的后台或管道前台,带进程组隔离)、输出管理(30k 字符上限,头尾截断,100ms 轮询)、超时/中断处理(60 秒空闲、600 秒绝对、InterruptToken 集成)。
run_command:六阶段 shell 执行。 图 17 展示了将每条 shell 命令处理经过六个阶段的流水线:(1) 安全门,不可覆盖地阻止危险模式;(2) 命令准备,自动确认包管理器提示并无缓冲 Python 输出;(3) 服务器检测,对 16 个框架模式正则匹配(E.2 节),自动将长时服务器提升为后台模式;(4) 执行分叉,在基于 PTY 的后台与带进程组隔离的管道前台之间选择;(5) 输出管理,30k 字符头尾截断和 100ms 轮询;(6) 超时处理,60 秒空闲和 600 秒绝对上限。附录 E 提供完整的逐阶段细节和完整服务器模式表。
提升为后台的命令注册到 BackgroundTaskManager,分配 7 字符十六进制 ID(来自 uuid4().hex[:7],提供约 2.68 亿唯一值)。注册创建任务记录,在 /tmp/opendev/{sanitized-dir}/tasks/{id}.output 打开输出文件,写入前 20 秒捕获的初始启动输出,并派生守护线程经 select.select() 轮询持续将 PTY 输出流式写入文件。任务在四个状态间转换:RUNNING → COMPLETED(退出码 0)、FAILED(非零退出)或 KILLED(经信号)。监听器回调将每次状态转换通知 UI,在 TUI 页脚实现实时状态显示。
list_processes:后台任务列举。 返回所有被跟踪的后台任务及其 PID、状态(running/completed/failed/killed)和墙钟运行时间。这让智能体看到哪些进程在活动,能检查长时服务器、识别停滞的构建或确定哪些任务需要关注。
get_process_output:任务输出检索。 按任务 ID 从后台任务的输出文件检索最后 100 行,让智能体无需重跑命令即可访问服务器日志、构建输出和错误消息。这对监控开发服务器、检查后台运行的测试结果、诊断长时进程失败必不可少。
kill_process:优雅进程终止。 用渐进升级终止运行中的后台任务:经 os.killpg() 向整个进程组发送 SIGTERM,等待 5 秒优雅关闭,进程仍在运行则升级为 SIGKILL。守护输出线程收到停止信号,PTY 主文件描述符关闭。进程组杀死确保命令派生的子进程(如 webpack 开发服务器派生的文件监视器)随父进程一起终止。
设计演进。 最初实现用带固定超时的 subprocess.run()。开发服务器总是撞超时被杀。基于活动的空闲超时解决了服务器问题,基于 PTY 的执行解决了输出缓冲问题——程序直到进程终止才产生可见输出。
2.4.4 Web 交互
四个工具提供 Web 交互能力(见表 1 Web 类别),用于文档研究、内容检查和基于浏览器的测试。所有 Web 工具只读,可安全用于规划模式。
fetch_url:浏览器引擎网页抓取。 使用 Crawl4AI——基于 Playwright 构建的浏览器引擎爬取库——检索 Web 内容。浏览器引擎方法处理简单 HTTP 客户端会遗漏的 JavaScript 渲染内容(单页应用、动态加载的文档)。HTML 转换为 markdown 供 LLM 以上下文高效的方式消费。输出上限 50,000 字符,每页 30 秒超时。文件下载被阻止,防止磁盘滥用。
多页探索时,工具支持三种可配置策略的深度爬取:广度优先(BFS)、深度优先(DFS)或最佳优先(按内容相关性排优先级)。参数控制最大爬取深度、页面上限和域名过滤,防止爬出目标站点。Playwright Chromium 首次使用时自动安装,安装在该工具首次调用时透明触发。
web_search:尊重隐私的搜索。 经 DuckDuckGo 搜索 Web——因其尊重隐私的设计(无用户跟踪或搜索历史保留)而被选用。最多返回 10 条结果,每条含标题、URL 和文本摘要。域名过滤允许将结果限制到特定站点(如只搜索官方文档域名)。工具返回结构化结果,智能体可随后用 fetch_url 跟进获取完整内容。
capture_web_screenshot:可视化页面捕获。 经 Playwright 无头浏览器拍摄整页截图。可配置视口尺寸(默认 1920×1080)允许在不同响应式断点捕获页面。可选 PDF 输出模式产生分页文档。对 JavaScript 初始化繁重的复杂页面,超时可延长至 180 秒。返回截图文件路径,智能体可在后续分析中引用或展示给用户。
open_browser:系统浏览器启动。 经平台原生命令在系统默认浏览器中打开 URL 或本地文件。本地文件路径自动转换为 file:// URI。该工具弥合智能体无头环境与用户可视化工作流之间的鸿沟,适合预览生成的 HTML、审查开发中的 Web 应用,或打开需要智能体无法提供的认证的文档链接。
设计演进。 最初实现用 requests 库的简单 HTTP 请求,在主导现代文档和 Web 框架的 JavaScript 渲染单页应用上失败。切换到带 Playwright 浏览器引擎的 Crawl4AI 解决了此问题,在内容提取前实现完整 DOM 渲染。
2.4.5 经 LSP 的多语言语义代码分析
六个工具经 LSP 提供多语言语义代码分析(见表 1 Symbols 类别),分为两个只读导航工具和四个结构编辑工具。基于文本的工具能搜索字符串但遗漏语义结构:查找方法的所有用例需要区分方法调用与变量名、处理重载、跨文件跟踪引用。为每种语言构建自定义解析器不可行,因此 OpenDev 采用经标准语言服务器的 Language Server Protocol 集成,复用每个服务器由领域专家维护的成熟生态。
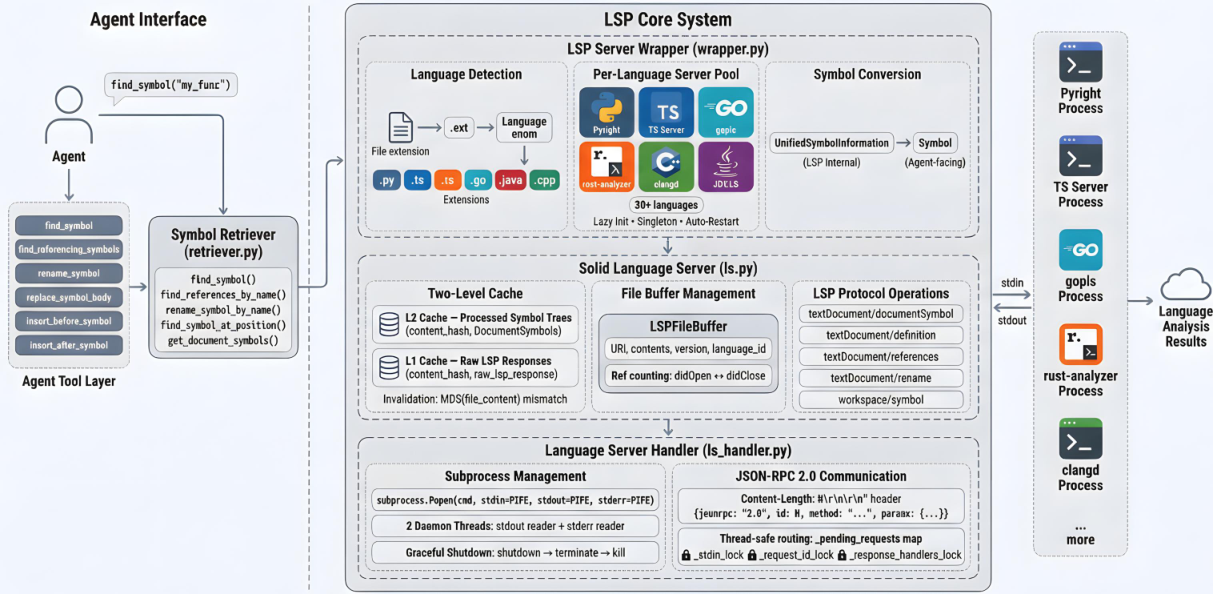
图 18:Symbols 处理器的详细架构(图 16)。 系统组织为四层:智能体工具层(六个符号工具)、Symbol Retriever(统一 API)、LSP Server Wrapper(语言检测、按语言服务器池、符号转换)、Solid Language Server(两级缓存、文件缓冲管理、LSP 协议操作)。Language Server Handler 管理子进程生命周期和与外部语言服务器进程的 JSON-RPC 2.0 通信。语言检测将 30+ 文件扩展名映射到相应服务器,服务器在首次查询时惰性启动并在后续请求间复用。
四层 LSP 抽象。 图 18 展示了组织为四层的架构,在面向智能体的工具调用与语言服务器特定协议消息之间逐级转换。智能体工具层暴露下述六个工具;每个接受文件路径和符号名,语言检测、服务器选择和协议转换由下层透明处理。Symbol Retriever 提供统一 API,用 NamePathMatcher 将符号名解析为位置,支持精确匹配(MyClass.method)、部分路径匹配(method 匹配路径以 .method 结尾的任何符号)和通配符匹配(My* 匹配 MyClass、MyModule)。LSP Server Wrapper 处理语言检测(30+ 文件扩展名;见图 18)和经单例池的服务器生命周期:每种语言一个服务器,惰性启动,自动活性检查,崩溃后透明重启。Solid Language Server 通过经 stdio 以 JSON-RPC 2.0 通信的子进程处理器管理底层 LSP 协议,每个服务器两个守护线程负责 I/O、线程安全的请求 ID、可配置的按请求超时。每个语言服务器扩展共同基类并做语言特定覆盖(初始化参数、忽略目录、跨文件引用等待时间),使新语言可通过放入一个服务器类来添加,无需修改核心框架。
为避免冗余 LSP 往返,每个语言服务器维护以文件内容哈希(MD5)为键的两级缓存。第 1 级缓存原始 LSP 响应;第 2 级缓存带父子关系和主体预览的处理后符号树。文件未变时,查询从第 2 级返回而不联系服务器。文件已变但原始响应模式未变时,仅从缓存的第 1 级数据重算第 2 级。缓存存储使用 pickle 序列化,位于项目的 .solidlsp/cache/<language_id>/ 目录,带版本字段确保不兼容缓存被丢弃。
find_symbol:符号定义查找。 参数:symbol_name(支持限定名如 MyClass.method、部分匹配和通配符)、可选 file_path 限定搜索范围。返回符号定义,含种类(函数、类、变量等)、位置(文件、行、列)、名称路径(如 module.Class.method)和主体预览(前 200 字符)。存在多个匹配时全部返回并附完整路径,让智能体消歧。
find_referencing_symbols:跨文件引用搜索。 参数:symbol_name、file_path(定义处)、include_declaration(是否包含定义本身)。语义地查找所有引用(调用、导入、类型标注),按文件分组。用于重构前的影响分析,以及理解符号在代码库中的消费方式。
rename_symbol:工作区范围语义重命名。 参数:symbol_name、file_path、new_name(验证为合法标识符:字母或下划线开头,只含字母数字字符)。以逆序(每个文件内自下而上)应用 LSP 服务器 textDocument/rename 返回的工作区编辑,使较早编辑不会移动后续编辑的行号。只重命名代码引用;字符串和注释保持不变。
replace_symbol_body:保留签名的重写。 参数:symbol_name、file_path、new_body、preserve_signature(默认 true)。检测主体边界(Python 的冒号,类 C 语言的开花括号),只替换主体,保持签名、装饰器和文档字符串完整。这使智能体能重写函数实现而不意外改变其公开接口。
insert_before_symbol 与 insert_after_symbol:定位代码插入。 参数:symbol_name、file_path、content。在匹配缩进级别向命名符号前或后插入内容,以空行分隔。适合在相关代码旁添加方法、在调用者附近插入辅助函数、或将测试用例放在其所测函数旁边。
设计演进。 最初方案考虑用 tree-sitter 语法构建自定义 AST 分析。tree-sitter 提供快速增量解析,但缺乏语言服务器的语义理解:类型解析、跨文件引用跟踪、工作区范围重命名。LSP 集成利用每个语言服务器由领域专家维护的成熟生态,按需的服务器生命周期确保资源消耗随实际使用而非支持语言数量扩展。
2.4.6 用户交互、任务管理与规划
八个工具实现用户交互、任务管理和基于计划的工作流(见表 1 任务管理、用户输入、规划和完成类别)。它们构成系统的人在环骨架,确保智能体能收集需求、报告进度,并在关键决策点获得批准。
ask_user:结构化多选问题。 每次调用最多呈现四个问题,每个问题采用为高效用户交互设计的结构化格式。每个问题包括:头部标签(最多 12 字符,显示为紧凑的芯片/标签便于视觉扫描)、2–4 个各带标签和说明含义描述的选项、可选的 multiSelect 标志用于非互斥选择。每个问题自动附加带自由文本输入的"其他"选项,确保用户永不受限于智能体提议的选项。
渲染适配活动 UI:TUI 以带键盘导航的模态对话框呈现问题;Web UI 用基于轮询的调查组件,智能体线程阻塞直到用户经 WebSocket 提交响应。这种带超时的阻塞设计确保智能体等待用户输入,而不消耗 CPU 或带着假设前进。
任务跟踪(write_todos、update_todo、complete_todo、list_todos):轻量看板任务列表。 四个工具管理跨智能体迭代持久化的轻量看板式任务列表:
- write_todos:从结构化定义创建或替换整个任务列表。每个任务有标题、描述和状态(todo、doing、done)。
- update_todo:按数字 ID、标题或 slug 修改现有任务。强制约束:同一时间最多一个任务为"doing"状态——将新任务设为"doing"自动将先前活动任务退回"todo"。
- complete_todo:将任务标记为完成,附可选的完成日志消息记录完成了什么。
- list_todos:返回按状态优先级排序的所有任务:doing 在前,然后 todo,然后 done。该排序确保智能体的注意力被引向活动和待办工作。
present_plan:计划审查与批准。 读取计划文件(智能体在规划模式写入),向用户展示其内容,并在进入实现前请求显式批准。用户以三种结果之一响应:
- approve_auto:批准计划并自动批准实现它的所有后续编辑,为受信计划最小化审批摩擦。
- approve:批准计划,但在实现期间逐个审查每次编辑,保持细粒度控制。
- modify:带反馈拒绝,提供智能体在重新展示前应纳入的具体修改。
批准后,计划步骤自动提取到待办列表,创建结构化执行跟踪器,智能体用它有条理地实现每一步并报告进度。
task_complete:显式完成信号。 表明智能体已完成当前任务,提供摘要消息和成功/失败状态。该工具承担关键架构角色:给 ReAct 执行器一个结构化终止信号,将有意完成与迭代耗尽(达到最大迭代限制)区分开。没有该工具,智能体要么循环到被切断,要么产生非结构化的最终消息,使系统难以判断任务是否真的完成。
设计演进。 早期版本缺乏结构化用户交互;智能体输出难以可靠解析的自由文本问题。引入带类型化选项和描述的结构化多选格式改善了响应质量、减少误解,并使 UI 能在 TUI 和 Web 两种界面渲染一致的调查式对话框。
2.4.7 经 MCP 的 token 高效外部工具发现
一个工具——search_tools——经模型上下文协议(MCP)提供 token 高效的外部工具发现(见表 1 Discovery 类别)。经搜索发现的外部工具随后经 McpToolHandler 调用,后者将调用分发到相应服务器。核心问题是上下文效率:有 100 个外部工具、每个模式平均 200 token 的系统,仅工具定义就消耗 20,000 token。包含所有模式是浪费;完全排除外部工具又限制能力。OpenDev 采用惰性发现:工具通过关键词搜索按需发现,只有已发现工具的模式才包含在上下文中。
图 19 展示了三组件交互。系统集成 MCP 实现动态工具连接。用户经管理命令配置外部工具服务器(数据库客户端、API 服务等)。系统维护已发现工具集合,只包含显式搜索过或先前调用过的工具的模式。初始上下文包含零个外部工具模式。智能体调用 search_tools(如查询"database query tools")时,SearchToolsHandler 从所有已注册 MCP 工具名和描述构建词汇表,提取关键词(3 字符及以上的 token),用词汇匹配对每个工具相对查询打分。顶部匹配带名称和描述返回给 LLM。ToolRegistry 随后经 discover_mcp_tool() 将匹配工具标记为已发现,将其模式加入已发现集合,下一次 LLM 调用即包含它们。以限定名直接调用 MCP 工具(如 mcp__github__create_issue)会无需事先搜索即自动发现它。McpToolHandler 将调用转发到相应外部服务器,管理序列化和错误处理。
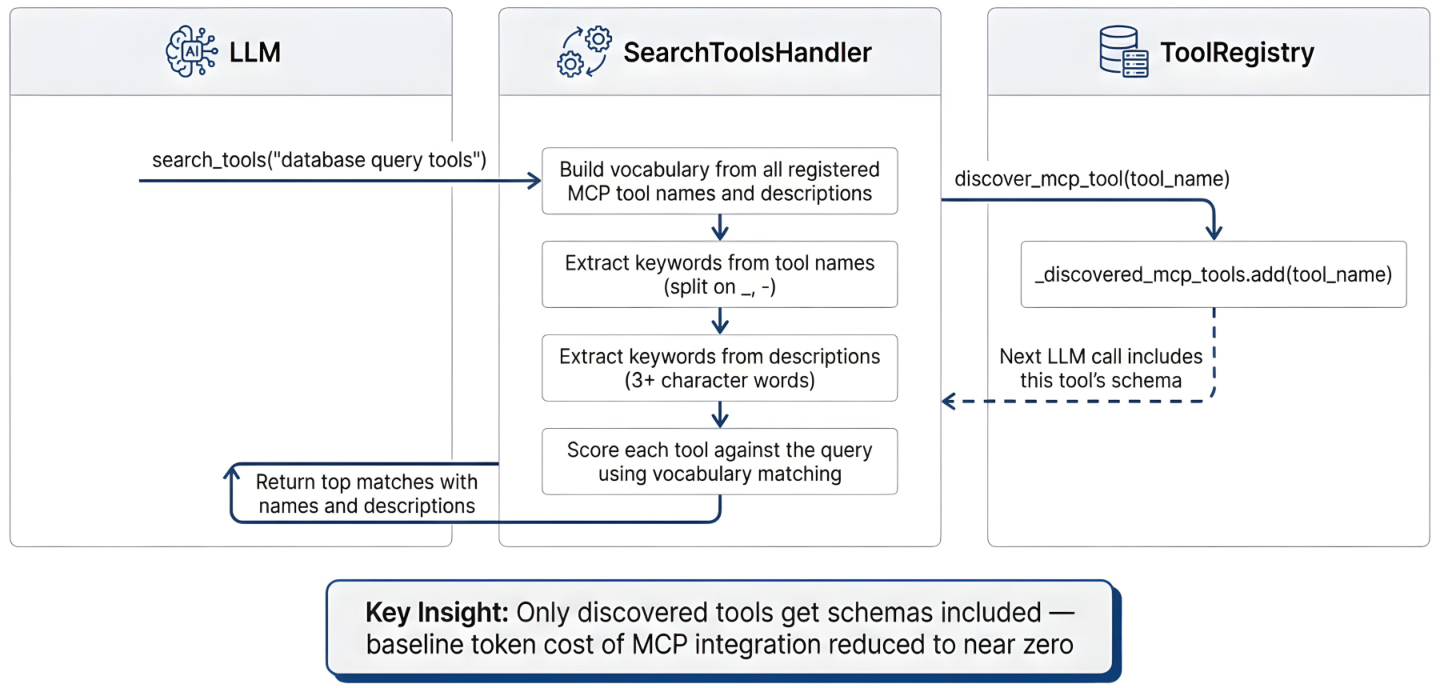
图 19:工具层内的时序(图 16)。 LLM 发起带自然语言查询的 search_tools 调用。SearchToolsHandler 从所有已注册 MCP 工具名和描述构建关键词词汇表,对每个工具相对查询打分,返回顶部匹配。ToolRegistry 将匹配工具标记为已发现,在后续 LLM 调用中包含其模式。只有已发现工具产生模式成本,将 MCP 集成的基线 token 开销降到接近零。
search_tools:关键词打分的工具发现。 三个细节级别控制上下文投入:names 只返回工具名(最少 token);brief 增加短描述;full 触发后续 LLM 调用中的完整模式包含。名称匹配得 2 分,描述匹配得 1 分;结果按总分排序,最相关的工具排在最前。这以发现开销(智能体必须先搜索再调用)换取上下文节省(只加载相关工具)。对使用少量外部工具的工作流,节省可观;对使用很多的工作流,开销累积但仍有界。
设计演进。 最初实现在每次调用中包含所有外部工具模式,在第一条用户消息前就消耗 40% 的上下文。惰性发现将基线开销降到接近零(<5%),只随能力实际使用增长。
2.4.8 子智能体委托、技能与批量执行
本节描述三个将智能体能力扩展到单工具调用之外的工具:用于复杂子任务的子智能体委托、用于按需领域专长的技能加载、用于多工具效率的批量执行。
经 spawn_subagent 的子智能体委托。 启动带自己的 ReAct 循环和过滤工具注册表的隔离子智能体。八种子智能体类型各自将可用工具限制到其领域:Code-Explorer(只读导航)、Planner(读 + 写计划文件)、PR-Reviewer(带 diff 分析的代码审查)、Security-Reviewer(漏洞扫描)、Web-Clone(网站复刻)、Web-Generator(从规格创建站点)、Project-Init(脚手架生成)、Ask-User(仅 UI 的结构化调查)。工具隔离确保子智能体不会意外相互干扰或超出预定范围。附录 G 提供完整的按子智能体工具列表能力矩阵。
一个关键设计性质是自动并行化:主智能体在同一 LLM 响应中发出多个 spawn_subagent 调用时,SubAgentManager 经 asyncio.gather() 并发执行它们,每个子智能体在单独线程中以自己的迭代预算和工具工作池运行。这使智能体能自然地扇出工作(如并行"调查认证模块"和"审查数据库模式"),无需显式并发管理。
附加参数提供灵活性:模型覆盖(haiku 用于快速低成本任务;sonnet 用于均衡能力;opus 用于复杂推理)、后台执行(智能体不等待完成而继续)、按智能体 ID 恢复会话(支持上下文跨调用保留的多轮子智能体工作流)。
经 invoke_skill 的按需技能。 技能是存储为带 YAML frontmatter 的 markdown 文件的模块化知识单元,提供领域特定专长(git 约定、代码审查清单、部署流程)——若无条件加载会浪费上下文。系统分两阶段处理技能:
- 阶段 1:元数据发现。 启动时,SkillLoader 扫描所有技能目录,只解析 YAML frontmatter 提取名称和描述。该轻量索引包含在系统提示中,使智能体能发现可用专长而不加载指导内容。描述遵循"Claude 搜索优化"约定,每条以"Use when…“开头指定触发条件(如"Use when writing bash scripts that need to wait for external conditions”),为智能体可发现性优化。
- 阶段 2:按需加载。 智能体判断技能相关时,以技能名调用 invoke_skill。加载器读取完整 markdown 内容,剥离 frontmatter,将指导正文注入对话上下文。去重缓存确保每个技能每会话最多加载一次,防止冗余调用造成上下文污染。
技能从三层发现,优先级严格排序:项目本地(.opendev/skills/,最高优先级)用于仓库特定约定,用户全局(~/.opendev/skills/)用于跨所有项目的个人偏好,内置(随包发布,最低优先级)用于默认专长。两个技能同名时,更高优先级来源优先,使项目特定覆盖默认行为成为可能。
经 batch_tool 的批量执行。 在单个智能体轮次中启用多个工具调用,减少往返开销。智能体指定执行模式:parallel(最多 5 个并发工作线程的线程池)用于独立操作,如读多个文件或运行多个搜索;serial 用于依赖操作,如先创建目录再写入文件。由智能体指定模式,因为只有它从上下文知道依赖关系——系统无法可靠推断操作是否独立。曾尝试自动依赖检测,但证明不可靠;由掌握完整上下文的一方显式指定模式干净地解决了此问题。
设计演进。 最初设计没有批量执行;每个工具需要完整 LLM 往返,多个文件读取占多个轮次。技能原本在启动时加载,在会话从未使用的专长上消耗上下文。子智能体最初顺序运行,即使任务独立。当前架构解决了全部三个问题:批量执行消除不必要的往返;两阶段技能加载将基线开销降到紧凑的元数据索引;子智能体调用的自动并行化利用任务独立性,无需智能体显式管理并发。
上述工具产生工件和副作用;持久化层确保它们跨会话存活,并在智能体犯错时提供回滚。
2.5 持久化层
持久化层用磁盘上的普通文件存储对话历史、配置、模型元数据和文件操作日志:结构化数据用 JSON,追加密集的流用 JSONL(每行一个 JSON 对象),追求简单处用纯文本。不需要外部数据库。
所有持久状态位于两个根目录下。用户全局状态(设置、缓存、已安装插件)放在 ~/.opendev/。项目作用域状态(会话记录、项目特定设置)放在从项目路径派生的子目录:~/.opendev/projects/{encoded-path}/,其中项目绝对路径通过将路径分隔符替换为连字符编码(如 /Users/alice/myapp 变为 -Users-alice-myapp)。这种分离确保关于一个仓库的对话永不会与另一个仓库的对话并列出现,项目特定设置不会泄漏到无关代码库。
2.5.1 会话存储
每个对话存储为两个文件:.json 元数据文件和 .jsonl 记录文件。元数据文件记录会话标识符、创建与最后活动时间戳、工作目录、标题和摘要,但不含消息。记录文件存储实际消息,每行一条,每条序列化为带角色、内容、时间戳、工具调用和 token 计数的 JSON 对象。元数据与消息分离意味着列出所有会话(向用户展示会话选择器)只需读取小的元数据文件,而非加载可能很大的记录历史。
安全写入会话。 会话通过专为防止数据丢失(即使并发访问)设计的写入流程保存。写入前,系统以 10 秒超时在元数据文件上获取独占文件锁(fcntl.flock)防止死锁。元数据随后写入临时文件,并用 os.rename() 原子重命名到位——POSIX 系统上保证文件要么完整写入要么未动,永不写一半。记录文件遵循同样的锁定协议。两个文件更新后,会话索引也原子更新。
自动保存。 系统不要求显式保存命令,而是每 5 轮自动保存对话(经 auto_save_interval 可配置)。每次自动保存写入元数据和完整记录。自动保存之间,消息只存在于内存中。对多渠道部署(如 Web 界面),单独的仅追加路径在独占锁下将每条新消息单独写入记录文件,以每条消息一次文件系统调用的成本提供即时持久性。
会话索引。 会话很多时,通过扫描项目目录中每个元数据文件来列出会话很慢。轻量索引文件(sessions-index.json)以每条约 200 字节缓存基本字段(会话 ID、标题、消息数、最后修改时间戳),实现即时会话列举。索引在每次保存会话时原子更新。若索引文件缺失、损坏或有权限错误,系统通过扫描目录中所有元数据文件自动重建——为每个有效会话创建条目并删除空条目。这种自愈行为意味着索引永不会成为单点故障:即使文件被意外删除或损坏,下一次 list_sessions 调用也会透明地重新生成它。
会话标题与恢复。 新会话首次保存时没有有意义的标题。轻量主题检测模型通过检查最后 4 条消息生成短标题(上限 50 字符)。这在后台守护线程运行,永不阻塞主对话循环。用户在项目目录启动智能体而未指定会话时,系统默认该项目最近的会话,实现"从上次离开处继续"的工作流。嵌套子项目的会话不出现在父项目列表中,因为每个项目根产生不同的编码路径。
会话成本元数据。 每个会话的元数据文件包含 cost_tracking 对象,记录累计 API 用量:总输入 token、总输出 token、以美元计的总成本(从模型定价元数据计算)、API 调用次数。该元数据在每次 LLM 调用后更新并随会话持久化。用户经 --continue 恢复会话时,CostTracker 服务从该元数据恢复状态,确保运行成本显示反映完整会话历史而非仅当前调用。
旧版迁移。 早期版本将消息内联存储在元数据 JSON 文件中,而非单独的 JSONL 记录。系统遇到含内联消息且无 JSONL 文件的会话时,自动将消息迁移到新 JSONL 文件,清除元数据中的内联消息,并保存原文件备份。这一一次性迁移对用户透明。
2.5.2 操作日志与撤销
智能体会犯错:写错文件、做了破坏性的编辑、删除用户不想删的文件。OpenDev 不要求用户用版本控制命令手动撤销这些变更,而是在日志中跟踪每个文件操作(创建、修改、删除),提供单命令撤销。
每条操作记录包含操作类型、文件路径、时间戳、唯一标识符和操作前的文件内容。这些记录存储在两处:内存列表用于当前会话快速撤销;会话目录中的 JSONL 文件(operations.jsonl)用于持久性。JSONL 日志是尽力而为的:写入失败(如因权限问题)时记录失败但不中断智能体工作。内存列表是撤销操作的主要数据源。
用户调用撤销时,系统从内存列表弹出最近操作并反转:创建的文件被删除,修改的文件恢复到备份内容,删除的文件从保存的副本恢复。内存历史上限 50 个操作,防止内存无界增长。达到上限时,最旧条目先被逐出。实践中,用户很少需要撤销十几个以前的操作,因此该上限未曾构成限制。
撤销系统与版本控制并存而非取代它。它处理未提交变更而无需用户懂 git,为智能体犯错后的快速纠正提供比键入 git restore 更低的摩擦。
影子 git 快照。 内存撤销日志只跟踪经智能体工具执行的文件操作,无法捕获 shell 命令(如 npm install 修改 package-lock.json)或构建过程的副作用。为全面的逐步撤销,系统维护影子 git 仓库——位于 ~/.opendev/snapshot/<project-id>/ 的裸仓库,与用户实际仓库不共享历史。在每个修改文件的智能体步骤,快照系统用影子仓库的对象库对项目工作目录运行 git add . && git write-tree,在会话元数据中记录树哈希。/undo 命令计算当前树与快照树之间的 git diff,识别变更文件,经 git checkout <hash> -- <file> 恢复。影子仓库的 .gitignore 从真实仓库同步,避免跟踪构建产物。定期清理(git gc --prune=7.days)保持影子仓库紧凑。该方法利用 git 的内容寻址存储实现完美的文件级恢复,而不干扰用户的版本控制工作流。
2.5.3 配置
配置遵循四层层次结构,使用户开箱即有合理行为,同时可在适当作用域定制一切:
- 内置默认值:无需任何用户设置即可工作的配置(默认模型、温度、自动保存间隔等)。
- 环境变量:提供 API 凭据和 CI/CD 特定覆盖。API 密钥只从环境变量加载,绝不从配置文件加载,防止在版本控制中意外暴露。若在配置文件中发现密钥,加载时自动剥离。
- 用户全局设置(
~/.opendev/settings.json):存储跨项目偏好,如用户首选模型、UI 设置、工具自动批准规则。 - 项目本地设置(
<project>/.opendev/settings.json):存储仓库特定覆盖,如特定代码库用不同模型或项目特定编码标准。
每层覆盖其上一层:项目设置优先于用户全局设置,用户全局优先于环境变量,环境变量优先于内置默认。配置在启动时加载一次并缓存在内存中;后续读取返回缓存值而不重读文件。
上下文窗口限制从模型能力自动推导,而非要求显式配置。用户选择模型时,系统从提供商缓存(如下所述)查询其最大上下文长度并相应设置 token 预算。这避免了常见的配置错误来源:用户设置的上下文限制与模型实际容量不匹配。
2.5.4 提供商与模型缓存
系统需要知道每个提供商有哪些可用模型及其能力(上下文长度、视觉支持、定价)。OpenDev 不硬编码这些信息,而是从外部目录 API 获取并本地缓存在 ~/.opendev/cache/ 下。
缓存使用 24 小时 TTL 的 stale-while-revalidate 策略。启动时,系统通过检查 .last_sync 标记文件的修改时间来判断缓存上次刷新时间。缓存不到 24 小时则原样使用。陈旧或缺失时,系统从 API 获取新数据,转换为按提供商的 JSON 文件(每提供商一个文件,含模型名、上下文长度、能力和定价),并更新标记。网络获取失败时,系统回退到陈旧缓存(若有);完全没有缓存则不携带能力信息继续。这确保智能体离线也能启动:上次成功同步的缓存文件提供足够信息正常运行。
环境覆盖(OPENDEV_MODELS_DEV_PATH 指向本地目录文件,OPENDEV_DISABLE_REMOTE_MODELS 完全跳过网络)允许在无网络访问情况下填充缓存,适用于物理隔离环境或用固定模型集测试。
上述架构体现了众多设计决策,其理由并非总能从组件描述中自明。下一节从按组件的细节中退一步,审视塑造这些选择的跨领域设计张力(上下文压力、行为引导、安全执行、LLM 不精确性、资源有界化),为类似系统的构建者提炼可迁移的经验。
3. 讨论
前面各节详细描述了 OpenDev 的架构和工具生态。这里我们从按组件的描述中退一步,审视塑造系统的五个跨领域设计张力。每个小节综合横跨多个组件的洞见,为类似智能体系统的构建者提炼可迁移的经验。
3.1 上下文压力作为核心设计约束
与 CPU 或内存不同,上下文同时被系统(提示、工具模式、安全前言)和智能体自己的动作(工具输出、对话历史)消耗。加入系统提示的每项能力和返回给智能体的每个工具结果都在争夺同一有限预算。根据我们的经验,工具输出(文件内容、命令结果、搜索命中)在典型会话中消耗 70–80% 的上下文,远超系统提示和智能体自身的推理。这使上下文利用率成为智能体续航能力最重要的单一指标,并施加了一种无处不在的张力:更丰富的工具输出提高单轮准确率,但缩短会话的有效寿命。
经验:将上下文当作预算,而非缓冲区。 上下文削减不是二元操作。渐进式方法——持续监控利用率、在陈旧工具输出变得无关前修剪、遮蔽旧观测、把基于 LLM 的摘要保留给真正的溢出——显著优于到达硬上限时一次性压缩一切的朴素策略。2.3.6 节描述的快速修剪遍 exemplifies 这一点:通过向后遍历工具结果、将超出智能体工作视野的输出替换为 [pruned] 标记,它常回收足够空间,完全避免昂贵的 LLM 压缩。要设计渐进削减阶段,而非单一紧急压缩。
经验:将大输出卸载到文件系统。 工具产出超过大小阈值的输出时,将完整内容写入暂存文件、只返回短预览加文件引用,使上下文聚焦于智能体正在使用的内容(2.3.2 节)。智能体看到足以判断完整输出是否重要的信息,并可按需读取。这把上下文消耗问题转变为检索问题,而后者严格更便宜:检索花一次工具调用,上下文消耗则在会话余下时间的每次 LLM 调用上都要支付。
面向缓存的提示结构。 对支持提示缓存的提供商,将系统提示拆分为稳定前缀和动态后缀、给前缀标记缓存控制头,在多轮会话中产生显著的输入成本节省(2.3.1 节)。由于系统提示每次 LLM 调用都重发,缓存稳定部分摊销了系统最丰富指令的成本。
思考上下文的双记忆。 向思考模型提供对话上下文时,将压缩的长程上下文(完整历史的 LLM 摘要)与详细的短程上下文(最近几次交换逐字)分离,使思考预算无论对话多长都保持有界,同时保留战略目标和操作细节(2.3.3 节)。一个微妙之处:迭代地对摘要做摘要会在多轮后累积失真。定期从完整对话历史重新生成摘要,而非压缩先前摘要,可纠正这种漂移。
经验:以 API 报告的 token 计数校准,而非本地估计。 以上一次调用 API 报告的 prompt_tokens 作为校准锚点对准确的上下文管理必不可少。提供商注入不可见内容(安全前言、工具模式序列化、内部格式),使本地 token 计数系统性低估实际用量。在我们的系统中,偏差大到导致压缩触发过晚,引发上下文溢出错误(2.3.7 节)。永远将提供商报告的 token 计数视为基准真相;本地估计只在没有先前 API 响应时作为回退。
3.2 长程行为引导
系统提示的影响随对话增长而衰减。在智能体最初几轮可靠生效的指令,在 30 次或更多工具调用后会被例行违反——此时指令远离模型的注意力窗口,被数十个工具结果埋在下面。因此,行为引导是一个信噪比工程问题:如何在不把上下文淹没于重复指令的情况下维持遵从。
经验:在决策点注入提醒,而非前置。 位于最高最近性位置的简短、针对性提醒,比模型在 20 轮后已部分遗忘的长系统提示段落更有效。关键是,这些提醒应使用
role: user而非role: system:在我们的实验中,user 角色提醒持续产生更强的遵从,可能因为模型对近期 user 消息赋予的显著性高于被中间轮次压下去的 system 上下文(2.3.4 节)。然而,提醒频率必须按类型设上限;每轮都注入的提醒会变成模型学会忽略的背景噪声, paradoxically 降低遵从。
经验:将思考与行动分离。 工具可用时,LLM 倾向于快速行动而非深入思考。提供无工具访问的独立思考阶段产生明显更好的推理轨迹,因为模型不受行动可用性的压力(2.2.6 节)。这种分离比在工具可用的同一调用中要求模型"仔细思考"更有效。机制很重要:是 API 调用中缺少工具模式——而非指示模型克制使用工具——改变了模型行为。
工具选择的显式决策树。 智能体对几乎每次查找都默认文本搜索(grep),即使存在更精确的工具。这浪费迭代并用假阳性淹没上下文。将检索工具决策树直接编码进智能体提示(符号名路由到语义搜索、字符串模式路由到文本搜索、结构模式路由到 AST 搜索、文件名约定路由到 glob)减少了不必要的 grep 调用,提高了首次检索准确率。关键是决策标准必须具体、锚定在查询的可观察特征上(“若目标是函数或类名,用 find_symbol”),而非抽象(“用最合适的工具”)。
提供商条件提示段落。 不同 LLM 提供商有显著不同的能力:扩展思考、函数调用约定、上下文限制。与其用提供商无关的指令弄乱系统提示,不如注册只在相应提供商活动时加载的提供商特定段落,保持提示预算聚焦(2.3.1 节)。未知提供商不获得任何段落;优雅降级优于错误引导。
经验:将智能体构造与智能体执行分离。 长时运行的智能体受益于脚手架(运行前组装)与 harness(运行时编排)之间的清晰分离。脚手架(构造系统提示、构建工具模式、注册子智能体)在第一个提示前运行一次,产出完全初始化的智能体。harness 随后用工具分发、上下文管理、安全执行和会话持久化包裹推理循环(2.2 节)。这种分离防止构造期关注点与运行时关注点纠缠:harness 从不检查智能体是否完全初始化,因为急切构造保证它始终是(2.2.1 节)。实际好处是每个关注点可独立演进:添加新工具只需构造时改注册表,改变压缩策略只需运行时改 harness。
3.3 通过架构约束实现安全
运行时权限检查是智能体安全的错误首要抽象。在模式中看到危险工具的模型可以对调用它进行推理、论证为什么应该允许、探测权限逻辑的边角情况。更稳健的方法是使违规在结构上不可能:若写工具不在智能体模式中,智能体无法尝试写入,因为它从未看到调用方式(2.2 节)。这是护栏与断路之间的区别:模型无法对它不知道存在的能力进行推理。
经验:让不安全工具不可见,而非被阻止。 模式门控(从智能体可用集合移除工具,而非调用时检查权限)从根本上比运行时权限检查更稳健。工具不在模式中时,智能体无法尝试调用它、论证例外或探测绕过条件。独立设计各层的纵深防御确保单一绕过不危及安全:模式门控防止未授权尝试,审批系统拦截需要人工审查的操作,文件新鲜度验证防止覆盖并发编辑,影子 git 快照(2.5.2 节)使所有文件系统变更可逆。这些层被有意设计为相互独立;一层的 bug 不会削弱另一层。
审批持久化防止疲劳。 用户将审批规则标记为"总是允许"时,将其持久化到磁盘以跨会话重启存活至关重要。没有持久化,用户每会话必须重新批准相同操作,导致审批疲劳,进而导致 blanket 自动批准——彻底瓦解安全系统。
生命周期钩子作为可扩展性。 观察或拦截智能体生命周期事件的外部脚本支持自定义策略、日志、CI 集成和安全执行,无需修改智能体代码。钩子接口必须尽早设计:阻塞与非阻塞语义、输入改写支持、全局/项目级配置合并,都是钩子有用而非摆设的必要条件。
中断时的模态优先级。 用户在模态对话框(审批提示、用户问题)激活时按中断键,系统应取消对话框而非中断智能体。对话框挂起时中断智能体会产生孤儿 UI 状态(悬空的加载指示器、陈旧的 future、未解决的 promise),需要手动清理。
3.4 为近似输出而设计
LLM 可靠地产出近似正确的输出。编辑目标会偏离实际文件内容:尾随空白、缩进差异、转义序列变化。恢复策略引用智能体没有的工具。搜索查询路由到次优工具。要求模型精确正确的系统会把大部分时间花在错误恢复循环中。替代方案是把吸收 LLM 不精确性作为一等性质来设计工具和接口。
经验:设计能吸收 LLM 不精确性的工具。 编辑操作是最清楚的例子。严格精确匹配的编辑工具在实践中造成智能体错误的大多数——并非因为智能体意图错误,而是它对目标文本的复现略有偏差。构建渐进放宽的匹配器链——每个返回在文件中实际找到的子串以保留原始格式——将这些差之毫厘转化为成功编辑(2.4.2 节)。链条在首次匹配短路,精确匹配零开销。一般原则:当智能体意图明确但字面输出不精确时,工具应弥合差距,而非拒绝尝试。
经验:让恢复提示适配智能体可用的工具集。 截断大输出并建议恢复策略时,系统必须检查智能体实际拥有哪些工具(2.3.2 节)。若智能体可委托子智能体,建议之;若不能(因为它自己就是子智能体),建议用 offset/limit 参数增量处理。推荐不可用工具的通用提示会导致智能体尝试不可能的动作并进入错误循环。同样原则适用于错误消息:"重读文件并以当前内容重试编辑"远比"再试一次"可行动,因此将错误分类为具体类别并为每类检索针对性恢复模板能提高恢复率(2.3.5 节)。
自动提升类服务器命令。 无限运行的开发服务器、构建监视器和测试套件会撞上任何前台超时。通过正则模式检测类服务器命令并自动提升为带输出捕获的后台执行,防止智能体阻塞在一个本就不该终止的进程上(2.4.3 节)。
自动安装缺失依赖。 依赖外部运行时的工具应在首次使用时自动安装依赖,而非以晦涩错误失败。检查依赖,缺失则安装,然后重试。这消除了一类让智能体和用户都困惑的常见安装相关失败,也是设计工具吸收环境不精确性的又一实例。
3.5 惰性加载与有界增长
急切加载在规模上失败。启动时加载所有 MCP 工具模式在智能体处理第一条用户消息前消耗 40% 的上下文预算。加载所有技能定义用智能体在多数会话中永远不会用的内容填充提示。两种情况的解决方案都是惰性发现:启动时加载元数据索引,将完整内容推迟到使用点(2.4.7 节)。
对 MCP 工具,惰性发现将启动上下文成本从 40% 降到 5% 以下。智能体收到可用服务器及其能力的紧凑摘要;完整工具模式只在智能体为特定任务选择服务器时加载。对技能,两阶段方法起同样作用:启动时加载元数据索引(名称、描述、触发条件),完整技能内容(可能含多页提示模板)只在智能体决定调用技能时加载。
外部元数据(模型能力、定价、上下文限制)受益于 stale-while-revalidate 缓存策略(2.5.4 节):启动时,缓存新鲜则从缓存服务;陈旧则先用陈旧数据并后台刷新;刷新失败则继续用陈旧数据。这保证离线启动,消除阻塞整个系统的"无法连接"失败。
经验:为每个随会话长度增长的资源设界。 无界资源在长会话中失败。没有显式上限,撤销历史会无限累积快照,并发工具调用会压垮系统,行为提示会淹没上下文。设计规则很简单:每个随会话长度增长的资源必须有上限。迭代限制防止失控的智能体循环。撤销历史限定固定快照数。并发工具调用设上限防止资源耗尽。提示预算限制每种提醒类型的触发次数。只读工具调用并行运行,写调用串行(2.2.3 节)。
经验:经验性阈值调优优于第一性原理计算。 上限的具体取值(上下文压力阈值、修剪保护窗口、提醒频率、迭代限制)难以从第一性原理计算。它们以难以预测的方式取决于模型行为、典型用户工作流和系统开销之间的交互。从保守值起步、基于观察到的失效模式调优(压缩过早的会话、触发过频的提醒、运行过长的循环)比试图解析推导最优值更有效。在我们的系统中,70% 压缩触发点、3 次提示尝试、思考深度级别都来自迭代式失效分析。
自愈索引。 将频繁访问的元数据缓存到轻量索引文件,实现无需扫描底层数据文件的快速列举(2.5.1 节)。索引缺失或损坏时,从底层数据自动重建,使索引成为性能优化而非单点故障。同样原则适用于任何派生数据结构:设计成丢失时触发再生,而非失败。
智能体循环外的确定性操作。 并非一切都要经过智能体。会话管理、模式切换、模型选择和服务器配置是确定性操作,应在输入边界直接处理(经斜杠前缀分发或等价机制)——无审批门、无撤销跟踪、无 token 成本(2.2.4 节)。将这些路由经 LLM 浪费上下文并引入不必要的非确定性。
这五个设计张力(上下文作为预算、长程行为引导、通过架构约束的安全、为近似输出而设计、无界增长的有界化)并非 OpenDev 独有。它们反映构建任何长时运行智能体系统的根本挑战。下一节综述更广泛的研究社区如何应对这些相同挑战,将 OpenDev 的设计决策置于代码智能、自主软件工程和上下文工程不断演进的版图之中。
4. 相关工作
以终端为中心的 AI 编程智能体的发展,依托于横跨代码智能、自主软件工程和交互式智能体设计的丰富而快速演进的研究成果。本节综述为我们的系统设计提供依据的关键研究脉络,并将 OpenDev 置于更广阔的版图中。
4.1 代码生成与代码 LLM
LLM 在编程上的应用,从由 HumanEval 和 MBPP 评测的函数级生成,经 ClassEval 等类级任务,发展到要求跨文件规划和多步推理的仓库级挑战。DeepSeek-Coder、StarCoder、CodeLlama 和 CodeT5+ 等专门代码 LLM 推动了这一进程,CodeTF 等统一工具包为跨模型的训练和推理标准化提供支持,而检索增强生成(RAG)和强化学习弥合了孤立生成与真实仓库规模任务之间的差距。OpenDev 在此基础上,将代码 LLM 嵌入提供导航、编辑和执行能力的智能体循环中,使生成的代码得以应用到真实仓库。
4.2 自主 Issue 解决
SWE-bench 定义了自主 issue 解决任务,催生了横跨单智能体、多智能体和基于工作流方法的研究前沿。SWE-Agent 等单智能体框架开创了自主文件导航和代码编辑;AutoCodeRover 和 HyperAgent 将其扩展到迭代精炼和通用任务求解。多智能体系统将问题分配到专门角色:MAGIS 采用角色扮演协作,CodeR 引入任务图执行,OpenHands 等平台经集成选择编排异构智能体。Agentless 等基于工作流的方法强制执行结构化流水线(定位、修复、验证)以提高可复现性。
除架构选择外,社区还探索了基于训练和推理时的方法来提升智能体能力。带课程学习的监督微调与合成数据,结合利用过程导向奖励的 RL 算法,使模型具备更强的 issue 解决技能。推理时,蒙特卡洛树搜索支持对修复轨迹灵活回溯,CodeMonkeys 等并行探索策略最大化解覆盖。OpenDev 借鉴这些进展,将单智能体自主性与结构化子智能体委托和基于工作流的安全执行相结合。跨这些范式,智能体越来越依赖代码本身作为推理与行动的主要媒介。
4.3 代码作为通用智能体的核心媒介
近期工作凸显了从纯自然语言推理到代码驱动智能体交互的范式转变。以代码为通用媒介赋予智能体精确的工具调用、可复现的状态管理和可组合的动作原语。
交互协议。 ReAct 和 ReWOO 等标准化工具使用模式实现精确工具调用和状态管理。模型上下文协议(MCP)为可靠的多轮工具编排引入结构化消息格式,Agent-to-Agent(A2A)等多智能体协调方案支持直接的智能体间通信。
以代码思考与行动。 PAL(Program-Aided Language Models)、Program-of-Thoughts 和 Chain-of-Code 等推理方法使 LLM 能生成并执行代码进行结构化推理。动作执行框架将计划翻译为可运行代码:CodeAct 经可执行 Python 实现交互式操作,TaskWeaver 将请求转换为基于插件的函数调用,CodeAgents 提供更多编排模式。领域应用将该范式扩展到软件工程之外,从医疗(EHRAgent)到机器人控制(Code as Policies)。
代码化记忆。 基于代码的存储策略被证明对管理 LLM 上下文约束有效。Voyager 将验证过的技能存为可执行代码供日后复用;Reasoning Bank 支持从修复轨迹进行基于规则的学习。MemGPT 和 ExpeRepair 引入分层和双记忆架构用于上下文管理,两者在下文上下文工程小节进一步讨论。
通过在终端环境中运行、并拥抱经 shell 命令的执行反馈,OpenDev 直接契合"以代码行动"哲学,利用 shell 作为通用解释器编排复杂的多步工作流。
4.4 智能体软件工程工作流
智能体软件工程将人类工程师与 LLM 协作完成软件任务的工作流形式化。
迭代式与提示驱动工作流。 Plan–Do–Assess–Review(PDAR)循环形式化单任务的生命周期:经产品需求提示(PRP)规划、开发智能体实现、自我评估、人工审查。SuperClaude 等 CLI 工具包将这些循环模板化以保持一致与便利,但止步于团队级方法论之前。
多智能体与敏捷启发框架。 BMAD 将智能体组织为敏捷角色(产品负责人、架构师、开发者、测试者),以 PRD 和故事文件支持并行执行。一项关键划分提议将工作空间分离为人类监督与编排的智能体命令环境(ACE)和可扩展智能体操作的智能体执行环境(AEE)。
导师制与生命周期管理。 SASE 引入"导师制即代码"概念:审查反馈变为版本受控、可测试的 MentorScript 规则,实现跨任务累积改进。智能体生命周期管理将智能体从无状态承包商转变为有记忆、可观测、安全执行的持久队友。
OpenDev 体现了以执行为中心的终端枢纽的特征,通过命令行交互原生桥接迭代开发周期,并将命令输出视为自主调试和循环精炼的直接信号。
4.5 智能体工具系统与模块化组件
在免训练框架中,LLM 依赖专门工具增强推理而无需微调。这些工具沿修复流水线组织:bug 复现、故障定位、代码搜索、补丁生成、验证、测试生成。
AEGIS 等 bug 复现工具提供自动化环境搭建和复现工作流,确保一致的执行上下文。故障定位工具包括基于谱的故障定位(SBFL)和构建代码依赖图的基于图的方法。代码搜索工具从使用 BM25 和基于 AST 的 API 的交互式检索,到经知识图谱和语言服务器协议的基于图的理解。补丁生成工具采用稳健的编辑格式(如 AutoDiff)和经回归测试的集成选择。SpecRover 使用规格引导的搜索产出高质量补丁。Otter 和 Issue2Test 等测试生成工具用反馈驱动机制合成复现所报缺陷的失败测试。
OpenDev 采用带惰性发现、分层技能模板和纵深防御安全机制的注册表工具架构,在全面能力与 token 效率间取得平衡。
4.6 长程智能体的上下文工程
上下文管理是长时运行智能体系统的根本挑战。Issue 解决任务常需长程多轮交互,既推高 API 成本,也因上下文腐化(context rot)导致性能退化。
形式化基础与分类体系。 Mei 等人提供了 LLM 上下文工程(CE)的首个综合综述,将供给模型的上下文形式化为结构化元组 C = 𝒜(c_instr, c_know, c_tools, c_mem, c_state, c_query),其中 𝒜 是编排指令上下文、外部知识、工具模式、记忆、执行状态和用户查询的组装函数。该综述围绕三大支柱组织该领域:上下文检索(从外部来源选择相关信息)、上下文处理(转换、压缩或重构检索内容)、上下文管理(跨轮次维持连贯与相关)。OpenDev 的架构直接映射到该分类体系:提示组合器从模块化 markdown 段落组装 c_instr,工具注册表以惰性 MCP 发现管理 c_tools,记忆流水线维护 c_mem,自适应压缩跨长会话处理 c_state。
历史与理论视角。 Hua 等人将上下文工程置于更广阔的思想史中,追溯四个发展时代:聚焦单轮指令的早期提示工程;引入外部知识的检索增强生成;扩展行动空间的工具增强智能体;以及当前将上下文视为一等工程问题的 CE 2.0 时代。借鉴 Dey 对普适计算中上下文的形式化定义和 Weiser 的平静技术愿景,他们阐述三条指导原则:熵减(每个上下文元素应降低对期望输出的不确定性)、最小充分性(只包含必要内容以避免注意力稀释)、语义连续性(上下文应跨轮次连贯演化,而非从头重建)。他们还指出当前系统的狭隘性差距:绝大多数聚焦聊天历史管理,忽视工具状态、环境信号、跨会话知识等整体上下文维度。OpenDev 的系统提醒在注意力关键位置注入事件驱动上下文,直接回应语义连续性原则;其分阶段压缩通过渐进摘要低价值历史实现熵减。
上下文处理与压缩技术。 综述文献记录了结构化上下文处理的可观定量收益。思维链变体(tree-of-thought、graph-of-thought)通过结构化中间上下文改善多步推理;压缩方法在不成比例损失质量的情况下降低 token 成本:In-context Autoencoder 实现 4 倍压缩,PREMISE 在保持任务性能的同时将提示长度减少 87.5%。检索方面,Self-RAG 引入自适应决定何时检索并批判自身输出的自反检索;RAPTOR 构建递归树结构摘要用于分层检索;GraphRAG 利用知识图谱结构(如 HippoRAG)提高复杂查询的检索精度。这些进展揭示一种根本不对称:LLM 在理解任务中对压缩上下文的鲁棒性强于生成任务,表明激进压缩对为推理提供信息的上下文最可行,对直接塑造输出文本的上下文则不然。OpenDev 的压缩策略利用这种不对称:激进摘要工具输出和历史轮次(理解上下文),同时逐字保留系统指令和近期用户消息(生成上下文)。
元级上下文优化。 Ye 等人提出元上下文工程(MCE),将上下文工程本身视为优化问题而非手工设计任务。他们将智能体上下文形式化为双层优化:外层循环搜索上下文配置(系统提示、工具模式、记忆策略),内层循环评估智能体在下游任务上的表现。一个关键洞见是:固定评测 harness 会给智能体基准引入系统偏差,因为 harness 本身以可能有利于某些策略的方式塑造上下文。MCE 通过 (1+1)-ES 带交叉的进化策略共同演化智能体上下文与评测设置来应对——该策略变异并重组上下文配置。在 SWE-bench Verified 上,MCE 达到 89.1% 解决率,而手工工程基线为 70.7%,且因更高效的上下文利用快 13.6 倍。优化后的配置跨任务迁移,表明元学习的上下文策略捕获的是一般原则而非任务特定产物。这条研究线索意味着,手工设计的上下文工程——包括 OpenDev 采用的策略——最终可被上下文组装的学习式优化补充或取代。
记忆集成使智能体能超越孤立问题求解,积累历史上下文。方法范围从分离通用知识与仓库特定细节的分层存储,到将知识划分为情景、语义和程序存储的认知架构。在上述记忆原语(MemGPT 的虚拟分页、ExpeRepair 的双记忆)基础上,更新的工作探索群体级记忆:智能体变体群体维护多样探索历史以实现稳健决策;经验库通过积累的知识引导搜索。当前前沿优先蒸馏可迁移的推理策略,从存储原始数据转向从轨迹抽象高层策略。
记忆驱动的扩展方法通过集成持久上下文减少冗余探索,补充上述推理时策略,使智能体建立在过往尝试之上而非从头开始。长程智能体的上下文压缩有显著进展:ACON 优化扩展智能体会话的压缩策略;Context-Folding 通过递归上下文摘要扩展智能体能力。前沿处,智能体上下文工程使模型能通过自我改进循环演化自己的上下文。多智能体通信经标准化协议的演进走向成熟:从早期知识共享语言(KQML、FIPA ACL)到现代互操作标准——用于工具集成的 MCP、用于直接智能体间消息传递的 A2A、用于结构化多智能体协调的 Agent Communication Protocol(ACP)。OpenDev 通过保留关键信息同时摘要历史的自动压缩、结合双记忆架构和基于模板的错误恢复来应对这些挑战。Young 将智能体 harness 概念形式化为协调这些关注点(工具分发、上下文生命周期、进度跟踪、上下文窗口之间的干净交接)的运行时框架,面向在扩展时间跨度上运行的智能体。
4.7 智能体编程系统的评测基准
上文已介绍基础代码生成基准,此处聚焦智能体系统的评测生态。基准范围逐步拓宽:从函数级和类级生成(APPS、CodeContests),经 SWE-bench 及其变体(SWE-bench Verified、Multi-SWE-bench、SWE-bench Multimodal、SWE-bench Pro、SWE-Lancer)锚定的仓库级 issue 解决,到 WebArena、OSWorld 和 EnvBench 等环境接地交互任务。互补基准针对特定维度:SWT-Bench 面向测试工作流,FEA-Bench 面向特性实现,NL2Repo-Bench 面向仓库生成,DevEval 面向完整开发生命周期,SWE-EVO 面向长程软件演化。
专门基准评估通用代码编辑之外的能力。τ-Bench 和伯克利函数调用排行榜评估工具使用与函数调用熟练度。在科学与 ML 工程领域,ReplicationBench 针对研究复现,MLGym 和 MLE-Bench 评估 ML 研究与工程任务,CORE-Bench 衡量计算可复现性。对长程终端交互,Terminal-Bench 表明前沿智能体解决不到 65% 的精选 CLI 任务;LongCLI-Bench 发现跨开发、特性添加、bug 修复和重构的多类别编程任务通过率低于 20%。
4.8 评测方法论与最佳实践
对智能体系统的严格评测需要超越简单准确率指标的细致基准设计。Agentic Benchmark Checklist 将最佳实践形式化,包括清晰的任务定义、可复现性保证、防污染和效率感知指标。MT-Bench 等 LLM 作为裁判的方法在传统指标无法捕获语义正确性时实现可扩展的质量评估,尽管数据污染仍是需要持续更新基准的关键关切。效率指标(API 成本、推理时间、token 消耗)和长任务完成度测量为真实世界部署中智能体的实用性提供整体评估。
4.9 人-智能体协作
LongCLI-Bench 提供了令人信服的证据:人-智能体协作显著改善任务完成度。静态计划注入(执行前提供关键计划)在通过率和效率上都优于自我纠正。动态交互引导(智能体基于当前状态请求人工干预)达到更高性能。组合设置产生最佳结果,同时减少人工干预需求。这些发现强烈表明:未来系统不应只追求完全自主,而应发展利用高效智能体执行与人类战略引导之间协同的协作工作流。OpenDev 通过其审批工作流、交互式命令执行和结构化反馈循环支持该范式。
上文综述的研究版图揭示了清晰的轨迹:从孤立代码生成走向集成的、必须在能力、安全和上下文效率之间取得平衡的长程智能体系统。基准越来越要求在真实环境中持续的多步推理,而方法则逐步应对这种持续运行所需的工程挑战(上下文管理、工具编排、记忆和安全)。下一节综合从 OpenDev 架构经验与这些更广泛研究趋势的交汇中浮现的具体未来方向。
5. 结论与未来方向
本文介绍了 OpenDev——一个开源的 AI 驱动命令行软件工程智能体——并记录了构建生产就绪系统过程中的架构决策、设计权衡与经验教训。关键贡献包括:带多模型路由的复合 AI 系统架构(2.2.5 节)、带思考与批判阶段的扩展 ReAct 流水线(2.2.6 节)、自适应上下文压缩(2.3.6 节)、事件驱动系统提醒(2.3.4 节)、经验驱动的记忆流水线、经 MCP 的惰性工具发现(2.4.7 节),以及双接口抽象。
核心架构洞见是:按工作流绑定 LLM(2.2.5 节)产生了模型无关性——适配新模型只需配置变更,无需代码变更。模式级安全执行(2.2 节)被证明比运行时权限检查更稳健,因为从规划智能体模式中移除写工具消除了整类绕过尝试。条件提示组合(2.3.1 节)通过排除无关指令降低了开销,同时在需要时保留全面引导。在上下文工程方面,管理有限上下文窗口成为一等工程问题,而非次要优化。使观测在活跃、淡化、归档状态间转换的自适应上下文压缩(2.3.6 节)将峰值上下文消耗降低约 54%,并常常消除紧急摘要的需要。三层上下文架构(静态系统提示、动态即时提醒(2.3.4 节)、长程持久化)解决了智能体在 30+ 次工具调用后可靠违反指令的注意力衰减问题。智能体上下文工程记忆流水线使智能体能从会话内和跨会话的工具结果中学习,而无需将策略硬编码进提示。
本工作浮现的跨领域设计张力和可迁移经验在第 3 节综合,该节审视了作为一等约束的上下文压力、长程行为引导、通过架构执行而非运行时检查的安全、吸收 LLM 不精确性的工具设计,以及长时运行会话的资源有界化策略。
若干先前被列为未来工作的能力——如经影子 git 快照的逐步撤销(2.5.2 节)——已在持续开发中实现,证明了分层架构的可扩展性。
从本工作识别的挑战中浮现出若干有前景的研究方向:
- 在既有基准上的定量评测。 本文记录了架构决策和设计理由,但缺乏系统的定量评测。在 SWE-bench、Terminal-Bench 和 LongCLI-Bench(第 4 节综述的更广阔评测生态的一部分)上做基准测试,将对照既有基线验证该架构并识别具体改进领域。Terminal-Bench 发现前沿智能体解决不到 65% 的任务、LongCLI-Bench 观察到长程任务通过率低于 20%,表明上下文管理和多步推理仍有很大改进空间。
- 自适应资源分配。 当前参数——70% 压缩阈值、3 次提示尝试、思考深度级别——是全局固定的。基于任务复杂度、当前上下文压力和错误历史动态调整的自适应方法,可以按任务优化成本-质量-延迟三角,而非依赖一刀切常量。例如,简单调试任务应完全跳过思考阶段,而复杂架构重构可能受益于更深的深思熟虑和更保守的压缩策略。
- 扩展记忆流水线。 ACE playbook 目前按项目运行,带有效性打分和语义检索。跨项目知识迁移——在一个仓库中学到的经验指导相似项目中的行为——分离通用编程启发与项目特定约定的分层条目组织,以及对不确定条目有选择地请求用户反馈的主动学习,可实质改善智能体随时间积累和应用经验的能力。
- 记忆的结构化代码表示。 当前记忆流水线将经验存为扁平的自然语言条目。更丰富的表示——捕获模块间关系的代码依赖图、跟踪函数交互的调用图、编码领域概念的项目级本体——可实现更精确的检索和推理。将图结构代码理解与跨越不仅会话、而是整个项目生命周期的长期持久记忆结合,将使智能体构建代码库的深度演化模型,而非积累孤立观察。
- 超越层级委托的多智能体协调。 当前子智能体在主智能体协调下独立执行,仅通过完成标记通信。更丰富的协调模式——子智能体之间的点对点通信、协作求解的共享黑板架构、解决冲突工具结果的协商协议——可实现更复杂的工作流,如并发代码审查与实现,或带结果综合的并行探索。
- 学习式系统提醒优化。 24 模板提醒目录及其注入时机是基于观察到的失效模式手工工程的。有效提醒模式的自动发现——通过在注意力衰减指标上做强化学习、基于对话动态的学习式注入时机、或以智能体状态为条件的自适应模板选择——可提高提示有效性,同时减少设计和维护提醒模板的手工工程负担。
- 混合 CLI-IDE 集成。 双接口架构证明共享回调协议可服务根本不同的前端。将其扩展到 IDE 插件——同一智能体逻辑同时驱动终端工作流和富编辑器集成——将服务既想要可视化便利(内联 diff、符号导航、测试结果叠加)又想要终端自主性的用户,且无需跨环境复制智能体逻辑。
构建有效的智能体编程系统需要在相互竞争的关注点之间导航:能力与复杂度、自主与安全、通用与 token 效率。设计空间充满没有单一选项占优的权衡。我们希望本文记录的架构模式、工程经验,以及对哪些做法有效、哪些无效的坦诚反思,能帮助未来智能体系统的构建者在面对这些选择时做出更明智的决定。
附录
说明:附录 A–J 为参考级目录,已译为中文;附录 K 是 OpenDev 实际发送给 LLM 的英文系统提示模板逐字集合(功能性构件,共 21 个主段落、4 个思考模式段落和 3 个独立模板),为保持其作为提示词的原貌未逐字翻译,仅给出结构概览。完整英文内容见原文:https://arxiv.org/html/2603.05344v1
附录 A:完整工具目录
表 1 提供 OpenDev 全部内置工具的完整目录,按处理器类别组织。每个工具在正文(2.4 节)有描述;本附录作为速查参考。除内置工具外,还可经 MCP 动态发现任意数量的外部工具(2.4.7 节)。
表 1:OpenDev 内置工具完整目录(按处理器类别组织)。标 † 的工具为只读,可在规划模式使用。
| 类别 | 工具 | 描述 |
|---|---|---|
| 文件操作 | read_file† | 读取文件内容,带行号输出和可选 offset/limit |
| write_file | 创建新文件(拒绝覆盖;引导使用 edit_file) | |
| edit_file | 经 9 遍模糊匹配链应用定点编辑 | |
| list_files† | 目录列举和基于 glob 的文件搜索 | |
| search† | 双模式搜索:正则(ripgrep)或结构(ast-grep) | |
| 进程 | run_command | 执行 shell 命令,服务器类命令自动转后台 |
| list_processes† | 列出被跟踪的后台任务及其状态和运行时间 | |
| get_process_output† | 检索后台任务的最后 100 行输出 | |
| kill_process | 终止运行中的任务(SIGTERM → SIGKILL 升级) | |
| Web | fetch_url† | 浏览器引擎网页抓取,支持深度爬取 |
| web_search† | 经 DuckDuckGo 的尊重隐私搜索 | |
| capture_web_screenshot† | 经 Playwright 无头浏览器的整页截图 | |
| open_browser† | 在系统默认浏览器打开 URL 或本地文件 | |
| 符号(LSP) | find_symbol† | 查找符号定义,支持通配符匹配 |
| find_referencing_symbols† | 跨文件查找符号的所有引用 | |
| rename_symbol | 跨所有引用重命名符号 | |
| replace_symbol_body | 替换函数/方法主体,保留签名 | |
| insert_before_symbol | 在符号定义前插入代码 | |
| insert_after_symbol | 在符号定义后插入代码 | |
| 视觉 | capture_screenshot† | 捕获桌面截图,可选区域 |
| analyze_image† | 经视觉语言模型分析图像 | |
| read_pdf† | 从 PDF 文件提取文本和元数据 | |
| 笔记本 | notebook_edit | 创建、修改或删除 Jupyter notebook 单元格 |
| 任务管理 | write_todos | 创建或替换任务列表 |
| update_todo | 按 ID 更新任务(强制单一"doing"约束) | |
| complete_todo | 将任务标记为完成,附可选完成日志 | |
| list_todos† | 按状态优先级列出所有任务 | |
| 用户输入 | ask_user† | 向用户呈现结构化多选问题 |
| 发现 | search_tools† | 按关键词搜索 MCP 工具,带打分排序 |
| 批量 | batch_tool | 以并行或串行模式执行多个工具 |
| 子智能体 | spawn_subagent | 启动带过滤工具注册表的隔离子智能体 |
| get_subagent_output† | 检索后台子智能体的输出 | |
| 技能 | invoke_skill† | 从技能文件加载按需领域专长 |
| 规划 | present_plan | 呈现计划供用户批准(批准/修改) |
| 完成 | task_complete | 发出任务完成信号,附摘要和状态 |
附录 B:LSP 语言服务器矩阵
表 2 列出通过 LSP 集成支持的所有编程语言及对应语言服务器。系统支持广泛的标准语言加若干实验性服务器,全部定义在 ls_config.py 中。
表 2:OpenDev 支持的 LSP 语言服务器。标 † 的服务器为实验性,必须显式指定。同一语言的备选服务器(如 Python 的 Jedi、Ruby 的 Solargraph)从略。
| 语言 | 服务器 | 语言 | 服务器 |
|---|---|---|---|
| Python | Pyright | Perl | Perl::LanguageServer |
| TypeScript/JS | tsserver | Clojure | clojure-lsp |
| Rust | rust-analyzer | Elm | elm-language-server |
| Go | gopls | Terraform | terraform-ls |
| Java | Eclipse JDT LS | Bash | bash-language-server |
| C/C++ | clangd | Nix | nixd |
| C# | csharp-ls | Erlang | erlang_ls |
| Ruby | Ruby LSP | AL | AL Language Extension |
| PHP | Intelephense | Rego | Regal |
| Swift | SourceKit-LSP | Fortran | fortls |
| Kotlin | kotlin-language-server | OCaml | ocamllsp |
| Lua | lua-language-server | Markdown† | Marksman |
| Elixir | ElixirLS | YAML† | yaml-language-server |
| Haskell | haskell-language-server | Dart | dart analyze |
| Scala | Metals | Zig | zls |
| Julia | LanguageServer.jl | R | languageserver |
附录 C:模块化系统提示组合
本附录记录 OpenDev PromptComposer(2.3.1 节)使用的完整提示段落注册表。正文描述了"过滤-排序-加载-连接"流水线及其理由;本附录提供段落的完整清单、条件和角色。每个模板的逐字内容在附录 K 重现(英文)。
C.1 主智能体提示段落。 默认动作模式智能体经 create_default_composer() 注册段落。表 3 列出每个段落及其激活条件、Anthropic 提示缓存的可缓存性和简要摘要。
表 3:主智能体提示段落完整注册表(21 个段落)。条件:always = 无条件;其余评估运行时上下文谓词。Cache:该段落是否包含在 Anthropic 提示缓存的稳定(可缓存)分区中。
| 段落 | 条件 | 缓存 | 摘要 |
|---|---|---|---|
| mode-awareness | always | ✓ | 引导非平凡任务使用规划子智能体 |
| security-policy | always | ✓ | 授权安全测试边界 |
| tone-and-style | always | ✓ | 沟通标准:简洁、直接、无表情符号 |
| no-time-estimates | always | ✓ | 绝不提供时长估计 |
| interaction-pattern | always | ✓ | ReAct 循环:思考 → 行动 → 观察 → 完成 |
| available-tools | always | ✓ | 工具类别概览与描述 |
| tool-selection | always | ✓ | 何时用直接工具、何时用子智能体 |
| code-quality | always | ✓ | 遵循约定、最小变更、不蔓延范围 |
| action-safety | always | ✓ | 破坏性/不可逆动作的风险评估 |
| read-before-edit | always | ✓ | 编辑前总是先读文件 |
| error-recovery | always | ✓ | 错误模式 → 解决策略映射 |
| subagent-guide | has_subagents | ✓ | 子智能体参考:8 种类型及时机/用法引导 |
| git-workflow | in_git_repo | ✓ | Git 安全协议、提交/PR 工作流 |
| task-tracking | todo_enabled | ✓ | 待办生命周期:创建 → 进行中 → 完成 |
| provider-openai | openai | ✓ | 函数调用、推理模型、视觉格式 |
| provider-anthropic | anthropic | ✓ | Tool_use 块、扩展思考、缓存控制 |
| provider-fireworks | fireworks | ✓ | 更小上下文、快速推理、无思考 |
| output-awareness | always | ✓ | 工具输出截断限制与分页 |
| scratchpad | session_id 已设 | ✗ | 会话特定暂存目录路径 |
| code-references | always | ✓ | 用于导航的 file_path:line_number 格式 |
| reminders-note | always | ✗ | 解释 <system-reminder> 标签 |
C.2 思考模式提示段落。 思考模式智能体经 create_thinking_composer() 只注册 4 个段落,有意省略工具使用和代码质量引导,避免将无工具推理带向过早行动。
表 4:思考模式提示段落(4 个段落)。全部无条件、可缓存。
| 段落 | 摘要 |
|---|---|
| thinking-available-tools | 工具感知而无调用压力 |
| thinking-subagent-guide | 委托推理:何时用、用哪个子智能体 |
| thinking-code-references | 用于导航的代码引用格式 |
| thinking-output-rules | 只推理不行动;简洁轨迹(≤100 词) |
C.3 专门模板。 五个独立模板在常规段落注册表之外承担特定角色,由各自子系统直接加载,而非经 PromptComposer 自动注册。
表 5:专门提示模板(非自动注册)。
| 模板 | 角色 | 关键输出 |
|---|---|---|
| compaction.md | 对话压缩器 | 带工件索引的结构化摘要(≤800 词) |
| critique.md | 推理批判者 | 对思考轨迹的可行动反馈(≤100 词) |
| init.md | 会话初始化器 | 经 Code-Explorer 生成 OPENDEV.md |
| main.md | 核心身份包装器 | 拥有完整工具访问的高级工程师人格 |
| thinking.md | 思考包装器 | 简洁的内部推理轨迹(≤100 词) |
C.4 组合机制。 组合流水线运作如下:
- 过滤 → 排序 → 加载 → 连接:针对运行时上下文字典评估每个已注册段落的条件谓词。返回 False 的段落在任何文件 I/O 前被排除。存活段落按优先级升序排列,从其 markdown 文件加载(剥离 frontmatter),以双换行分隔拼接。
- 面向提示缓存的两段式组合:
compose_two_part()方法将段落分为稳定(可缓存)和动态部分。对 Anthropic API,稳定部分携带 cache_control 头,在多轮会话中对缓存部分产生约 88% 的成本降低。通常 21 个段落中 19 个是稳定的;只有 scratchpad 和 reminders-note 是动态的。 - 模式特定组合器:工厂函数
create_composer(templates_dir, mode)返回相应组合器:“system/main” 产出 21 段落动作组合器;“system/thinking” 产出 4 段落思考组合器。规划模式使用针对只读探索优化的独立模板。 - 变量替换:模板使用
${VAR}占位符,由 PromptRenderer 在渲染时解析。集中式 PromptVariables 注册表将符号名映射到具体工具标识符(如${EDIT_TOOL.name}→edit_file),将模板行文与工具命名解耦。 - 两级回退:单个段落文件缺失时,组合器跳过并以缩减的提示继续。模块化组合整体失败时(如模板目录缺失),构建器回退到单体核心模板,保证智能体在部分部署条件下启动。
附录 D:编辑工具模糊匹配链
edit_file 工具(2.4.2 节)以责任链模式实现九个替换器类,各自解决 LLM 指定的 old_content 与实际文件内容之间的一类特定不匹配。链条在首次匹配短路,精确匹配不因模糊遍产生开销。每个替换器返回在原文件中实际找到的子串(而非搜索查询),保留文件原始格式。
- Simple:精确字符串匹配(基线)。
- Line-trimmed:比较前剥离每行尾随空白。
- Block-anchor:以首行和末行为锚;多候选匹配时用 SequenceMatcher 以 0.3 相似度阈值为中间区域打分。
- Whitespace-normalized:将所有连续空白折叠为单个空格。
- Indentation-flexible:忽略所有前导空白,跳过空行。
- Escape-normalized:反转义常见序列(\n、\t、\)。
- Trimmed-boundary:尝试修剪后内容;找到部分匹配则扩展到完整行边界。
- Context-aware:以首个和最后一个非空行为锚,以 0.5 相似度阈值为所有候选区域打分。
- Multi-occurrence:作为最后手段,对所有出现位置做逐行修剪精确匹配。
附录 E:Shell 执行流水线
shell 执行流水线(2.4.3 节)将每次 run_command 调用处理经过六个阶段(图 17 所示)。
E.1 六阶段流水线细节:
- 安全门。 任何命令执行前运行三项检查:(a) 权限配置判断该命令类别是否需要审批;(b) 允许命令匹配,对照用户配置的安全模式;© 危险模式阻止,拒绝灾难性操作(
rm -rf /、sudo、fork 炸弹、curl|bash管道链、对设备文件做 dd),用户不可覆盖。 - 命令准备。 已知包管理器的交互提示(npm init、npx)通过前置
yes |自动确认。Python 命令获得PYTHONUNBUFFERED=1,防止破坏实时流式传输的输出缓冲。 - 服务器检测。 对 16 个服务器模式(表 6)正则匹配,匹配的命令无论调用方设置如何都自动提升为后台模式。
- 执行分叉。 后台命令在伪终端中派生(
pty.openpty(),Popen 挂到从文件描述符),获得正确处理 ANSI 码、进度条和交互程序的终端模拟输出。前台命令用带管道的subprocess.Popen和start_new_session=True做进程组隔离,确保杀死命令即杀死所有子进程。 - 输出管理。 输出上限 30,000 字符,头尾截断(溢出时前 10,000 + 后 10,000)。实时流式传输经回调将输出送达 UI。
select.select()以 100ms 间隔轮询,平衡响应性与 CPU 开销。 - 超时与中断。 空闲超时在 60 秒无输出后杀死命令。绝对超时上限 600 秒。每个轮询周期检查 InterruptToken(每用户查询共享);触发时,处理器经
os.killpg()杀死整个进程组。
E.2 服务器检测模式。 表 6 列出用于自动提升为后台模式的 16 个正则模式。所有模式以 re.IGNORECASE 匹配。
表 6:自动后台提升的服务器检测模式。
| # | 正则模式 | 框架 |
|---|---|---|
| 1 | flask\s+run | Flask |
| 2 | python.*app\.py | 通用 Python 应用 |
| 3 | python.*manage\.py\s+runserver | Django(manage.py) |
| 4 | django.*runserver | Django(直接) |
| 5 | uvicorn | Uvicorn(ASGI) |
| 6 | gunicorn | Gunicorn(WSGI) |
| 7 | python.*-m\s+http\.server | Python http.server |
| 8 | npm\s+(run\s+)?(start|dev|serve) | npm |
| 9 | yarn\s+(run\s+)?(start|dev|serve) | Yarn |
| 10 | node.*server | Node.js |
| 11 | nodemon | Nodemon |
| 12 | next\s+(dev|start) | Next.js |
| 13 | rails\s+server | Ruby on Rails |
| 14 | php.*artisan\s+serve | Laravel |
| 15 | hugo\s+server | Hugo |
| 16 | jekyll\s+serve | Jekyll |
附录 F:系统提醒目录
本附录提供 2.3.4 节所述 24 个命名系统提醒的完整目录(按类别组织),以及每次 ReAct 迭代内的 9 步注入时机。
F.1 提醒类别。 24 个提醒组织为六个功能类别:
- 阶段控制(4 个提醒):管理思考/行动阶段转换。将思考轨迹注入行动阶段上下文;控制智能体应深入推理还是直接行动。
- 任务生命周期(5 个提醒):引导多步工作流中的阶段转换。子智能体返回后,提示主智能体综合结果。计划批准后,复述计划和待办并附显式工作流指令。会话恢复时,引用既有计划文件。
- 待办强制(2 个提醒):门控过早完成。智能体有待办未完成却调用 task_complete 时,拒绝调用并列出剩余事项。所有待办完成时,发出收尾信号。每次运行上限 2 次提示。
- 错误恢复(8 个提醒):一个通用提示加六个按错误分类(权限、文件未找到、语法、速率限制、超时、编辑不匹配)选择的类型特定提示,以及一个 Docker 特定提示。每段错误序列上限 3 次尝试。
- 行为纠正(5 个提醒):纠正可观察的反模式。连续 5 次以上只读工具调用后,打破探索螺旋。用户拒绝工具调用后,防止重试。空完成时,请求简短结果摘要。达到迭代安全上限时,强制摘要。
- JSON 重试(2 个提醒):记忆系统 Reflector 和 Curator 组件 JSON 输出解析失败时的专门解析重试提示。
F.2 注入时机。 提醒由 ReAct 执行器在每次迭代内按严格的 9 步顺序注入:
- 自动压缩检查(上下文压力评估)。
- 中断检查(用户取消)。
- 思考阶段,可选将轨迹注入行动上下文。
- 子智能体完成信号(若有子智能体返回结果)。
- 排空 UI 线程消息(审批结果、用户输入)。
- 中断检查(LLM 调用前第二道门)。
- 行动阶段 LLM 调用。
- 响应分发:提醒按响应类型分岔——无工具调用路径:依次检查失败工具提示、未完成待办提示、空完成提示;有工具调用路径:工具执行后,检查计划已批准信号、所有待办完成信号、工具被拒提示、连续读取提示。
- 会话持久化(自动保存)。
安全守卫。 两个机制防止提醒退化为噪声:(1) 一次性标志确保某些提醒每次智能体运行最多触发一次(plan_approved_signal_injected、all_todos_complete_nudged、completion_nudge_sent);(2) 尝试预算为可重复提醒设上限(MAX_TODO_NUDGES = 2,MAX_NUDGE_ATTEMPTS = 3)。
附录 G:子智能体能力矩阵
表 7 记录完整的子智能体注册表。每个子智能体接收限制到其领域的过滤工具集,防止范围蔓延并限制爆炸半径。所有子智能体默认以无界迭代预算运行;ask-user 子智能体是特例,完全绕过 LLM 执行路径。
表 7:子智能体类型、工具访问与用例。工具数反映过滤后的注册表;主智能体可访问全部 35 个内置工具。
| 子智能体 | 可用工具 | 用例 |
|---|---|---|
| Code-Explorer | read_file、search、list_files、find_symbol、find_referencing_symbols | 深度代码库探索、架构分析、模式发现 |
| Planner | 全部只读 + write_file、edit_file、spawn_subagent、ask_user、task_complete | 带代码库分析和计划文件写入的实现规划 |
| PR-Reviewer | read_file、search、list_files、find_symbol、find_referencing_symbols、run_command | Pull request 代码审查、diff 分析、合并前审查 |
| Security-Reviewer | read_file、search、list_files、find_symbol、find_referencing_symbols、run_command | 安全审计、漏洞评估、严重性/置信度打分 |
| Web-Clone | capture_web_screenshot、analyze_image、write_file、read_file、run_command、list_files | 可视化网站分析与 UI 复刻 |
| Web-Generator | write_file、edit_file、run_command、list_files、read_file | 从规格创建 Web 应用(React/TypeScript/Tailwind) |
| Project-Init | read_file、search、list_files、run_command、write_file | 从代码库分析生成 OPENDEV.md 项目指令文件 |
| Ask-User | (无;仅 UI) | 呈现结构化多选调查;绕过 LLM 执行 |
附录 H:配置模式
表 8 描述 OpenDev AppConfig 模型中的关键配置字段。
表 8:OpenDev 关键配置字段。
| 字段 | 类型 | 描述 |
|---|---|---|
| model | str | LLM 模型标识符 |
| provider | str | API 提供商(openai、azure 等) |
| max_context_tokens | int | 最大上下文窗口大小 |
| temperature | float | LLM 采样温度 |
| max_tokens | int | 最大响应 token 数 |
| thinking_model | str | 思考阶段使用的模型 |
| thinking_provider | str | 思考模型的提供商 |
| auto_approve | bool | 跳过审批对话框 |
| web_search_provider | str | Web 搜索后端 |
| mcp_servers | dict | MCP 服务器配置 |
| blocked_commands | list | 额外阻止的 shell 命令 |
附录 I:实现常量
本节记录关键实现常量及其理由。
表 9:OpenDev 实现常量及依据。
| 常量 | 取值 | 理由 |
|---|---|---|
| 压缩阶段 | 70/80/90/99% | 四个渐进阈值:警告、遮蔽、激进遮蔽、完整压缩 |
| 最大撤销历史 | 50 个操作 | 有界增长防止长会话内存溢出 |
| 最大提示尝试 | 3 | 平衡恢复机会与强制推进 |
| 死循环阈值 | 3 次重复 | 相同(工具,参数)指纹在滑动窗口中出现 3 次触发警告 |
| 死循环窗口 | 20 次调用 | 近期工具调用指纹的滑动窗口 |
| 思考级别 | 4(OFF–HIGH) | OFF、LOW、MEDIUM、HIGH(含自我批判) |
| 编辑模糊遍数 | 9 | 责任链(附录 D) |
| 工具输出卸载 | 8,000 字符 | 写入暂存文件;保留 500 字符预览 |
| 观测遮蔽 | 6/3 个最近 | 80%/90% 压缩时保持完整保真度的输出数 |
| 子智能体迭代限制 | 15 | 限制探索同时允许充分调查 |
| 最大并发工具 | 5 | 平衡并行开销与利用率 |
| 会话 ID 长度 | 8 字符 | 人类可读,62⁸ 唯一值 |
| 提供商缓存 TTL | 24 小时 | 平衡陈旧性与网络调用 |
| 摘要再生 | 每 5 条消息 | 摊销成本,防止漂移累积 |
| 近期消息尾部 | 3–10 条消息 | 按对话长度自适应 |
| 最大工具结果长度 | 300 token | 防止冗长输出污染上下文 |
附录 J:CLI 命令参考
常用命令行选项和交互命令:
启动选项:
opendev— 启动交互式终端 UIopendev -p "prompt"— 非交互式单提示执行opendev --continue— 恢复最近会话opendev --working-dir /path— 设置项目上下文opendev run ui— 启动 Web UI
交互命令(斜杠命令):
/mode— 在普通与规划模式间切换/undo— 撤销最近的文件操作/clear— 清除对话历史/sessions— 列出可用会话/thinking— 配置思考级别/exit— 退出会话
MCP 服务器管理:
opendev mcp list— 列出已配置的 MCP 服务器opendev mcp add <name> <command>— 添加 MCP 服务器opendev mcp enable <name>— 启用 MCP 服务器opendev mcp disable <name>— 禁用 MCP 服务器
键盘快捷键(TUI):
- Shift+Tab — 切换普通/规划模式
- Ctrl+C — 中断智能体执行
- Ctrl+L — 清屏
/+ 文本 — 触发命令自动补全
附录 K:完整系统提示模板(概览)
附录 K 逐字重现 OpenDev 使用的每个系统提示模板的内容(英文原文)。每个模板是存储在 templates/system/ 下的 Markdown 文件,由 PromptComposer 在剥离 HTML frontmatter 后加载(附录 C)。其内容正是 LLM 作为系统提示的一部分收到的文本。模板按角色分组:
- K.1 核心身份模板:确立智能体人格(拥有完整工具访问的高级软件工程师 OpenDev),作为包装器在模块化段落追加前加载。直接任务(读文件、做编辑、跑命令、快速搜索)自己执行;复杂、多步或受益于聚焦上下文的任务(深度代码库探索、全面代码审查、多文件重构)委托给专门子智能体。
- K.2 主智能体提示段落:由
create_default_composer()注册的 21 个段落,按优先级带分组——核心身份与策略(优先级 10–30)、交互与工具引导(40–50)、代码质量与安全(55–65)、条件段落(70–80)、上下文感知(85–95)。内容对应附录 C 表 3 的注册表。 - K.3 思考模式模板:4 个段落,对应附录 C.2。
- K.4 专门独立模板:compaction、critique、init 等独立模板,对应附录 C.3。
由于这些模板是系统实际运行的功能性英文提示词(而非描述性文字),本译文保留其英文原貌,逐字内容请见原文附录 K:https://arxiv.org/html/2603.05344v1
参考文献(保留英文,完整列表见原文)
- Anonymous. Agentic software engineering, foundational pillars and a research roadmap. arXiv preprint, 2025.
- Anthropic. Model context protocol. https://modelcontextprotocol.io, 2024.
- Anthropic. Claude Code: An agentic coding tool. 2025.
- Anthropic. Effective context engineering for AI agents. 2025.
- Anysphere. Cursor: The AI code editor. 2025.
- Asai et al. Self-RAG: Learning to retrieve, generate, and critique through self-reflection. ICLR 2024.
- Austin et al. Program synthesis with large language models (MBPP). 2021.
- Baddeley. Working memory. Science, 1992.
- Besta et al. Graph of thoughts. AAAI 2024.
- Block. Goose: An open-source AI agent. 2025.
- Bui et al. CodeTF: One-stop transformer library for state-of-the-art code LLM. 2023.
- Chan et al. MLE-bench: Evaluating machine learning agents on ML engineering. ICLR 2025.
- Charm. Crush: An agentic coding tool for the terminal. 2025.
- Chen et al. CodeR: Issue resolving with multi-agent and task graphs. 2024.
- Chen et al. Evaluating large language models trained on code (HumanEval). 2021.
- Chen et al. SpecRover: Specification-guided patch generation. 2024.
- Clune, Stanley et al. Diverse agent populations for more robust exploration. 2024.
- Cognition. Introducing Devin, the first AI software engineer. 2024.
- OpenCode Contributors. OpenCode: AI-powered terminal assistant. 2025.
- Deng et al. Investigating data contamination in modern benchmarks for LLMs. NAACL 2024.
- Deng et al. SWE-bench Pro: Can AI agents solve long-horizon software engineering tasks? 2025.
- Ding et al. NL2Repo-Bench: Towards long-horizon repository generation evaluation of coding agents. 2025.
- Du et al. Evaluating large language models in class-level code generation (ClassEval). ICSE 2024.
- Eliseeva et al. EnvBench: A benchmark for automated environment setup. 2025.
- Feng et al. LongCLI-Bench: A preliminary benchmark and study for long-horizon agentic programming in CLIs. 2025.
- Gao et al. PAL: Program-aided language models. ICML 2023.
- Gauthier. Aider: AI pair programming in your terminal. 2024.
- Ge et al. In-context autoencoder for context compression in a large language model. ICLR 2024.
- GitHub. GitHub Copilot: Meet the new coding agent. 2025.
- Google. Gemini CLI. 2025.
- Guo et al. DeepSeek-Coder: When the large language model meets programming. 2024.
- Gutierrez et al. HippoRAG: Neurobiologically inspired long-term memory for LLMs. NeurIPS 2024.
- He et al. EHRAgent: Code empowers LLMs for few-shot complex tabular reasoning on EHRs. 2024.
- Hendrycks et al. Measuring coding challenge competence with APPS. 2021.
- Hu et al. Memory in the age of AI agents. 2025.
- Hua et al. Context engineering 2.0: The context of context engineering. 2025.
- Jimenez et al. SWE-bench: Can language models resolve real-world GitHub issues? ICLR 2024.
- Kang et al. ACON: Optimizing context compression for long-horizon LLM agents. 2025.
- Kwa et al. Measuring AI ability to complete long tasks. 2025.
- Kwa et al. Measuring AI ability to complete long tasks. 2025.
- Lewis et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. NeurIPS 2020.
- Li et al. Prompting LLMs to tackle the full software development lifecycle (DevEval). COLING 2025.
- Li et al. Advances and frontiers of LLM-based issue resolution in software engineering: A comprehensive survey. 2025.
- Li et al. From code foundation models to agents and applications: A comprehensive survey and practical guide to code intelligence. 2025.
- Li et al. StarCoder: May the source be with you! 2023.
- Li et al. FEA-Bench: A benchmark for evaluating repository-level code generation for feature implementation. 2025.
- Li et al. Competition-level code generation with AlphaCode (CodeContests). Science, 2022.
- Li et al. AEGIS: Automated environment setup for bug reproduction. 2024.
- Liang et al. Code as Policies: Language model programs for embodied control. ICRA 2023.
- Lightman et al. Let’s verify step by step. 2023.
- Liu et al. Reasoning Bank: Learning from trajectories for program repair. 2024.
- Liu et al. Efficient evaluation of LLM agents: Cost, latency, and token consumption. 2024.
- Mei et al. A survey of context engineering for large language models. 2025.
- Merrill et al. Terminal-Bench: Benchmarking agents on hard, realistic tasks in CLIs. 2025.
- Microsoft. Language Server Protocol specification. 2016.
- Miserendino et al. SWE-Lancer: Can frontier LLMs earn $1 million from real-world freelance software engineering? ICML 2025.
- Mündler et al. SWT-bench: Testing and validating real-world bug-fixes with code agents. NeurIPS 2024.
- Nathani et al. MLGym: A new framework and benchmark for advancing AI research agents. 2025.
- Ong et al. RouteLLM: Learning to route LLMs with preference data. 2024.
- Open Interpreter. 2023.
- OpenAI. Introducing SWE-bench Verified. 2024.
- OpenAI. Introducing Codex. 2025.
- Packer et al. MemGPT: Towards LLMs as operating systems. 2023.
- Patil et al. The Berkeley Function Calling Leaderboard (BFCL). ICML 2025.
- Pham et al. SWE-smith: Synthesizing verifiable bug-fix data. 2025.
- Phan et al. HyperAgent: Generalist software engineering agents to solve coding tasks at scale. 2024.
- Press et al. Measuring and narrowing the compositionality gap in language models (Self-Ask). 2022.
- Qiao et al. TaskWeaver: A code-first agent framework. 2023.
- Rozière et al. Code Llama: Open foundation models for code. 2023.
- Sarthi et al. RAPTOR: Recursive abstractive processing for tree-organized retrieval. ICLR 2024.
- Shinn et al. Reflexion: Language agents with verbal reinforcement learning. NeurIPS 2023.
- Siegel et al. CORE-Bench: Fostering the credibility of published research through a computational reproducibility agent benchmark. 2024.
- (Context-Folding) Scaling agent capabilities through recursive context summarization. 2025.
- (CodeAgents) Orchestration patterns for code agents. 2024.
- (MAGIS) Role-playing collaboration for multi-agent issue resolution. 2024.
- (SWE-EVO) Long-horizon software evolution benchmark. 2025.
- (Interleaving retrieval with chain-of-thought) Agentic search pattern reference.
- Wang et al. Voyager: An open-ended embodied agent with LLMs. 2023.
- (Issue2Test) Feedback-driven failing test synthesis.
- Wang et al. CodeAct: Executable code actions. 2024.
- Wang et al. OpenHands: An open platform for AI software developers. 2024.
- (Experience banks) Guiding search through accumulated knowledge.
- (CodeMonkeys) Parallel exploration strategies for solution coverage.
- Wang et al. CodeT5+: Open code large language models. 2023.
- (Agentic search) Dynamic retrieval control in complex environments.
- Xia et al. Agentless: Demystifying LLM-based software engineering agents. 2024.
- Xie et al. OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. 2024.
- (Curriculum learning SFT) Supervised fine-tuning with curriculum learning for issue resolution.
- Xu et al. ReWOO: Decoupling reasoning from observations for efficient augmented language models. 2023.
- (Benchmark renewal) Continuous benchmark renewal against data contamination.
- Yang et al. SWE-Agent: Agent-computer interfaces enable automated software engineering. 2024.
- Yang et al. SWE-bench / SWE-Agent references. 2024.
- Yang et al. SWE-bench Multimodal. 2024.
- Yao et al. τ-Bench: A benchmark for tool-agent-user interaction in real-world domains. 2024.
- Yao et al. Tree of thoughts: Deliberate problem solving with large language models. NeurIPS 2023.
- Yao et al. ReAct: Synergizing reasoning and acting in language models. ICLR 2023.
- (ReplicationBench) Research replication benchmark.
- Ye et al. Meta Context Engineering (MCE). 2025.
- Young. On agent harnesses: runtime orchestration frameworks for long-horizon agents. 2025.
- Zaharia et al. The shift from models to compound AI systems. 2024.
- Zan et al. Multi-SWE-bench. 2025.
- (Autonomous agents survey) Agentic coding assistants.
- (ExpeRepair) Dual-memory architecture for experience-driven repair.
- (Agentic Context Engineering) Self-improving context evolution.
- Zhang et al. AutoCodeRover: Autonomous program improvement. 2024.
- (Otter) Feedback-driven test generation.
- Zheng et al. MT-Bench: Judging LLM-as-a-judge. 2023.
- (Cognitive architectures) Episodic/semantic/procedural memory partitioning.
- (MCTS for repair) Monte Carlo Tree Search over repair trajectories.
- Zhou et al. WebArena: A realistic web environment for building autonomous agents. 2023.
- (Agentic Benchmark Checklist I) Best practices for agentic evaluation.
- (Agentic Benchmark Checklist II) Reproducibility and contamination prevention.
注:以上为按引用编号的简要列表;个别条目原文即标注不详(匿名或预印本)。完整著录信息请见原文:https://arxiv.org/html/2603.05344v1


 扫一扫


 260

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


