RAGFlow核心引擎DeepDoc之PDF解析大起底

深度拆解RAGFlow分片引擎之切片实现 本文深入解析了RAGFlow的文档处理核心组件deepdoc,重点介绍其pdf解析器的实现。文章指出deepdoc包含parser(文档解析)和vision(视觉处理)两大模块,其中pdf解析是最复杂部分。通过源码分析展示了PdfParser类的整体架构,包括三个实现类:轻量级文本提取工具PlainParser、核心处理器RAGFlowPdfParser和功能扩展VisionParser。详细解读了初始化方法__init__的资源加载逻辑和标准解析流程__call__的实现方式,揭示了文档解析、布局分析、表 阅读详情

前面讲解了深度拆解RAGFlow分片引擎之切片实现 并没有深入的介绍deepdoc,我们今天来看下deepdoc。

综述
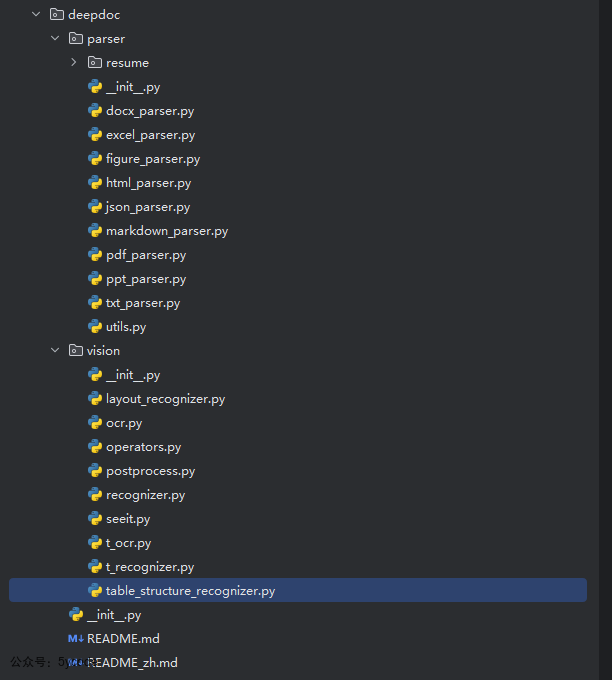
在deepdoc中主要有两个目录parser和vision。

  • parser是解析器,解析器是各种文档的解析实现,最复杂就是pdf的解析
  • vision是视觉处理,主要包括OCR、布局识别、表结构识别

解析器在实现的过程中依赖视觉处理

pdf 文档解析器

在之前的切盼方法详解中。我们知道每个切片,只要涉及到pdf处理的,都有一段类似的代码

class Pdf(PdfParser):  
    def __init__(self):  
  
    def __call__(self, filename, binary=None, from_page=0,  
                 to_page=100000, zoomin=3, callback=None, separate_tables_figures=False):  
        start = timer()  
        first_start = start  
        callback(msg="OCR started")  
        # ocr识别
        self.__images__(  
            filename if not binary else binary,  
            zoomin,  
            from_page,  
            to_page,  
            callback  
        )  
        callback(msg="OCR finished ({:.2f}s)".format(timer() - start))  
        start = timer()  
        # 布局分析 识别标题/段落等层级
        self._layouts_rec(zoomin)  
        callback(0.63, "Layout analysis ({:.2f}s)".format(timer() - start))  
  
        start = timer()  
        # 使用 transformer 进行表格检测与识别
        self._table_transformer_job(zoomin)  
        callback(0.65, "Table analysis ({:.2f}s)".format(timer() - start))  
  
        start = timer()  
        self._text_merge()  
        callback(0.67, "Text merged ({:.2f}s)".format(timer() - start))  
        # 是否分离表格和图形  
        if separate_tables_figures:  
            tbls, figures = self._extract_table_figure(True, zoomin, True, True, True)  
            self._concat_downward()  
            logging.info("layouts cost: {}s".format(timer() - first_start))  
            # 返回文本块+表格+图形  
            return [(b["text"], self._line_tag(b, zoomin)) for b in self.boxes], tbls, figures  
        else:  
            tbls = self._extract_table_figure(True, zoomin, True, True)  
            # self._naive_vertical_merge()  
            self._concat_downward()  
            # self._filter_forpages()  
            logging.info("layouts cost: {}s".format(timer() - first_start))  
            return [(b["text"], self._line_tag(b, zoomin)) for b in self.boxes], tbls

PdfParser指向的就是pdf解析器。
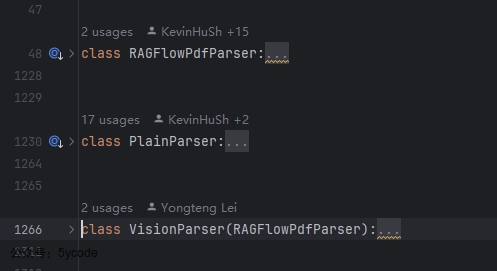
在pdf_parser.py文件中,总共有1000多行代码,有3个类。

  • PlainParser 是轻量级工具类,仅提供最基础的文本提取
  • RAGFlowPdfParser 是核心处理器,包含完整的文档理解流水线
  • VisionParser 是功能扩展,在核心功能上增加视觉模型能力

虽然三个类的实现不同,但通过统一的 __call__ 方法返回相同格式:

初始化方法__init__

在这里把所有的资源进行了初始化。

def __init__(self, **kwargs):  
    """  
    If you have trouble downloading HuggingFace models, -_^ this might help!!  
    For Linux:    export HF_ENDPOINT=https://hf-mirror.com  
    For Windows:    Good luck    ^_-  
    """    
    # OCR引擎  
    self.ocr = OCR()  
    self.parallel_limiter = None  
    # 计算gpu的数量,来推测并行数量  
    if PARALLEL_DEVICES is not None and PARALLEL_DEVICES > 1:  
        #  每个GPU独占1个工作槽位  
        self.parallel_limiter = [trio.CapacityLimiter(1) for _ in range(PARALLEL_DEVICES)]  
    # 动态模型选择  
    if hasattr(self, "model_speciess"):  
        self.layouter = LayoutRecognizer("layout." + self.model_speciess)  
    else:  
        self.layouter = LayoutRecognizer("layout")  
    # 表格结构识别器  
    self.tbl_det = TableStructureRecognizer()  
    self.updown_cnt_mdl = xgb.Booster()  
    # GPU加速优化  
    if not settings.LIGHTEN:  
        try:  
            import torch.cuda  
            if torch.cuda.is_available():  
                self.updown_cnt_mdl.set_param({
   
   "device": "cuda"})  
        except Exception:  
            logging.exception("RAGFlowPdfParser __init__")  
    # 双路径加载设计  
    try:  
        # 优先从本地加载  
        model_dir = os.path.join(  
            get_project_base_directory()

【Ragflow】13.Deepdoc效果一言难尽,MinerU解析降维打击 要用好rag的输出增强效果,文档解析是关键一环。如果文档解析块存在问题,那么后面检索到的内容,也会对模型造成错误干扰。前文分析过,ragflow使用自研的Deepdoc算法对不同类型的文档进行解析,然而,对于pdf文件,在多数情况下的解析效果并不如意。 阅读详情

相关推荐

RAGFlow实战:如何用DeepDoc解析复杂PDF表格(附完整代码解析)

本文详细介绍了如何利用DeepDoc这一专业级PDF解析引擎,结合RAGFlow实现复杂PDF表格的高精度提取。通过视觉布局分析、表格结构识别和多模态融合等关键技术,DeepDoc能够有效解决传统OCR工具在表格数据提取中的常见问题。文章还提供了完整的代码解析和实战案例,帮助开发者快速掌握这一技术。

hh234的博客 844

RagFlow深度解析:如何通过DeepDoc实现高效文档理解与处理

本文深度解析了RagFlow如何通过DeepDoc实现高效文档理解与处理。DeepDoc作为核心引擎,结合混合OCR、版面理解和表格重建技术,显著提升文档解析准确率。文章详细介绍了文档解析全流程、性能调优策略及高级功能实战,助力企业高效处理各类文档。

Python的专栏 828

DeepDoc解析引擎在RAGFlow中的核心技术解析与应用实践

本文深入解析了DeepDoc解析引擎在RAGFlow中的核心技术与应用实践。作为RAGFlow的核心组件,DeepDoc通过OCR、版面分析、表格识别等多模块协同工作,实现对复杂文档的深度理解与结构化解析,为后续高质量检索与生成奠定坚实基础。文章还探讨了其在金融合同、学术论文等场景的实战表现及性能优化策略。

weixin_29034963的博客 403

RagFlow实战:如何用DeepDoc引擎高效处理扫描PDF文档(附完整代码解析)

本文详细解析了如何利用RagFlow的DeepDoc引擎高效处理扫描PDF文档。通过实战演示从环境搭建、PDF预处理、文本检测与识别,到布局分析与表格结构提取的完整流程,并提供了完整的代码实现。该方案超越了传统OCR,能输出保留原始版面信息的结构化数据,为构建高质量知识库提供了强大支持。

weixin_29245767的博客 294

DeepDoc实战:用RAGFlow版面分析引擎彻底搞定PDF解析难题

从概念到原理,再到工程实践,解析PDF是构建RAG知识库中最基础也最头疼的一环。PDF本质是坐标与图形指令的集合,常规文本提取无法保留标题、表格、公式等结构信息。DeepDoc作为RAGFlow内置的文档解析引擎,通过深度学习版面检测将页面划分为标题、正文、表格、页眉页脚等区域,并结合OCR与表格结构还原,为后续切片、向量化提供结构化输入。本文结合实战经验,详细介绍了DeepDoc的三种解析模式、页面阈值与模板选择技巧、表格公式处理难点、批量校验方法以及常见问题排查,帮助你在搭建RAG知识库时少走弯路。

weixin_29038303的博客 251

RAGFlow源码拆解:DeepDoc三阶段PDF解析流水线

文档解析是构建RAG知识库时最容易被低估的工程环节。PDF并非真正的结构化格式,而是一组按坐标放置文字与图形的打印指令,文本顺序错乱、扫描件缺失文本层、表格结构丢失是常见痛点。直接抽取文本的方案在真实场景频繁失效,更稳健的思路是将PDF渲染为图像,通过版面分析识别标题、正文、表格区域,再用OCR补全文字信息,最后将结果映射回页面坐标并输出结构化数据。这种流水线解耦了版面理解与文字识别,对扫描件、混合版式等脏数据兼容性更强,已成为RAG应用落地的关键技术底座。RAGFlow的DeepDoc模块正是这一思路的工

weixin_31062533的博客 331

RAGFlow实战:如何用DeepDoc解析器处理扫描版PDF(附性能优化技巧)

本文详细介绍了如何使用RAGFlow的DeepDoc解析器高效处理扫描版PDF文档,包括应对低分辨率、倾斜、复杂表格等挑战的深度学习技术方案。通过硬件选型建议、Docker部署配置及性能优化技巧,帮助用户实现工业级文档解析,显著提升OCR处理效率和准确性。

weixin_28221501的博客 429

RAGFlow知识库实战:从PDF解析到智能问答的完整配置流程(含DeepDoc技巧)

本文详细介绍了RAGFlow知识库从PDF解析到智能问答的完整实战配置流程。重点探讨了DeepDoc解析器的优化技巧、多格式文档处理策略、嵌入模型选择与检索优化,为企业级知识库的落地部署提供了全面的指南和解决方案。

weixin_29043895的博客 519

RAGFlow开源RAG引擎:从本地化部署到知识库搭建全流程解析

RAG(检索增强生成)是当前大模型落地中的关键技术,它通过外部知识库增强模型回答的准确性,解决模型“知识陈旧”和“幻觉”问题。在实际工程中,一个完整的RAG系统需要处理文档解析、分块、向量化、检索、重排和对话生成等多个环节,而RAGFlow作为开源RAG引擎,将这些能力整合在统一平台中。它内置DeepDoc文档解析引擎,支持表格还原、OCR、多栏版面分析,显著降低了文档“进不来、检不准”的痛点。通过Docker容器化部署,用户可以快速搭建私有化知识库,实现本地化问答。结合实际部署经验,从环境准备、知识库搭建

weixin_33843409的博客 443

RAGFlow实战:如何用DeepDoc解析器提升PDF表格识别准确率(附配置技巧)

本文深入探讨了如何利用RAGFlow的DeepDoc解析器,通过调整缩放因子、版面分析、表格结构识别等关键配置,有效提升PDF中复杂表格(尤其是扫描件和跨页表格)的识别准确率。文章提供了从原理理解到参数调优的实战技巧,帮助用户构建高鲁棒性的文档解析流水线。

dapp9builder的博客 461

RAGFlow与DeepDoc深度文档理解技术解析与应用

深度文档理解技术是自然语言处理(NLP)领域的重要分支,通过结合计算机视觉与大语言模型,实现对文档内容的多模态解析与语义理解。其核心技术原理包括分层解析算法、动态分块策略和领域适配向量化,能有效解决传统OCR和关键词检索的局限性。在工程实践中,该技术显著提升了知识库构建、智能问答和信息检索的效率,特别适用于处理技术文档、法律合同等复杂场景。RAGFlow作为集成DeepDoc技术的智能平台,通过本地化部署和性能优化方案,已在企业级应用中展现出10倍以上的效率提升。

weixin_29794879的博客 282

AI学习指南RAG篇(23)-RAGFlow的DeepDoc模块

DeepDoc作为RAGFlow的核心组件,通过利用OCR、布局识别、表格结构识别等技术,实现了对文档的深度理解和信息提取。这些技术不仅能够处理多种文档格式,还能智能地识别文档中的各种元素,为后续的检索和生成提供支持。希望本文的介绍能帮助您更好地理解和使用DeepDoc。

俞兆鹏的博客 1611

大模型面试题34:Transformer的Encoder和Decoder区别与协作

Encoder:双向自注意力,专注理解输入,输出语义特征;Decoder:掩码自注意力+编码器-解码器注意力,专注生成输出,实现语义对齐。

叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 807

三维重建之条纹投影结构光(三)——相高模型标定

接上面两文: 三维重建之条纹投影结构光(一)https://blog.csdn.net/beyond951/article/details/123361852?spm=1001.2014.3001.5501三维重建之条纹投影结构光(二)——四步相移+三频外差法https://blog.csdn.net/beyond951/article/details/123769596?spm=1001.2014.3001.5501接下来对相高模型进行标定,其推导过程如下图所示 ...

beyond951的博客 4871

YOLOv8改进-bifpn

跨尺度连接通过添加一个跳跃连接和双向路径来实现,自此实现了加权融合和双向跨尺度连接。该结构是加权且双向连接的,即自顶向下和自底向上结构,通过构造双向通道实现跨尺度连接,将特征提取网络中的特征直接与自下而上路径中的相对大小特征融合,保留了更浅的语义信息,而不会丢失太多的深层语义信息。传统的特征融合时将尺度不同的特征图以相同权重进行加权,但是当输入的特征图分辨率不同时,以相同的权重进行加权对输出的特征图不平等。所以BiFPN根据不同输入特征的重要性设置不同的权重,同时反复采用这种结构来加强特征融合。

weixin_45303602的博客 8122

cesium单向流动线效果

在学材质的路上一去不复返了属实是,难也难在这。还请各位大佬多多指教~

就zhei? 686

OD图 arcgis曲线制作插件 od图曲线 路径图曲线制作插件 航线图曲线制作插件

在ArcGIS 10.2 中导入节点数据,打开插件,选择输入起始节点和目标节点的节点文件Point,以Name字段(地名)为连接线的起始字段和目标字段,(Input Table File)选择连接关系表格SDLine.csv,(Origin Column 和 Destination Column)为起始节点和目标节点,(Output Path)为输出路径,应选择.gdb数据库路径,否则容易报错,(Chord Coefficient)为连线的曲率,数值越大,曲率越高。运行环境:ArcGIS10.2。...

JData_Engineer的博客 2664

【NLP】第十五章:隐马尔可夫——前向算法、后向算法、维特比算法、Baum-Welch算法

就是好比我现在知道了观测序列Observations、掩藏序列States,我试着去学一个最优的(π, A, B),让在这个(π, A, B)下,观测序列Observations、掩藏序列States的概率最大。(2)矩阵B就更好理解了,矩阵B的第一行表示我已经抽取的是盒子1,那我抽取白球的概率就是0.4,抽取黑球的概率就是0.6了,因为第一个盒子只有4白6黑嘛。三是,由于每次抽取的小球的颜色的概率不仅取决于,小球所在的盒子中的黑白球的比例,还取决于你是从哪个盒子中抽的,所以其实观测序列还对应着一个。

因为热爱所以坚持 1156

MuJoCo XLA (MJX) 强化学习人形机器人四足机器人入门教程(三)

MJX 是用 JAX 编写的 MuJoCo 实现,可以在 GPU/TPU 上进行大批量训练。在本笔记本中,我们将演示如何使用 MJX 训练 RL 策略。在开始大量 RL 工作负载之前,我们先从一个简单的示例开始!xml = """"""接下来,我们使用 MJX 将 MuJoCo 模型和数据放到 GPU 设备上。下面,我们将打印来自 MuJoCo 和 MJX 的 qpos。

2506_90492529的博客 2467

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

上一篇: 深度拆解RAGFlow分片引擎之切片实现
下一篇: MCP不像想象的那么简单,MCP+数据库,rag之外的另一种解决方案
5ycode
博客等级 码龄18年 4393粉丝 378原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值