


AI前沿 | 2026年9月20日:阿里 Qwen3.8-LiveTranslate —— 2.3 秒同传、Interleave 架构与 Thinker-Talker 双模
📖 首屏导读 · 本教程配套付费专栏:《大模型工程师修炼手记》
19.9 元(AI 编程 · Agent 实战 · 本文同主题系统课程)· 《AI时代程序员的自我提升》49.9 元(AI 时代成长方法论)单篇不过瘾?订阅解锁全量源码、实战与答疑;文末附资料包领取方式 ↓
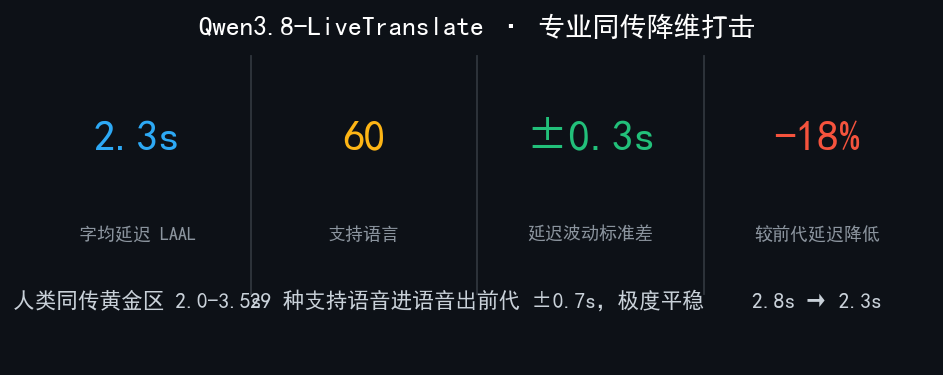
📊 本期导读:9 月 19 日,阿里巴巴通义千问团队发布新一代即時同声传译模型 Qwen3.8-LiveTranslate,把字均延迟(LAAL)压到 2.3 秒——这是 AI 第一次在工业级部署下,踩进联合国顶级同传译员的黄金反应区间(Ear-Voice Span,2.0~3.5 秒)。架构上没有走传统的「ASR+翻译+TTS 拼装流水线」,而是用 Interleave 交错因果架构把「听、等、译、说」编进同一条自回归序列,再用 Thinker-Talker 双模(Hybrid-MoE)让「思考」与「发声」并行:Thinker 负责跨语言语义对齐,Talker 专职高速语音合成与零样本音色复刻。支持 60 种语言、29 种语音进语音出,内置多人说话人分离与双语字幕同帧对齐,模型
qwen3.8-livetranslate-flash-realtime已上架阿里云百炼。本期拆六件:2.3 秒为什么是分水岭、十个关键数字、Interleave 与 Thinker-Talker 怎么搭、专业同传如何被重做、对做实时语音/出海产品的启示、一个开放问题。
一、事件:AI 同传第一次踩进「人类同传员的耳朵」
过去十年,「机器同传」一直是「能用但不敢开大会用」的存在——传统方案是 ASR、翻译、TTS 三段拼装(Cascade):先等一句话说完再切块翻译,再串 TTS 发声,一轮下来平均延迟 3.5~5.0 秒,且经常因切分不均卡顿。而人类专业同传译员大约要延迟 2~3.5 秒才开始说话——他们不是「等你说完再译」,而是「边听边预判边说」,专业上叫 Ear-Voice Span(耳朵到声音的跨度)。
Qwen3.8-LiveTranslate 这次的定量突破,就是把 LAAL 从上一代的 2.8 秒干到 2.3 秒(降幅约 18%),并且把延迟波动标准差从 ±0.7 秒收窄到 ±0.3 秒。「平均延迟达标」和「波动极小」放在一起看才是关键:延迟稳定意味着不会忽然卡顿,这决定了它能不能真的站上发布会、商务谈判和直播这种「一卡就穿帮」的场景。
二、十个关键数字
| 指标 | 值 | 含义 |
|---|---|---|
| 字均延迟(LAAL) | 2.3 秒 | 首次进入人类同传黄金区(2.0~3.5s) |
| 延迟波动标准差 | ±0.3 秒(前代 ±0.7s) | 极度平稳,罕见卡顿 |
| 支持语言 | 60 种 | 覆盖主要语种互译 |
| 语音端到端 | 29 种 | 语音进、语音出 |
| 架构 | Interleave 交错因果序列 | 听/等/译/说一条流 |
| 双模设计 | Thinker–Talker(Hybrid-MoE) | 思考与发声解耦并行 |
| 说话人处理 | 多说话人分离 + 各自音色复刻 | 多人会议可用 |
| 字幕对齐 | 双语同屏同帧流式对齐 | 毫秒级字幕 |
| 上下文消歧 | 长上下文识别人名/术语/代词 | 跨句翻得准 |
| 上线形态 | qwen3.8-livetranslate-flash-realtime(百炼平台) | 云 API 直接可用 |
三、架构:把「听、等、译、说」编进同一条流
Qwen3.8-LiveTranslate 的底层思路,是从「流水线拼接」切换到「单序列决策」:
- Interleave 交错因果架构:不再用固定时间分块轮询 ASR,而是把音频输入与文字/语音输出编排进一个自回归序列,让模型自己学会「何时听、何时等、何时译、何时说」。因果性保证了它只依据已发生的内容向前推进,不会「翻后句补前句」。
- Thinker–Talker 双模(Hybrid-MoE):把「大脑」和「发音器官」拆开并行——Thinker 专注跨语言语义对齐、语法重建(比如中英倒装、定语从句提前),Talker 专职流式语音合成与零样本音色复刻(你说什么口音,它就尽量用什么口音回)。
- 多人语音分离 + 同屏字幕对齐:不是「会场里只译主发言」,而是能区分多说话人、各自保留音色,并在界面上给出双语同步滚动字幕。
这套设计的聪明之处在于:同传本来就是「边听边说」的任务,把它从『三辆车接力』改成『一辆车并排跑』,延迟的源头就没了——拼接方案里每一个环节的排队与被切块打断都被绕开。
四、数字怎么读:2.3 秒到底意味着什么
| 口径 | 延迟(LAAL) | 稳定性 |
|---|---|---|
| 前代 Qwen3.5-LiveTranslate | ~2.8 秒 | ±0.7s |
| 业界传统拼装方案(Cascade) | 3.5~5.0 秒 | ±1.5s,常卡顿 |
| Qwen3.8-LiveTranslate | 2.3 秒 | ±0.3s |
| 联合国顶级同传译员(EVS) | 2.0~3.5 秒 | 动态自适应 |
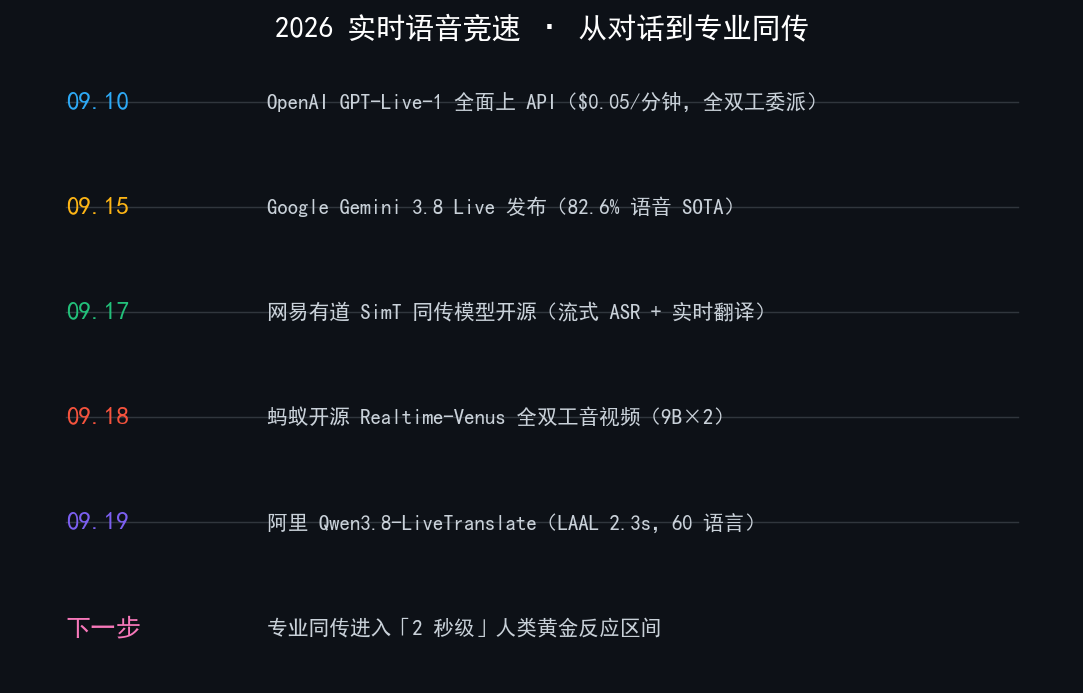
把它放进 2026 年 9 月的「实时语音竞速」看位置:OpenAI 9 月 10 日把 GPT-Live-1 放上 API(每分钟 0.05 美元、主打通话式全双工),Google 9 月 15 日发布 Gemini 3.8 Live(82.6% 语音 SOTA),蚂蚁 9 月 18 日开源 Realtime-Venus 全双工音视频,阿里 9 月 19 日直接押注专业同传——四家的定位差异很明显:OpenAI 做「伺候耳朵的口语助手」,Google 做「又聪明又会说的全能 Agent」,阿里则选择垂直场景降维打击:同传是出海、跨境直播、政府商务谈判最愿意付钱、也最难被通用语音助手替代的刚需。
五、对做实时语音 / 出海产品的三点启示
- 「延迟低」与「延迟稳」是两个产品:很多团队只盯着平均延迟,但真实场景(直播、会议)里一次 3 秒的卡顿就足以穿帮。把延迟波动(P95/P99)当成交付指标,比平均延迟更重要——阿里这次把波动砍到 ±0.3 秒,才是它能上商务场景的原因。
- 垂直刚需 > 通用助手:GPT-Live-1 和 Gemini 3.8 Live 是「全能语音」,而阿里选择死磕同传这一个场景。创业公司做语音,与其跟巨头拼'什么都懂',不如挑一个巨头没精力的专业环节做出差异化——口译、医学通话、客服风控都是这类切口。
- 多说话人 + 音色复刻会成为标配:当字幕、发言归属、音色还原都变成模型原生能力,「语音产品的体验账本」会重构——凡是今天靠工程拼装实现(VAD 分段、TTS 拼接)的功能,明天都会被端到端模型按进一条流里,集成成本大幅下降。
💡 启示:Qwen3.8-LiveTranslate 的意义,是证明『基于专业任务设计的端到端架构』可以在一个垂直赛道上跑赢『通用巨兽』。对创业者的含义:① 不要只盯「谁的模型参数大」,要看谁为主场景做了架构级设计——Interleave + Thinker-Talker 这种「为同传而生」的设计,通用模型很难靠堆参数追平;② 2.3 秒已经进入人类同传的生理极限区,下一步的增量不在延迟,而在场景化交付(会议纪要、术语库、行业黑话)——谁能把同传变成可落地的产品流程,谁就赢下出海这条垂直赛道;③ 从 GPT-Live-1 到 Qwen3.8-LiveTranslate,实时语音的竞赛一季度就换一轮强度,今天的产品决策要奔着「半年后的默认值」去做。
六、一个开放问题
当 AI 同传的延迟逼近甚至将要低于人类译员的反应速度,『专业口译员』的护城河还剩什么? 可以确定的是:术语准确性、文化语境、情绪与谈判语气、临场应变与保密责任——这些「模型还不擅长」的部分会越来越贵;而「会说 60 种语言、2.3 秒开口」的部分会变成免费的基础设施。那么问题来了:一个年收入里 60% 来自「翻译速率」的同传社,接下来三年的定价策略该怎么改?——这个问题的答案,会同样适用于所有『核心优势即将被模型做成默认值』的职业。
来源:Qwen 官方博客(2026-09-19)/ 阿里云百炼模型平台(2026-09-19)/ AI Post Hub 架构解读(2026-09-19)。本文为 AI 辅助整理的前沿技术解读,事实以官方与权威媒体口径为准,不构成任何投资建议。
📚 延伸阅读 · 我的付费专栏
觉得这篇文章对你有帮助?我把同类主题的系统化内容沉淀成了付费专栏,欢迎订阅支持持续输出:
| 专栏 | 定价 | 内容 |
|---|---|---|
| 大模型工程师修炼手记 | 19.9 元 | AI 编程 / Agent 深度实战 |
| AI时代程序员的自我提升 | 49.9 元 | AI 时代成长方法论 |
💡 一杯咖啡的价格,换来系统化的知识体系;你的订阅,是我持续创作的最大动力。
💬 本文配套代码 / 资料包:欢迎在评论区留言「求代码」,我会私信发送完整资源!


 扫一扫


 5923

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


