二叉树、平衡二叉树、红黑树、BTree、B+Tree的区别

数据结构之“树”——二叉树、红黑树、B树、B+树、B*树 这篇文章主要简单总结下二叉树、红黑树、B树、B+树、B*树的基本结构和原理。 阅读详情

一、二叉查找树

二叉树具有以下性质:左子树的键值小于根的键值,右子树的键值大于根的键值。
如下图所示就是一棵二叉查找树,
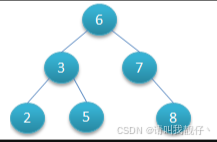
在这里插入图片描述
对该二叉树的节点进行查找发现深度为1的节点的查找次数为1,深度为2的查找次数为2,深度为n的节点的查找次数为n,因此其平均查找次数为 (1+2+2+3+3+3) / 6 = 2.3次

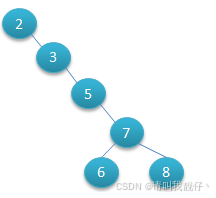
二叉查找树可以任意地构造,同样是2,3,5,6,7,8这六个数字,也可以按照下图的方式来构造:
在这里插入图片描述
但是这棵二叉树的查询效率就低了。因此若想二叉树的查询效率尽可能高,需要这棵二叉树是平衡的,从而引出新的定义——平衡二叉树,或称AVL树。


二、平衡二叉树(AVL Tree)

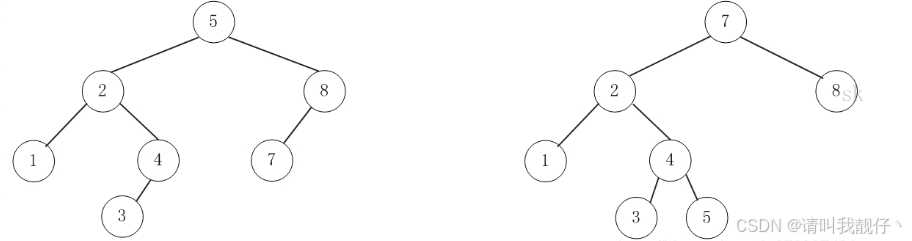
平衡二叉树(AVL树)在符合二叉查找树的条件下,还满足任何节点的两个子树的高度最大差为1。下面的两张图片,左边是AVL树,它的任何节点的两个子树的高度差<=1;右边的不是AVL树,其根节点的左子树高度为3,而右子树高度为1;
在这里插入图片描述

如果在AVL树中进行插入或删除节点,可能导致AVL树失去平衡,这种失去平衡的二叉树可以概括为四种姿态:LL(左左)、RR(右右)、LR(左右)、RL(右左)。它们的示意图如下:在这里插入图片描述
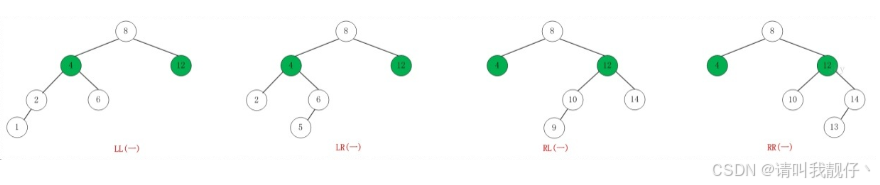
这四种失去平衡的姿态都有各自的定义:

  • LL:LeftLeft,也称“左左”。插入或删除一个节点后,根节点的左孩子(Left Child)的左孩子(Left
    Child)还有非空节点,导致根节点的左子树高度比右子树高度高2,AVL树失去平衡。

  • RR:RightRight,也称“右右”。插入或删除一个节点后,根节点的右孩子(Right Child)的右孩子(Right
    Child)还有非空节点,导致根节点的右子树高度比左子树高度高2,AVL树失去平衡。

  • LR:LeftRight,也称“左右”。插入或删除一个节点后,根节点的左孩子(Left Child)的右孩子(Right
    Child)还有非空节点,导致根节点的左子树高度比右子树高度高2,AVL树失去平衡。

  • RL:RightLeft,也称“右左”。插入或删除一个节点后,根节点的右孩子(Right Child)的左孩子(Left
    Child)还有非空节点,导致根节点的右子树高度比左子树高度高2,AVL树失去平衡。

AVL树失去平衡之后,可以通过旋转使其恢复平衡。下面分别介绍四种失去平衡的情况下对应的旋转方法。

1、LL的旋转

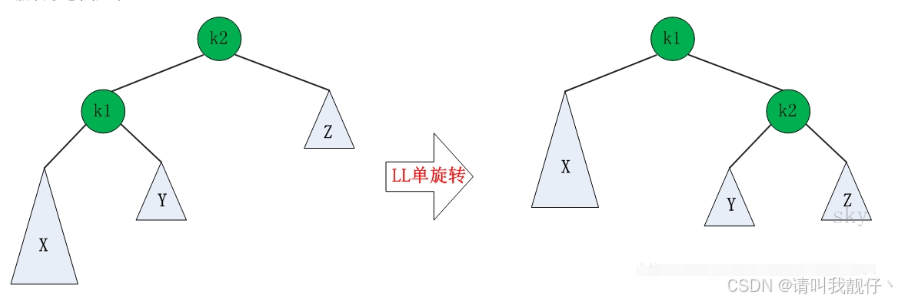
LL失去平衡的情况下,可以通过一次旋转让AVL树恢复平衡。步骤如下:

  • 将根节点的左孩子作为新根节点。
  • 将新根节点的右孩子作为原根节点的左孩子。
  • 将原根节点作为新根节点的右孩子。

LL旋转示意图如下:
在这里插入图片描述

2、RR的旋转

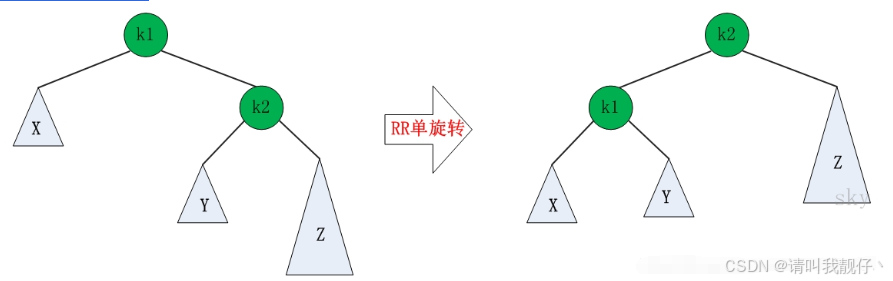
RR失去平衡的情况下,旋转方法与LL旋转对称,步骤如下:

  • 将根节点的右孩子作为新根节点。
  • 将新根节点的左孩子作为原根节点的右孩子。
  • 将原根节点作为新根节点的左孩子。

RR旋转示意图如下:
在这里插入图片描述

3、LR的旋转

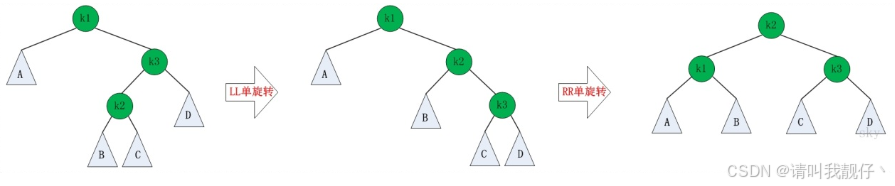
LR失去平衡的情况下,需要进行两次旋转,步骤如下:

  • 围绕根节点的左孩子进行RR旋转。
  • 围绕根节点进行LL旋转。

RL的旋转示意图如下:
在这里插入图片描述


三、红黑树(弱平衡二叉树)

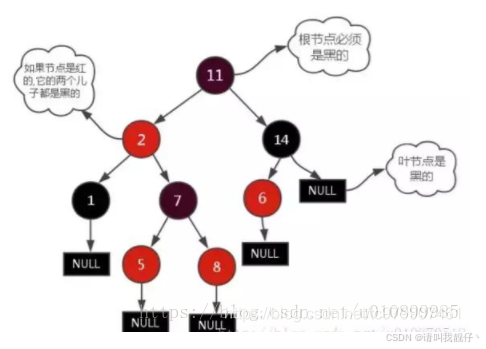
红黑树也属于平衡二叉树,但在每个节点增加一个存储位表示节点的颜色,非红即黑。通过对任何一条从根到叶子的路径上各个节点着色的方式的限制,红黑树确保没有一条路径会比其它路径长出两倍,因此,红黑树是一种弱平衡二叉树(由于是弱平衡,可以看到,在相同的节点情况下,AVL树的高度低于红黑树),相对于要求严格的AVL树来说,它的旋转次数少,所以对于搜索,插入,删除操作较多的情况下,我们就用红黑树。
在这里插入图片描述
具体红黑树详解:https://blog.csdn.net/sun_tttt/article/details/65445754


四、平衡多路查找树(B-Tree)

B-Tree是为磁盘等外存储设备设计的一种平衡查找树。因此在讲B-Tree之前先了解下磁盘的相关知识。

系统从磁盘读取数据到内存时是以磁盘块(block)为基本单位的,位于同一个磁盘块中的数据会被一次性读取出来,而不是需要什么取什么。

InnoDB存储引擎中有页(Page)的概念,页是其磁盘管理的最小单位。InnoDB存储引擎中默认每个页的大小为16KB,可通过参数innodb_page_size将页的大小设置为4K、8K、16K,在MySQL中可通过如下命令查看页的大小:

mysql> show variables like 'innodb_page_size';

而系统一个磁盘块的存储空间往往没有这么大,因此InnoDB每次申请磁盘空间时都会是若干地址连续磁盘块来达到页的大小16KB。InnoDB在把磁盘数据读入到磁盘时会以页为基本单位,在查询数据时如果一个页中的每条数据都能有助于定位数据记录的位置,这将会减少磁盘I/O次数,提高查询效率。

B-Tree结构的数据可以让系统高效的找到数据所在的磁盘块。为了描述B-Tree,首先定义一条记录为一个二元组[key, data] ,key为记录的键值,对应表中的主键值,data为一行记录中除主键外的数据。对于不同的记录,key值互不相同。

  1. 一棵m阶的B-Tree有如下特性:
  2. 每个节点最多有m个孩子。
  3. 除了根节点和叶子节点外,其它每个节点至少有Ceil(m/2)个孩子。
  4. 若根节点不是叶子节点,则至少有2个孩子
  5. 所有叶子节点都在同一层,且不包含其它关键字信息
  6. 每个非终端节点包含n个关键字信息(P0,P1,…Pn, k1,…kn)
  7. 关键字的个数n满足:ceil(m/2)-1 <= n <= m-1
  8. ki(i=1,…n)为关键字,且关键字升序排序。
  9. Pi(i=1,…n)为指向子树根节点的指针。P(i-1)指向的子树的所有节点关键字均小于ki,但都大于k(i-1)

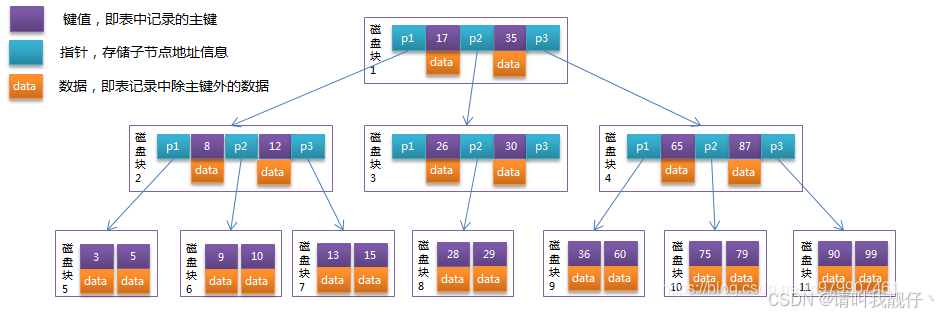
B-Tree中的每个节点根据实际情况可以包含大量的关键字信息和分支,如下图所示为一个3阶的B-Tree:
在这里插入图片描述
每个节点占用一个盘块的磁盘空间,一个节点上有两个升序排序的关键字和三个指向子树根节点的指针,指针存储的是子节点所在磁盘块的地址。两个关键词划分成的三个范围域对应三个指针指向的子树的数据的范围域。以根节点为例,关键字为17和35,P1指针指向的子树的数据范围为小于17,P2指针指向的子树的数据范围为17~35,P3指针指向的子树的数据范围为大于35。

模拟查找关键字29的过程:

  1. 根据根节点找到磁盘块1,读入内存。【磁盘I/O操作第1次】
  2. 比较关键字29在区间(17,35),找到磁盘块1的指针P2。
  3. 根据P2指针找到磁盘块3,读入内存。【磁盘I/O操作第2次】
  4. 比较关键字29在区间(26,30),找到磁盘块3的指针P2。
  5. 根据P2指针找到磁盘块8,读入内存。【磁盘I/O操作第3次】
  6. 在磁盘块8中的关键字列表中找到关键字29。

分析上面过程,发现需要3次磁盘I/O操作,和3次内存查找操作。由于内存中的关键字是一个有序表结构,可以利用二分法查找提高效率。而3次磁盘I/O操作是影响整个B-Tree查找效率的决定因素。B-Tree相对于AVLTree缩减了节点个数,使每次磁盘I/O取到内存的数据都发挥了作用,从而提高了查询效率。


五、B+Tree

B+Tree是在B-Tree基础上的一种优化,使其更适合实现外存储索引结构,InnoDB存储引擎就是用B+Tree实现其索引结构。

从上一节中的B-Tree结构图中可以看到每个节点中不仅包含数据的key值,还有data值。而每一个页的存储空间是有限的,如果data数据较大时将会导致每个节点(即一个页)能存储的key的数量很小,当存储的数据量很大时同样会导致B-Tree的深度较大,增大查询时的磁盘I/O次数,进而影响查询效率。在B+Tree中,所有数据记录节点都是按照键值大小顺序存放在同一层的叶子节点上,而非叶子节点上只存储key值信息,这样可以大大加大每个节点存储的key值数量,降低B+Tree的高度。

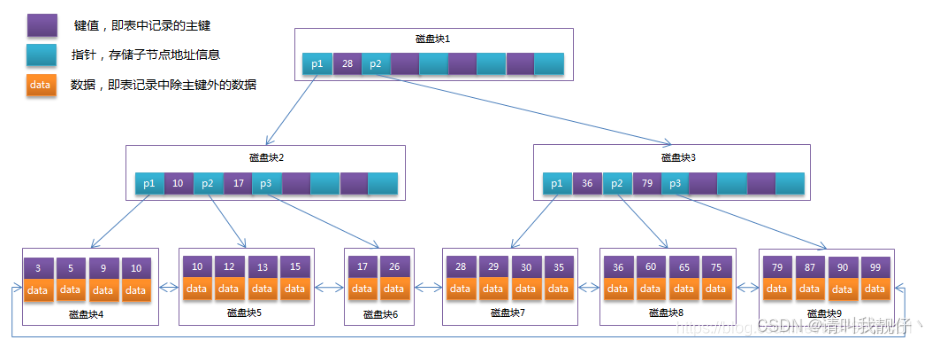
B+Tree相对于B-Tree有几点不同:

  1. 非叶子节点只存储键值信息。
  2. 所有叶子节点之间都有一个链指针。
  3. 数据记录都存放在叶子节点中。

将上一节中的B-Tree优化,由于B+Tree的非叶子节点只存储键值信息,假设每个磁盘块能存储4个键值及指针信息,则变成B+Tree后其结构如下图所示:
在这里插入图片描述
通常在B+Tree上有两个头指针,一个指向根节点,另一个指向关键字最小的叶子节点,而且所有叶子节点(即数据节点)之间是一种链式环结构。因此可以对B+Tree进行两种查找运算:一种是对于主键的范围查找和分页查找,另一种是从根节点开始,进行随机查找。

可能上面例子中只有22条数据记录,看不出B+Tree的优点,下面做一个推算:

InnoDB存储引擎中页的大小为16KB,一般表的主键类型为INT(占用4个字节)或BIGINT(占用8个字节),指针类型也一般为4或8个字节,也就是说一个页(B+Tree中的一个节点)中大概存储16KB/(8B+8B)=1K个键值(因为是估值,为方便计算,这里的K取值为〖10〗3)。也就是说一个深度为3的B+Tree索引可以维护103 * 10^3 * 10^3 = 10亿 条记录。

实际情况中每个节点可能不能填充满,因此在数据库中,B+Tree的高度一般都在24层。mysql的InnoDB存储引擎在设计时是将根节点常驻内存的,也就是说查找某一键值的行记录时最多只需要13次磁盘I/O操作。

数据库中的B+Tree索引可以分为聚集索引(clustered index)和辅助索引(secondary index)。上面的B+Tree示例图在数据库中的实现即为聚集索引,聚集索引的B+Tree中的叶子节点存放的是整张表的行记录数据。辅助索引与聚集索引的区别在于辅助索引的叶子节点并不包含行记录的全部数据,而是存储相应行数据的聚集索引键,即主键。当通过辅助索引来查询数据时,InnoDB存储引擎会遍历辅助索引找到主键,然后再通过主键在聚集索引中找到完整的行记录数据。

参考:https://blog.csdn.net/Hubery_James/article/details/80565137

数据结构之BTree、B+Tree的含义及区别 1.引言 前面学习索引时,了解到MySQL索引的数据类型有B+Tree索引和哈希索引,本文将详细介绍一下BTree和B+Tree的含义和他们的区别。 2.BTree 2.1 概念 B树是一种自平衡树数据结构,它维护有序数据并允许以对数时间进行搜索,顺序访问,插入和删除。B树是二叉搜索树的一般化,因为节点可以有两个以上的子节点。与其他自平衡二进制搜索树不同,B树非常适合读取和写入相对较大的数据块(如光盘)的存储系统。它通常用于数据库和文件系统。 定义: B树是一种平衡的多分树,通常我们说m阶的B树,它必须满足 阅读详情

相关推荐

红黑树和二叉树有什么区别

红黑树和二叉树有什么区别? 什么是二叉树?什么是红黑树? 二叉树(Binary Tree)是指每个节点最多只有两个分支的树结构,即不存在分支大于 2 的节点,二叉树的数据结构如下图所示 这是一棵拥有 6 个节点深度为 2(深度从 0 开始),并且根节点为 3 的二叉树 二叉树有两个分支通常被称作 “左子树” 和 “右子树”,而且这些分支具有左右次序不能随意地颠倒 一棵空树或者满足以下性质的二叉树被称之为二叉查找树 若任意节点的左子树不为空,则左子树上所有节点的值均小于它的根节点的值; 若任意节点的

蔡定努 992

二叉树、平衡二叉树、红黑树、BTree、B+Tree的区别和联系

1.二叉查找树 二叉树具有以下性质:左子树的键值小于根的键值,右子树的键值大于根的键值。 如下图所示就是一棵二叉查找树, 对该二叉树的节点进行查找发现深度为1的节点的查找次数为1,深度为2的查找次数为2,深度为n的节点的查找次数为n,因此其平均查找次数为 (1+2+2+3+3+3) / 6 = 2.3次 二叉查找树可以任意地构造,同样是2,3,5,6,7,8这六个数字,也可以按照下图的方式来构造...

tc979907461的博客 5694

UART全功能测试指南:环路/DMA/RS485/硬件流控实战

UART(通用异步收发器)是嵌入式系统中最基础的串行通信接口,其核心原理基于起始位、数据位、校验位与停止位的异步帧结构,依赖精确的波特率时钟同步与采样重建机制。在工业与物联网场景中,UART不仅需保障基本通信可靠性,更需支持DMA卸载、RS485半双工自动方向控制、RTS/CTS硬件流控等进阶能力,以提升实时性、抗干扰性与系统资源效率。典型应用涵盖调试日志输出、传感器数据采集、Modbus RTU总线通信及固件空中升级。本指南聚焦UART外设测试实践,覆盖环路自检、DMA吞吐验证、RS485时序对齐、硬件流

weixin_42599908的博客 125

二叉树、平衡二叉树、红黑树、B树、B+树、B*树的区别

1、每个节点非黑即红。2、根节点总是黑色的。3、如果节点是红色的,则它的子节点必须是黑色的。4、非叶子节点值大于左边子节点、小于右边子节点。

weixin_55076626的博客 1928

博客系统 - 系统简介与首页设计

用Bootstrap实现手机端的博客导航栏效果。

m0_53450409的博客 1230

别再只用LSTM了!用Temporal Fusion Transformer (TFT) 搞定多变量时序预测,附PyTorch实战代码

本文介绍了Temporal Fusion Transformer (TFT) 在多变量时序预测中的优势,并提供了PyTorch实战代码。TFT通过三重注意力机制解决了LSTM在特征交互、静态特征处理和解释性方面的不足,显著提升了预测精度和可解释性。文章详细讲解了TFT的核心组件构建、数据预处理、模型训练技巧及可解释性分析,帮助开发者快速掌握这一先进时序预测技术。

weixin_33712987的博客 275

2、MySQL索引

从数据结构角度可分为B+树索引、哈希索引、以及FULLTEXT索引(现在MyISAM和InnoDB引擎都支持了)和R-Tree索引(用于对GIS数据类型创建SPATIAL索引);从物理存储角度可分为聚集索引、非聚集索引;从逻辑角度可分为主键索引、普通索引,或者单列索引、多列索引、唯一索引、非唯一 索引等等。

sproutBoy的博客 956

OpenVins解析:基于滤波框架的SLAM

这一方式存在的关键问题是匹配耗时很长,对性能影响显著。可以参考ORBSLAM3中的匹配方式来对其优化,比如左右目匹配可以在极线上搜索,前后帧可以利用运动先验投影匹配。理论上加入路标点会提升精度,代价是增加了计算量。着重说下基于描述子的匹配:OpenVins中匹配的方式是robust_match(),里面是调用的opencv的。openvins中不仅仅进行了传统的MSCKF更新(状态向量中不包含路标点),还在。中进行了包含路标点的估计更新。图像帧到来时,利用IMU递推得到的位姿给该图像帧赋初值。

qq_18076309的博客 4053

MySQL索引和存储引擎

目录MySQL索引二叉树平衡二叉树红黑树Hash表BTreeB+TreeMySQL存储引擎MyISAM存储引擎数据存储形式锁的粒度事务数据的存储特点索引实现其他**InnoDB存储引擎****数据存储形式****锁的粒度****事务****数据的存储特点****索引实现**联合索引问题总结InnoDB一颗B+树可以存放多少行数据?聚簇索引和非聚簇索引的区别为什么InnoDB表必须有主键,并且推荐使用整型的自增主键?MySQL为什么用自增作为索引比较好。而UUID索引效率比较低?为什么非主键索引结构叶子节点存

weixin_46744534的博客 407

OpenCV实战:高效检测与识别多类型条码与二维码

本文详细介绍了如何利用OpenCV的BarcodeDetector和QRCodeDetector模块,高效实现EAN-13条形码与常见二维码的检测与识别。内容涵盖从环境搭建、单码识别到处理多二维码的完整流程,并分享了提升识别率的图像预处理与性能优化等实战技巧,帮助开发者一站式解决视觉项目中的条码识别需求。

weixin_29094539的博客 489

【stata基础代码大全 】 可独立完成一篇实证

用stata打开,直接替换自己需要的变量就行,小白友好❗️❗️❗️。八、八.中介效应检验:路径分析(三种方法)第二种方法即Sobel-Goodman检验。*(7)Winsor处理,剔除异常值。六、内生性问题解决方法(附具体模型)其三,工具变量:两阶段最小二乘。第三种方法即Bootstrap检验。二、Stata中数据的基本处理。*(5)生成行业、年度虚拟变量。PSM1————近邻匹配。七、调节效应检验:机制分析。*(2)剔除数据中的样本。*(4)给变量添加标签。*(3)生成新的变量。*(6)基本数据匹配。

J_Giser的博客 8014

Mysql中BTree和B+Tree

为啥要使用B+Tree,而不是用普通二叉树和AVL平衡二叉树呢B-Tree树即B树,B即Balanced,平衡的意思。B-Tree即B树,Balance Tree,平衡树。2-3树是最简单的B树结构。B树的阶:节点的最多子节点个数。比如2-3树的阶是3,2-3-4树的阶是4。B树通过重新组织节点,降低树的高度,并且减少IO读写次数来提升效率。关键字集合分布在整颗树中,即叶子节点和非叶子节点都存放数据。

Knight 3399

第一章:GEE 和 GEEMAP

在本章中,我们将介绍地理空间数据科学、谷歌地球引擎和地理地图的基础知识。然后,我们将逐步完成设置 conda 环境和安装 geemap 的步骤。我们还将学习如何在不在您的计算机上安装任何东西的情况下将 geemap 与 Google Colab 一起使用。...

韩天放 8043

MSQL系列(一) Mysql实战-索引结构 二叉树/平衡二叉树/红黑树/BTree/B+Tree

其实红黑树和上面的平衡二叉树类似, 红黑树是一种自平衡二叉搜索树。

流浪的喵的博客 1121

Ollama + OpenCLAW 在 Windows 系统的完整部署指南

Windows 部署优先选 WSL2,避免原生环境的权限/兼容性问题;网络问题通过“离线包+国内镜像”解决,版本问题通过升级 Node.js 解决;内存不足可切换轻量模型或增大 WSL2 内存分配;核心链路:Ollama(模型管理)→ Gateway(网关)→ OpenCLAW TUI(交互),各组件启动正常即可稳定使用。

lpfasd123的博客 2802

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

数据结构:树、二叉树(排序/查找/平衡)、红黑树、BTREE、B+TREE

简称BST(Binary Search Tree),也称为二叉查找树。其或是一棵空树,或是一棵具有下列特性的非空二叉树:1)若左子树非空,则左子树上所有结点关键字值均小于根结点的关键字值。2)若右子树非空,则右子树上所有结点关键字值均大于根结点的关键字值。3)左、右子树本身也分别是一棵二叉排序树。是一个递归的数据结构:左子树结点值 < 根结点值 < 右子树结点值后面直接将“结点关键值”简称为“结点值”

учёба 1204

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

B-tree(BTree)、B+tree、红黑树的浅浅的认识

B-tree(BTree)、B+tree、红黑树------浅浅的认识 B-tree(Btree)—B-tree即为B树 B树是一种多路自平衡搜索树,它类型于普通的二叉树,但B树允许每个节点拥有更多的子节点。 这里只要知道我们日常所说的B树与B-tree是什么就好,其实就是同一个东西。B-tree树即B树(Btree) B树的特征: 所有的键值分布在整个树中(找到这个键就能找到对应它的值) 任何值的出现且只会出现一个节点上(对应上面这条特征) 搜索可能在非叶子节点上结束,(要么找到对应的值,要么找不到)

qq_40305030的博客 1300

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

B+tree和红黑树的区别?为什么MySql不使用红黑树?

谈谈你对B+tree的理解,为什么MySql不使用红黑树?

记录点点滴滴的成长。 2004

深入分析 BTree、B+Tree、AVL树、红黑树

一、红黑树 – 平衡二叉搜索树 红黑树的特点 节点是红色或黑色。 根节点是黑色。 每个叶子节点都是黑色的空节点(NIL节点)。 每个红色节点的两个子节点都是黑色。(从每个叶子到根的所有路径上不能有两个连续的红色节点) 从任一节点到其每个叶子的所有路径都包含相同数目的黑色节点。 二、 AVL树 – 平衡二叉搜索树 AVL树的特点 它的左子树和右子树都是AVL树 左子树和右子树的高度差不能超...

迁就100 1639

大白话btree和b+tree

引语 作为一直后端程序猿,经常会看到好几个关于树的概念,平衡二叉树,二叉搜索树,avl树,btree,b+tree等等。 没有弄清楚的时候,放到一起很容易弄混。今天咱们就来捣鼓捣鼓这几个名词,理解一下它们都是啥。本文会从二叉树由浅入深介绍到b+tree, ,对于不同的树的插入删除先不谈,主要用于帮助不清楚概念的童鞋理解这些名词代表的什么样的数据结构,暂不涉及红黑树(这玩意要写起来篇幅有点长,下次可...

我想问问天的专栏 2450

BTree和B+Tree详解

https://www.cnblogs.com/vianzhang/p/7922426.html B+树索引是B+树在数据库中的一种实现,是最常见也是数据库中使用最为频繁的一种索引。B+树中的B代表平衡(balance),而不是二叉(binary),因为B+树是从最早的平衡二叉树演化而来的。在讲B+树之前必须先了解二叉查找树、平衡二叉树(AVLTree)和平衡多路查找树(B-Tree),B+树即...

weixin_30610755的博客 117

Btree与b+tree

1. Btree: B-tree是一种多路自平衡搜索树,它类似普通的二叉树,但是Btree允许每个节点有更多的子节点。Btree示意图如下: B树的搜索,从根结点开始,如果查询的关键字与结点的关键字相等,那么就命中;否则,如果查询关键字比结点关键字小,就进入左儿子;如果比结点关键字大,就进入右儿子;如果左儿子或右儿子的指针为空,则报告找不到相应的关键字; 如果B树的所有非叶子结点的左右子树的结点数目均保持差不多(平衡),那么B树的搜索性能逼近二分查找;但它比连续内存空间的二分查找的

雪锋的笔记 3732

BTree和B+Tree 简单区别

本篇作用于各种树之间的区别,非算法详细介绍,只是个我们这种非科班出身的一种大概的印象,现在网上跟多是是讲各种树的这么实现的细节问题,本篇不涉及那么高深,如果详细了解可以查阅他人的资料,很多大神已经说的很多了 二叉树效果 这个是我们想象中的本应该的树的数据结构。 可是他存在一种极端的情况 他的查询效率就变的低了可能在极端点直接就一条腿走下去。 为了解决这个问题 出来一个平衡二叉树或者红黑二叉树(...

happyming886的博客 725

Mysql innodb为什么使用B+Tree

Mysql innodb存储结构(B+Tree) 二叉树 缺点:数据量容易单边过长形成链表。 红黑树(本质为平衡二叉树) 缺点:虽然使用旋转方式改变了单边过长,但是数据量大时, 树高度太高不利于查询。 B-Tree 缺点:虽然每个节点横向扩容控制了高度为3,但是每个节点包含索引列值和行数据,导致存储量小。叶子节点之间没有指针导致范围查找必须每次从根节点查找 特点:索引列不重复 B+Tree...

技术分子博客 939

数据结构--RBTree/BTree/B+Tree

1. 红黑树的性质 红黑树本身就是一颗二叉搜索树,只不过给他添加了很多的限制 红黑树的性质如下: 根节点是黑色 不存在两个红色节点相连的情况 每个节点不是红色就是黑色 所有的叶节点(NiL)都是黑色 2. 变换规则 ...

HAH--M的博客 571

MYSQL索引详解之数据结构、存储方式、聚簇/非聚簇索引、基本设计理念

根据上面的Hash结构可知,如果是定向查找,如查找id = 184的数据,可直接hash算法后获取桶标识=8,直接拿到id=184的数据。在mysql中,数据都存储在叶子结点,非叶子结点不存储数据,冗余结点将直接存至内存,便于定位。如需查找id=30的数据,第一层定位15~56区间,第二层定位20~49区间,即可找到对应的叶子结点page页,再找到id=30的结点,即可直接获取到数据。同理,如需查找id>30的数据,同样直接定位至id=30的结点,再通过叶子结点的连接,即可查找到id>30的所有结点。

aquriushu的博客 1273
上一篇: 根据不同类型。进入子类
下一篇: 阿里探花笔试
请叫我靓仔丶
博客等级 码龄9年 164粉丝 61原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值