


大家读完觉得有帮助记得关注和点赞!!!
摘要
军事行动受益于动能领域与非动能领域之间的协调。特别是,网络作战与电磁战的协调对于获取作战优势已变得日益重要。这种协调对于网络态势感知(CSA)也很重要,其中观察-定位-决策-行动(OODA)循环需要监控和解读来自异构来源的证据。在此背景下,异常不仅可能出现在信号的物理行为中,也可能出现在流量层面观察到的通信行为中。然而,许多现有的异常检测方案仅关注这些视角中的一个,限制了它们表征同时在电磁频谱和网络空间显现事件的能力。为解决这一局限性,本研究开发并评估了两种结合两个领域特征的异常检测模型。更具体地说,该研究使用了ZBDS2023数据集,其中包含来自网状网络中节点的流量,包括正常行为和攻击行为。因此,该数据集提供了物理层特征、流量级特征和标记的攻击。评估了两种检测方法:一种基于随机森林的有监督模型和一种使用LSTM-自编码器的无监督模型。结果表明,基于学习的模型可以检测结合两个层次的模式,尤其是在有监督方法下,随机森林的F1分数达到89.76%,LSTM-自编码器达到64.09%。尽管这些结果表明所提出的模型可以通过改进对异常行为的观察和解读来支持CSA,但正常样本和攻击样本之间的细微差异突显了对更丰富判别特征的需求。
关键词: 异常检测,机器学习,深度学习,网络态势感知,网络电磁活动
1 引言
在现代战场上,军事行动的成功取决于传统动能领域(即陆地、海洋、空中和太空)与非动能作战领域(网络空间、电磁频谱(EMS)和信息作战(IO))的整合[16, 19]。由于EMS与许多作战领域(包括动能领域和网络空间)相交,军事力量对其控制对于任务成功至关重要。此外,网络空间与电磁领域之间日益增长的融合增加了协调网络和电磁能力以获取作战优势的需求。在此背景下,几个国家已专注于发展网络电磁活动(CEMA)[14, 16],旨在协调跨网络空间和EMS的进攻、防御、信息和赋能活动。这种协调对于CSA也很重要,其中必须观察和解读异构的网络和电磁证据,以支持作战理解和决策。
这种融合产生了对能够关联证据并从EMS和网络空间视角表征事件的监控方法的需求。从CSA的角度来看,这种能力在OODA循环的观察和定位阶段尤其相关,因为态势感知(SA)依赖于收集异构指标、解读其含义,并将其转化为后续决策的有用信息。尽管联合利用信号级和流量级信息的模型可以有助于在CEMA相关场景中早期识别恶意或异常行为,但大多数现有的异常检测方法仅关注这些视角中的一个。
在此背景下,本研究提出开发并评估用于CEMA场景的异常检测模型,该模型结合了电磁环境和网络空间的特征。使用基于Zigbee的ZBDS2023数据集,该数据集包括物理层特征、流量级特征以及标记的重放和洪泛攻击,本研究分析了两种检测时间序列中异常行为的方法。第一个方案是基于随机森林的有监督模型,它使用在帧序列上计算的统计特征来捕获时间属性并预测是否存在攻击。该模型因其简单性而作为初步方法。第二个模型是无监督的LSTM-自编码器,它从序列中学习时间模式,并在仅使用正常数据训练后,根据其重构误差确定序列是否异常,这是文献中最常用的模型之一。结果表明,这些方法可以检测结合两个层次的时间模式,通过改进对异常网络-电磁行为的观察和定位,为CSA提供有用的支持。
2 相关工作
在电磁和网络通信环境中的异常检测传统上使用单一信息源来解决。现有方法通常依赖于物理层信号特征(例如,I/Q样本、频谱功率或频谱图)或网络流量特征(例如,数据包头部、流统计信息或帧元数据)。因此,缺乏联合利用物理层和流量级特征来关联信道事件与通信行为的工作。为此,本节回顾了分别使用物理信号特征和流量特征的异常检测方法。大多数回顾的工作通过基于重构的方法解决异常检测。最后,在这些方法中,模型学习被监控系统的正常行为,并在重构误差超过预期范围时检测异常。
首先关注网络异常,Casajus-Setién等人[3]提出了一种基于Transformer模型的工业物联网网络异常入侵检测系统。他们的方法通过处理IP流序列来实时分析工业网络流量。每个流由从相同源和目的IP地址、端口和协议之间交换的数据包派生的聚合统计信息描述。这些流序列被用作Transformer编码器-解码器模型的输入。该模型被训练来重构正常流量窗口,并通过计算重构损失(基于原始和重构流序列之间的均方误差(MSE))来执行异常检测。该方法在WUSTL-IIoT-2021数据集上评估,对拒绝服务(DoS)攻击检测达到94.31%的F1分数和97.44%的AUC。
类似地,Kummerow等人[9]提出了一种基于Transformer的网络流量自编码器,用于网络数据包序列中的无监督异常检测和解释。他们的模型在两个层次上学习表示:数据包级别,其中离散和连续的数据包特征被编码;以及时间级别,其中Transformer捕获数据包序列之间的依赖关系。异常分数从重构误差计算:对离散特征使用分类准确率,对连续特征使用MSE。最佳配置达到95.36%的F1分数和95.47%的二元准确率。
Park等人[13]提出了一种基于长短期记忆(LSTM)自编码器的无监督入侵检测系统(IDS),特别关注卷积神经网络双向LSTM自编码器(CNN-BiLSTM-AE)。目标是解决基于签名的IDS在检测以前未见过的攻击时的局限性。该模型仅在经过预处理和特征选择后的CICIDS2018数据集的正常流量上训练。通过计算推理期间的重构损失并应用预定义阈值来区分正常和异常流量来进行检测。该模型达到98.1%的准确率和98.3%的F1分数。同一模型也在UNSW-NB15数据集上评估,报告了97.7%的准确率和97.8%的F1分数。
在电磁频谱领域,Tian等人[18]解决了未授权频段中的无监督频谱异常检测问题,其中频谱组成复杂且异常模式事先未知。他们提出了一种基于变分自编码器(VAE)的方法,对从I/Q数据生成的频谱图进行操作。作者定义了一种基于百分位数的异常度量,命名为PER分数,该度量关注频谱图中重构最差的区域,而不是将重构误差平均到整个输入上。使用Conv-VAE模型,PER分数在不同异常类型(包括GMSK、CHIRP、QPSK和16QAM信号)上实现了96.71%至98.91%的AUC值。
Wang等人[20]也使用时频表示关注异常无线电信号检测,提出了一种卷积神经网络对抗性自编码器(CNN-AAE)。使用重构误差检测异常,MSE用于量化原始和重构时频矩阵之间的差异。该模型在使用的三个数据集上实现了93.14%至96.71%的准确率,F1分数范围为91.2%至94.1%。
Lourme等人[10]提出了一个互补的工作线,他们引入了ZBDS2023[11]。该数据集提供了MAC层帧数据和物理层RSSI值,并包括正常时段和标记的攻击。作为基线,作者评估了一个简单的基于RSSI阈值的IDS用于欺骗检测,在单设备用例中获得91.7%的准确率、31.2%的精确率和83.3%的召回率。
表1总结了回顾的方法。大多数现有方法依赖基于重构的检测,并分析流量级数据或物理层信号表示。Lourme等人[10]的研究构成了一个相关例外,因为他们提供了MAC层Zigbee数据和RSSI测量值,尽管他们的IDS是一个简单的基于阈值的基线。这一差距激发了联合利用信号级信息和通信行为的方法。
表1:网络流量和电磁频谱异常检测文献总结。
| 参考文献 | 输入 | 模型 | 异常分数 | 评估 |
|---|---|---|---|---|
| [3] | 流序列 | Transformer编码器-解码器 | MSE | 94.31% F1分数;97.44% AUC |
| [9] | 具有离散和连续特征的数据包序列 | 基于Transformer的网络流量自编码器 | 分类准确率 + MSE | 最佳:95.36% F1分数,95.47% 准确率 最差:74.02% F1分数,79.42% 准确率 |
| [13] | 预处理流量特征 | CNN-BiLSTM-AE | 重构损失 + 阈值 | CICIDS2018:98.3% F1分数,98.1% 准确率 UNSW-NB15:97.8% F1分数,97.7% 准确率 |
| [18] | 频谱图 | 变分自编码器 | PER分数 | 最佳:98.91% AUC 最差:96.71% AUC |
| [20] | 时频矩阵 | CNN-AAE | MSE + 阈值 | 最佳:94.1% F1分数,96.71% 准确率 最差:91.2% F1分数,93.14% 准确率 |
| [10] | Zigbee MAC层帧 + RSSI | 基于RSSI阈值的基线IDS | RSSI移动平均 + 固定阈值 | 91.7% 准确率,31.2% 精确率,83.3% 召回率 |
本研究还搜索了结合电磁信号信息和网络流量特征的公共数据集。目标是识别适合训练深度学习(DL)模型的数据集,这些模型能够检测电磁频谱信号中的异常,并支持CEMA相关场景中的EMS分析。表2总结了识别出的数据集。
几个数据集包含有限数量的样本或仅提供被监控环境的部分覆盖,这可能阻碍稳健模式的学习并增加过拟合风险。此组包括以下真实数据集:[4],一个2.4 GHz频段的蓝牙和Zigbee数据集,包含I/Q样本和BLE/Zigbee元数据;[8],一个2.4 GHz频段的蓝牙数据集,包含I/Q样本和BLE信道元数据;以及[17],一个2.4 GHz频段的Wi-Fi数据集,包含频谱图和原始Wi-Fi数据包时间序列。此外,[6]在400 MHz提供合成数据,包含I/Q样本和PCAP注释。尽管这些资源可能对特定研究有用,但均不包含标记的异常,这限制了它们在面向监督或评估的异常检测中的适用性。
基于LoRaWAN技术的数据集,如[1, 15],尤其相关,因为它们提供了物理层指标(如RSSI或SNR)以及数据包相关信息。两者都是在868 MHz频段运行的数据集:[1]提供LoRaWAN数据包和PHY元数据,而[15]结合了LoRaWAN PHY和数据包元数据。然而,LoRaWAN流量通常稀疏,这在连续样本之间引入了显著的时间间隙,这可能使训练序列模型以捕获短期动态或无线电信道的快速变化变得复杂。
一个中间情况是[5],一个2.4 GHz频段的真实Wi-Fi数据集,包含I/Q样本和Wi-Fi数据包元数据。然而,该数据集是使用恒定头部和0字节有效载荷收集的。尽管它对于RF指纹识别有用,但其流量级变异性有限,降低了其分析与事件或攻击相关的现实通信模式的适用性。另一个相关资源是[7],一个来自DARPA频谱协作挑战赛的100 MHz合成数据集,包含大量数据,并包括PSD、RF和帧级元数据。然而,缺乏足够的元数据来上下文化每条记录,使得该数据集难以解释和重用用于异常检测研究。
最后,[2, 11]在2.4 GHz频段提供真实数据,包含物理层和流量级信息。前者是一个Wi-Fi数据集,包含基于Radiotap的元数据,但没有标记的异常。相比之下,[11]是一个Zigbee数据集,包括MAC层元数据和从多个位置捕获的RSSI值,以及正常时段和标记的攻击场景。尽管该数据集专注于Zigbee,但该技术代表了传感器丰富环境中常用的短距离、低功耗无线通信,使其适合于近似频谱监测和早期干扰或攻击检测相关的场景。
本综述表明,缺乏同时提供物理层射频信息、网络流量跟踪或元数据以及具有一致注释的代表性攻击场景的公开可用数据集。考虑到这些局限性和可用数据量,[11]中的Zigbee数据集被选为开发本工作的参考数据集。
表2:具有EMS信息和网络流量特征的数据集。
| 参考文献 | 技术 | 频率 | 特征 | 数据 | 异常 |
|---|---|---|---|---|---|
| [1] | LoRaWAN | 868 MHz | LoRaWAN数据包和PHY元数据 | R | - |
| [2] | Wi-Fi | 2.4 GHz | 基于Radiotap的Wi-Fi元数据 | R | - |
| [4] | 蓝牙和Zigbee | 2.4 GHz | I/Q样本和BLE/Zigbee元数据 | R | - |
| [5] | Wi-Fi | 2.4 GHz | I/Q样本和Wi-Fi数据包元数据 | R | - |
| [6] | 未指定 | 400 MHz | I/Q样本和PCAP注释 | S | - |
| [7] | 未指定 | 100 MHz | PSD、RF和帧级元数据 | S | - |
| [8] | 蓝牙 | 2.4 GHz | I/Q样本和BLE信道元数据 | R | - |
| [11] | Zigbee | 2.4 GHz | MAC层元数据和RSSI | R | ✓ |
| [15] | LoRaWAN | 868 MHz | LoRaWAN PHY和数据包元数据 | R | - |
| [17] | Wi-Fi | 2.4 GHz | 频谱图和原始Wi-Fi数据包时间序列 | R | - |
| • R:真实数据;S:合成数据。 |
3 提出方案的设计与实现
实现的解决方案遵循图1所示的工作流程。首先,在由Zigbee设备网状网络组成的真实场景中收集数据。然后,处理捕获的流量以进行清洗、特征提取、标记和归一化。基于处理后的数据,探索了两种异常检测视角。一方面,基于随机森林的有监督二元分类器确定一组帧是否对应正常行为或攻击。另一方面,基于LSTM-自编码器的无监督时间序列检测器从时间序列中学习系统的正常行为,并通过重构误差检测偏差。
该工作流使用Scikit-learn和Keras在Python中实现。Scikit-learn用于处理、归一化、数据集划分、评估指标和随机森林分类器,而Keras用于构建和训练LSTM-自编码器模型。源代码在GitHub仓库[12]中公开可用。
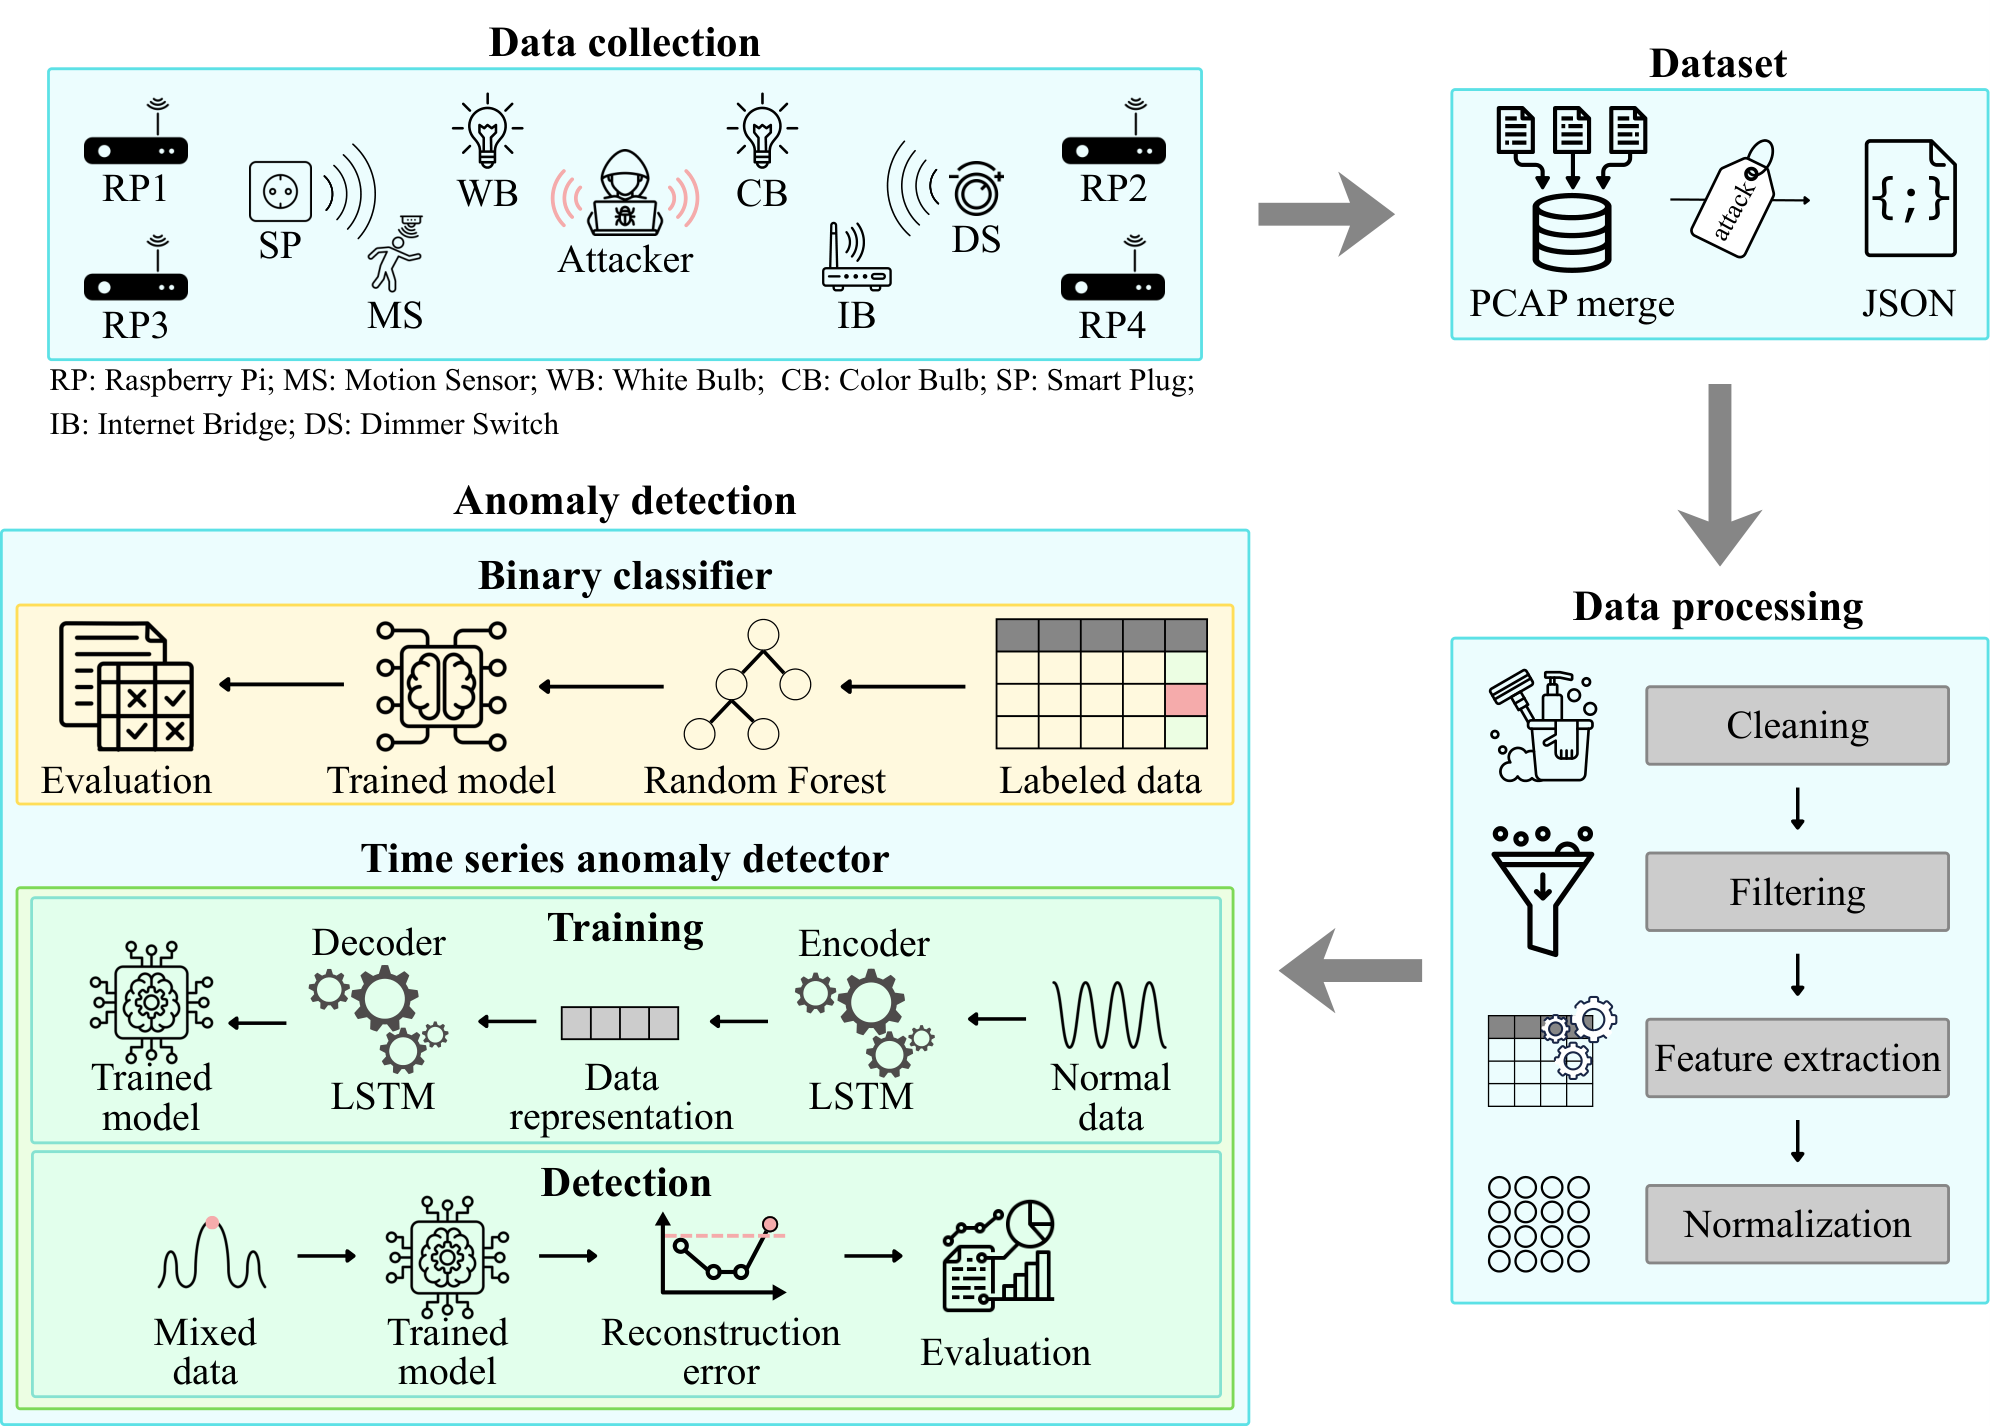
图1:所提出的CEMA异常检测场景概述。
图描述:一个流程图,显示数据收集 -> 数据预处理(清洗、特征提取、标记、归一化) -> 两个分支:监督分类(随机森林)和无监督时间序列检测(LSTM-自编码器) -> 评估。
3.1 数据集:ZBDS2023
在本工作的实验开发中,使用了ZBDS2023数据集[11]。这与Lourme等人[10]介绍和分析的相同数据集,如前一节所述。该数据集旨在支持基于Zigbee的物联网环境中入侵检测系统(IDS)的开发和评估。它是在一个配备10个Philips Hue设备的有人居住的智能家居中收集的。该数据集包括正常操作时段和攻击时段。
捕获设置由分布在房屋不同位置的四个被动探针组成。每个探针使用Raspberry Pi和CC2531模块构建。这种配置允许Zigbee设备传输的单个帧根据覆盖条件被一到四个探针捕获。因此,该数据集在MAC层提供了冗余,此外还提供了来自不同空间位置的RSSI测量值。捕获以PCAP格式存储,并按探针和时间间隔组织。此外,ZBDS2023数据集包括分布在多个会话中的50个标记攻击。总共考虑五种攻击类型,标记为A到E攻击,并在[11]中详述,包括四种不同的洪泛策略和一种重放攻击。
为便于预处理阶段,数据集作者提供了从原始PCAP捕获生成JSON文件的代码。在本工作中,该代码被改编以在生成的JSON记录中包含额外字段。结果,每个处理后的记录包含表3中总结的属性。这些属性共同允许构建设备级时间序列,并分析流量行为以及物理层信息。
表3:从原始数据集中提取的特征。
| 特征 | 描述 |
|---|---|
| frame_index | 从Wireshark列索引派生的帧索引。 |
| src16 | 发送方的16位MAC短地址。 |
| length | 帧长度(字节)。 |
| time_relative_us | 自第一帧以来经过的时间,以μs表示。 |
| rssi | 与捕获帧关联的RSSI值。 |
| epoch_us | 帧接收时间的Unix纪元格式,以μs表示。 |
| dst16 | 接收方的16位MAC短地址。 |
| attack | 与帧关联的攻击标签。可能值为:NO_ATTACK、A、B、C、D和E。 |
| dev | 传输帧的设备的参考,如[10]所述。 |
| rpi | 捕获帧的Raspberry Pi探针的标识符。 |
用于从PCAP捕获获取JSON文件的预处理代码提取上述描述的变量,并应用过滤以仅保留格式良好且有效的帧。结果,所有生成的记录都包含完整信息,没有空值或空字段。预处理后,每个Raspberry Pi获得约8,500,000个有效样本,总计接近34,000,000行,10列。
表4显示了用每种攻击类型和NO_ATTACK标签标记的样本数量。总计33,829,336行对应正常操作,而55,638行与攻击上下文关联。这证明了强烈的类别不平衡,因为攻击样本仅占完整数据集的0.16%。此外,数据集文档表明攻击会话发生在7月3日至7月9日之间。因此,当分析限制在此时间间隔时,非攻击行数减少到17,721,706,将攻击比率提高到0.31%。
表4:与每个攻击标签关联的样本数量。
| 标签 | 样本数量 |
|---|---|
| NO_ATTACK | 33,829,336 |
| A | 6,755 |
| B | 6,268 |
| C | 2,919 |
| D | 20,599 |
| E | 19,097 |
3.2 数据处理
为有效使用数据,应用了初步处理阶段,包括清洗、过滤、标签转换和特征工程。首先,丢弃未知设备发送或接收的帧。关于攻击标记,决定不区分特定攻击类型,而是将任务公式化为二元分类问题。因此,原始标签被映射为正常样本的0和攻击样本的1。
对于模型训练,移除了几个元数据字段,因为它们不提供相关的预测信息,或者可能使模型过度依赖特定的捕获设置。这些丢弃的字段包括捕获帧的Raspberry Pi(rpi)、帧索引(frame_index)以及相对于第一帧的相对时间(time_relative_us)。与设备标识符或设备类型直接相关的变量也被排除。此设计选择旨在获得更通用的模型,较少依赖于实验环境中存在的特定设备和探针。此外,为纳入时间信息,定义了两个派生变量:delta_t,表示同一设备发射并由同一Raspberry Pi捕获的连续样本之间的时间差;以及delta_l,表示这些连续样本之间的长度差。这些变量将部分流量时间行为引入原本不设计用于处理时间序列的模型中。它们也便于为可以明确利用序列信息的模型提取特征。
3.3 异常检测
本节描述了为在先前描述的数据集上实现两个旨在检测异常和攻击的模型所遵循的过程。
二元异常检测。
第一种方法开发了基于随机森林的有监督二元分类模型。目标是对固定大小的样本窗口,基于每个窗口的统计特征,确定是否发生了攻击(1)或没有(0)。
为保留时间信息,每个窗口由同一设备发射并由同一Raspberry Pi捕获的连续消息构建。一旦定义了窗口,对每个特征计算以下统计度量:平均值、中位数、最小值、最大值、第25百分位数、第75百分位数和四分位距(IQR)。由此产生的向量由这些聚合统计量组成,在训练和预测阶段均用作输入。
该模型需要标记为正常(0)和攻击(1)的样本。因此,为减少这两个类别之间的不平衡,本研究仅使用了7月3日至7月9日之间的时间间隔,这对应于攻击会话。结果,用于此方法的数据集包含17,721,371个正常样本和55,638个攻击样本。
评估指标。
由于数据集呈现正常和攻击样本之间的显著不平衡,像F1分数这样的指标比准确率更合适,因为它们更好地反映了检测攻击和避免误报之间的平衡。为此,用于选择最佳模型的主要指标是F1分数,尽管也使用精确率和召回率以获得更详细的评估。
训练过程。
鉴于可用数据量巨大,在保留样本时间顺序的同时使用了标准划分策略。具体来说,按日期排序的前80%数据用于训练,随后的20%保留用于测试。超参数调优和五折交叉验证在训练集上执行,而测试集在最终评估前保持隔离。
为正确训练模型,有必要确定哪组超参数提供最佳结果。初步搜索后,为每个超参数选择了一组候选值。最有希望的值总结在表5中。使用此超参数搜索空间和五折交叉验证,识别出根据所选评估指标优化模型的配置,随后用于最终训练。
表5:随机森林超参数搜索中使用的值。
| 超参数 | 值 |
|---|---|
| n_estimators | 200, 400, 800 |
| max_features | None, sqrt |
| max_depth | None, 80, 120 |
| min_samples_split | 20, 40, 50 |
| min_samples_leaf | 1 |
| bootstrap | True |
| criterion | gini, entropy |
| class_weight | None |
时间序列中的异常检测。
为从时间角度解决异常检测,实现了一个无监督的LSTM-自编码器。该模型仅使用无攻击流量训练,并学习重构正常序列。在推理期间,重构误差高于选定阈值的序列被分类为异常。
模型架构。
LSTM-自编码器架构组织为两个主要块:编码器和解码器。编码器由与LayerNormalization交错的LSTM层组成,将输入序列压缩为时间表示。RepeatVector层将此表示适配回原始序列长度,解码器重构输入序列。最后,TimeDistributed全连接层在每个时间步生成重构变量。该模型使用Adam优化器和Early Stopping以减少过拟合。
数据预处理。
训练前,数据被重塑为具有以下结构的三维输入:(样本数,时间步数,特征数)。使用长度为seq_length和步长stride的窗口生成序列。为保持时间一致性,每个序列由同一设备发射并由同一Raspberry Pi捕获的连续样本构建。对于评估,如果测试序列中至少20%的样本与攻击关联,则将其标记为异常;否则标记为正常。
评估指标和异常阈值。
评估优先考虑高召回率,因为在网络安全背景下,最小化未检测到的攻击尤为重要,即使以一些误报为代价。然而,也考虑精确率和F1分数以评估检测能力和误报率之间的权衡。
LSTM-自编码器不直接输出类别标签。相反,它重构输入序列,因此异常检测需要测量原始序列和重构序列之间的差异。为此,使用MSE:
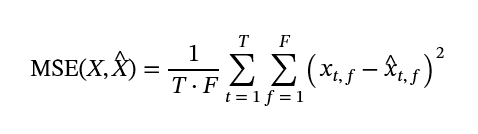
其中T是序列长度,F是特征数,X是原始序列,X̂是重构序列。
异常阈值选为正常条件下重构误差分布的百分位数,并在包含正常和攻击序列的混合验证集上调优。选定后,阈值在测试期间保持固定。图2说明了F1分数、精确率和召回率指标随用于定义阈值的百分位数增加而演变的趋势。
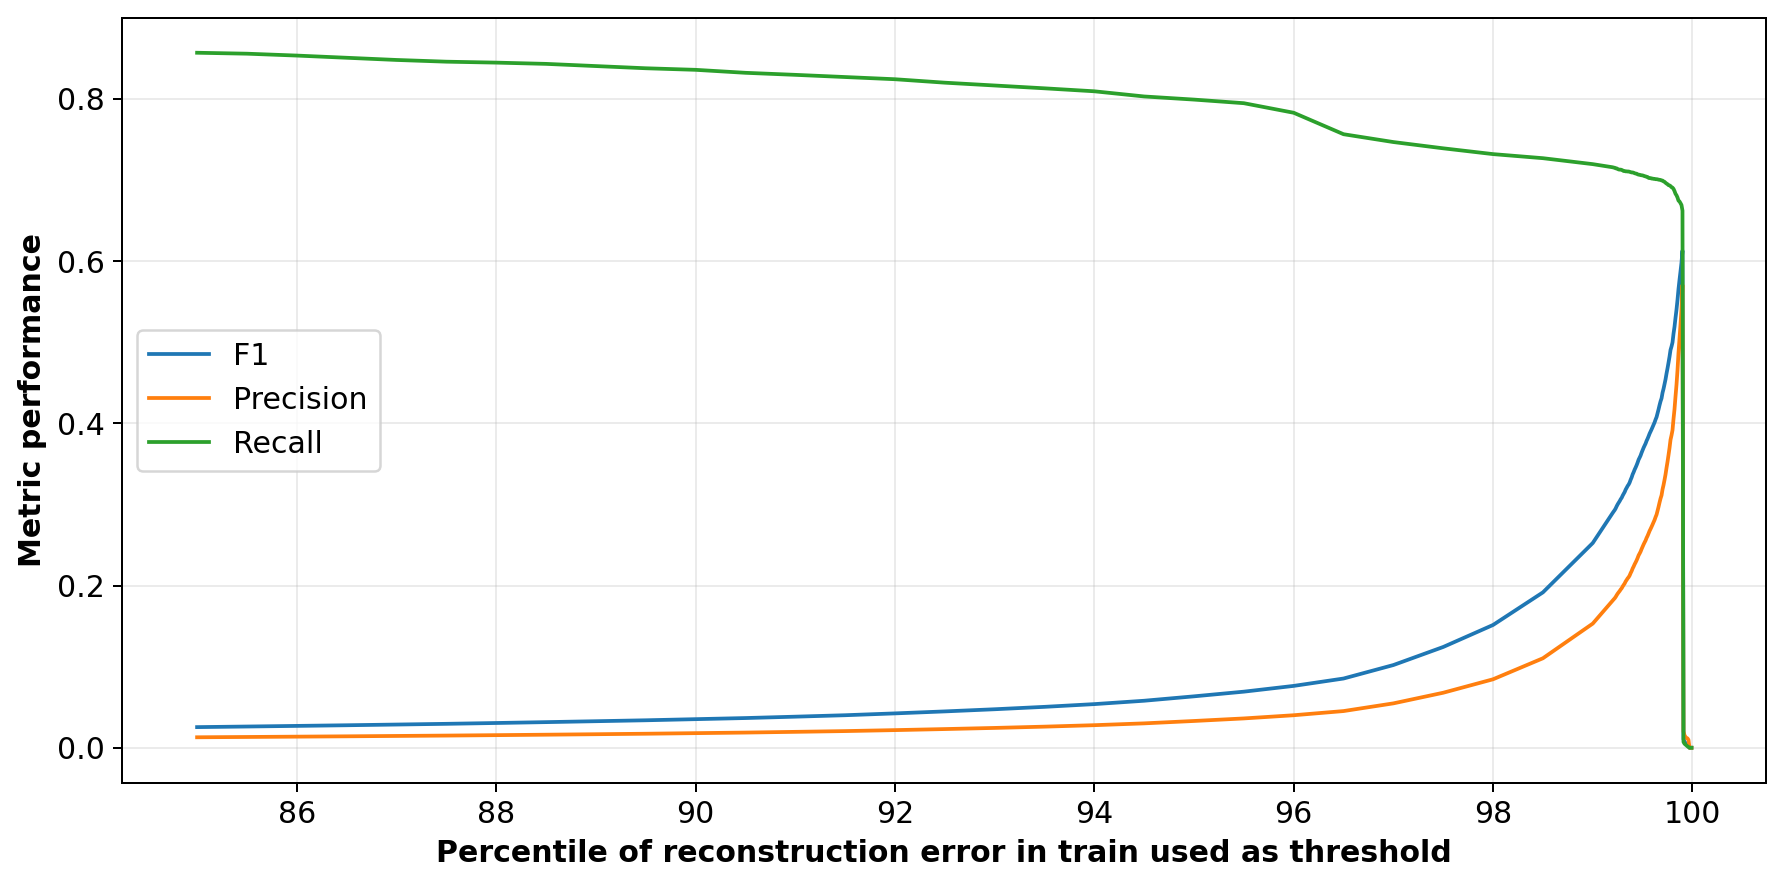
图2:F1分数、精确率和召回率随用于定义异常阈值的百分位数变化的演变。阈值从正常序列的重构误差分布获得,并在包含正常和攻击流量的混合验证集上评估。所示配置对应于具有四个LSTM层、seq_length=8、stride=4、units=128和middle_units=64的模型。
图描述:折线图,X轴为百分位数,Y轴为分数。召回率随百分位数增加而下降,精确率上升,F1分数先升后降,在某个点达到峰值。
训练过程。
训练集限制在6月30日至7月3日之间传输的样本,这些样本完全没有攻击。相比之下,7月3日至7月9日之间的间隔(正常和异常序列共存)用于阈值选择和最终评估。
无攻击子集被划分为80%用于训练和20%用于验证。训练子集用于调整模型权重,而验证子集用于监控重构损失。包含正常和恶意流量的子集也被分为两部分:50%用于验证和50%用于测试。混合验证子集用于选择异常阈值和超参数配置。
一些超参数在所有实验中保持固定,使用标准值,而其余的超参数则通过实验探索。固定值在表10中以灰色背景突出显示。从这一基线出发,进行了超参数探索,以识别在验证数据上最大化检测能力的架构和参数化。初步手动分析表明,性能最佳的架构由编码器中的两个LSTM层和解码器中的两个LSTM层组成。其余超参数最有希望的值如表6所示。
表6:LSTM-自编码器超参数搜索中使用的值。
| 超参数 | 值 |
|---|---|
| sequence length | 8, 16 |
| stride | sequence length/2, sequence length |
| units | 128, 256 |
| middle_units | 64, 96, 128 |
在超参数列表中,units指编码器第一LSTM层和解码器最后一LSTM层的隐藏单元数,而middle_units指内部LSTM层的隐藏单元数。从该搜索中,为所提出的时间序列异常检测器选择了最合适的超参数组合。
4 结果
本节总结了有监督随机森林模型和无监督LSTM-自编码器模型获得的结果。
4.1 基于随机森林的二元检测
最合适的窗口配置(由seq_length和stride定义)可以通过分析攻击序列的长度来确定。当按设备和Raspberry Pi(遵循用于构建输入窗口的相同标准)分组连续攻击样本时,大多数攻击序列集中在相对较短的范围内,大约在1到6帧之间,如表7所示。这支持了过长的序列可能稀释攻击信号,而较短或中等窗口可以更好地捕获与攻击相关的局部变化的观点。为此,选择了长度为8的序列。此外,使用简单的基于帧的随机森林模型的初步实验确定了最合适的stride值,结果为8。为简化起见,这些结果未在本文中呈现。
表7:根据长度的攻击序列部分分布。粗体条目表示最常见的序列长度。
| 序列长度 | 序列数 | 序列长度 | 序列数 | 序列长度 | 序列数 | 序列长度 | 序列数 |
|---|---|---|---|---|---|---|---|
| 1 | 642 | 8 | 1 | 15 | 34 | 22 | 42 |
| 2 | 177 | 9 | 3 | 16 | 36 | 23 | 24 |
| 3 | 52 | 10 | 6 | 17 | 41 | 24 | 8 |
| 4 | 141 | 11 | 13 | 18 | 35 | 25 | 14 |
| 5 | 91 | 12 | 14 | 19 | 64 | 26 | 8 |
| 6 | 101 | 13 | 25 | 20 | 43 | 27 | 16 |
| 7 | 36 | 14 | 53 | 21 | 28 | 28 | 7 |
超参数调优后获得的最佳配置如表8所示。结果总结在表9中,显示该模型在测试集上达到89.76%的F1分数,精确率为97.74%,召回率为82.99%。得到的混淆矩阵为 [[745743, 81], [719, 3508]],其中行对应实际类别(正常和攻击),列对应预测类别(正常和攻击)。高精确率值表明大多数被分类为攻击的窗口对应异常行为,导致低误报率。同时,召回率值表明模型能够识别大多数攻击实例,尽管仍有一些异常窗口被误分类为正常。总体而言,获得的F1分数反映了检测能力和分类可靠性之间的良好平衡。这种性能表明,在统计值中聚合连续帧提供了局部行为的稳健表示,并能够区分正常和攻击流量。
表8:随机森林模型的选定超参数。
| 超参数 | 值 |
|---|---|
| n_estimators | 800 |
| max_features | None |
| max_depth | 80 |
| min_samples_split | 20 |
| min_samples_leaf | 1 |
| bootstrap | True |
| criterion | entropy |
| class_weight | None |
表9:随机森林模型在测试集上获得的结果。
| 准确率 | 平衡准确率 | 精确率 | 召回率 | F1分数 |
|---|---|---|---|---|
| 99.89% | 91.49% | 97.74% | 82.99% | 89.76% |
4.2 基于LSTM-自编码器的时间检测
无监督时间检测器使用不同的架构和序列配置进行评估。首先,比较了2层、4层、6层和7层架构,如图3所示。结果表明,增加模型复杂度仅在达到某一点之前提高性能。基于这些结果,4层架构在召回率、精确率和F1分数之间提供了最佳平衡。
这些初步分析缩小了第3.3节中描述的超参数搜索空间。然后,进行了最终搜索以选择最合适的配置,得到图4所示的结果。基于该搜索,选定的配置是具有seq_length=8、stride=8、units=256和middle_units=96的4层LSTM-自编码器。完整配置总结在表10中。
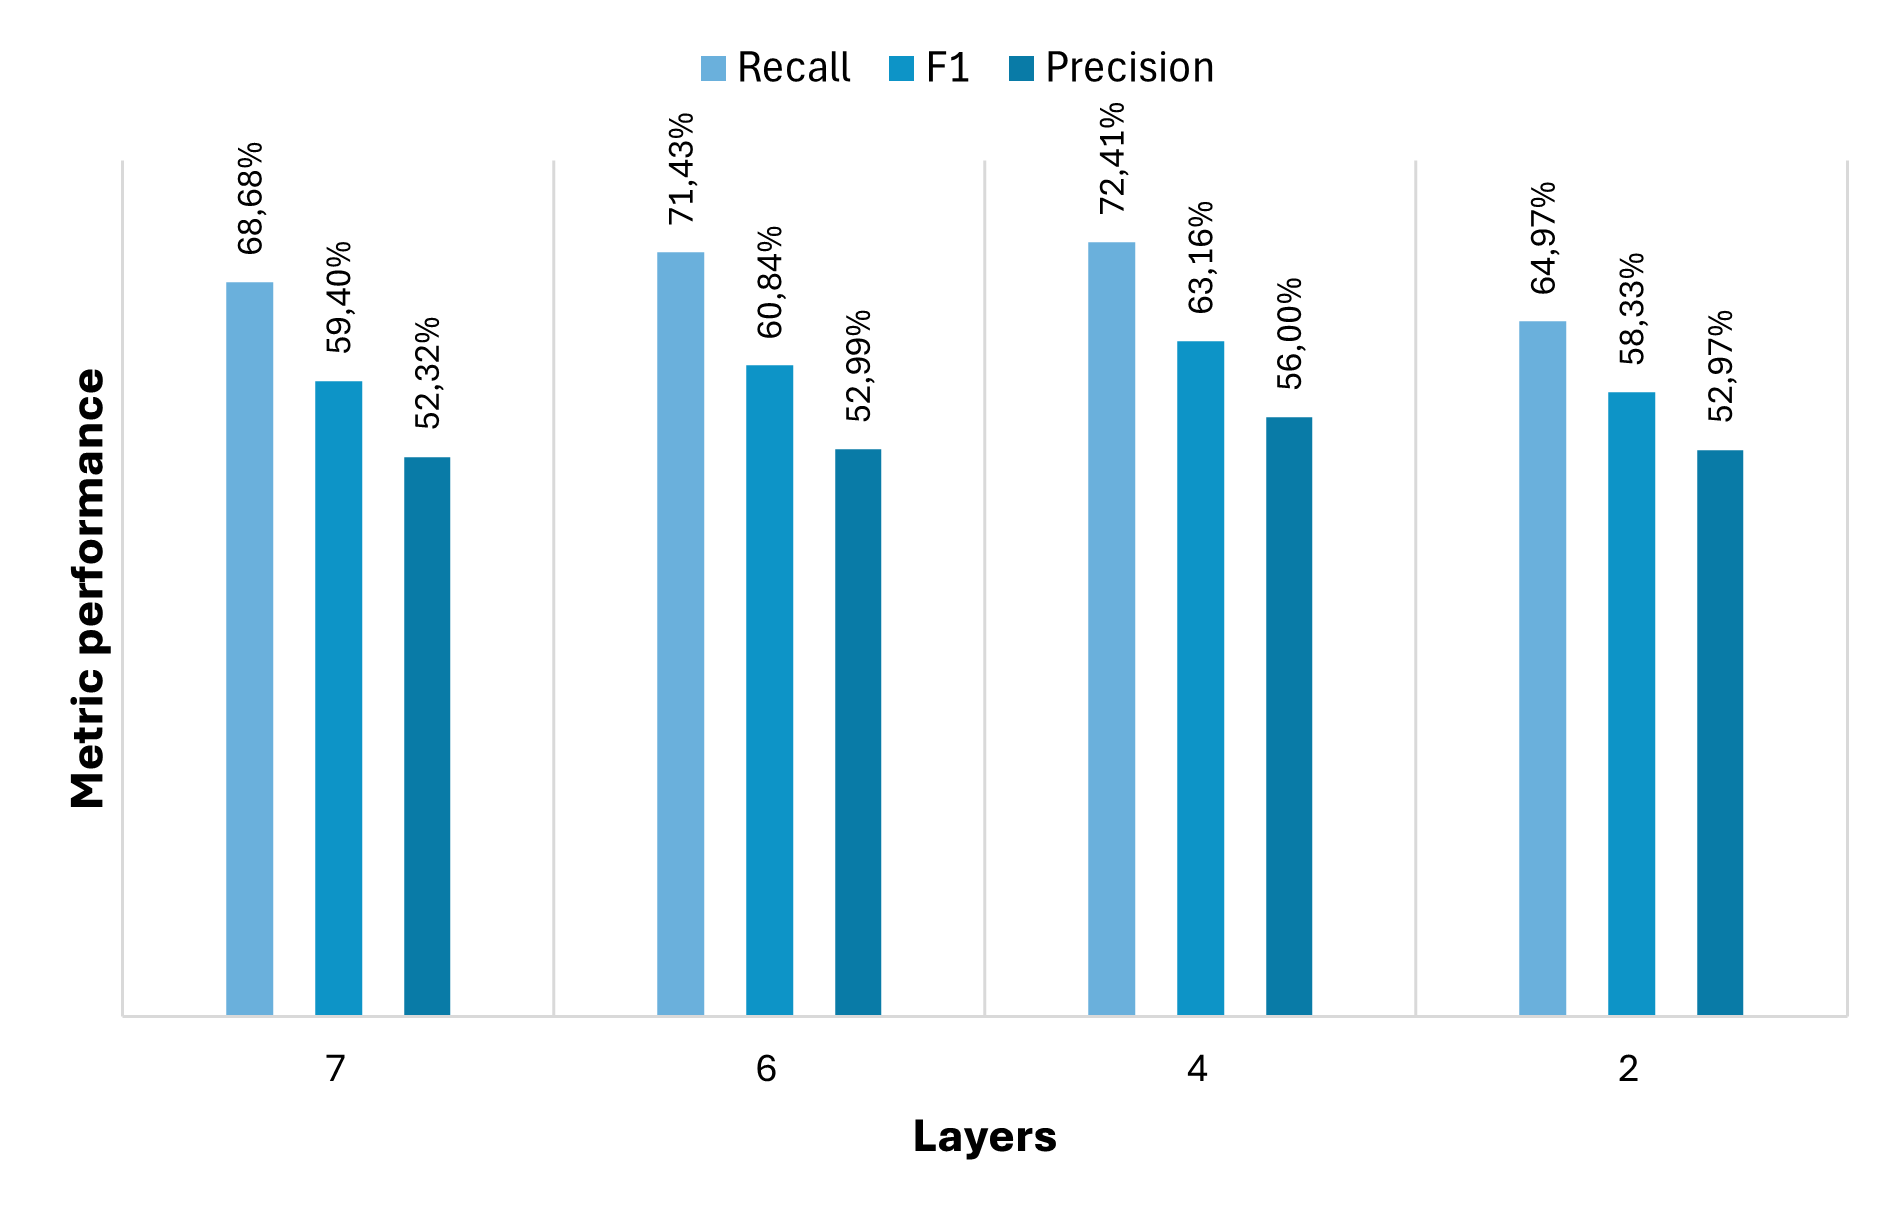
图3:改变层数时LSTM-自编码器性能的比较,seq_length=8,stride=4。7层架构使用192/144/96/48-96/144/192单元,6层架构使用256/128/64-64/128单元,4层架构使用128/64-64/128单元,2层架构使用256-256单元。
图描述:条形图,显示不同层数配置的召回率、精确率和F1分数。4层配置通常表现最佳。
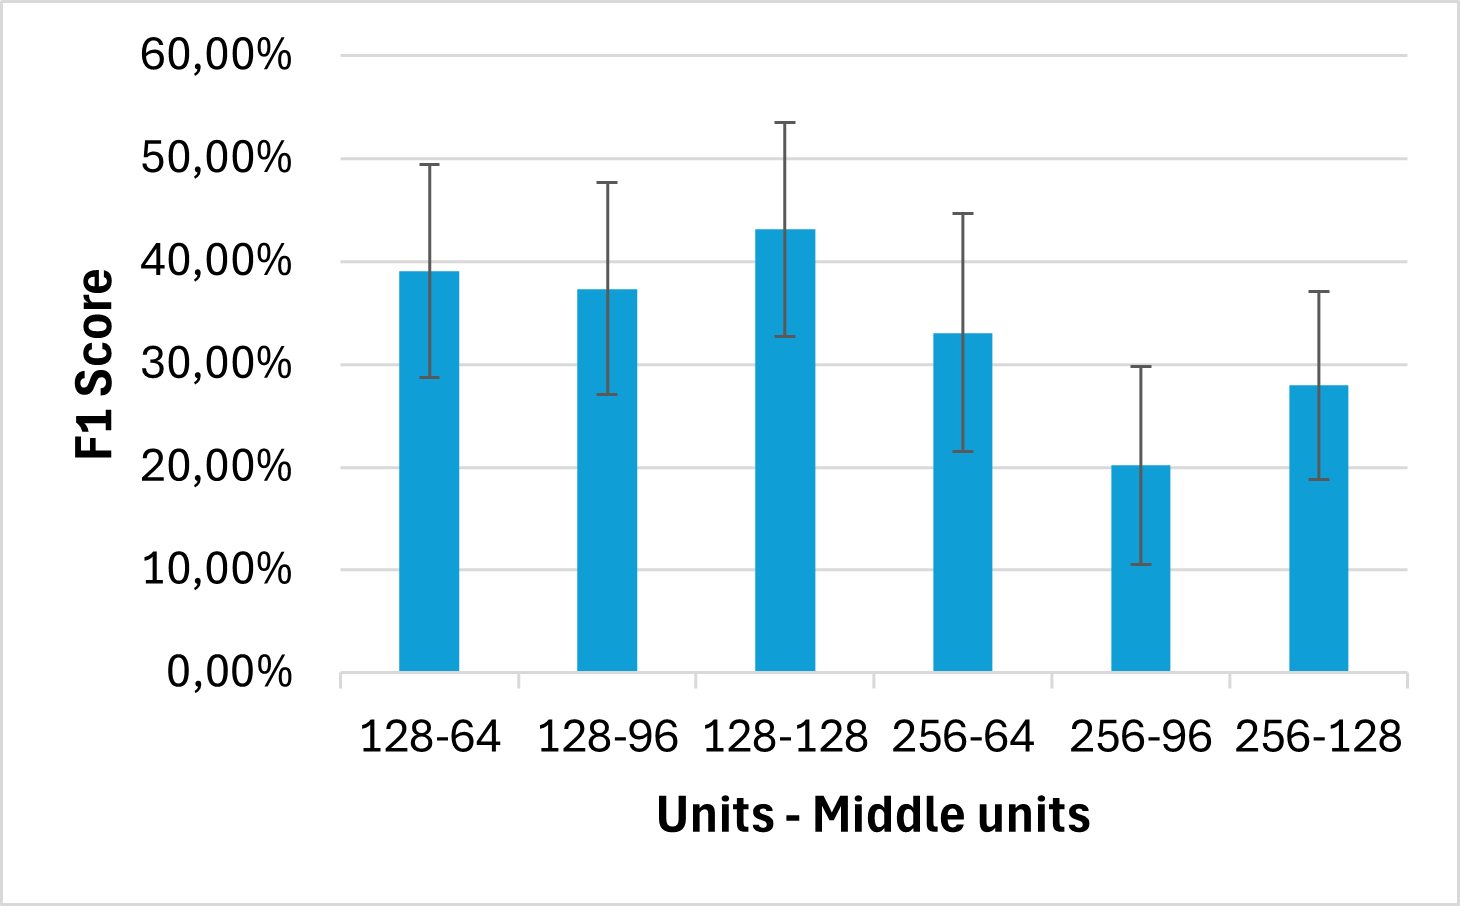
图4a:seq_length=8,stride=4。
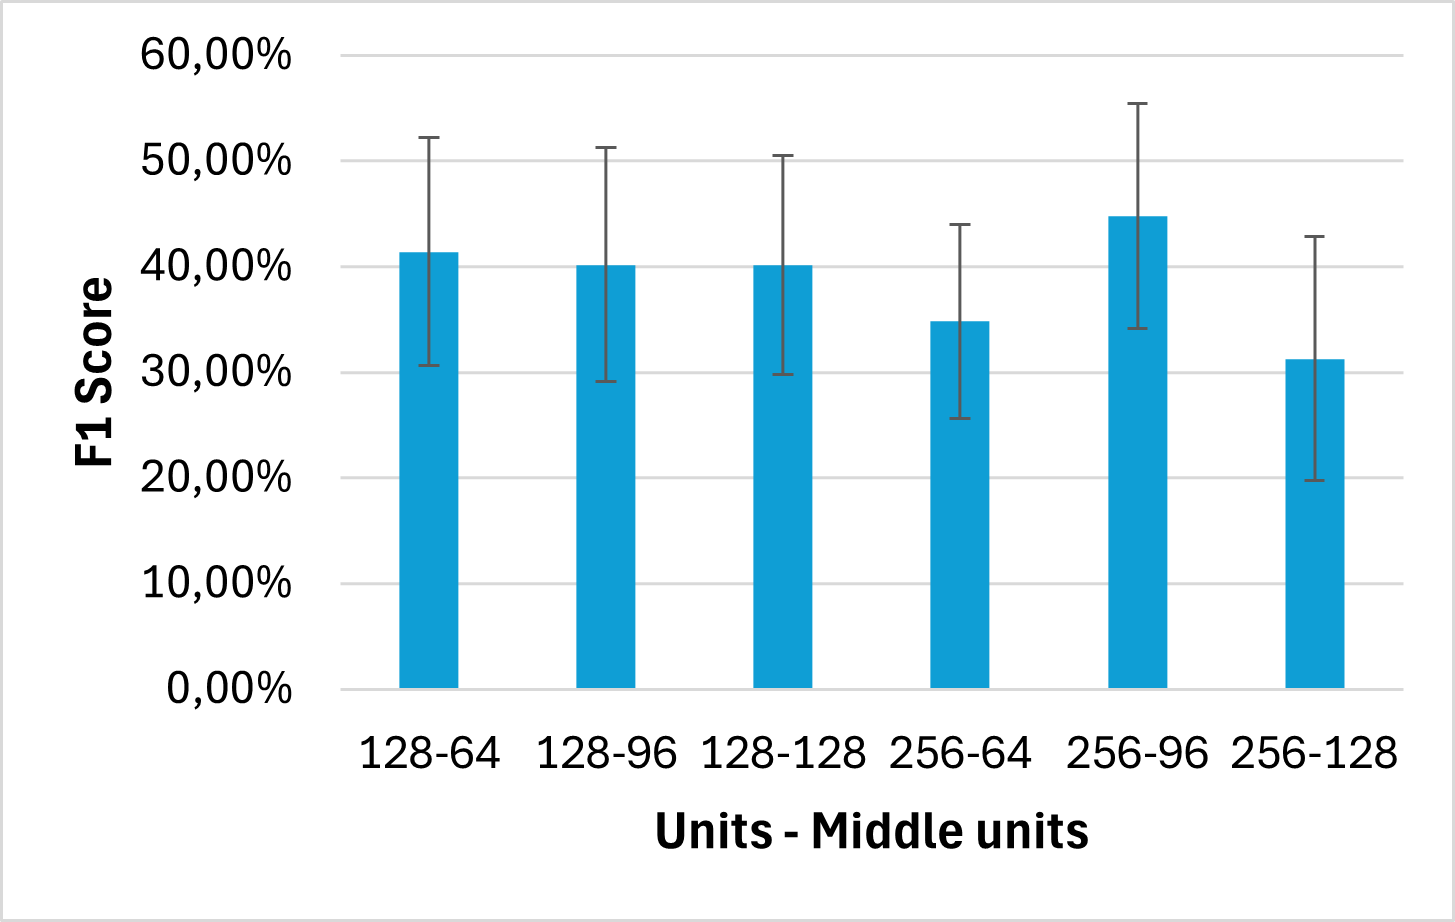
图4b:seq_length=8,stride=8。
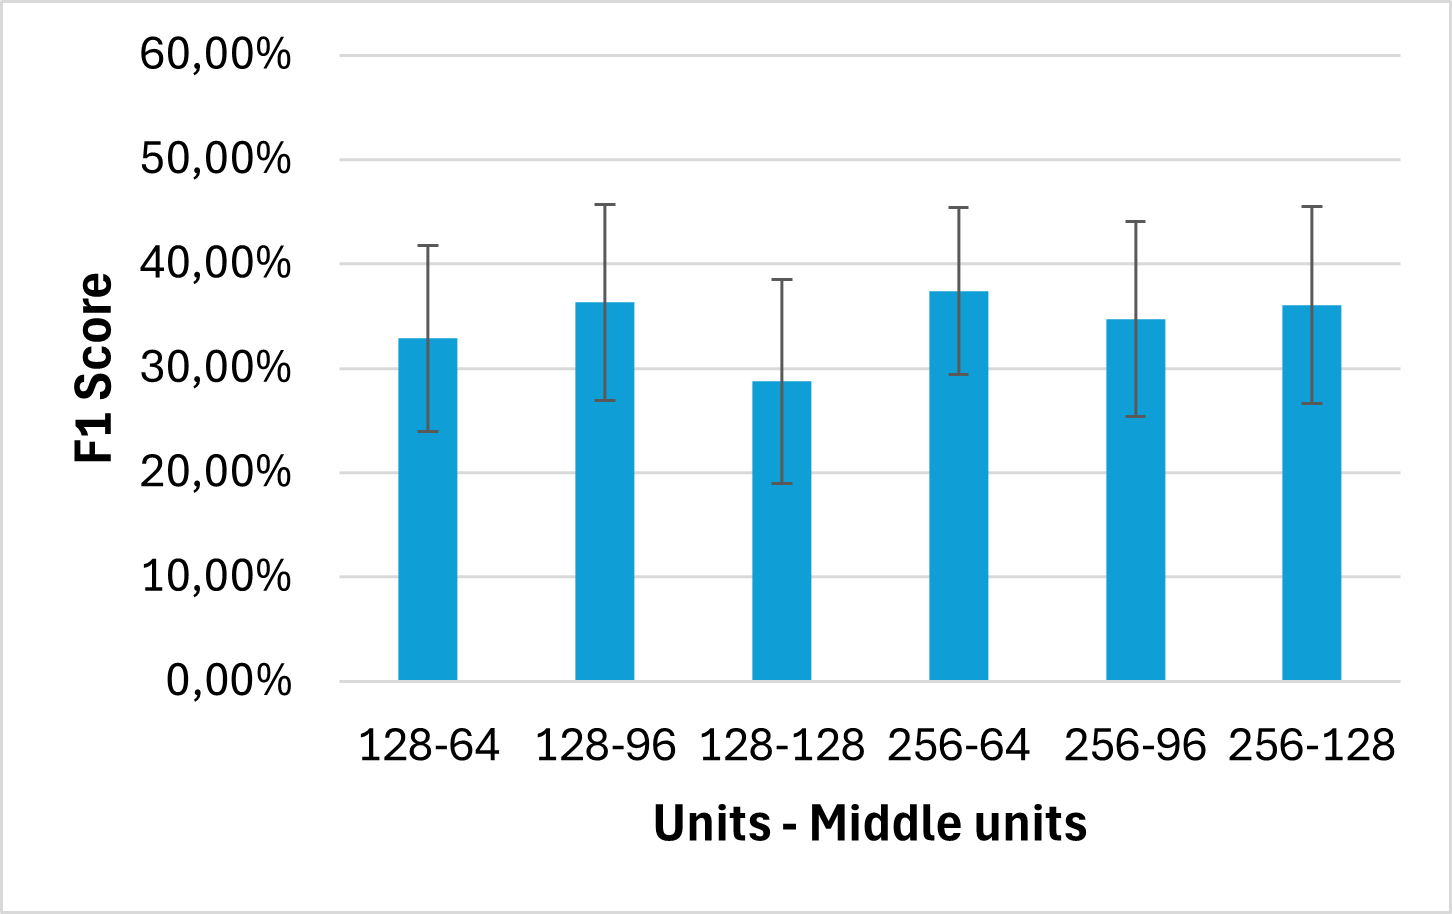
图4c:seq_length=16,stride=8。
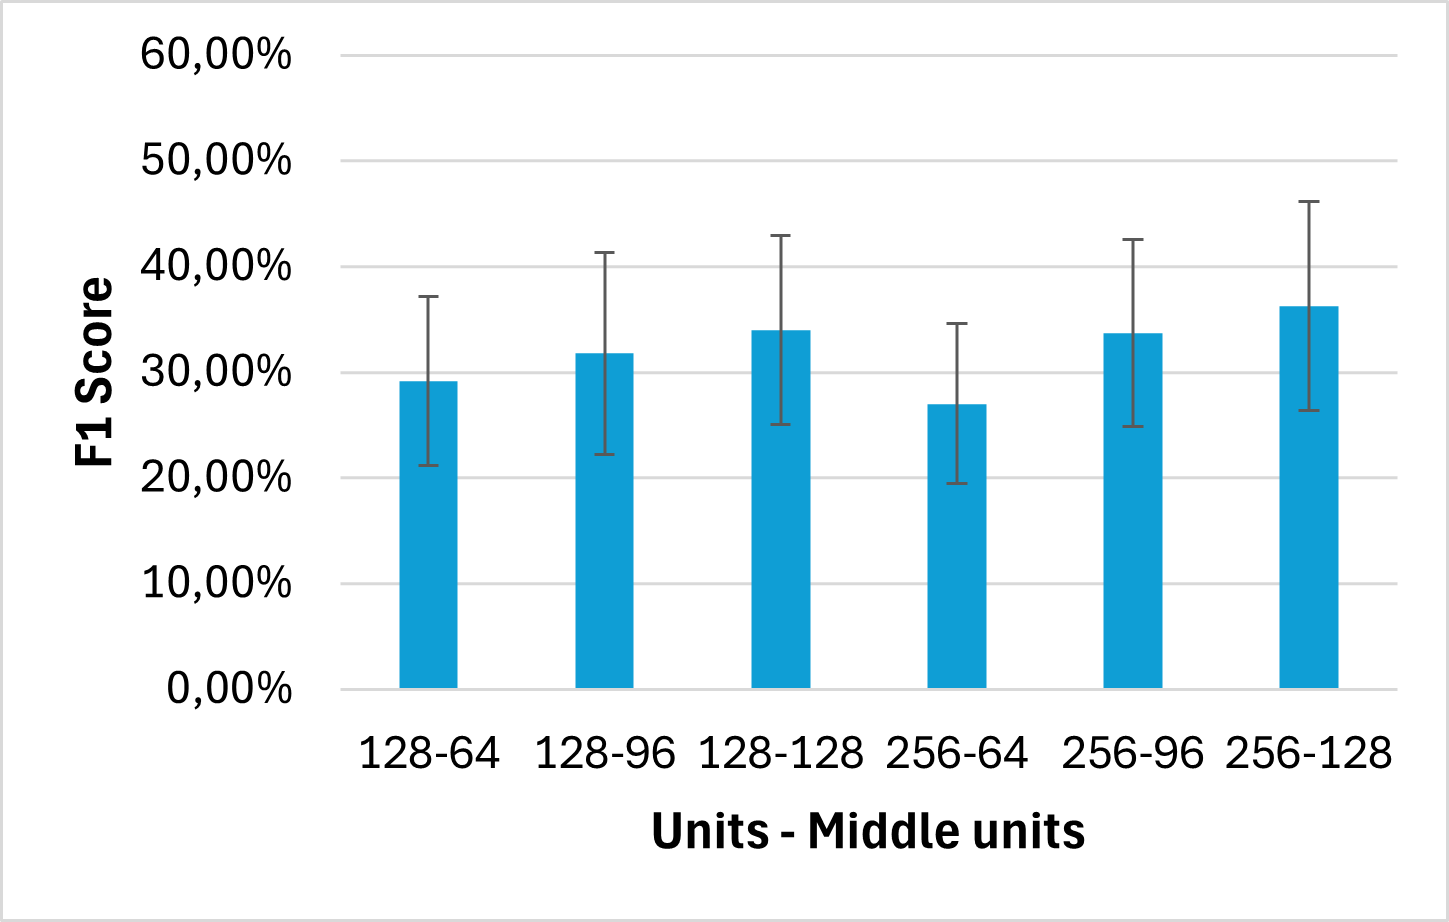
图4d:seq_length=16,stride=16。
[图4描述:四组条形图,每组显示不同units和middle_units组合在四种序列长度/步长配置下的召回率、精确率和F1分数。]
表10:LSTM-自编码器模型的选定超参数。调优期间保持固定的超参数以灰色背景突出显示。
| 超参数 | 值 |
|---|---|
| sequence length | 8 |
| stride | 8 |
| units | 256 |
| middle_units | 96 |
| loss | mse |
| activation | tanh |
| recurrent activation | sigmoid |
| batch size | 64 |
| epochs | 60 |
| learning rate | 0.0001 |
| lambda | 0.00001 |
| dropout rate | 0.15 |
| recurrent dropout | 0 |
最终结果如表11所示,显示该模型达到86.55%的平衡准确率和73.36%的召回率,表明它检测到相关比例的异常窗口,混淆矩阵 [[931085, 2313], [1109, 3054]] 也反映了这一点。然而,其56.90%的精确率和64.09%的F1分数低于有监督随机森林模型的性能。这些结果与模型的性质一致。与随机森林不同,LSTM-自编码器仅使用正常流量训练,并通过重构误差间接检测攻击。因此,其性能取决于攻击序列在选定特征空间中偏离正常行为的程度。尽管精确度较低,但这种无监督方法对于CSA仍然相关,因为它可以在标记攻击数据稀缺的场景中提供预警机制。
表11:LSTM-自编码器模型在测试集上获得的结果。
| 准确率 | 平衡准确率 | 精确率 | 召回率 | F1分数 |
|---|---|---|---|---|
| 99.63% | 86.55% | 56.90% | 73.36% | 64.09% |
5 结论
结果表明,有监督模型在准确率和精确率方面显著优于数据集作者提出的原始IDS基线,同时保持了相似的召回率。此外,所提出的方法更通用,因为它不依赖于特定设备或固定的设备相关RSSI配置文件。从CSA角度来看,获得的性能表明网络-电磁异常检测模型可以通过支持跨电磁和网络域异常行为的检测和解释,为OODA循环的观察和定位阶段做出贡献。
最佳结果通过基于窗口的随机森林模型获得。这些结果表明,聚合连续帧提供了局部流量行为的稳健表示,并改善了正常和攻击流量之间的区分。无监督LSTM-自编码器也提供了有希望的结果,尽管其性能仍低于有监督随机森林模型。这种行为与模型仅在无攻击数据上训练的事实一致,检测取决于攻击序列是否产生与正常行为足够不同的重构误差。这一结果表明,即使在训练期间不使用攻击标签,时间信息对异常检测也是有用的。因此,两种方法都可以通过将低级物理和流量级指标转化为可用作后续决策过程输入的异常信息来支持SA。
然而,该研究也存在一些局限性。首先,可用特征集有限,这降低了正常和攻击窗口之间的可分离性,尤其是对于无监督检测。其次,分析限于单个数据集和技术,因此需要进一步验证以将结果推广到其他环境。最后,尽管所提出的模型避免使用显式设备标识符,但数据集仍与固定拓扑和特定设备关联。
未来工作应探索纳入额外的判别特征、评估替代学习模型,以及不同特征聚合策略和阈值选择方法对检测性能的影响。此外,可以纳入可解释性技术以评估物理层和流量级特征对异常检测的贡献。此外,模型可以从二元检测扩展到多类分类以识别特定攻击类型。最后,应在额外数据集、技术和攻击场景上验证该方法,以评估其在更广泛的网络-电磁异常检测上下文中的适用性。



 扫一扫


 232

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


