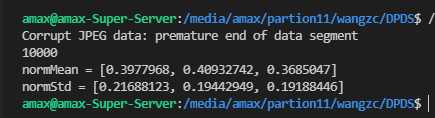
AID数据集的均值和方差

论文阅读——GeoChat(cvpr2024) 阅读详情

在这里插入图片描述

基于K均值聚类的葡萄酒品种判别 摘要 本文基于K均值聚类方法,首先利用使得组间平方和较大、组内平方和较小的方法确定聚类簇K,再对葡萄酒数据进行聚类,得到误判率为3.37%。为描述不同类别葡萄酒的特点,利用主成分分析,探究影响分类的因素,发现类别1与非类别1的差异主要是脯氨酸含量的高低。 关键词:K均值聚类;葡萄酒;主成分分析 ABSTRACT This article trys to classify distinguishe... 阅读详情

相关推荐

用PyTorch处理Million-AID遥感数据:从图片加载到归一化的完整代码实战

本文详细介绍了如何使用PyTorch高效处理Million-AID遥感数据集,涵盖从图片加载到归一化的完整代码实战。通过构建基础数据加载器、高级图像预处理流水线以及优化数据加载策略,帮助研究者快速掌握遥感图像处理的核心技术,提升在计算机视觉领域的实践能力。

weixin_30439067的博客 723

遥感数据集Million-AID介绍及数据预处理

遥感数据集Million-AID介绍和数据预处理

m0_53374472的博客 7108

用 SVM、决策树与感知机算法进行 Wine 数据集分类:从数据预处理到模型评估

Wine 数据集是一个经典的多类分类数据集,其中每个样本表示一种酒的化学成分特征,并且每个样本都标有不同的种类标签(共三类)。在本例中,为了简化问题,我们将选择前两类进行二分类任务。数据集包含多个特征,如酒精含量、苹果酸含量、色度等,而我们选择了其中的两个特征:“alcohol”和“malic_acid”。感知机是最基本的线性分类模型之一。尽管它较为简单,但通过正确的训练可以有效地解决二分类问题。在本例中,我们实现了一个简单的感知机模型,并使用梯度下降更新权重。# 自定义感知机。

weixin_48327795的博客 1261

展示AID数据集,并将类别名放在图像下方

【代码】展示AID数据集,并将类别名放在图像下方。

热爱分享,热爱记录 950

遥感图像场景分类常用数据集

1. UC Merced Land-Use Data Set contains 21 scene classes and 100 samples of size 256x256 in each class. 图像像素大小为256*256,总包含21类场景图像,每一类有100张,共2100张。 下载地址:http://weegee.vision.ucmerced.edu/datasets/landuse.html 2.WHU-RS19 Data Set has 19 dif...

haoji007的博客 3323

19、交互式检索实验:AID与ITAL方法的深入探究

本博文深入探讨了交互式检索实验中的AID与ITAL方法。AID方法通过聚类有效处理模糊图像查询,将不同主题的检索结果区分开来;而ITAL方法在批量模式主动学习中表现出色,结合用户模型和信息论,提升了检索性能。实验涵盖了多个数据集,并评估了不同用户行为和特征维度对结果的影响,验证了这两种方法在图像检索领域的广泛应用潜力。

wdx0123456的博客 89

机器学习 数据预处理之特征缩放(理论+案例)

特征缩放 原因: 数量级的差异将导致量级较大的属性占据主导地位 数量级的差异将导致迭代收敛速度减慢 依赖于样本距离的算法对于数据的数量级非常敏感 好处: 提升模型的精度:在机器学习算法的目标函数(例如支持向量机的 RBF 内核或线性模型的 l1 和 l2 正则化),许多学习算法中目标函数的基础都是假设所有的特征都是零均值并且具有同一阶数上的方差。如果某个特征的方差比其他特征大几个数量级,那么它就会在学习算法中占据主导位置,导致学习器并不能像我们期望的那样,从其他特征中学习 提升收敛速度:对于线性模型来

yj8023xx的博客 5711

18、自适应池化与交互式图像检索实验解析

本文探讨了自适应池化与交互式图像检索的相关技术与实验。重点介绍了基于Exemplar-LDA模型的局部特征相关性分析方法,以及如何通过自适应池化技术将局部特征聚合为更具有判别能力的全局图像表示。此外,文章还详细解析了自动查询图像消歧(AID)方法在MIRFLICKR-25K数据集上的实验结果,验证了其在最小用户反馈下显著提升检索性能的能力。实验涵盖了多个数据集和特征提取方法,强调了全局重新排名和聚类策略在检索系统中的重要性。最后,总结了相关技术的有效性,并展望了未来研究方向。

wdx0123456的博客 88

PCA、LDA降维——应用于wine葡萄酒数据集

参考教程:https://mp.weixin.qq.com/s/QqqLAxx92v_HOg7QBKrK6A 一、wine数据集介绍 sklearn的wine数据,它有178个样本,13个特征(Alcohol ,Malic acid ,Ash等),总共分为三类。 二、查看三个特征下的数据分布 #葡萄酒数据集+PCA import matplotlib.pyplot as plt#画图工具...

北落师门XY的博客 1万+

昇思25天学习打卡营第23天|K近邻算法实现红酒聚类

K近邻算法(K-Nearest-Neighbor, KNN)是一种用于分类和回归的非参数统计方法,最初由 Cover和Hart于1968年提出(Cover等人,1967),是机器学习最基础的算法之一。它正是基于以上思想:要确定一个样本的类别,可以计算它与所有训练样本的距离,然后找出和该样本最接近的k个样本,统计出这些样本的类别并进行投票,票数最多的那个类就是分类的结果。KNN的三个基本要素:K值,一个样本的分类是由K个邻居的“多数表决”确定的。K值越小,容易受噪声影响,反之,会使类别之间的界限变得模糊。

数字人生 1157

iSAID_Devkit:[CVPR'W19-Oral]“ iSAID的官方存储库

iSAID:用于航空影像中实例分割的大规模数据集,CVPR研讨会,2019年。 数据准备和评估代码 环境和依赖项安装 创建conda环境conda env create -f environment.yml 激活当前的工作环境source activate py_isaid 为evalaution服务器设置pycocotols- cd cocoapi/PythonAPI - make - python setup.py install 为evalaution服务器设置城市景观脚本-cd cd preprocess/cityscapesScripts cityscapesScripts- python setup.py install 为Evlaution服务器设置Detectron- cd preprocess/Detectron make 注意:opencv版本== 3.4.

《R的极客理想——高级开发篇 A》一一1.3 概率基础和R语言

本节书摘来华章计算机出版社《R的极客理想——高级开发篇 A》一书中的第1章,第1.3节,作者:张丹 更多章节内容可以访问云栖社区“异步社区”公众号查看。 1.3 概率基础和R语言 问题如何用R语言学习概率? 引言R语言是统计语言,概率又是统计的基础,所以可以想到,R语言必然要从底层API上提供完整、方便、易用的概率计算的函数。下面就让R语言帮我们学好概率...

weixin_33913377的博客 239

AID 数据集 AID 是一个新的大规模航拍图像数据集

AID 是一个新的大规模航拍图像数据集,通过从 Google Earth 图像中收集样本图像而形成。请注意,尽管 Google Earth 图像是使用原始光学航拍图像的 RGB 渲染进行后处理的,但事实证明,即使在像素级土地利用/覆盖制图方面,Google Earth 图像与真实光学航拍图像之间也没有显着差异。因此,Google Earth 图像也可以用作评估场景分类算法的航拍图像。 新的数据集由以下 30 个空中场景类型组成: 机场、裸地、棒球场、海滩、桥梁、中心、教堂、商业区、密集住宅区、沙漠、农田、森林、工业区、草地、中等住宅区、山区、公园、停车场、游乐场、池塘、港口、火车站、度假村、河流、学校、稀疏住宅区、广场、体育场、储罐和高架桥。所有图像均由遥感图像解译领域的专家标注,每个类别的一些样本如图 1 所示。AID 数据集总共有 30 个类别的 10000 幅图像。 AID 中的图像实际上是多源的,因为 Google Earth 图像来自不同的远程成像传感器。这给场景分类带来了比 UC-Merced 数据集等单源图像更大的挑战。此外,AID 中每个类别的所有样本图像都是从全球不同

15 离群点和高杠杆率点

15 离群点和高杠杆率点 标签:机器学习与数据挖掘 1.离群值   离群值的标准残差的据绝对值非常大,我们研究的时候可以单独把这类值来出来看一下,以使我们的预测模型的不会受到太大干扰。   那我们如何揪出离群值呢?看图 这里有两个特别离群的点,他们的残差都比一般的值要大一些。但是对于不同的变量,就有不同的度量和方差,我们需要将它们标准化,这样就有了标准残差。   令Si,residS_{i, \...

纸境止境的博客 7978

Golang面试(一)莉莉丝游戏-Golang后端开发-中台部门

莉莉丝游戏-Golang后端开发-中台部门 开场白,双方自我介绍,对方介绍这个岗位情况,erlang语言,全部转向go。 聊项目,介绍IM架构以及使用Go写的服务简介 动态扩容相关问题:平常30万,现在100万,你们现在是如何应对的? 如果让你调整架构实现动态扩容,你会怎么做?回答了kafka,是一种,应该还要使用docker和k8s以及微服务框架等 如果使用kafka,你是如何确保消息有序?回答了redis,好像没回答到那个点 消息发送失败的问题,如何做到消息不丢?回答持久化存储、拉消息和ACK 发送失

xmcy001122的专栏 3890

新手避坑指南:从GEO数据库下载单细胞测序数据的5个关键步骤(附实操截图)

本文为单细胞测序数据下载新手提供5个关键避坑步骤,涵盖数据搜索准备、样本量评估、文件选择决策、元数据诊断及高效下载技术。通过实操截图和代码示例,帮助研究者快速锁定GEO数据库中的优质单细胞测序数据,避免常见错误。

weixin_30296405的博客 615

机器学习 数据预处理之特征缩放(理论+案例)_数据特征缩放 的例题(3)

网上学习资料一大堆,但如果学到的知识不成体系,遇到问题时只是浅尝辄止,不再深入研究,那么很难做到真正的技术提升。需要这份系统化的资料的朋友,可以戳这里获取一个人可以走的很快,但一群人才能走的更远!不论你是正从事IT行业的老鸟或是对IT行业感兴趣的新人,都欢迎加入我们的的圈子(技术交流、学习资源、职场吐槽、大厂内推、面试辅导),让我们一起学习成长!x−mean(x)std(x)x^{\prime} = {{x - mean(x)} \over std(x)}x′=std(x)x−mean(x)​适用范围:将原

2401_84561461的博客 857

1. 基于STM32的1.28寸圆形IPS屏(GC9A01)驱动移植实战:软件SPI与硬件SPI双方案详解

本文详细介绍了如何在STM32平台上为1.28寸圆形IPS屏(GC9A01驱动芯片)移植驱动程序,涵盖软件SPI与硬件SPI两种实现方案。内容从引脚定义、工程搭建、GPIO配置到SPI外设初始化逐步详解,并提供了完整的测试代码,帮助开发者根据项目需求(灵活性或性能)选择合适的通信方式,快速点亮屏幕并集成到智能手表等嵌入式项目中。

weixin_42300144的博客 200

Python28-7.1降维算法之LDA线性判别分析

Wine 数据集中的样本是从意大利某个地区生长的葡萄酿造的葡萄酒中提取的,涉及 13 种化学成分分析。数据集包含 178 个样本,每个样本有 13 个特征。

Argulo的博客 1191

PCL 动态半径滤波【2025最新版】

使用PCL实现的2022年最新SCI论文——【Design of Dust-Filtering Algorithms for LiDAR Sensors Using Intensity and Range Information in Off-Road Vehicles】 一文中提出用于自动驾驶点云剔除粉尘、雨雪等影响因素导致的噪声点滤波算法。

点云侠的博客 1468

YOLO26 无损剪枝:稀疏训练 + 结构化通道裁剪

YOLO26 无损剪枝链路:YOLO26s (7.2M) → 稀疏训练 30 epoch (L1 on BN gamma, lam=0.01) → 阈值剪枝 50% (gamma<quantile(0.5)) → 结构化重建 Conv+BN → 微调 10 epoch (lr=1e-4) → YOLO26n (1.9M, mAP50 0.808, 仅降 0.6%)。核心贡献:稀疏训练让 BN gamma 趋向二元分布 (近 0 或近 1), 剪枝阈值可直接取 median 自动 50% 压缩。

m0_64661770的博客 259

R语言红酒模型实战

R语言数据分析报告 使用软件:R studio 一、对数据的基本分析 在这一次的数据分析报告我选取的是对红酒质量的一个数据分析。我从kaggle上下载了一个1599x12的数据集,其中对于红酒质量影响因素一共有11个因素,分别是:fixed.acidity volatile.acidity Citric.acid Residual.sugar chlorides free.sulfur.dioxi...

qq_45105409的博客 9781

CollisionLoss 设计与实现原理说明

文章摘要 CollisionLoss是一种用于自动驾驶轨迹规划的碰撞惩罚损失函数,其核心思想是用多个沿车身纵轴排列的圆盘来近似表示车辆(Oriented Bounding Box)。该设计通过圆盘间的距离计算实现碰撞检测,具有以下特点: 可微性:圆盘距离计算处处可微,便于梯度回传,而传统矩形碰撞检测(分离轴定理)不可微且计算复杂。 多圆盘设计:沿车身纵向排列多个圆盘能更精确地拟合细长车体,避免单圆盘过度膨胀导致的误报。 安全覆盖:圆盘半径经过数学推导,确保完全覆盖车体矩形,避免漏检(宁可保守)。 软惩罚机制

@bangbang的博客 84

《Python数据分析技术栈》第06章使用 Pandas 准备数据 13 分组和汇总 Grouping and aggregation

Python数据分析技术栈》第06章使用 Pandas 准备数据 13 分组和汇总 Grouping and aggregation聚合是将一组值汇总为一个值的过程。下面我们将介绍 groupby 方法、聚合函数、变换、筛选和应用方法以及 groupby 对象的属性。在此,我们再次使用相同的 COVID-19 数据集,该数据集显示了 2020 年 4 月 12 日所有国家的病例数和死亡数。我们可以看到,有几个国家属于同一个大洲。让我们找出各大洲的病例总数和死亡人数。

未来已来,AI时代,学AI编程,做AI量化,就来大鹏AI教育。 1012

自动驾驶大模型---小米&华科的ORION端到端方案

本文介绍了小米汽车与华中科技大学联合开发的ORION自动驾驶端到端方案。该框架创新性地将视觉语言模型(VLM)与自动驾驶系统结合,包含QT-Former特征提取模块、大语言模型(LLM)推理模块和生成式规划器三大核心组件。通过视觉感知与语言理解的深度融合,ORION能更准确地理解人类指令并生成合理轨迹,同时提升系统的可解释性。实验证明,该方案在准确性、泛化能力和决策透明度方面均有显著优势。ORION框架为自动驾驶技术提供了新思路,有望推动行业向更安全、智能的方向发展。

智能汽车人的博客 2000

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: StochasticPooling 随机池化的PyTorch实现
下一篇: 力扣刷题日记
hellyou
博客等级 码龄9年 7粉丝 35原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
