【硬件】16种实用的将5V输出连接到3.3V输入的方法

欢迎关注【玩转单片机与嵌入式】公号,回复关键字获取更多免费视频和资料。回复【加群】,【单片机】、【STM32】、【硬件知识】、【硬件设计】、【经典电路】、【论文】、【毕业设计】、【3D封装库】、【PCB】、【电容】、【TVS】、【阻抗匹配】、【资料】、【终端电阻】、【Keil】、【485】、【CAN】、【振荡器】、[USBCAN]、【PCB】、【智能手环】、【智能家居】、【智能小车】、【555】、【I2C】、【华为】、【中兴】,等……


本文我们讲一下如果将5V系统的输出接到3.3V系统的输入。本文重点讲解16种方法,统计如下:
  • 直接连接(警告:仅使用 5V 容限输入!!!)

  • 串联电阻器。

  • 串联电阻器具有外部肖特基二极管箝位,朝向3.3V线路。

  • 带上拉电阻的串联二极管。

  • 带有源钳位的串联电阻器。

  • 电阻和齐纳二极管。

  • 电阻分压器。

  • BJT/MOSFET 作为逆变器。

  • 两个级联双极型晶体管/MOSFET 作为缓冲器。

  • 漏极/集电极开路输出上的上拉电阻。

  • 增加具有漏极/集电极开路输出的 5V 供电逻辑 IC(缓冲器、栅极等)。

  • 增加具有 5V 容限输入的 3.3V 供电逻辑 IC(缓冲器、栅极等)。

  • 系列 MOSFET(通用栅极配置)。

  • 双极型晶体管系列(通用底座配置)。

  • 电平转换器。

  • 光耦合器


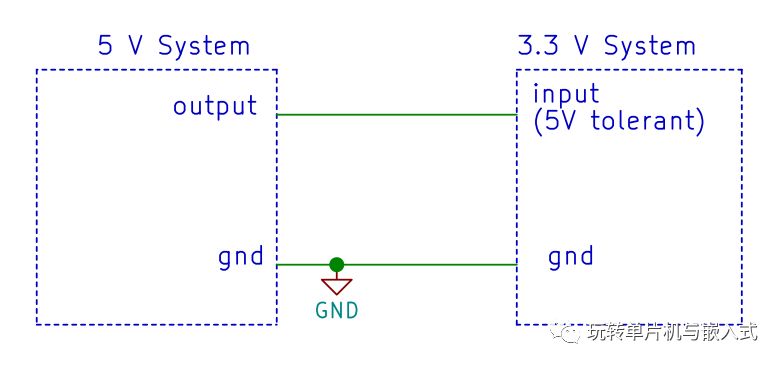
1、直接连接(仅限于5V容限输入)

最简单的方法是直接连接。

519720c5e84c813966a34a41c4ba613e.jpeg

优势:

  • 没有额外的成本或空间

  • 最快的解决方案


劣势:

  • 仅适用于 5V 容限器件


2、串联电阻器

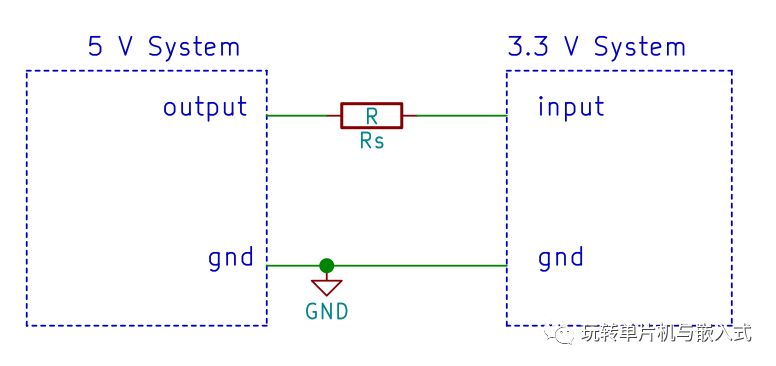
将5V连接至3.3V系统的第二种最简单方法是使用串联电阻。
ec31bdd439fd7258e14eeb49b31f014b.jpeg


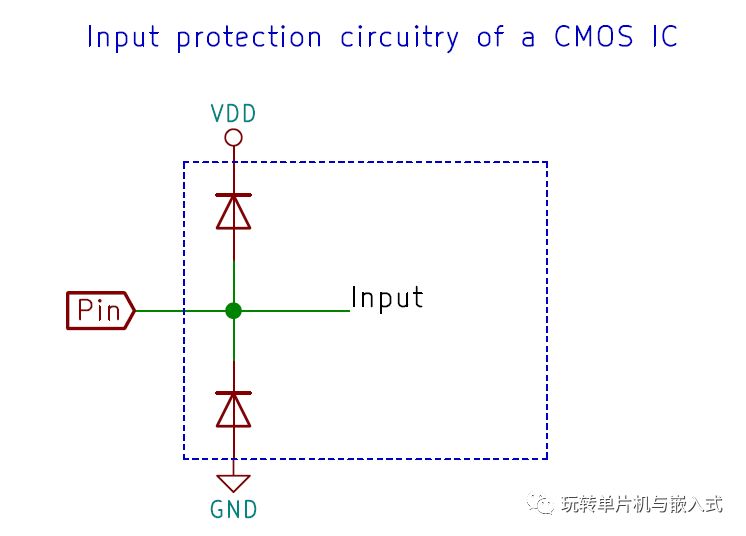
上图串联电阻器用于将一个 5V 输出连接至一个 3.3V 输入。输入端必须有其保护二极管。工作原理如下:3.3V(非5V容限IC)的输入通常由二极管保护:一个朝向VDD,另一个朝向GND,如下图所示。这些二极管通常为关断,因为它们都是反向偏置的。但是,如果尝试输入大于VDD,3.3V的电压,它们会将输入电压箝位为VDD,3.3V(加上正向二极管电压,通常为0.7V)。由于开关器件的电容耦合或振铃,即使在仅3.3V的系统上,也可能发生大于VDD,3.3V的瞬态尖峰。

06a9ea0aa4c578cc5a94da6d73df4807.jpeg


当5V信号通过电阻馈送到输入端时,二极管将导通:电阻限制流入引脚的电流,保护输入。进入引脚的最大电流有时会在数据表中注明,并且应保持较低水平,原因有两个:

  • 除了漏电流外,没有电流会流入引脚。由于闩锁现象,可能会发生损坏。
  • 流入输入引脚的电流将从VDD引脚流出!如果这样的电流太大,可能会增加整个系统的VDD电压,破坏IC。如果系统的电流消耗大于流入PIN的电流,那么应该没有问题。否则,建议在VDD,3.3V和GND之间放置一个虚拟负载。负载的值应使其至少吸附流入所有输入的电流。
要计算,只需将输入电流视为I=(5V-3.3V)/RS。然后在VDD,3.3V和GND之间放置一个电阻,使其将吸收相同的电流I。换句话说:RLOAD = RS 3.3V (5V-3.3V) 或约 2 RS。如果有多个输入,则必须相应地降低 RLOAD。如果您的系统已经从3.3V吸收“I”(例如,由于IC电流消耗或存在始终接通的LED),那么您可以省略或增加RLOAD。.该解决方案还有另一个缺点:除非使用低值电阻,否则它会严重限制带宽。事实上,输入引脚和走线都会有一定的寄生电容.

优势:

  • 简单的解决方案:每个输入引脚只有一个电阻。


劣势:

  • 高功率使用率(使用低值电阻器)或低带宽(高值电阻器)。

  • 输出过载(使用低值电阻器)

  • 进入输入端的电流可能会导致锁存。

  • 如果 3.3V 系统具有非常低的最小电流消耗,则需要在 3.3V 电源上使用一个外部负载电阻器。

  • 3.3V电源上可能由于电流注入而产生噪声。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


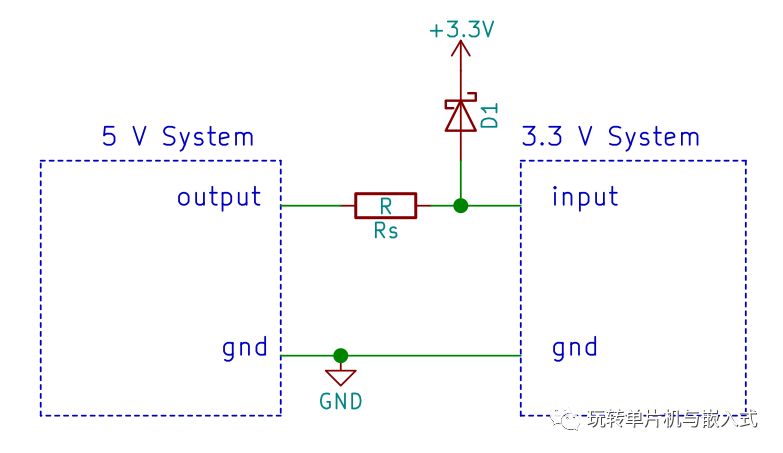
3、串联电阻器,带有朝向 3.3V线路的外部肖特基二极管箝位

该电路与以前的解决方案类似,但可以实现更快的速度,因为大部分电流将由肖特基二极管承载,而不是保护二极管。这仍然有将电流馈送到VDD,3.3V线的缺点。因此,系统必须“消耗”这种电流,如前一种情况所示。
e71e35aa7035aadb054f678387fb914c.jpeg

优势:

  • 可实现更大的带宽。

  • 注入输入引脚的电流可忽略不计。


劣势:

  • 每个输入需要两个元件(电阻和肖特基二极管)。

  • 高功率使用率(使用低值电阻器)或低带宽(高值电阻器)。

  • 输出过载(使用低值电阻器)

  • 如果 3.3V 系统具有非常低的最小电流消耗,则需要在 3.3V 电源上使用一个外部负载电阻器。

  • 3.3V电源上可能由于电流注入而产生噪声。

  • 还必须考虑二极管的电容。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


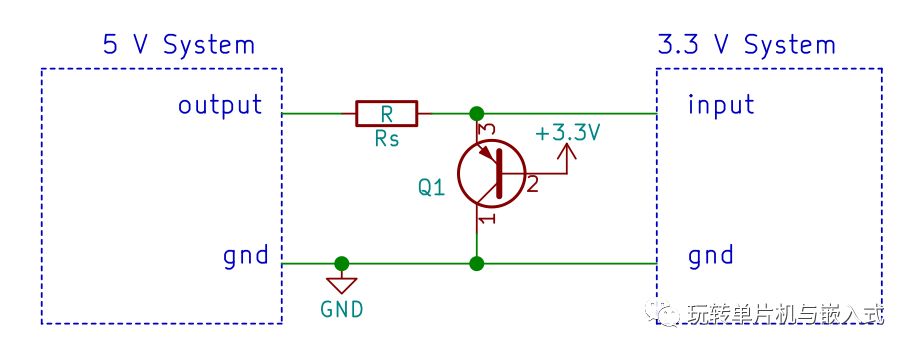
4、带有源钳位的串联电阻器。

与其将输入电流重定向到VDD,3.3V,不如将其耗散到地,这样就不会发生VDD,3.3V电平变化。
a5b1cad945961b7f58c9dde6287c3739.jpeg

当输入电压大于3.9V时,PNP BJT将持续传导。该解决方案允许使用更小的电阻(更高的带宽)。值得注意的是,仍然有电流注入VDD,3.3V,但是,这种电流将比流入RS的电流小很多倍。

另一个问题是,在某些IC上,当输入端的值比3.3V电平低至0.35V时,它们的保护二极管开始导通。在这种情况下,BJT基极不应连接到3.3V,而应连接到稍小的电压(如果系统上可用)。

优势:

  • 可实现更大的带宽。

  • 注入3.3V电源线的电流非常小。

  • 小电流注入输入引脚。


劣势:

  • 每个输入需要两个元件(电阻和双极型晶体管)。

  • 高功率使用率(使用低值电阻器)或低带宽(高值电阻器)。

  • 输出过载(使用低值电阻器)

  • 如果3.3V系统具有极低的最小电流消耗,则仍可能需要在3.3V电源上使用外部负载电阻。

  • 由于电流注入3.3V电源,3.3V电源上仍可能存在噪声。

  • 在某些情况下,可能需要另一个电源(低于3.3V)将电压箝位到输入保护二极管的导通电压以下。

  • BJT的电容仍然必须考虑在内。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。

  • 箝位电压可能过高(约3.9V)。可能需要另一个电压源(小于3.3V)。


5、电阻器和齐纳二极管

我们可以不使用BJT,而是使用齐纳二极管,它将电压削波到Vz值。问题在于,低值齐纳二极管具有相当大的动态电阻,并且必须有大电流流入齐纳二极管,才能实际显示Vz值(几mA)。

6e4deee9d88d715c5cd77a4f577575dd.jpeg

优势:

  • 带宽类似于肖特基或有源箝位解决方案,因为可以使用低值电阻。

  • 没有电流注入3.3V电源线。

  • 没有电流注入输入引脚。

  • 比BJT或肖特基的成本更低。

  • 箝位电压可以低于BJT。


劣势:

  • 每个输入需要两个元件(电阻和齐纳二极管)。

  • 高功率使用率(使用低值电阻器)或低带宽(高值电阻器)。

  • 输出过载(使用低值电阻器)

  • 还必须考虑二极管的电容。

  • 输出电压并不精确,因为一些低值齐纳二极管的动态电阻非常差。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


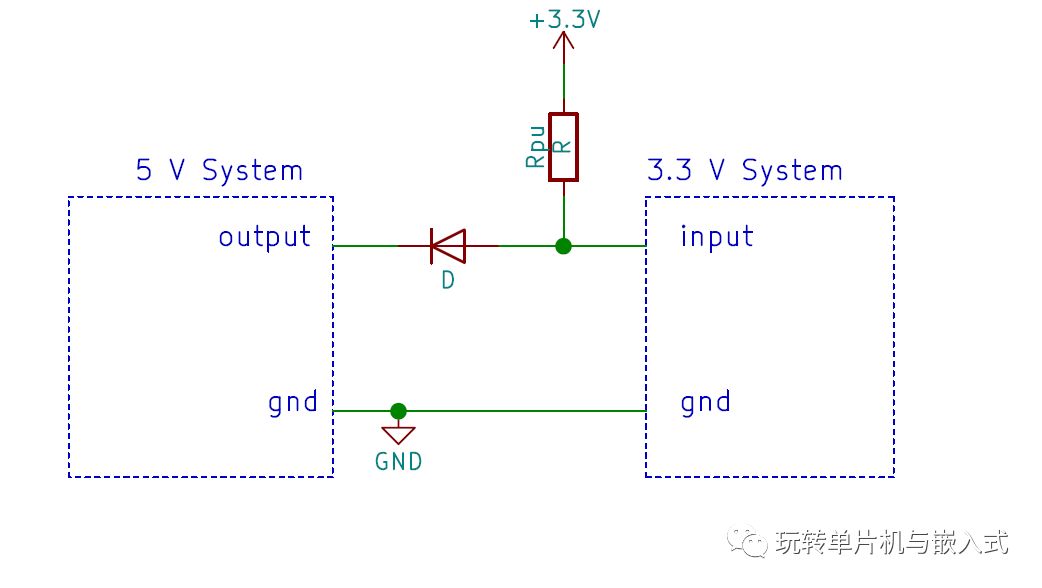
6、带上拉电阻的串联二极管。

如果您的3.3V系统接受高达0.7V的低电平输入电压,则可以使用普通的1N4148二极管,如下所示。如果您想要更大的噪声裕量(或者如果只是0.7V太高),请改用肖特基二极管。工作原理很简单:当5V系统输出5V时,二极管反极化,因此是开路的。3.3V系统的输入通过R1被上拉至3.3V。然后5V系统输出0V,二极管正向偏置,因此3.3V输入端的电压将是二极管的正向压降:硅二极管约为0.6-0.7V,肖特基二极管约为0.35V。切记使用快速信号二极管!(即不要使用1N4007!)
9f8a4713c09603eb0087ec04920ce482.jpeg

优势:

  • 带宽类似于肖特基箝位解决方案,因为可以使用低值上拉电阻。

  • 没有电流注入3.3V电源线。

  • 没有电流注入输入引脚。


劣势:

  • 每个输入需要两个元件(电阻和二极管)。

  • 高功率使用率(使用低值电阻器)或低带宽(高值电阻器)。

  • 输出过载(使用低值电阻器)

  • 还必须考虑二极管的电容。

  • 低电平输出电压是二极管的正向压降。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


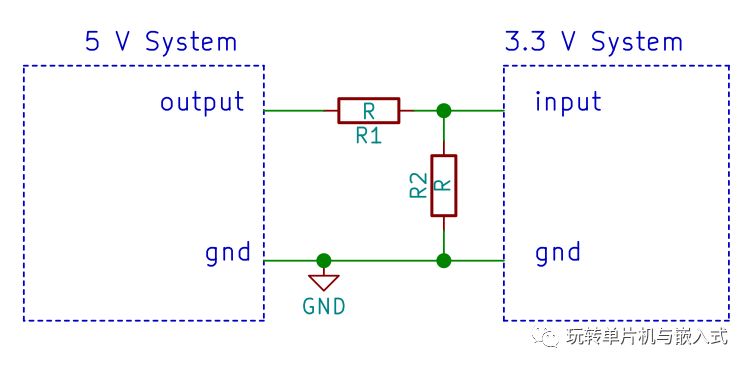
7、电阻分压器

降低5V电压的一种简单方法是通过电阻分压器!
16729f2d7e48174dca105bd891c89086.jpeg

电阻分压器相对于单个电阻表现更好。给定相同的带宽,与已经检查过的其他解决方案相比,它消耗的更少(直接连接除外!)

优势:

  • 相对于其他系统(直接连接除外)而言,在相同消耗(或相同带宽下消耗较小)的带宽更好。

  • 没有电流注入3.3V电源线。

  • 没有电流注入输入引脚。

  • 成本低于 BJT、肖特基或齐纳。

  • 对称上升/下降时间。


劣势:

  • 每个输入需要两个元件(两个电阻)。

  • 高功率使用率(使用低值电阻)或低带宽(高值电阻)。

  • 输出过载(使用低值电阻器)

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


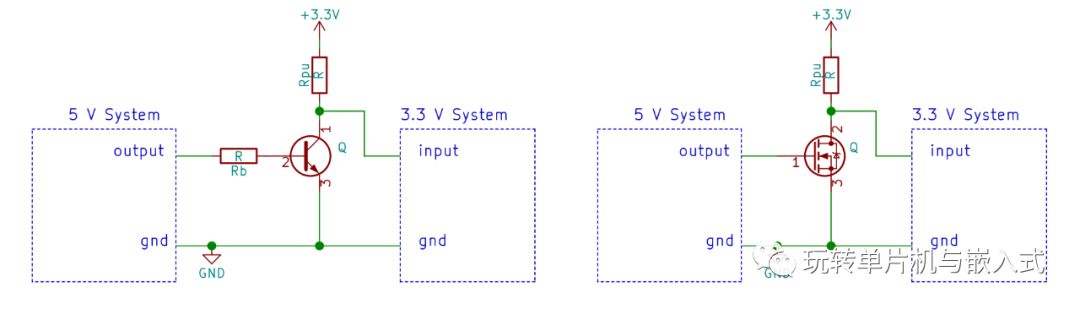
8、双极型晶体管/MOSFET 作为逆变器

如果您可以接收反相信号,则可以使用BJT或MOSFET。
ae5a3c5773fe3590071638c2ace15bd1.jpeg

带宽主要由上拉电阻和寄生电容(必须包括BJT/MOSFET的电容!)决定。

优势:

  • 没有电流注入3.3V电源线。

  • 无输出过载。

  • 没有电流注入输入引脚。


劣势:

  • 每个输入需要两个或三个元件(BJT/MOSFET和一个或两个电阻器)。

  • 高功耗(使用低值上拉电阻)

  • 反转输出!

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


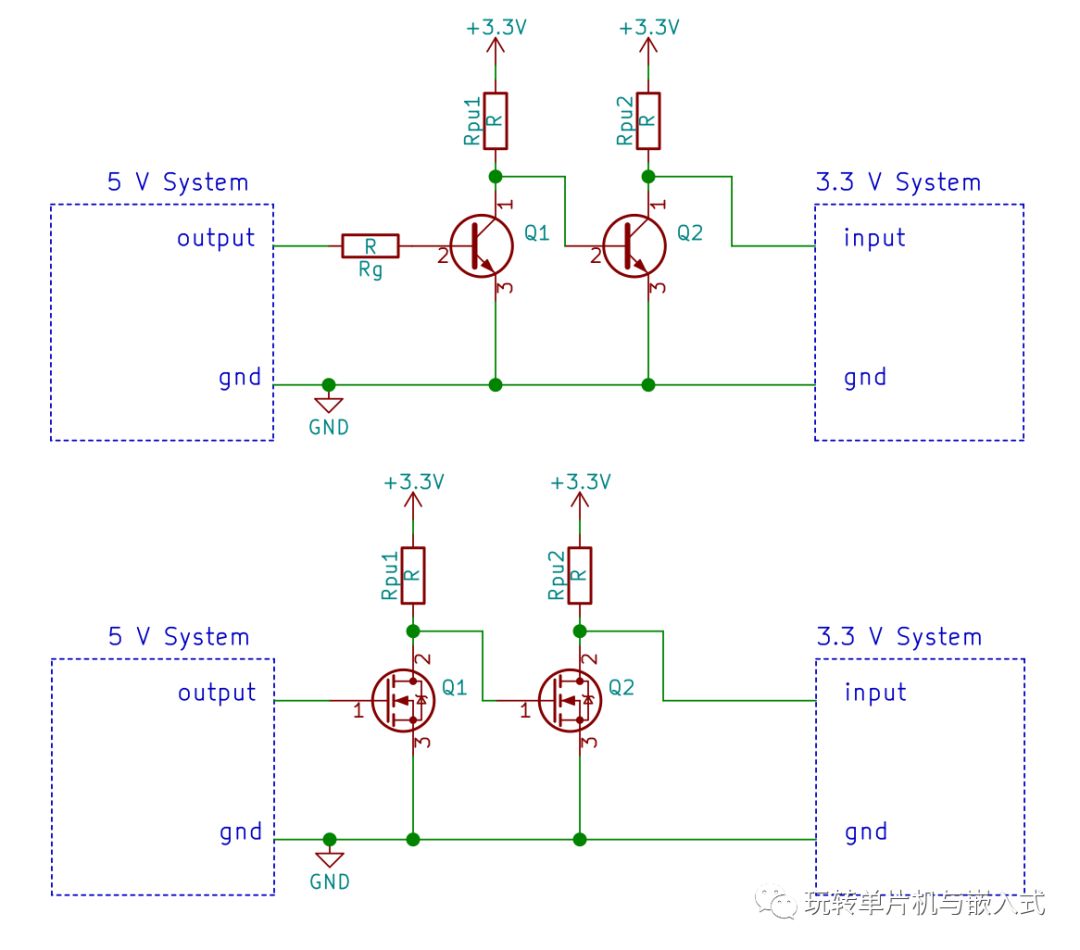
9、两个级联的双极型晶体管/MOSFET作为缓冲器。

您可以级联两个以前的 BJT/MOSFET 电阻器逆变器。这样,输出就不会反转。
6090204a29a7fb70237c00a8dfec88f7.jpeg


优势:

  • 没有电流注入3.3V电源线。

  • 无输出过载。

  • 没有电流注入输入引脚。

  • 逻辑电平不会反转。


劣势:

  • 需要很多组件!

  • 高功耗(使用低值上拉电阻)

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。

  • 与前一种情况相比,带宽较小,因为两级级联。


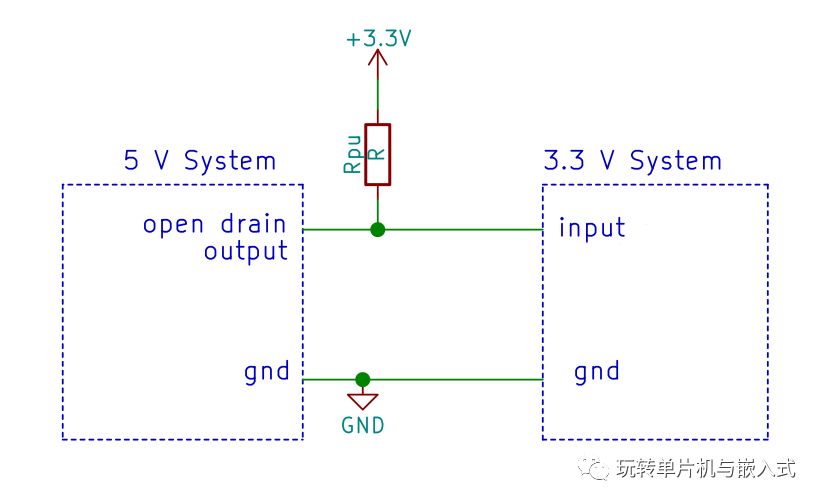
10、开漏/耦合器输出端上的上拉电阻

仅当输出为集电极/漏极开路时,此方法才有效。
8f91db93481d2f68c79ca039356977f9.jpeg

这与“BJT/MOSFET作为逆变器”非常相似。由于输出是漏极开路,因此必须插入一个上拉电阻。

优势:

  • 需要单个电阻器。

  • 没有电流注入引脚。

  • 没有电流注入3.3V线路。


劣势:

  • 高功率使用率(使用低值电阻器)或低带宽(高值电阻器)。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


11、逻辑IC(缓冲器、栅极等),具有漏极开路/集电极输出。

您可以连接漏极开路/集电极缓冲器/栅极IC,外加一个上拉电阻,如下所示。缓冲器/栅极由5V供电,因此可接受5V。

15668c854681612ea6845ed993ff6f5d.jpeg

优势:

  • 没有电流注入引脚。

  • 没有电流注入3.3V线路。


劣势:

  • 高功率使用率(使用低值电阻器)或低带宽(高值电阻器)。

  • 该解决方案需要一个缓冲器和一个电阻器。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


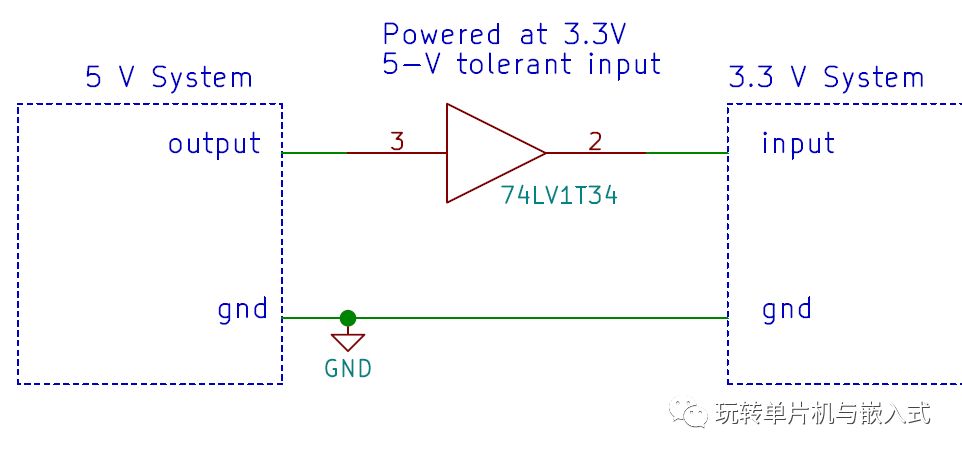
12、增加具有 5V 容限输入的 3.3V 供电逻辑 IC(缓冲器、栅极等)

您可以连接一个 5V 容限 IC,供电电压为 3.3V,例如 SN74LV1T34。
6fe1312b899b396d8e1f8a2fe2ba1d11.jpeg

优势:

  • 没有电流注入引脚。

  • 没有电流注入3.3V线路。

  • 低功耗。

  • 快。

  • 高噪声裕量。


劣势:

  • 成本和空间


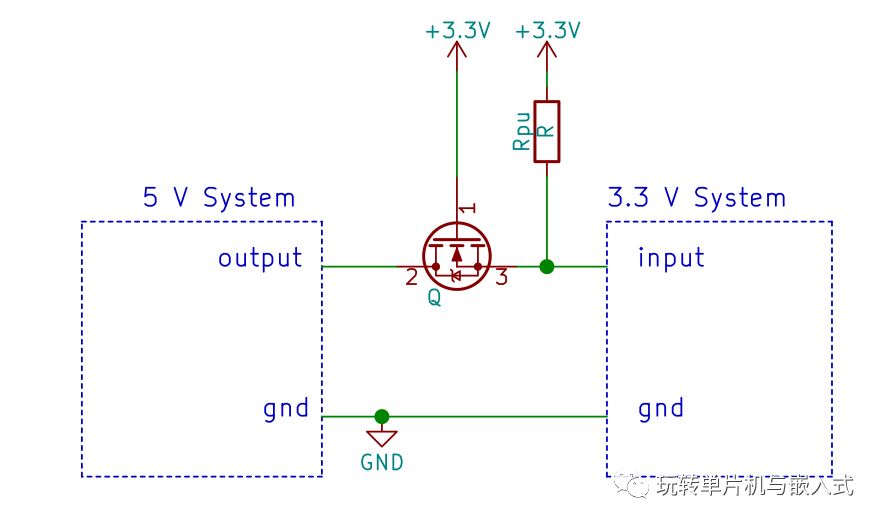
13、MOSFET 系列(通用栅极配置)

我们可以使用公共栅极配置,而不是在公共源配置中使用MOSFET。MOSFET实际上将是串联的。MOSFET 必须是 2.5V 逻辑电平 MOSFET,否则将无法工作。
57a7a8244a9ba80599b421407e09f29b.jpeg


电路的工作原理如下。当Vin为5V时,MOSFET将关闭,因为VGS = 0V(被R2束缚)。当Vin为0V时,由于MOSFET的漏体寄生二极管,输出最初将变为0.7V。因此,VGS将变为3.3V-0.7V = 2.6V。由于这是一个2.5V逻辑电平MOSFET,MOSFET将导通,现在有效地充当短路。输出为0V。正如我们将在“连接3.3V至5V系统”中所示,该电路也可以双向工作,即它将3.3V信号转换为5V信号!

优势:

  • 没有电流注入3.3V电源线。

  • 没有电流注入输入引脚。

  • 非反相输出。

  • 可以是双向的。


劣势:

  • 每个输入需要两个元件(MOSFET和一个电阻器)。

  • 高功耗(使用低值上拉电阻)

  • 输出过载(使用低值上拉电阻)

  • 还必须考虑MOSFET的电容。

  • 需要一个 2.5V 逻辑电平 MOSFET。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


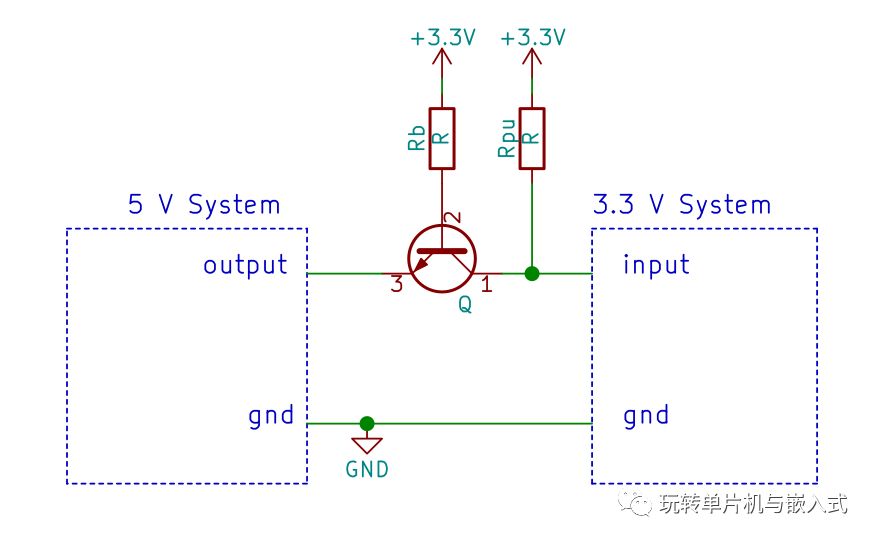
14、双极型晶体管系列(通用底座配置)

也可以使用BJT,但发射器必须在5V侧(MOSFET的源极是在3.3V侧!
95c7dc0839803f58b1053b6f5279468b.jpeg


其工作原理如下:当输入为5V时,VBE=-1.7,因此BJT为OFF。3.3V侧上拉。当VIN为0V时,基极-发射极结将正向极化,BJT将导通,将“0”逻辑电平传输到3.3V侧。

优势:

  • 没有电流注入3.3V电源线。

  • 没有电流注入输入引脚。

  • 非反相输出。


劣势:

  • 每个输入需要三个元件(BJT和两个电阻)。

  • 高功耗(使用低值上拉电阻)

  • 输出过载(使用低值上拉电阻)

  • BJT的电容仍然必须考虑在内。

  • VCE,sat被添加到低值输出中。

  • 3.3V输入必须具有高阻抗(小输入泄漏,如CMOS)。


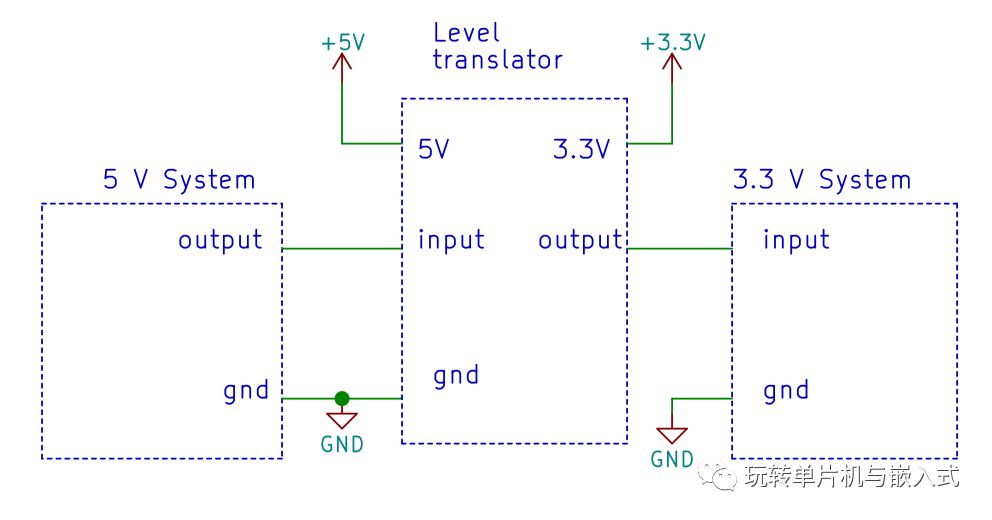
15、电平转换器

为了实现最快的速度、最低的功耗和更好的信号电平,您可以使用电平转换器 IC,如 74LVC8T245(8 位)或 74LVC1T45(1 位)。然而,它们成本很高,占用空间,并且需要另外两个去耦电容(原理图中未显示)。通常,电平转换器具有不同数量的输入/输出,它们也可以是双向的(由数据方向控制或自动控制)。
6bb3674e7733dd816673631838bc5753.jpeg

优势:

  • 没有电流注入3.3V电源线。

  • 没有电流注入输入引脚。

  • 非反相输出(也有反相转换器)。

  • 无输出过载。

  • 非常高的带宽。

  • 良好的信号水平。

  • 收发器的输出也可以加载。

  • 静态功耗可忽略不计。


劣势:

  • 成本(电平转换器比一对电阻器或MOSFET/二极管贵得多)。

  • 所需的空间(特别是在需要很少输入的情况下)。


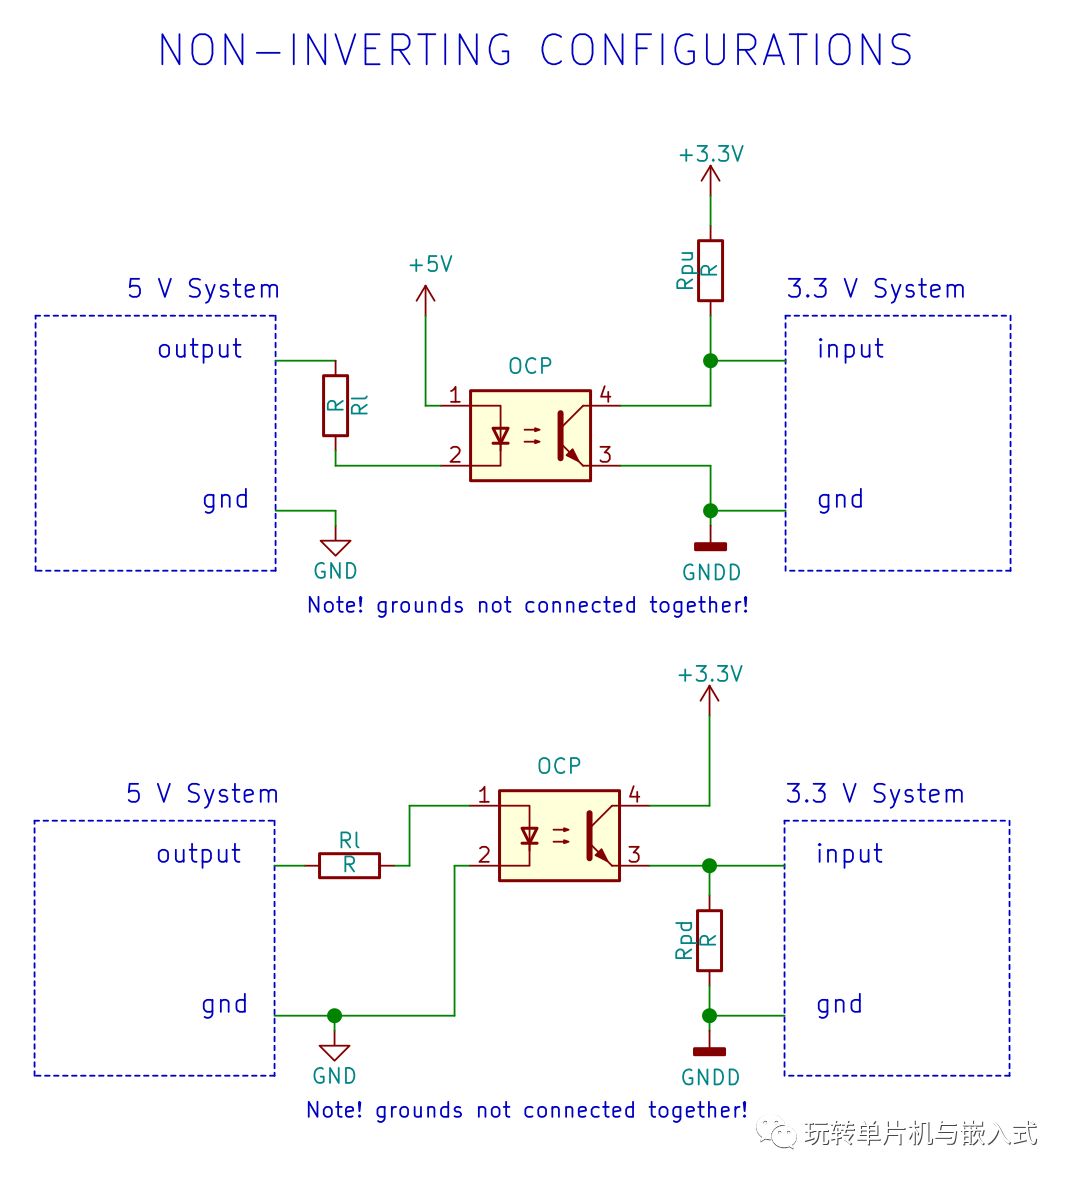
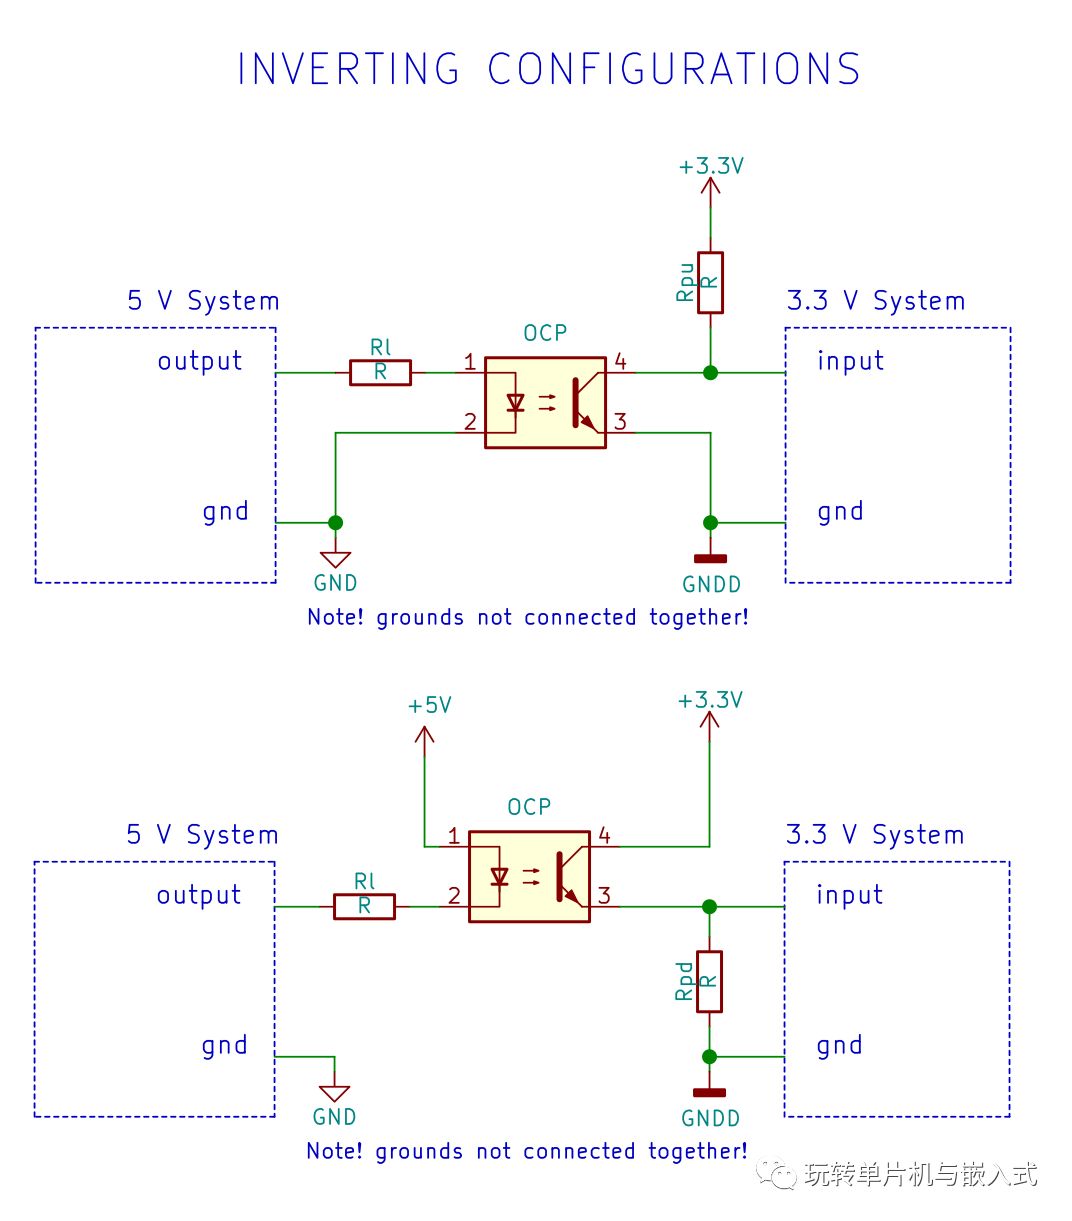
16、光耦合器/隔离器

当您需要连接两个单独的系统,或者当您需要在同一电路/系统的两个部分之间进行电气绝缘时,这种技术特别有用,并推荐使用。当处理远高于5V(例如24V)的电压时,它也非常有用。请注意,这两个系统也可能共享相同的接地,但是,在这种情况下,您将失去它们之间的电气绝缘。在下面的原理图中,我们展示了一个带有晶体管输出的标准光耦合器。有些光耦合器已经提供了数字,并且在某些情况下不需要Rpu(检查输出是否为集电极开路)。最近,其他类型的隔离器已经问世。这些不是基于光学的,而是基于电容式,巨磁阻或磁耦合。这些通常更快,但要贵得多。在所有这些具有直接数字输出的光耦合器/隔离器中,只能使用反相和非反相配置的第一个版本(即光耦合器连接在3.3V系统的输入和地之间)。
10862fd165cd4ad00ec0ba7b5e35d2e9.jpeg

0a4bfc6ec7b07937490bb253641e40bf.jpeg

优势:

  • 两个系统之间的电气绝缘。它不仅提供更好的噪声性能,而且还提高了系统的安全性。

  • 允许将任何电压电平转换为“任何”电压电平。

  • 通过正确选择接地或电源(取决于配置),您可以实现其他类型的电压转换(例如-12V...+12V至0...3.3V转换)。

劣势:

  • 它需要一个光耦合器。

  • 标准光耦合器通常速度较慢。对于高数据速率,需要特殊的“高速”光耦合器。

  • 由于内部LED,电流消耗相对较高。

  • 如果需要高带宽,则功耗较高,因为如果需要较小的上升/下降时间,则Rpu/Rpd需要相当小。


以上16种方法,您更喜欢哪种方法?欢迎在评论区留言讨论。~

在本公号内回复【电路】,可以获取更多电路设计相关的实用电路。


相关推荐

深入浅出TinyML 25:一个.tflite模型文件内部保存了什么?

<think>我们根据要求生成≤150字的文章摘要。内容核心:.tflite是FlatBuffer二进制,保存结构描述而非可执行代码;运行时解析并调用算子内核;模型文件与固件需兼容;检查构建门禁。摘要需简洁。</think>.tflite是FlatBuffer二进制模型,保存计算图、张量、算子、权重及量化参数,而非可执行代码。运行时解析结构并调用固件算子内核,需确保Schema版本与算子集合兼容。部署前应自动检查输入输出契约、算子类型、量化参数和模型哈希,作为构建门禁。理解Model

358

深入浅出TinyML 24:剪枝、聚类、蒸馏和算子替换是否真正适合MCU?

<think>我们只需要根据给定内容生成摘要,不超过150字。内容主要讲剪枝、聚类、蒸馏、算子替换在MCU部署中的实际收益取决于目标链支持,强调以Flash/RAM/延迟/能量等统一指标验收。需简洁概括核心观点。</think>剪枝、聚类、蒸馏和算子替换须经目标部署链才能转化为MCU收益。非结构化剪枝需稀疏内核支持;聚类常只优化压缩文件;蒸馏与算子替换更易直接减小模型结构。应用Flash、RAM、推理时间、能量和效果统一验收,压缩率仅为中间指标,避免误判。

389

深入浅出TinyML 23:代表性数据集和量化感知训练分别解决什么问题?

训练后量化需要一批代表性样本估计中间激活范围。样本只覆盖安静、正常或单一设备时,现场极端输入可能大量饱和。代表性数据集解决范围校准,无法自动修复模型对量化噪声敏感的问题。量化感知训练在训练过程中模拟量化,让权重适应整数误差。它增加训练复杂度,应在PTQ结果经过误差定位后再使用。PTQ在训练完成后选择整数尺度。代表性数据不需要标签,但必须像部署输入一样经过相同预处理并覆盖真实工况。图1:PTQ优先,量化误差超出目标时再进入QAT。

158

深入浅出TinyML 22:Scale、Zero Point和Per-Channel量化如何工作?

INT8只有256个整数码,模型需要用Scale说明相邻整数代表多大实数间隔,用Zero Point说明实数0对应哪个整数码。量化与反量化都依赖这两个参数。权重的不同输出通道可能具有不同数值范围。Per-Channel量化为每个通道设置独立Scale,通常能减少大范围通道对小范围通道的精度挤压。scale表示相邻整数码之间隔多远,zero point表示实数0落在哪个整数码。

184

深入浅出TinyML 21:INT8量化改变了模型中的哪些数据?

把模型文件标记为INT8并不能证明整个推理链都在执行整数计算。权重、输入、输出和中间激活可能采用不同数据类型,某些量化方式仍需要浮点输入或浮点内核。MCU部署最常关注全整数量化:权重和激活使用整数表示,输入输出也具有明确Scale与Zero Point。是否获得速度收益还取决于运行时和目标处理器的优化内核。INT8用-128到127共256个整数格子近似一段浮点范围。模型仍在做同类数学运算,但数值表示和内核发生改变。图1:全整数量化涉及输入、权重、中间激活和输出映射。

320

深入浅出TinyML 20:如何在准确率、延迟、内存和功耗之间选择模型?

TinyML模型很少在所有指标上同时最好。更深网络可能提高少量识别效果,却让Arena、推理时间和能量超过系统预算。模型选择应先淘汰不满足硬约束的方案,再比较剩余候选的业务收益。Pareto前沿提供一种清晰方法:当一个模型在效果不低于另一个模型的同时占用更少资源,后者就没有继续保留的理由。模型选择没有单一最高分。先淘汰超过Flash、RAM或截止时间的方案,再在合格方案中比较效果和余量。

236

深入浅出TinyML 19:一维卷积和深度可分离卷积为什么适合时间序列?

振动、动作、电流和声音都包含局部时间模式。相同冲击或周期片段可能出现在窗口不同位置,一维卷积使用同一组卷积核沿时间移动,能够复用参数提取这些局部特征。深度可分离卷积进一步把时间滤波与通道组合拆开。在输入输出通道较多时,它能够显著减少参数和MACC,但真实速度仍取决于MCU优化内核。卷积核像一个短模板,沿时间轴滑动寻找局部模式。同一个模板在每个位置重复使用,因此参数不随窗口长度增长。图1:深度可分离卷积将时间滤波和通道混合拆成两个阶段。

240

深入浅出TinyML 18:全连接网络适合解决哪些TinyML问题?

24维时域或频带特征连接16个隐藏单元,只需要24×16+16=400个参数;再连接5类输出需要16×5+5=85个参数。这样的小网络便于训练、转换和调试。若把100×6原始窗口展平为600维再连接128个单元,第一层已有600×128+128=76928个参数,还丢失了模型利用局部共享的机会。窗口加长会继续线性增加参数。Dense也是比较基线。它效果不足时,通过错误分析判断缺少时序局部模式、频率信息还是数据覆盖,再选择卷积或新特征。直接从复杂网络开始会失去一个可解释参照。

237

深入浅出TinyML 17:参数量、模型大小、MACC和激活内存有什么区别?

参数少的模型可能计算很多次,模型文件小的模型也可能产生很大的中间激活。把参数量、模型大小、MACC和激活内存混为一谈,会在部署阶段遇到Flash够用但RAM不足,或模型很小但推理超时的情况。这四个指标需要分别计算,再与最终固件和目标MCU实测对应。静态分析帮助筛选候选模型,链接报告与板端测试负责最终验收。参数是训练后保存的权重,激活是推理过程中产生的中间结果。前者多影响Flash,后者多影响运行时RAM。图1:参数量、模型文件、MACC和激活内存对应不同资源问题。

226

深入浅出TinyML 16:FFT、频带能量和MFCC分别适合什么任务?

FFT把时间序列转换为频率分量,适合识别周期、谐波和频带能量变化。MFCC在频谱基础上压缩出更接近听觉尺度的表示,常用于关键词和设备声音。频域方法依赖窗口长度、采样率、窗函数和幅值标定。频谱图清晰并不自动带来更好模型,仍要用独立数据和目标MCU验证。FFT是一种快速计算离散傅里叶变换的方法。它把时间序列换成各个频率分量的幅度和相位。图1:FFT、频带能量与MFCC位于同一频域处理链的不同阶段。

260

深入浅出TinyML 15:时域特征能够描述信号的哪些属性?

时域特征把一段波形压缩成少量数字。均值描述基线,RMS描述总体能量,峰峰值描述幅度范围,峭度对尖锐冲击更敏感。特征名称熟悉并不代表它一定适合当前任务。有效特征应在类别之间形成稳定差异,并在设备、温度和时间变化下保持可重复。计算量、数值稳定性和PC/MCU一致性也要进入选择。时域特征直接在采样值上计算,不需要FFT。它们适合幅值、能量、冲击和通道关系能够区分类别的任务。

316

深入浅出TinyML 14:归一化、标准化和滤波为什么必须保持一致?

模型在PC上输出正确、移植到MCU后类别混乱,最常见的根因之一是预处理不一致。缩放系数、均值方差、滤波状态、通道顺序或量化公式只要有一项不同,模型接收的张量就发生了变化。解决方法是把预处理视为模型的一部分,使用版本化参数和黄金样本,从原始数据开始逐级比较PC与MCU中间结果。模型输入前的每一步数学变换都属于模型接口。训练时减了均值,固件也必须减同一个均值。图1:PC与MCU预处理一致性应按处理阶段逐级验证。

632

深入浅出TinyML 13:原始波形和人工特征应该如何选择?

原始波形把特征学习交给模型,能够保留完整局部形状;人工特征先压缩数据,常能用更小模型完成任务。两种方案的优劣取决于数据规模、任务复杂度和MCU预算。选择输入形式时,应把预处理计算也计入系统成本。一个很小的特征模型,如果每个窗口需要昂贵FFT和大量浮点统计,整体资源未必更低。特征是从一段波形计算出的摘要,例如均值、RMS或某个频带的能量。模型可以接收波形,也可以接收这些摘要。

385

深入浅出TinyML 12:如何划分数据集并正确评价模型?

时间序列切窗后,相邻样本高度相似。把所有窗口随机打散,训练集与测试集可能来自同一设备、同一次采集甚至共享大部分数据,测试准确率会明显高估现场效果。可靠评价从划分单位开始。测试集应模拟真正的部署变化,例如新设备、新人员、新时间段或新工况;指标则根据误报与漏报成本选择。训练集用于学习,验证集用于选参数,测试集只用于最终评价。三者共享同一设备或同一连续片段时,测试结论会过于乐观。图1:时间序列项目应优先使用会话、设备或人员级分组划分。

202

深入浅出TinyML 11:标签应该如何定义和检查?

标签把传感器数据连接到业务目标。标签名称相同,并不保证标注者理解相同;“异常晃动”如果没有幅值、持续时间或现场条件说明,会在数据集中形成互相冲突的样本。标签规范应先于大规模采集完成。规范不仅列出类别名称,还要定义开始与结束、过渡段处理、未知状态、证据来源和版本。标签是模型要学习的答案。答案本身含糊时,网络只能拟合标注矛盾,增加层数不会解决定义问题。

416

深入浅出TinyML 10:窗口长度、步长和重叠率如何确定?

窗口太短可能截断一个完整事件,窗口太长会增加输入尺寸并把多个状态混在一起。步长决定多久产生一次新判断,重叠率则决定相邻样本共享多少数据。这三个参数应通过事件时间尺度、业务响应要求和MCU资源共同确定。只按模型准确率选窗口,容易得到延迟过长或推理频率过高的系统。窗口长度决定模型一次能看多长时间,步长决定多久给出一次新判断。两个参数共同决定体验和资源。

248

深入浅出TinyML 09:连续传感器数据如何变成模型样本?

传感器持续输出数据,神经网络通常要求固定形状的输入张量。工程中的关键工作是从连续流中截取时间窗口,同时保持采样间隔、通道顺序和标签时间范围一致。数据点、数据帧、样本和批次代表不同层级。混淆这些概念会造成样本数量计算错误、通道错位或训练与MCU输入形状不一致。连续传感器流没有天然的第1个样本和第2个样本。切窗规则负责把时间流转换成模型能够接收的固定形状。图1:采样点、数据帧、时间窗口和输入张量的层级关系。

398

深入浅出TinyML 08:噪声、漂移、毛刺和校准应该如何处理?

噪声、漂移和毛刺在波形上都可能表现为“数据不稳定”,处理方法却不同。低通滤波能抑制高频噪声,无法纠正缓慢零偏;减去均值可以修正偏置,却可能删除任务需要的直流成分。数据清洗的目标是修复采集链路问题,同时保留真实异常。若冲击正是待识别事件,把所有尖峰当作毛刺删除,会直接破坏标签与输入之间的关系。本篇先处理最常见的四类数据异常。每种问题的来源和处理不同,不能用一个低通滤波器包办。图1:噪声、漂移、周期干扰与真实事件的时间尺度不同。

211

深入浅出TinyML 07:采样频率如何决定模型能够看到什么?

采样频率定义了相邻数据点的时间间隔,也限制了可区分的最高频率。目标振动成分超过奈奎斯特频率时会折叠到低频,模型看到的是混叠后的伪信号。提高采样率会增加窗口点数、存储、预处理和推理负载。合理采样率应覆盖任务频段、给抗混叠滤波留出过渡带,并与模型输入和实时预算一起确定。只要会看正弦波即可完成本篇实验。频率表示每秒重复次数,采样率表示每秒记录多少个点。

252

深入浅出TinyML 06:传感器和采样链路如何决定数据上限?

模型只能处理已经进入数字数据的信息。传感器饱和后被截掉的峰值、带宽不足时被滤除的高频成分,以及安装松动造成的随机响应,都无法通过增加网络层数恢复。传感器选型应与任务频段、动态范围和现场安装共同评估。规格表提供边界,实采数据验证这些边界在目标设备上是否成立。传感器输出的数字不是物理量本身。先学会读量程和灵敏度,才能知道模型输入代表多少g、多少度每秒或多少伏。

204

深入浅出TinyML 05:TinyML模型实际识别的是什么?

模型无法直接接触振动、声音或动作。它接收的是传感器经过量程、带宽、采样、量化和预处理后形成的一组数字。模型学到的模式也只在这条数据链路定义的范围内成立。同一设备状态换一个安装位置、传感器批次或采样时钟后,数字分布可能改变。理解物理世界到输入张量的转换过程,是数据采集、模型解释和现场失效分析的共同起点。模型没有眼睛和耳朵。它只能处理按固定形状排列的数字,因此本篇从一帧数字怎样形成开始。图1:从物理现象到模型输入张量的四级数据链路。

327

深入浅出TinyML 04:如何判断一个项目是否适合使用TinyML?

摘要: TinyML项目常因输入不稳定、标签不一致或误报成本不可接受而失败。文章提出将可行性评审前移,在数据采集和训练前识别硬性阻断项(数据、标签、资源、风险、维护),通过四类检查(输入稳定性、输出量化、MCU资源、维护闭环)评估项目可行性。评审结果分为继续、试点或停止,避免无效投入。重点包括:确保传感器数据可重复区分、量化错误成本与业务指标、验证MCU资源约束、建立维护机制。提供评审脚本模板,强调硬性门槛优先,未知项必须明确标注,确保决策基于可验证证据而非盲目调参。最终目标是将模糊需求转化为可执行任务,减

238

深入浅出TinyML 03:TinyML、传统算法、边缘AI和云端AI如何分工?

技术选型应从问题和约束开始。稳定阈值能够解决的问题,使用状态机更容易验证;需要从多通道时间序列识别复杂模式时,TinyML能够在本地完成低延迟判断;大规模融合、全局优化和复杂生成任务更适合边缘服务器或云端。同一系统可以同时使用四类方法。关键是明确每一层接收什么数据、输出什么结论、失败时由谁接管,以及通信中断后系统是否仍能保持安全状态。本篇不要求你在四种方案中只选一个。工程系统经常把它们串成一条从保护到分析的决策链。图1:传统规则、TinyML、边缘节点与云端的分层协作。

394

深入浅出TinyML 02:MCU运行神经网络与运行普通C算法有什么不同?

本文对比了传统C算法与神经网络在MCU实现上的核心差异。神经网络将主要计算逻辑存储在模型图中,通过运行时解析计算图并调用内核完成推理,这带来了调试方法、内存管理和版本控制的新挑战。文章详细介绍了如何通过逐层检查张量、权重和中间结果进行调试,并提供了一个手工执行两层神经网络的Python示例,帮助理解神经网络作为数组运算的本质。最后强调在安全关键系统中,应将神经网络输出与传统确定性规则相结合,并保持模型与类别索引表的版本一致性。

227

深入浅出TinyML 01:TinyML到底小在哪里?

一个只有几十 KB 的模型,放进 MCU 工程后可能需要更多 Flash;运行时还会申请 Tensor Arena、输入缓冲区和算子工作区。只报模型文件大小,无法回答它能否稳定运行。TinyML 中的“小”是一组同时成立的约束:程序放得下、峰值内存不越界、推理在截止时间前结束、平均能量满足供电条件,并且硬件成本能够接受。本文给出一张可以直接用于项目评审的资源账单。只需要知道Flash用于掉电保存、RAM用于运行时读写即可。文中的参数量、MACC和张量会从零解释。

348

单片机为什么能够运行神经网络?从 C 函数理解 AI推理

《嵌入式AI:单片机如何运行神经网络》摘要 本文揭示了单片机(MCU)运行神经网络的核心原理:将训练好的神经网络转化为固定数值计算流程。关键要点包括: 神经网络在MCU上表现为确定的C函数,输入输出均为数组,通过固定计算流程处理数据。 权重和偏置本质上是常量数组,模型推理就是按既定顺序执行乘加运算。 输入输出需严格遵循训练时的格式约束,包括长度、顺序和数值范围。 MCU部署受限于三大因素:Flash存储参数、RAM存放中间结果、算子支持情况。 工程实现需关注数据链路完整性和可靠性,而非单纯追求模型复杂度。

519

嵌入式工程师要不要学AI?为什么我建议从TinyML开始?

这里是《贺老师讲嵌入式AI》,我是《嵌入式AI:让单片机学会思考》课程主理人,专注AI在MCU上的落地实践。嵌入式工程师要不要学AI?这个问题不应该被理解成“嵌入式工程师要不要转去做算法”。真正的问题是:设备现场越来越多判断,已经很难只靠固定阈值和几条 if-else 覆盖。嵌入式工程师要补的不是身份标签,而是让设备看懂复杂信号的能力。我建议从 TinyML 开始,是因为它足够小,也足够真实。

297

不会AI的嵌入式工程师,手把手教你系统跑通第一个STM32 AI模型(多图预警,建议收藏备用)

本文详细介绍了在STM32F407VET6单片机上部署TFLite正弦波模型的完整流程。通过STM32CubeMX/IDE配置GPIO、USART1和X-CUBE-AI组件,解析量化模型的输入输出参数(scale=0.02457/zero_point=-128),使用周期调度实现每20ms推理一次。重点包括:模型量化处理(输入/输出int8转换)、内存缓冲区管理、16位串口协议设计(帧头0x7E+4路16位数据+帧尾0x7F)以及误差分析。最终通过串口将理论值、推理值和误差传输到上位机显示,验证了嵌入式AI

726

“我们老板说了,嵌入式AI就是在单片机上运行神经网络算法,没啥难度!”用这4条信息反驳他!

大家好,我是贺老师,嵌入式 AI工程师,《嵌入式AI:让单片机学会思考》课程主理人,专注AI在MCU上的落地实践。前几天有个学员来问我,说自己想系统学一下嵌入式 AI,准备回公司问问老板能不能报销。结果老板回了一句:“嵌入式AI就是在单片机上运行神经网络算法,没啥难度。出于PUA员工的目的,这种“把事情想的很简单”的话,一般会出自老板的口中。不过,【嵌入式AI就是在单片机上运行神经网络算法】这句话很适合拿出来聊一聊。

278

嵌入式AI的常见问题解答:STM32Cube_AI全流程开发60问完整资料包

大家好,我是贺老师,嵌入式 AI工程师,《嵌入式AI:让单片机学会思考》课程主理人,专注AI在MCU上的落地实践。最近根据课程中大家私信我的问题,系统的整理了一份关于STM32Cube AI 开发流程的系统资料,名字叫:《STM32Cube AI全流程开发60问》……这份资料围绕 STM32Cube.AI 的实际使用过程展开,从基础概念、环境搭建、模型准备,到代码生成、部署优化、典型应用等内容,尽量用问答和专题讲解的方式,把嵌入式 AI 落地过程中常见的问题串起来。

350
上一篇: 这款开源的STM32外设驱动库,可以直接拿来用
下一篇: 【硬件】通俗易懂的讲解晶体管(三极管和MOS管)的工作原理
端侧AI贺老师
端侧AI贺老师 济南行远智能科技有限公司 济南行远智能科技有限公司
博客等级 码龄17年 783粉丝 111原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值