


为什么抖音越刷越懂你?一文搞懂背后的点估计、MLE、梯度下降
晚上窝在沙发里刷抖音,刷着刷着发现它怎么比你还懂你——刚搜过一次猫,下一条全是猫。你有没有想过:它到底是怎么变"聪明"的?
答案藏在三个老概念里。ChatGPT 能接你的话,拆开看,训练时最核心的两件事就是:最大似然估计(猜哪个答案最可能)和梯度下降(一点点调参数),而这一切的起点就是"点估计"。这三个从一百多年前走来的数学概念,撑起了今天整个 AI。本文用抖音刷视频的例子讲透它们,公式都配通俗解释,零基础也能跟上。
📌 先说明:本文讲的是抖音、大模型背后共用的数学地基,不是抖音推荐算法的完整实现(那还要召回、排序等一整套)。地基懂了,再看那些系统才不会懵。
📑 读完你能得到:① 三个概念各是什么、彼此什么关系 → ② 硬币 MLE 怎么一步步推出来 → ③ 梯度下降为什么能"自动逼近较优点" → ④ 它们在生活中用在哪 → ⑤ 一段完整代码亲手跑一遍 → ⑥ 新手最容易踩的坑。不堆公式,能跑能懂。
一、先理清:这三个概念是什么关系?
很多人学这三个概念,学着学着就混了。其实它们是三层不同的东西,分工明确:
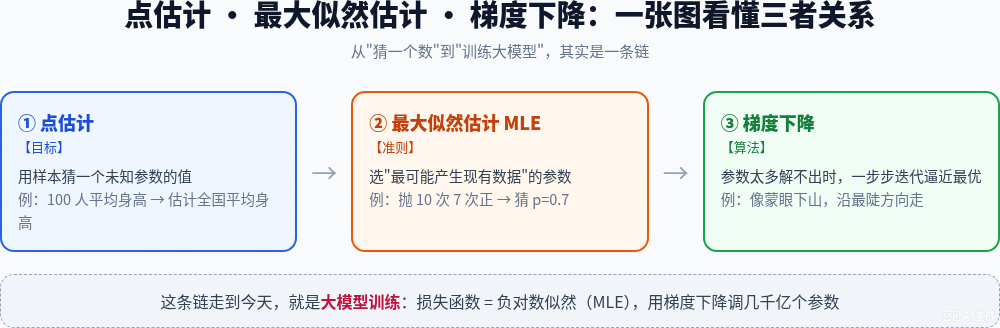
- 点估计是任务——从手里的样本,估计总体的某个未知参数
- 最大似然估计(MLE)是完成这个任务的一种方法——选"最可能产生现有数据"的那个参数(点估计还有矩估计等别的方法,MLE 只是其中最常用的一种)
- 梯度下降是一个通用优化工具——当 MLE 写不出解析解、参数又太多时,用它一步步逼近较优的点(它不专属于点估计,任何"求最小值"的问题都能用)
打个比方:点估计是"要找宝藏"这个任务,MLE 是"凭哪座山最可能有宝藏来选山"的方法,梯度下降则是"怎么一步步爬上去"的通用工具。
二、点估计:用一小撮数据,猜整体
它是干嘛的?
抖音怎么知道你喜欢猫的?它不会把你这辈子刷过的视频全看一遍,只看你最近几十条的停留、点赞,就预估出"你对猫类内容的偏好分"。这个"用一小段行为估计出一个数"的过程,思路上和点估计是相通的。
⚠️ 说严谨点:统计学里的点估计,假设总体有一个固定不变的参数;而抖音估出的"偏好分"是随时变化、实时更新的。这里只是借它说明"用样本估一个数"的思路,不是严格的统计定义。
严格的定义是:我们手里只有样本,却想知道总体的某个未知参数。用样本算出一个数来"代表"它,就叫点估计;算出来的那个数,就叫"点估计量"。
它和"区间估计"的区别:
- 点估计:给一个数 → 你对猫的偏好就是 0.8
- 区间估计:给一个范围 → 你的猫类偏好大概在 0.7~0.9(还带个"比较有把握")
它在现实中用在哪?
点估计是抽样判断的核心,到处都是:
- 抖音/推荐:只看你最近的行为,估计你的长期喜好
- 民意调查:不可能打 14 亿个电话,抽 1000 人问,估计全国支持率
- 外卖预估时间:根据这一带历史订单,估出"这单大概 40 分钟到"
它是怎么来的?
19 世纪统计学家面对"只有样本、想推总体"的问题,逐步发展出一整套估计理论,点估计就是这一切的起点。
三、最大似然估计(MLE):哪个参数最像真的?
先从一个具体例子说起:抖音下一条推什么?
你刚看完一条猫视频,抖音的"下一条"会推什么?它面前有一堆候选视频,凭什么挑那条给你?答案是:挑那个**“你最可能点开看完”**的。
这就是最大似然估计的思路——选那个"让我们看到的数据最有可能出现"的参数。
MLE 的核心一句话:在所有可能里,挑那个最像真的、最可能解释现有数据的。
为了把它算清楚,我们用最简单的抛硬币把过程推一遍(数学是通用的,抖音挑视频背后也是这个理):
抛一枚硬币,抛 10 次,7 次正面。先别往下看——如果是你,你猜这枚硬币的正面概率 p 是多少?
一起推一遍(这是严谨推导,可略读)
先给结论:p̂ = 7 ÷ 10 = 0.7。下面用数学把这个想法严格地写出来;这部分是推导过程,跳过去也不影响理解后面的内容。
把"抛 n 次、其中 k 次正面"写成数学式(C(n,k) 是"从 n 次里挑 k 次正面"的组合数,只和 n、k 有关、和 p 无关):
P = C(n,k) × p 的 k 次方 × (1-p) 的 (n-k) 次方
它的意思是:在正面概率为 p 时,"正好出现 k 次正面"这件事发生的概率。我们想找到让这个概率最大的 p。因为 C(n,k) 和 p 无关,求最大值时可以直接忽略它。
为了方便计算,通常做两步处理:先对式子取对数(不改变最大值的位置),再对 p 求导并令导数等于 0(对应曲线的最高点):
ln L = k·ln p + (n-k)·ln(1-p)        (取了对数)

对 p 求导:
d(ln L)/dp = k·(1/p) + (n-k)·(-1)/(1-p)
           = k/p - (n-k)/(1-p)        (注意第二项带个负号)

令它等于 0:
k/p = (n-k)/(1-p)
整理一下:
k(1-p) = (n-k)p → k = np → p = k/n
代入数字:p̂ = 7 ÷ 10 = 0.7。
其实就是正面次数除以总次数——和我们从这个例子得出的判断完全一致,数学只是把这个结论写得更严谨而已。
它在现实中用在哪?
"选最像的那个"这个思路,用得非常广:
- 垃圾邮件过滤:邮箱根据邮件内容,判断它"有多像垃圾邮件",像就自动进垃圾箱
- 推荐系统:你刷短视频、听歌时,App 根据你的历史行为猜你下一个最可能喜欢什么
- 大模型:根据你说的上半句话,猜下一个词最可能是什么——这就是在做最大似然估计
你天天听到的交叉熵损失函数,其实就是"负的对数似然"。所以:
大模型训练的核心 = 最小化交叉熵 ≈ 最大化似然(MLE)
(这是核心目标;真实训练还会叠加正则化、RLHF 等技巧,但地基就是它。)
四、梯度下降:解不出来时,就一步步爬
为什么需要它?
抖音的推荐模型不是一夜之间就懂你的——你每停留多看几秒、每划走一条,这些反馈都会被收进数据里,系统定期拿它们重新训练、把模型往更准的方向调一调,日子久了越来越准。这种"根据反馈一步步往好里调"的思想,就是梯度下降。
严谨说:真实系统不是你划一次就立刻重训一次(那样成本太高),而是离线批量训练、在线做实时微调;但核心思想就是"按反馈一步步调"。
硬币例子只有一个参数 p,我们能直接列方程、算出答案。但抖音推荐、大模型有几千亿个参数,似然方程虽然写得出来,却没有解析解——靠手算根本解不动。怎么办?
梯度下降:像蒙着眼下山,每一步都往当前最陡的方向迈一小步,一步步走下去,通常就能走到比较低的地方(能不能走到最低那个点,要看函数长什么样,下面会讲)。
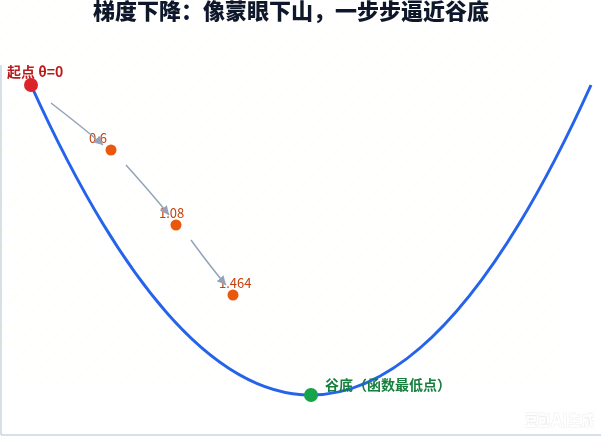
它的全部思想,其实很简单
"梯度下降"这个名字听起来有些学术,但核心思想很朴素:站在山坡上,往最陡的方向迈一小步,反复走,就会慢慢下到比较低的地方。
写成公式是这样(符号不熟悉也没关系,下面逐项解释):
新参数 = 旧参数 - 步子大小 × 坡度
- 坡度:现在站的位置,哪边往下走——专业名叫"梯度"
- 步子大小:每一步迈多远——专业名叫"学习率"(太大容易跨过谷底,太小走得慢)
- 就这么重复几千次,一步步从高处走到了低处
一个一维例子(把上面的话套进去)
求 f(θ)=(θ-3)² 的最小值——肉眼一看就知道谷底在 θ=3。用梯度下降走一遍:
- 这个函数的"坡度"是 f’(θ) = 2(θ-3)
- 从 θ=0 出发,步子大小 η=0.1:
- 第 1 步:θ = 0 - 0.1×2×(0-3) = 0.6
- 第 2 步:θ = 0.6 - 0.1×2×(0.6-3) = 1.08
- 第 3 步:θ = 1.08 - 0.1×2×(1.08-3) = 1.464
- …… 一步步越来越接近 3,和上图完全对应
这就是"迭代逼近较优点"的全过程——大模型训练,只是把这一步重复了几千亿次。
⚠️ 严谨提醒:这个 f(θ)=(θ-3)² 是个凸函数(只有一个谷底),所以梯度下降一定能走到全局最低点。但真实大模型的损失面不是凸的,到处是山峰、山谷和平台,梯度下降不保证找到全局最好的点,这也是它要仔细调学习率、用 Adam 等技巧的原因之一。
它在现实中用在哪?
梯度下降是几乎所有神经网络和大模型的"发动机"(注意:树模型如 XGBoost、随机森林不靠它,那是另一类算法):
- 训练大模型、人脸识别、医疗影像诊断模型时,都靠它一点点把参数调到较优的状态
- 抖音、淘宝的推荐模型之所以越用越懂你,背后就是它在持续优化
- 手机里的语音识别、翻译软件,训练时也是用它调参数
它和 MLE 什么关系?
- MLE 是目标(我们想达到什么效果)
- 梯度下降是手段(目标写不出直接答案时,用它一步步逼近)
两者配合:用 MLE 定出"要优化的目标",再用梯度下降一步步逼近它——大模型训练就是这个循环重复几千亿次。
五、动手跑一下(完整代码,复制就能跑)
前面都是"看",不如亲手跑一遍。下面这段代码做了两件事:先用 MLE 估计硬币正面概率,再用梯度下降找函数最低点。每行都有注释。
只需先装 numpy:
pip install numpy
import numpy as np

# ============================================
# 第一部分:最大似然估计 —— 抛硬币
# 目标:根据"10 次抛硬币、7 次正面",估计正面概率 p
# ============================================
k, n = 7, 10          # k 次正面,一共抛 n 次

# 方法A:解析解(直接套公式 p = 正面次数 / 总次数)
p_mle = k / n
print(f"[MLE] 解析解:正面概率 p = {p_mle}")

# 方法B:模拟"试一遍"——从 0.01 到 0.99 各试一次,
#         哪个 p 让"7 正 3 反"这件事最可能发生,就选它
ps = np.linspace(0.01, 0.99, 99)
likelihood = ps**k * (1 - ps)**(n - k)   # 每个 p 对应的"可能性大小"
best_p = ps[np.argmax(likelihood)]        # 挑可能性最大的那个 p
print(f"[MLE] 试遍 99 个候选,最可能的 p = {best_p:.2f}")


# ============================================
# 第二部分:梯度下降 —— 找 f(θ)=(θ-3)² 的最低点
# 目标:不解方程,靠"一步步下坡"自动找到 θ=3
# ============================================
def f(theta):
    """我们要找最低点的函数:(θ-3)²"""
    return (theta - 3) ** 2

def gradient(theta):
    """这个函数在 θ 处的"坡度"(即导数)"""
    return 2 * (theta - 3)

theta = 0.0          # 起点:从 θ=0 这个"山坡位置"开始
lr = 0.1             # 学习率:每一步迈多大
print("\n[梯度下降] 开始下坡:")
for step in range(1, 21):
    theta = theta - lr * gradient(theta)   # 往坡度的反方向迈一步
    print(f"  第{step:2d}步: θ = {theta:6.4f}, 函数值 = {f(theta):6.4f}")
实际运行结果(在我这台机器直接跑出来的,你跑结果一样):
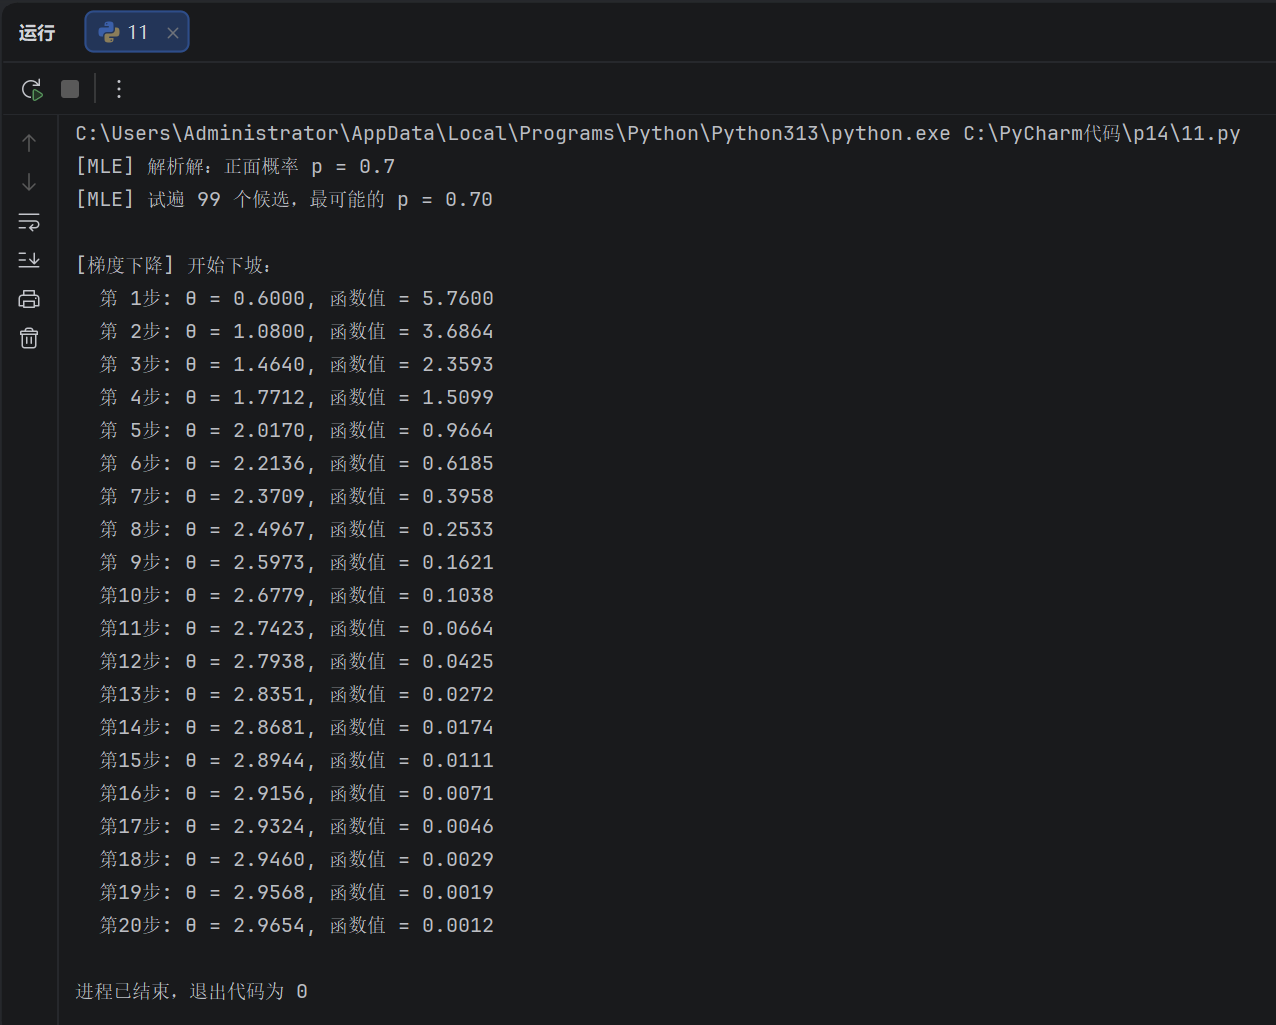
怎么读这两段结果:
- **第一部分**:解析解和"试遍 99 个候选"都指向 0.7,可以对照着看(本质是同一件事的两种做法)。
- **第二部分**:θ 从 0 一点点爬到 2.96,函数值从 5.76 降到 0.0012——这就是"自动走到较低的点"。你可以改 `lr` 亲眼看差别:改成 **0.8**,它会在 3 两边来回摆动但最终收敛;改成 **1.5**,它会越跑越远、直接发散;改成 **0.01**,它收敛得特别慢。这就是"学习率"为什么这么重要。
六、一张图:它们和你的日常有什么关系?
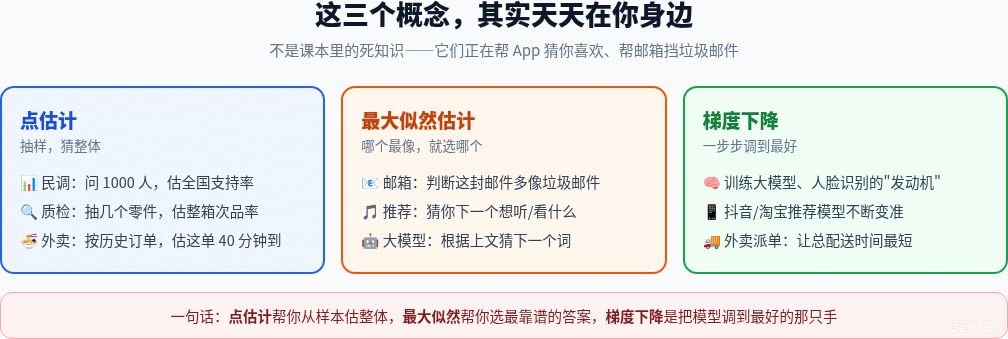
| 概念 | 现实角色 | 生活中的影子 |
|---|---|---|
| 点估计 | 抽样猜整体 | 抖音看你最近行为估偏好、民调、外卖预估 |
| 最大似然估计 | 选最像的答案 | 抖音挑下一条视频、大模型猜下一个词 |
| 梯度下降 | 一步步逼近较优点 | 抖音推荐越用越准、训练大模型 |
🧭 一句话记住:用样本做点估计,按 MLE 准则定目标,用梯度下降逼近较优的点。
七、往深走一步:进阶知识(选读)
看懂了前面的例子,再往深一层——这些是面试和进阶会遇到的点,配着例子看并不难。
1. MLE:似然和概率有啥区别?为什么非要取对数?
很多人卡在这两点,其实一句话就能分清:
- 概率:参数已知,预测"接下来会发生什么"。比如已知硬币正面概率 0.7,问"抛 10 次出 7 次正的概率"。
- 似然:数据已经发生了,反推"哪个参数最可能"。比如已经抛了 10 次出 7 次正,反推这枚硬币的 p。
同一个式子 P(数据|参数),站在参数角度看是概率,站在数据角度看就是似然。
那为什么要取对数?两个原因:
- 数值稳定:很多个小于 1 的概率连乘,结果会越来越小,小到计算机直接当 0;取对数后变成"连加",不会下溢。
- 好求导:乘积的导数很麻烦,和的导数直接逐项求,数学上干净。
2. 梯度下降:公式里为什么有个减号?大模型到底用哪种?
- 为什么是减号:梯度指的是"上升最快"的方向,而我们要把损失降到最低,所以往反方向走——这就是公式里减号的来历。
- 学习率多大合适:太大,一步跨过谷底来回震荡;太小,走到天黑。实际要调,或用自适应方法。
- 全量 vs 随机(SGD):理论上每一步都该用全部数据算梯度,但大模型数据量太大,这么算太慢。实战改成**每次随机抽一小批(mini-batch)**更新一次,这就是随机梯度下降(SGD)。
- 现代大模型用 Adam:在 SGD 基础上加了"惯性"(记得上次往哪走)和"自适应步长"(不同参数用不同步长),收敛更稳——你听到的 Adam、AdamW 都是这类。
3. 点估计:怎么判断一个估计量"好不好"?
不是随便算个数都叫合格的估计,统计上主要看三点:
- 无偏性:估计量的平均值要等于真实值。比如无数次抽样、每次估一个全国平均身高,这些估计值的均值应该正好是真实平均,不偏高也不偏低。
- 有效性:估计值要稳、波动小。同样无偏,一个今天估 170、明天估 190,另一个总在 168~172 之间,后者更有效。
- 一致性:样本越多,估计得越准——这背后就是大数定律:100 人不准,10 万人就靠谱多了。
4. 把它们串起来:偏差与方差的权衡
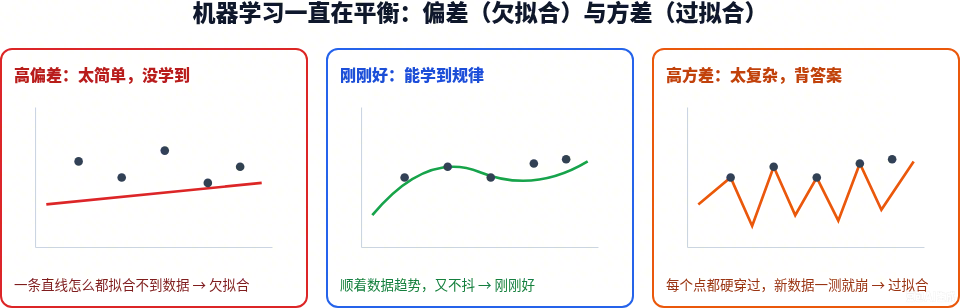
学到这,你会发现机器学习一直在平衡一件事:
- 模型太简单(比如只用一条直线)→ 拟合不足,叫高偏差,怎么练都不准
- 模型太复杂(比如一棵无限制的树)→ 把训练数据的噪音都背下来了,考试一换数据就崩,叫高方差,也就是"过拟合"
而 MLE 定目标、梯度下降调参数,本质上都是在找"刚刚好"的那个点——既学得动,又不背答案。
八、新手最容易搞混的 3 个点
写在最后,帮你避开三个常见误区:
- “最大似然"不等于"这就是真相”。它只是说:在现有数据下,这个参数最合理。抛 10 次估出 0.7,不代表这枚硬币真实概率就是 0.7——样本太少,换 1 万次,估计值可能又变成别的数,而且会越来越稳。
- 梯度下降不一定走到全局最低点。步子太大,会在一个点两边来回震荡甚至发散;函数面复杂时,它还可能卡在一个局部的小谷底,到不了全局最低——所以要调学习率,现代大模型用 Adam 这类优化器和学习率调度来帮忙。
- 点估计不是"拍脑袋猜一个数"。好的估计要无偏、稳定、样本越多越准,不是随便平均一下就算完。
九、结语
三句话带走:
- 点估计:用一小撮数据,猜整体
- 最大似然估计:选"最像真的"那个答案
- 梯度下降:解不出来时,一步步逼近较优的点
下次再看到"大模型训练",你就知道屏幕后在用梯度下降调参数、用最大似然让模型"猜最可能的下一个词"——这一切的根,就是一百多年前那道抛硬币的数学题。
你是在哪第一次碰到这三个概念的?面试、论文,还是课程?欢迎评论区聊聊,也欢迎点赞收藏方便回来照着跑代码~
注:文中推导为经典统计与优化教材内容(硬币 MLE、一维梯度下降),数值已验算;"交叉熵 = 负对数似然"为深度学习标准结论。


 扫一扫


 9627

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


