
OpenAI 悄悄重写 Agents SDK:生产级 Agent 底座来了,LangChain 们还怎么活?

Agent Runtime 正在消失:从自研沙箱到云原生基础设施 Agent runtime 不再是可选的开发组件,而是 AI 应用的底层操作系统级基础设施。其核心原理在于状态与执行解耦、凭证零接触隔离、沙箱按需生命周期管理,技术价值体现为故障域收敛、静默崩溃止血与合规可审计性提升。典型应用场景覆盖金融风控、医疗合规、SaaS 销售自动化等高可靠性要求领域,尤其在 session 管理、工具调用安全、trace 可追溯性等关键环节形成工程刚需。本文聚焦 Anthropic Managed Agents 与 AWS AgentCore 所代表的 runtime 归零趋势,解 阅读详情

很多人已经开始感觉到不对劲了。

三个月前,GPT-5.4 带着原生 computer use 登场,模型能直接操作电脑了。但开发者很快发现一个问题:模型能点能敲,可 Agent 到底跑在哪台机器上?怎么保证它不乱删文件?怎么让它跑几个小时不断线?

这些基建问题,还是得自己东拼西凑。

今晚,OpenAI 把这个缺口堵上了。

不是小修小补,是把整个 Agents SDK 从底层重写了一遍。原生 harness、原生沙盒、Codex 同款文件系统工具,外加七家沙盒厂商一键接入。

一句话:OpenAI 把 Agent 的「运行环境」和「大脑」彻底解耦,然后把基建层直接铺到了所有人脚下。

这篇文章,我们从工程视角拆三件事:

  1. 这次到底改了什么
  2. 为什么说 LangChain 们无处可躲
  3. 你现在应该怎么做

一、现象:GPT-5.4 能操作电脑了,但 Agent 没地方跑

3 月初,GPT-5.4 带着原生 computer use 发布。模型能看屏幕、移动鼠标、点击输入,跟人一样操作电脑。

开发者当时就炸了。

但炸完之后是尴尬。模型是能操作电脑了,可 Agent 跑在哪台电脑上?用自己笔记本?那跑几小时的任务怎么办?用云服务器?环境怎么配?权限怎么隔离?跑崩了从哪恢复?

这些问题,OpenAI 当时一个都没解决。

开发者只能自己拼:LangChain 管流程、Docker 管隔离、Redis 管状态、再加一堆回调脚本。一套下来,还没写业务逻辑,基建已经堆了上千行。

这不是个例。过去一年,几乎所有做长周期 Agent 的团队都在重复造同一个轮子:一个能稳定运行几小时、几天、甚至几周的 Agent 运行时。

今晚,OpenAI 把这个轮子直接塞进了 SDK。

二、本质变化:OpenAI 把「基建」和「算力」拆开了

这次升级,核心就两件事。

第一件:给 Agent 配了一个完整的运行框架——harness。

配置化记忆、感知沙盒编排、文件系统工具(Codex 同款)、通过 MCP 调外部工具、通过 skills 渐进式披露信息、通过 AGENTS.md 自定义指令、用 shell 执行代码、用 apply_patch 编辑文件。

这套清单,熟悉 Claude Code 和 Cursor 的开发者一看就懂。OpenAI 把自家 Codex 过去一年踩过的坑、积累的最佳实践,全部产品化塞进了 SDK。

第二件:把 harness 和 compute 彻底分离。

harness 跑在你的可信基建里,负责模型调用、工具路由、审批流、状态追踪、暂停恢复。

compute 是一个独立的沙盒,专门负责读写文件、跑命令、装依赖、吐产物。

两层之间接口标准化。API key 和敏感凭证压根不会进入沙盒。沙盒里既没有密钥,也没有任何敏感数据。甚至可以断开网络,零对外流量。

这不是安全加固。这是架构范式的迁移。

以前,Agent = 模型 + 提示词 + 工具调用。
现在,Agent = harness(控制流) + sandbox(执行环境) + 模型。

本质是:OpenAI 不再只卖模型推理,开始卖 Agent 的生产级运行底座。

三、核心机制拆解:harness + 沙盒 + Manifest

这次发布,技术上有三个点值得深挖。

1. Manifest:一份配置清单,解耦所有沙盒供应商

Manifest 描述 Agent 工作区的完整配置:要挂载哪些本地文件、从哪个云存储拉数据、产物写到哪里。AWS S3、GCS、Azure Blob、Cloudflare R2 全覆盖。

关键是,Manifest 和具体沙盒供应商解耦。今天用 E2B 写的 Agent,明天想换 Modal 跑,不改代码,只改一行配置。

官方给了最小示例,让一个 Agent 跑进本地沙盒,挂载财报目录,对比两年的财务指标,核心代码不到 20 行。

agent = SandboxAgent(
    name="Dataroom Analyst",
    model="gpt-5.4",
    instructions="Answer using only files in data/. Cite source filenames.",
    default_manifest=Manifest(entries={"data": LocalDir(src=dataroom)}),
)

20 行代码,完成一个能读文件、能分析、能引用来源的 Agent。以前用 LangChain 写,至少 100 行起。

2. 快照与状态恢复:掉线续命

长跑任务最怕什么?沙盒容器挂了,所有进度丢失,从头再来。

这次 SDK 原生支持快照和状态恢复。Agent 跑到一半,整个状态序列化保存。沙盒崩了,从最近检查点恢复,继续跑。

这不是 checkpoint 回调,是原生内建。

3. 多沙盒并行 + 子 Agent 隔离:分身作战

一个任务拆成十个子任务,十个子任务分别跑在十个独立沙盒里,互不干扰。每个子 Agent 有自己的隔离环境,主 Agent 负责协调和汇总。

扩展性问题,原生解决。

Agent 第一次有了「掉线续命」和「分身作战」的能力。

四、典型案例:900 页保单 100% 提取,一半 PR 来自 Agent

数字比观点更有说服力。

案例一:900 页保险理赔记录,100% 提取

FurtherAI CTO 披露,他们的 Agent 啃下了一份 900 多页的保险理赔记录,提取成功率 100%。保险业的人知道,这是业内最难啃的文档之一,以前跑到某一页崩掉是常态。

案例二:公司一半 PR 出自 Agent

Modal 技术团队成员透露,Ramp 已经用 Modal 跑了一支后台编码 Agent 大军,公司超过一半的 PR 都是这些 Agent 自己创建的。Stripe 也在今年早些时候披露,内部 AI Agent 每周产出超过 1000 个 PR。

两家公司的共同点:在拿到成熟 Agent 基建之后,业务团队的生产力出现了断层式跃迁。

案例三:代码量减少 6 倍

Tomoro AI 研发工程师给出了硬数字:相同能力的 Agent,这次需要的代码量比以前少了 6 倍。

案例四:发票对账,第一轮就跑通

Box 开发者关系负责人传了一份业务数据,配上 bash/python 作为工具,让 Agent 在沙盒里跑了一整套发票对账业务流程。第一轮试水就全跑通了。

这些案例说明一件事:以前只有头部公司才能攒出来的 Agent 基建,现在变成了 SDK 里开箱即用的默认配置。

五、工程落地启示:你的 Agent 架构该升级了

如果你现在还在用 LangChain 或自己手写 Agent 框架,这次发布应该让你重新思考三件事。

启示一:不要自己造 harness 轮子

harness 的核心是控制流、状态管理、工具路由、暂停恢复。这些逻辑非常通用,OpenAI 已经给出了官方实现。自己写的版本,大概率没有官方稳定,也没有官方迭代快。

除非你有极其特殊的编排需求,否则直接基于 OpenAI Agents SDK 往上搭业务。

启示二:沙盒选型变成配置问题

以前,选沙盒意味着改代码。换了沙盒供应商,工具调用层要重写。现在,Manifest 一层抽象,沙盒选型变成改一行配置。

建议:本地开发用 UnixLocalSandboxClient,测试用 E2B,生产环境按数据位置选 Modal 或 Runloop。哪家便宜、哪家离数据近,就切到哪家。

启示三:长跑任务必须用快照

很多人做 Agent 演示时跑几分钟没问题,一到生产跑几个小时就崩。原因是没有状态恢复能力。

新 SDK 原生支持快照,建议从第一天就把 checkpoint 机制用起来。不是等出了问题再加,是架构上就依赖它。

下面这张图概括了新的 Agent 架构:
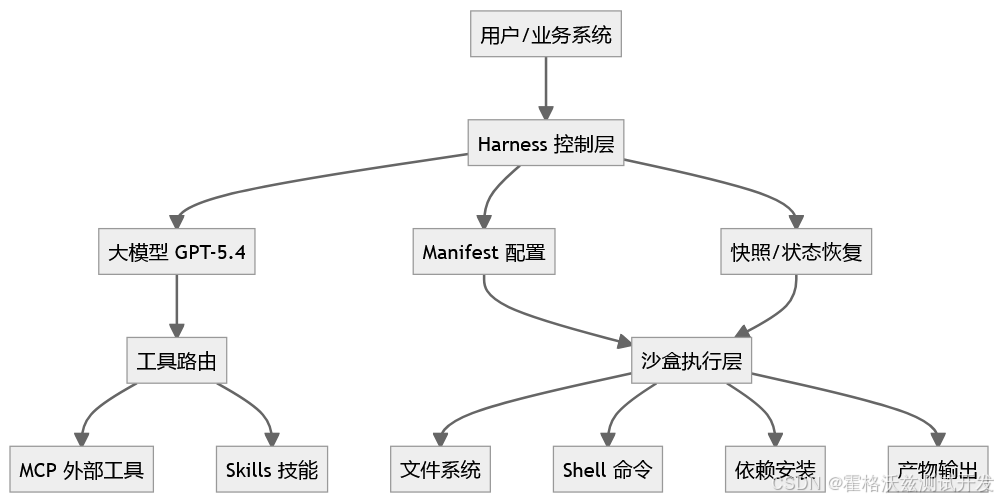
核心变化:Harness 管脑子,Sandbox 管手脚。中间用 Manifest 解耦。

六、趋势判断:第三方框架往哪走

这次发布,对 Agent 生态的冲击才刚刚显露。

LangChain、LangGraph、CrewAI、AutoGen 这些第三方框架,过去一年靠什么活着?靠补齐 OpenAI 原生 SDK 不够「生产可用」的那块空白。编排、记忆管理、护栏、追踪、多 Agent 协作,这些都是第三方的主战场。

现在,OpenAI 一次性把这些主战场全接管了。

harness 原生支持编排和暂停恢复,Manifest 原生支持工具和沙盒管理,快照原生支持状态持久化。

第三方框架的空间,被压缩到两个方向:

  • 往上走:垂直场景的 Agent 编排(比如只做客服 Agent、只做编码 Agent)
  • 往下走:专用沙盒、专用工具、专用存储

夹在中间做通用 Agent 框架的,地板已经被 OpenAI 自己踩实了。

另外,OpenAI 口中的「兼容所有沙盒服务商」,本身就是在把沙盒供应商纳入自己的生态位。今天还是合作伙伴,明天可能就是「组件供应商」。

当然,目前还不完美。新能力首发只上了 Python,TypeScript 还在排队。SDK 版本号仍然停留在 0.Y.Z。

但方向已经非常清晰了。

GPT-5.4 带着原生 computer use 登台,Agents SDK 给它配齐了真正的运行环境。下一步缺的,只是更多开发者把业务逻辑搭在这个基建之上。

LangGraph实战:用状态机图编排构建可落地的AI Agent工作流 AI Agent本质是面向任务的自动化决策系统,其核心挑战在于状态管理、错误恢复与动态流程控制。LangGraph通过有向无环图(DAG)建模,将Agent重构为显式状态机,以TypedDict定义数据契约、conditional_edge实现业务逻辑驱动的条件跳转、内置循环与检查点保障韧性执行。相比传统Chain的线性无状态模式,LangGraph让AI行为具备可追溯、可中断、可审计的工程确定性,特别适用于合同审核、工单处理、数据同步等需多步校验与人工协同的真实场景。本文聚焦LangGraph的核心机制与 阅读详情

相关推荐

Agent Runtime 归零:从上下文陷阱到事件日志驱动的工程实践

Agent 运行时(runtime)正从自建复杂层加速退化为云厂商默认提供的基础设施能力,其核心动因在于传统‘上下文即状态’范式存在根本性缺陷——上下文窗口并非存储层,而是不可靠、不可追溯、不可审计的临时缓存。Anthropic 的 Session-as-Event-Log 架构本质是将状态管理交还给成熟分布式系统(如 Pulsar 日志),通过事件溯源实现可恢复、可审计、可治理的会话生命周期。这一转变使开发者重心从 runtime 优化转向 trace store 建设、策略治理(governance)与

weixin_34218890的博客 426

用Qwen2.5+LangChain实现GPT-5级多步推理自校验

大语言模型的多步推理能力,指模型能分解复杂问题为可验证子步骤并逐层推导,其核心在于思维链(Chain-of-Thought)的结构化生成与可信度反馈机制。当前主流模型如GPT-4o虽支持基础CoT,但缺乏显式步骤标记、置信度评分和错误路径剪枝等GPT-5关键特性。技术价值在于将‘黑箱输出’转化为‘可审计、可复现、可干预’的推理过程,显著提升医疗问答、政策核查、数据计算等高可靠性场景的落地可行性。本文基于Qwen2.5-7B-Instruct的refine_step机制与LangChain Agent工具链,

weixin_34348805的博客 372

下一词预测(Next-token Prediction)深度解析:从 N-gram 到 GPT 的唯一目标函数

下一词预测(NTP)是自回归语言模型的核心训练目标,其本质为最小化交叉熵,等价于最大似然估计。通过链式法则将序列概率分解为条件分布,模型在无监督下学习语料中真实下一个 token 的高概率输出。从n-gram到Transformer,技术演进始终围绕提升上下文建模能力与并行效率。训练时利用因果掩码实现并行前向,推理则逐token采样生成。损失函数的下降揭示了规模定律下的通用智能涌现,但模型仍受限于生成能力,无法学习逻辑或常识。该目标统一了训练、评估与推理,构成大模型发展的基石。

reset2021的博客 266

AI代理运行时层正在商品化:会话即事件日志的工程实践

AI代理运行时(Agent Runtime)正从定制化组件演变为标准化基础设施,其核心在于将‘会话’抽象为可持久化、可追溯、可重放的结构化事件流,实现状态与计算分离。这一范式解决了LLM应用中长期存在的上下文溢出、静默失效、审计缺失等关键问题,技术价值体现在高可靠性、强可观测性与合规就绪性。典型应用场景包括长周期自动化任务(如IPO尽调)、金融风控审批、销售线索分级等需多工具协同与法律留痕的业务。随着AWS Bedrock AgentCore、Anthropic Managed Agents及开源方案(如D

weixin_34280237的博客 540

存储&AI行业每日要闻(2026-10-25

影响:这是市场对"烧钱就能赢"叙事的一次集体重估——Meta 主动设 C 类股稀释投票权也要融资,SpaceX 单季资本开支逼近营收 1.35 倍,叠加前一日博通 600 亿/SpaceX 400 亿芯片抵押融资,AI 基建已进入"股权+债务双管抽血"阶段;若指引保守,则昨日费半暴跌的余波将继续发酵。影响:DSX POD 的本质是把 AI 基建从"定制工程"变成"集装箱产品"——这与前一日"芯片抵押融资 5000 亿框架"形成闭环:英伟达不仅卖 GPU,还帮客户解决融资、集成、电力等全链条问题;

惠惠软件 67

第33章 YOLO+OpenCV:视频流网络传输

本案例演示用视觉处理库连接网络视频流并逐帧显示画面。程序先打开流地址,再循环取帧、显示、等待按键退出,并用重试计数应对连接失败与读取中断。验证时关注窗口能否稳定出画、是否长时间卡顿黑屏、退出后终端有无报错。🌈

小哥谈 508

AI代理运行时革命:从上下文状态到事件日志驱动的稳态执行

AI代理(Agent)本质上是具备自主决策与工具调用能力的程序化工作流,其核心挑战在于状态管理与执行可靠性。传统方案依赖大模型上下文窗口暂存历史,导致token溢出、信息丢失与不可审计等‘安静失败’;而新一代运行时(runtime)通过事件日志(event log)持久化全链路操作、无状态执行引擎(harness)保障安全隔离、微虚拟机沙箱(sandbox)实现硬件级洁净执行,构建出可追溯、可调试、可治理的稳态基础设施。该范式已成生产级Agent落地的关键底座,并正快速标准化为云平台免费能力。本文深入解析s

weixin_34034670的博客 368

OpenBCI脑电帽硬件DIY与低成本搭建实战

本文详细介绍了如何通过第三方兼容硬件和开源设计,低成本DIY一套功能完备的OpenBCI脑电采集系统。从硬件选购、组装、软件配置到信号调试,提供了完整的实战指南,将总成本控制在千元级别,使脑机接口技术对爱好者、学生和研究者变得更加触手可及。

weixin_29322855的博客 765

「大车小标」自动稽核怎么落地:识别车型与计费车型如何自动比对、争议如何排除

在高速公路货车逃费里,"大车小标"是最高频、也最难缠的一类:实际是更大车型、更多轴数的货车,却按更小车型交费,跑同样的路交更少的钱。单次差额可能不大,但放到长距离、高频次、规模化运营的路网里,累积的通行费流失相当可观。自动稽核"大车小标",核心不是"识别出这是什么车"这么简单,而是要把多个来源的车型判断和最终计费车型自动比对,并在大量正常交易里把真正可疑的少数挑出来,同时把设备误差、遮挡污染造成的误判排除掉。本文拆解这条链路的工程落地思路,全文定性,不涉及具体识别率与金额。

weixin_53898122的博客 352

ESP32之 ESP-IDF + Clion 开发环境搭建(二)—— Linux版

本文介绍了 Linux 下,使用Clion IDE 用官方 ESP-IDF 开发包进行 ESP32 开发的环境搭建

Augtons 的博客 6090

Excel数字变成了小数点+E+17?这些方法帮你解决!

本文介绍了三种解决Excel中数字变成小数点+E+17问题的方法:通过下拉箭头或右键菜单设置单元格格式为文本、使用TEXT函数将科学计数法转换为文本。这些方法各有优缺点,适用于不同的场景和需求。在实际应用中,我们可以根据具体情况选择合适的方法来解决问题。通过以上方法,我们可以轻松地从繁琐的小数点+E+17问题中解脱出来,更便捷地处理Excel中的数字。希望本文能够帮助到您,让您在使用Excel时更加得心应手!

nntxthml的博客 1238

【技术拆解】配音工具选型评估方法论:用 6 个维度给 AI 配音软件打打分

✅ 测试方案:准备一段包含括号注释、数字、中英文混排的文案导入试听,校验读音、停顿是否合理。案例参考:逗哥配音配套了文案提取、自动对轴、人声分离、声音转换等附加工具,支持 wav /mp3 /mp4 格式导出,可附带字幕与 SRT 文件,在字幕对齐、文件导出这条链路具备对应的能力,适合批量生产场景的创作者在这个维度进行自测打分。同一款配音引擎,有人评价 “自然接近真人”,也有人反馈 “AI 感很重”,核心差异往往来自使用场景:30 字以内的短口播,和 3000 字小说章节朗读,对引擎能力要求完全不一样。

zhizhizhuzhuxia的博客 146

【AI概念】迁移学习 vs. 域自适应 vs. 域泛化|定义、核心原理、数学表达、易混淆点与工程选择建议|实际案例、工程实现细节、未来研究趋势、实际应用场景

大家好,我是爱酱。本篇将会详细梳理迁移学习(Transfer Learning)、域自适应(Domain Adaptation)、域泛化(Domain Generalization)三大常被混淆的核心概念,结合数学公式、典型算法与实际应用场景,帮助你厘清它们的本质区别、联系与工程意义。 注:本文章含大量数学算式、详细例子说明及大量代码演示,大量干货,建议先收藏再慢慢观看理解。新频道发展不易,你们的每个赞、收藏跟转发都是我继续分享的动力!

AI人工智能爱酱~你的AI学习好帮手~ 2456

外贸独立站 AI 爬虫日志分析:UA 清单、状态码分布与「爬取不等于引用」

日志可反映爬虫访问路径、状态码与UA,但无法证明内容是否被AI引用。需按UA、状态码、路径三层分析,识别可达性问题,避免误判“抓取=引用”。应结合实测验证引用效果,警惕日志误导。关键结论:抓取≠收录≠引用,技术优化仅解决可抓取性,不保证被引用。

mqhgeo的博客 343

FFmpeg + OBS 低延迟直播串流实战:从H264裸流到RTP组播的完整配置

本文详细介绍了如何利用FFmpeg将H264裸流转码为RTP协议,并通过组播技术实现与OBS客户端的超低延迟直播串流。文章深入剖析了FFmpeg关键参数调优、SDP文件生成与配置,以及OBS客户端的无缝拉流方法,为需要毫秒级实时交互的场景提供了一套去中心化、高效稳定的完整解决方案。

fanta的博客 820

SAP 替代关系完全替代简介

这里产生了成品物料的计划订单,我们查看计划订单中BOM的变化,如下图可以看到物料的需求仍然落在了优先级为1的这个302300005555这个物料上面,并没有考虑到302300006666的这个库存,和我们理解的MRP的完全替代不一样,按我们的理解需求应该是要落在302300006666这个物料料,但是MRP计算后并没有这样进行分配。最近用户在对长周期物料进行备料的时候又提出替代料的问题,主料库存不足的时候需要考虑替代料的在途库存,经常会忘了SAP标准的替代料逻辑,这次一次性把这个逻辑写清楚。

我小时候很黑的博客 1710

把GeoReady九维当工程项做:储能管理官网的AI就绪度改造笔记

GeoReady把1900多个网站的审计数据摊开,做成实时基准(State of GEO):AI搜索就绪度平均56.7/100,中位数59,一半以上卡在地基档。这篇用工程视角拆解这份基准:九维权重分别对应哪些工程项(robots.txt放行AI爬虫、llms.txt部署、Schema JSON-LD注入、Meta标签规范化、品牌实体清晰),哪些是「白给的分」,以及怎么把就绪度检查纳入CI流水线。先说结论——56.7分测的是机器可读性,是卫生指标不是排名;工程上先补最便宜的两块(llms.txt+JSON-L

RoseMarketing的博客 250

【即插即用模块】注意力篇 | MICCAI 2023 | MFE:多尺度特征提取,告别固定感受野,猛涨2个点!

本文提出一种用于低分辨率乳腺癌病理图像超分辨率与分类的网络SHISRCNet。针对现有方法处理低分辨率图像效果差、感受野固定等问题,设计了多特征提取模块(MFE),通过多速率空洞卷积覆盖全尺度感受野(局部到全局),结合递进残差连接和动态权重融合机制,实现自适应多尺度特征增强。实验表明,该模块在超分辨率任务中PSNR提升近2个点,分类准确率显著提高。代码提供详细注释,支持即插即用,适用于各类多尺度视觉任务。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 199

LDR6100 智能遥控器精品软文:Type-C 充电口与低功耗量产维护

当 USB-C 接口从单纯的结构升级,变成整机供电稳定性、待机续航、量产一致性的核心瓶颈,智能遥控器、语音遥控器、手持控制器这类小型手持设备的硬件开发,早已不再是 “换一个 Type-C 座子” 那么简单。大量项目在试产阶段反复踩坑:不同品牌适配器识别失败、热插拔瞬间掉电死机、整机休眠待机电流超标导致电池续航缩水、产线测试时端口状态无法捕捉、兼容性参差不齐。乐得瑞 LDR6100 作为单路 USB-C/PD 专用控制芯片,专为小体积手持设备的 Type-C 供电入口量身打造。

LDR006的博客 406

国密SSL通信的调试技巧

前面写了几篇国密开发相关的文章:解读国密非对称加密算法SM2啥?双证书?详解国密SM2的加密和解密详解国密SSL ECC_SM4_SM3套件详解国密SM2的数字签名这篇文章来聊一聊国密S...

云水木石 3201

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

什么是AI、模型和token、vibecoding介绍、ClaudeCode环境搭建

AI是用计算机模拟人类思维与行为的技术,不具意识,仅作为能力放大器。模型是其核心,参数量决定智能水平,大模型历经文本、多模态到全模态演进。大模型按任务表现排名,如千问、DeepSeek等。收费以token为单位,按使用量或套餐计费。Vibecoding通过自然语言生成代码,工具包括ClaudeCode、Cursor等。安装可选CLI或GUI版本,需配置Python、Git、Node及大模型账号,提升开发效率。

2501_91966873的博客 259

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Python 浏览器自动化:Selenium vs Playwright 底层原理、实现细节 + Codex 大模型为什么能自主操控浏览器登录填表

Selenium。缺点维护成本高,不适合对接 AI。Playwright,CDP+AX 语义树是核心优势。用自然语言代替硬编码选择器,让 AI 看懂网页语义,自主完成多步网页任务。传统自动化是 “人告诉程序每一步点击哪里”;AI 浏览器 Agent 是 “人告诉程序目标,AI 自己观察页面,决定点哪里,自主完成任务”。

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 323

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【论文解读】DMH-Net:用深度曼哈顿霍夫变换从全景立方图估计3D房间布局

想象一个空房间,把所有面都去掉,只剩下棱┌─────────────┐ ← 墙与天花板的交界线/│ /│/ │ / │ ← 墙与墙的交界线(竖直)│ │ │ ││ / │ /└─┘───────────┘ ← 墙与地板的交界线论文的房间线框只有三类线线类型是什么在 3D 空间中的方向墙-天花板交界线​墙顶那条边水平,在天花板平面上墙-地板交界线​墙脚那条边水平,在地板平面上墙-墙交界线​两面墙相交的竖棱竖直​为什么用线框?​ 论文给的动机很有说服力:人类感知 3D 世界时,靠的是。

拜小白的成长之路,告别小白 353

8G 显存本地部署 AI 漫剧流水线:分镜提示词版本管理、批量归档与角色提示词隔离实战教程

本文针对8G显存本地部署的AI漫剧生产中提示词混乱、版本丢失、角色画风漂移等痛点,设计并实现一套轻量化本地提示词管理系统。系统基于纯JSON文件存储,支持角色提示词隔离、分镜模板复用、项目版本快照、批量校验与导入导出,与ComfyUI流水线无缝对接,实现画风一致性与高效复现。所有功能均无需数据库,可常驻后台运行,显著提升红果短剧系列化生产的稳定性与可维护性。

2603_96706877的博客 151

纳米 AI 搜索实战应用场景指南

在数字化运营的日常工作中,我们常常面临这样的困境:海量信息扑面而来,但真正能转化为决策依据的却寥寥无几。无论是电商团队需要精准锁定潜力爆款,还是市场部门急需捕捉转瞬即逝的热点,亦或是研究人员需要在浩如烟海的文献中梳理脉络,传统的人工检索与整理方式不仅效率低下,还极易遗漏关键细节。很多时候,我们花费了数小时甚至数天去收集数据,最后却发现信息滞后、来源单一,甚至存在事实偏差,导致后续的strategy制定建立在沙滩之上。这种“信息过载”与“价值稀缺”的矛盾,正在成为制约个人与企业成长的核心瓶颈。

llhllq2015的博客 211
上一篇: 同事.Skill刷屏出圈,AI“技能蒸馏”的底层规则
下一篇: 50个 Claude Code 日常使用技巧与最佳实践
测吧软件测试开发
博客等级 码龄5年 55粉丝 351原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值