


很多人遇到ChatGPT前后矛盾,第一反应是继续补一句:
“请记住我前面说过的要求。”
短对话里这句话有时有效,长任务里却经常只是再增加一条上下文。真正的问题不是“模型突然失忆”这么简单,而是同一段对话里已经混进了旧目标、新目标、废弃草稿、未经核实的结论,以及大量“这个、上面、刚才”之类的隐含指代。
解决办法不是无限续聊,而是把对话整理成一个可以复核、可以迁移、可以重新开始的上下文包。
一、长对话为什么会越来越不稳定?
先看四种常见污染源。
1. 目标在变,但旧目标没有退出
一开始让它写科普文,中途又改成销售页,最后要求像技术文档。模型同时看到了三套方向,如果没有明确宣布哪一版作废,后续输出就可能混合三种语气。
2. 事实和草稿混在一起
“官方已经确认”“我猜应该是”“先按这个数字占位”同时出现在对话中。到后面,草稿里的临时数字很容易被当成已经确认的事实。
3. 修改要求彼此覆盖
先要求“越详细越好”,后面又说“控制在800字”,再后来只说“按上一版优化”。哪一条优先,没有被写清楚。
4. 对话里有结论,却没有证据位置
只保留“结论是什么”,没有记录来源、日期和适用范围。等模型再次组织内容时,很难判断结论是官方事实、用户提供的数据,还是上一轮生成的推测。
二、出现这些信号,就该停止续聊
- 同一个问题连续改三次,仍然回到旧写法;
- 人名、日期、产品名或版本号开始混用;
- 已明确删除的段落再次出现;
- 引用的依据无法对应到具体链接或原文件;
- 每轮提示词都在解释“我前面到底是什么意思”;
- 新任务已经与最初任务没有直接关系。
这时继续补充要求的收益很低。应该先做一次结构化整理,再决定留在原对话还是新开会话。
三、第一步:锁定当前唯一目标
不要让模型自己猜“现在最重要的是什么”。直接给它一张任务卡:
请先停止继续写正文,只整理当前任务。

当前唯一目标:
交付对象:
最终格式:
必须保留:
必须删除:
不得推断:
完成标准:
“当前唯一目标”是关键。如果某个旧要求已经失效,要明确写“以下旧要求全部作废”,而不是只给一个新方向。
例如写报告时,可以这样填:
当前唯一目标:完成一份给管理层看的月度复盘
交付对象:不熟悉技术细节的业务负责人
最终格式:1200字正文 + 1张指标表
必须保留:原始数据、同比口径、异常说明
必须删除:之前面向开发团队的实现细节
不得推断:订单来源、客户身份、因果关系
完成标准:所有数字均能回到原表核对
四、第二步:生成阶段摘要,但不要直接相信摘要
让ChatGPT总结对话很方便,但摘要本身也是模型生成内容,不能自动变成事实。正确做法是先让它按固定字段输出,再由你确认。
请把截至目前的对话整理为阶段摘要,只使用以下结构:

1. 已确认事实:逐条列出,并标注来源位置
2. 用户决定:列出最后一次有效决定
3. 已废弃内容:说明哪些旧版本不得再使用
4. 未确认事项:不得补全,不得猜测
5. 下一步:只列一个最小动作

如果找不到来源,请标记“待核验”,不要写成确定事实。
你需要重点检查三件事:
- 它有没有把自己的上一轮回答写成“用户确认”;
- 它有没有把临时示例数字写成真实数据;
- 它有没有遗漏最近一次修改要求。
确认后的摘要可以复制出来,作为后续新会话的上下文入口。
五、第三步:把事实、决定和草稿分开
长对话最实用的整理方式,不是再写一段长摘要,而是做一张证据表。
| 类型 | 内容 | 来源 | 状态 |
|---|---|---|---|
| 事实 | 官方页面当前写明的规则 | 官方链接 + 核验日期 | 已核验 |
| 用户数据 | 昨日访问量与订单量 | 用户截图/原表 | 已提供 |
| 决定 | 本次采用标题A | 用户最后一次确认 | 生效 |
| 草稿 | 转化率可能下降 | 模型推测 | 不得当事实 |
| 待办 | 核对移动端数据 | 尚无来源 | 待核验 |
这张表解决了两个问题:一是避免模型把草稿升级成事实,二是当结论变化时,能找到变化来自新证据还是仅仅换了说法。
对于需要公开发布的内容,还应检查日期、适用地区、账号方案和产品版本。可以配合这份AI工作资料事实核验清单逐项核对。GPT108是独立第三方AI会员服务平台,并非OpenAI官方网站或授权合作方;涉及产品规则时仍以官方当前页面为准。
六、第四步:把整理后的上下文放进新会话复核
什么时候应该新开会话?只要任务目标已经变化、旧草稿大量作废,或者你准备生成最终交付物,就值得新开。
新会话不要整段粘贴几万字旧记录。只提供经过确认的上下文包:
下面是已经人工核对的任务上下文。

【唯一目标】
...

【已确认事实】
...

【生效中的限制】
...

【已废弃内容】
...

【证据与文件】
...

请先复述你将遵守的3条最高优先级约束。
如果材料之间冲突,请先指出,不要直接生成最终答案。
先让它复述约束,再开始写正文。这样能在交付前发现理解偏差,而不是等生成几千字后才返工。
七、哪些情况留在原对话,哪些情况新开?
| 情况 | 建议 |
|---|---|
| 只修改一个标题或一句话 | 留在原对话 |
| 继续分析同一份文件,目标未变 | 留在原对话,但补一段阶段摘要 |
| 从“分析问题”转为“写最终方案” | 新开会话,带入确认后的上下文包 |
| 主题、受众或交付格式已经改变 | 新开会话 |
| 对话中出现多个冲突版本 | 先整理证据表,再新开会话 |
| 需要独立复核结论 | 新开会话,不提供旧结论或明确要求质疑它 |
八、一个可直接复用的“一页上下文包”
项目名称:
当前目标:
交付对象:
截止时间:

已确认事实:
-
-

有效决定:
-

禁用内容:
-

必须引用的文件或链接:
-

仍待确认:
-

输出格式与完成标准:
-
每完成一个阶段就更新这张卡,而不是把所有历史对话继续向后拖。它同时适合写文章、做研究、改方案、分析数据和整理会议材料。
九、三个最容易踩的坑
坑1:把“请记住前文”当成整理
这是提醒,不是版本管理。模型仍然要在冲突内容中判断哪条有效。
坑2:让模型总结后不人工检查
摘要可能压缩掉限定条件,也可能把推测写得更像事实。保留证据位置,比保留漂亮结论更重要。
坑3:为了保留上下文,把全部旧聊天复制到新会话
这会把旧冲突一起搬过去。迁移时只带当前目标、已确认事实、生效约束、证据和待办。
结语
ChatGPT长对话前后矛盾时,最有效的动作往往不是再写一条更长的提示词,而是暂停生成,做一次上下文治理:
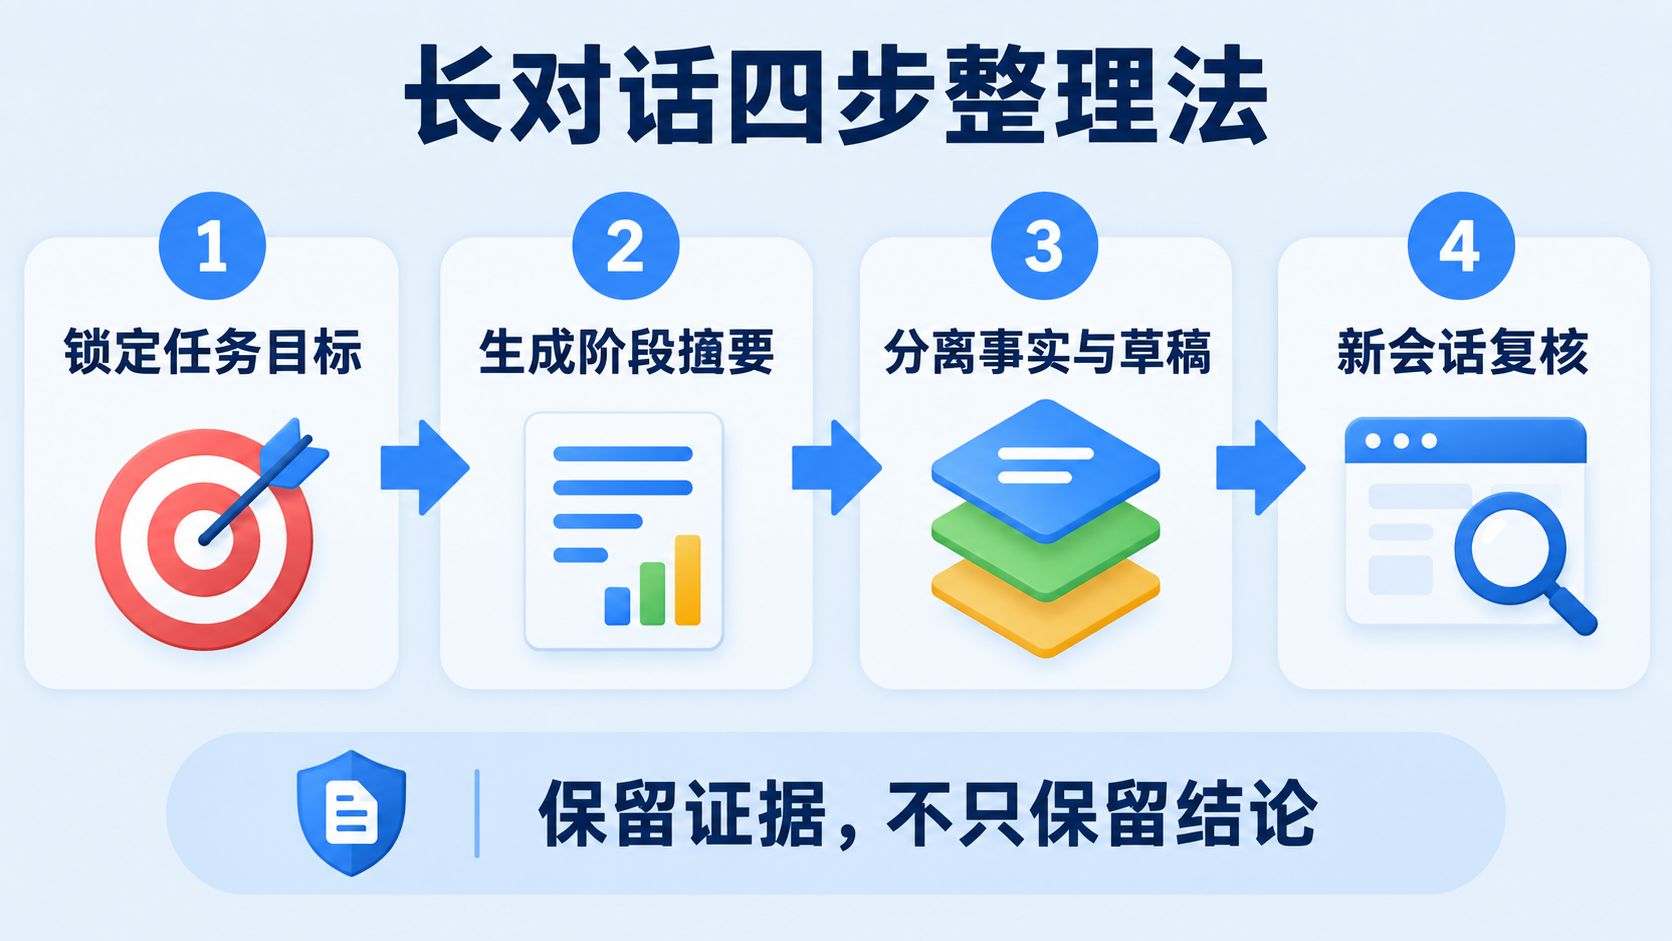
锁定目标 → 阶段摘要 → 事实与草稿分离 → 新会话复核。
长对话真正需要保存的不是所有文字,而是经过核对的事实、最后生效的决定,以及能回到原出处的证据。做到这一点,即使换会话、换模型或过几天再继续,任务也不容易失控。
参考资料
- OpenAI:ChatGPT项目与聊天组织方式
https://learn.chatgpt.com/zh-Hans/docs/projects?surface=app - OpenAI:使用ChatGPT
https://learn.chatgpt.com/zh-Hans/docs/use-chatgpt


 扫一扫


 393

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


