OddASR:基于FunASR的API封装,支持离线转写+流式转写

docker部署FunASR实时语音听写服务,纯CPU+简化官方的测试页面API docker部署FunASR实时语音听写服务,纯CPU+简化官方的测试页面 阅读详情

OddASR:基于FunASR的API封装,支持离线转写+流式转写

由于我在做的小落同学(https://x.oddmeta.net)项目需要用到ASR功能,之前针对 FunASR、FireRedAsr、Vosk等ASR项目也做了一些评测,但是总体跑下来发现还是FunASR的整体表现最好,所以我就将FunASR给封装了一下,做了一个OddAsr的项目。

而考虑到ASR功能的用途广泛,之前也有一些朋友私下问过我相关的一些使用和封装的问题,尤其是流式ASR的支持(github上有好多FunASR的API封装,但是全是离线文件转写的,没有一个同时支持离线文件转写和流式转写的API封装项目),想了一下干脆直接把它开源出来吧。希望对有ASR需求的同学有帮助。

项目地址: https://github.com/oddmeta/oddasr
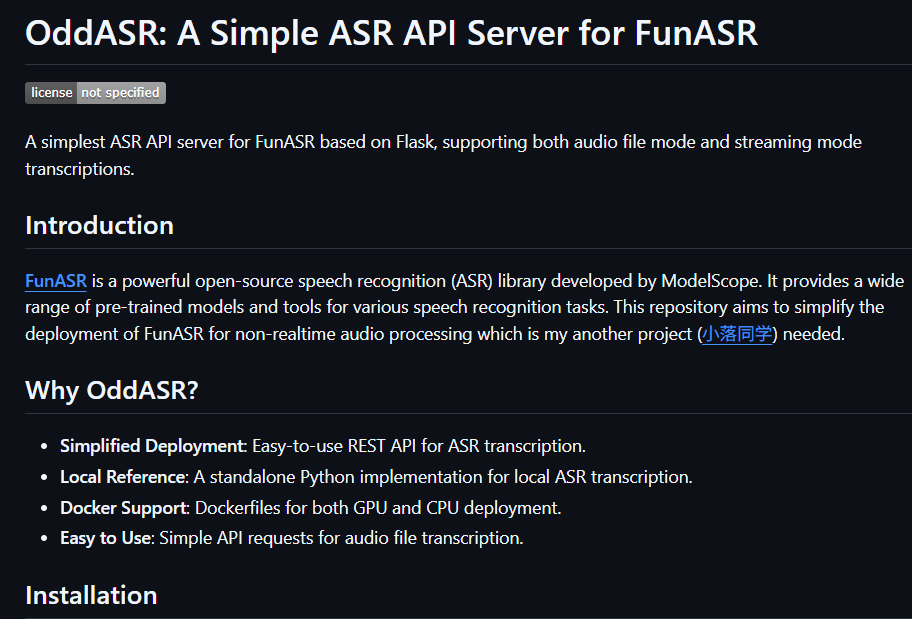
在这里插入图片描述

之前关于ASR相关的一些测试

ASR引擎测试:FireRedASR只能说小红书的诚意不够
ASR引擎测试:FunASR,必须给阿里点一个赞
可能是最紧凑、最轻量级的ASR模型:Vosk实战解析

项目简介

OddASR是一个简单的ASR API服务器,基于强大的开源语音识别库FunASR构建。FunASR由ModelScope开发,提供了丰富的预训练模型和工具,可用于各种语音识别任务。
OddASR的目标是简化FunASR的部署,满足非实时音频处理的需求,同时也为实时流式转写提供了支持。

项目具有以下特点:

  • 简化部署:提供易于使用的REST API,方便进行ASR转录。
  • 本地参考:有独立的Python实现,可在本地进行ASR转录。
  • Docker支持:提供GPU和CPU部署的Dockerfile,简化服务器部署。
  • 易于使用:通过简单的API请求即可实现音频文件转录。

安装步骤

1. 克隆仓库

git clone https://github.com/oddmeta/oddasr.git
cd oddasr

2. 安装依赖

pip install -r requirements.txt

使用方法

1. 启动REST API服务器

python main_server.py

服务器将在http://127.0.0.1:12340上启动。

2. 测试文件ASR API

使用testAPI.py脚本测试API:

python testAPI.py test_en_steve_jobs_10s.wav txt

也可以使用curl命令发送音频文件到REST API:

curl -X POST -F "audio=@path/to/audio.wav" http://127.0.0.1:12340/v1/v1/asr

3. 测试流ASR API

使用testStreamAPI.py脚本测试API:

python testStreamAPI.py 111.pcm

4. 示例输出

  • text模式
是开始这个呃实时的一个转写。 
对, 然后是转写的一个效果, 大概大概就是这个样子。 
然后的话那个在这里边你也可以去给他那个加一个人。 
比如说是嗯我随便给他取一个名字, 
就是连云端的还是自己算的连云端的吧。 
  • spk模式
发言人 0: 是开始这个呃实时的一个转写。
发言人 0: 对,
发言人 0: 然后是转写的一个效果,
发言人 0: 大概大概就是这个样子。
发言人 0: 然后的话那个在这里边你也可以去给他那个加一个人。
发言人 0: 比如说是嗯我随便给他取一个名字,
发言人 1: 就是连云端的还是自己算的连云端的吧。
发言人 0: 呃本地的本地的本地的对,
发言人 0: 不用连看能调吧。
发言人 2: 这个还有对呀,
发言人 0: 然后这里边可以给他加格。
  • srt模式
0 00:00:01,010 --> 00:00:04,865 发言人 0: 是开始这个呃实时的一个转写。 
1 00:00:06,040 --> 00:00:06,280 发言人 0: 对, 
2 00:00:06,640 --> 00:00:08,660 发言人 0: 然后是转写的一个效果, 
3 00:00:08,680 --> 00:00:10,280 发言人 0: 大概大概就是这个样子。 
4 00:00:10,280 --> 00:00:14,500 发言人 0: 然后的话那个在这里边你也可以去给他那个加一个人。 
5 00:00:14,660 --> 00:00:19,665 发言人 0: 比如说是嗯我随便给他取一个名字, 
6 00:00:20,440 --> 00:00:23,200 发言人 1: 就是连云端的还是自己算的连云端的吧。 
7 00:00:23,240 --> 00:00:25,340 发言人 0: 呃本地的本地的本地的对, 
8 00:00:25,340 --> 00:00:27,275 发言人 0: 不用连看能调吧。 
9 00:00:29,120 --> 00:00:31,480 发言人 2: 这个还有对呀, 
10 00:00:32,130 --> 00:00:33,885 发言人 0: 然后这里边可以给他加格。 

5. Docker部署

  • GPU部署
docker build -t asr-service-gpu:v0.1.0.
docker run --gpus all -d -p 12340:12340 --name asr-service asr-service-gpu:v0.1.0
  • CPU部署
docker build -f Dockerfile_CPU -t asr-service-cpu:v0.1.0.
docker run -d -p 12340:12340 --name asr-service asr-service-cpu:v0.1.0

项目待办事项

  • 添加更多模型和功能:不断丰富模型库,提供更多实用功能。
  • 支持实时ASR:进一步优化实时流式转写的性能。
  • 添加更多自定义选项:如--mode、--output_format、--hotword等。
  • 简单UI展示:开发简单的用户界面,方便用户使用。
  • 支持声纹识别:满足特定场景下的声纹识别需求。
  • 其他增强功能:如设置并发发送线程数、支持不同格式的音频输入等。

参考资料

如果你对语音识别技术感兴趣,不妨试试OddASR。它简单易用,功能强大,能为你的语音转文字工作带来极大的便利。快来体验吧!

FunASR的本地使用及部署 funasr的本地使用流程 阅读详情

相关推荐

使用阿里funasr作为freeswitch的ASR语音识别服务

要使用unimrcp 必须先编译一个正常的unimrcpserver ,再修改里面的asr语音识别模块。

livepy的博客 6200

关于python环境下的语音转文本,whisper或funASR

对whisper和funASR这样的语音转文本的工具的使用

Elysion_Daniel的博客 6398

FunASR 框架使用;api服务搭建

参考:安装版本:funasr 1.0.191、解耦modelscope版本限制(不再需要更新版本),所有模型不再需要指定model_revision,自动下载最新模型资源。2、根据模型自动安装该模型的三方依赖包,不再需要用户手动去安装了。

weixin_42357472的博客 2729

FunASR语音转文字本地部署、API接口教程

首次运行会下载模型文件,模型文件会被下载到当前电脑用户的**.cache/modelscope/hub/iic**文件夹中。当然,也可以手动下载模型并放到这个目录下,如果手动下载模型的话,就不需要执行这一步了。FunASR的部署可以使用Docker,有关Docker的部署教程就很多了,一搜就是一大堆,我就不写了。阿里新开源的FunASR仓库(语音转文字),识别速度快,精度高。修改代码中的要识别的wav文件路径,然后运行这个test.py,我们需要的是最后的白色文本,这才是对音频文件的识别结果。

chui_yu666的博客 8810

paddlespeech asr语音转录文字;FunASR使用;sherpa 实时、离线、rtsp流语音转录

安装后运行可能会numpy相关报错;1)下载项目:git clone https://github.com/k2-fsa/sherpa-ncnn.git。参考:https://www.cnblogs.com/chenkui164/p/16296941.html。模型默认下载保存位置:C:\Users\loong.paddlespeech\models下。参考:https://github.com/k2-fsa/sherpa-ncnn。

weixin_42357472的博客 5540

quartus 13.1常见报错解决方法

在使用quartus中会遇到很多由于安装或设置不规范造成的错误。我就目前我遇到的一些错误以及我的解决方法分享给大家,这个文章将会持续更新,如果读者有遇到软件中错误无法解决的问题,也欢迎在评论区留言。 一、编译出现lience错误 在对设计的电路编译时,系统在程序运行3秒内即结束并报错,大概意思为现有的证书不支持编译。这个常见问题源自破解不成功,这里读者很有可能犯的错误是在使用破解器的时候没有区分x86(即32-bit)和x64软件破解器对应的文件夹。 如图所示有两种破解器,分别对应32位和64位的软件,大部

肥宅的博客 3万+

关于funasr模型api调用

sensevoicesmall 模型的api

ddyzqddwb的博客 963

CondaHTTPError: HTTP 404 NOT FOUND for url

用conda创建新环境时出现问题了。

qq_40713201的博客 1262

ubuntu使用whisper和funASR-语者分离-二值化

在项目里面写代码就可以了,或者复制代码里面的pyannote_whisper.utils模块代码。如果您的环境中存在CUDA,您应该安装与CUDA匹配的版本的pytorch。通过 modelscope-sdk 将模型下载到本地目录。或者通过 git lfs 将模型下载到本地目录。如果你使用使用AutoDL平台,你可以使用。或者从源码安装funASR。使用本地模型路径进行推断。

huiguo_的博客 7280

STRING数据库的蛋白质相互作用(PPI)网络分析

在转录调控相关的文献中,我们经常能够看到这样的蛋白质相互作用网络(protein protein interaction network,PPI network)。具体而言,这些相关的文献中首先通过RNA-seq、表达谱芯片或者蛋白质组分析等,找到了在不同分组样本间一系列的差异表达基因或蛋白。

weixin_43029125的博客 9444

STM32使用内部RC振荡器作为系统时钟开发项目--内晶振启动模板工程

STM32使用内部RC振荡器时,OSC32_IN,OSC32_OUT接法: 1)对于100脚或144脚的产品,OSC_IN应接地,OSC_OUT应悬空。 2)对于少于100脚的产品,有2种接法:    2.1)OSC_IN和OSC_OUT分别通过10K电阻接地。此方法可提高EMC性能。    2.2)分别重映射OSC_IN和OSC_OUT至PD0和PD1,再配置PD0和PD1为推挽输出

overflyme的博客 1万+

中文语音标注工具FunASR(语音识别)

全称(一个语音识别工具)可能大家用过whisper(openAi),它【标注英语的确很完美】,【但中文会出现标注错误】或搞了个没说的词替换上去,所以要人工核对,麻烦。FunASR作用:能【准确】识别语音,并转成【文字、标出声调】他的原理,就不讲了,俺是搞大数据的,python这东西就勉强能写个爬虫和接口,机器学习和ai相关的算法是0基础。

前方的路在刚开始 1万+

操作不能完成 (错误 0x00000709) 共享打印机无法连接解决办法

环境:windows Server 2012 + Win10 客户端 问题:使用计算机名和IP地址可以正常连接打印机,但是使用另外的A记录或CN记录无法连接,报此错误 原因:这是打印服务DNS解析的问题 故障补充:假设你的服务器电脑名称叫print01,但是你又建了一条A记录或者CNname 叫PR01,就会发现使用额外的A记录或CN记录就无法连接 故障截图: 操作不能完成 (错误...

瑞哥的博客 3万+

FunASR自动语音识别的创新平台

自动语音识别(ASR, Automatic Speech Recognition)是一种将语音信号转换为文本的技术。随着语音助手、智能家居、翻译系统等应用的兴起,ASR技术的重要性日益凸显。传统的ASR系统依赖于复杂的统计模型和大量的语音数据,但随着深度学习技术的普及,现代ASR系统已能更高效、准确地识别语音。FunASR是一个先进的自动语音识别平台,旨在为开发者和企业提供高效、便捷的语音识别解决方案。无论是实时语音转写、语音命令识别,还是大规模语音数据处理,FunASR都能提供强大的支持。

hello.reader 2605

100天精通Python(可视化篇)——第98天:Pyecharts绘制多种炫酷日历图参数说明+代码实战

一、日历图介绍 二、基础配置 1. 配置项类 2. 添加函数 3. 日期标签配置 4. 坐标系配置 三、日历图实战 1. 基础日历图 2. 日历热图

努力让自己发光,对的人才能迎着光而来 2万+

智能车图像处理0-图像处理整体框架思路

1.总体框架如上所示,具体代码请查看后续文章。2.因为参与竞赛时间是大二,所以在编程中有许多不规范的地方(如变量的命名),大家见谅。3.原创文章,请勿侵权=-=

taiyuezyh的博客 1万+

FunASR模式的API封装,支持CPU离线转写+流式转写文字

本文介绍了基于开源语音识别库FunASR构建的录音转写工具,支持离线转写和流式转写两种模式。FunASR由ModelScope开发,提供丰富的预训练模型。用户可通过Docker镜像快速部署,支持CPU环境运行,包含不区分说话人和带时间戳的区分说话人两种转写模式。作者已提供现成镜像,包含模型自动下载功能,并分享了镜像拉取和启动命令。文章还列出了FunASR和oddasr项目的参考链接。初步测试显示转写效果良好,后续计划完善流式转写功能。

qq_52421033的博客 321

SAP FICO CBS接口-银企直连付款平台功能开发说明书(包括测试样例、FS)

SAP FICO CBS接口-银企直连付款平台功能开发说明书(包括测试样例、FS)

我好像病了的博客 2445

FunASR API接口详解:Python调用工业级语音能力

在语音交互技术日益普及的今天,开发者面临三大核心挑战:如何快速集成高精度语音识别能力、如何处理复杂音频格式、如何实现低延迟的流式语音交互。FunASR(Fundamental End-to-End Speech Recognition Toolkit)作为达摩院开源的工业级语音识别工具包,通过简洁易用的Python API接口,将原本需要复杂配置的语音能力封装为可直接调用的函数,完美解决了上述痛点...

gitblog_00151的博客 1614

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

OddAsr更新:将默认模型从moonshine改回paraformer

搞来搞去,还是切回paraformer模型。如果不是因为我这个用了超过十年的老笔记本CPU不太够用,我也完全不想去折腾一些其他的轻量级的ASR模型。

OddMeta 200

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

开发者必看!Fun-ASR API接口调用入门指南

本文介绍了如何在星图GPU平台上自动化部署Fun-ASR钉钉联合通义推出的语音识别大模型语音识别系统 构建by科哥镜像,快速构建高可用语音识别服务。开发者可基于该镜像调用标准化API,实现会议录音转写、课堂语音转文字等典型场景,显著提升语音处理效率与工程落地能力。

weixin_42518334的博客 627

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

使用Qwen3-ASR-0.6B实现会议语音实时转写系统

本文介绍了如何在星图GPU平台自动化部署Qwen3-ASR-0.6B镜像,快速搭建会议语音实时转写系统。该系统能够高效地将会议语音实时转换为文字,支持多说话人识别和时间戳标注,显著提升会议记录效率与准确性,适用于远程会议、技术讨论等办公场景。

weixin_42513928的博客 32

NLP之ASR之FunASR:FunASR(端到端语音识别工具包)的简介、安装和使用方法、案例应用之详细攻略

​ NLP之ASR之FunASR:FunASR(端到端语音识别工具包)的简介、安装和使用方法、案例应用之详细攻略 目录 FunASR的简介 FunASR的安装和使用方法 FunASR的案例应用 FunASR的简介 FunASR是一个基础的端到端语音识别工具包,旨在架起语音识别学术研究和工业应用之间的桥梁。它支持工业级语音识别模型的训练和微调,方便研究人员和开发者更便捷地进行语音识别模型的研究和生产,促进语音识别生态的发展。其目标是让语音识别变得更有趣(ASR f

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 5539

Fun-ASR开发文档:API接口与二次开发指南

本文介绍了Fun-ASR语音识别大模型的API接口与二次开发指南。开发者可在星图GPU平台上自动化部署Fun-ASR钉钉联合通义推出的语音识别大模型语音识别系统 构建by科哥镜像,快速构建如智能会议纪要自动生成、客服录音转写等高效语音处理应用,实现语音到文本的精准转换与结构化信息提取。

weixin_42452924的博客 427

FunASR docker install and API

docker安装如果您已安装docker,忽略本步骤!! 通过下述命令在服务器上安装docker:curl -O https://isv-data.oss-cn-hangzhou.aliyuncs.com/ics/MaaS/ASR/shell/install_docker.shsudo bash install_docker.shdocker安装失败请参考 Docker Installation镜像启动通过下述命令拉取并启动FunASR软件包的docker镜像:sudo docker pull \ reg

hope0328的博客 1743

语音识别项目开发必备:Fun-ASR API接口调用方法探索

深入解析Fun-ASR的本地化语音识别能力,涵盖文件转写、实时流式识别、批量处理与VAD语音检测等核心API使用技巧。结合代码示例与部署建议,帮助开发者高效集成高精度中文ASR功能,满足金融、政务等场景对隐私与性能的双重需求。

weixin_42581846的博客 1840
上一篇: 快速入手最新的Gemma 3n:一个手机、平板、笔记本皆可运行的多模态文本+图像+音频的全能模型
下一篇: OddTTS:基于EdgeTTS、GPTSovits等语音生成的API封装,支持Web前端+API接口
iwgh
博客等级 码龄23年 454粉丝 55原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值