YOLOv5改进 | 注意力篇 | 添加MLCA混合局部通道注意力(轻量化注意力机制)

 一、本文介绍

本文带来的改进机制是MLCA(Mixed local channel attention)翻译来就是混合局部通道注意力,它结合了局部和全局特征以及通道和空间特征的信息,根据文章的内容来看他是一个轻量化的注意力机制,能够在增加少量参数量的情况下从而大幅度的提高检测精度(论文中是如此描述的),根据我的实验内容来看,该注意力机制确实参数量非常少,效果也算不错,而且官方的代码中提供了二次创新的思想和视频讲解非常推荐大家观看。同时在开始讲解之前推荐一下我的专栏,本专栏的内容支持(分类、检测、分割、追踪、关键点检测),专栏目前为限时折扣,欢迎大家订阅本专栏,本专栏每周更新3-5篇最新机制,更有包含我所有改进的文件和交流群提供给大家。
专栏目录:YOLOv5改进有效涨点目录 | 包含卷积、主干、检测头、注意力机制、Neck上百种创新机制

专栏回顾:YOLOv5改进专栏——持续复现各种顶会内容——内含100+创新

目录

 一、本文介绍

二、MLCA的基本框架原理

三、MLCA的核心代码

四、手把手教你添加MLCA

4.1 MLCA添加步骤

4.1.1 修改一

4.1.2 修改二

4.1.3 修改三 

4.1.4 修改四

4.2 MLCA的yaml文件和训练截图

4.2.1 MLCA的yaml版本一(推荐)

4.2.2 MLCA的yaml版本二

4.2.3 MLCA的yaml版本三

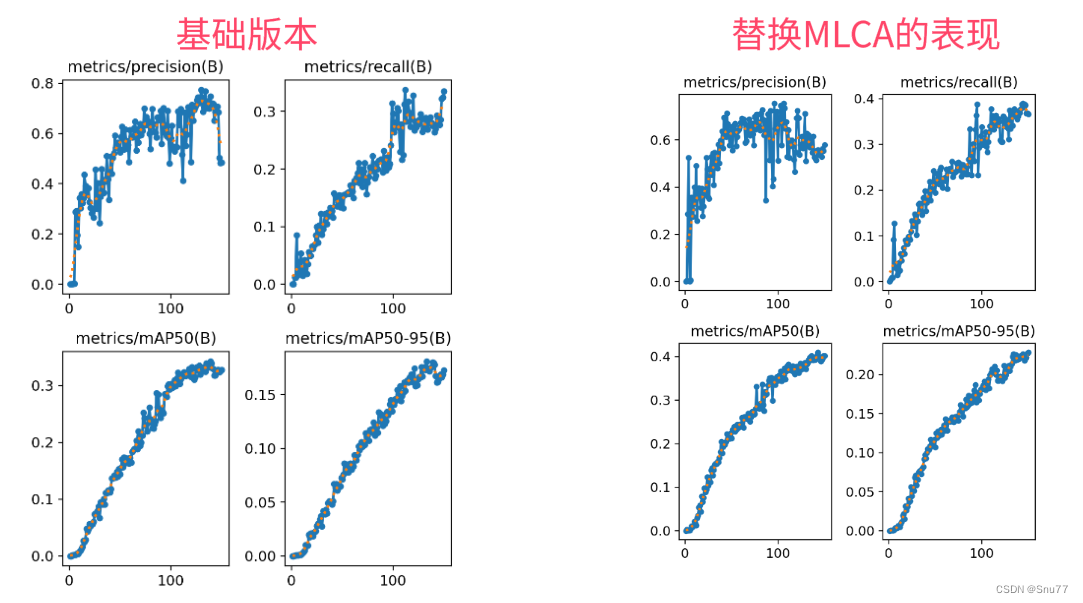
4.3 MLCA的训练过程截图 

五、本文总结


二、MLCA的基本框架原理

官方论文地址: 官方论文地址,需要注意的是该文章为非开源需要花钱下载

官方代码地址: 官方代码地址

YOLO11改进|注意力机制篇|引入MLCA轻量级注意力机制 YOLO11中添加MLCA轻量级注意力机制 阅读详情

相关推荐

YOLOv8涨点改进:轻量级的 Mixed Local Channel Attention (MLCA),加强通道信息和空间信息提取能力

一种轻量级的 Mixed Local Channel Attention (MLCA) 模块,该模块考虑通道信息和空间信息,并结合局部信息和全局信息以提高网络的表达效果

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 4268

YOLO11改进-注意力-引入混合局部通道注意力机制(MLCA)

MLCA(混合局部通道注意力)是一种轻量级的注意力机制,旨在提高目标检测网络的性能。它结合了局部和全局特征以及通道和空间特征的信息,以增强网络对有用特征的捕捉能力。具体来说,MLCA首先对输入特征图进行局部和全局平均池化,然后通过1D卷积进行特征转换。局部池化后的特征与原始输入特征相结合,全局池化后的特征则与局部池化特征相结合,最终通过反池化恢复到原始空间维度。这种方法在保持计算效率的同时,显著提高了检测精度。

qq_64693987的博客 3295

YOLOv8改进 | 注意力机制 | 添加MLCA混合局部通道注意力(轻量化注意力机制)

本文带来的改进机制是MLCA(Mixed local channel attention)翻译来就是混合局部通道注意力,它结合了局部和全局特征以及通道和空间特征的信息,根据文章的内容来看他是一个轻量化的注意力机制,能够在增加少量参数量的情况下从而大幅度的提高检测精度(论文中是如此描述的),根据我的实验内容来看,该注意力机制确实参数量非常少,效果也算不错,而且官方的代码中提供了二次创新的思想和视频讲解非常推荐大家观看。推荐指数:⭐⭐⭐⭐⭐涨点效果:⭐⭐⭐⭐⭐。

Snu77的博客 9473

YOLOv11改进 | 添加注意力机制篇 | 混合局部通道注意力MLCA二次创新C2PSA机制助力YOLOv11有效涨点

本文带来的改进机制是翻译来就是混合局部通道注意力,它结合了局部和全局特征以及通道和空间特征的信息,根据文章的内容来看他是一个轻量化的注意力机制,能够在增加少量参数量的情况下从而大幅度的提高检测精度(论文中是如此描述的),根据我的实验内容来看,该注意力机制确实参数量非常少,效果也算不错,而且官方的代码中提供了二次创新的思想和视频讲解非常推荐大家观看。YOLOv11改进系列专栏——本专栏持续复习各种顶会内容——科研必备目录一、本文介绍二、MLCA的基本框架原理三、MLCA的核心代码四、手把手教你添加MLCA。

Snu77的博客 4848

YOLOv9改进策略 | 添加注意力篇 | 添加MLCA混合局部通道注意力(轻量化注意力机制)

本文带来的改进机制是翻译来就是混合局部通道注意力,它结合了局部和全局特征以及通道和空间特征的信息,根据文章的内容来看他是一个轻量化的注意力机制,能够在增加少量参数量的情况下从而大幅度的提高检测精度(论文中是如此描述的),根据我的实验内容来看,该注意力机制确实参数量非常少,效果也算不错,而且官方的代码中提供了二次创新的思想和视频讲解非常推荐大家观看。同时在开始讲解之前推荐一下我的专栏,本专栏的内容支持(分类、检测、分割、追踪、关键点检测),专栏目前为限时折扣,

Snu77的博客 2064

YOLOv10改进 | 添加注意力篇 | 添加MLCA混合局部通道注意力(轻量化注意力机制)

本文带来的改进机制是翻译来就是混合局部通道注意力,它结合了局部和全局特征以及通道和空间特征的信息,根据文章的内容来看他是一个轻量化的注意力机制,能够在增加少量参数量的情况下从而大幅度的提高检测精度(论文中是如此描述的),根据我的实验内容来看,该注意力机制确实参数量非常少,效果也算不错,而且官方的代码中提供了二次创新的思想和视频讲解非常推荐大家观看。YOLOv10改进系列专栏——本专栏持续复习各种顶会内容——科研必备目录一、本文介绍二、MLCA的基本框架原理三、MLCA的核心代码四、手把手教你添加MLCA。

Snu77的博客 1670

YOLOv8改进有效系列目录 | 包含卷积、主干、检测头、注意力机制、Neck上百种创新机制

Hello,各位读者们好,本专栏自开设两个月以来已经更新改进教程120+余篇其中包含C2f、主干、检测头、注意力机制、Neck多种结构上创新,也有损失函数和一些细节点上的创新,订阅本专栏以后你不仅可以收获跟专栏的阅读权限,同时可以进Qq群,里面包含集成我所有创新的YOLO最新目录,和我本人录制的视频讲解教程,如果你想要在YOLOv8系列收获一篇论文,我相信订阅本专栏后你一定会有所收获~YOLOv8改进有效系列目录。

Snu77的博客 18万+

通过MLCA增强YOLOv8性能:混合局部通道注意力机制的应用与分析【YOLOv8】

YOLO(You Only Look Once)系列模型以其卓越的实时目标检测能力在计算机视觉领域取得了广泛应用。YOLOv8在之前版本的基础上进行了优化,提升了模型的精度和效率。然而,在处理复杂背景和小物体检测任务时,YOLOv8仍有提升的空间。MLCA(Mixed Local Channel Attention)混合局部通道注意力机制旨在通过结合局部区域的通道注意力来提升模型的特征表达能力。与全局通道注意力机制不同,MLCA关注于局部特征区域,以实现更精细的注意力分配。

博客 1449

YOLOv8改进:MLCA模块嵌入的轻量化注意力机制研究

MLCA是一种轻量化的注意力机制,旨在结合局部和全局特征以及通道和空间特征的信息,以增强网络对有用特征的捕捉能力。其核心思想是通过将局部空间信息融入到通道注意力机制中,同时考虑通道信息、空间信息、局部信息和全局信息,从而提高网络的表达效果。

shrgegrb的博客 1209

YOLOv12改进目录一览 | 涉及卷积层、轻量化、注意力、损失函数、Backbone、SPPF、Neck、检测头等全方位改进

1️⃣ 什么!不知道如何改进模型⁉️ 本专栏所使用并改进的每一个模块均包含详细的模块分析、原理讲解、个人总结、多种改进方式以及完整的修改流程,所有改进100%可直接运行,性价比极高。2️⃣ 找不到合适的模块⁉️ 所有改进点均为近三年顶会,顶刊提出的先进算法,将其融入到中,并进行二次创新,新颖度高,创新度高,能够适应不同的任务场景。3️⃣ 不确定自己改进的步骤、结果是否正确⁉️ 订阅专栏即可进群享受模型训练、模型改进、论文写作、投稿选刊,从入门到论文的各种答疑内容,非常适合新手。4️⃣ 团队内发表数篇SCI论

Limiiiing的博客 2万+

YOLOv11 | 注意力机制篇 | 混合局部通道注意力MLCA与C2PSA机制

性能突破:COCO mAP提升4.7%,小目标检测提升8.4%混合感知:同时捕获局部细节与全局上下文位置感知:通过C2PSA保留关键空间信息高效部署:TensorRT优化后仅损失9.6% FPS该方案特别适用于无人机航拍、自动驾驶等需要多尺度感知的场景,其模块化设计便于迁移到其他视觉任务。未来工作将聚焦于注意力机制的自动压缩和3D扩展。

weixin_39818775的博客 1066

AI:286-提升YOLOv8性能 | 集成MLCA混合局部通道注意力机制的研究与应用

YOLO(You Only Look Once)系列模型以其卓越的实时目标检测能力在计算机视觉领域取得了广泛应用。YOLOv8在之前版本的基础上进行了优化,提升了模型的精度和效率。然而,在处理复杂背景和小物体检测任务时,YOLOv8仍有提升的空间。MLCA(Mixed Local Channel Attention)混合局部通道注意力机制旨在通过结合局部区域的通道注意力来提升模型的特征表达能力。与全局通道注意力机制不同,MLCA关注于局部特征区域,以实现更精细的注意力分配。

一键难忘的博客 2546

YOLOv11缝合改进注意力机制MLCA-C2PSA:混合局部通道注意力机制(附核心代码)

YOLOv11作为当前主流高效目标检测框架之一,凭借其端到端的推理机制和优秀的推理速度,受到广泛关注。然而,在处理遮挡严重或目标密集的复杂场景时,其感受野表达能力和关键特征提取能力仍存在提升空间。为此,本文提出一种创新注意力机制——混合局部通道注意力(Mixed Local Channel Attention, MLCA),并在其基础上设计了C2PSA结构(Channel-2 Phase Selective Attention),助力YOLOv11提升精度的同时保持轻量化优势。

一键难忘的博客 909

YOLOv11 改进 - 注意力机制 | MLCA混合局部通道注意力:多维度特征融合破解信息局限,增强复杂场景感知能力

本文介绍了轻量级的Mixed Local Channel Attention(MLCA)模块及其在YOLOv11中的结合应用。MLCA模块同时考虑通道、空间、局部和全局信息,其输入特征先经局部池化,再通过两个分支分别处理全局与局部信息,最后经一维卷积、反池化融合信息。该模块能提取局部空间信息、捕获通道交互信息,并避免通道维度减少导致的精度损失。基于此模块提出的MobileNet - Attention - YOLO(MAY)算法,在Pascal VOC和SMID数据集上,相比其他注意力技术,能更好平衡模型表

魔改工程师的博客 675

YOLOv11改进目录一览 | 涉及卷积层、轻量化、注意力、损失函数、Backbone、SPPF、Neck、检测头等全方位改进

如今各种网络模型更新迭代越来越快,计算机视觉相关的文章也越来越多,多到一些普通,通用的改进点无法达到发表的要求。本专栏正是解决这个问题!如何寻找创新点?为什么要使用这个模块?如何才能提升模型的精度?这是贯穿我们研究始终的问题。创新点在这个专栏中我已经整理好了,这已经省去了大部分时间,但是当我们使用这些新的模块去优化已有的模型,如何才能提升模型的精度,才是我们要达到的最终目标。当然我们可以使用传统的A+B+C的方法去堆积模块,然后是进行大量的实验去排列组合以实现最终的精度提升,这无可厚非。

Limiiiing的博客 6万+

YOLOv8改进 - 注意力机制 | MLCA (Mixed Local Channel Attention) 混合局部通道注意力实现局部与全局特征融合

本文介绍了轻量级的Mixed Local Channel Attention (MLCA) 模块,并将其集成进YOLOv8。实时目标检测需要提高网络表达效果,MLCA模块通过局部池化、分支处理和信息融合,同时考虑通道、空间、局部和全局信息。其工作原理包括提取局部空间信息、捕获通道交互信息以及融合全局和局部信息。我们将MLCA代码集成到YOLOv8中,在tasks文件中注册,并配置yolov8-MLCAttention.yaml文件。实验证明,在Pascal VOC和SMID数据集上,该方法相比其他注意力技术

魔改工程师的博客 1070

YOLOv10改进策略【注意力机制篇】| Mixed Local Channel Attention (MLCA) 同时融合通道、空间、局部信息和全局信息的新型注意力

本文记录的是利用模块优化的目标检测网络模型。的作用在于同时包含了通道信息和空间信息,克服了常见通道注意力方法只考虑通道关系而忽略空间信息的问题。相比一些只提供全局长程信息的方法,能更好地表达网络特征。本文将其加入到的不同位置中,综合多种信息,更好地突出重要特征,从而提升模型对物体检测的表达能力。Mixed local channel attention for object detection的输入特征向量会进行两步池化。首先通过局部池化将输入转化为1∗C∗ks∗ks1*C*ks*ks1∗C∗ks∗ks的向

Limiiiing的博客 1149

城市NOA加速落地,BEV+Transformer引领自动驾驶感知新范式

数据闭环能力的建立,不仅依赖于数据规模,还依赖于数据的筛选、回传、标注、训练、验证与再部署,数据之于自动驾驶的价值再被印证的同时,也将推动自动驾驶迈向更为高阶的智能化时代。6月份,理想汽车向早鸟用户推送了首个不依赖高精地图的城市NOA。而特斯拉推出的基于BEV+Transformer的自动驾驶感知路线,可将2D图像转化为BEV鸟瞰图视角下的3D图像,并基于更庞大、更复杂、参数更多的感知算法模块,利用Transformer的注意力机制,将各个传感器统一到同一个连续的四维(三维空间+一维时间)时空中。

manfukeji的博客 1391

【keras】走近VGG16卷积神经网络

        VGG16是一个16层的卷积神经网络模型,输入数据的维度为224*224*3,即长宽均为224像素的RGB彩色图片,VGG16模型的权重由ImageNet训练而来。由于其具有简单实用的优点,因此,在图像分类和目标检测任务中得到了较为广泛的应用。 1.卷积神经网络的基本概念 1.1卷积         简单的将其理解为一种数学运算,具体的计算过程如下图所示:       ...

XYZ 1万+

运维面试常见问题

对数据库表中一列或多列的值进行排序的一种结构,使用索引可快速访问数据库表中的特定信息。优缺点:优点:利用索引可以加速对数据的检索,索引是可以唯一的,创建索引允许指定单个列或者多个列缺点:减慢了数据录入速度,同时也增加了数据库的尺寸大小。

asdmjy123的博客 1360

CODESYS无扰切换PID(ST源代码)

/运行信号//手自动切换//设置值、目标值yk : REAL;// 实际值、反馈信号;// 开环给定值;// 比例增益;// 积分时间 单位S;Td : REAL;// 微分时间 单位S;//采样时间 单位S// 滤波时间 单位S;//中断周期 默认10msEND_VARVAR_OUTPUT//uk : REAL;//控制器输出;//上一时刻的实际值;uDk : REAL;

RXXW_Dor的博客 1394

第42章:AI代码生成的质量标准——何时用AI、何时自己写

> - AI代码生成的质量分级标准:可用、稳定、安全、优雅 > - 一个决策矩阵:什么场景适合用AI,什么场景必须人工编写 > - 如何评估AI生成的代码质量(复杂度、可读性、安全性) > - 实战对比:同一需求下AI生成代码 vs 人工编写代码 > - 团队落地:将质量标准集成到Code Review和CI流程 > - 我如何将团队AI代码接受率从70%提升到90%

sfishfly的博客 156

【补充篇】三万字了解AUTOSAR软件架构(一)

主要讲解了AUTOSAR软件架构的分层及各个栈的作用

weixin_47571898的博客 1113

RK3568移植AP6256

本文主要是记录RK3568移植正基的AP6256的WIFIBT模块,感兴趣的朋友可以一起学习!!!提示:以下是本篇文章正文内容,下面案例可供参考。

qq_24093081的博客 3710

Unreal Engine开发:角色动画与状态机_动画混合:通过混合节点实现平滑动画过渡

动画混合是提升游戏动画质量的关键技术之一。Unreal Engine提供了多种混合节点,包括BlendSpace1D、Blend Two By Bool、Blend Two By Alpha和Sequencer,每种节点适用于不同的场景。通过合理使用这些节点,可以实现平滑、自然且高效的动画过渡效果。此外,遵循最佳实践和高级应用技巧,可以进一步优化动画质量和性能。希望本节内容对你在Unreal Engine中实现动画混合有所帮助,使你的游戏角色动作更加流畅和自然。

chenlz2007的博客 1238

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

上一篇: YOLOv5改进 | 细节创新篇 | iAFF迭代注意力特征融合操作助力多目标细节涨点
下一篇: YOLOv5改进 | 注意力篇 | iRMB倒置残差块注意力机制(轻量化注意力机制,附二次创新)
Snu77
Snu77 优质创作者: 人工智能技术领域 优质创作者: 人工智能技术领域
博客等级 码龄5年 11万+粉丝 934原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Snu77

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值