


开始讲解之前推荐一下我的专栏,本专栏的内容支持(分类、检测、分割、追踪、关键点检测),专栏目前为限时折扣,欢迎大家订阅本专栏,本专栏每周更新3-5篇最新机制,更有包含我所有改进的文件和交流群提供给大家。
一、本文介绍
本文给大家带来的改进内容是AKConv是一种创新的变核卷积,它旨在解决标准卷积操作中的固有缺陷(采样形状是固定的),AKConv的核心思想在于它为卷积核提供了任意数量的参数和任意采样形状,能够使用任意数量的参数(如1, 2, 3, 4, 5, 6, 7等)来提取特征,这在标准卷积和可变形卷积中并未实现。AKConv能够根据硬件环境,使卷积参数的数量呈线性增减(非常适用于轻量化模型的读者)。本文通过先介绍AKConv的基本网络结构和原理让大家对该卷积有一个大概的了解,然后教大家如何将该卷积添加到自己的网络结构中,二次创新C3k2。
目录
二、AKConv网络结构讲解
论文地址:官方论文地址
代码地址:官方代码地址
2.1 AKConv的主要思想和改进
AKConv的主要思想:AKConv(可变核卷积)主要提供一种灵活的卷积机制,允许卷积核具有任意数量的参数和采样形状。这种方法突破了传统卷积局限于固定局部窗口和固定采样形状的限制,从而使得卷积操作能够更加精准地适应不同数据集和不同位置的目标。
AKConv的改进点:
-
灵活的卷积核设计:AKConv允许卷积核具有任意数量的参数,这使得其可以根据实际需求调整大小和形状,从而更有效地适应目标的变化。
-
初始采样坐标算法:针对不同大小的卷积核,AKConv提出了一种新的算法来生成初始采样坐标,这进一步增强了其在处理各种尺寸目标时的灵活性。
-
适应性采样位置调整:为适应目标的不同变化,AKConv通过获得的偏移量调整不规则卷积核的采样位置,从而提高了特征提取的准确性。
-
减少模型参数和计算开销:AKConv支持线性增减卷积参数的数量,有助于在硬件环境中优化性能,尤其适合于轻量级模型的应用。
个人总结:总的来说,AKConv通过其创新的可变核卷积设计,为卷积神经网络带来了显著的性能提升。其能够根据不同的数据集和目标灵活调整卷积核的大小和形状,从而实现更高效的特征提取。
图片展示了AKConv结构的详细示意图,并附上我个人的过程理解:
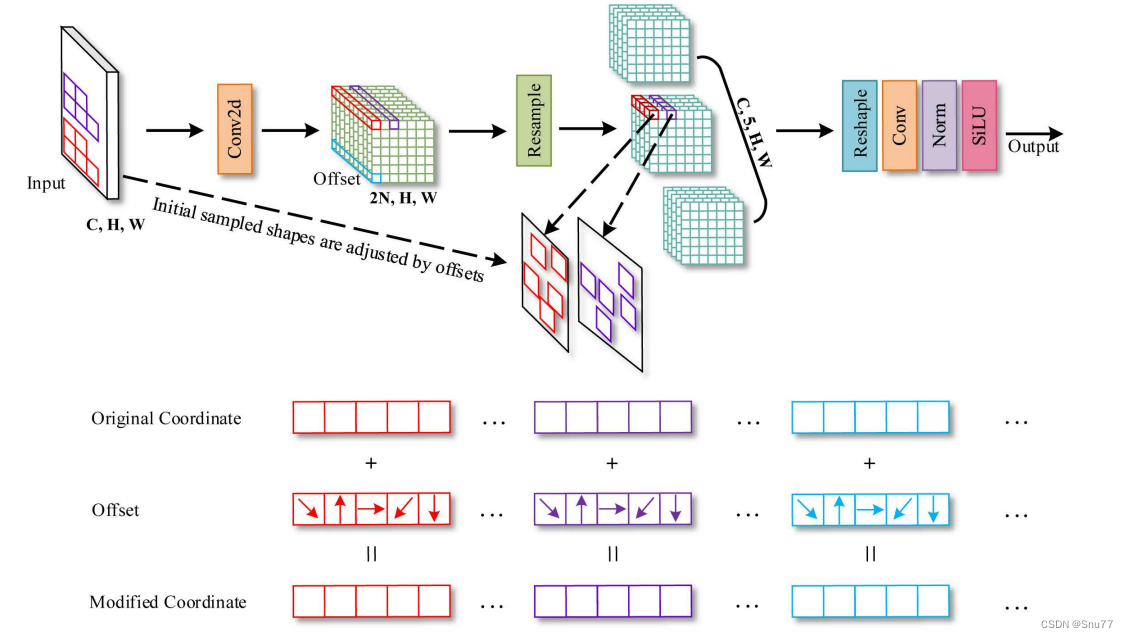
1. 输入:输入图像具有维度(C, H, W),其中C是通道数,H和W分别是图像的高度和宽度。
2. 初始采样形状:这一步是AKConv特有的,它给出了卷积核的初始采样形状。
3. 卷积操作:使用Conv2d对输入图像执行卷积操作。
4. 偏移:通过学习得到的偏移量来调整初始采样形状。这一步是AKConv的关键,允许卷积核形状动态调整以适应图像的特征。
5. 重采样:根据调整后的采样形状对特征图进行重采样。
6. 输出管道:重采样后的特征图经过重塑、再次卷积、标准化,最后通过激活函数SiLU输出最终结果。
底部的三行展示了采样坐标的变化:
- 原始坐标:显示了卷积核在没有任何偏移的情况下的初始采样位置。
- 偏移:展示了学习到的偏移量,这些偏移量将应用于原始坐标。
- 修改后的坐标:应用偏移后的采样坐标。
总结:官方这个图说明了AKConv如何为任意大小的卷积分配初始采样坐标,并通过可学习的偏移调整采样形状。与原始采样形状相比,每个位置的采样形状都通过重采样进行了改变,这使得AKConv可以根据图像内容动态调整其操作,为卷积网络提供了前所未有的灵活性和适应性。
2.1.1 灵活的卷积核设计
AKConv中的灵活卷积核设计是一种创新的机制,旨在使卷积网络更加适应性和有效率。以下是其主要原理和机制的总结:
主要原理
-
任意参数数量:传统的卷积核通常具有固定的尺寸和形状,例如3x3或5x5的方形网格。而AKConv的核心原理是允许卷积核具有任意数量的参数。这意味着卷积核不再局限于标准的方形网格,而是可以根据图像特征和任务需求,采用更多样化和灵活的形状(如下图所示,任意参数数量)。
-
自适应采样形状:在处理不同的图像和目标时,AKConv的卷积核能够自动调整其采样形状。这是通过引入一种新的坐标生成算法实现的,该算法能够为不同大小和形状的卷积核生成初始采样坐标(如下图所示,自适应采样形状)。
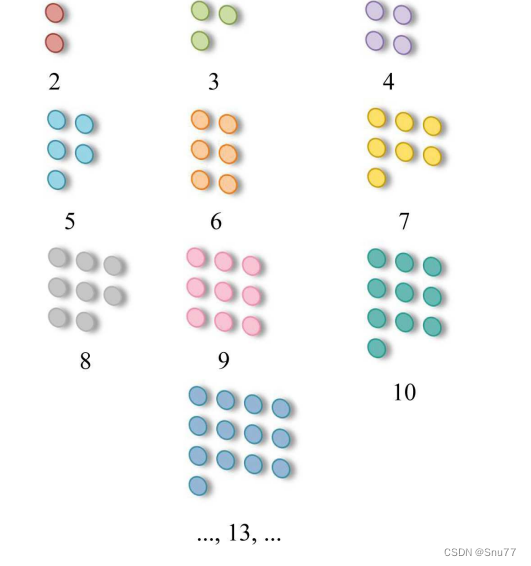
工作机制
-
初始坐标生成:AKConv首先通过其坐标生成算法确定卷积核的初始采样位置。这些位置不再是固定不变的,而是可以根据图像中的特征和目标动态变化。
-
采样位置调整:为了更好地适应图像中目标的大小和形状变化,AKConv会根据目标的特点调整卷积核的采样位置。这种调整是通过添加偏移量来实现的,使得卷积操作更加灵活和适应性强。
个人总结:通过这种灵活的设计,AKConv能够有效地适应各种大小和形状的目标,提高了特征提取的准确性和效率。它在标准卷积核基础上引入了更多的灵活性和自适应性,从而使得卷积神经网络在处理复杂和多样化的图像数据时更为高效。这种灵活的卷积核设计不仅提升了模型的性能,还为减少模型参数和计算开销提供了可能,特别是在轻量级模型的应用中显示出其优势。
2.1.2 初始采样坐标算法
AKConv中的初始采样坐标算法是其核心特征之一,这个算法为AKConv的灵活性和适应性提供了基础。以下是该算法的主要原理和机制的概述:
主要原理
-
针对多样化尺寸的适应性:传统卷积操作通常使用固定尺寸的卷积核,这限制了其在处理不同尺寸和形状目标时的效果。AKConv的初始采样坐标算法旨在解决这一问题,通过允许卷积核适应不同大小的目标,增强其灵活性和有效性。
-
动态采样坐标生成:该算法能够根据目标的尺寸和形状动态生成卷积核的初始采样坐标。这种动态生成方式使卷积核能够更精确地覆盖和处理图像中的不同区域,从而提高特征提取的精度。

工作机制
-
适应不同目标尺寸:对于每一个卷积操作,算法首先考虑目标的尺寸。基于这一信息,它生成一组初始坐标,这些坐标定义了卷积核将要采样的位置。
-
灵活的坐标调整:生成的初始坐标不是固定不变的,而是可以根据图像中的特征动态调整。这意味着卷积核可以根据图像内容的不同而改变其采样策略,从而更有效地提取特征。
个人总结:通过引入这种初始采样坐标算法,AKConv能够更灵活地处理各种尺寸的目标,无论是大尺寸还是小尺寸的目标,都能得到更准确的特征提取。
2.1.3 适应性采样位置调整
AKConv的适应性采样位置调整机制是其核心之一,该机制允许卷积核基于图像内容进行动态调整。这里是对这一机制的概述:
-
动态采样调整:传统的卷积网络使用固定形状的卷积核在图像上滑动来提取特征,这种方法忽略了图像中对象形状和尺寸的多样性。AKConv采用一种新颖的方法,它允许卷积核的形状和位置根据图像内容动态调整,更好地匹配和覆盖目标区域。
-
偏移量学习:在AKConv中,卷积核的位置可以通过学习到的偏移量来调整。在训练过程中,网络学习到对于特定图像和目标最有效的偏移量,以便在采样过程中自动调整卷积核的位置。
-
提高特征提取准确性:通过这种自适应调整,AKConv能够更准确地对齐并提取图像中的关键特征,特别是当目标的形状和大小在不同图像中有所变化时。
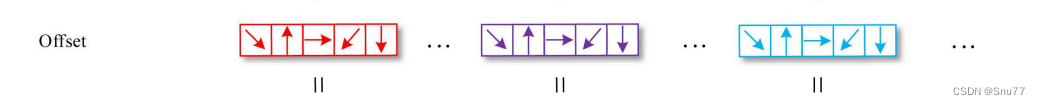
个人总结:AKConv的适应性采样位置调整为卷积网络提供了前所未有的灵活性和适应性,使其能够对各种不同形状和尺寸的目标实现更精确的特征提取。
2.1.4 线性增减卷积参数的数量
AKConv通过其独特的设计减少了模型参数和计算开销实现方式如下:
1. 线性参数调整:AKConv允许卷积核的参数数量根据需要进行线性调整。这与传统卷积网络中参数数量随着卷积核尺寸平方级增长的情况形成对比。通过支持参数数量的线性调整,AKConv能够根据任务需求和硬件能力灵活地增减模型的复杂度。
2. 优化性能:在硬件资源有限的环境中,AKConv能够通过减少不必要的参数来优化性能。这样不仅减轻了对存储和计算资源的需求,还有助于加快模型的训练和推理速度,同时降低能耗。
3. 轻量级模型设计:AKConv特别适合于轻量级模型的设计,这类模型需要在保持高性能的同时,尽可能地减少参数数量。AKConv的这一特性使其成为设计紧凑而高效模型的理想选择,特别是在移动设备、嵌入式系统和物联网设备等资源受限的平台上。
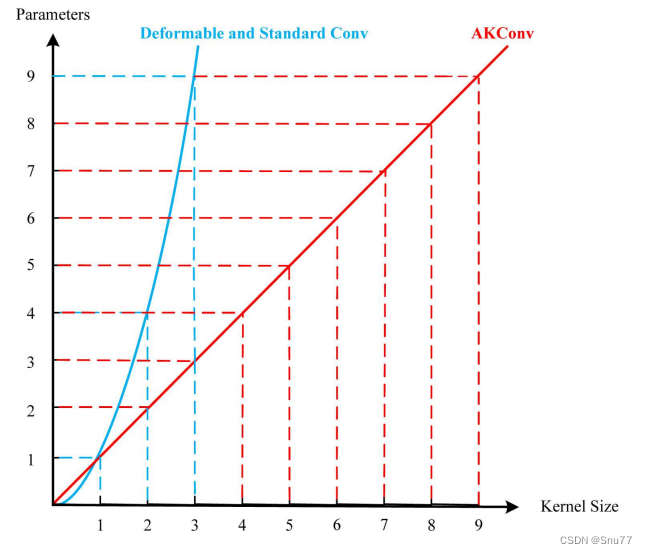
总结:AKConv通过支持卷积参数的线性增减,提供了一种在不牺牲性能的前提下,降低模型参数和计算开销的有效方法。这使得AKConv不仅在实现高精度的特征提取方面表现出色,而且在实际应用中具有显著的资源效率优势。
三、AKConv的代码
在AKConv的官方代码中有一个版本的警告我给进行了一定的处理解决了,该代码的使用方式我们看章节四进行使用。
import math
import torch
import torch.nn as nn
from einops import rearrange

__all__ = ['AKConv', 'C3k2_AKConv']

class AKConv(nn.Module):
    def __init__(self, inc, outc, num_param=2, stride=1, bias=None):
        super(AKConv, self).__init__()
        self.num_param = num_param
        self.stride = stride
        self.conv = nn.Sequential(nn.Conv2d(inc, outc, kernel_size=(num_param, 1), stride=(num_param, 1), bias=bias),
                                  nn.BatchNorm2d(outc),
                                  nn.SiLU())  # the conv adds the BN and SiLU to compare original Conv in YOLOv5.
        self.p_conv = nn.Conv2d(inc, 2 * num_param, kernel_size=3, padding=1, stride=stride)
        nn.init.constant_(self.p_conv.weight, 0)
        self.p_conv.register_full_backward_hook(self._set_lr)

    @staticmethod
    def _set_lr(module, grad_input, grad_output):
        grad_input = (grad_input[i] * 0.1 for i in range(len(grad_input)))
        grad_output = (grad_output[i] * 0.1 for i in range(len(grad_output)))

    def forward(self, x):
        # N is num_param.
        offset = self.p_conv(x)
        dtype = offset.data.type()
        N = offset.size(1) // 2
        # (b, 2N, h, w)
        p = self._get_p(offset, dtype)

        # (b, h, w, 2N)
        p = p.contiguous().permute(0, 2, 3, 1)
        q_lt = p.detach().floor()
        q_rb = q_lt + 1

        q_lt = torch.cat([torch.clamp(q_lt[..., :N], 0, x.size(2) - 1), torch.clamp(q_lt[..., N:], 0, x.size(3) - 1)],
                         dim=-1).long()
        q_rb = torch.cat([torch.clamp(q_rb[..., :N], 0, x.size(2) - 1), torch.clamp(q_rb[..., N:], 0, x.size(3) - 1)],
                         dim=-1).long()
        q_lb = torch.cat([q_lt[..., :N], q_rb[..., N:]], dim=-1)
        q_rt = torch.cat([q_rb[..., :N], q_lt[..., N:]], dim=-1)

        # clip p
        p = torch.cat([torch.clamp(p[..., :N], 0, x.size(2) - 1), torch.clamp(p[..., N:], 0, x.size(3) - 1)], dim=-1)

        # bilinear kernel (b, h, w, N)
        g_lt = (1 + (q_lt[..., :N].type_as(p) - p[..., :N])) * (1 + (q_lt[..., N:].type_as(p) - p[..., N:]))
        g_rb = (1 - (q_rb[..., :N].type_as(p) - p[..., :N])) * (1 - (q_rb[..., N:].type_as(p) - p[..., N:]))
        g_lb = (1 + (q_lb[..., :N].type_as(p) - p[..., :N])) * (1 - (q_lb[..., N:].type_as(p) - p[..., N:]))
        g_rt = (1 - (q_rt[..., :N].type_as(p) - p[..., :N])) * (1 + (q_rt[..., N:].type_as(p) - p[..., N:]))

        # resampling the features based on the modified coordinates.
        x_q_lt = self._get_x_q(x, q_lt, N)
        x_q_rb = self._get_x_q(x, q_rb, N)
        x_q_lb = self._get_x_q(x, q_lb, N)
        x_q_rt = self._get_x_q(x, q_rt, N)

        # bilinear
        x_offset = g_lt.unsqueeze(dim=1) * x_q_lt + \
                   g_rb.unsqueeze(dim=1) * x_q_rb + \
                   g_lb.unsqueeze(dim=1) * x_q_lb + \
                   g_rt.unsqueeze(dim=1) * x_q_rt

        x_offset = self._reshape_x_offset(x_offset, self.num_param)
        out = self.conv(x_offset)

        return out

    # generating the inital sampled shapes for the AKConv with different sizes.
    def _get_p_n(self, N, dtype):
        base_int = round(math.sqrt(self.num_param))
        row_number = self.num_param // base_int
        mod_number = self.num_param % base_int
        p_n_x, p_n_y = torch.meshgrid(
            torch.arange(0, row_number),
            torch.arange(0, base_int))
        p_n_x = torch.flatten(p_n_x)
        p_n_y = torch.flatten(p_n_y)
        if mod_number > 0:
            mod_p_n_x, mod_p_n_y = torch.meshgrid(
                torch.arange(row_number, row_number + 1),
                torch.arange(0, mod_number))

            mod_p_n_x = torch.flatten(mod_p_n_x)
            mod_p_n_y = torch.flatten(mod_p_n_y)
            p_n_x, p_n_y = torch.cat((p_n_x, mod_p_n_x)), torch.cat((p_n_y, mod_p_n_y))
        p_n = torch.cat([p_n_x, p_n_y], 0)
        p_n = p_n.view(1, 2 * N, 1, 1).type(dtype)
        return p_n

    # no zero-padding
    def _get_p_0(self, h, w, N, dtype):
        p_0_x, p_0_y = torch.meshgrid(
            torch.arange(0, h * self.stride, self.stride),
            torch.arange(0, w * self.stride, self.stride))

        p_0_x = torch.flatten(p_0_x).view(1, 1, h, w).repeat(1, N, 1, 1)
        p_0_y = torch.flatten(p_0_y).view(1, 1, h, w).repeat(1, N, 1, 1)
        p_0 = torch.cat([p_0_x, p_0_y], 1).type(dtype)

        return p_0

    def _get_p(self, offset, dtype):
        N, h, w = offset.size(1) // 2, offset.size(2), offset.size(3)

        # (1, 2N, 1, 1)
        p_n = self._get_p_n(N, dtype)
        # (1, 2N, h, w)
        p_0 = self._get_p_0(h, w, N, dtype)
        p = p_0 + p_n + offset
        return p

    def _get_x_q(self, x, q, N):
        b, h, w, _ = q.size()
        padded_w = x.size(3)
        c = x.size(1)
        # (b, c, h*w)
        x = x.contiguous().view(b, c, -1)

        # (b, h, w, N)
        index = q[..., :N] * padded_w + q[..., N:]  # offset_x*w + offset_y
        # (b, c, h*w*N)
        index = index.contiguous().unsqueeze(dim=1).expand(-1, c, -1, -1, -1).contiguous().view(b, c, -1)

        x_offset = x.gather(dim=-1, index=index).contiguous().view(b, c, h, w, N)

        return x_offset

    #  Stacking resampled features in the row direction.
    @staticmethod
    def _reshape_x_offset(x_offset, num_param):
        b, c, h, w, n = x_offset.size()
        # using Conv3d
        # x_offset = x_offset.permute(0,1,4,2,3), then Conv3d(c,c_out, kernel_size =(num_param,1,1),stride=(num_param,1,1),bias= False)
        # using 1 × 1 Conv
        # x_offset = x_offset.permute(0,1,4,2,3), then, x_offset.view(b,c×num_param,h,w)  finally, Conv2d(c×num_param,c_out, kernel_size =1,stride=1,bias= False)
        # using the column conv as follow, then, Conv2d(inc, outc, kernel_size=(num_param, 1), stride=(num_param, 1), bias=bias)

        x_offset = rearrange(x_offset, 'b c h w n -> b c (h n) w')
        return x_offset


class Bottleneck(nn.Module):
    # Standard bottleneck with DCN
    def __init__(self, c1, c2, shortcut=True, g=1, k=(3, 3), e=0.5):  # ch_in, ch_out, shortcut, groups, kernels, expand
        super().__init__()
        c_ = int(c2 * e)  # hidden channels

        self.cv1 = Conv(c1, c_, k[0], 1)
        self.cv2 = AKConv(c_, c2, 3)
        self.add = shortcut and c1 == c2

    def forward(self, x):
        return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x))

def autopad(k, p=None, d=1):  # kernel, padding, dilation
    """Pad to 'same' shape outputs."""
    if d > 1:
        k = d * (k - 1) + 1 if isinstance(k, int) else [d * (x - 1) + 1 for x in k]  # actual kernel-size
    if p is None:
        p = k // 2 if isinstance(k, int) else [x // 2 for x in k]  # auto-pad
    return p


class Conv(nn.Module):
    """Standard convolution with args(ch_in, ch_out, kernel, stride, padding, groups, dilation, activation)."""
    default_act = nn.SiLU()  # default activation

    def __init__(self, c1, c2, k=1, s=1, p=None, g=1, d=1, act=True):
        """Initialize Conv layer with given arguments including activation."""
        super().__init__()
        self.conv = nn.Conv2d(c1, c2, k, s, autopad(k, p, d), groups=g, dilation=d, bias=False)
        self.bn = nn.BatchNorm2d(c2)
        self.act = self.default_act if act is True else act if isinstance(act, nn.Module) else nn.Identity()

    def forward(self, x):
        """Apply convolution, batch normalization and activation to input tensor."""
        return self.act(self.bn(self.conv(x)))

    def forward_fuse(self, x):
        """Perform transposed convolution of 2D data."""
        return self.act(self.conv(x))


class C2f(nn.Module):
    """Faster Implementation of CSP Bottleneck with 2 convolutions."""

    def __init__(self, c1, c2, n=1, shortcut=False, g=1, e=0.5):
        """Initializes a CSP bottleneck with 2 convolutions and n Bottleneck blocks for faster processing."""
        super().__init__()
        self.c = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, 2 * self.c, 1, 1)
        self.cv2 = Conv((2 + n) * self.c, c2, 1)  # optional act=FReLU(c2)
        self.m = nn.ModuleList(Bottleneck(self.c, self.c, shortcut, g, k=((3, 3), (3, 3)), e=1.0) for _ in range(n))

    def forward(self, x):
        """Forward pass through C2f layer."""
        y = list(self.cv1(x).chunk(2, 1))
        y.extend(m(y[-1]) for m in self.m)
        return self.cv2(torch.cat(y, 1))

    def forward_split(self, x):
        """Forward pass using split() instead of chunk()."""
        y = list(self.cv1(x).split((self.c, self.c), 1))
        y.extend(m(y[-1]) for m in self.m)
        return self.cv2(torch.cat(y, 1))

class C3(nn.Module):
    """CSP Bottleneck with 3 convolutions."""

    def __init__(self, c1, c2, n=1, shortcut=True, g=1, e=0.5):
        """Initialize the CSP Bottleneck with given channels, number, shortcut, groups, and expansion values."""
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, 1, 1)
        self.cv2 = Conv(c1, c_, 1, 1)
        self.cv3 = Conv(2 * c_, c2, 1)  # optional act=FReLU(c2)
        self.m = nn.Sequential(*(Bottleneck(c_, c_, shortcut, g, k=((1, 1), (3, 3)), e=1.0) for _ in range(n)))

    def forward(self, x):
        """Forward pass through the CSP bottleneck with 2 convolutions."""
        return self.cv3(torch.cat((self.m(self.cv1(x)), self.cv2(x)), 1))

class C3k(C3):
    """C3k is a CSP bottleneck module with customizable kernel sizes for feature extraction in neural networks."""

    def __init__(self, c1, c2, n=1, shortcut=True, g=1, e=0.5, k=3):
        """Initializes the C3k module with specified channels, number of layers, and configurations."""
        super().__init__(c1, c2, n, shortcut, g, e)
        c_ = int(c2 * e)  # hidden channels
        # self.m = nn.Sequential(*(RepBottleneck(c_, c_, shortcut, g, k=(k, k), e=1.0) for _ in range(n)))
        self.m = nn.Sequential(*(Bottleneck(c_, c_, shortcut, g, k=(k, k), e=1.0) for _ in range(n)))

class C3k2_AKConv(C2f):
    """Faster Implementation of CSP Bottleneck with 2 convolutions."""

    def __init__(self, c1, c2, n=1, c3k=False, e=0.5, g=1, shortcut=True):
        """Initializes the C3k2 module, a faster CSP Bottleneck with 2 convolutions and optional C3k blocks."""
        super().__init__(c1, c2, n, shortcut, g, e)
        self.m = nn.ModuleList(
            C3k(self.c, self.c, 2, shortcut, g) if c3k else Bottleneck(self.c, self.c, shortcut, g) for _ in range(n)
        )


if __name__ == "__main__":
    # Generating Sample image
    image_size = (1, 64, 224, 224)
    image = torch.rand(*image_size)

    # Model
    model = C3k2_AKConv(64, 64)

    out = model(image)
    print(out.size())
四、手把手教你添加AKConv
4.1 修改一
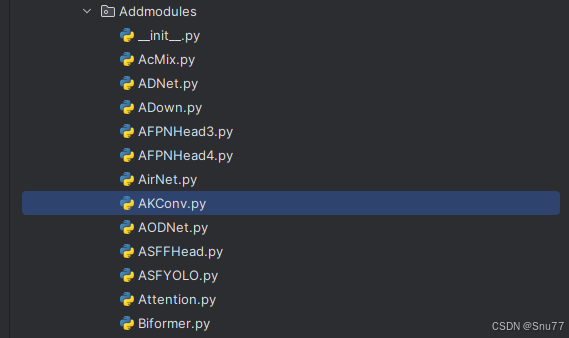
第一还是建立文件,我们找到如下ultralytics/nn文件夹下建立一个目录名字呢就是'Addmodules'文件夹(用群内的文件的话已经有了无需新建)!然后在其内部建立一个新的py文件将核心代码复制粘贴进去即可。
4.2 修改二
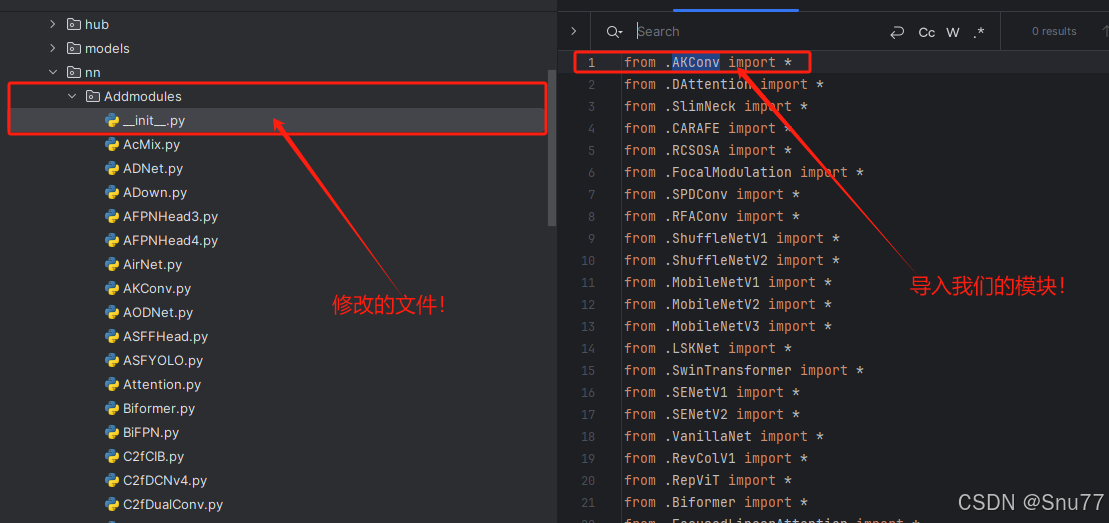
第二步我们在该目录下创建一个新的py文件名字为'__init__.py'(用群内的文件的话已经有了无需新建),然后在其内部导入我们的检测头如下图所示。
4.3 修改三
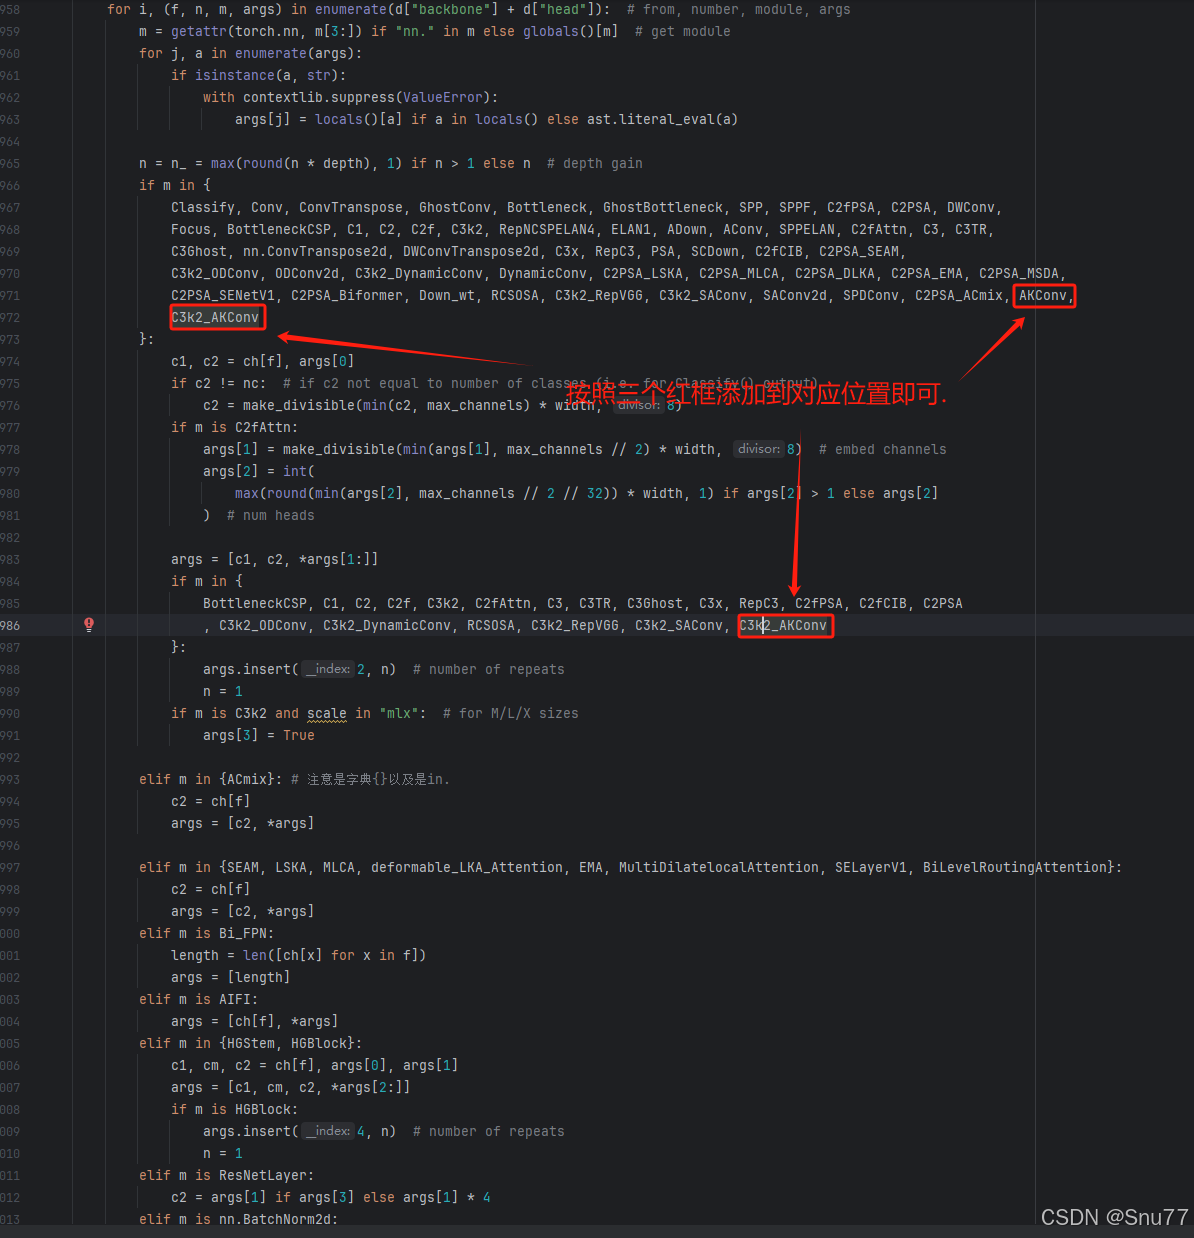
第三步我门中到如下文件'ultralytics/nn/tasks.py'进行导入和注册我们的模块(用群内的文件的话已经有了无需重新导入直接开始第四步即可)!
从今天开始以后的教程就都统一成这个样子了,因为我默认大家用了我群内的文件来进行修改!!

4.4 修改四
按照我的添加在parse_model里添加即可。
到此就修改完成了,大家可以复制下面的yaml文件运行。
4.5 AKConv的yaml文件和训练截图
4.5.1 AKConv的yaml文件1
此版本训练信息:YOLO11-C3k2-AKConv summary: 353 layers, 2,471,697 parameters, 2,471,681 gradients, 6.2 GFLOPs
# Ultralytics YOLO 🚀, AGPL-3.0 license
# YOLO11 object detection model with P3-P5 outputs. For Usage examples see https://docs.ultralytics.com/tasks/detect

# Parameters
nc: 80 # number of classes
scales: # model compound scaling constants, i.e. 'model=yolo11n.yaml' will call yolo11.yaml with scale 'n'
  # [depth, width, max_channels]
  n: [0.50, 0.25, 1024] # summary: 319 layers, 2624080 parameters, 2624064 gradients, 6.6 GFLOPs
  s: [0.50, 0.50, 1024] # summary: 319 layers, 9458752 parameters, 9458736 gradients, 21.7 GFLOPs
  m: [0.50, 1.00, 512] # summary: 409 layers, 20114688 parameters, 20114672 gradients, 68.5 GFLOPs
  l: [1.00, 1.00, 512] # summary: 631 layers, 25372160 parameters, 25372144 gradients, 87.6 GFLOPs
  x: [1.00, 1.50, 512] # summary: 631 layers, 56966176 parameters, 56966160 gradients, 196.0 GFLOPs

# YOLO11n backbone
backbone:
  # [from, repeats, module, args]
  - [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
  - [-1, 1, Conv, [128, 3, 2]] # 1-P2/4
  - [-1, 2, C3k2_AKConv, [256, False, 0.25]]
  - [-1, 1, Conv, [256, 3, 2]] # 3-P3/8
  - [-1, 2, C3k2_AKConv, [512, False, 0.25]]
  - [-1, 1, Conv, [512, 3, 2]] # 5-P4/16
  - [-1, 2, C3k2_AKConv, [512, True]]
  - [-1, 1, Conv, [1024, 3, 2]] # 7-P5/32
  - [-1, 2, C3k2_AKConv, [1024, True]]
  - [-1, 1, SPPF, [1024, 5]] # 9
  - [-1, 2, C2PSA, [1024]] # 10

# YOLO11n head
head:
  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 6], 1, Concat, [1]] # cat backbone P4
  - [-1, 2, C3k2_AKConv, [512, False]] # 13

  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 4], 1, Concat, [1]] # cat backbone P3
  - [-1, 2, C3k2_AKConv, [256, False]] # 16 (P3/8-small)

  - [-1, 1, Conv, [256, 3, 2]]
  - [[-1, 13], 1, Concat, [1]] # cat head P4
  - [-1, 2, C3k2_AKConv, [512, False]] # 19 (P4/16-medium)

  - [-1, 1, Conv, [512, 3, 2]]
  - [[-1, 10], 1, Concat, [1]] # cat head P5
  - [-1, 2, C3k2_AKConv, [1024, True]] # 22 (P5/32-large)

  - [[16, 19, 22], 1, Detect, [nc]] # Detect(P3, P4, P5)
4.5.2 AKConv的yaml文件2
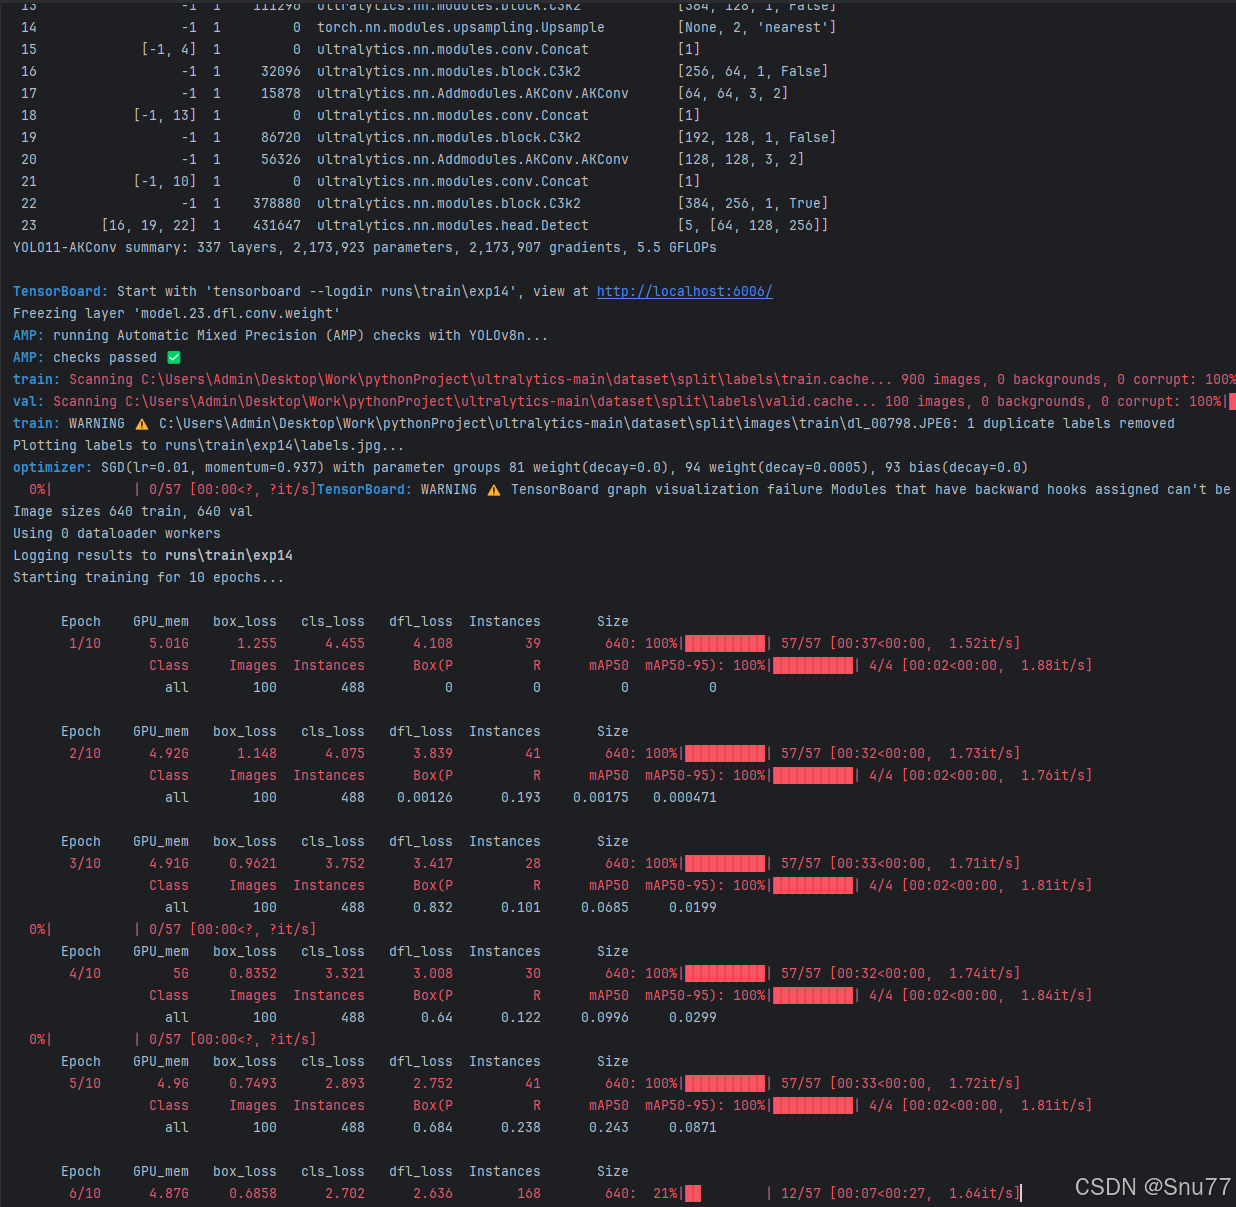
此版本训练信息:YOLO11-AKConv summary: 337 layers, 2,173,923 parameters, 2,173,907 gradients, 5.5 GFLOPs
# Ultralytics YOLO 🚀, AGPL-3.0 license
# YOLO11 object detection model with P3-P5 outputs. For Usage examples see https://docs.ultralytics.com/tasks/detect

# Parameters
nc: 80 # number of classes
scales: # model compound scaling constants, i.e. 'model=yolo11n.yaml' will call yolo11.yaml with scale 'n'
  # [depth, width, max_channels]
  n: [0.50, 0.25, 1024] # summary: 319 layers, 2624080 parameters, 2624064 gradients, 6.6 GFLOPs
  s: [0.50, 0.50, 1024] # summary: 319 layers, 9458752 parameters, 9458736 gradients, 21.7 GFLOPs
  m: [0.50, 1.00, 512] # summary: 409 layers, 20114688 parameters, 20114672 gradients, 68.5 GFLOPs
  l: [1.00, 1.00, 512] # summary: 631 layers, 25372160 parameters, 25372144 gradients, 87.6 GFLOPs
  x: [1.00, 1.50, 512] # summary: 631 layers, 56966176 parameters, 56966160 gradients, 196.0 GFLOPs

# YOLO11n backbone
backbone:
  # [from, repeats, module, args]
  - [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
  - [-1, 1, AKConv, [128, 3, 2]] # 1-P2/4
  - [-1, 2, C3k2, [256, False, 0.25]]
  - [-1, 1, AKConv, [256, 3, 2]] # 3-P3/8
  - [-1, 2, C3k2, [512, False, 0.25]]
  - [-1, 1, AKConv, [512, 3, 2]] # 5-P4/16
  - [-1, 2, C3k2, [512, True]]
  - [-1, 1, AKConv, [1024, 3, 2]] # 7-P5/32
  - [-1, 2, C3k2, [1024, True]]
  - [-1, 1, SPPF, [1024, 5]] # 9
  - [-1, 2, C2PSA, [1024]] # 10

# YOLO11n head
head:
  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 6], 1, Concat, [1]] # cat backbone P4
  - [-1, 2, C3k2, [512, False]] # 13

  - [-1, 1, nn.Upsample, [None, 2, "nearest"]]
  - [[-1, 4], 1, Concat, [1]] # cat backbone P3
  - [-1, 2, C3k2, [256, False]] # 16 (P3/8-small)

  - [-1, 1, AKConv, [256, 3, 2]]
  - [[-1, 13], 1, Concat, [1]] # cat head P4
  - [-1, 2, C3k2, [512, False]] # 19 (P4/16-medium)

  - [-1, 1, AKConv, [512, 3, 2]]
  - [[-1, 10], 1, Concat, [1]] # cat head P5
  - [-1, 2, C3k2, [1024, True]] # 22 (P5/32-large)

  - [[16, 19, 22], 1, Detect, [nc]] # Detect(P3, P4, P5)
4.5.3 AKConv的训练过程截图
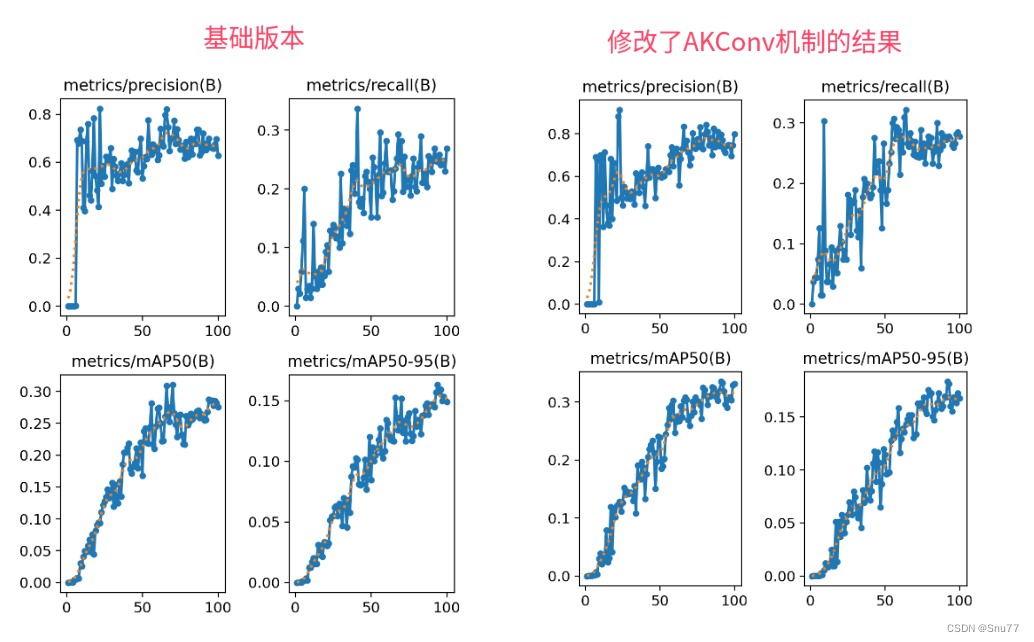
下面是添加了AKConv的训练截图。
4.5.4 AKConv的训练代码
import warnings
warnings.filterwarnings('ignore')
from ultralytics import YOLO

if __name__ == '__main__':
    model = YOLO('yolo11n.yaml') # 续训yaml文件的地方改为lats.pt的地址,需要注意的是如果你设置训练200轮次模型训练了200轮次是没有办法进行续训的.
    # 如何切换模型版本, 上面的ymal文件可以改为 yolov11s.yaml就是使用的v11s,
    # 类似某个改进的yaml文件名称为yolov11-XXX.yaml那么如果想使用其它版本就把上面的名称改为yolov11l-XXX.yaml即可(改的是上面YOLO中间的名字不是配置文件的)!
    # model.load('yolov11n.pt') # 是否加载预训练权重,科研不建议大家加载否则很难提升精度
    model.train(data=r"C:\Users\Administrator\Desktop\ultralytics-main\NEU-DET\data.yaml",
                # 如果大家任务是其它的'ultralytics/cfg/default.yaml'找到这里修改task可以改成detect, segment, classify, pose
                task='detect',
                cache=False,
                imgsz=640,
                epochs=100,
                single_cls=False,  # 是否是单类别检测
                batch=4,
                close_mosaic=0,
                workers=0,
                device='0',
                optimizer='SGD', # using SGD 优化器 默认为auto建议大家使用固定的.
                # resume=, # 续训的话这里填写True
                amp=False,  # 如果出现训练损失为Nan可以关闭amp
                project='runs/train',
                name='exp',
                )
五、AKConv可添加的位置
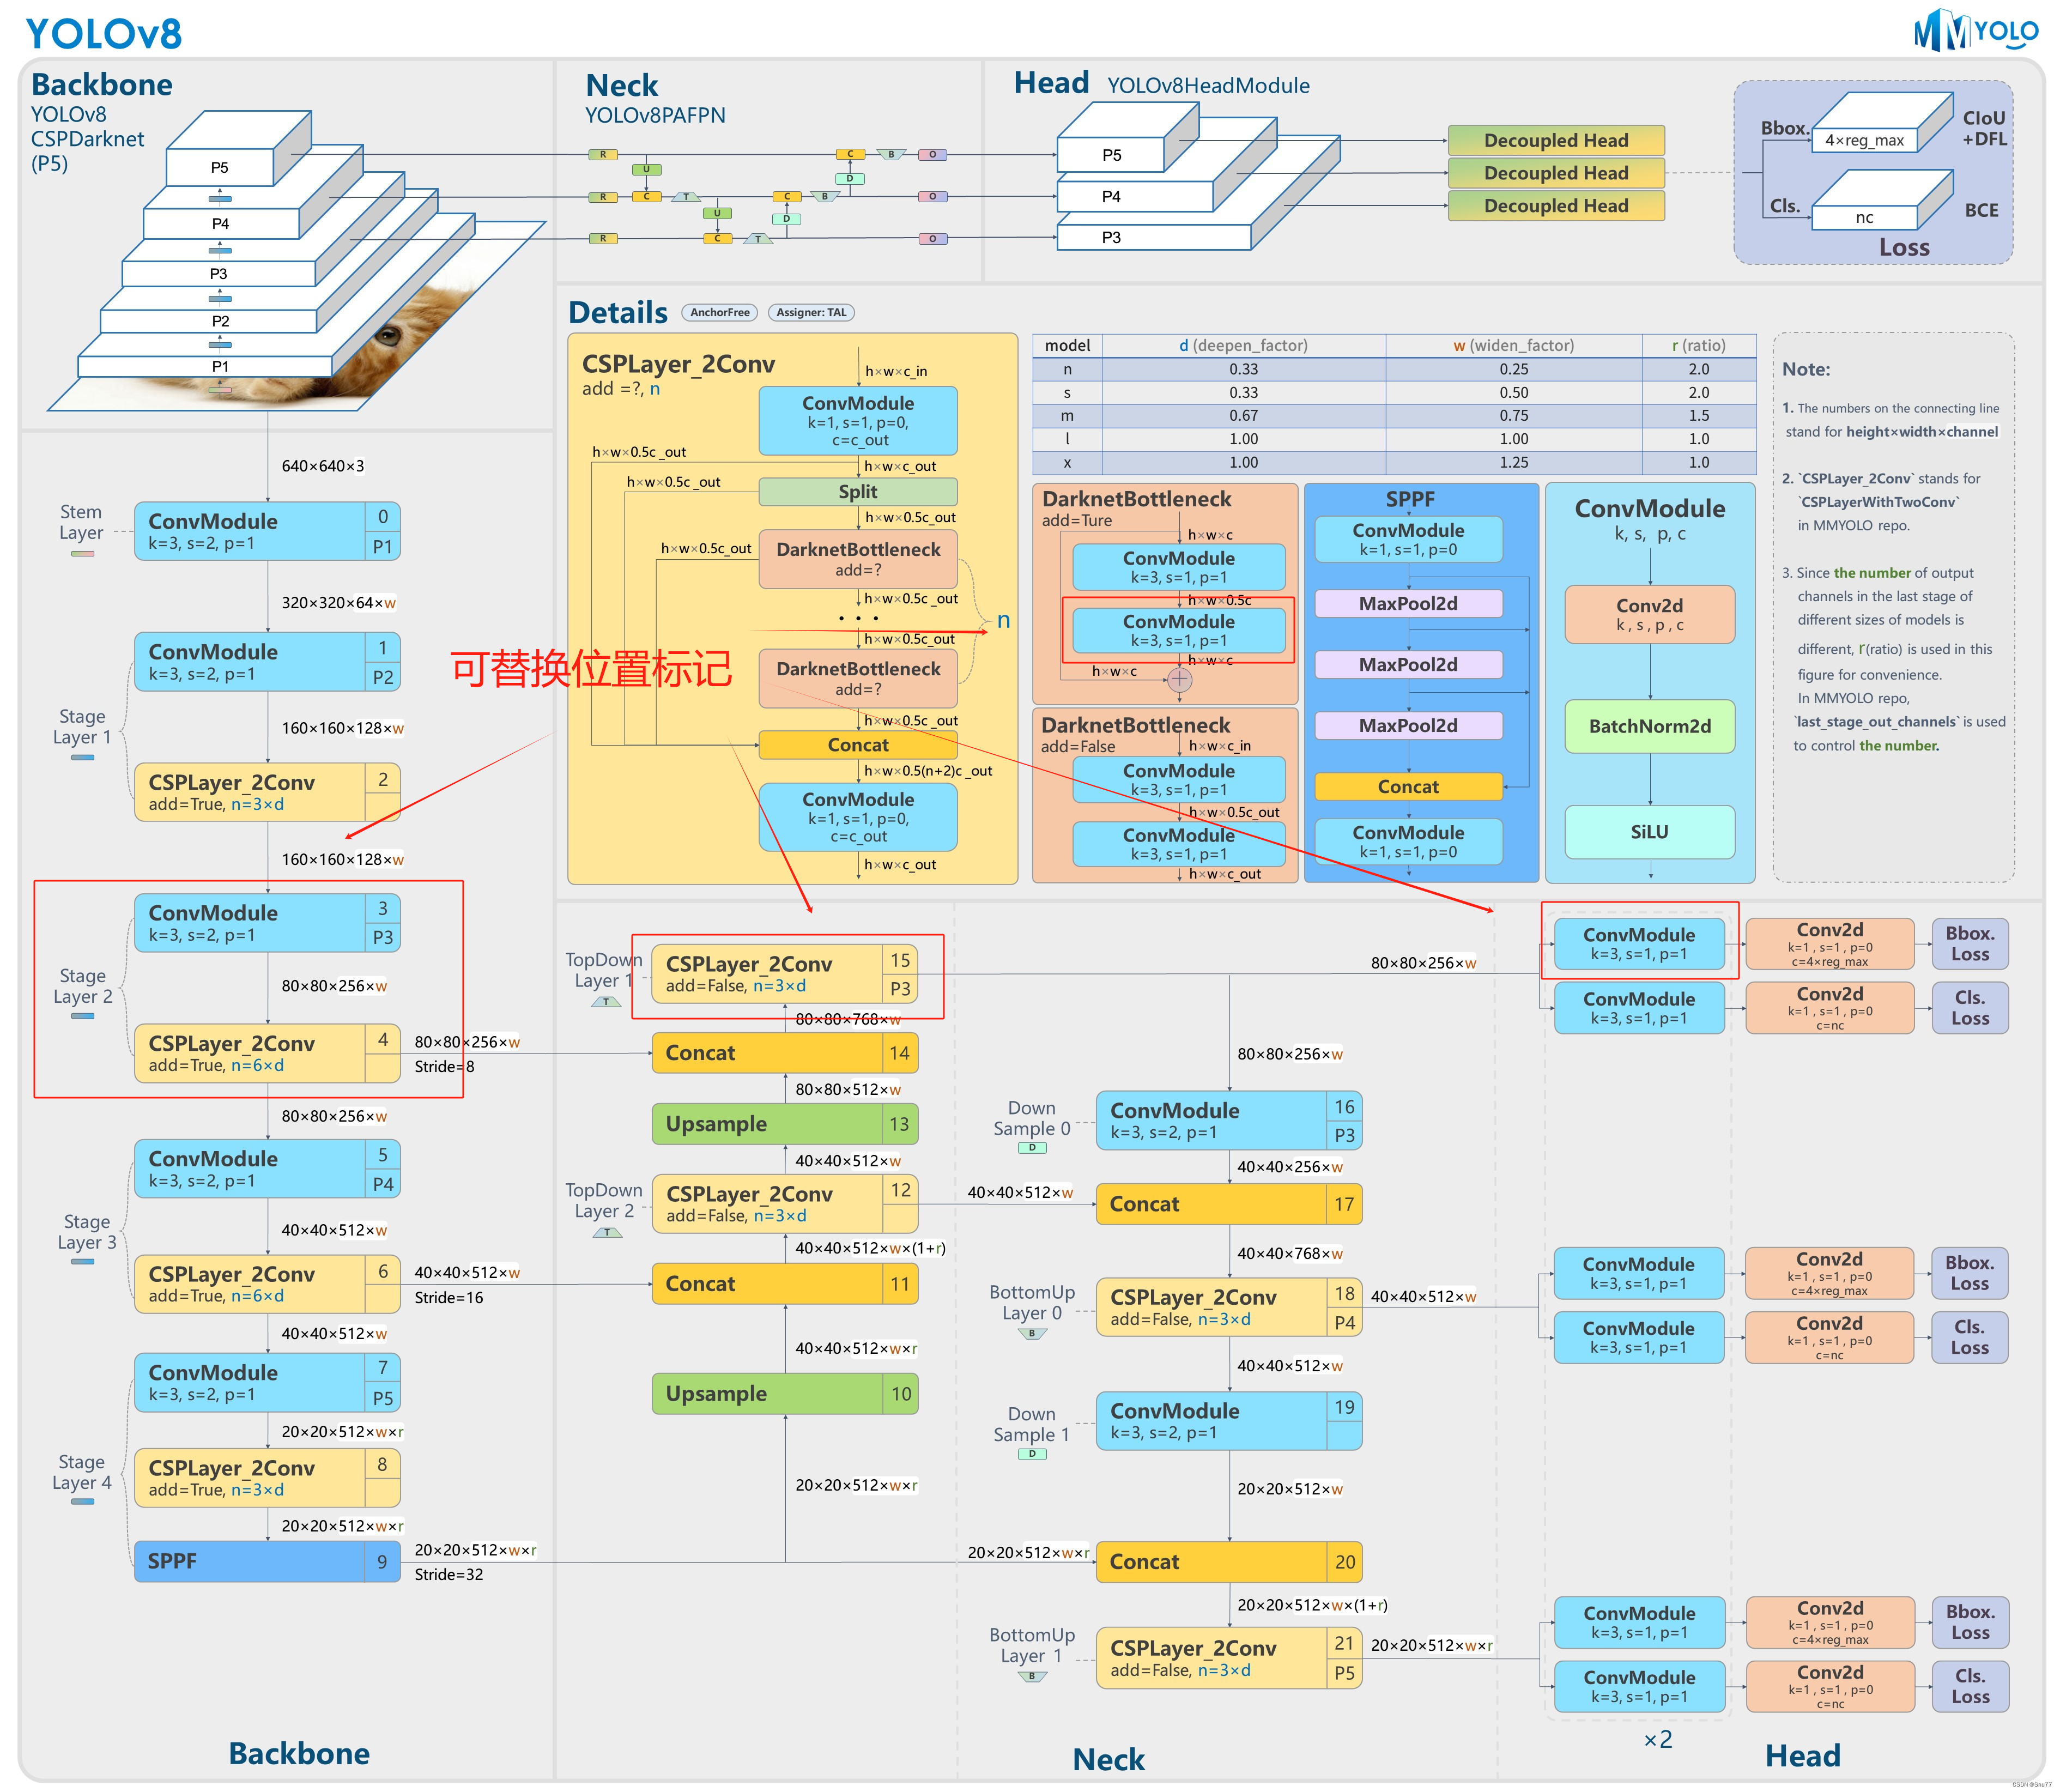
5.1 推荐AKConv可添加的位置
AKConv是一种即插即用的模块
文字大家可能看我描述不太懂,大家可以看下面的网络结构图中我进行了标注。
5.2 图示AKConv可添加的位置
六、本文总结
到此本文的正式分享内容就结束了,在这里给大家推荐我的YOLOv11改进有效涨点专栏,本专栏目前为新开的平均质量分98分,后期我会根据各种最新的前沿顶会进行论文复现,也会对一些老的改进机制进行补充,目前本专栏免费阅读(暂时,大家尽早关注不迷路~),如果大家觉得本文帮助到你了,订阅本专栏,关注后续更多的更新~
 2060


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


