


摘要:本文说明如何基于LangChain构建一个简单的Agent代理;使用OpenAi模型和TAVILY搜索。
该Agent代理具备读取历史信息的能力。
在介绍之前首先说明如何在Pycharm中配置代理。这样就可以使用LangSmith来进行追踪和TAVILY来搜索。
Pycharm打开,依次点积File,Settings,Appearance&behavior、System settings、HTTP Proxy,选择Manual proxy configuration,选择HTTP,以我为例,我挂着clash小猫,打开电脑网络设置的代理。
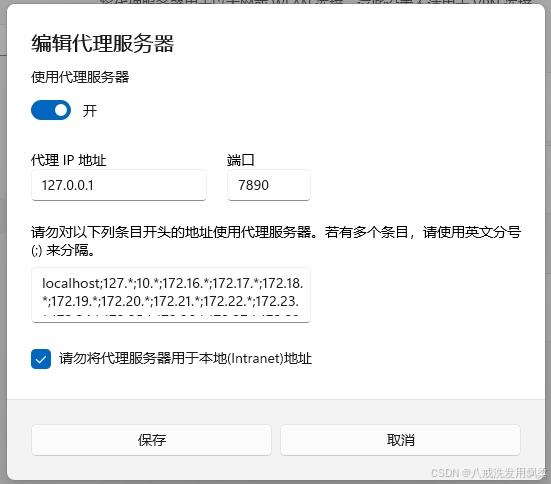
将IP地址、端口、下面的文本框分别粘贴复制到刚才打开的Pycharm中的相应地址,点击check connection,输入谷歌网址进行测试。测试成功即可。
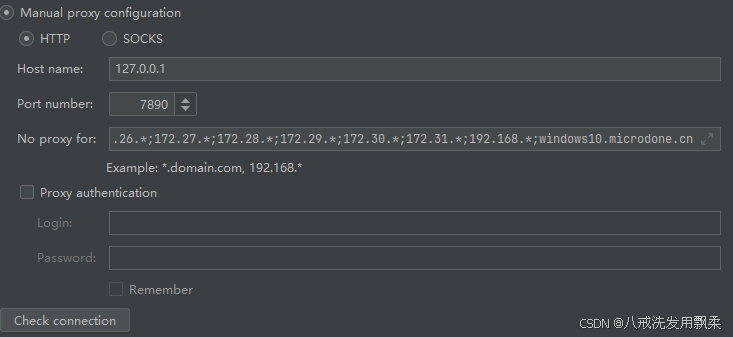
上面介绍完了如何在Pycharm中使用代理,下面进入正题。根据我当前的理解,agent的工作流程是
- 接收输入:代理接收用户的输入消息,并开始处理。
- 启动代理链:代理链启动,准备处理输入数据。
- 调用工具或服务:根据需要,代理调用特定的工具或服务来执行部分任务。
- 工具处理结束:工具完成任务并返回结果,代理接收工具输出。
- 生成响应:代理根据输入数据和工具输出,逐步生成响应内容。
- 代理链处理结束:代理链完成整个处理流程,生成最终响应。
第一步
导入相应的api创建chat对象以及搜索工具定义。
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_API_KEY"] = ''
os.environ["TAVILY_API_KEY"] = ''
api_key = ""
api_base = ""
model = ChatOpenAI(model="gpt-3.5-turbo", api_key=api_key, base_url=api_base)

search = TavilySearchResults(max_results=2)
search_results = search.invoke("what is the weather in SF")
print(search_results)

tools = [search]
model_with_tools = model.bind_tools(tools)
引号中的内容都要自己去获取。定义model时直接在ChatOpenAI后的()添加model、api_key、base_url是我随便试试的竟然成功了,这是使用代理的方式连接openai。如果读者有实力可以直接定义openai的api_key,模型定义时只要传入model参数即可。search是定义的工具。将定义的工具和模型bind一下,因为我没有找到科大讯飞对应的api说明,星火大模型也没有bind方法,所以用openai来示例。
第二步
定义agent_executor
agent_executor = create_react_agent(model, tools)
以上面的定义为例,分别以返回的输出结果以Messagt的形式或者token的形式展示;
Streaming Messages如下
for chunk in agent_executor.stream(
    {"messages": [HumanMessage(content="whats the weather in sf?")]}
):
    print(chunk)
    print("----")
async def handle_agent_events():
    async for event in agent_executor.astream_events(
        {"messages": [HumanMessage(content="whats the weather in sf?")]}, version="v1"
    ):
        kind = event["event"]
        if kind == "on_chain_start":
            if event["name"] == "Agent":
                print(
                    f"Starting agent: {event['name']} with input: {event['data'].get('input')}"
                )
        elif kind == "on_chain_end":
            if event["name"] == "Agent":
                print()
                print("--")
                print(
                    f"Done agent: {event['name']} with output: {event['data'].get('output')['output']}"
                )
        if kind == "on_chat_model_stream":
            content = event["data"]["chunk"].content
            if content:
                print(content, end="|")
        elif kind == "on_tool_start":
            print("--")
            print(
                f"Starting tool: {event['name']} with inputs: {event['data'].get('input')}"
            )
        elif kind == "on_tool_end":
            print(f"Done tool: {event['name']}")
            print(f"Tool output was: {event['data'].get('output')}")
            print("--")

# 启动异步事件处理函数
asyncio.run(handle_agent_events())
Streaming tokens如上,.astream_events方法就是以token的形式返回,输出结果如下

这两个个例子就是按照我的理解进行agent对事件的处理来执行的。这两个例子都不会读取历史信息,按我之前的介绍需要加入cofig,在agent中还要新增内存memory。
第三步
添加内存和config
memory = SqliteSaver.from_conn_string(":memory:")

agent_executor = create_react_agent(model, tools, checkpointer=memory)

config = {"configurable": {"thread_id": "abc123"}}
分别执行下面两段代码可以说明。
for chunk in agent_executor.stream(
    {"messages": [HumanMessage(content="hi im bob!")]}, config
):
    print(chunk)
    print("----")
for chunk in agent_executor.stream(
    {"messages": [HumanMessage(content="whats my name?")]}, config
):
    print(chunk)
    print("----")
读者可以尝试新定义一个config,更改线程id,执行第二段代码会输出我不知道您的名字类似的话。
本篇文章说明了用Langchain构建一个简单的agent代理的过程,还增加了内存可以读取历史信息。

 421


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


