



【导航】➡️制造业数据与AI践行者老蒋的技术博客全系列文章汇总(四阶段学习路径版-持续更新)
摘要: 针对制造业 IoT 设备数据采集方案落地难、不可复现、质量不可控的痛点,本文基于智联工坊 3 条产线 12 台设备的场景,演示用 WorkBuddy 将模糊方案落地为生产级数据工程的完整过程。采用 SeedSequence 分区随机实现 2000 万条数据逐字节可复现,配套五维质量门禁与退出码调度阻断机制,附完整 Python 脚本、DolphinScheduler 工作流与 Doris 数仓 ODS 衔接契约,可直接用于数仓测试、CI 校验与模拟数据源场景。
目录
🔴 #01 pip报"No matching distribution found",其实是镜像源403
🔴 #02 激活了venv,却仍报ModuleNotFoundError: No module named 'pandas'
一、开篇:方案落地时,最容易卡住你的3个地方
兄弟们,上一版《方案》我发出去之后,后台和评论区问得最多的,其实不是"算法怎么写",而是"跑不起来 / 对不齐 / 不可复现"这三件最接地气的事:
-
"依赖装不上" —— 明明照着
requirements.txt装,pip却报No matching distribution found,第一反应是包名写错了,折腾一晚上。 -
"venv激活了,脚本一跑还是
ModuleNotFoundError: No module named 'pandas'" —— 提示符都显示(.venv)了,怎么还能找不到模块? -
"标题写着DolphinScheduler全链路,正文却一个工作流定义都没有,我到底要不要写DS?" —— 这是方案本身的坑,不是你的锅。
📋 快速自检:本文能帮你解决这些问题吗?
▢ 需要可复现的设备模拟数据,用于数仓测试与验证
▢ 方案落地总遇到环境、依赖、解释器等边角料问题
▢ 需要带质量门禁的采集流水线,能和调度系统联动
▢ 数据要和下游 ODS 表严格对齐,字段格式零偏差
以上问题,本文全部给出可落地的解决方案。
所以这篇,我不只给你"能跑的脚本",更把跑通这条路踩过的坑、方案自身的歧义、以及和#08的衔接约定一次说清。
这不科学啊...... 一份方案发出去,落地时卡的居然不是技术难点,而是这些边边角角。但这就是工程实践——真正让你加班的,从来不是核心算法,而是这些"看起来不是问题的问题"。
二、本文交付物清单
读完本文,你将直接拿到以下东西:
| 序号 | 交付物 | 说明 | 适用场景 |
|---|---|---|---|
| 1 | 可复现的数据生成脚本 | SEED=42,单机重跑/单日补跑逐字节一致 | 本地造数、CI冒烟 |
| 2 | 五维质量门禁 | 完整性/准确性/及时性/一致性/异常标记,百分制+退出码阻断 | 调度前置校验 |
| 3 | 离线编排 + DS工作流资产 | run_pipeline.sh + DolphinScheduler DAG JSON | 无DS/有DS两种环境 |
| 4 | ODS衔接契约核对 | 10/10项字段对齐校验 | #08接入勾选清单 |
| 5 | 2条实战排坑 | 镜像源403 / venv解释器选错 | 部署即查即用 |
核心价值:你不用再手动造数了。把方案丢给WorkBuddy,它帮你把歧义理清、把工程搭好、把数据跑出来。
💡 适用场景说明
本文方案适用于:数仓开发测试数据源、IoT 采集链路模拟验证、调度流水线质量门禁测试、CI 自动化数据校验; 若需真实设备接入,替换数据生成模块为真实采集网关即可,质量门禁与调度链路可直接复用。
三、数据准备:12台设备 · 3条产线 · 5个测点
虚拟工厂「智联工坊」有3条SMT产线(L01/L02/L03),每条产线4台关键设备(印刷机/贴片机/回流焊/AOI),合计12台设备。本案例的目标,是为Doris数仓准备一份可复现、可控注入、与ODS表结构严格对齐的模拟数据源,让#08的SeaTunnel同步作业"拿到即可导入"。
| 维度 | 取值 |
|---|---|
| 采集规模 | 3产线 × 4设备 × 30天 × 16小时 × 1秒 = 20,736,000条 |
| 时间范围 | 2026-09-01 ~ 2026-09-30(30天) |
| 生产时段 | 每天08:00:00 ~ 23:59:59(含午休/换线停机) |
| 输出格式 | CSV(UTF-8无BOM,逗号分隔),按日期/产线双分区 |
| 随机种子 | SEED = 42,任意重跑逐字节一致 |
| 技术栈 | Python 3.10+ / pandas / numpy / PyYAML / tqdm |
数据特征(五重注入):
| 特征 | 设计 |
|---|---|
| 正常波动 | 正态分布,σ = 量程5% |
| 周期性 | 上午(08–12)偏中上+4% / 下午(13–17)稳定0% / 晚间(17–24)略降−3% |
| 老化漂移 | 30天缓慢漂移+2%(以绝对基准日锚定) |
| 异常注入 | 2%:温度超上限20% / 振动超上限50% / 压力超上限30% |
| 缺失注入 | 0.5%:随机1个适用测点置空,quality_flag=MISSING |
| 停机 | 每日午休12:00–13:00(OFF)+ 每日1次30分钟换线(IDLE) |
四、快速开始(3步跑通)
4.1 安装依赖
python -m venv .venv

# Windows(在Git Bash中执行)
.venv/Scripts/python -m pip install -r requirements.txt

# Linux / macOS
.venv/bin/python -m pip install -r requirements.txt
⚠️ 踩坑预警:若
pip install报No matching distribution found,九成是镜像源403(详见第六节#01),先查源、再查包。
4.2 一键编排(推荐)
# 生成昨天的数据(默认区间)
bash scripts/run_pipeline.sh

# 全量生成30天(位置参数写法,cmd / Git Bash通用)
bash scripts/run_pipeline.sh 2026-09-01 2026-09-30
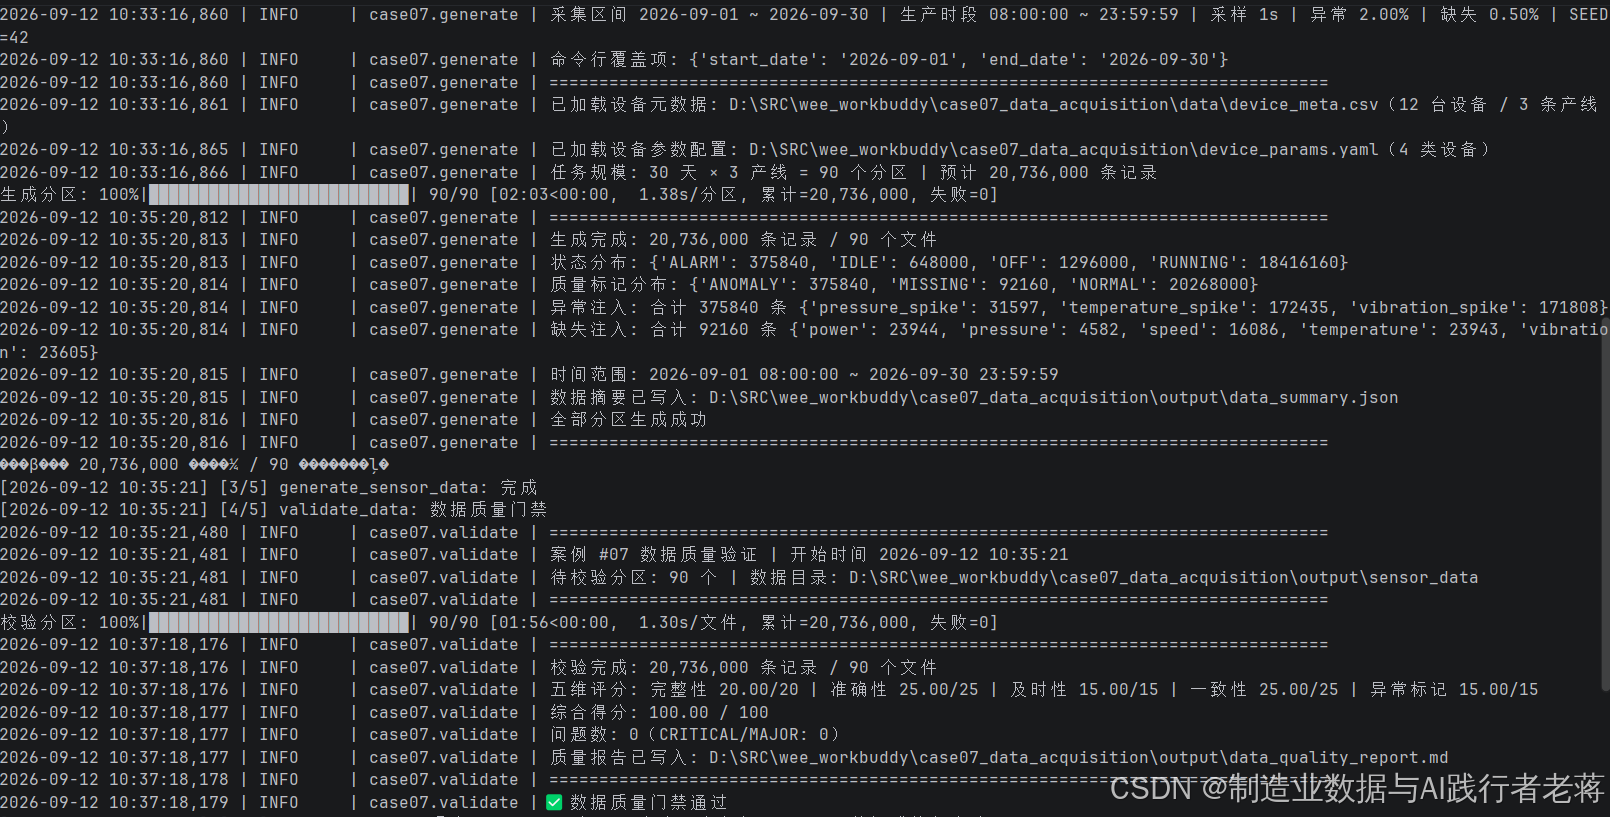
工程执行日志截图:
4.3 分步执行
# ① 生成设备元数据 + 参数配置(幂等)
python generate_device_meta.py

# ② 生成30天全量数据
python generate_sensor_data.py

# ③ 数据质量校验
python validate_data.py

# ④ #08交付前契约核对
python scripts/verify_ods_contract.py

# ⑤ DolphinScheduler工作流离线自检
python dags/deploy_dolphin_workflow.py --dry-run
五、核心实现回顾:从"一份方案"到"一套可跑工程"
5.1 可复现性:独立子随机流派生(最关键的设计)
方案要求"任何人重跑数据完全一致",但朴素的np.random.seed(SEED) + hash()会因进程级哈希随机化导致不可复现。
WorkBuddy的处理是:改用SeedSequence([seed, 日序号, 设备序号])派生每个分区的独立随机流,彻底消除进程依赖。
# generate_sensor_data.py(节选)
from numpy.random import SeedSequence, default_rng

# seed: 全局种子(42);day_ordinal: 该日在绝对基准年内的序号;pos: 设备序号
ss = SeedSequence([int(cfg.seed), int(day_ordinal), int(device_pos)])
rng = default_rng(ss)设计推演:以绝对基准日(
features.aging_reference_date = 2026-09-01)计算老化漂移,使"单日补跑09-15"与"全量跑09-01~09-30中的09-15"逐字节一致——已实测验证。
5.2 数据生成:五重注入
每台设备每日57,600秒网格(16h × 3600s)逐秒生成,再按"日期×产线"分区落盘。
# generate_sensor_data.py(节选:异常注入)
def inject_anomalies(values, rng, rules, ratio):
    """按类型注入超量程异常:温度+20% / 振动+50% / 压力+30%。"""
    n = len(values)
    n_anom = int(n * ratio)
    idx = rng.choice(n, size=n_anom, replace=False)
    for i in idx:
        r = rules[rng.integers(0, len(rules))]
        values[i] = values[i] * (1.0 + r["spike"])
        flags[i] = "ANOMALY"
return values不适用的测点(贴片机/回流焊/AOI无压力、AOI无速度)输出空字符串而非
0,避免与真实零值混淆。
5.3 质量门禁:五维校验 + 退出码阻断
validate_data.py不只"出报告",更以退出码作为调度系统的数据门禁——校验不通过,下游SeaTunnel同步任务就不会启动。
# validate_data.py(节选:门禁退出码语义)
if critical_or_major > 0:
    logger.error("❌ 存在阻断级问题,质量门禁不通过")
    sys.exit(1)          # 1 = 阻断,调度链路在此截断
elif total == 0:
    sys.exit(2)          # 2 = 无数据 / 执行失败
else:
    logger.info("✅ 数据质量门禁通过")
    sys.exit(0)          # 0 = 通过
五维校验口径:
| 维度 | 阈值 | 权重 | 判定口径 |
|---|---|---|---|
| 完整性 | 字段空值率 < 1% | 20 | 分母为「该设备类型适用行数」(不适用测点不计入) |
| 准确性 | 数值合理范围 100% | 25 | 仅判定NORMAL/MISSING行;ANOMALY设计意图即越界 |
| 及时性 | 时间戳断点 < 5% | 15 | 按设备分组,相邻间隔 > 采样周期即计为断点 |
| 一致性 | 状态与数值逻辑一致 100% | 25 | 4条硬规则(ALARM⇔ANOMALY、OFF/IDLE数值趋零…) |
| 异常标记 | quality_flag准确率 > 95% | 15 | 混淆矩阵TP/FP/FN/TN |
六、实测结果:20,736,000条 · 质量100分
全量30天本地运行实测:
| 指标 | 实测值 |
|---|---|
| 总记录数 | 20,736,000 |
| 分区文件数 | 90(30日期 × 3产线) |
| 单文件记录数 | 230,400(4设备 × 57,600秒) |
| 单文件大小 | 22.95 ~ 22.96 MB(< 100 MB约束 ✅) |
| 磁盘占用 | ≈ 2.02 GB |
| 状态分布 | RUNNING 18,416,160 / OFF 1,296,000 / IDLE 648,000 / ALARM 375,840 |
| 质量标记 | NORMAL 20,268,000 / ANOMALY 375,840 / MISSING 92,160 |
| 异常注入 | 375,840条(温度172,435 / 振动171,808 / 压力31,597) |
| 缺失注入 | 92,160条(5字段均匀分布) |
| 综合耗时 | 生成≈100s + 校验≈53s |
质量评分(全量):
五维评分: 完整性 20.00/20 | 准确性 25.00/25 | 及时性 15.00/15 | 一致性 25.00/25 | 异常标记 15.00/15
综合得分: 100.00 / 100
问题数:   0(CRITICAL/MAJOR: 0)
质量门禁: ✅ 通过(退出码0)反向验证:人为注入6类缺陷(ALARM错标、越界、空主键、MISSING缺多字段、时间戳跳变、OFF高负荷)后,得分降至56.98、退出码1正确阻断——证明门禁真能拦,不是恒真。
七、排坑笔记:两个"差点让你重装一晚上"的坑
| 坑点 | 核心现象 | 一句话解法 |
|---|---|---|
| pip 报 No matching distribution | from versions: none | 优先排查镜像源 403,先查源再查包 |
| venv 激活仍找不到模块 | Windows Git Bash 下解释器错位 | 脚本自动锁定 venv 目录下的 python.exe |
这2条坑,是我这次真机部署时踩过的。每条都按"现象 → 后果 → 正确做法"写清楚。
🔴 #01 pip报"No matching distribution found",其实是镜像源403(点击链接查看详情)
现象
Looking in indexes: https://pypi.tuna.tsinghua.edu.cn/simple
ERROR: Could not find a version that satisfies the requirement pandas>=2.1.0 (from versions: none)
ERROR: No matching distribution found for pandas>=2.1.0
后果(极易误判)
-
报错里的
(from versions: none)极具误导性,第一反应会去怀疑包名拼错、版本约束写错、Python版本不兼容。 -
实际三者都没问题,真正原因是索引页根本没拿到。
-
pip对索引返回403/404的表现和"包不存在"完全一样,不会有任何网络层提示。
正确做法
先查源,再查包:
# 1) 看当前生效的索引源
python -m pip config list

# 2) 直接探测各源HTTP状态码
curl -s -o /dev/null -w "%{http_code}\n" --max-time 15 https://pypi.tuna.tsinghua.edu.cn/simple/pandas/
curl -s -o /dev/null -w "%{http_code}\n" --max-time 15 https://pypi.org/simple/pandas/
curl -s -o /dev/null -w "%{http_code}\n" --max-time 15 https://mirrors.aliyun.com/pypi/simple/pandas/
定位后改全局配置:
[global]
index-url = https://mirrors.aliyun.com/pypi/simple/
extra-index-url = https://pypi.org/simple
trusted-host = mirrors.aliyun.com
               pypi.org
timeout = 60
retries = 3一句话结论:
(from versions: none)优先怀疑索引源不可达,而不是包名或版本约束。
🔴 #02 激活了venv,却仍报ModuleNotFoundError: No module named 'pandas'
现象
Windows Git Bash里已激活虚拟环境(提示符(.venv)),pip install也成功了,但bash run_pipeline.sh一上来就炸:
[1/5] init_env: 环境自检
Traceback (most recent call last):
  File "<string>", line 1, in <module>
ModuleNotFoundError: No module named 'pandas'
后果(极易误判)
-
明明装了依赖却找不到模块,第一反应会去怀疑
pip install没成功、或requirements.txt写错。 -
实际是解释器选错:脚本里写死
PYTHON=python3,而Windows的venv只有Scripts/python.exe,没有python3.exe。Git Bash下python3会落到系统Python(如3.13),它没装pandas,于是报"找不到模块"——和你当前激活的.venv根本不是同一个解释器。
正确做法
让脚本自动锁定venv解释器:
resolve_python() {
  if [ -n "${PYTHON:-}" ]; then
    echo "${PYTHON}"
  elif [ -n "${VIRTUAL_ENV:-}" ] && { [ -x "${VIRTUAL_ENV}/Scripts/python.exe" ] || [ -x "${VIRTUAL_ENV}/bin/python" ]; }; then
    if [ -x "${VIRTUAL_ENV}/Scripts/python.exe" ]; then echo "${VIRTUAL_ENV}/Scripts/python.exe"; else echo "${VIRTUAL_ENV}/bin/python"; fi
  elif [ -x "${PROJECT_PATH}/.venv/Scripts/python.exe" ]; then
    echo "${PROJECT_PATH}/.venv/Scripts/python.exe"
  elif command -v python3 >/dev/null 2>&1; then
    echo "python3"
  else
    echo "python"
  fi
}
PYTHON="$(resolve_python)"一句话结论:Windows下别信
python3就是venv;用$VIRTUAL_ENV/Scripts/python.exe才稳。
八、方案缺失/歧义的处理(Q1–Q16关键假设)
方案存在缺失、歧义或前后冲突之处。WorkBuddy对16处问题做了保守兼容方向的处理,未改变表结构、字段顺序、命名规范。
| # | 严重度 | 问题 | 本次采用的处理 |
|---|---|---|---|
| Q1 | 🔴 | 标题含「DS全链路」,正文无工作流定义 | 补充实现:5任务DAG + OpenAPI导入 + 离线编排 |
| Q4 | 🟠 | 贴片机/回流焊/AOI无压力、AOI无速度 | 不适用测点输出空字符串(NULL契约) |
| Q6 | 🔴 | AOI「1次/工单」与「1秒/次」冲突 | 依「预留扩展」→ AOI按秒级生成 |
| Q10b | 🟠 | 停机期是否留行 | 停机留行(OFF/IDLE),可一键切换 |
| Q15 | 🟠 | 不适用测点致整列空值率75% | 空值率分母取「适用行数」 |
| Q16 | 🔴 | 老化漂移若按运行区间算,补跑会改写历史 | 老化基准日固定为绝对日期2026-09-01 |
一句话:方案既定项100%落地,0跳过、0替换技术栈;偏差全部来自方案自身的缺失/歧义/冲突,已逐条列明原因。
九、与#08的衔接契约(一句话对齐)
由scripts/verify_ods_contract.py自动核对,实测10/10项通过。
| 约定项 | 要求 | 实测 |
|---|---|---|
| 文件格式 | CSV(UTF-8无BOM,逗号分隔) | ✅ |
| 字段顺序 | device_id,device_type,line_id,timestamp,temperature,pressure,speed,vibration,power,status,quality_flag,etl_batch_id | ✅ 严格一致 |
| 日期格式 | YYYY-MM-DD HH:MM:SS | ✅ |
| NULL表示 | 空字符串"" | ✅(SeaTunnel须显式空串→NULL,不可按0处理) |
| 分区策略 | sensor_data/YYYY-MM-DD/L{产线}_device_data.csv | ✅ |
| 批次标识 | BATCH_YYYYMMDD_HHMMSS | ✅ |
| 文件大小 | 单文件< 100MB | ✅ 最大22.96 MB |
十、实在人总结
怕你忘了,我再啰嗦一遍:
1. 这一版把"一份方案"做成了"一套能交付的工程"。 从元数据生成、数据注入、质量门禁到离线编排/DS工作流,从"能跑"到"好接"——给#08直接灌数、给调度挂门禁、给同事换台机器复现,一条龙。
2. 可复现性是这条链路的地基。 SEED=42 + SeedSequence([seed, 日序号, 设备序号]) + 绝对基准日老化漂移,三者缺一不可。不然"单日补跑"会把历史分区悄悄改写,你都不知道数据什么时候变了。
3. 质量门禁要用退出码,别只用报告。 validate_data.py返回0/1/2,DS的validate_data任务直接透传,mark_ready依赖它——门禁不通过,下游SeaTunnel同步自动不启动。这是调度系统该有的样子。
4. 排坑笔记的价值,比脚本本身还大。 脚本是"答案",排坑笔记是"为什么这么答"。镜像源403、venv解释器选错——这两个坑任何一个都能让你卡一晚上,知道坑在哪,才敢在自己的环境动手。
5. 方案标题写了DS全链路,但正文没定义工作流——这是方案的锅,不是你的。 WorkBuddy用5任务DAG + 离线编排补上了,但真实Doris落库归#08,本案例只备好DDL与契约核对。
老蒋我做了二十多年制造业数据工程,最深的感受是:决定项目能不能落地的,从来都不是核心架构,而是这些环境、依赖、一致性、衔接的细节。把这些坑都踩平、把标准都定死,数据链路才能真正跑起来。
十一、评论区炸弹
兄弟们,这一版把IoT设备数据采集的完整闭环公开了:脚本、质量门禁、离线编排、DS工作流、契约核对、排坑笔记,全都有。
现在轮到你们了:
你们做数据采集/数仓贴源层,现在卡在哪一步?
A. 方案写完了,但依赖装不上、跑不起来(先去查镜像源和venv解释器)
B. 数据跑出来了,却和下游ODS表对不上字段
C. 能生成数据,但质量没法保证,不敢往数仓灌
D. 我们做得比这还牛(大佬求带)全套16份交付物(脚本+报告+DDL+DAG+排坑笔记),评论区留言「IoT全套」我直接发你,不用自己凑。
够意思吧?评论区见!👇
📎 系列导航
| 专栏传送 | 制造业数据与AI落地实战 WorkBuddy工作场景应用实践 |
|---|---|
| 关联博文 | #06 智联工坊设备综合效率(OEE)趋势解读:从设备铭牌照片到Word报告与HTML看板 #05 制造业MES工时异常检测:AI帮我2小时干完Excel 2天的活 #04 我用 WorkBuddy 分析了 30 篇 CSDN 博客,发现 3 个反直觉的流量真相 #03 MES 工时异常检测-升级版:看板 + 脚本 + 提示词 + 排坑,2 小时干完 2 天的活 |
| 下一篇Doris | #08 《IoT采集数据落地Doris:SeaTunnel同步 + ODS建模》(规划中) |
📌 本文数据来源:智联工坊虚拟工厂IoT设备模拟数据。全部脚本、质量报告、DDL、DS工作流、契约核对、排坑笔记均已随工程公开。评论区留言「IoT全套」即可获取完整工程包。
标签:#WorkBuddy #IoT数据采集 #数据工程 #Python #模拟数据生成 #数据质量校验 #DolphinScheduler #Doris #制造业数字化


 扫一扫


&spm=1001.2101.3001.5002&articleId=165117925&d=1&t=3&u=d559d793ec7a4f4b8e6308eea399ab03)

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


