【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(进阶篇)

项目介绍

这是一个 AI 驱动的音频内容创作助手。你可以用自然语言与它对话,它会理解意图、调用相应的语音合成工具,把文字变成真实的播客音频,并保存在本地。

关于项目的详细介绍见第一篇文章:第一个 AI Agent 项目:从零搭建 AI 音频创作助手(入门篇)

这篇文章更多介绍进阶篇添加的功能

更新概览

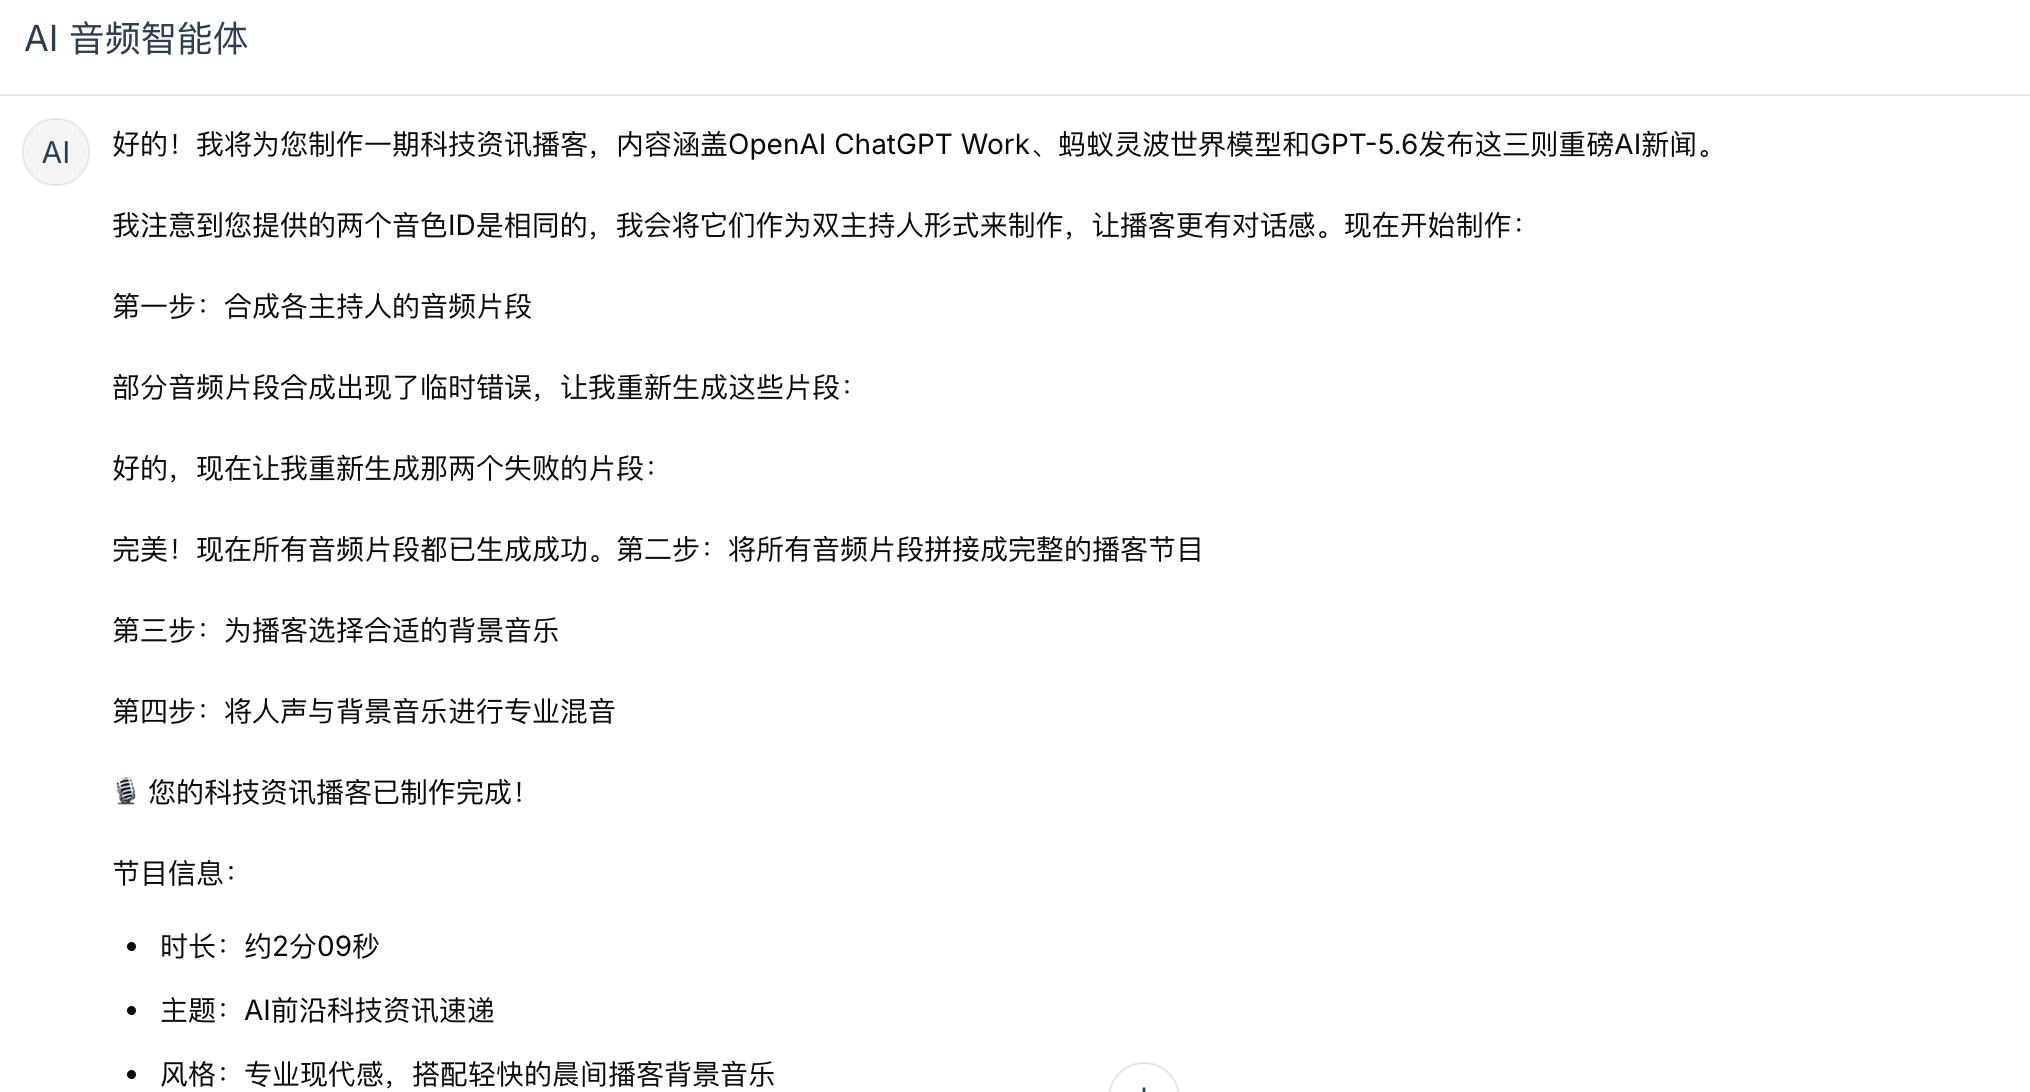
本次更新新增了完整的播客后期制作能力,包括音频拼接、智能BGM选择、音轨混音三大核心功能,同时新增了音频资源管理API和语音输入功能,实现了从前端上传、语音输入到后端处理的全链路闭环。


后端更新

1. 音频混音工具模块

新增 backend/app/tools/audio_mixing.py,提供三个核心音频处理工具:

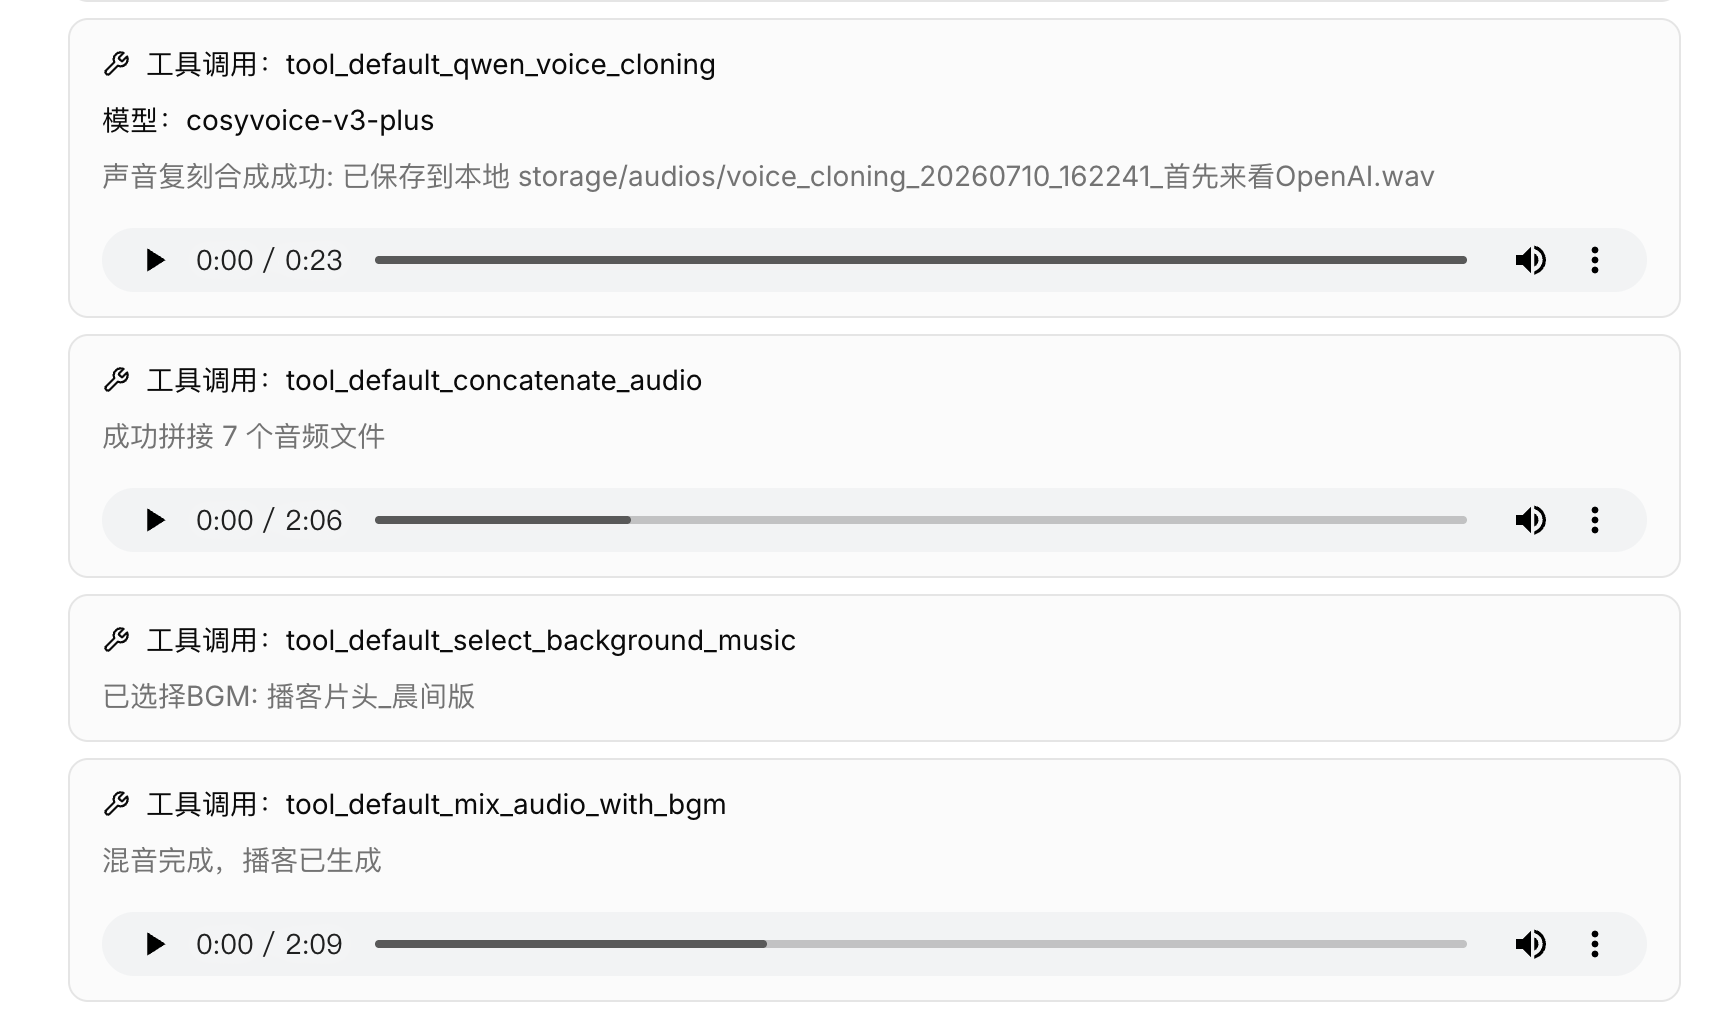
1.1 音频拼接工具(concatenate_audio)

将多个音频片段按顺序拼接成完整对话,适用于播客场景。

核心功能:

  • 支持交叉淡入淡出过渡(crossfade),使音频过渡更自然

  • 可配置音频片段之间的静音时长(默认1200ms,播客推荐1000-1500ms)

  • 自动生成带时间戳的唯一文件名

  • 自动记录到音频索引系统

代码示例:

@tool("concatenate_audio", args_schema=ConcatenateAudioInput)
def concatenate_audio_tool(
    audio_files: List[str],       # 音频文件路径列表
    crossfade_duration: int = 200,  # 交叉淡入淡出时长(ms)
    silence_duration: int = 1200    # 静音间隔(ms)
) -> str:
    """
    拼接逻辑:
    1. 加载所有音频片段 → AudioSegment.from_file()
    2. 依次拼接,支持两种模式:
       - crossfade > 0:交叉淡入淡出过渡
       - silence > 0:静音间隔拼接
    3. 导出为 WAV 文件并记录索引
    """

使用场景:将多个角色的语音片段拼接成播客对话。

1.2 智能BGM选择工具(select_background_music)

根据场景描述智能匹配合适的背景音乐。

核心功能:

  • 基于文件名的语义匹配(BGM文件名即场景描述)

  • 自动循环播放或裁剪以匹配目标时长

  • 支持直接指定BGM文件路径

  • 自动添加淡出效果

代码示例:

@tool("select_background_music", args_schema=SelectBGMInput)
def select_bgm_tool(
    scene_description: str,           # 场景描述,如"欢快的开场"
    duration_seconds: Optional[float] = None,  # 期望时长
    bgm_audio_path: Optional[str] = None       # 指定BGM路径
) -> str:
    """
    匹配逻辑:
    1. 如果指定了 bgm_audio_path,直接使用
    2. 否则扫描 storage/bgm/ 目录下所有 .mp3/.wav 文件
    3. 基于文件名与 scene_description 的关键词匹配度打分
    4. 选择得分最高的BGM,必要时循环/裁剪匹配时长
    """

使用场景:为播客对话选择合适的背景音乐。

1.3 音频混音工具(mix_audio_with_bgm)

将人声对话与背景音乐混合,生成专业的播客成品。

核心功能:

  • 专业BGM开场效果:

    • 前N秒(默认3秒):BGM原音量播放

    • 过渡阶段:音量渐变至背景音量

    • 后续阶段:BGM降低至约5%音量作为背景

  • 音量归一化处理,确保音质一致性

  • 自动淡出效果

  • 支持自定义BGM音量(推荐-24到-28dB)

代码示例:

@tool("mix_audio_with_bgm", args_schema=MixAudioWithBGMInput)
def mix_audio_with_bgm_tool(
    voice_audio: str,           # 主音频路径(人声)
    bgm_audio: str,             # BGM路径
    bgm_volume: float = -26,    # BGM背景音量(dB)
    intro_duration: float = 3.0, # BGM开场时长(秒)
    normalize: bool = True       # 是否归一化
) -> str:
    """
    混音逻辑:
    1. 加载人声和BGM音频
    2. BGM分段处理:
       - 开场段:原音量播放 intro_duration 秒
       - 过渡段:20步渐变从原音量到 bgm_volume
       - 背景段:固定 bgm_volume 音量
    3. 人声前插入静音(与BGM开场对齐)
    4. 叠加人声到BGM → bgm_processed.overlay(voice_with_intro)
    5. 可选归一化 + 淡出,导出为 MP3
    """

音量变化曲线:

BGM 音量变化:
原音量 ─────┐
            │\
            │ \  过渡时段(2秒)
            │  \
背景音量 ───┘   └────────── 背景音量
         ↑
      开场时段(3秒)

2. 音频资源管理API

新增 backend/app/routers/resources.py,提供音频资源的RESTful API。

2.1 接口列表
方法路径说明
GET/resources/audio查询所有音频资源列表
POST/resources/audio/upload上传音频文件(支持 .mp3 和 .wav)
DELETE/resources/audio/{id}删除指定音频资源
2.2 上传接口代码示例
@router.post("/audio/upload", response_model=UploadResponse)
async def upload_audio_resource(file: UploadFile = File(...)):
    """上传音频文件,存储到 BGM_DIR 并记录到索引"""
    # 1. 校验文件格式(仅支持 .mp3 和 .wav)
    ext = os.path.splitext(file.filename)[1].lower()
    if ext not in UPLOAD_ALLOWED_EXTENSIONS:
        raise HTTPException(status_code=400, detail=f"不支持的文件格式")

    # 2. 生成唯一文件名,避免冲突
    voice_id = str(uuid.uuid4())
    safe_filename = f"{name_without_ext}{voice_id}{ext}"

    # 3. 保存文件到 storage/bgm/
    with open(save_path, "wb") as f:
        shutil.copyfileobj(file.file, f)

    # 4. 记录到音频索引
    record_voice_index(local_path=save_path, voice=voice_id, model_name="", path="bgm")

    return UploadResponse(success=True, message="上传成功", voice_id=voice_id)
2.3 删除接口代码示例
@router.delete("/audio/{id}", response_model=DeleteResponse)
async def delete_audio_resource(id: str):
    """删除音频资源:移除索引记录 + 删除物理文件"""
    # 1. 从 voice_index.json 中查找匹配记录
    matched = [r for r in voice_index if r.get("id") == id]

    # 2. 删除对应的本地文件
    for record in matched:
        filepath = os.path.abspath(record.get("local_path", ""))
        os.remove(filepath)

    # 3. 从索引中移除并写回
    voice_index = [r for r in voice_index if r.get("id") != id]
    with open(index_path, "w", encoding="utf-8") as f:
        json.dump(voice_index, f, ensure_ascii=False, indent=2)

    return DeleteResponse(success=True, message="删除成功")

3. 音频索引系统

新增 backend/app/tools/audio_index.py,提供统一的音频索引管理,供各工具模块共享调用。

代码示例:

def record_voice_index(local_path: str, voice: str, model_name: str = "", path: str = "audios") -> None:
    """将音频文件信息记录到 voice_index.json 索引文件中

    Args:
        local_path: 音频文件本地路径
        voice: 音色ID
        model_name: 模型名称
        path: 音频存储路径类型 (audios/bgm/podcasts)
    """
    # 读取已有索引 → 追加新记录 → 写回文件
    new_record = {
        "id": str(uuid.uuid4()),
        "local_path": local_path,
        "voice_id": voice,
        "model_name": model_name,
        "path": path,
        "createTime": datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    }
    index.append(new_record)
    VOICE_INDEX_FILE.write_text(json.dumps(index, ensure_ascii=False, indent=2))

path 字段说明:

path 值说明存储目录
audiosTTS生成的音频storage/audios/
bgm上传的背景音乐storage/bgm/
podcasts混音生成的播客成品storage/podcasts/

4. 新增依赖

pip install pydub

注意:pydub 需要系统安装 FFmpeg。macOS: brew install ffmpeg,Ubuntu: sudo apt install ffmpeg。

5. 存储目录结构更新

storage/
├── audios/              # TTS生成的音频
├── bgm/                 # 背景音乐(新增)
├── podcasts/            # 播客成品(新增)
├── voice_index.json     # 音频索引(统一管理)
└── images/              # 图片文件

前端更新

1. 音频资源API对接

新增上传音频文件和删除音频资源功能,对应 fronted/src/api/resource.ts 中的两个新接口

2. 语音输入转文字

在聊天输入框中新增语音输入功能,用户可以通过麦克风将语音转换为文字发送消息。

组件位置:fronted/src/components/ai-elements/prompt-input/PromptInputSpeechButton.vue

使用方式:在 ChatAgent.vue 的输入区域中集成麦克风按钮:

<PromptInputFooter>
  <PromptInputSpeechButton />  
</PromptInputFooter>

技术实现:

  • 基于 Web Speech API(SpeechRecognition / webkitSpeechRecognition)实现浏览器端语音识别

  • 默认语言为中文(zh-CN),支持通过 lang 属性配置

  • 支持连续识别(continuous: true)和中间结果(interimResults: true)

  • 识别完成后自动将文字填入输入框,智能处理中英文空格

核心代码:

// 初始化语音识别
const sr = new SpeechRecognition()
sr.continuous = true          // 连续识别
sr.interimResults = true      // 返回中间结果
sr.lang = 'zh-CN'             // 默认中文

// 识别结果回调
sr.onresult = (event) => {
  let finalTranscript = ''
  for (let i = event.resultIndex; i < event.results.length; i++) {
    if (event.results[i].isFinal) {
      finalTranscript += event.results[i][0]?.transcript ?? ''
    }
  }
  if (finalTranscript) {
    // 智能添加空格:中文不加空格,英文前加空格
    const needsSpace = textInput.value && !/[\u4e00-\u9fa5]/.test(textInput.value.slice(-1))
    setTextInput(textInput.value + (needsSpace ? ' ' : '') + finalTranscript)
  }
}

交互效果:

  • 点击麦克风按钮开始录音,按钮显示脉冲动画

  • 再次点击停止录音

  • 识别结果自动追加到输入框文本中

  • 不支持 Web Speech API 的浏览器自动禁用按钮


使用场景

完整的播客制作流程

  1. 准备阶段:通过前端上传背景音乐到 storage/bgm/ 目录

  2. 对话生成:Agent 调用 TTS 工具生成多个角色的语音片段

  3. 音频拼接:Agent 调用 concatenate_audio 工具拼接对话

  4. BGM选择:Agent 调用 select_background_music 工具匹配背景音乐

  5. 混音合成:Agent 调用 mix_audio_with_bgm 工具生成最终播客成品

  6. 资源管理:通过前端查看、播放、删除所有音频资源

语音输入交互流程

  1. 用户点击聊天输入框旁的麦克风按钮

  2. 浏览器请求麦克风权限

  3. 开始录音,按钮显示脉冲动画

  4. 语音实时识别为文字

  5. 识别结果自动填入输入框

  6. 用户按 Enter 发送消息


升级指南

后端升级

  1. 安装新依赖:

    cd backend
    pip install pydub
    
  2. 安装 FFmpeg(如未安装):

    # macOS
    brew install ffmpeg
    # Ubuntu
    sudo apt install ffmpeg
    
  3. 创建新目录:

    cd backend
    mkdir -p storage/bgm storage/podcasts
    
  4. 准备背景音乐:

    • 将 .mp3 或 .wav 格式的背景音乐文件放入 storage/bgm/ 目录

    • 文件名建议使用场景描述(如 欢快的开场.mp3、深沉的讨论.mp3)

  5. 重启服务:

    python main.py
    

前端升级

无需额外操作,API 调用逻辑和语音输入组件已在现有代码中集成。


技术亮点

  1. 专业的音频处理:支持交叉淡入淡出、音量归一化等专业特性

  2. 智能BGM匹配:基于文件名的语义匹配,易于扩展为向量检索

  3. 统一索引管理:所有音频资源统一管理,支持查询、上传、删除等操作

  4. 浏览器端语音识别:基于 Web Speech API,无需后端支持,零延迟

  5. 全链路闭环:从前端上传、语音输入到后端处理,完整的数据流转


结果展示

具体音频在podcasts里面
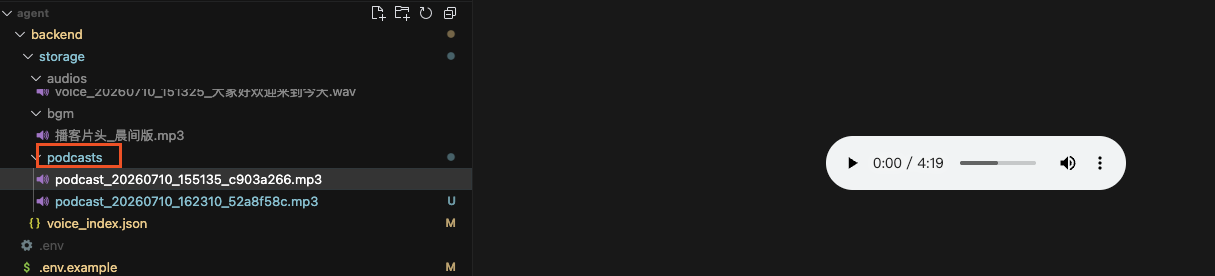
image.png

相关推荐

OxygenData-Vibe搭建:用 AI Coding重新定义数据看板搭建

长期以来,数据看板开发主要有两种方式:一种是使用标准化 BI 工具,交付快、成本低,但图表样式、交互体验和功能扩展都受限于 BI 本身的能力;另一种是自研定制开发,能够充分满足复杂和个性化需求,但需要投入大量研发资源,交付周期也更长。比如一个通过 BI 只需要 1 天就能搭建出来的看板,如果采用自研方式,可能需要投入 30 PD 的研发人力。既然 BI 交付这么快,为什么不把所有看板需求都交给 BI?原因在于,业务某些场景需要的不只是把数据展示出来。

京东科技开发者 216

当我谈数据库高可用时我谈些什么

大家都经常听到说数据库的双1,那双1指的是什么呢?参数=1(最安全)≠1(更快但可能丢)每次提交都把 redo 刷盘0/2:攒着刷,崩溃丢最近 1 秒每次提交都把 binlog 刷盘0/N:攒着刷,崩溃丢最近若干条"双 1"(都设为 1)= 单机不丢已提交事务的前提。生产核心库必须双 1;代价是每次提交两次 fsync。小结:单机层用 WAL 提速、用 2PC 保证 redo/binlog 一致、用崩溃恢复裁决半成品事务、用双 1 兜底持久性。

京东科技开发者 199

ScoAI:面向供应链的运筹原生决策智能

ScoAI 关注的并非 AI 能否进入供应链,而是 AI 参与供应链决策之后,哪些内容适合通过数据学习,哪些关系必须显式计算,以及哪些结果需要依据执行记录进行验证。其基本分工是:供应链业务定义问题、资源与行动后果,运筹学表达目标、约束和协同关系,AI 提供可复用的估计与判断。真正用于改进后续决策的,不仅是模型生成的初始结果,还包括实际采取的行动及其产生的业务反馈。

京东科技开发者 300

拆解海博 AI-Native 落地保障:海博团队 AI 知识库能力建设

绕了一大圈,回头看,我们其实一直在解开头那三个结:AI 读不懂系统、影响面靠人脑记、测试预期没处查。做到这里,本质上是把"AI 用不好"这个问题,从"是不是该换个更强的模型"重新定义成了"怎么把上下文经营好"。顺着这个思路,我们攒下了这么几样东西:•。

京东科技开发者 448

从零构建一个生产级记忆型 AI Agent —— AgentScope 项目全景技术与学习指南

domain 层端口接口(domain)职责适配器实现(infra)对话流水账读写经验记忆检索/落库请求级幂等四态会话元数据 CRUD会话级 Skill 选择态Skill 元数据HITL 权限网关(domain 内含逻辑,见第四篇)StreamSink技术中立的流式下沉(client 层桥接)以幂等端口为例,头部注释明确写道:实现 domain 端口,持有实体不出 infra 边界,对外只暴露嵌套视图GateResult。

京东科技开发者 515

数据涅槃:Agentic 重塑搜推数据生产体系

当前大模型已经能够理解需求、生成代码和解释错误,但数据生产的难点并不只是“写出一段 SQL”。一个需求还要经过数据源确认、口径澄清、加工编排、资源规划、任务提交、调度运行、结果交付和故障处置。任何一步缺少都可能让“看起来正确”的任务变成生产事故。

京东科技开发者 287

81.8 秒的视频,我们改了 15 个版本:一次纯 Codex 驱动的 AI-native 视频实践

81.8 秒、15 个版本,这些数字真正想说明什么?视频制作正在从一组专业软件里的复杂操作,变成一场围绕目标、参考和反馈展开的持续对话。AI 已经可以接住从脚本到交付的大量工作。你可以把精力留给更重要的部分:理解观众、选择故事、判断好坏。过去停在 PPT 和脑海里的想法,现在有机会被快速做成一支能看、能改、也愿意转发的视频。如果明天就要介绍你手头的项目,你最想先把哪一步交给 AI?

京东科技开发者 387

Codex 驱动的移动端AI全栈开发:从 Relay 原型图到可交付链路

AI 编程工具降低了跨端开发门槛,但“让 AI 写页面”并不等于“完成移动端交付”。PC 运营端页面通常以功能闭环为中心,设计约束较弱,研发可以基于组件库快速搭建;移动端 C 端页面直接面对用户,Relay 原型图和 UI 设计稿不仅是视觉参考,更是交互、信息层级、状态反馈和业务信任感的综合契约。

京东科技开发者 516

Claude Code vs Codex 记忆体系深度对比

Claude Code —— 分层自动记忆系统四层分层架构(CLAUDE.md / Auto Memory / Session Memory / AutoDream)构成自优化闭环,系统主动捕获、分类、去冗并跨会话接力经验。走的是自动化优先路线——让机器替人记忆、替人整理,以少量可控性的不确定换取强大的经验积累能力。Codex —— 声明式契约系统两层扁平架构(AGENTS.md 静态声明层 + 会话上下文层),记忆完全由人显式订立、显式修改,系统只读契约、绝不擅自变更。走的是可控性优先。

京东科技开发者 576

上游给空、下游拿到 -1,我把故障一直追到了 commons-beanutils 的构造函数

这篇手记是一份事后复盘,写在我们已经把修复推上线、把测试用例跑绿、把约束文档沉淀进团队库之后。非研发同事,可以直接从第八章开始看,前七章都是讲排障和代码分析。故障本身不复杂,修复也不复杂,但这次排查真正让我想写下来的,不是技术本身——而是从问题提报到解决全程AI的作用:问题定位:业务方反馈了一个异常单号说「下发失败」,一线运维同事直接在日志系统捞到相关的系统日志,用IDE打开下游代码库,把异常信息给到JoyCode——AI 直接指向了问题是serialType值非法,系统只接受0和1,而当前上游给的是-1。

京东科技开发者 674

SKill测评:谁才是真正的Skill之王?

巧合的是,阿里近期开源了一款名为 Skill-Up 的测评工具——它专门面向 Agent Skill 开发者,支持在 Claude Code、Codex、Qoder CLI 等真实 Agent Engine 环境中验证 Skill 的功能正确性,并可将失败用例转化为精准的修复指引,同时支持本地与 CI 环境的持续回归。2026年,Skill 的热度不减,已成为 AI 辅助编程领域的标配。在日常研发中,无论是沉淀个人经验,还是将团队的优秀范本标准化,将知识“蒸馏”为 Skill 已是大家的常规操作。

京东科技开发者 591

让AI真正参与工作!JoyDesk已上线京东云

JoyDesk提供覆盖AI资产管理、权限控制、安全策略、审批审计、运营监控等企业级治理能力,支持按组织、角色和项目进行精细化权限管理,并支持私有化部署,确保企业数据边界清晰、AI行为全程可追溯、安全策略灵活可配置,满足金融、政企等行业对数据安全和合规治理的要求,让AI真正成为企业可信赖的生产力。JoyDesk支持MCP协议、标准API、技能等多种开放接入方式,可快速连接企业现有业务系统,将业务能力封装为AI可调用的技能和专家,让AI能够理解业务流程、调用业务系统、完成业务任务,而无需改变企业原有IT架构。

京东科技开发者 635

【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手【最终版】

这个项目展示了AI Agent 在垂直内容创作领域端到端自动化:从内容理解到播客输出,全流程 AI 驱动多模态融合:文字、图片、音频、视频统一处理专业级音频质量:音色设计 + 智能混音,输出广播级品质低门槛使用:可视化配置 + 自然语言交互,无需技术背景。

京东科技开发者 550

【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(高级篇)

这是一个 AI 驱动的播客创作助手,专注于从文字/视频/音频内容识别到播客制作的全流程。你可以用自然语言与它对话,也可以上传视频和音频,它会理解意图、调用相应的语音合成工具,把他们变成真实的播客音频。

京东科技开发者 691

【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(入门篇)

这个项目让我第一次把前端、后端、AI Agent 三块内容独立串联起来。技术选型上每一块都是当下主流的方案,实际跑通整条链路之后对"全栈"有了更具体的感受。框架版本要锁定:LangChain 这类快速迭代的框架,版本差异带来的问题远比你想象的多先跑通链路,再追求完美:新手阶段能把用户输入 → AI 处理 → 结果展示这条链跑通,比深入某个技术点更有价值多看官方文档:相比博客和教程,官方文档更新及时,特别是 LangGraph 这种新框架后续计划继续迭代,欢迎交流!

京东科技开发者 589

ICLR 2026 | 面向序列决策的贝叶斯集成方法

在这篇工作中,我们关注的是。

京东科技开发者 289

ICML 2026|NaviAgent:面向 Oxygen 智能体的可扩展工具编排

大型语言模型(LLM)越来越多地作为函数调用代理,调用外部工具来处理超出其静态知识范围的任务。然而,它们通常一次只调用一个工具,缺乏对任务结构的全局视图。由于工具之间往往相互依赖,这会导致错误累积和可扩展性差,尤其是在扩展到数百或数千个工具时。为了解决这些局限性,我们提出了NaviAgent,一种显式的双层架构,它通过基于图的工具关系建模将任务规划与工具执行解耦。在规划层,基于 LLM 的代理决定是直接响应、澄清意图,还是检索并执行一个独立于工具间复杂性的工具链。

京东科技开发者 376

实测 9 款 AI 架构图工具:从 Mermaid 美化到 GPT-Image2,一份选型清单

支持 5 类图(架构图、工作流图、时序图、数据流图、生命周期/状态机图),主题 4 种(Classic、Signal Flow、Blueprint、Editorial)+ 3 种色彩模式(Dark / Light / System Auto),输出格式含 HTML、PNG、SVG、WebM、Share Card PNG、JSON IR。它把提示词图库、图像生成案例、参考图编辑流程和命令行工具整合在一起,让 AI Agent 能直接调用 GPT Image 2 模型完成文生图、图生图、参考图编辑等任务。

京东科技开发者 861

别再守着 Claude Code 了——学会指挥它自主干活

回到开头那句:别再一句一句地喂它、然后守着屏幕。真正的用法是——把一件事想清楚、划好边界、给它一个能自我验证的目标,然后交出去。你会发现,省下来的时间不是一点半点。把重复的判断和执行还给机器,把真正需要你的判断留给自己。

京东科技开发者 579

CVPR 2026|Oxygen XR 团队在原生鱼眼高斯泼溅技术上带来新突破

京东零售技术团队联合清华大学提出DirectFisheye-GS框架,创新性地将鱼眼相机模型原生嵌入3D高斯泼溅管线,通过跨视角联合优化策略直接处理鱼眼图像,避免了传统去畸变预处理导致的信息损失。该方案在多个公开数据集上达到SOTA性能,有效解决了单视角优化引起的几何畸变和视角不一致问题,同时保持与现有3DGS工具链的兼容性。技术已应用于电商3D重建和4D体积视频等场景,显著提升了沉浸式体验。相关论文被CVPR 2026接收,为宽视场场景重建提供了高效解决方案。

京东科技开发者 349

拆解海博 AI-Native 落地保障:Harness、双 Loop、知识库与技能自主迭代实践

海博研发RoadMap 的落地,彻底终结了 AI 编程“对话式玄学”的旧模式,真正落地了AI Native 研发工程化。它证明 AI 规模化赋能研发的核心,不在于堆砌大模型能力,而在于用工程思维重构 AI 的工作范式:用结构化流程替代随机对话,用固化规则约束模型行为,用持续沉淀实现能力复利,用分层架构支撑规模化落地。

京东科技开发者 625

让 AI 快速「读懂」你的代码仓:Joy-Code-Graph 云端图谱服务的三次进化

代码知识图谱不是要取代 AI 的智能,而是要补齐它对代码全局关系的认知盲区。当 AI 能一眼看清「谁调用了谁、改动会波及哪里」,它写出的代码才真正靠谱;当这份认知安全地留在自己手里、随时被 Joygen 调用、并且永久沉淀在代码仓里——AI 编程的体验,才算真正上了一个台阶。这,就是我们做 Joy-Code-Graph 云端服务的初衷。能力共享,数据自主;一次建图,长期受用。

京东科技开发者 750

【Coding生态】从代码托管到 AI 能力底座:与Coding一起共建 AI 研发生态

前两种框架能够很好地支撑对话式能力和预设流程式能力。它们适合基于提示词或预设工作流完成研发问答、知识查询、流程编排等任务。但在更复杂的研发场景中,仅仅“回答问题”还不够。当用户业务逻辑复杂时,一旦场景进入真实落地阶段,例如下载代码、修改文件、执行命令、安装依赖、运行测试、读取完整代码文件,或者与自有系统联动、将结果渲染到 Coding 页面、推送到京 ME,AI 应用需要的不只是知识能力,还需要真实的代码库操作能力和独立可执行环境。

京东科技开发者 764

GPT-5.6、ChatGPT Work 与 Codex 更新食用指南

三档模型当前都提供 1,050,000 tokens 上下文、922,000 tokens 最大输入和 128,000 tokens 最大输出,接受文本与图像输入、输出文本,并支持 web search、file search、Computer Use、MCP、Tool Search、Skills、Apply Patch 等工具。Work 可以读取你提供的文件,通过插件连接 Slack、Google Drive、SharePoint、邮箱、日历、CRM 或项目系统,调用获批工具,并在执行中展示进度。

京东科技开发者 853

把业务流程沉淀成高质量 Skill 的实践路径

使用Record & Replay创建的Skill,尽管创建流程简单,但它的本质实际是让 AI 去操作页面,这不但有可能影响我们对电脑的操作,还有可能无法稳定复现。创建Skill时,可以使用 Codex 的 Record & Replay 插件,把一次手工操作录下来,再让 AI 生成可复用流程。刚开始切换时,很容易遇到接口报错,可以让Codex排查原因进行优化,直到可以稳定执行;补充相应业务背景,说明这件事为什么要做,谁会用,输入从哪来,输出给谁看。电脑休眠、关机、软件没开时,本地任务可能无法执行。

京东科技开发者 831

政企前台AI-Agent的架构实践:打造可复用的 AI 服务平台-【灯塔计划】

不止是爆火的龙虾,还是各种Skills,MCP、Agent,脱离的具体的场景谈方案,最后只会是一场空。这一套可复用的 AI 服务平台,截止目前,通过前后端对接规范文档,多项能力已快速接入到各个场域的不同端平台,大幅降低研发成本, 并且各业务线新场景的接入从原来的 “开发驱动” 转为 “配置驱动”,接入周期从天维度缩短至小时级。

京东科技开发者 851

京东 Oxygen xLLM 大模型推理引擎正式捐赠开放原子开源基金会,共建国产 AI Infra 生态

下一阶段 AI 基础设施的核心命题,不是简单的算力堆叠,而是让工程本身变得智能——让调度系统能自主感知负载特征并动态优化,让推理引擎能根据模型结构和硬件特性自动生成最优执行方案,让整个 AI 工程链路具备自感知、自决策、自优化的能力。未来,Oxygen xLLM 的项目官网、社区沟通渠道及微信社区将陆续向开发者开放,诚邀芯片厂商、模型厂商、云厂商、企业用户及个人开发者共同参与,让国产大模型推理引擎在开放生态中加速成长。硬件层,原生支持 GPU / NPU / MLU 多类 AI 芯片,深度适配国产芯片。

京东科技开发者 990

【京东云】全球首个!京东全栈开源JoyAI-VL-Interaction,让大模型从“一问一答”走向“边看边说”

开源一套系统,而不只是一个模型在实时视频流中,JoyAI-VL-Interaction每秒都会做一次判断,比如,继续观察、保持沉默,发现关键事件、主动回应,遇到复杂任务,交给后台Agent处理。一个好的AI 助手,不应该一直打扰用户,而应该知道什么时候该出现,什么时候该安静,以及什么时候自己解决,什么时候交由agent解决。深耕零售、物流、健康、工业等实体产业二十余年,京东拥有全球领先的物理世界运营网络,覆盖仓储、配送、门店、直播、客服、售后海量真实场景,每天都在发生人、货、场的实时互动。

京东科技开发者 1022

【京东云】京东市民服务又“上新”!这次是黑龙江“龙易办”

即日起,用户只需打开京东App,搜索“龙易办”,即可一键进入,在线办理公安、人社、医保、公积金、文旅、教育等30余项高频政务服务,真正实现“办事不出门,服务在指尖”。未来,京东市民服务还将持续拓展服务城市与覆盖领域,深入更多民生场景,以AI赋能公共服务,助力各地政府构建更加普惠、高效、智能的数字政务生态,让每一位市民都能享受到触手可及的美好生活服务。此外,京东市民服务还构建了丰富的城市智能体矩阵,覆盖政务服务、生活缴费、出行停车、健康管理、就业安居、财富规划等多元民生场景,持续提升城市服务智能化水平。

京东科技开发者 1034

【京东云】JoyBuilder首批接入!智谱GLM-5.2正式上线京东云

依托京东云自研推理框架,结合PD分离部署、KV Cache缓存、投机采样等推理优化技术,实现模型推理吞吐与响应效率的进一步提升,为开发者和企业用户带来更高效、更稳定的大模型服务体验。面向未来,京东云将持续深化 AI 基础设施与模型服务能力建设,携手模型厂商、开发者社区及产业伙伴,共同构建开放、多元、繁荣的 AI 生态。即日起,用户登录京东云官网,在 JoyBuilder 模型开发平台即可一键调用最新GLM-5.2模型,快速体验百万级上下文、更高效的智能体开发与代码生成等前沿能力。

京东科技开发者 1100
上一篇: 【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(入门篇)
下一篇: 【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(高级篇)
京东云开发者
京东云开发者 企业官方账号 企业官方账号
博客等级 码龄8年 1万+粉丝 2138原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值