


01 AI应用开发的门槛,不在入门那天,而在入门的方式
如果要在今年挑一个离钱最近的技术方向,我会毫不犹豫投大模型应用开发一票。岗位数量肉眼可见地往上翻,同等年限的工程师,只要简历上带 AI 项目的痕迹,薪资普遍能高出三到四成。
所以后台总有人来问:我想转 AI,从哪儿开始?
问得多了,我发现一个规律——越是科班出身、越觉得"我底子在"的人,越倾向于自己摸索。理由听起来也很扎实:教程满地都是,框架文档写得那么全,看起来能有多难。
但三个月后再聊,画风通常是这两种:
一部分人还在跟环境死磕——显卡驱动、Python 版本、依赖冲突,一周一周地耗;另一部分人把官方 Demo 跑通了,截了个图,就觉得这事儿不过如此,然后……就没有然后了。
真不是你们不行。是绝大多数教程都在绕开一个事实:
AI这行的门槛,从来不在"你什么时候开始",而在"你从哪个口子进去"。
很多人对这行的想象,还停留在"调几个接口 + 写几段提示词"。但你去看那些真正把 AI 项目送上线的人,他们每天在干的事完全是另一回事。企业愿意砸高薪招大模型应用开发工程师,本质上是在买下面这三样东西:
🧠 RAG(检索增强生成)
给模型接一根"说实话的管子"。企业文档、产品手册、行业规范、法务条款,先检索出来再喂给模型——让回答有出处、能追溯,而不是张口就来。
🤖 Agent 智能体
把 AI 从"你问我答"推到"自己干活"。工具调用、环境反馈、多步规划,串成一条能真正跑完的任务链。这一步跨过去才叫"应用",跨不过去,你做的只是个聊天窗口。
🔧 模型微调(Fine-tuning)
用垂直领域的数据给模型"开小灶"。LoRA、QLoRA 这一套吃透,制造、医疗、金融这些行业的专属模型才有得谈。
这三样,我习惯叫它"铁三角"。少任何一个角,项目都撑不起来——要么答不准,要么动不了手,要么成本高到根本没法上线。
至于怎么学,我的建议一直没变:先让它跑起来,再回头问为什么。
先看到反馈,动力就有了;有了动力再去啃"为什么要这么切分"“为什么换这个 embedding 效果就变了”,理解速度快得多。反过来,先闷头啃三个月论文再动手的人,我见过的,八成折在半路。
02 AI 开发岗的钱,到底夸张到什么程度
空谈机会没意思,直接摆数据。
AI 相关岗位这两年在疯狂扩招,尤其是一线大厂和刚拿到融资的 AI 公司。三到五年经验、手上真做过项目的人,开到 50K × 20薪 这个量级,已经不算什么新闻了。
〔图片:薪资数据截图〕
我知道有人会想:这波热度是不是泡沫。说实话,某些岗位确实有泡沫。但泡沫挤掉之后留下来的,是那批真能把模型塞进业务流程里的人——他们的价格,只会更贵。
03 为什么程序员转 AI,比"从零开始学"的人更吃香
有个误解特别普遍:转 AI 就得把过去清零,从头做人。
恰恰相反。你的工程经验,在这波 AI 落地里是最缺的东西。
现在市面上不缺会调参数、会跑 Notebook 的人,缺的是能把一个"效果还不错的模型"变成"敢放到生产环境的产品"的人——而这,恰恰是写了几年代码的程序员最擅长的活。
按方向对号入座:
💻 后端开发(Java / Python / Go)——服务拆分、并发控制、容错降级,几乎可以原样平移到 Agent 的工具编排和兜底策略,转型成本最低的一群人。
🎨 前端开发——AI 产品的交互体验至今还是一片荒地,"懂前端 + 懂 AI"的组合,市面上少得可怜。
🔧 运维 / DevOps——模型部署、推理加速、GPU 成本控制,说白了就是你的老本行换了一台机器。
📊 数据工程师——RAG 的本质就是数据管道加知识库治理,你天天写的那套 ETL 换个名字就能接着用。
📱 移动端开发——端侧模型、AI 原生 App 正在起量,这块的人才储备几乎是空的。
🎯 被35岁这道坎卡住的程序员——AI 能力是目前最实在的一条延长职业周期的路。
🎓 计算机专业应届生——直接以 AI 应用开发作为入行切口,起跑线就比同龄人往前挪了一大截。
我自己是写了六年 Java 后端转过来的。回头看,真正让我跨过去的不是学会了哪个新框架,而是想明白一件事:原来那些年踩过的坑,换个说法全都能用。
这波 AI 跟以往任何一次风口都不一样。以前是"先知先觉的人吃肉,后知后觉的人喝汤";这一次更接近——能落地的人往上走,只看热闹的人被重新定价。
方向给你指到这儿了,数据也摆在这儿了。
剩下的,就一个字:动。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
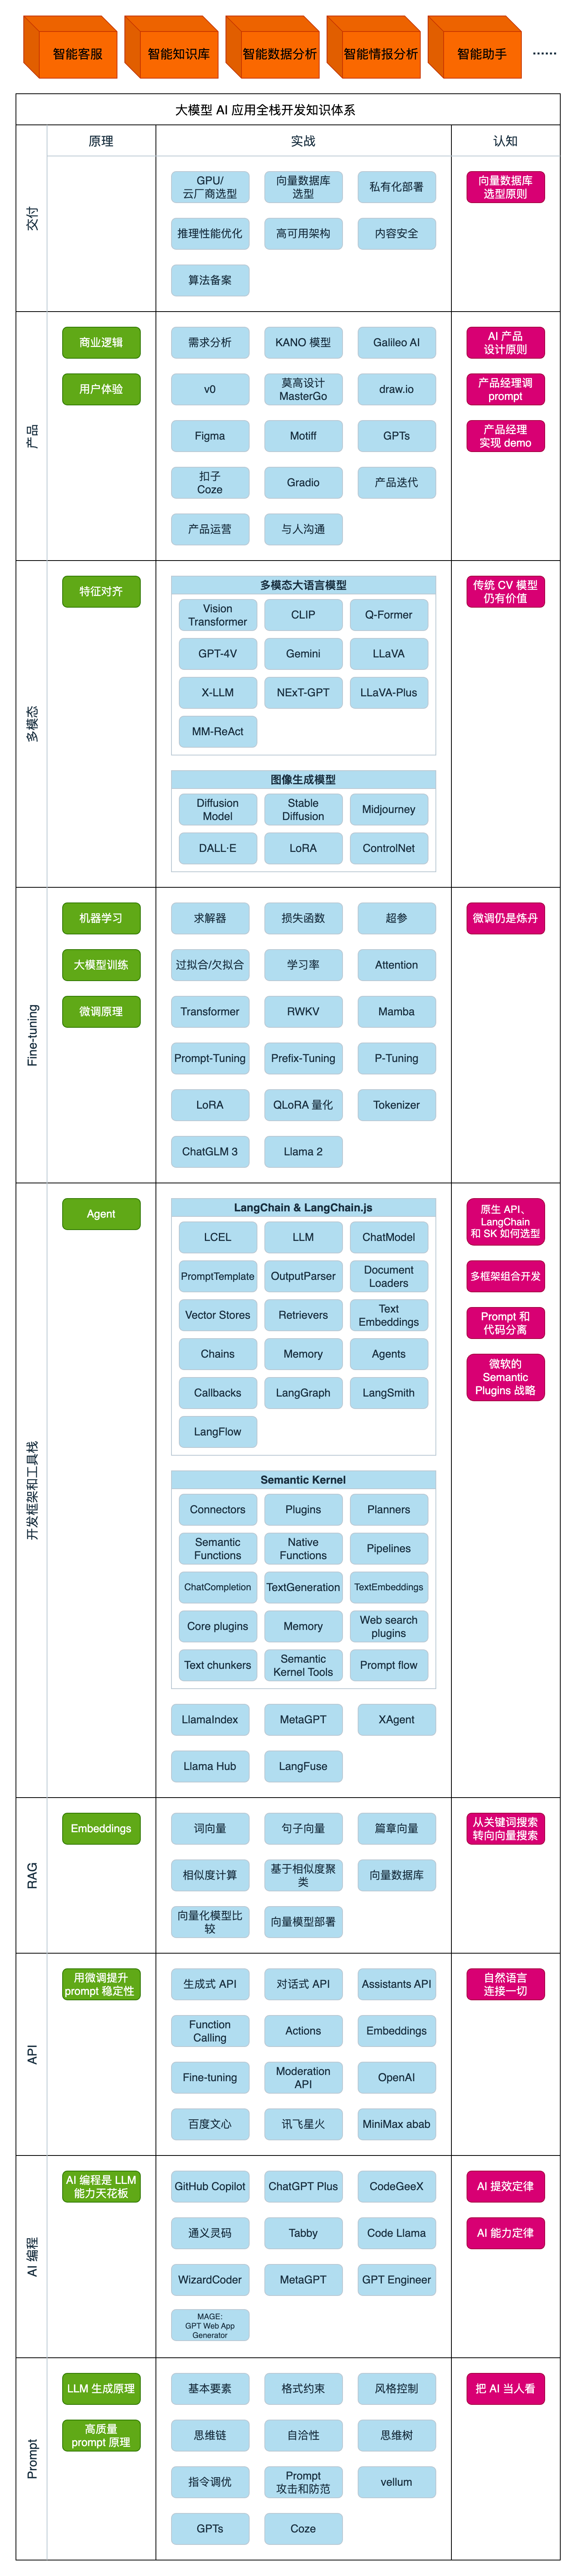
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
混进去之后,怎么站稳
当然,混进去只是第一步。进去之后站不站得住,看的是补课速度。分享我自己验证过的三条:
1. 抓住「最小闭环」,别贪全。 别想着把 LLM 全栈知识都学一遍。先把你负责的那条链路完整跑通——哪怕就是「一个提示词调一个模型存一个结果」。跑通之后你就在团队里有了立足点,剩下的按需补。我第一周干的事,就是把我们的 Agent 主循环用 200 行代码重写了一遍,从此开会我敢说话了。
2. 把 80% 的旧能力用足。 Agent 开发里大部分活是工程活:接口设计、状态管理、异常处理、部署监控。这些后端老本行直接用。你的差异化不是「比同事更懂模型」,而是「比同事更能把系统做稳」。前一点你短期追不上,后一点你天生就有。
3. 每天输出一点东西。 我开始做「30 天挑战」之后发现,写下来是最好的补课方式——写不出来的地方,就是没学懂的地方。而且记录本身会让你在团队里快速建立「这个人很懂」的错觉,好吧,也不全是错觉。


 扫一扫


 66

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


