LLM推理过程:​Prefill+Decode

为什么大语言模型推理要分成 Prefill 和 Decode?深入理解这两个阶段的真正意义 Prefill 阶段是语言模型推理中的第一个步骤,它负责处理你输入的所有上下文内容(prompt),为后续生成打下基础。“请解释一下 Transformer 的原理。这句话会被 tokenizer 编码为一串 token,比如["请", "解释", "一下", "Trans", "##former", "的", "原理", "。"]。然后这些 token 会进入 Transformer 模型进行前向传播。重点来了 👇。 阅读详情

一、 推理过程:Prefill+Decode

大型语言模型(LLM)的推理过程通常分为两个核心阶段:Prefill(预填充)阶段和Decode(解码)阶段。这两个阶段在计算特性、资源需求和优化策略上存在显著差异,共同构成了LLM从输入处理到文本生成的完整流程。以下是详细解析:


1. Prefill(预填充)阶段

目标:处理输入的完整提示(prompt),为后续生成准备上下文和中间状态。
核心任务:

  • Token化与嵌入:将输入文本转换为token序列,并通过嵌入层映射为高维向量(形状为 [batch_size, seq_len, hidden_dim])。
  • 全量注意力计算:对输入的所有token执行并行自注意力计算,生成每个token与上下文的关联性(注意力矩阵)。输入是完整的上下文,因此模型会执行一次完整的 masked self-attention.
  • KV Cache初始化:缓存每一层Transformer的Key(K)和Value(V)向量,避免后续重复计算(会在 decode 阶段被反复使用)。 在这里插入图片描述

计算特性:

  • 高度并行:输入token已知,可一次性计算所有位置的注意力(矩阵-矩阵运算)。
  • 计算密集型:复杂度为O(n²)(n为输入长度),GPU算力利用率高,但长提示处理延迟显著。
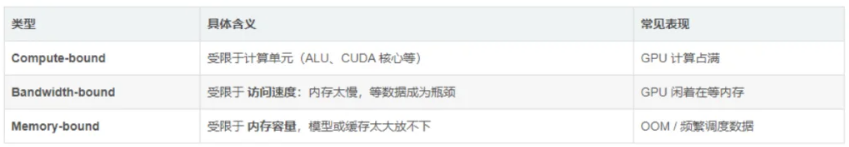
  • 显存占用:KV Cache的存储需求随输入长度平方增长,可能成为瓶颈。

优化技术:

  • FlashAttention:优化注意力计算的内存访问模式,减少显存开销。
  • 分块处理:将长输入分段处理,降低单次计算压力。

2. Decode(解码)阶段

目标:基于Prefill阶段的KV Cache,自回归生成输出token,直至达到终止条件(如EOS标记或最大长度)。
核心任务:

  • 增量生成:每次仅处理最新生成的1个token,通过查询(Q)与历史KV Cache计算注意力。
  • KV Cache更新:将当前token的K/V向量追加到缓存中,供下一步使用。
  • 输出选择:通过解码策略(如贪心、采样或集束搜索)从概率分布中选择下一个token。

计算特性:

  • 严格串行:每步依赖前序所有token,无法并行(矩阵-向量运算)。
  • 内存带宽限制:需频繁加载历史KV Cache,计算量小但内存访问压力大。
  • 显存增长:KV Cache随生成序列线性扩展,长文本生成可能耗尽显存。

优化技术:

  • KV Cache压缩:分页存储(PagedAttention)、低精度量化(INT8)。
  • 推测解码:用小模型预生成草稿,大模型并行验证,加速2-3倍。
  • 动态批处理:合并多个请求的生成步骤,提高GPU利用率。

3. 阶段对比与协同

特性 Prefill阶段 Decode阶段
输入形式 完整prompt(已知所有token) 逐token生成(每次1个)
并行性 高度并行 严格串行
计算瓶颈 算力限制(Compute-bound) 内存带宽限制(Memory-bound),每生成一个 token,都需要访问所有历史的 KV Cache(多层、多头)
主要优化目标 减少长提示处理延迟 提高生成吞吐量、降低显存占用

协同关系:Prefill为Decode提供初始KV Cache,两者通过缓存复用实现高效推理。例如,Prefill生成的KV Cache使Decode阶段避免重复计算prompt的注意力,将总复杂度从O(n³)降至O(n²)。

在这里插入图片描述


4. 其他可选阶段

部分框架会扩展以下阶段:

  • 后处理(Post-Processing):对生成结果进行过滤、重排序或格式化。
  • 缓存管理:动态释放或压缩历史KV Cache,适应长对话场景。

总结

LLM推理的两阶段划分源于输入与输出的计算特性差异:Prefill充分利用并行性处理已知输入,Decode则通过串行和缓存复用实现高效生成。这一设计平衡了计算效率与资源消耗,是LLM落地应用的核心优化基础。

二、Prefill阶段解析

LLM(大语言模型)在 Prefill(预填充)阶段 主要完成对输入提示(prompt)的预处理和上下文理解,为后续的生成(Decode)阶段奠定基础。以下是该阶段的核心任务和实现细节:


1. 输入处理与Token化

  • 文本转Token序列:将用户输入的文本(如“请解释Transformer的原理”)通过分词器(Tokenizer)转换为模型可理解的Token ID序列。
  • 嵌入映射:每个Token通过嵌入层(Embedding Layer)转换为高维向量(如768维或1024维),形成形状为 [batch_size, seq_len, hidden_dim] 的输入矩阵。

2. 全量注意力计算与KV Cache生成

  • 并行计算:Prefill阶段的核心优势是能够并行处理所有输入Token。模型通过自注意力机制(Self-Attention)计算每个Token与之前所有Token的关联性(包括自身),生成注意力分数矩阵。
    • 数学过程:对每个位置的Token,计算其Query(Q)与所有Key(K)的点积,经Softmax归一化后加权求和Value(V)向量。
  • KV Cache初始化:每一层Transformer计算的Key和Value向量被缓存,形成KV Cache。这是后续Decode阶段复用中间结果、避免重复计算的关键。

大模型推理中Prefill与Decode、KV Cache三者说明 Prefill 阶段对输入 Prompt 并行编码,一次性构建KV Cache,属于计算密集型任务。Decode 阶段逐 token 迭代生成,复用KV Cache避免重复计算,属于显存带宽密集型任务。KV Cache是自回归推理的核心基石,用显存换时间,实现两阶段衔接与高效生成。PD 分离通过任务解耦、异构硬件、异步调度、独立批处理,解决传统一体化推理的资源冲突与利用率低下问题,是当前云端大模型推理服务的主流工程优化方向。 阅读详情

相关推荐

大模型内容分享(二十八):mnn-llm: 大语言模型端侧CPU推理优化

在大语言模型(LLM)端侧部署上,基于 MNN 实现的 mnn-llm 项目已经展现出业界领先的性能,特别是在 ARM 架构的 CPU 上。目前利用 mnn-llm 的推理能力,qwen-1.8b在mnn-llm的驱动下能够在移动端达到端侧实时会话的能力,能够在较低内存(

之乎者也·的博客 4905

LLM推理性能优化:深入解析Prefill与Decode阶段的核心机制

在大语言模型推理过程中,Prefill(预填充)和Decode(解码)是两个核心阶段,深刻影响着模型的响应速度和资源效率。Prefill阶段负责并行处理整个输入提示,属于计算密集型任务,其性能瓶颈主要在于GPU的算力,决定了用户感知的首字延迟。Decode阶段则逐个生成输出令牌,属于内存带宽密集型任务,其效率受限于对KV Cache的高速读写,直接影响生成速度。理解这两个阶段的不同特性,是优化推理服务、降低延迟和成本的关键。在实际应用中,通过算法优化、模型压缩和高效的内存管理策略,可以显著提升性能。例如,使

weixin_30340617的博客 559

LLM推理性能优化:Prefill与Decode阶段深度解析

Transformer架构的自回归特性将大型语言模型(LLM)推理过程划分为Prefill和Decode两个关键阶段。Prefill阶段通过并行处理输入提示(prompt)建立初始上下文,其计算密集型特性主要消耗在矩阵乘法(GEMM)和自注意力计算上。Decode阶段则以序列化方式生成输出token,其性能瓶颈主要来自KV Cache的内存访问。理解KV Cache的存储机制和访问模式是优化推理延迟的关键,特别是在处理长序列时。这些优化技术在RAG(检索增强生成)工作流和边缘计算场景中尤为重要,可通过算子融

weixin_30908103的博客 507

大语言模型推理机制:Prefill、Decode与KV Cache解析

Transformer架构中的推理过程涉及prefill和decode两个关键阶段,以及KV Cache这一核心技术。Prefill阶段通过并行处理输入序列建立上下文表示,其计算复杂度与输入长度平方成正比。Decode阶段采用自回归方式逐个生成token,依赖KV Cache缓存历史注意力计算结果,将复杂度从O(n²)降至O(n),显著提升长文本生成效率。KV Cache通过优化显存使用,使大模型推理在工程实践中成为可能,例如GPT-4生成2000字文章时显存占用从理论64GB降至8GB。这些技术在代码生成

weixin_30298497的博客 388

MATLAB新手必看:Stewart平台运动学逆解从入门到实战(附完整代码)

本文详细介绍了如何使用MATLAB实现Stewart平台的运动学逆解,从基础原理到完整代码实现,涵盖并联机器人的数学建模、MATLAB编程和Simulink集成。通过实战案例和可视化分析,帮助新手快速掌握Stewart平台的运动学逆解技术,适用于机器人学和控制理论领域的研究与应用。

dream的博客 546

学术版GPT安装教程——保姆版(附带原生GPT注册教程)

学术版GPT图文安装教程

DBenD的博客 2万+

详解ReID的各部分组成及Trick——基于FastReID

这一系列博客将基于京东开源的FastReID进行扩充,详细介绍了ReID的各个组成部分,一些有用的Trick,评价指标,常用数据集等,详细内容见下方的链接,总结不易,如有理解不正确之处,麻烦各位批评指正。 一、FastReID的中的baseline文件配置 二、Training strategy 三、Pre-processing 四、Backbone 五、Aggregation 六、Head 七、Loss 八、Distance Metric 九、Post-processing 十、Evaluation 十一

藏晖的博客 9151

AI大模型实战——模型测评:如何评估大模型的表现

大模型评测体系解析:从数据集到基准测试 本文系统梳理了大模型评测的关键要素。在数据集方面,重点介绍了C-Eval等中文评估套件,强调数据质量需通过人工验证保证。评测维度涵盖自然语言理解、知识推理、代码生成等核心能力。基准测试作为标准化评估方法,Glue、SuperClue等平台提供了公平比较的依据。文章指出厂商自评榜单存在水分问题,建议关注第三方评测。同时解析了少样本和零样本两种prompt模式的应用场景差异。最后解释了"SOTA"这一术语在描述模型最优性能时的应用价值。整体呈现了大模型

小志的博客 878

从权限对象到业务角色:把 SAP Authorization Object 讲清楚,并用 ABAP 写对一次 AUTHORITY-CHECK

摘要:SAP权限管理的核心在于Authorization Object(授权对象),它通过组合最多10个授权字段来精确控制用户访问权限。关键要点包括:1) 授权对象与ACTVT字段(如01创建/02修改/03显示)的配合使用;2) ABAP中AUTHORITY-CHECK语句的四种常见返回码(0通过/4字段不匹配/12无权限/40无效用户);3) 系统自动执行的S_TCODE事务码检查;4) 自定义授权对象时应遵循"最少且足够"原则,优先复用标准对象。在RAP和OData场景中,权限检查

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 240

ClaudeCode入门01-环境安装(小白入门:手把手教你配置,超简单的一种接入方式)

文手把手教你从零搭建 Claude Code 开发环境。针对国内网络现状,我们采用 OpenRouter + Claude Code Router 的方案,支持支付宝/微信充值,无需科学上网即可完成配置。内容涵盖 Node.js 安装(macOS/Windows/Linux)、OpenRouter 注册与充值、Claude Code 和 Router 安装配置,以及一键启动脚本的编写。跟着截图一步步操作,10分钟搞定全部环境!

yueyeguzhuo的专栏 271

计算机毕设项目一:基于卷积神经网络、resnet、VGG化妆品分类识别 完整代码数据可直接运行

计算机毕设项目一:基于卷积神经网络、resnet、VGG化妆品分类识别 完整代码数据可直接运行

650

GaussDB本地安装手册(主备模式)

如果实例状态是Normal,则安装成功。三节点集中式配置文件。

Sebastien23的博客 2608

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

上一篇: Lookahead:Trie 树(前缀树)
下一篇: Verilator总结
jerwey
博客等级 码龄22年 1926粉丝 159原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
