yolo v2 训练自己数据集遇到的问题

限时加码!20+主流AI编程工具免费用 购周边加赠Coding Plan Lite,Claude Code、Cursor等即刻畅享,学习进阶更高效! 阅读详情

1.CUDA Error: out of memory darknet: ./src/cuda.c:36: check_error: Assertio `0' failed.


需要修改所使用的模型cfg文件中的subdivision的参数。

由subdivisions=8改成subdivisions=64。
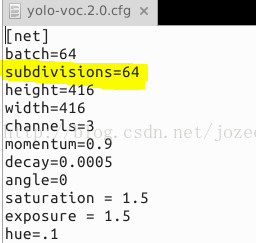

subdivision:这个参数很有意思的,它会让你的每一个batch不是一下子都丢到网络里。而是分成subdivision对应数字的份数,一份一份的跑完后,在一起打包算作完成一次iteration。这样会降低对显存的占用情况。如果设置这个参数为1的话就是一次性把所有batch的图片都丢到网络里,如果为2的话就是一次丢一半。


yolov8推理时(检测、分割、追踪)cuda out of memory问题的解决方案(已解决) YOLOv8检测的时候显存爆了?别着急,看这里! 阅读详情

相关推荐

yolov2 - tiny模型训练识别

兴趣尝试,训练一下自己的数据集做图像识别。 darknet网络下载 下载地址:https://pjreddie.com/darknet/yolov2/ 直接按照步骤,里面有不同yolo版本的基本配置文件,区别是使用什么样的预训练模型就用什么样的weight文件,下载好后直接放在darknet目录下。 尝试运行: cd darknet ./darknet detector test cfg/voc.data cfg/yolov2-tiny-voc.cfg yolov2-tiny-voc.weights da

m0_48941999的博客 3751

YOLOX训练:显存足够,但依旧CUDA out of memory(Tried to allocate 5.58 GiB,8.00 GiB total capacity,6.40 GiB free)

刚刚我尝试训练自己的yolox_s模型,但我batch_size不管改成多少,甚至改成1,都直接报CUDA out of memory,我很苦恼,这里明明显示我的显存是足够的,但是依旧OOM。 训练命令如下: (mypytorch) E:\YOLOX>python tools/train.py -f exps/example/yolox_voc/yolox_voc_s_bm.py -d 1 -b 2 --fp16 -o -c weights/yolox_s.pth 我在这里加载了GitHub的预训练

ELSA001的博客 2万+

YOLOv3 CUDA Error: out of memory darknet: ./src/cuda.c:36: check_error: Assertion `0‘ failed.

Batch Size(批量大小):批量大小是指在每次模型训练中同时处理的输入样本数量。Subdivisions(子分区):子分区是将每个批量进一步划分为更小的部分进行处理的方式。通过使用子分区,可以减少 GPU 内存的需求,特别是当批量大小较大时。把subdivisions=8改成subdivisions=16,64,最好都是2的指数,并且要保证batch是subdivisions的整数倍。方法二:修改尾行 random 值 (默认值为1),此处修改为 :random=0 (注:yolov3共有三处)

nicole3375的博客 502

Yolov8模型训练报错:torch.cuda.OutOfMemoryError

最近在使用自己的数据训练Yolov8模型的时候遇到了很多错误,下面将逐一解答。 如何解决:torch.cuda.OutOfMemoryError的报错问题

大雾的小屋的博客 7422

深度学习论文翻译 -- YOLO-V2

本文翻译为目标检测论文系列:YOLO-V2YOLO9000:Better, Faster, Stronger 论文链接:https://arxiv.org/pdf/1612.08242v1.pdf 开源代码:http://pjreddie.com/yolo9000/ Abstract 我们引入新的目标检测模型,YOLO9000,顶级的实时目标检测系统,可以检测超过9000类目标。首先,我们介绍针对YOLO-V1的改进工作,在前面工作的基础上,提出新的方法和思想。改进的YOLO-V2模型,在PASCAL

DAOCHI 392

关于YOLO_V2训练自己的数据出现nan的问题

    最近用yolo_v2训练自己的数据,网上有很多关于yolo训练的博客,操作起来到不麻烦,于是跟着步骤一步一步的来,但是很不幸,训练的时候出现了这种结果,如图经过反复的检测,最后发现是自己数据的问题。        因为我是对视频的关键帧进行标注,然后再把关键帧转化为图片,同时把bounding box的位置信息保存在图片中,然而因为我的视频标注工具的bounding box对应原始视频的...

小白的成长史 7720

YOLO-v2-pytorch 项目常见问题解决方案

YOLO-v2-pytorch 项目常见问题解决方案 1. 项目基础介绍 本项目是基于论文 "You Only Look Once: Unified, Real-Time Object Detection" 的 PyTorch 实现。YOLO(You Only Look Once)是一种流行的目标检测算法,以其快速和准确的特点在计算机视觉领域得到广泛应用。本项目使用了 Pyth...

gitblog_00135的博客 820

YOLOv3训练过程中重要参数的理解和输出参数的含义

原英文地址:https://timebutt.github.io/static/understanding-yolov2-training-output/ 原中文翻译地址:https://blog.csdn.net/dcrmg/article/details/78565440 最近有人问起在YOLOv2训练过程中输出在终端的不同的参数分别代表什么含义,如何去理解这些参数?本篇文章中我将尝试着...

浩瀚之水的专栏 1738

YOLO教程之训练自己的数据

官网: http://pjreddie.com/yolo/  相关文章: http://arxiv.org/abs/1506.02640  源代码: https://github.com/pjreddie/darknet.git 以上都是V2,V2比V1占显存少,训练更快,指标更好,论文还没有出来,代码里面也有V1的相关文件可以直接用。官网的教程写得挺好,首先要仔细看了再看其他教程。 教程

eloise_29的博客 5912

YOLO 2训练自己的数据记录

本教程以YOLO_v2为例,检测三种不同的剪刀。 系统:Ubuntu16.04, 基于 Darknet。 安装Darknet darknet官网都有很详细的步骤darknet 在终端输入: git clone https://github.com/pjreddie/darknet cd darknet make 数据集的准备 图片和标签 (1) 采用jpg格式的图像,在名字上最好像使用voc一样...

weixin_41054702的博客 727

YAD2K实战教程:如何在自定义数据集训练YOLO_v2目标检测模型

YAD2K是一个强大的90% Keras/10% TensorFlow实现的YOLO_v2目标检测框架,让你能够轻松将Darknet模型转换为Keras格式并在自定义数据集上进行训练。本教程将手把手教你如何利用YAD2K框架训练自己的目标检测模型,从数据准备到模型评估的完整流程。 ## 🔧 环境配置与项目准备 首先,你需要克隆YAD2K仓库并配置开发环境: ```bash git clon

gitblog_00994的博客 726

<实战指南>从DOTA v2.0遥感数据集YOLO目标检测模型训练<全流程解析>

本文提供了一份完整的实战指南,详细解析了如何利用DOTA v2.0遥感航拍数据集训练YOLO目标检测模型。内容涵盖从数据集理解、数据准备、环境搭建、模型选择到训练配置与性能分析的全流程,并针对遥感图像中的小目标检测等挑战给出了实用建议,帮助读者快速上手遥感目标识别任务。

gitlab7runner的博客 417

【计算机视觉】【神经网络与深度学习】YOLO v2 detection训练自己的数据2

1. 前言   关于用yolo训练自己VOC格式数据的博文真的不少,但是当我按照他们的方法一步一步走下去的时候发现出了其他作者没有提及的问题。这里就我自己的经验讲讲如何训练自己的数据集2.数据集   这里建议大家用VOC和ILSVRC比赛的数据集,因为xml文件都是现成的,省去很多功夫。当然除非你是个执着的孩子就想凭借着非人的毅力和追逐斗鸡眼这种个性特征而自己去标记label。

ZhangPY的专栏 1866

YOLO自定义数据集GPU训练全链路实战指南

目标检测是计算机视觉的核心任务之一,其工程落地关键在于模型、数据与硬件的协同优化。YOLO系列凭借轻量高效、部署友好等优势,成为工业级检测首选;而真实场景中,90%的训练失败源于数据格式混乱、GPU环境错配或超参缺乏物理依据。本文聚焦‘自定义数据集+本地GPU’这一高频刚需场景,系统解析数据清洗校验、CUDA/PyTorch版本兼容性诊断、Ultralytics统一训练范式、多卡NCCL通信调优等硬核环节,覆盖RTX 30/40系及A100等主流NVIDIA显卡适配策略,并融入mosaic增强、copy_p

weixin_34246529的博客 303

物体检测算法调研——YOLO9000

    作者pjreddie的主页有YOLO v2的详细说明,包括模型和配置文件、使用方法、训练方法等。但是介绍中没有提及9000模型,本文对该模型的相关内容做一个汇总。    YOLO 9000是论文'YOLO9000: Better, Faster, Stronger'中提出的,该模型的训练方法是文章的一个创新点,其使用效果是Stronger论点的由来。下文将对上述两点内容进行详细介绍。   ...

hzhj的博客 486

win10下YOLO v3的安装

本文章所要讲的是如何在win10环境下安装yolov3,然后用官方的权重文件去做识别 【注】非常重要的一点是大家在进行之前首先要看一下自己的显卡是否是NVIDA显卡,如果不是NVIDA显卡就先放一放吧 接下来进行入正题: 一、所需环境和工具: 1.win10系统 2.Visio Studio2019,yolov3支持20122013,2015,高版本需要下载相关的数据集 3.OpenCV3.4...

qq_33287871的博客 3083

YOLO数据集一键拆分工具:自由设定训练集与验证集比例

直接运行data_split.py就能把YOLO格式的图像和对应txt标签文件,按你指定的比例(比如8:2、7:3或9:1)自动分开成train和val两套数据;图片和标签严格配对,不会错位,支持YOLOv5/v8/v10通用目录结构;生成的train/val文件夹里自动包含images和labels子目录,还带train.txt和val.txt路径列表文件;能随机打乱顺序,也能固定随机种子保证每次结果一致;输出路径可以自定义,不依赖任何第三方库,复制即用,专为模型训练前的数据整理环节设计。

x1y2z的博客 250

YOLO车辆行人四类别数据集构建与训练实战指南

目标检测是计算机视觉领域的核心任务之一,在交通监控、辅助驾驶和安防系统中应用广泛。而数据集的构建与质量把控,往往决定了模型性能的上限。本文从数据集设计出发,详细讲解行人、轿车、公交车与货车四类目标的定义逻辑,以及图片采集、清洗、标注与格式转换的完整流程。在此基础上,围绕YOLOv5/YOLOv8等主流检测框架,介绍数据增强策略、训练参数调优、评估指标解读与小目标漏检、类别混淆等工程实践问题的解决方案。无论是算法选型还是训练流程优化,这套方法都能帮助开发者快速构建可落地的车辆行人检测系统,并有效迁移至不同业务

weixin_28221501的博客 298

YOLO v2算法详解

论文: YOLO9000:Better,Faster,Stronger 论文链接:https://arxiv.org/abs/1612.08242 YOLO9000是CVPR2017的最佳论文提名。首先讲一下这篇文章一共介绍了YOLO v2YOLO9000两个模型,二者略有不同。前者主要是YOLO的升级版(关于YOLO v1的介绍可以参考:YOLO v1算法详解),后者的主要检测网络也是YO...

AI之路 6万+
下一篇: YOLOv2目标检测_单目标_训练自己数据全过程(自用)
jozeeh
博客等级 码龄10年 3粉丝 2原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值