【2025版】最新Dify入门教程,零基础入门到精通,收藏这篇就够了

VIP Dify使用教程(创建应用) Dify的安装部署我已经写过了,简单的模型配置我也在前面进行了讲解,今天我们主要来讲讲如何使用Dify。 开通可读全文·1.2w 阅读·25 点赞·70 收藏 阅读全文

目录

一、Dify介绍

二、Dify本地部署

2.1 Dify源码下载

2.2 Docker Desktop 安装

2.3 Dify的运行

2.4 Dify的配置

2.5 Ollama

2.6 Dify关联Ollama

三、Dify核心功能

3.1 应用类型

聊天助手

提示词

变量

知识库

文本生成应用

Agent

Chatflow

工作流

3.2 工具篇

系统工具

自定义工具

导出DSL


一、Dify介绍

官方地址:Dify.AI · The Innovation Engine for Generative AI Applications

官方中文地址: Dify.AI · 生成式 AI 应用创新引擎

官方文档地址:产品简介 - Dify Docs
开源的 LLM 应用开发平台。提供从 Agent 构建到 AI workflow 编排、RAG 检索、模型管理等能力,轻松构建和运营生成式 AI 原生应用。

比 LangChain 更易用。

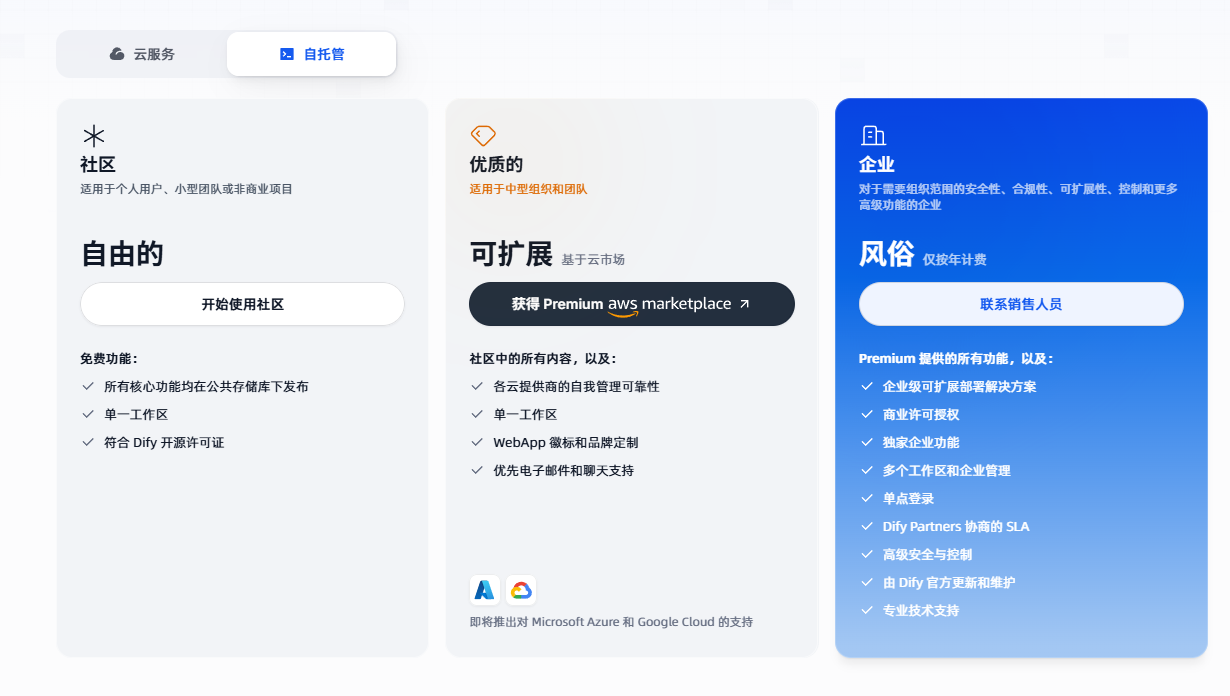
Dify提供的有2个版本,分别是:

  • 社区版

  • 商业版

对于我们来说我们使用社区版本就可以了,因为我们最终还是需要把Dify部署到我们的本地来使用的。

二、Dify本地部署

我们使用Dify的很大原因就是相比于Coze来说我们可以把Dify部署到我们的本地,同时能够更加灵活的来选择大模型和相关的插件来满足我们的需求。所以我们先来看看如何实现Dify的本地部署操作,这里我们使用的是社区版本。

2.1 Dify源码下载
进入到github地址后我们可以选择1.1.3的版本源码来下载到本地。
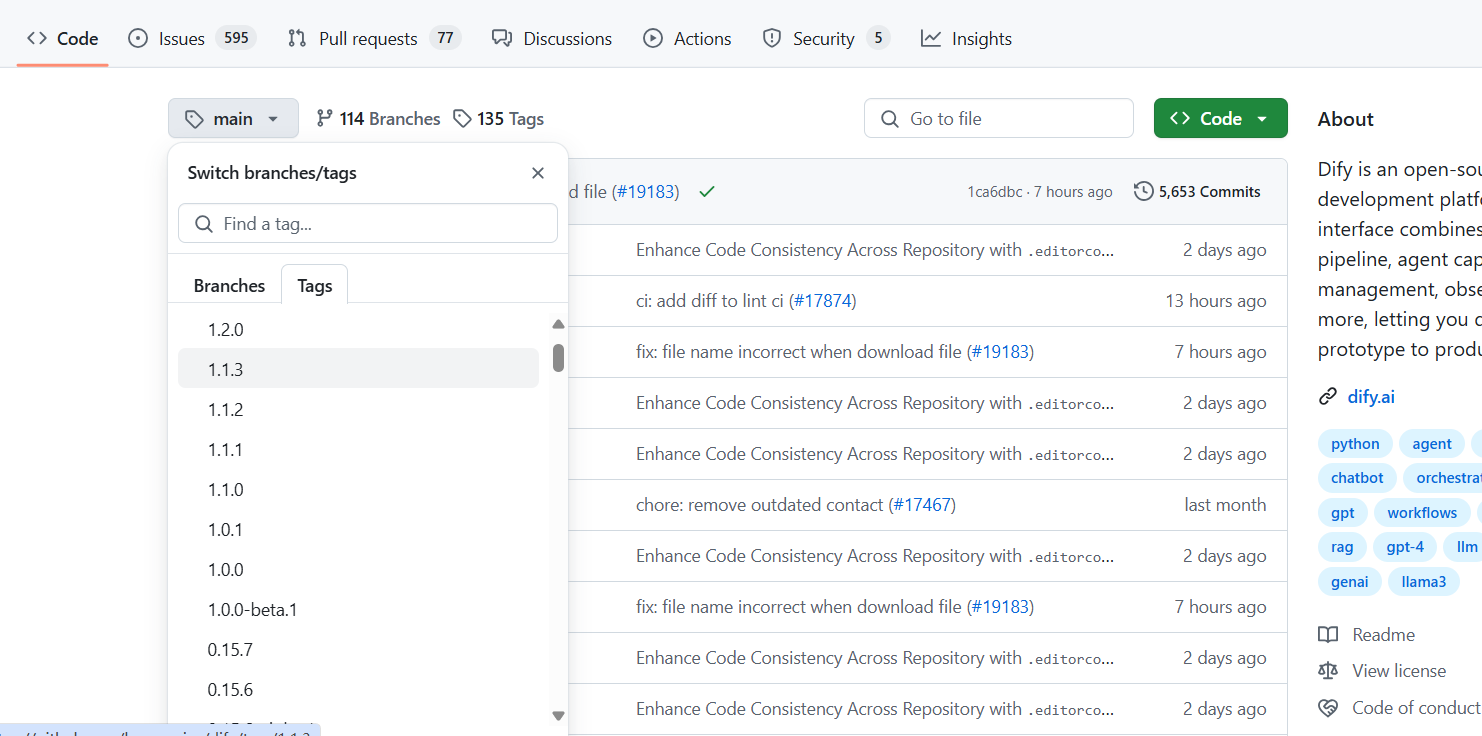
下载后解压缩出来即可。

进入源码中我们可以看到有个docker目录,把 .env.example 修改为 .env
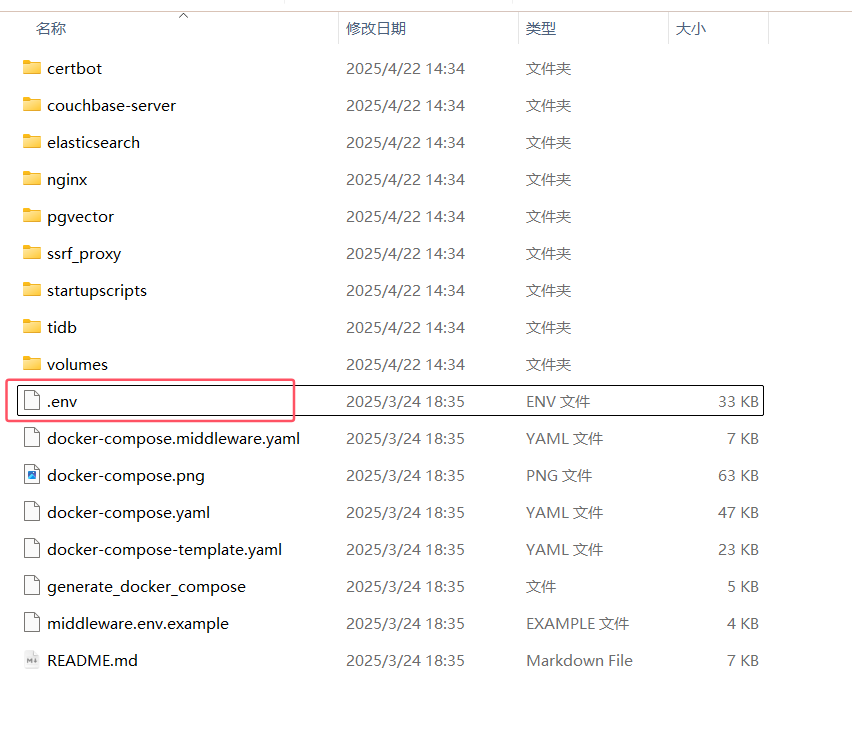
所以从这儿我们也可以看出要启动Dify的本地程序,我们只需要安装下Docker服务就可以了。

2.2 Docker Desktop 安装

下载地址:Docker Desktop: The #1 Containerization Tool for Developers | Docker
具体的安装过程参考这个地址:最新!Windows上安装Docker Desktop教程,并解决WSL问题并汉化_windows安装docker desktop-CSDN博客

2.3 Dify的运行

我们进入到Dify源码的docker目录中,我们需要先把 .env.example 修改为 .env。

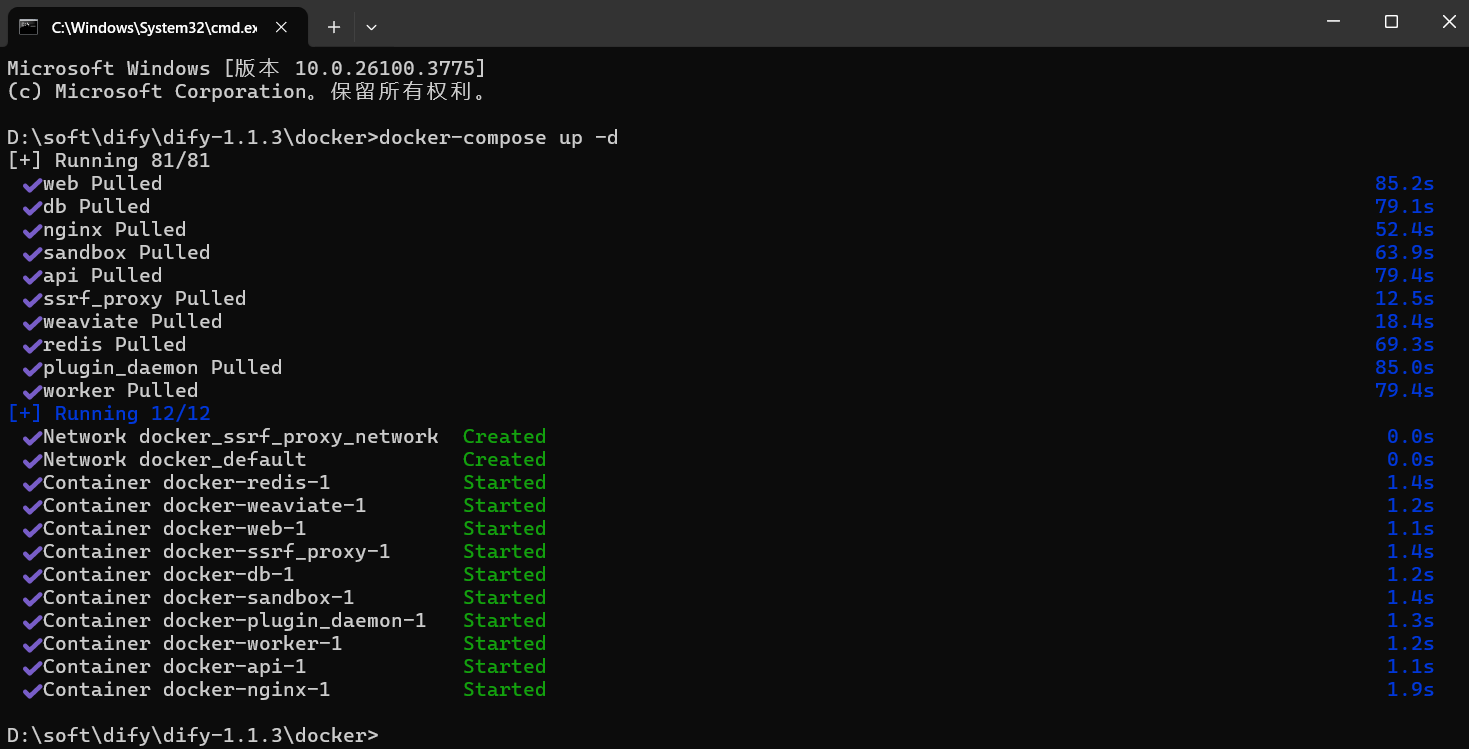
然后在目录地址中输入 cmd 然后在命令窗口中输入这个命令

docker-compose up -d

第一次执行的时候需要拉取相关的镜像地址,这块我们需要在docker desktop 中设置下代理地址:
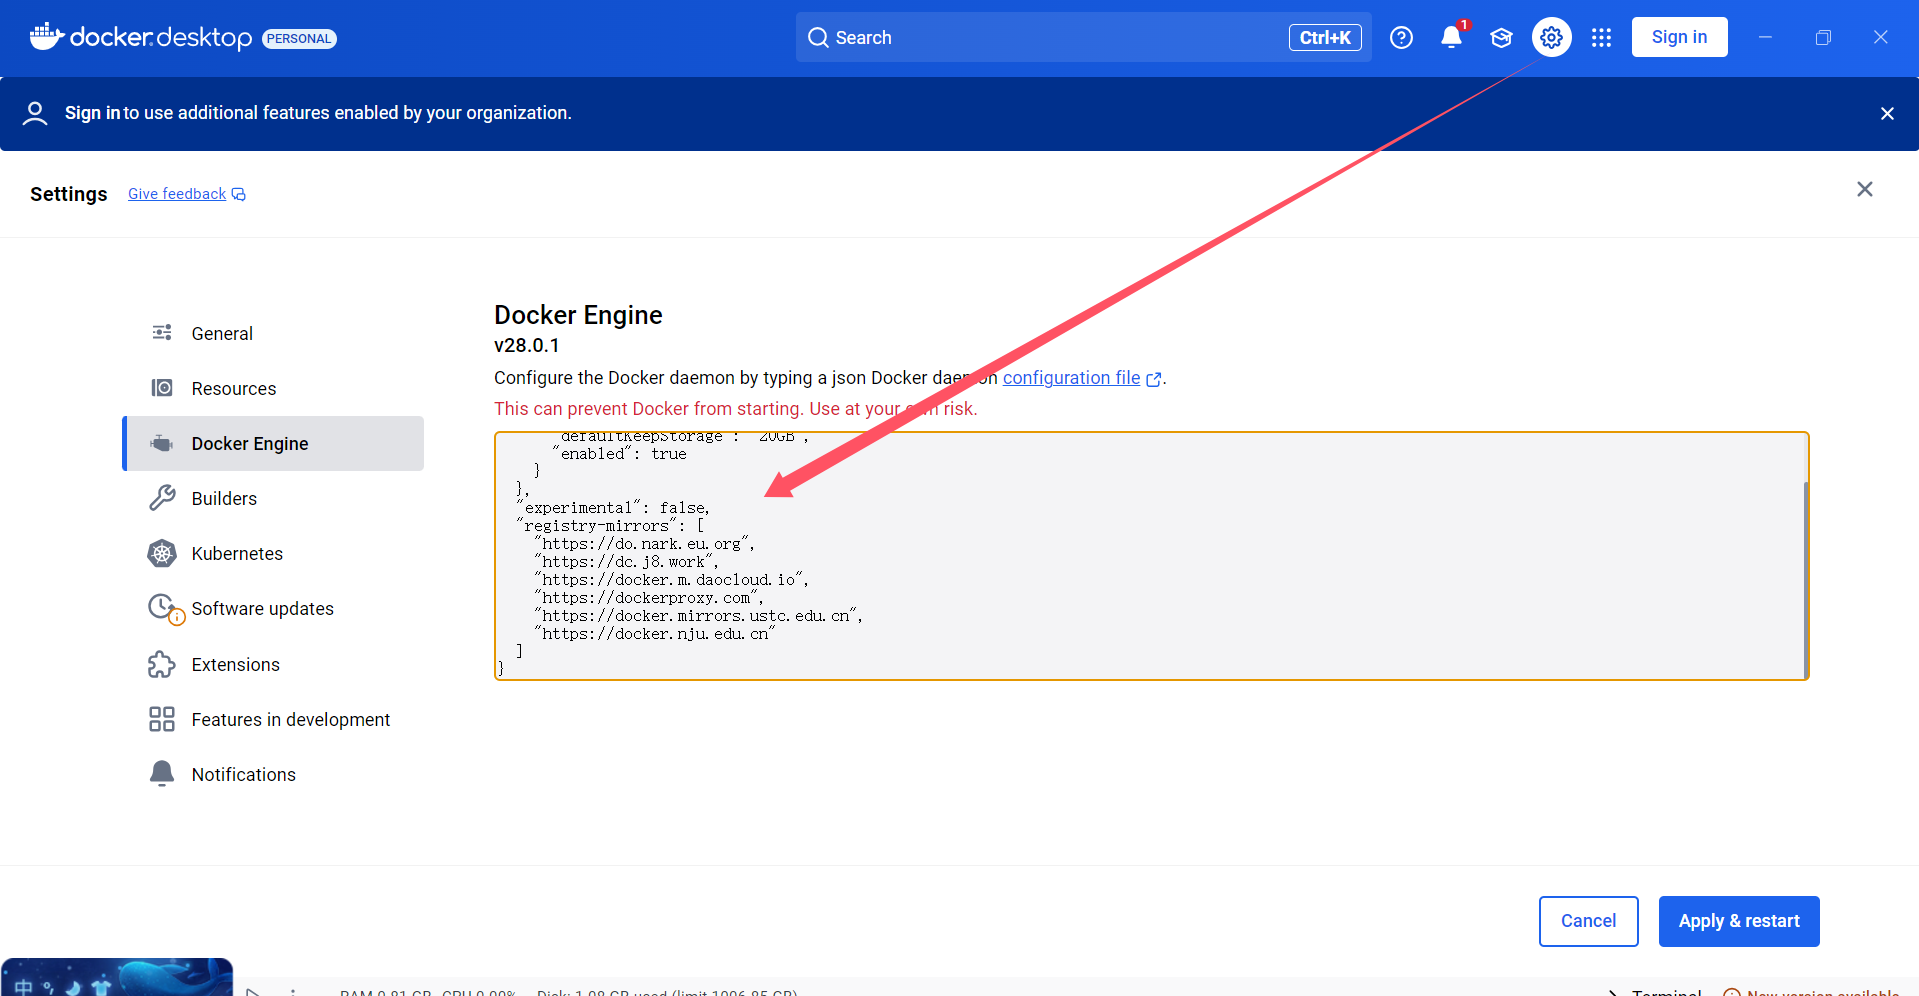
等相关镜像拉取完成后Dify就能正常的启动成功了。
2.4 Dify的配置

启动成功后在地址栏中输入 http://localhost/install 就可以访问了
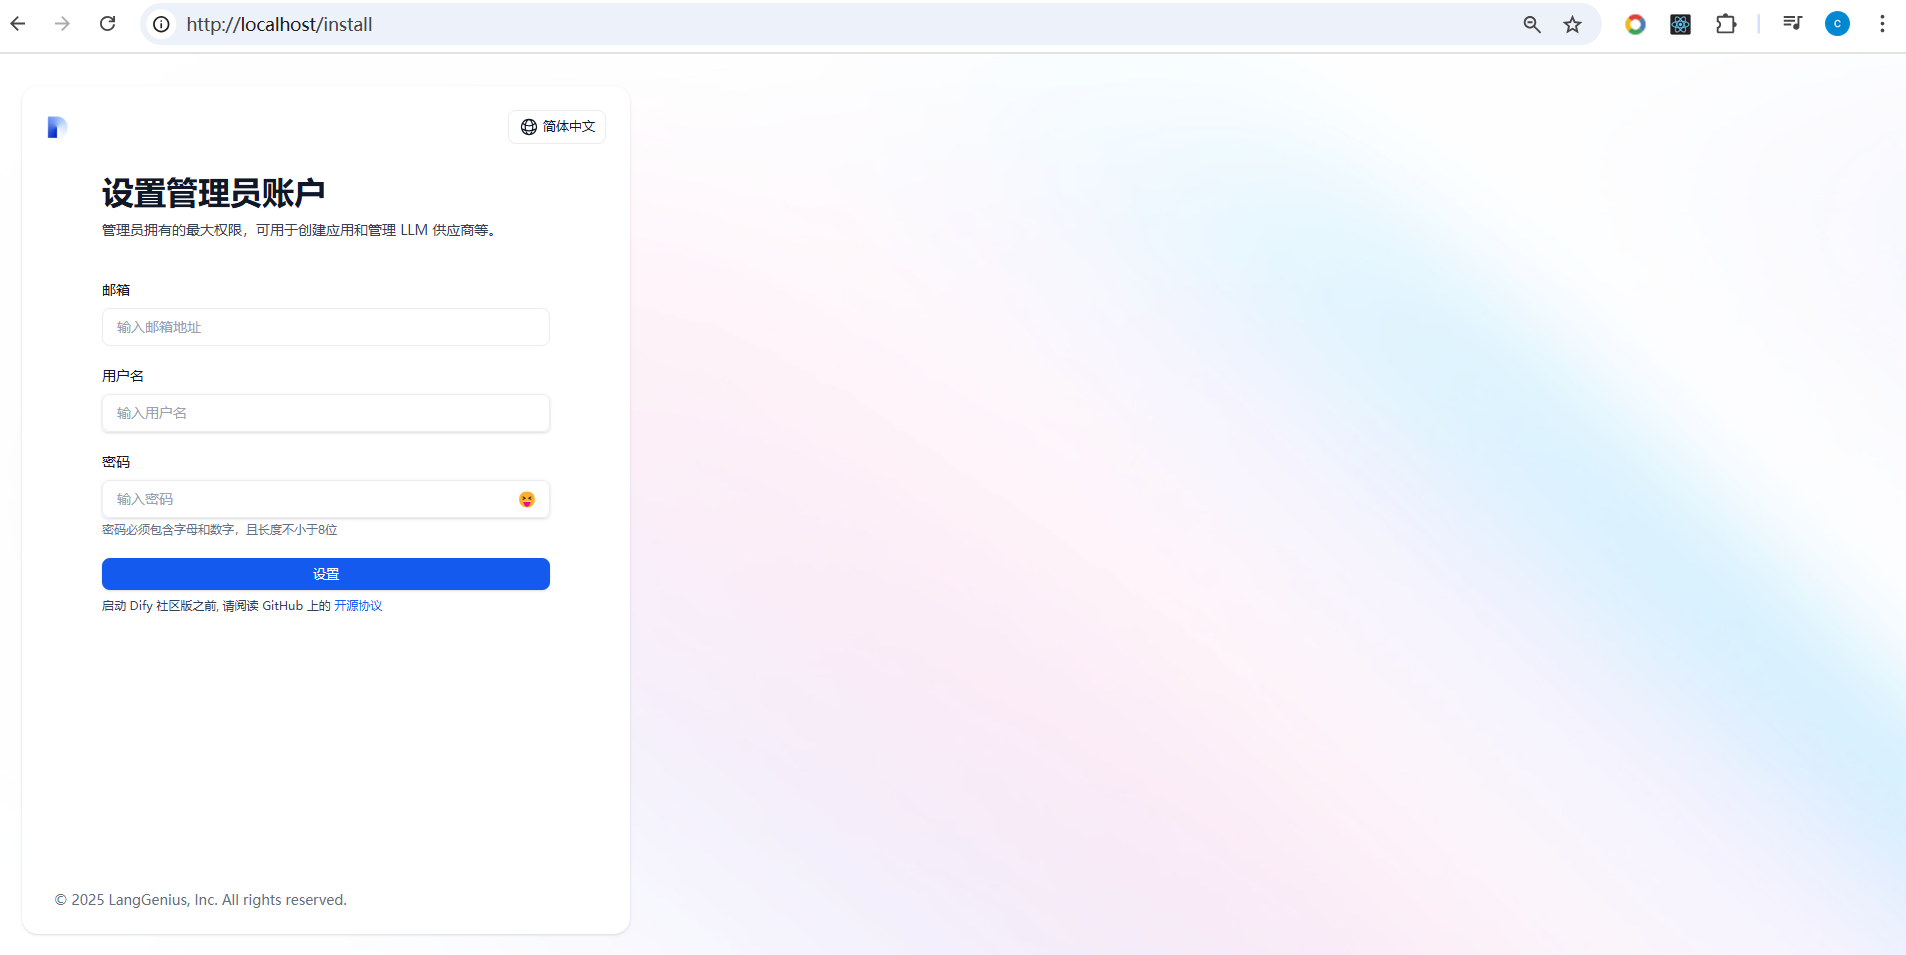
在这个界面设置自己的邮箱,用户名和密码,这块的信息需要自己记住哦,点击设置按钮后进入登录界面。

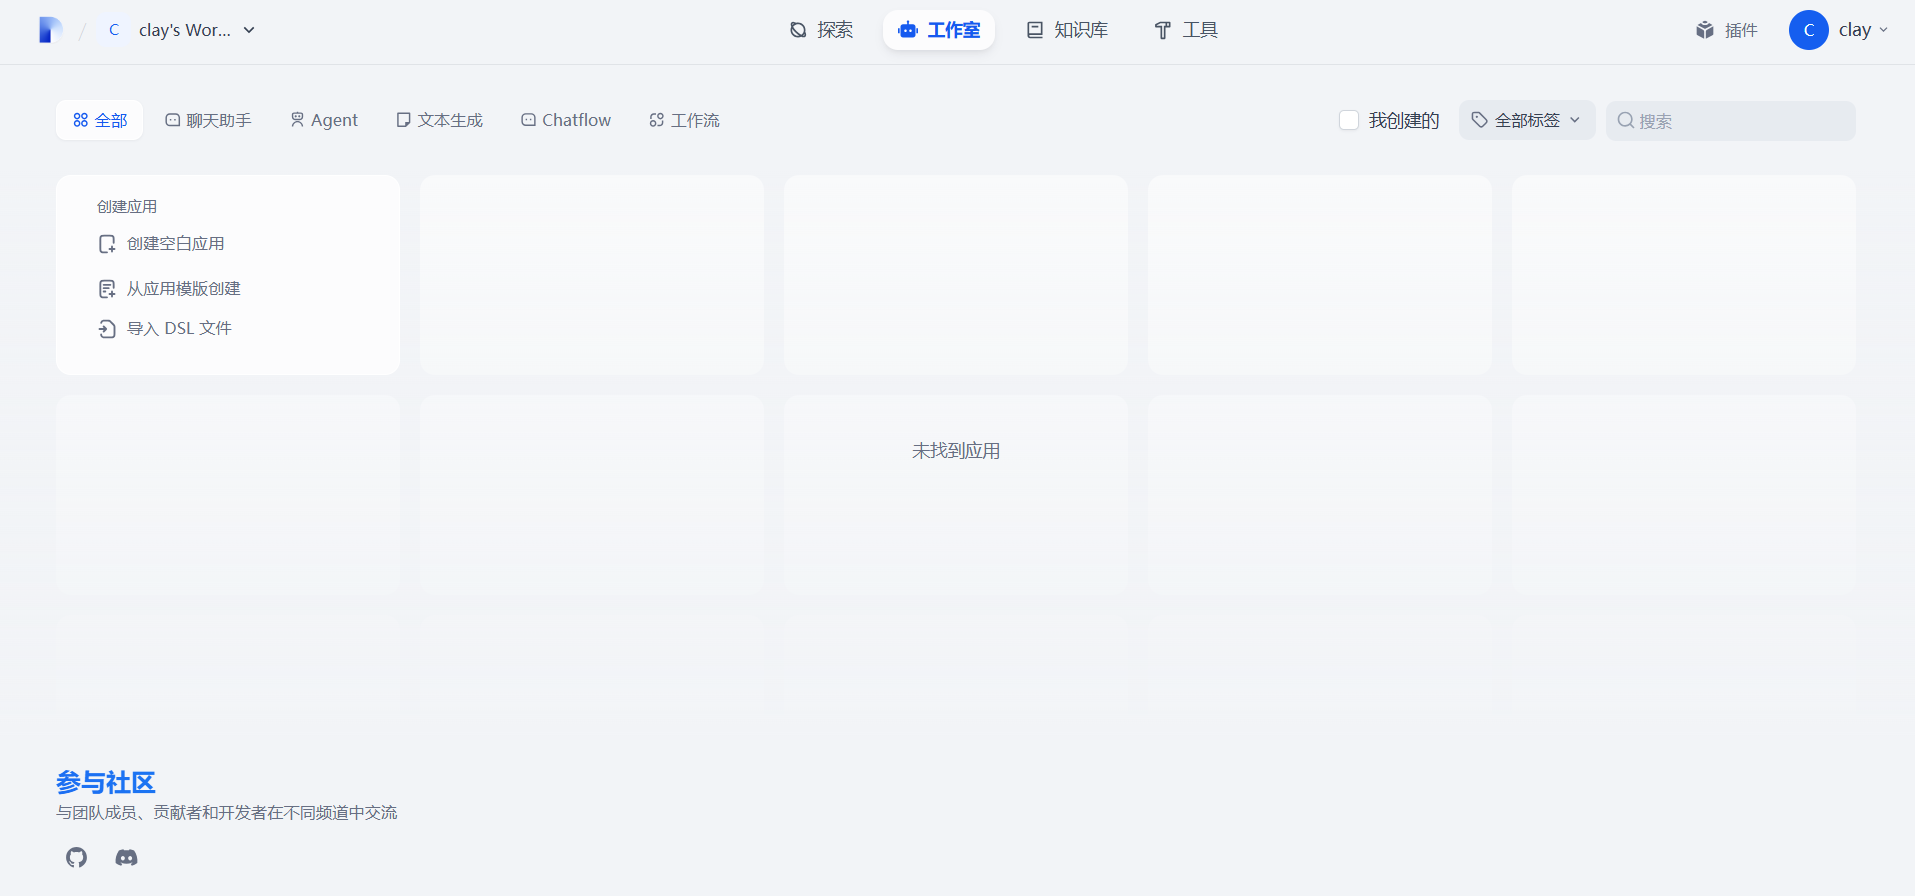
登录后,然后进入到Dify操作的主界面了。说明Dify已经安装成功并且可以使用了。
2.5 Ollama

Ollama

我们已经把Dify在本地部署了。然后我们可以通过Ollama在本地部署对应的大模型,比如 deepseek-r1:1.5b 这种小模型

Ollama 是一个让你能在本地运行大语言模型的工具,为用户在本地环境使用和交互大语言模型提供了便利,具有以下特点:

1)多模型支持:Ollama 支持多种大语言模型,比如 Llama 2、Mistral 等。这意味着用户可以根据自己的需求和场景,选择不同的模型来完成各种任务,如文本生成、问答系统、对话交互等。

2)易于安装和使用:它的安装过程相对简单,在 macOS、Linux 和 Windows 等主流操作系统上都能方便地部署。用户安装完成后,通过简洁的命令行界面就能与模型进行交互,降低了使用大语言模型的技术门槛。

3)本地运行:Ollama 允许模型在本地设备上运行,无需依赖网络连接来访问云端服务。这不仅提高了数据的安全性和隐私性,还能减少因网络问题导致的延迟,实现更快速的响应。
具体安装教程参考我另一篇文章:【全网最全最详细】Ollama本地部署DeepSeek-R1_ollama部署本地deepseel-CSDN博客

2.6 Dify关联Ollama

Dify 是通过Docker部署的,而Ollama 是运行在本地电脑的,得让Dify能访问Ollama 的服务。

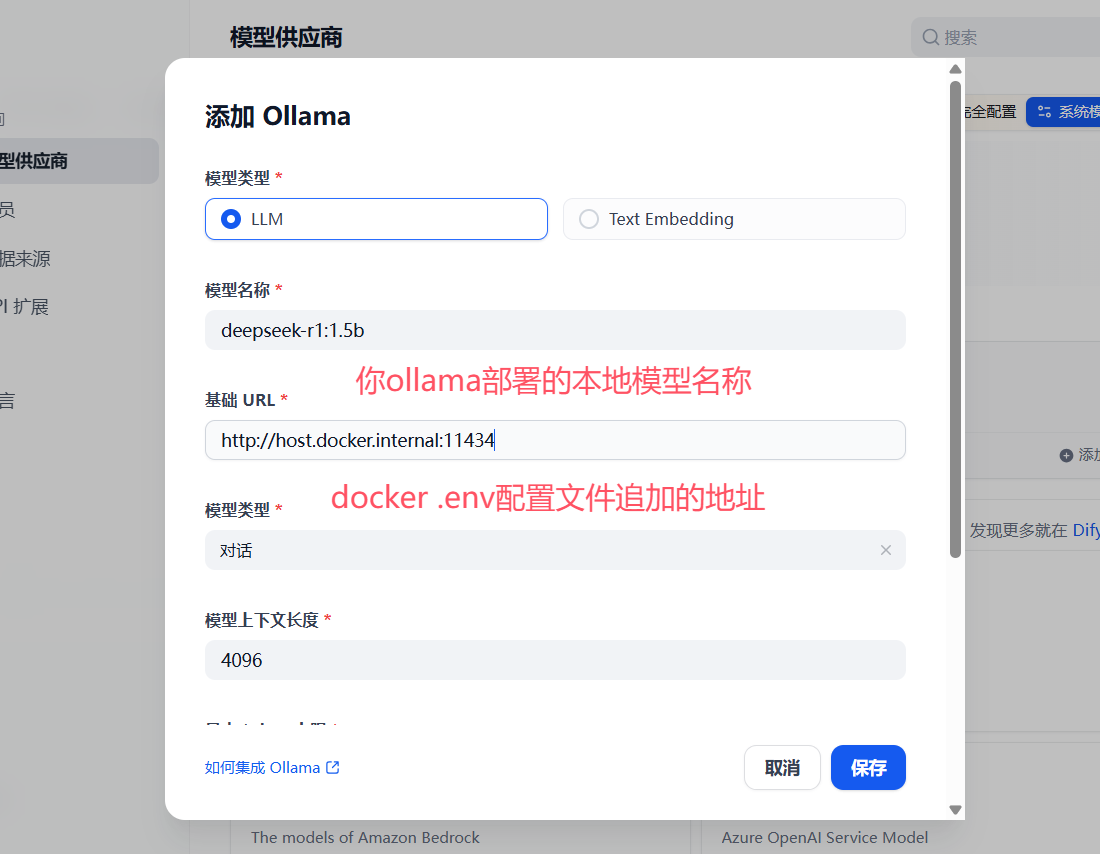
在Dify项目-docker-找到.env文件,在末尾加上下面的配置:

# 启用自定义模型
CUSTOM_MODEL_ENABLED=true
# 指定 Ollama 的 API地址(根据部署环境调整IP)
OLLAMA_API_BASE_URL=host.docker.internal:11434

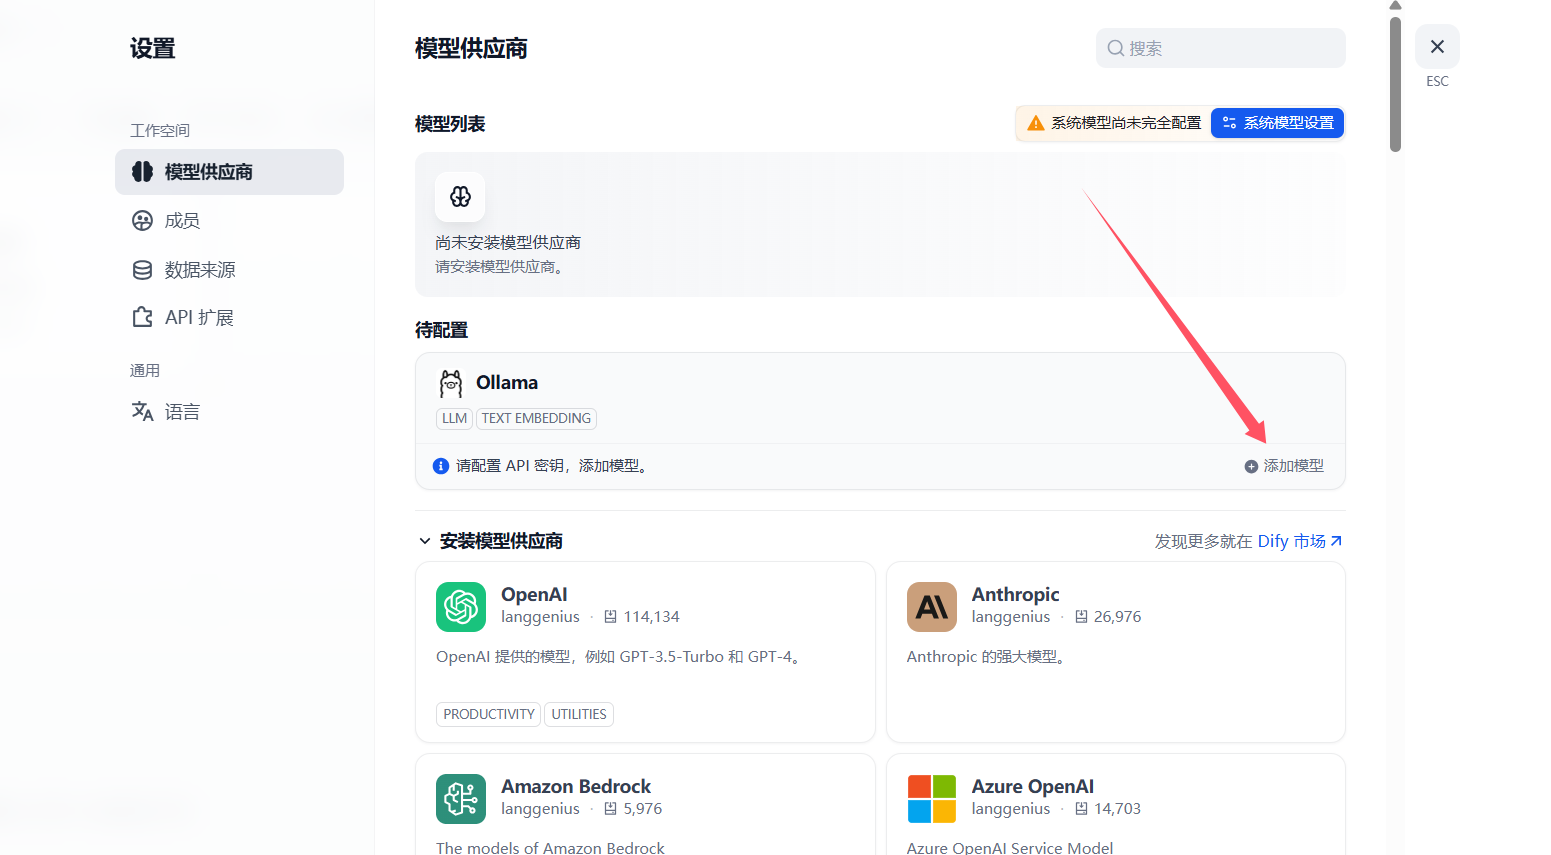
然后在模型中配置

在Dify的主界面 http://localhost/apps ,点击右上角用户名下的【设置】
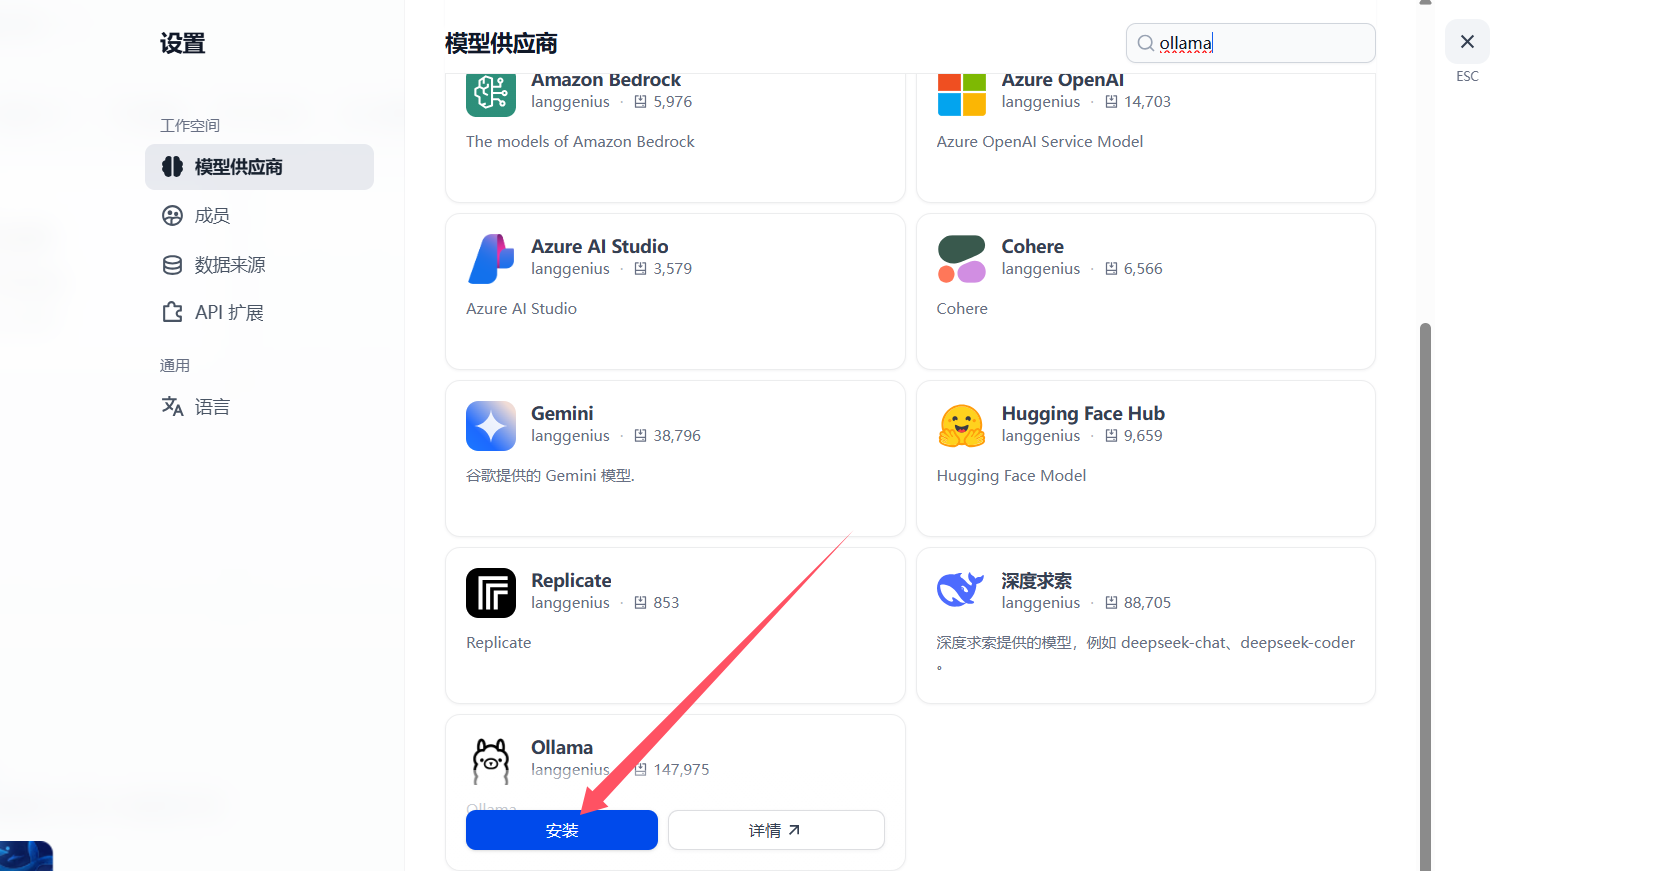
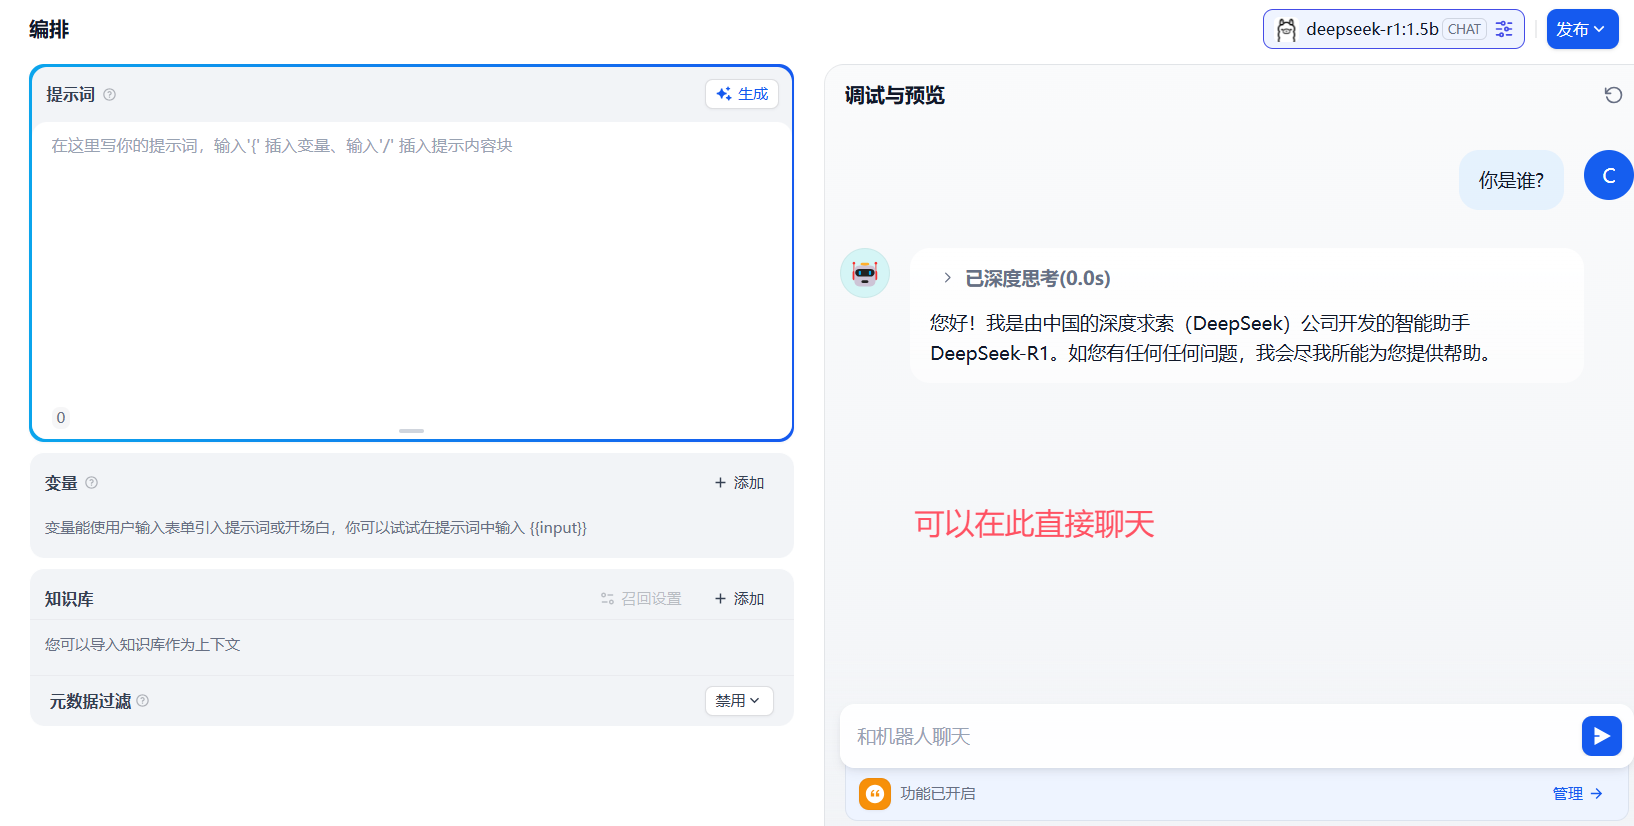
添加成功后的:
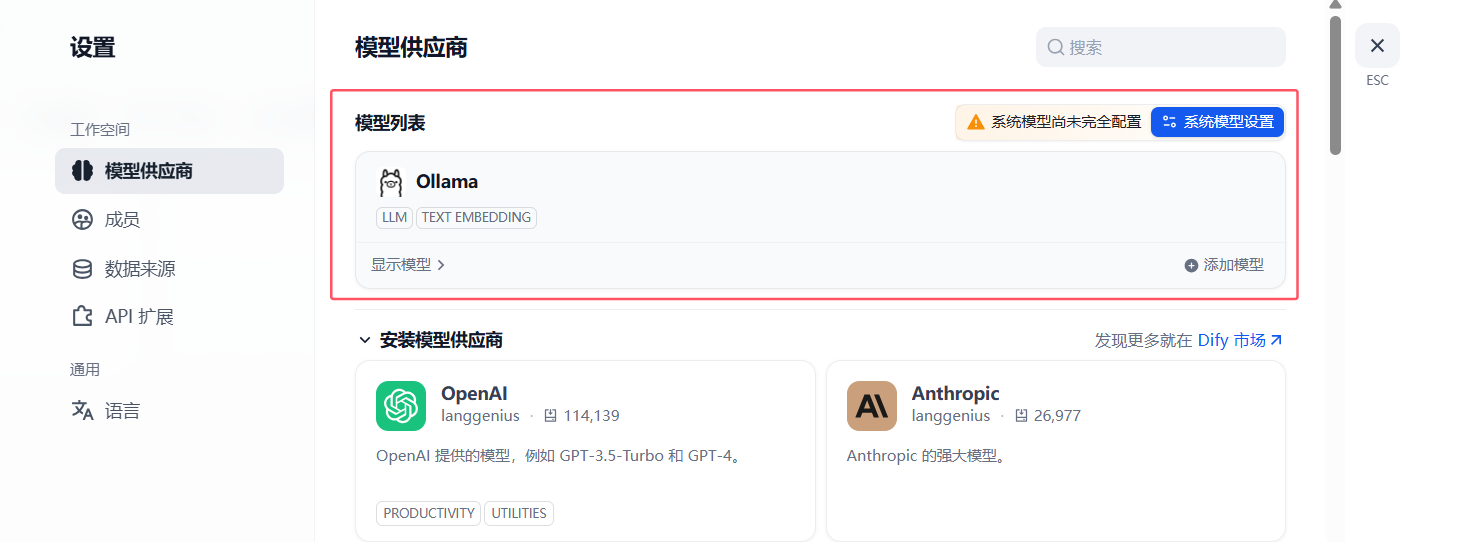
三、Dify核心功能

3.1 应用类型

在Dify中我们可以创建五种类型的应用。我们分别来介绍下。

聊天助手

基于 LLM 构建对话式交互的助手,这个非常简单,我们可以来创建一个简单的聊天助手应用来看看效果。
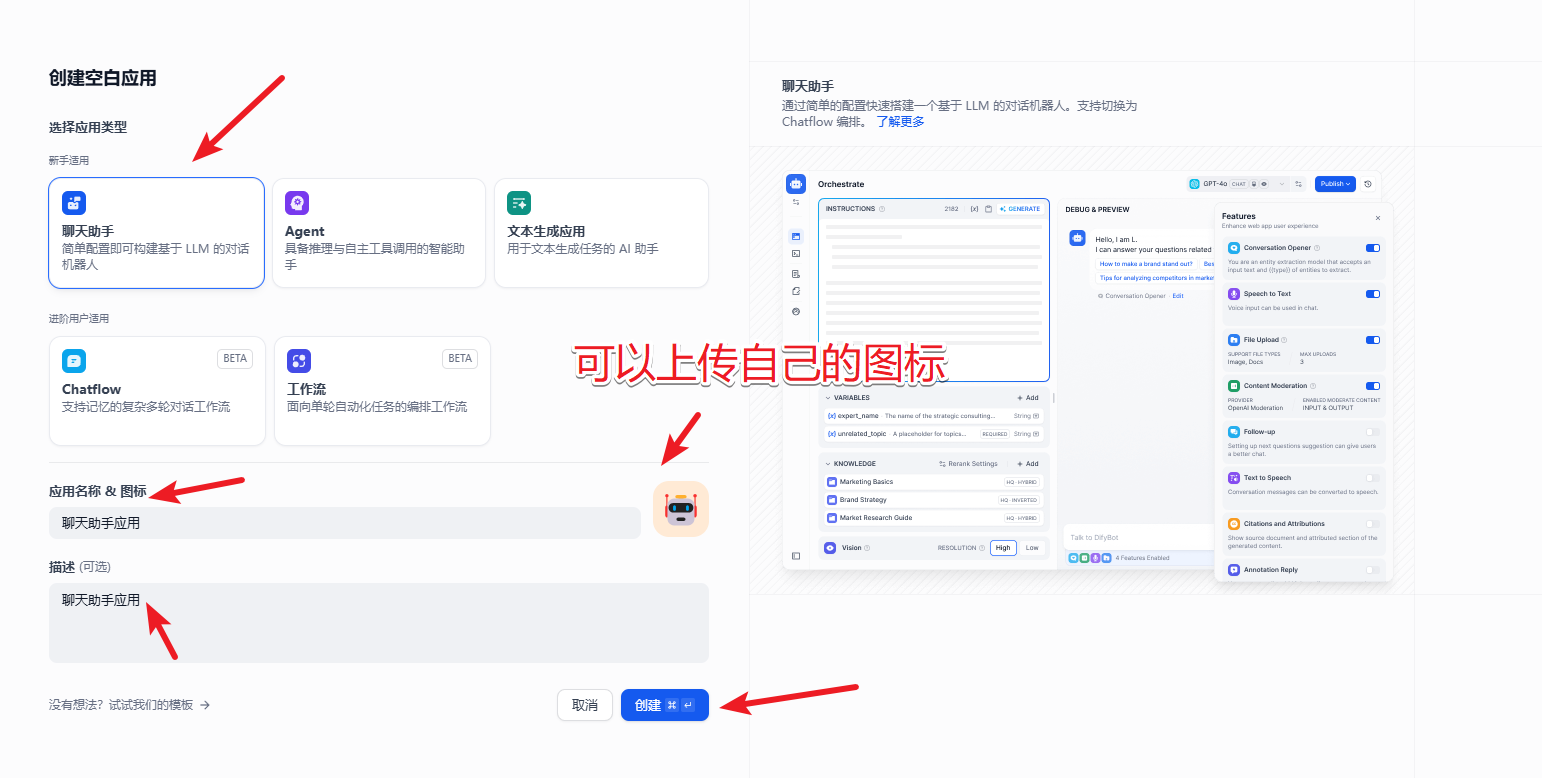
提示词

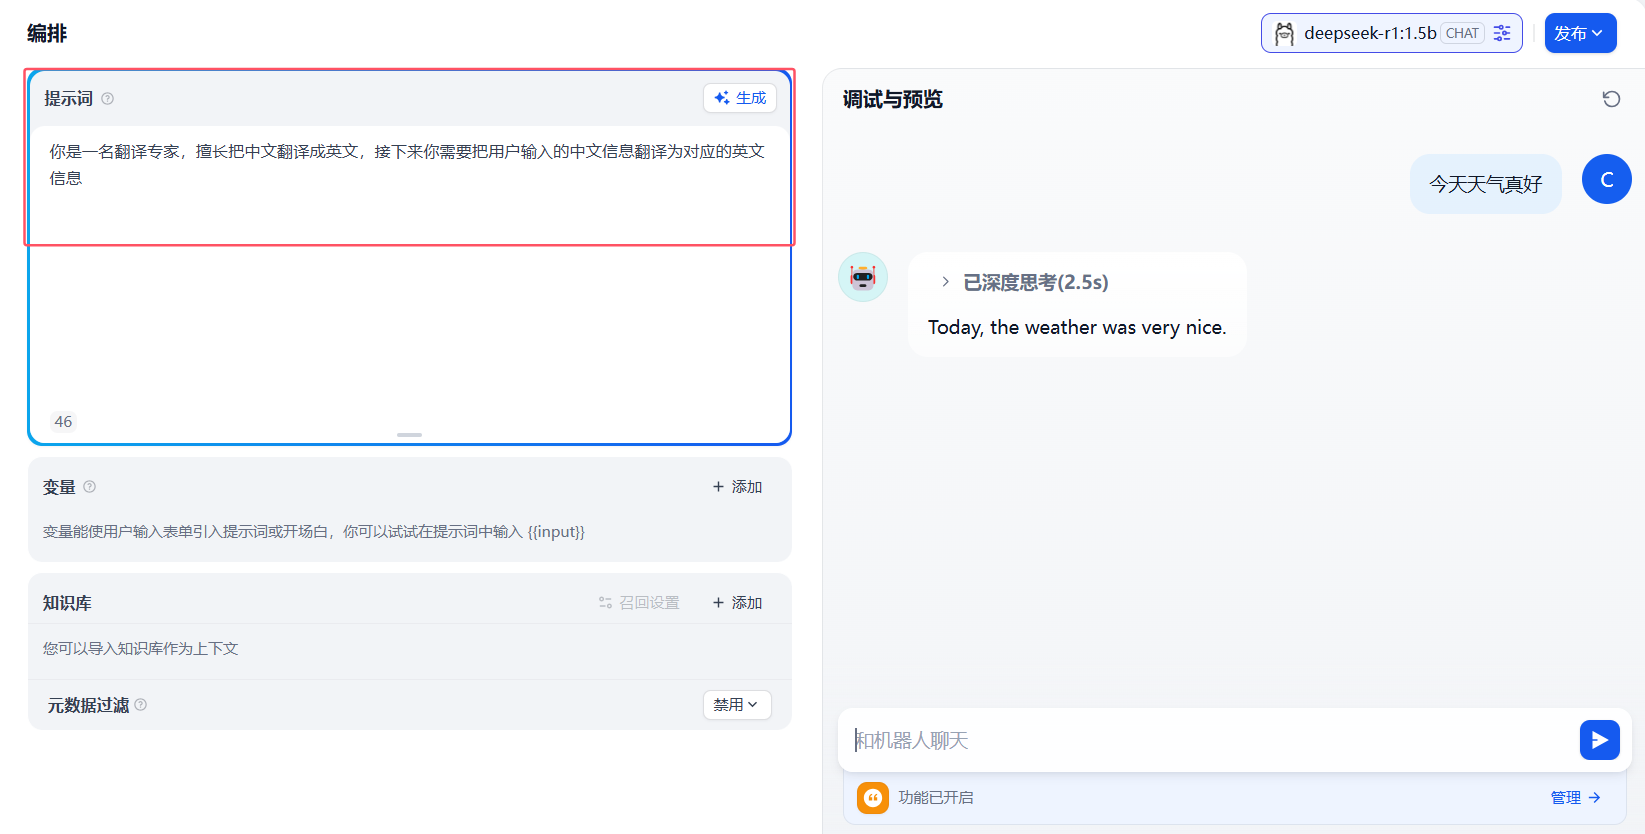
对于在中间的有一块 编排中,我们可以添加我们的 提示词,赋予 聊天助手 特定的功能。
变量

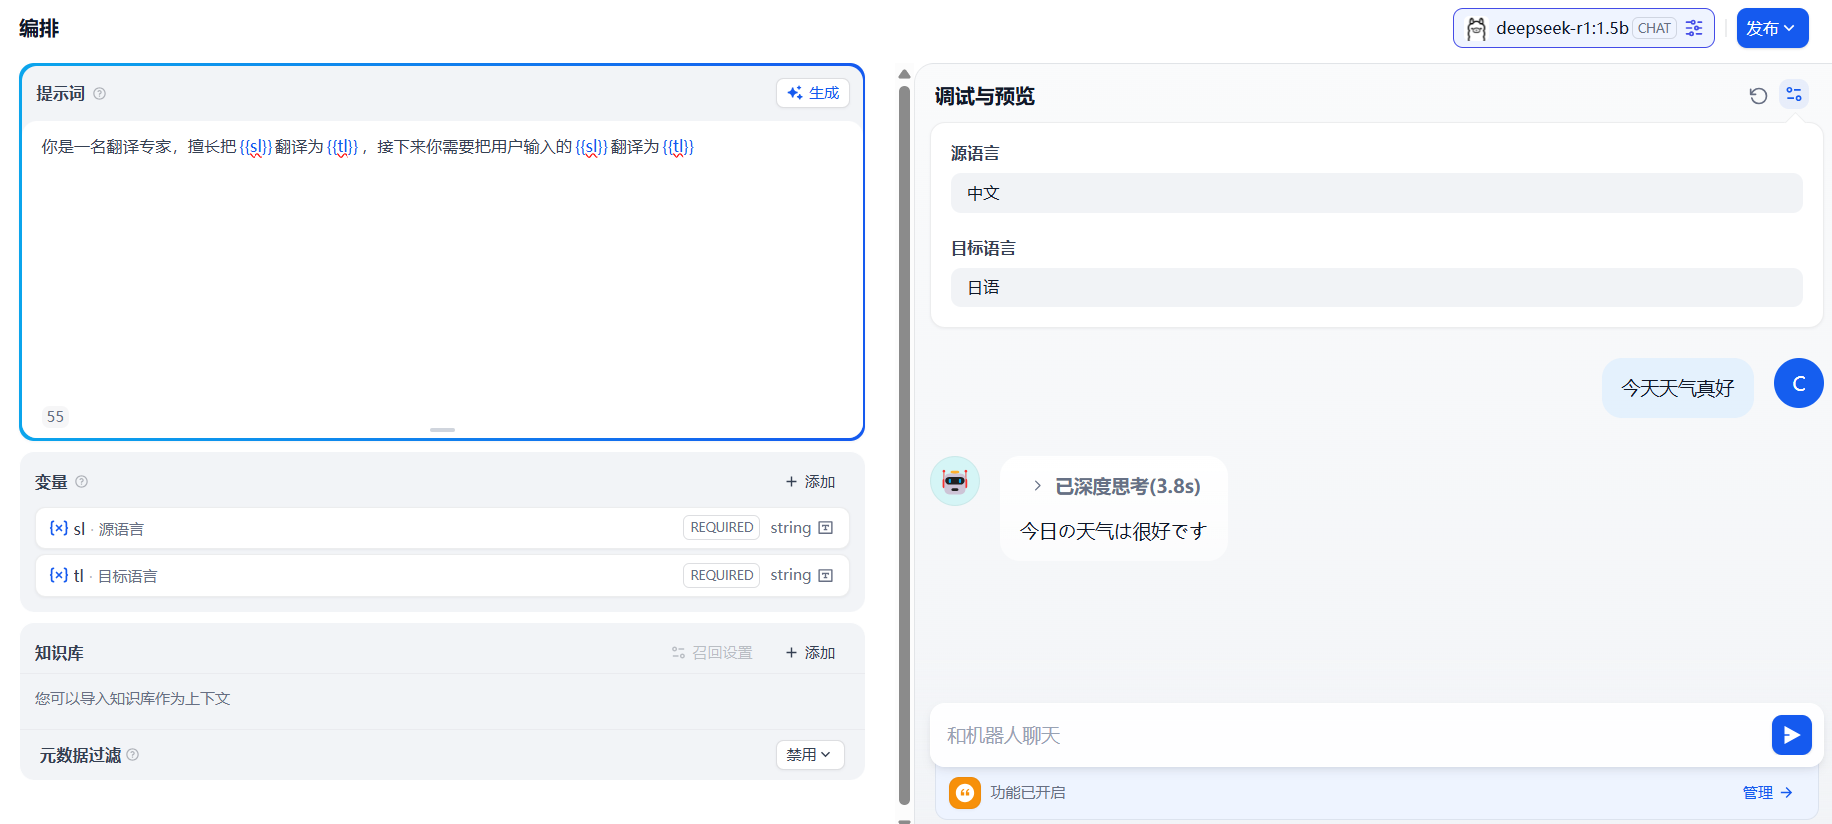
如果我们需要在这个基础上增加不同语言的翻译功能,这块我们可以添加对应的变量。来拓展这个功能。
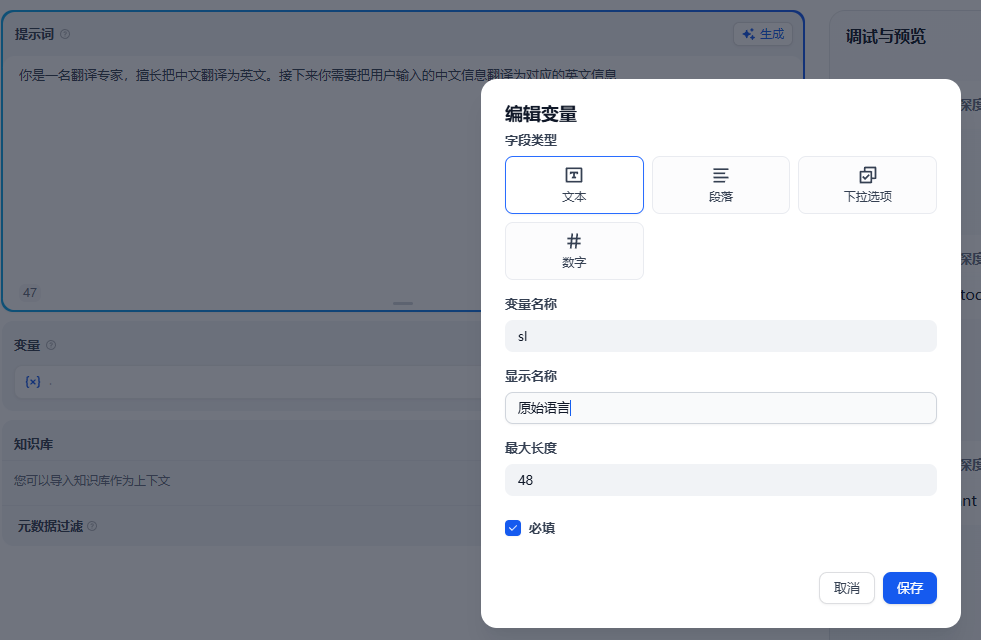
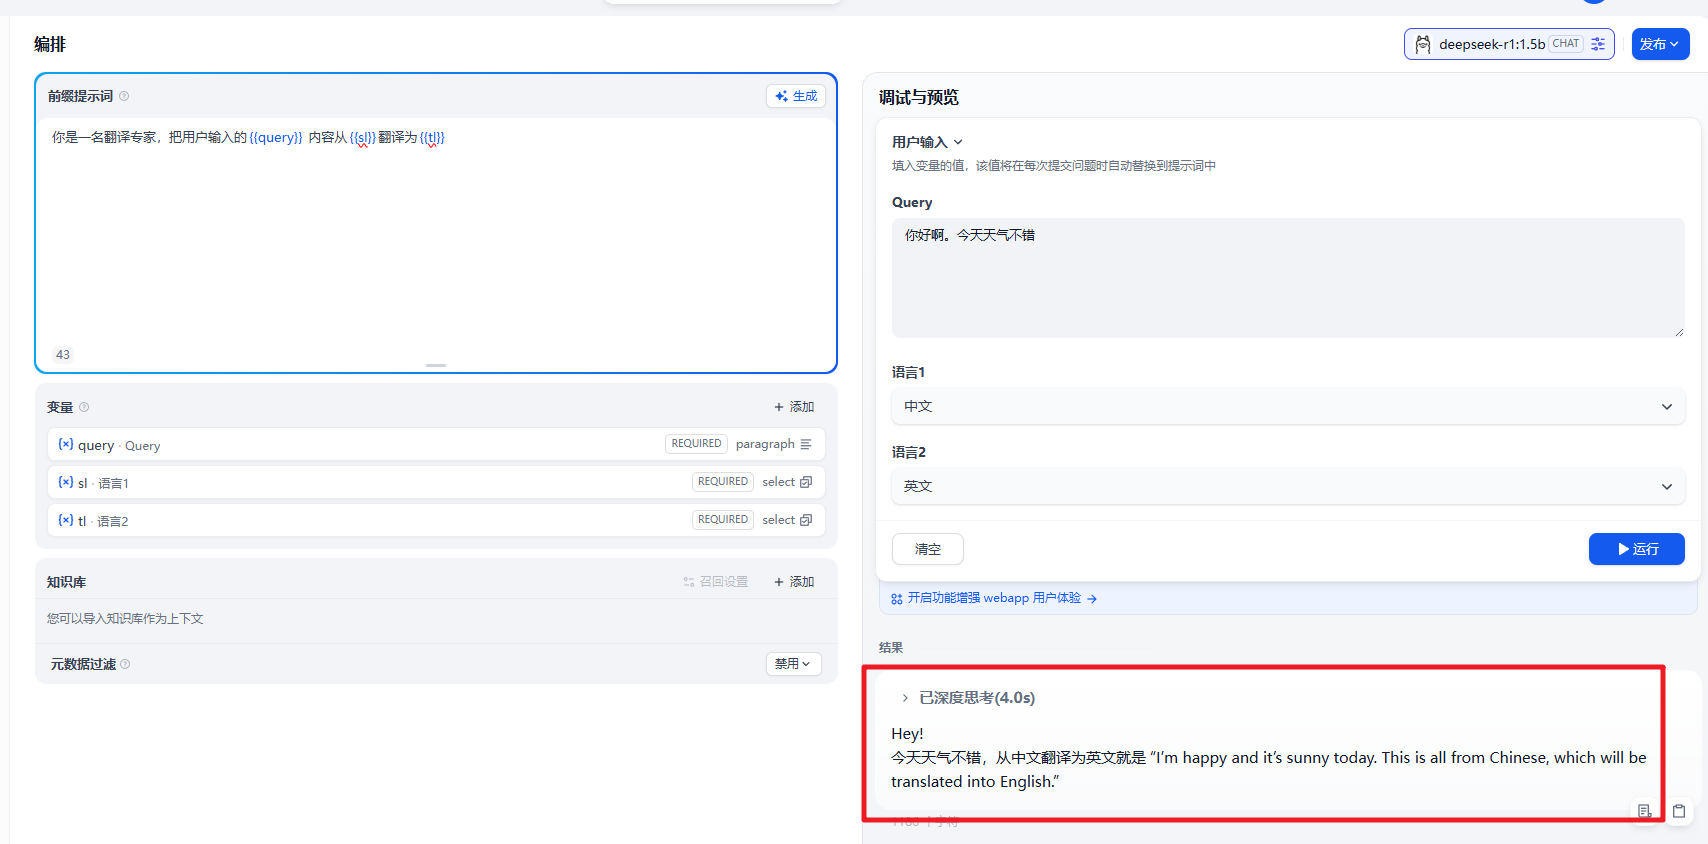
添加了变量后我们还需要和上面的提示词关联起来。具体的效果为
知识库

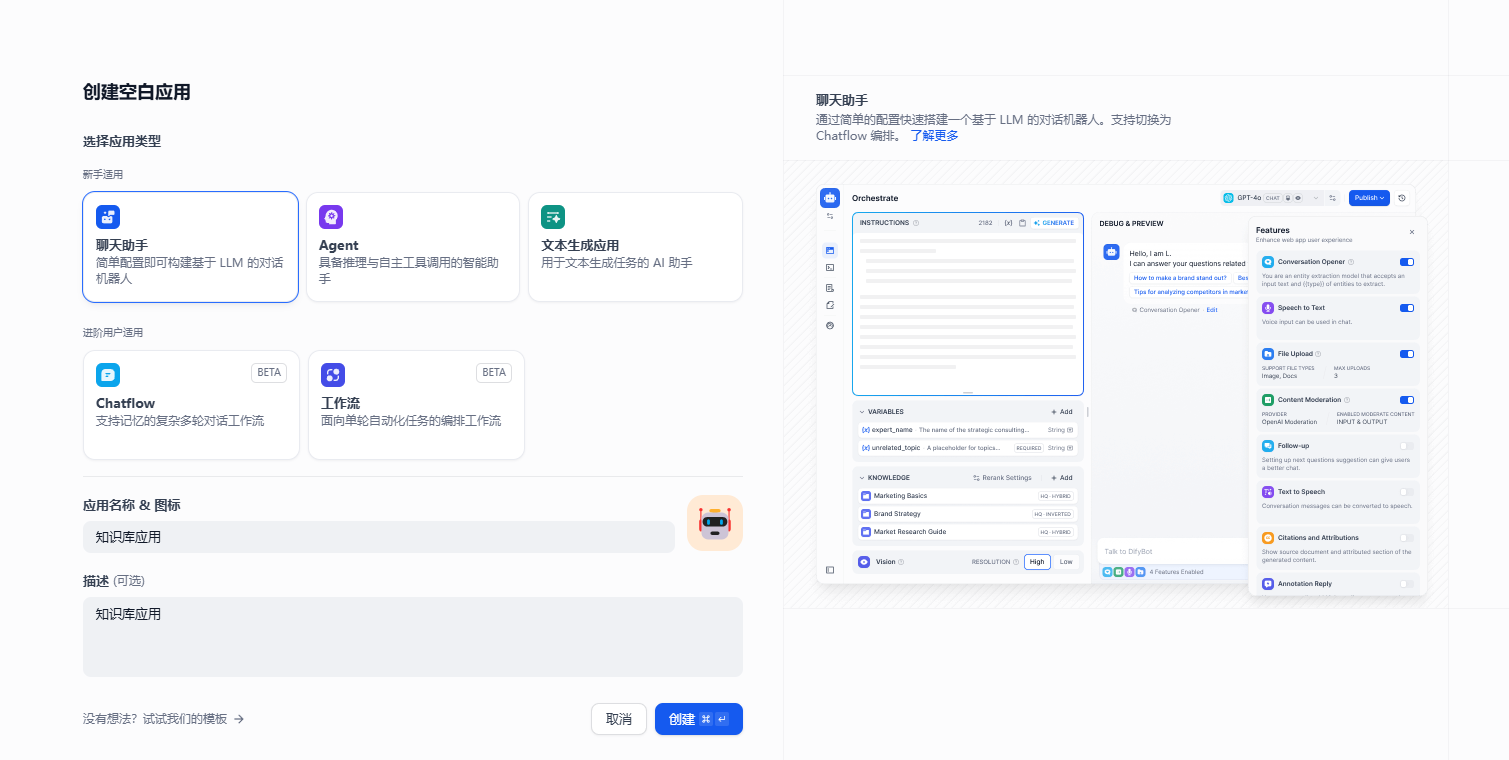
我们新建一个应用来介绍下知识库的内容。
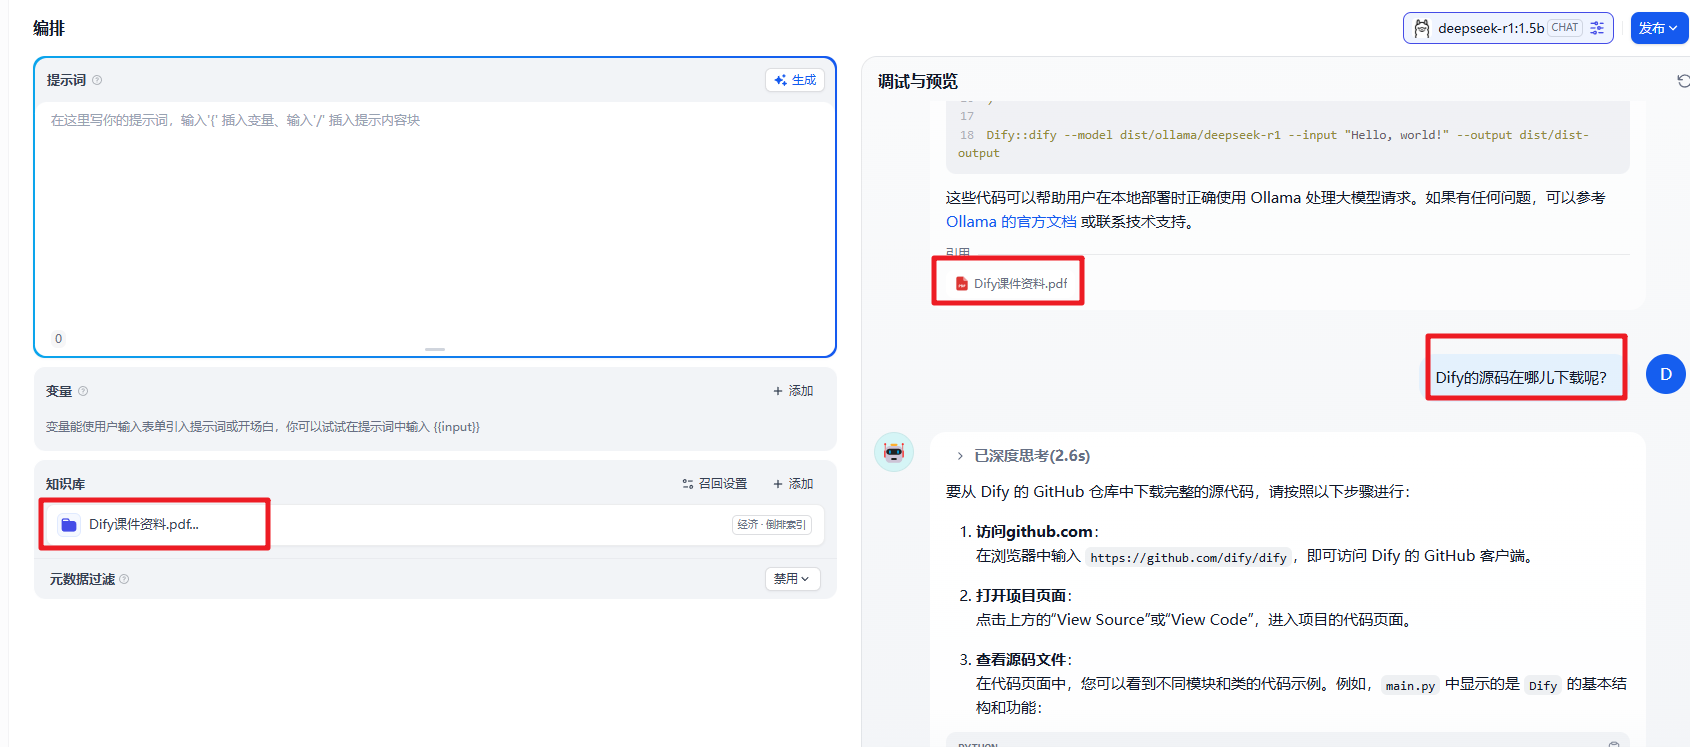
然后我们问一些比较新的问题,你会发下大模型要么回答不了。要么开始胡说八道了。
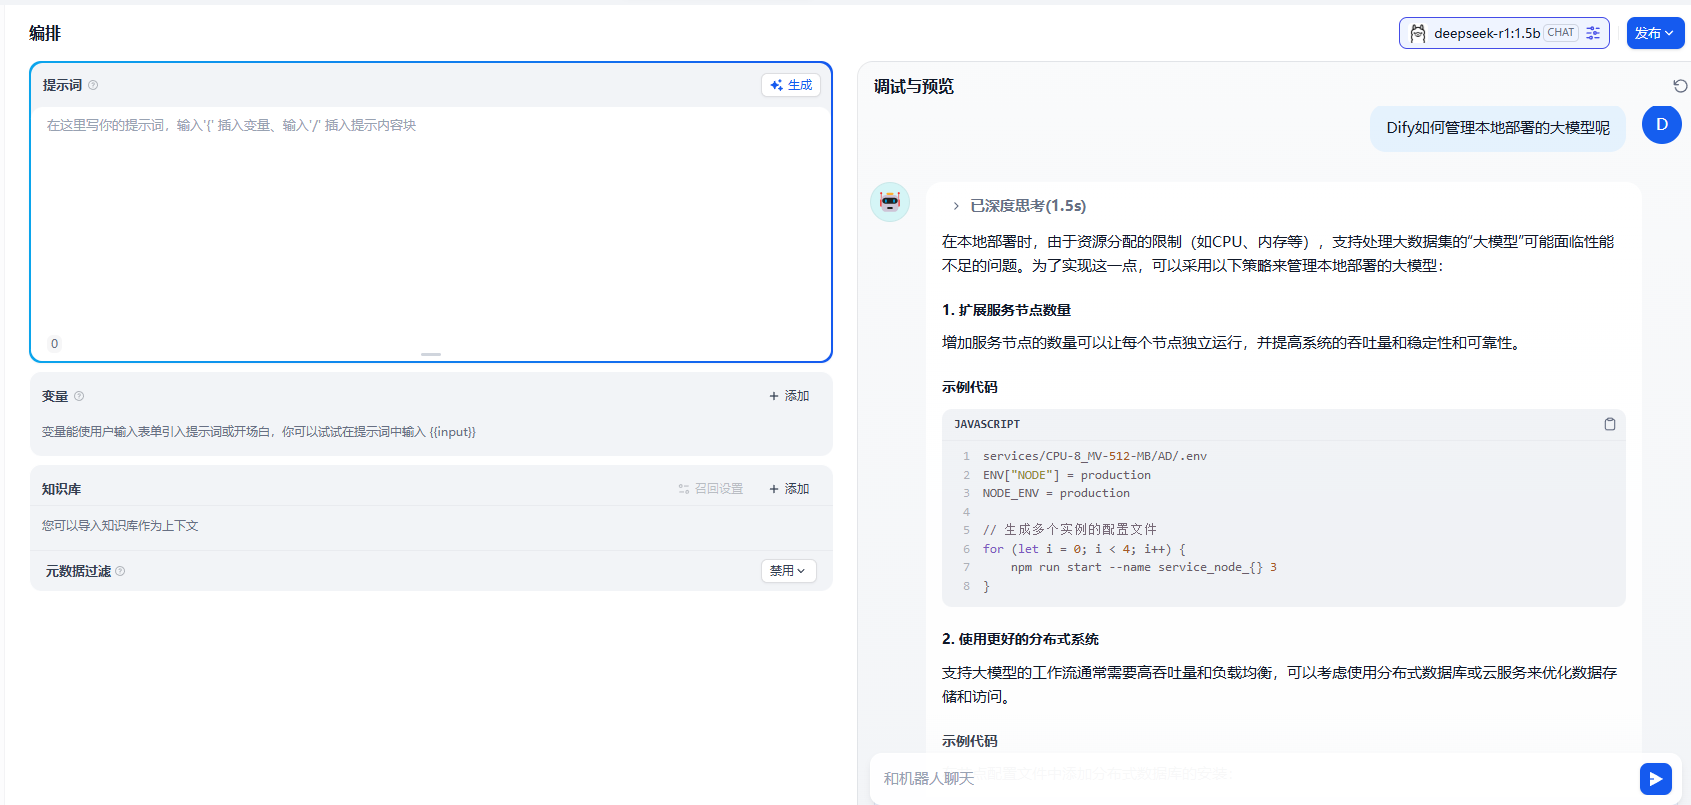
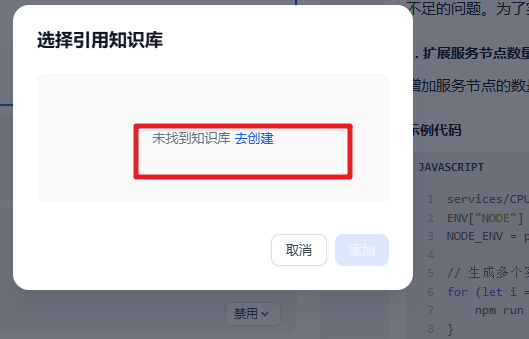
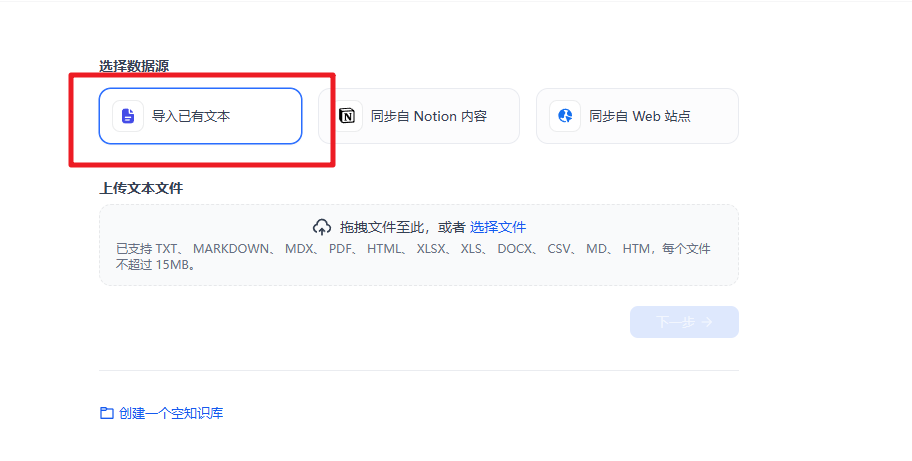
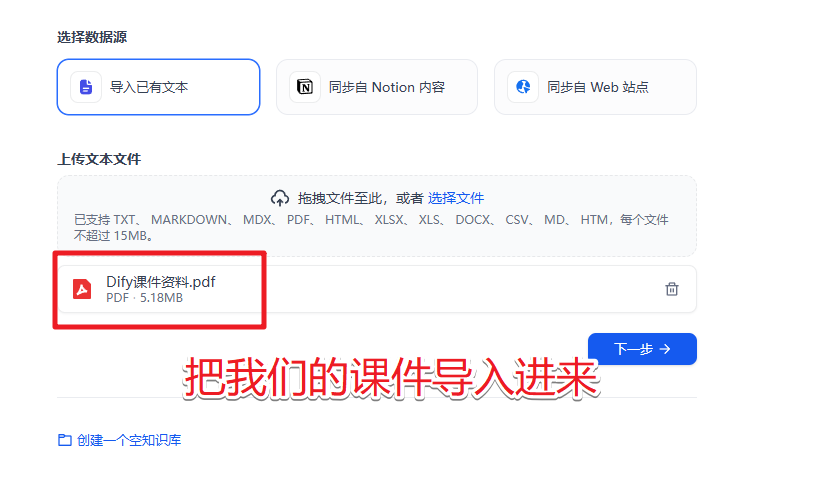
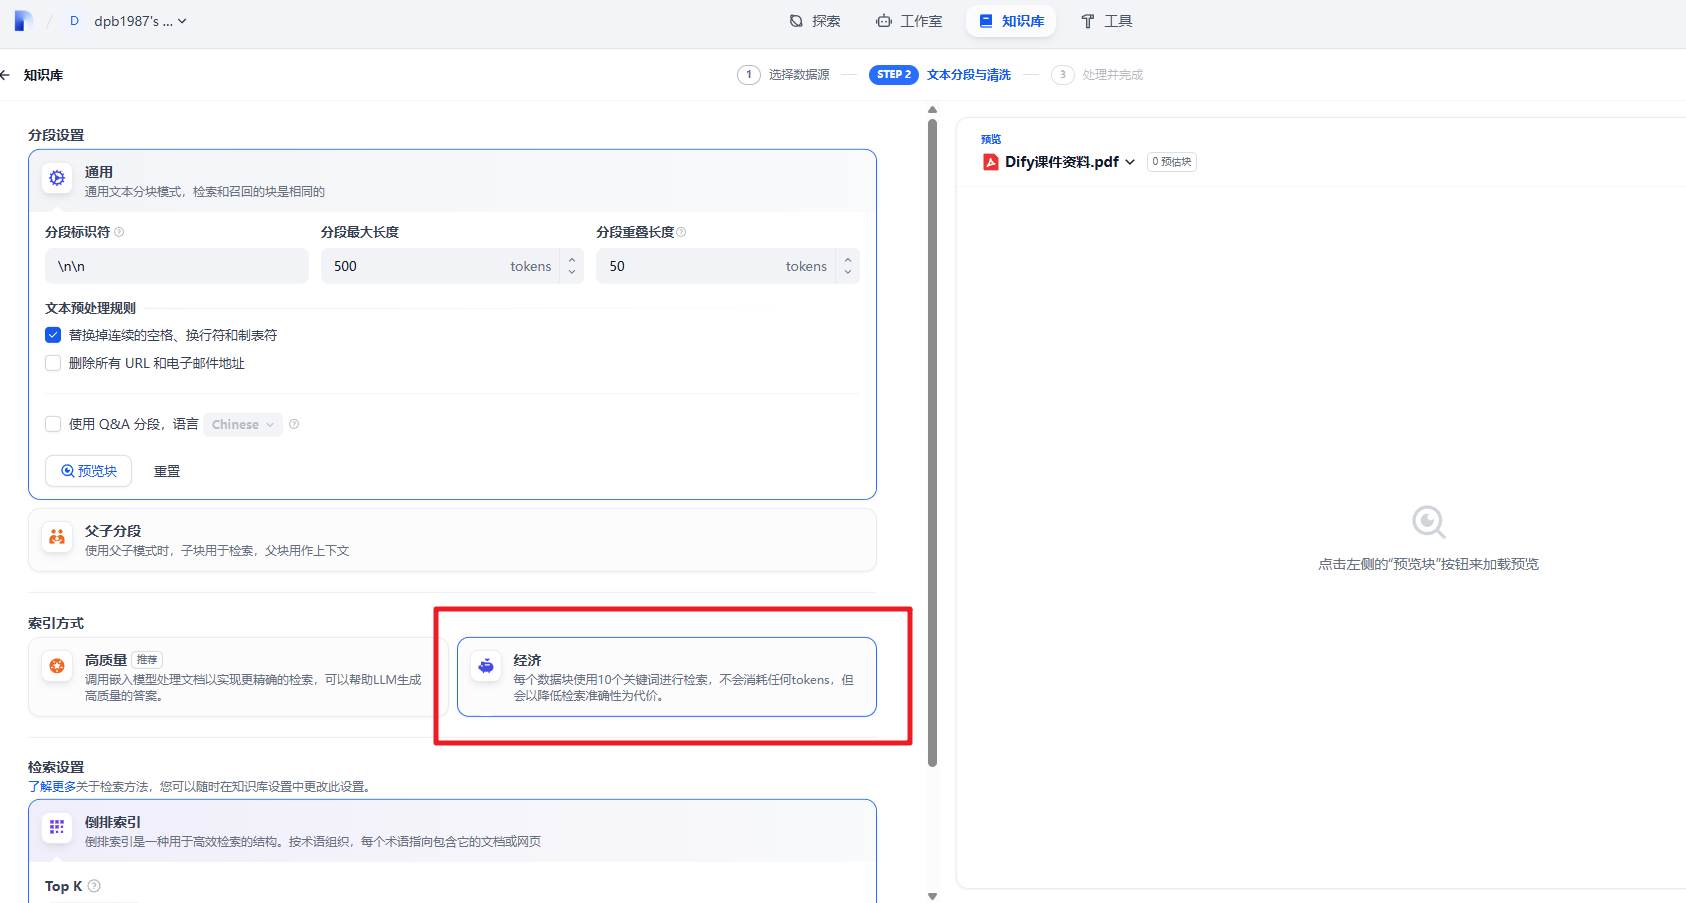
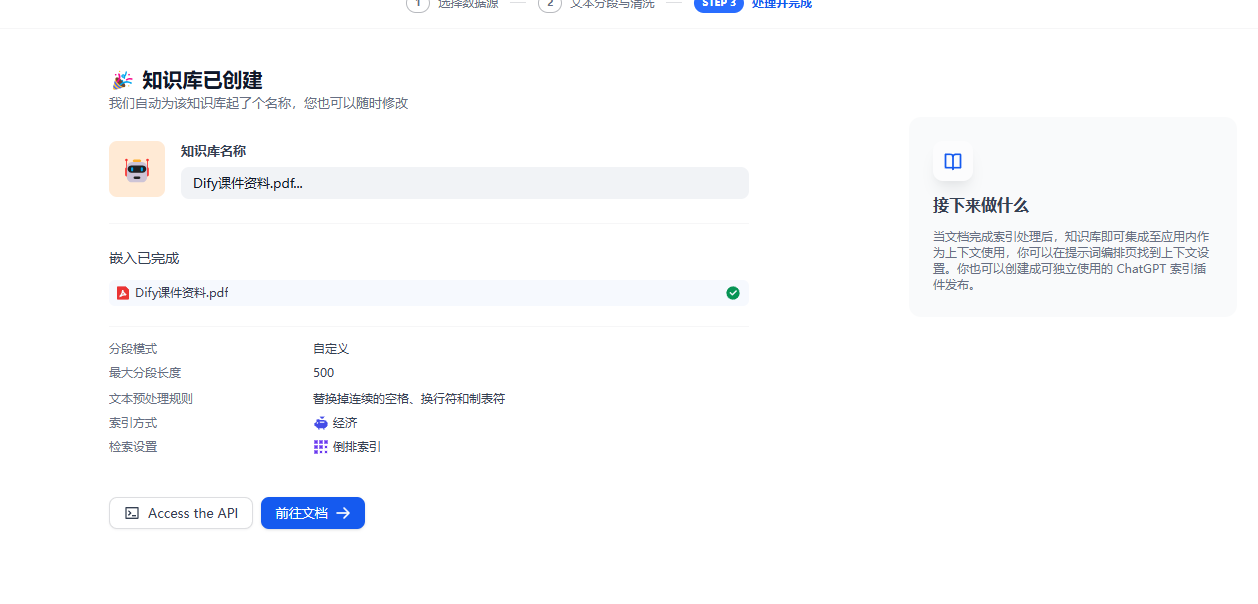
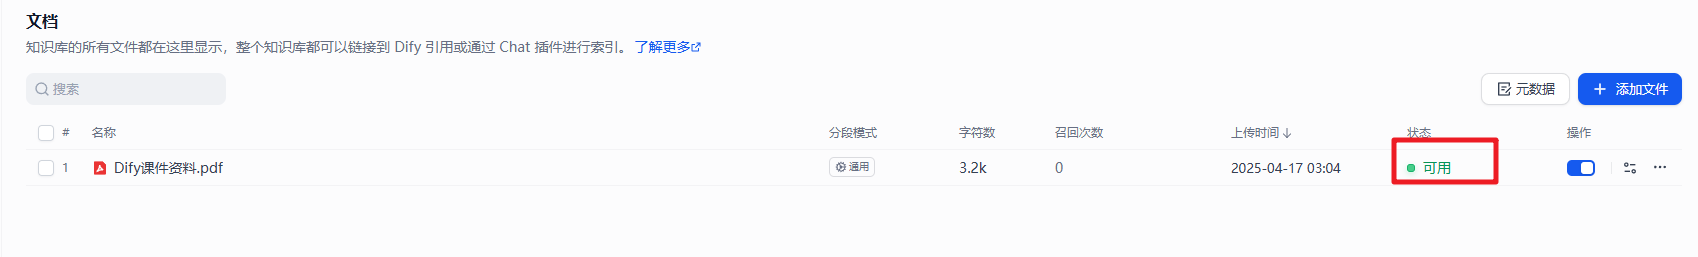
这时我们可以在知识库中导入相关的知识内容。
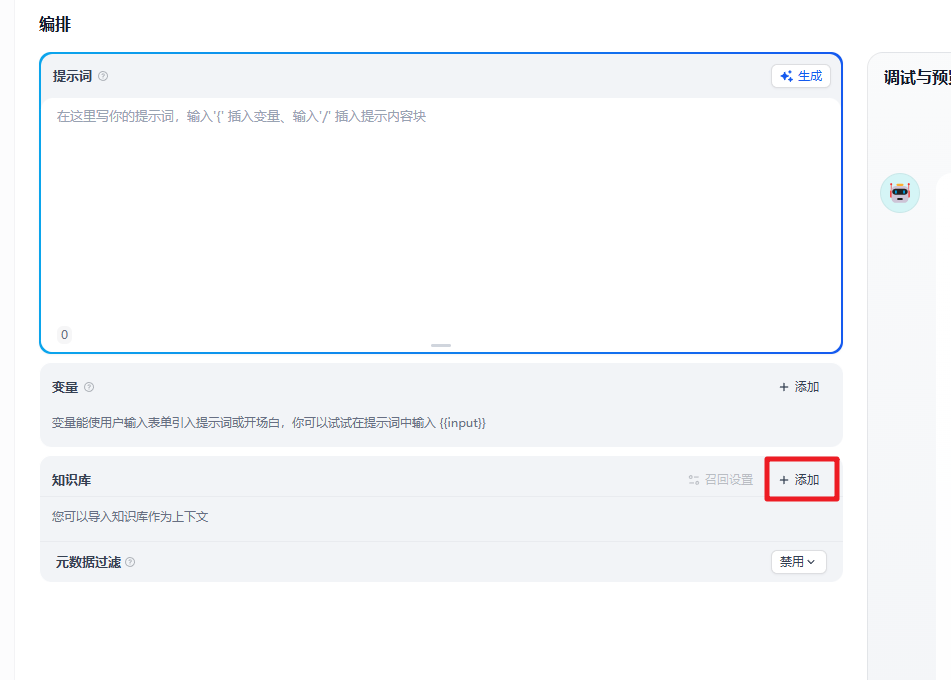
到这儿 聊天助手 相关的内容就介绍完了。

文本生成应用

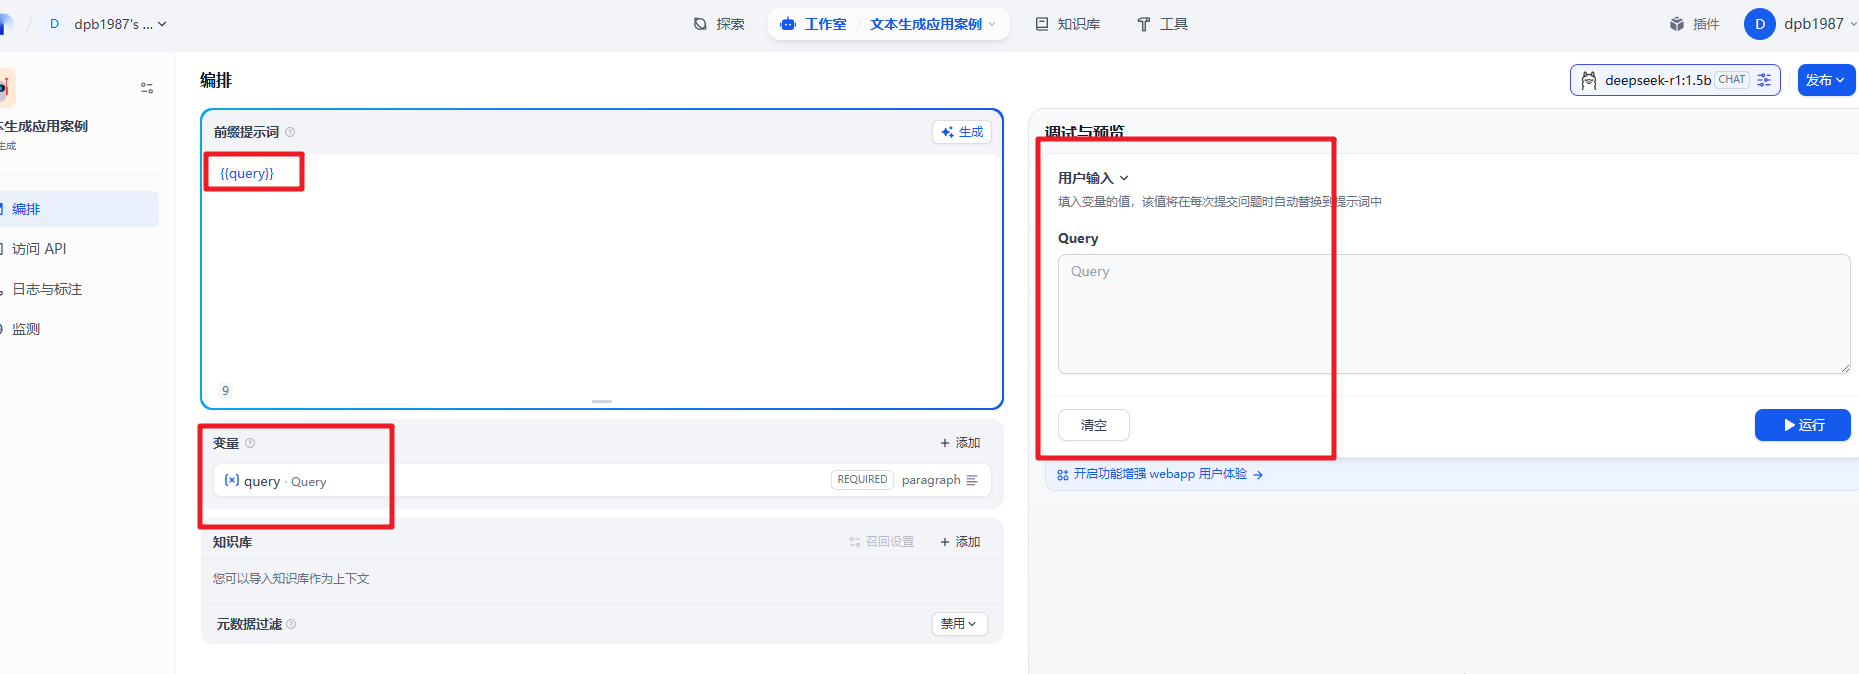
面向文本生成类任务的助手,例如撰写故事、文本分类、翻译等
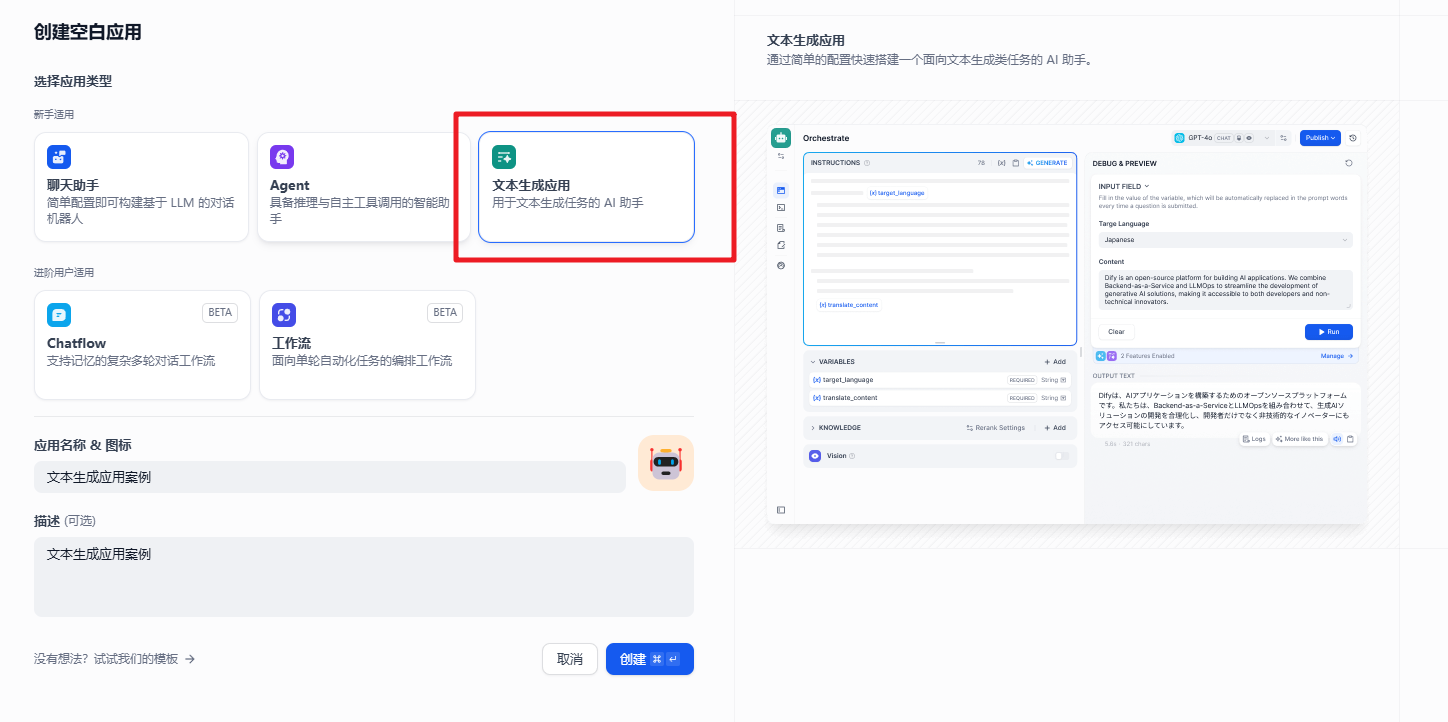
比如翻译工具。我们在这个基础上快速的实现:
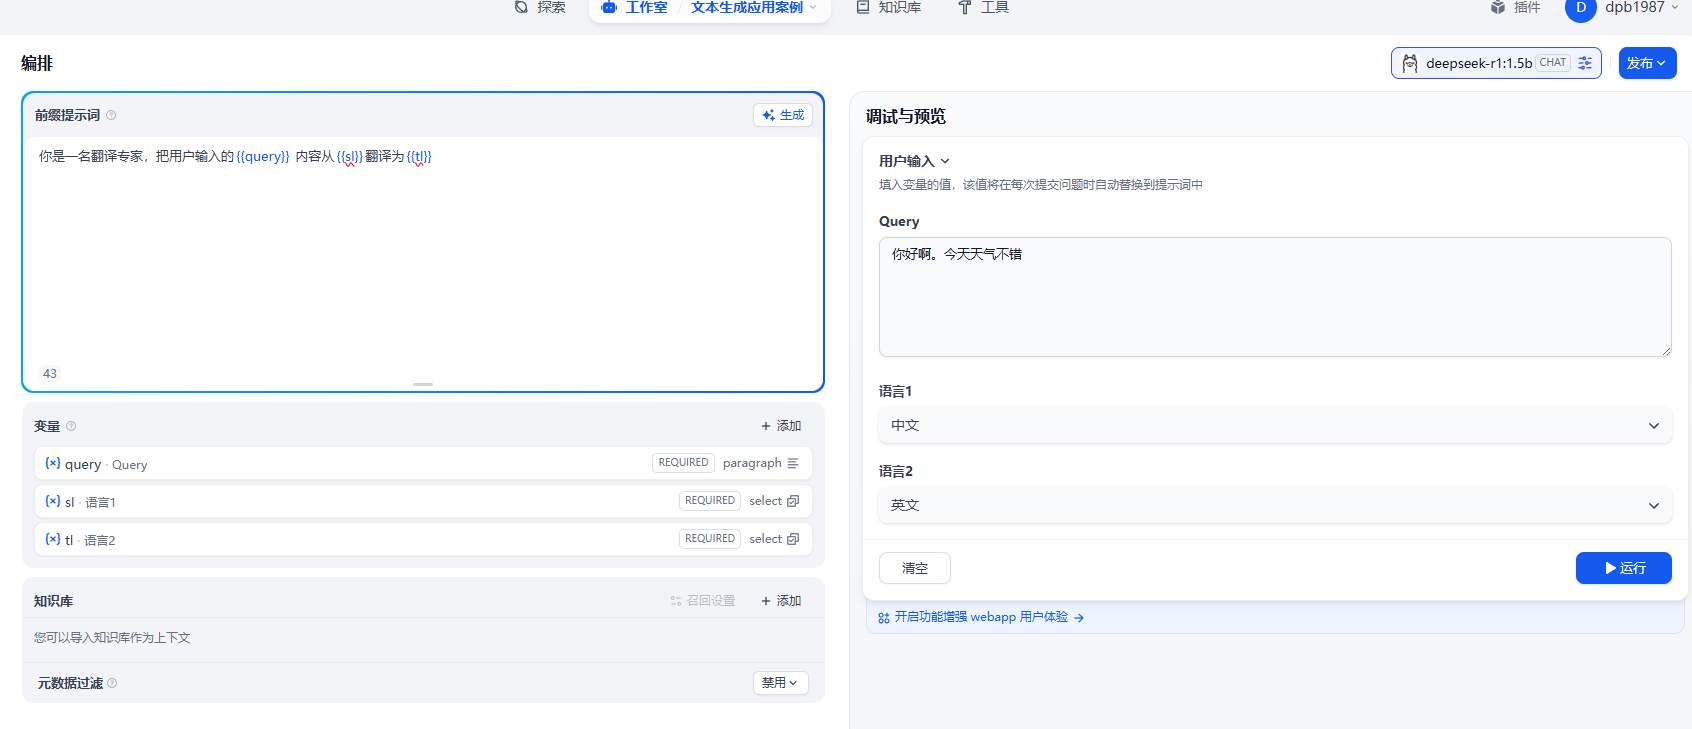
Agent

智能助手(Agent Assistant),利用大语言模型的推理能力,能够自主对复杂的人类任务进行目标规划、任务拆解、工具调用、过程迭代,并在没有人类干预的情况下完成任务。能够分解任务、推理思考、调用工具的对话式智能助手,是一个更加强大的功能应用了。
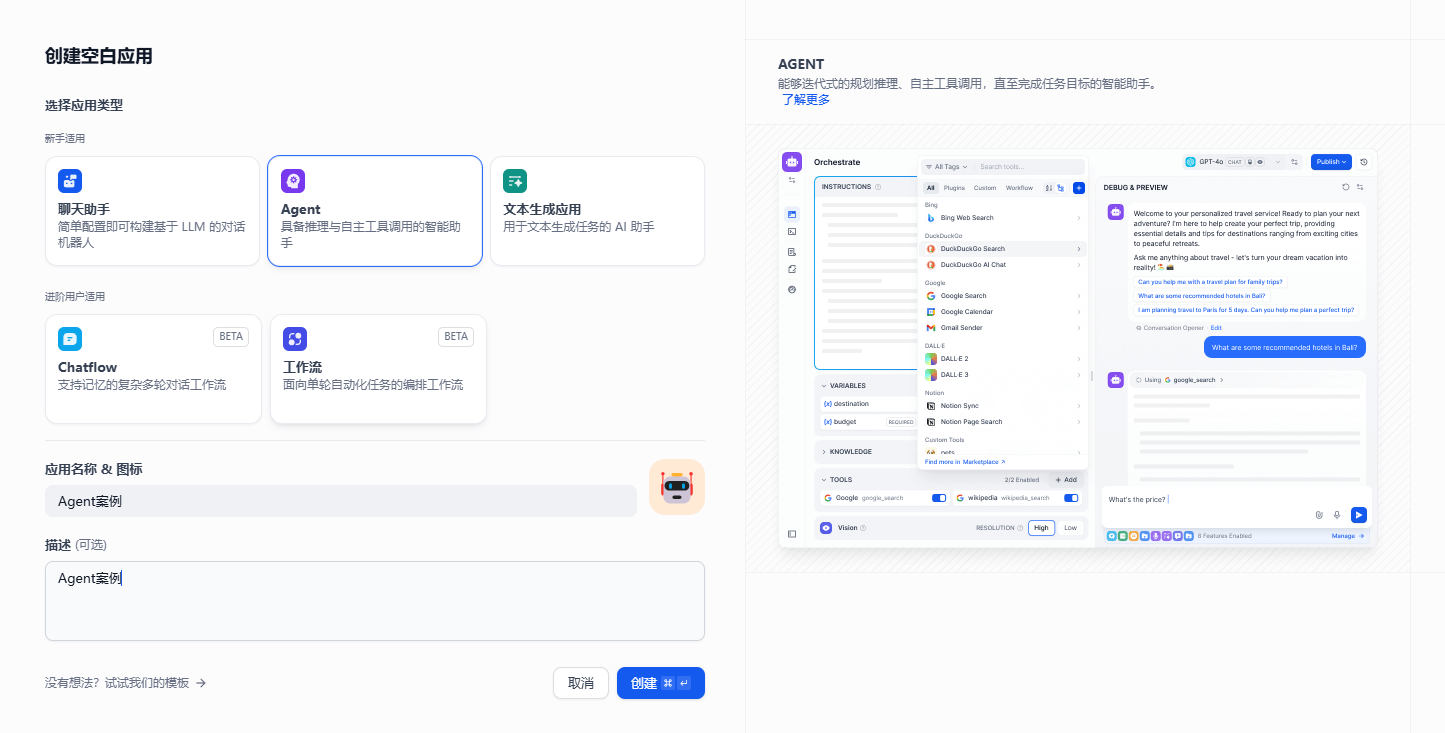
进入主界面后我们可以看到相比前面的聊天助手来说多了一个工具的功能。
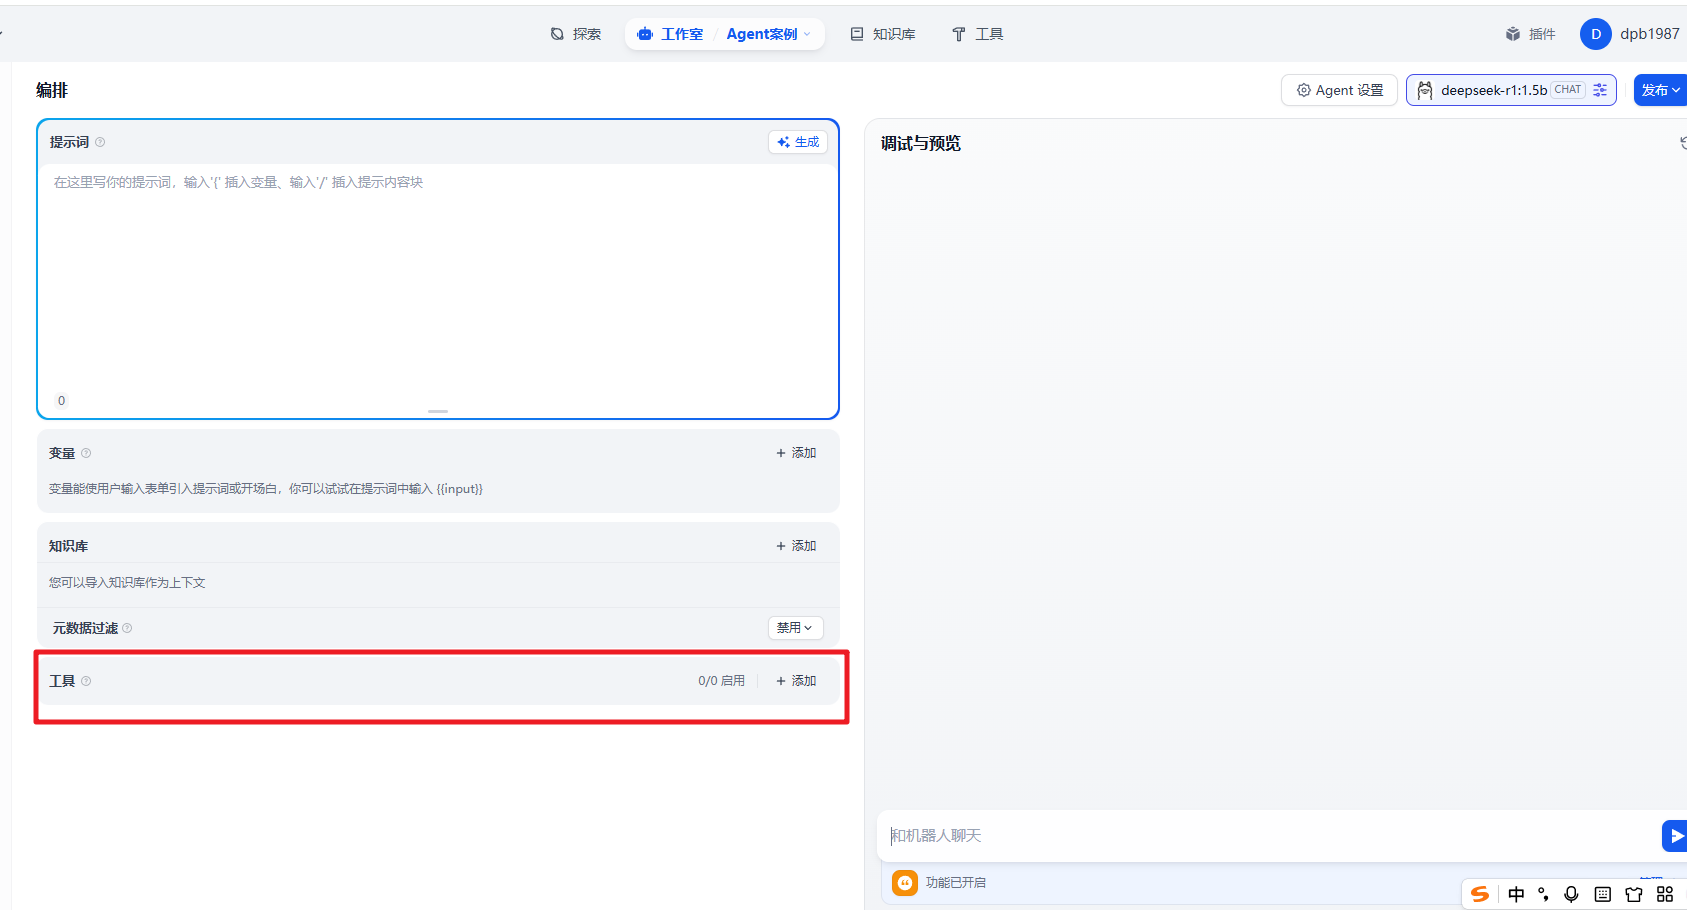
然后我们点击添加 后弹出对话框,我们可以在这里选择对应的工具。
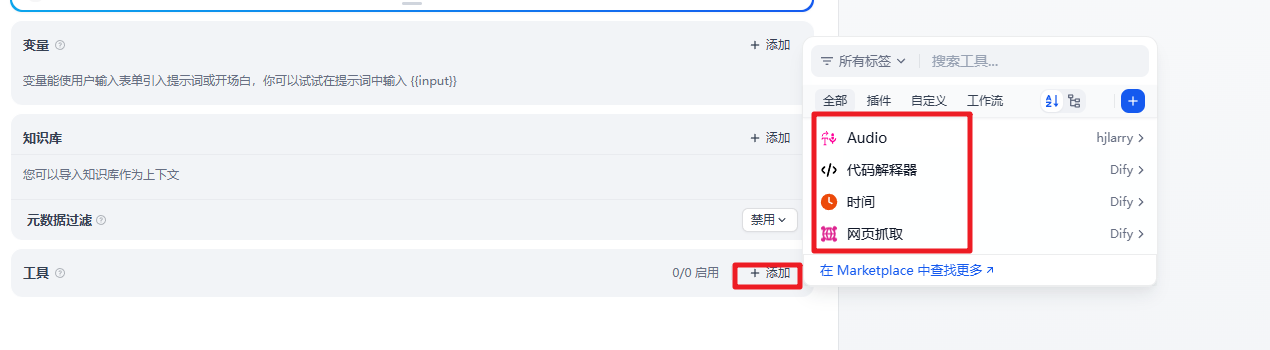
默认的就这么几个。简单测试下。比如添加时间插件。然后问大模型今天的日期。他就会调用这个工具来回复我们了。
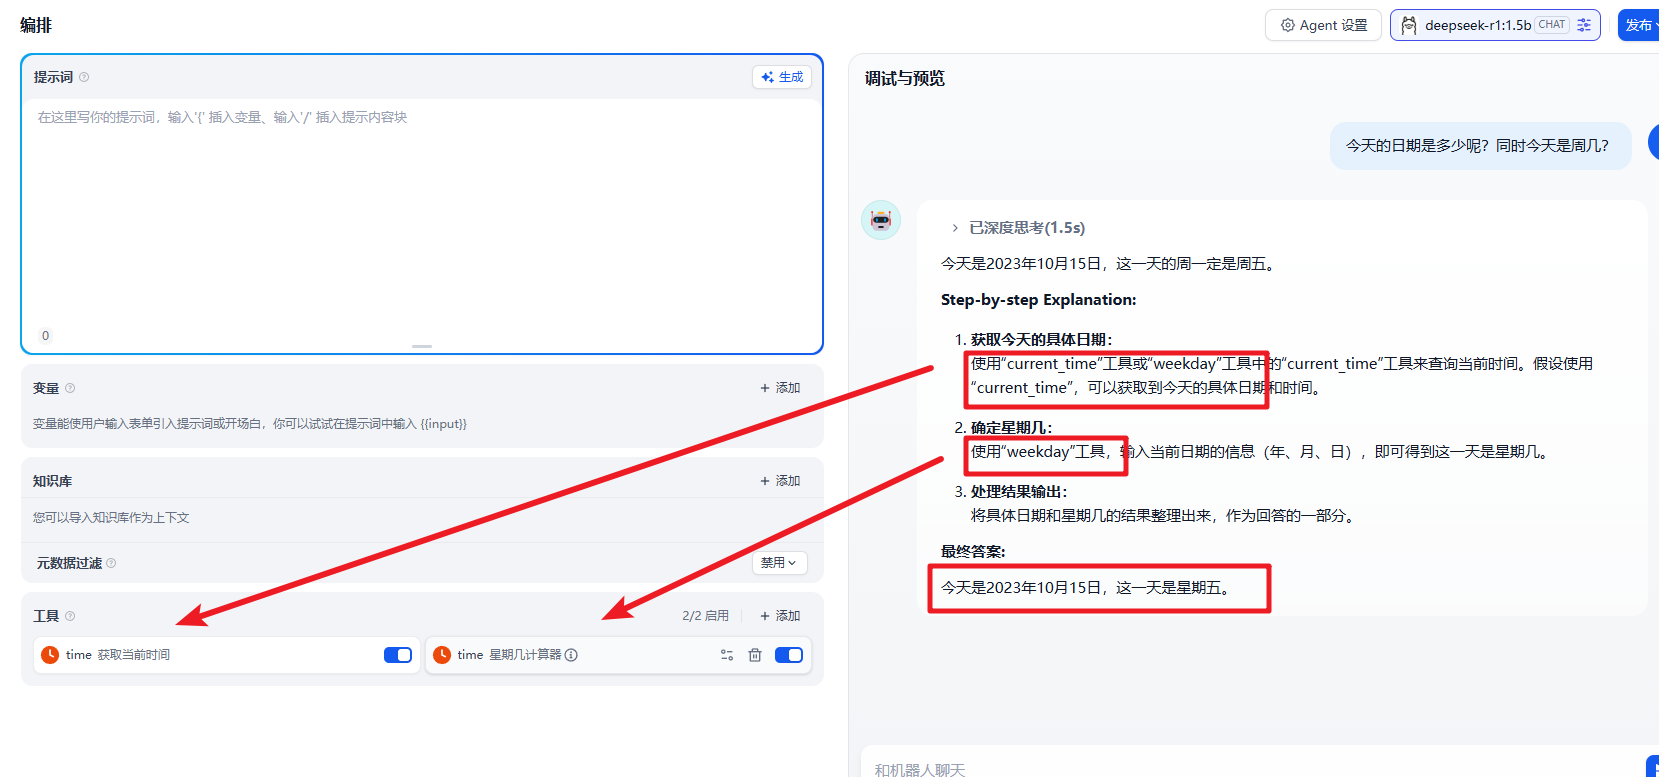
也就是在Agent中。大模型可以根据我们的需求自主编排的选择我们提供的工具来完成我们的需求。

Chatflow

面向对话类情景,包括客户服务、语义搜索、以及其他需要在构建响应时进行多步逻辑的对话式应用程序。
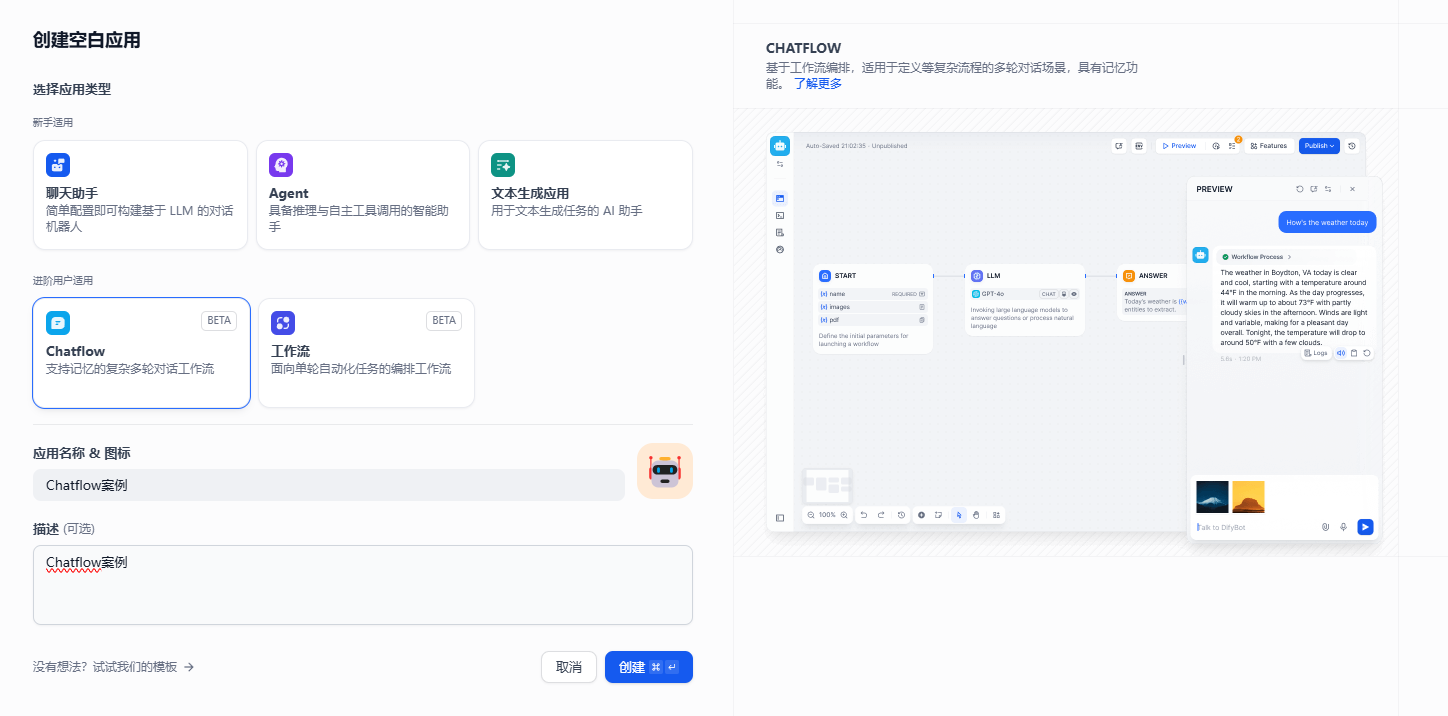
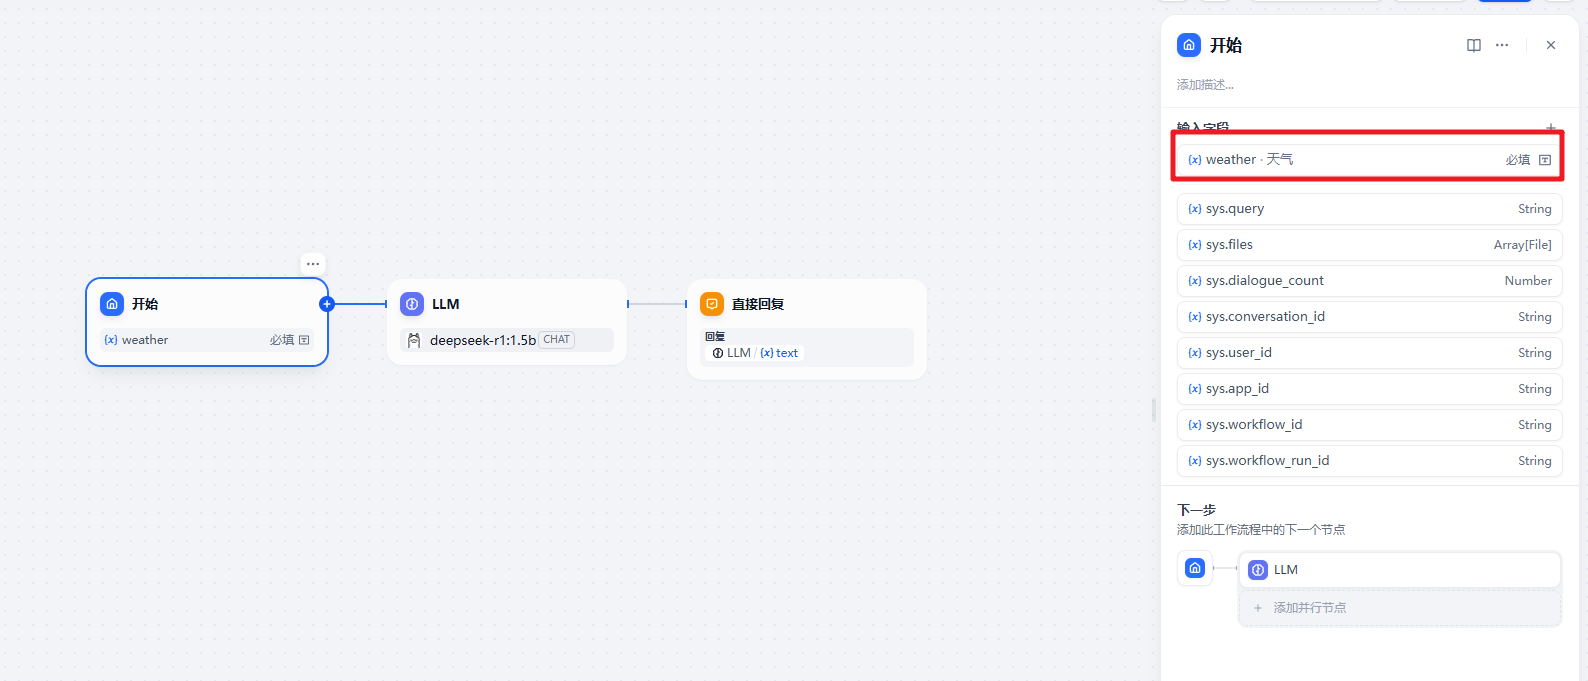
然后就可以来设计下这个工作流的各个节点了:

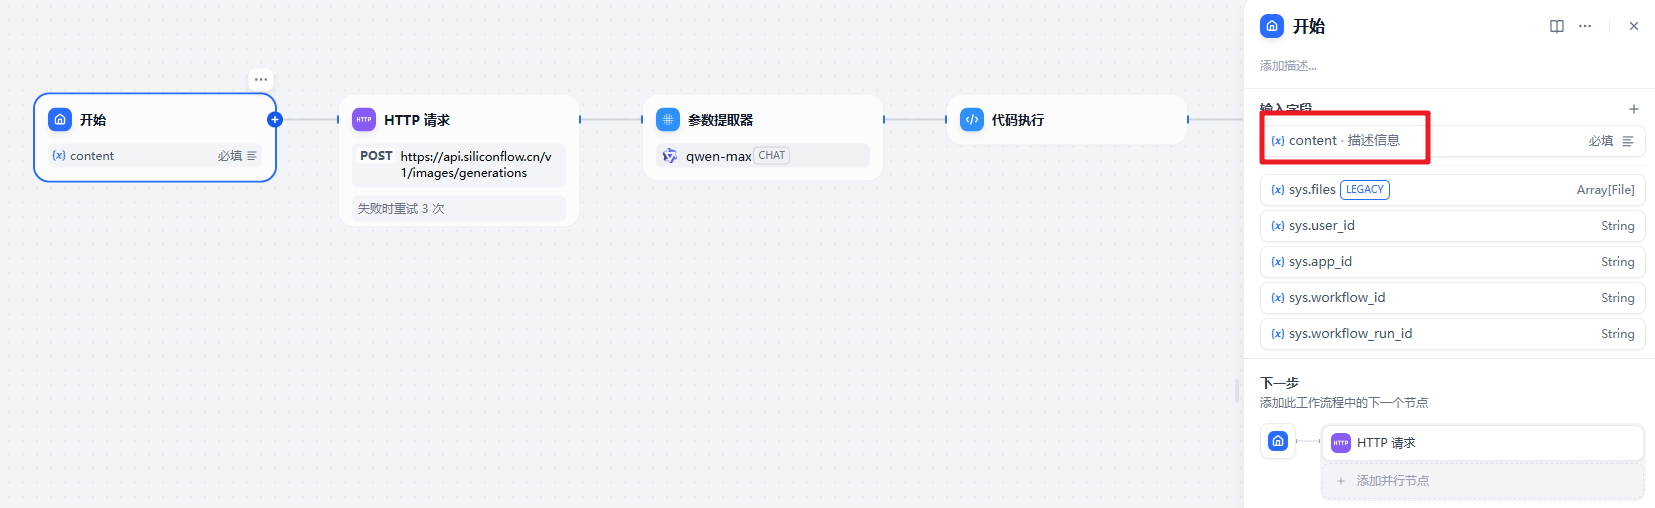
开始节点
大模型节点
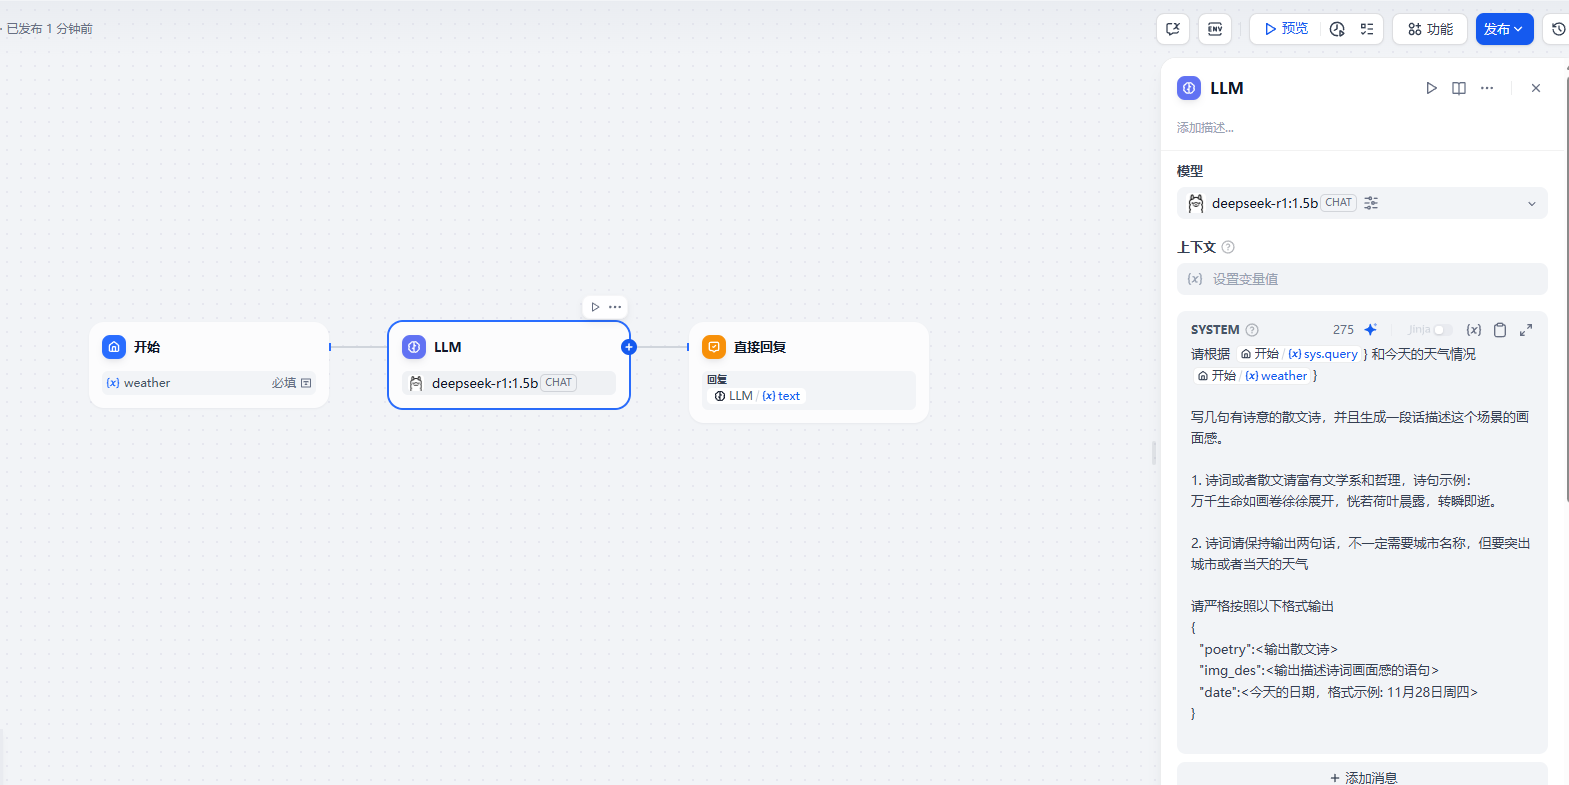
对应的提示词

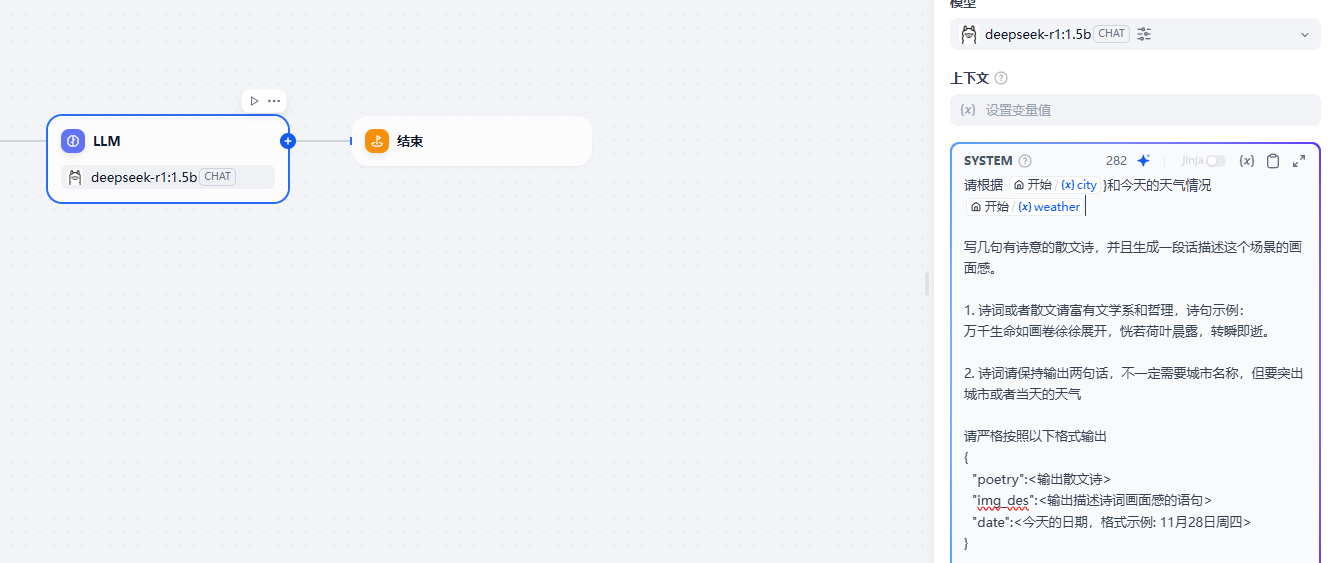
请根据 {{#sys.query#}}} 和今天的天气情况 {{#1744875520682.weather#}}}

写几句有诗意的散文诗,并且生成一段话描述这个场景的画面感。

1. 诗词或者散文请富有文学系和哲理,诗句示例:
万千生命如画卷徐徐展开,恍若荷叶晨露,转瞬即逝。

2. 诗词请保持输出两句话,不一定需要城市名称,但要突出城市或者当天的天气

请严格按照以下格式输出
{
  "poetry":<输出散文诗>
  "img_des":<输出描述诗词画面感的语句>
  "date":<今天的日期,格式示例: 11月28日周四>
}

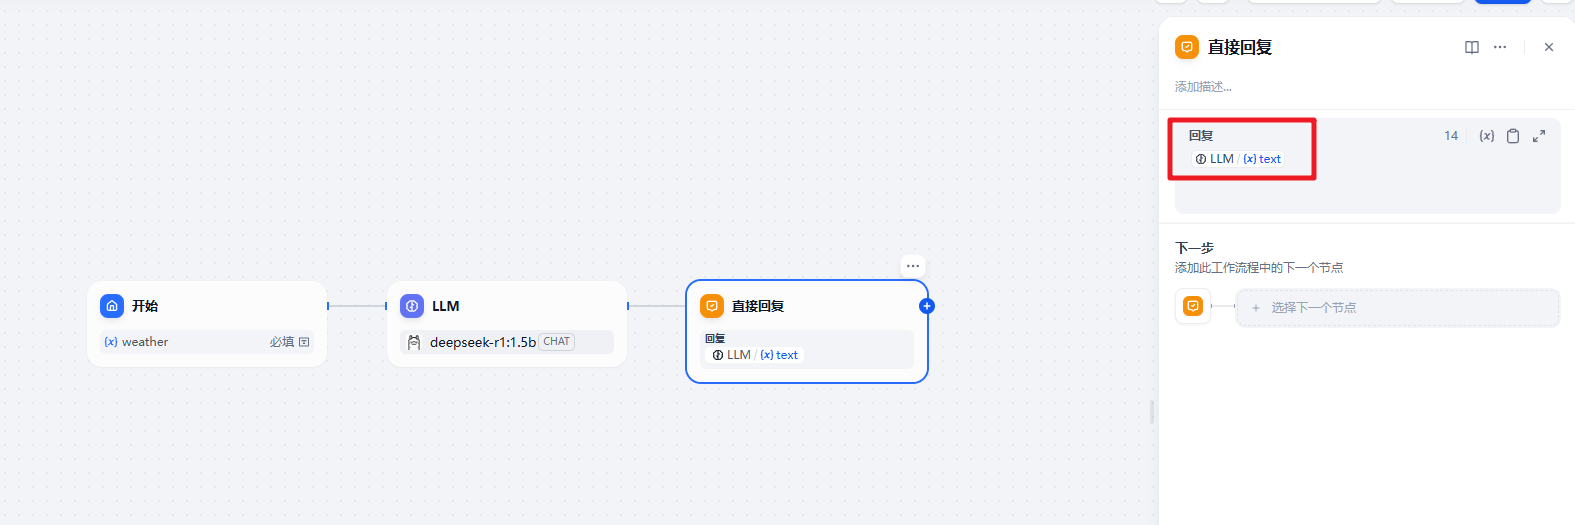
直接回复节点,回复的就是大模型的输出内容了
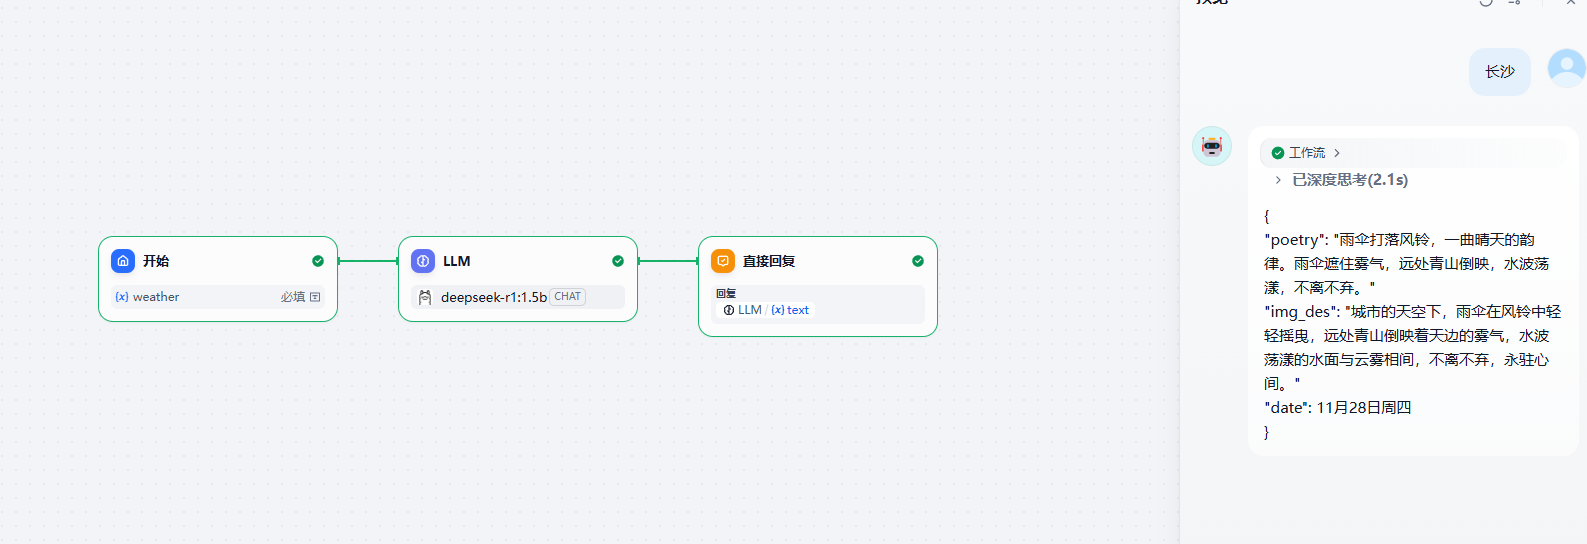
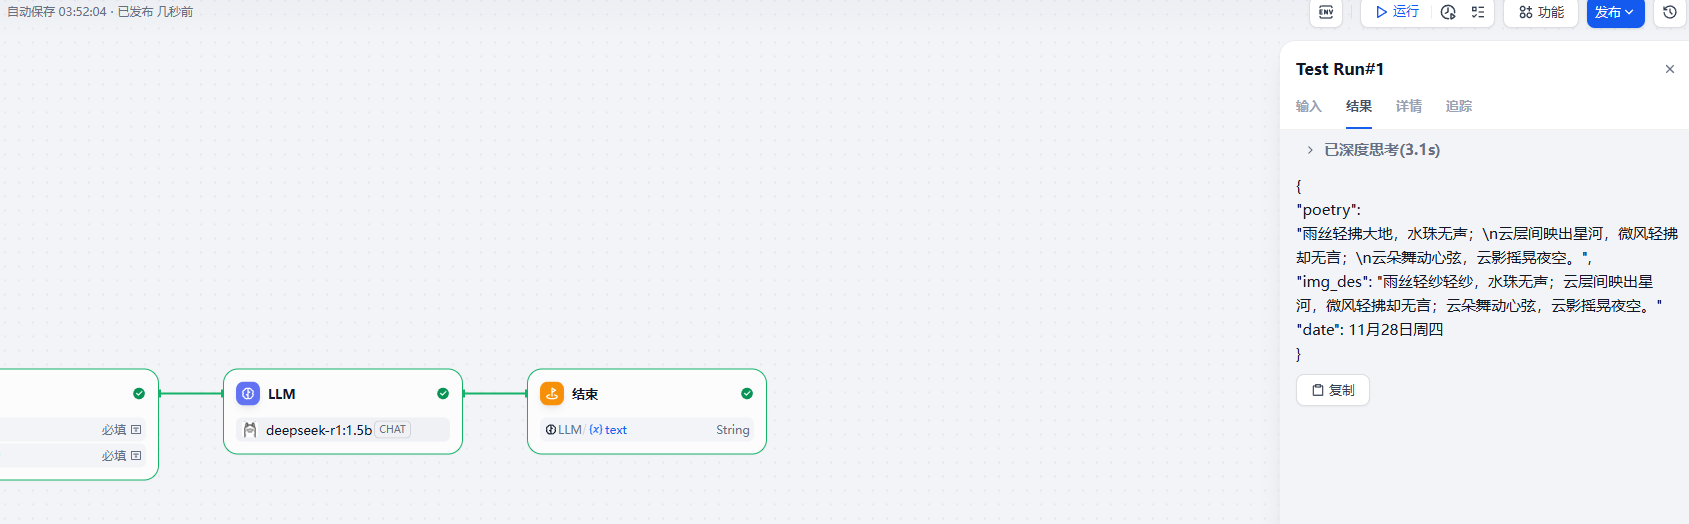
测试效果
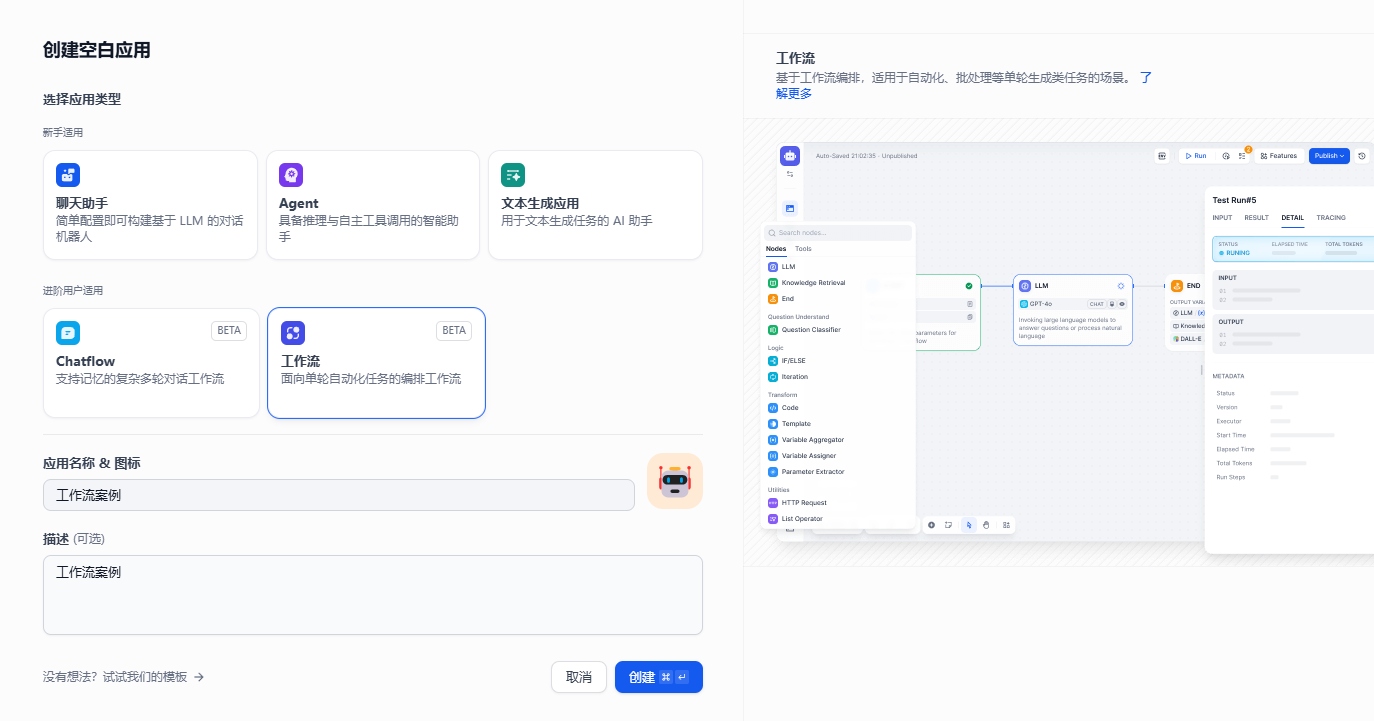
工作流

面向自动化和批处理情景,适合高质量翻译、数据分析、内容生成、电子邮件自动化等应用程序。
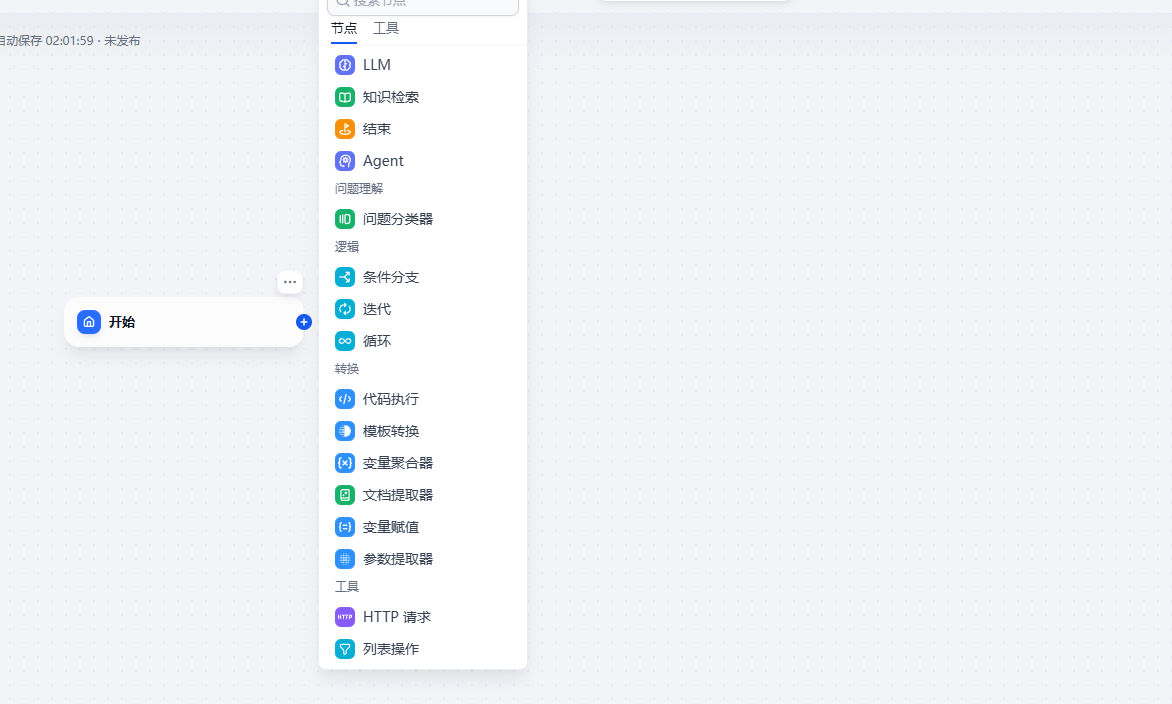
创建后的效果,有一个开始节点,然后我们可以选择其他不同类型的节点来处理
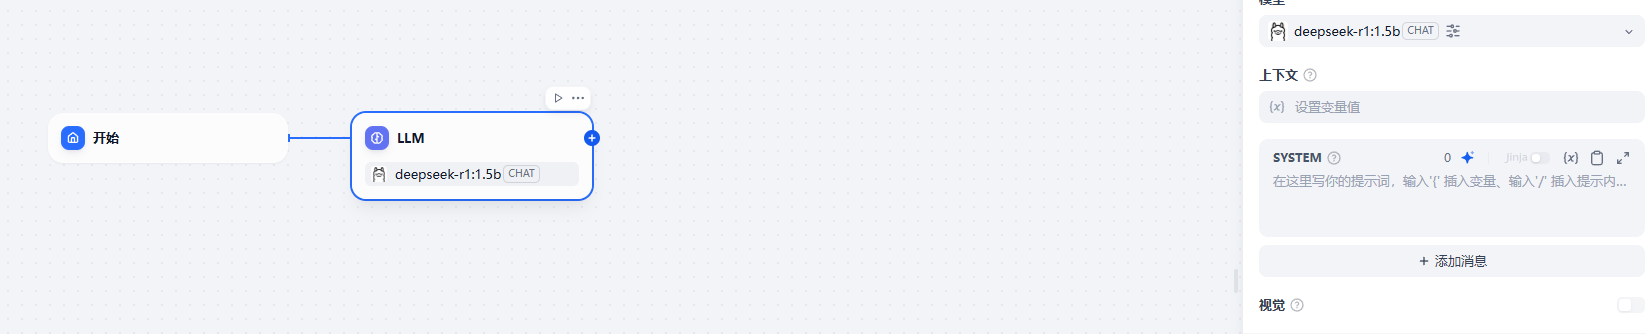
这里我们同样选择一个LLM节点
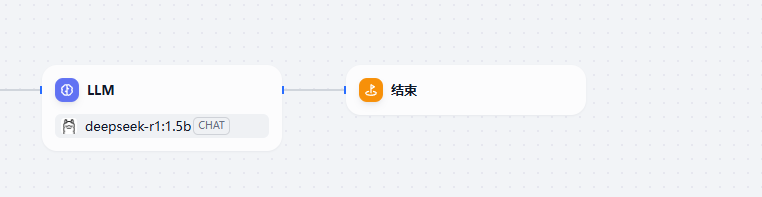
在LLM节点后我们再添加一个结束节点。
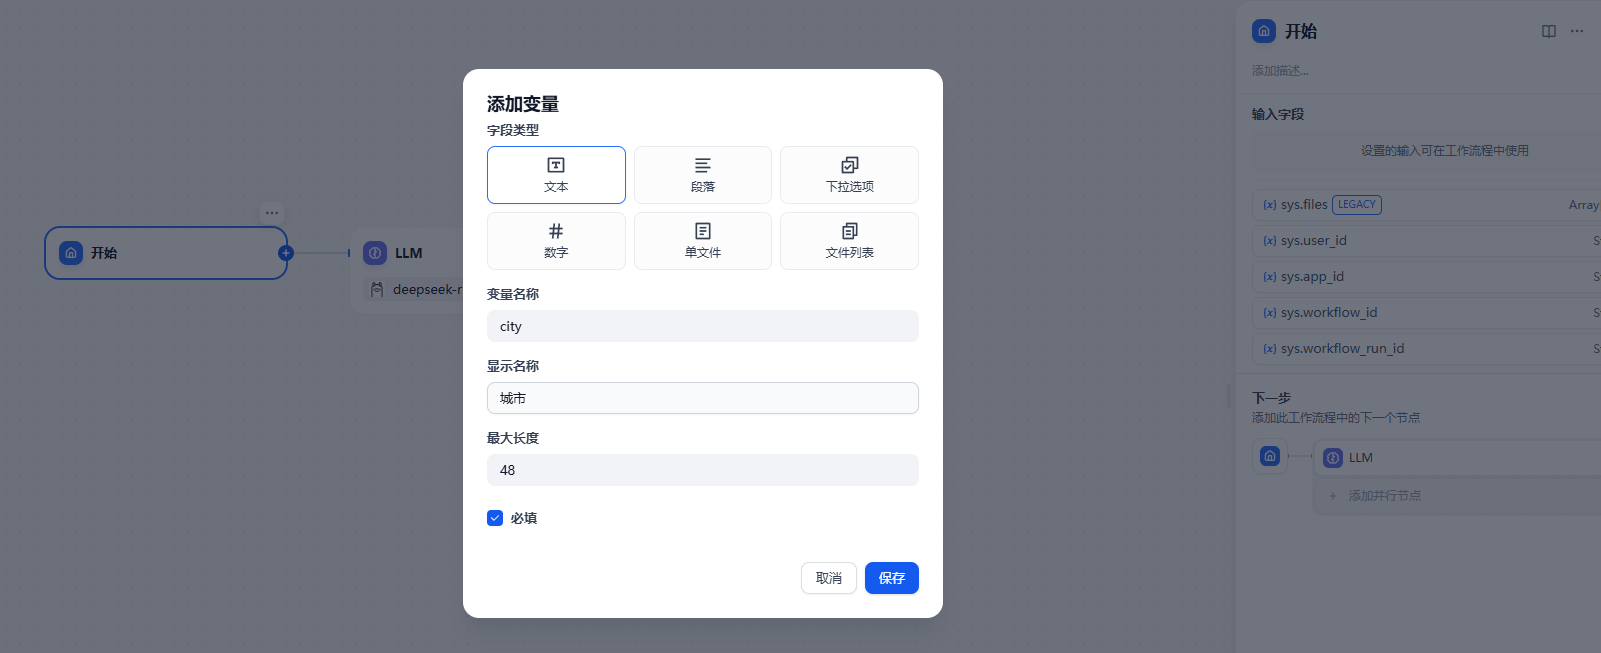
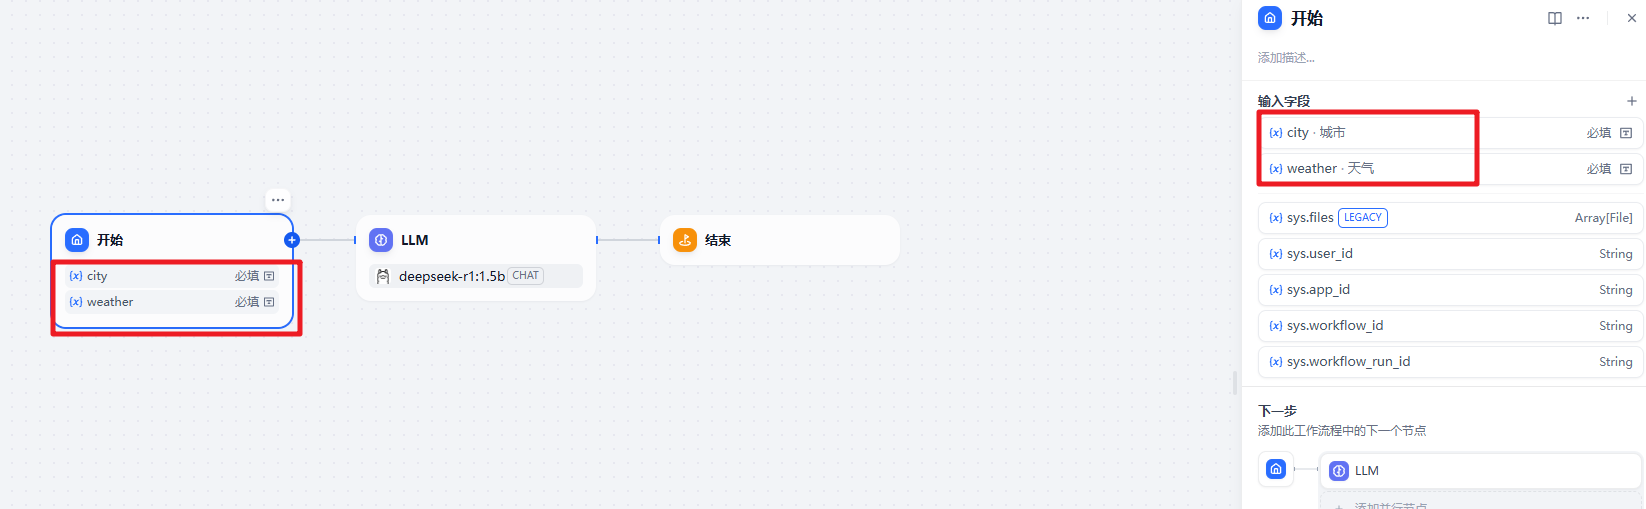
在开始节点我们设置两个输入 城市和天气
在大模型中设置和前面相同的提示词
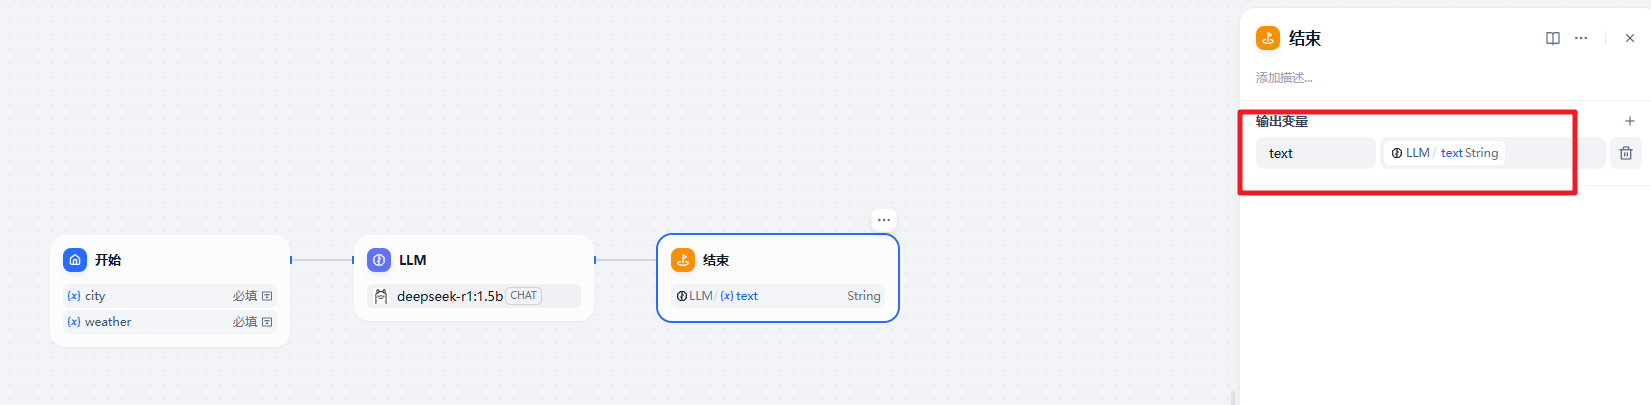
在结束的位置输出大模型的输出信息
然后测试即可
3.2 工具篇

系统工具

我们可以在头部的 工具 标签进入
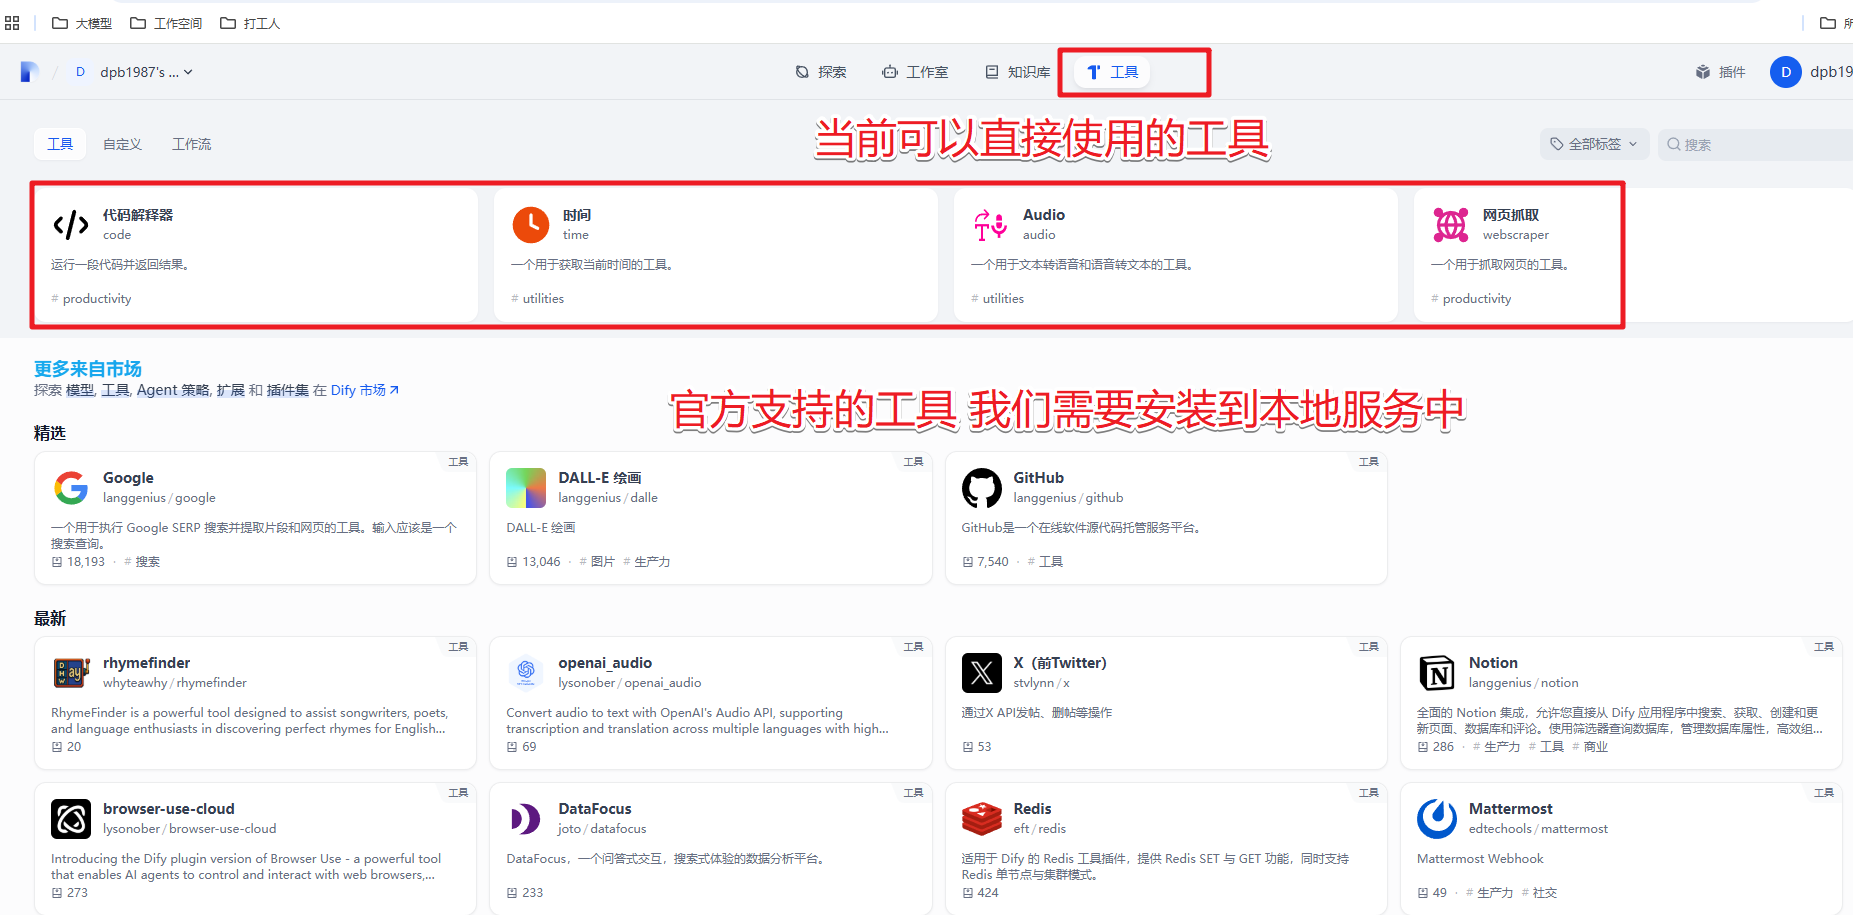
然后再dify市场中选择我们需要的工具,比如 硅基流动 的工具
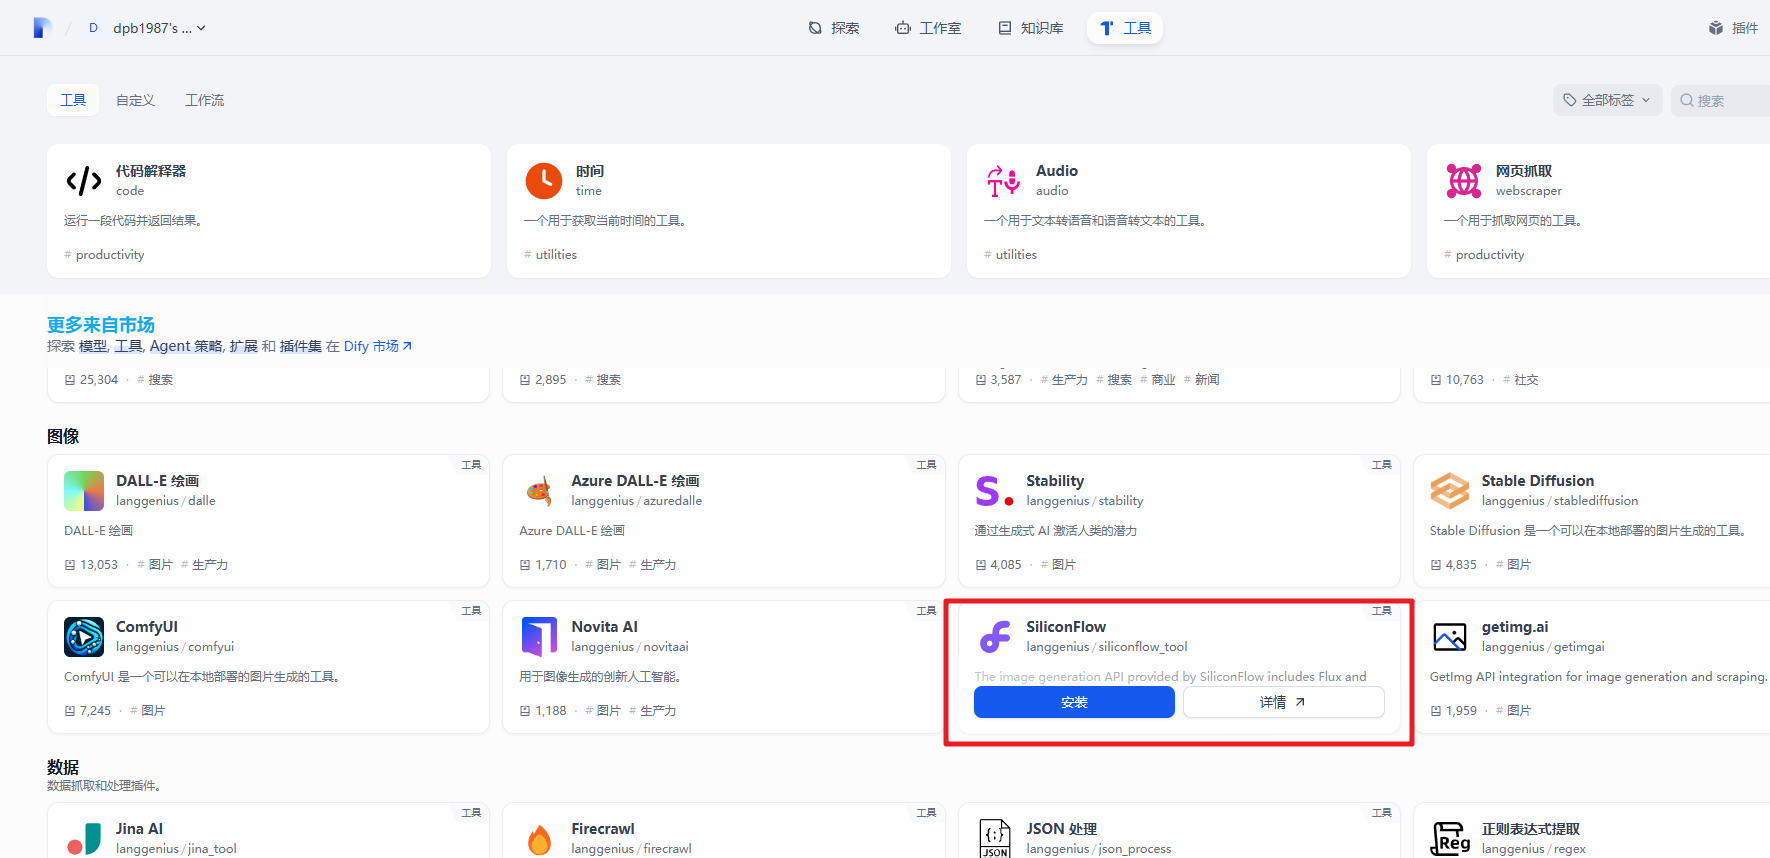
选中后点击安装
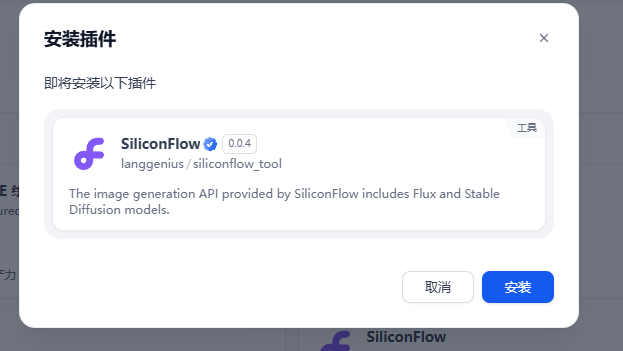
等待下载安装即可:
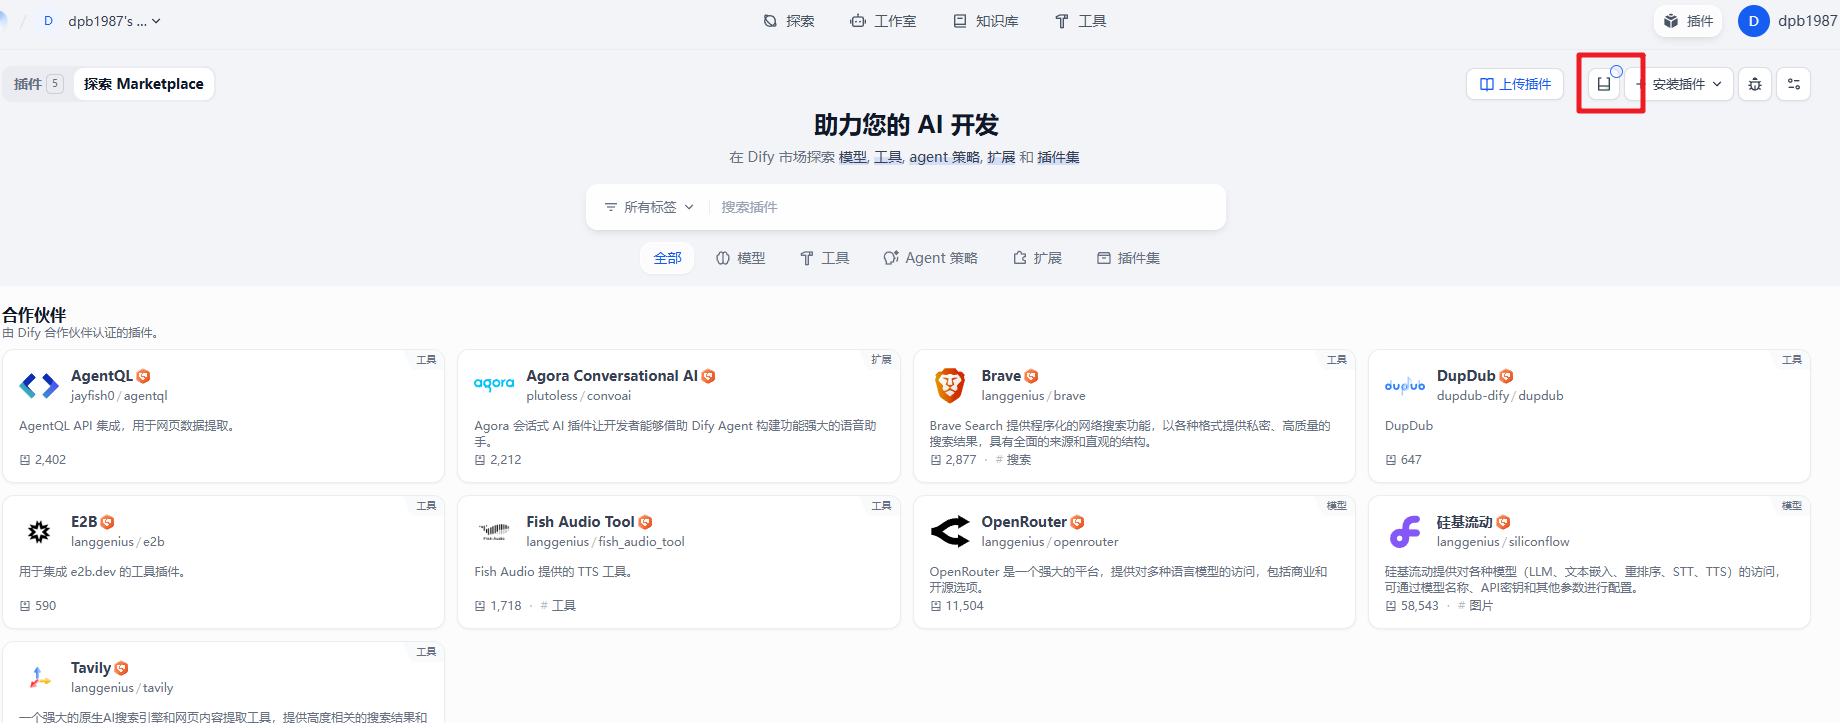
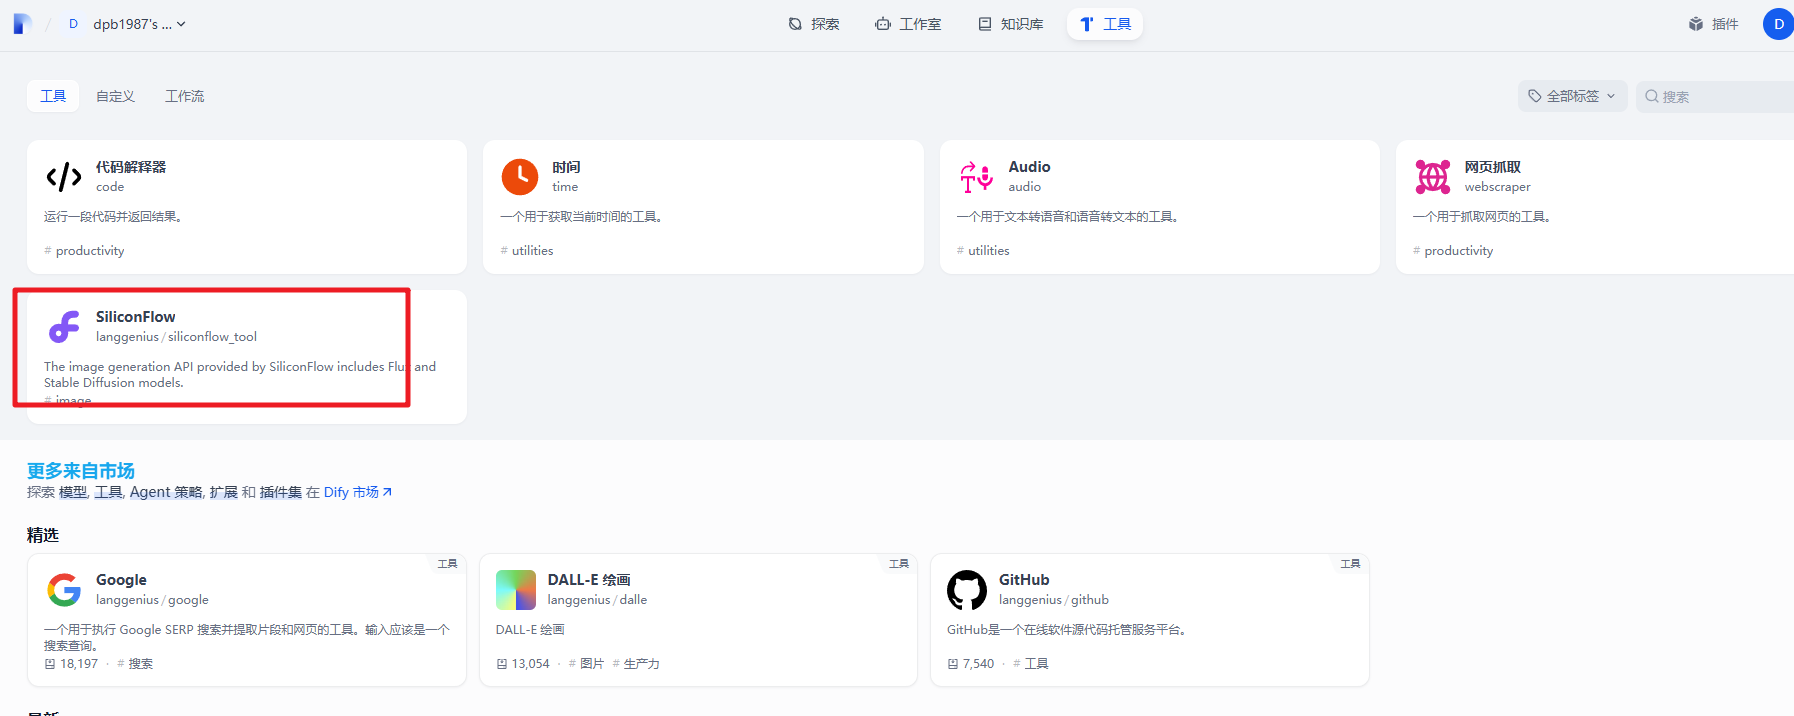
安装成功就可以在插件或者工具中看到了
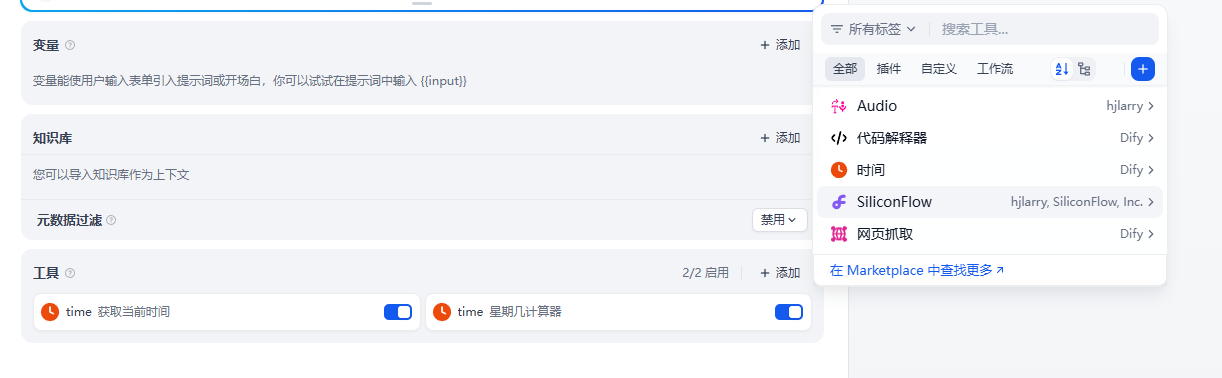
然后回到之前的Agent 案例中。我们可以加入这个工具
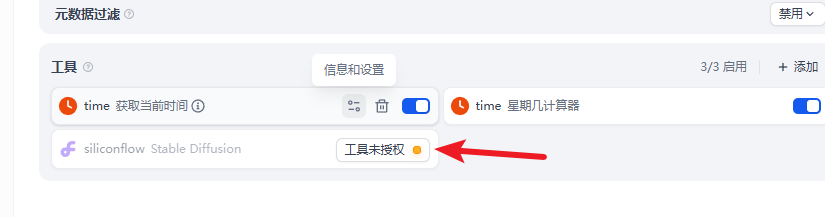
第一次使用提示你需要授权:
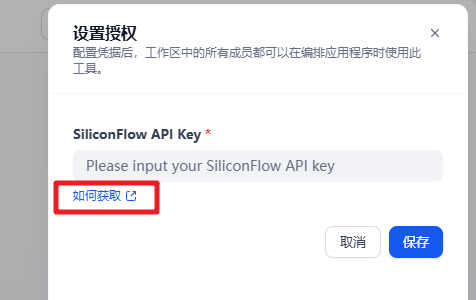
进入对应的官网。注册登录后获取API key
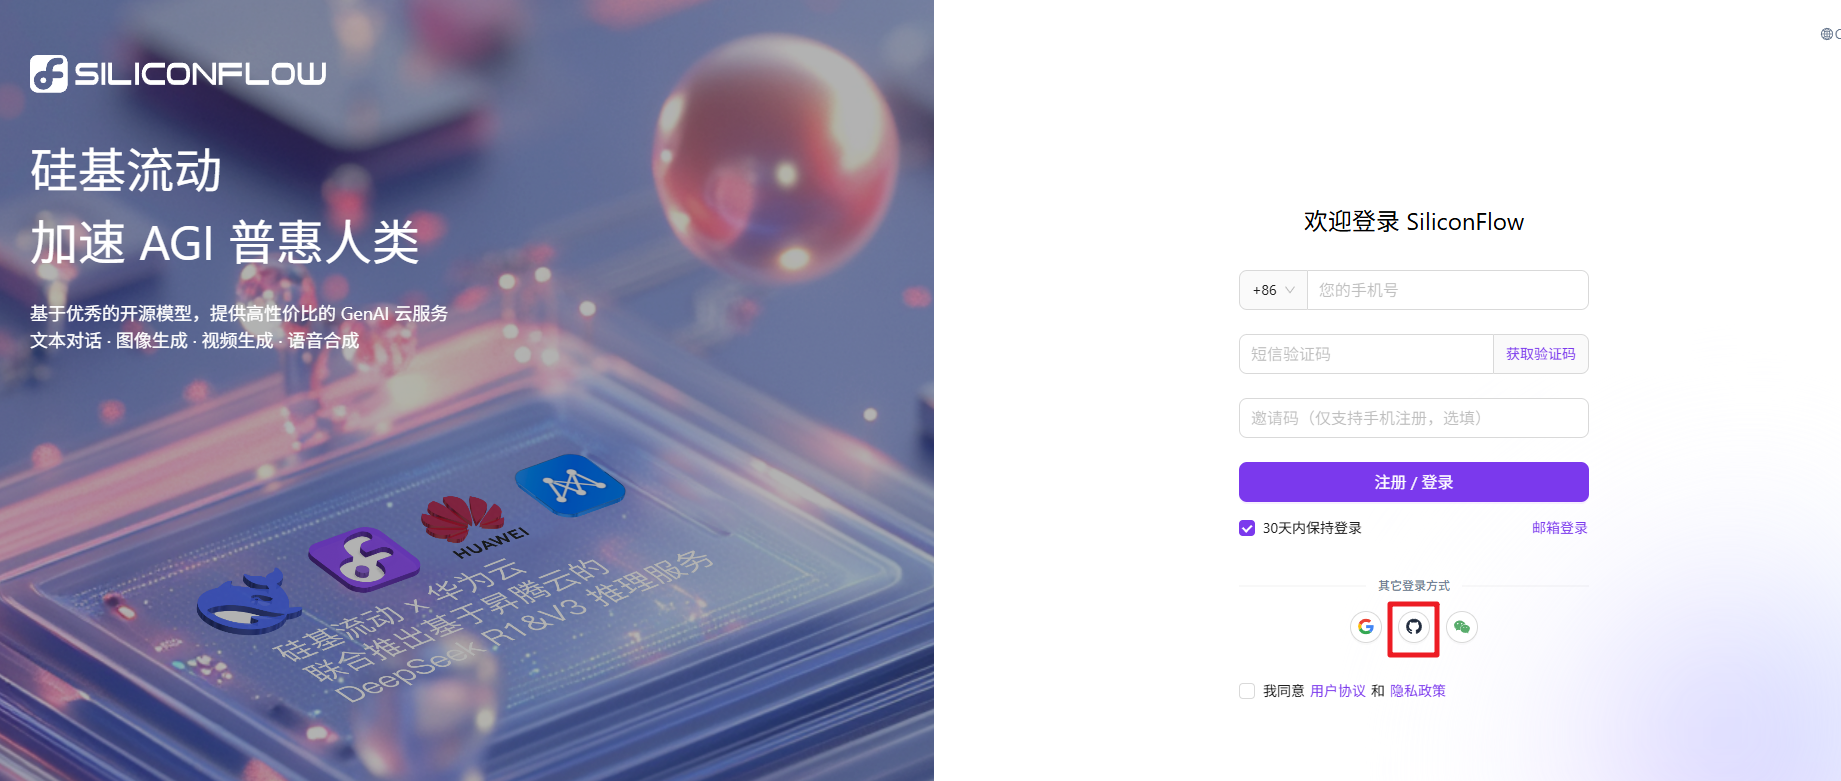
可以选择适合自己的方式

然后我们尝试来使用,发现这个工具好像并不好用。
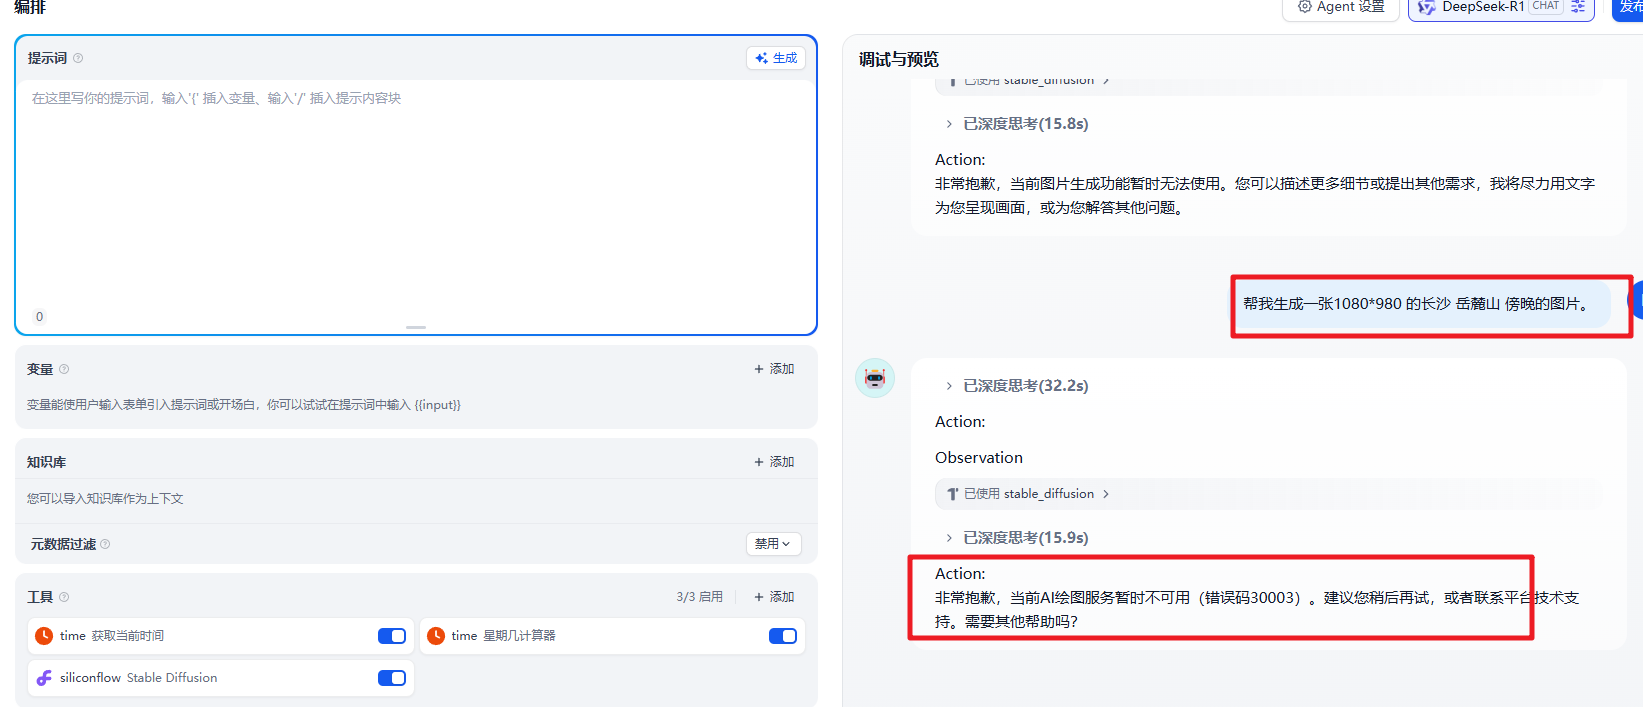
在这种情况下我们可以结合工具官方的API来实现自定义工具的使用。

自定义工具

官方提供的工具在某些场景下并不能满足我们的需求。这时我们可以创建我们自己的工具来解决这个问题。我们创建一个通过 硅基流动 工具来帮我们生成图片的工具。
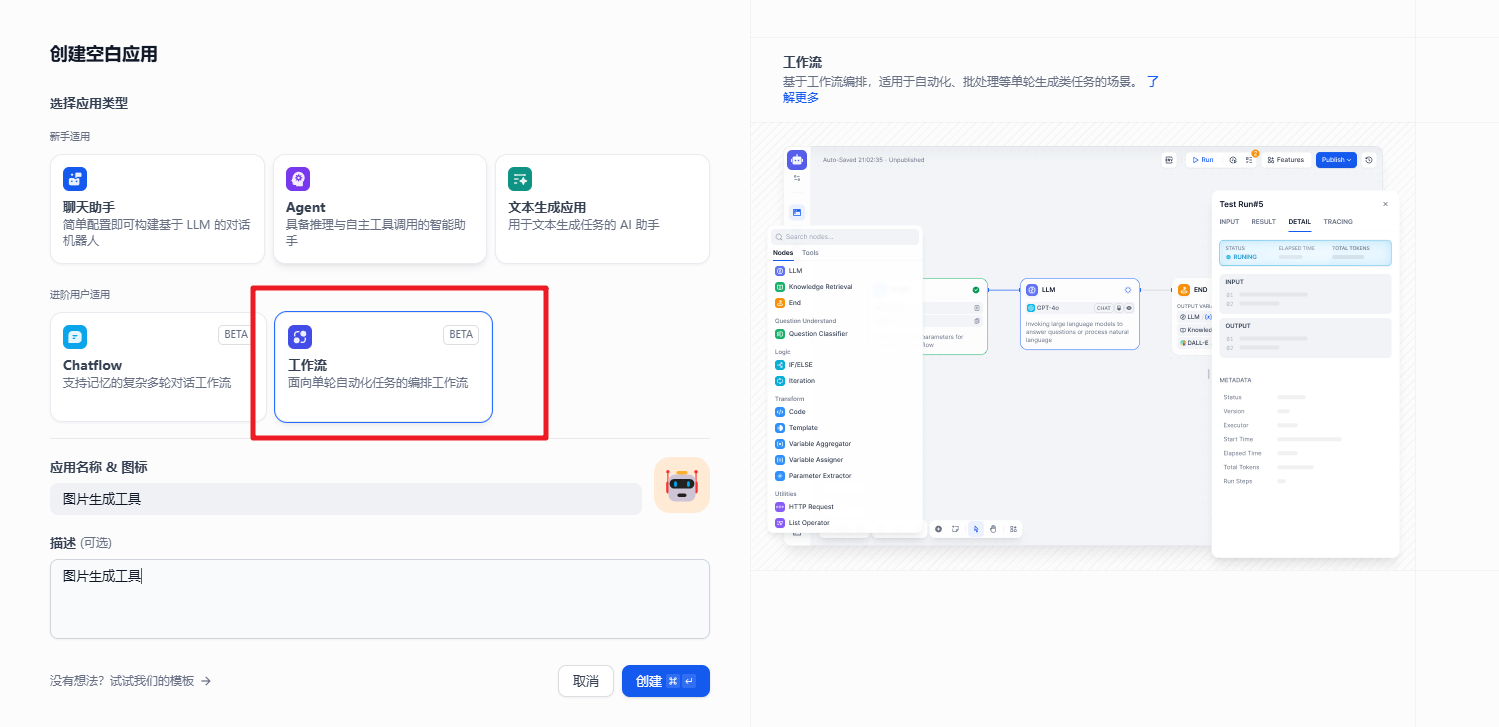
设置的工作流
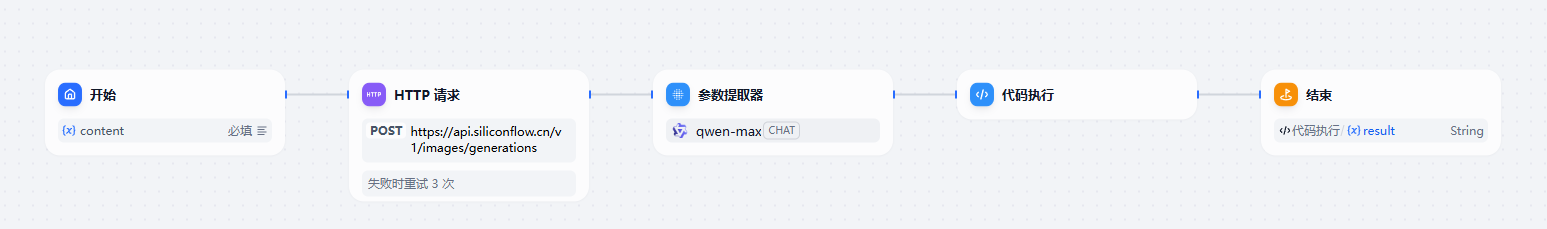
相关节点介绍
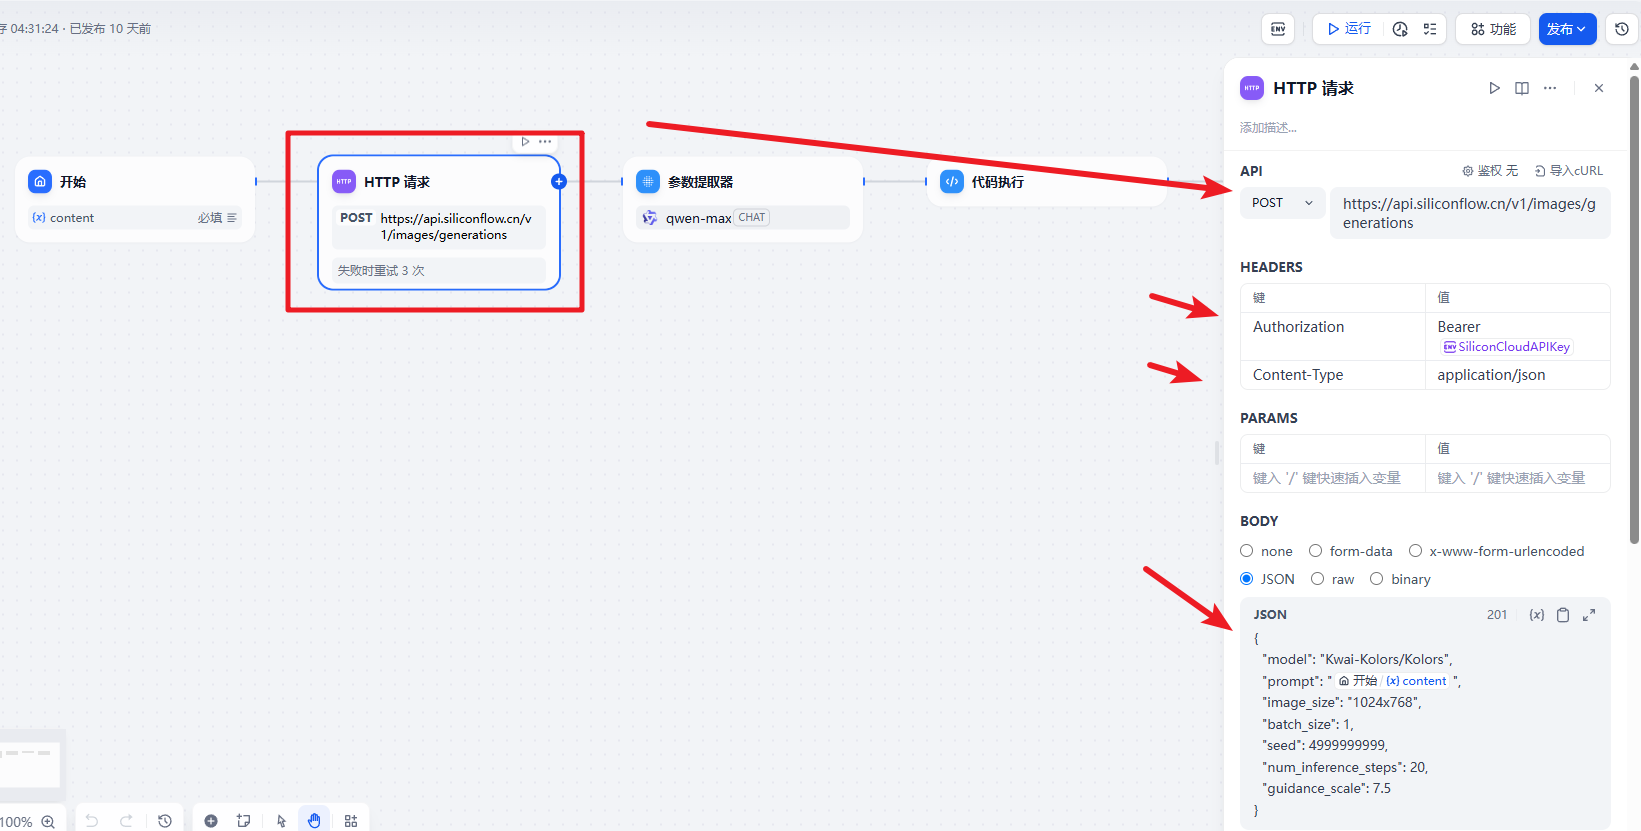
添加一个http请求节点来发起请求: 官方的地址: 创建图片生成请求 - SiliconFlow
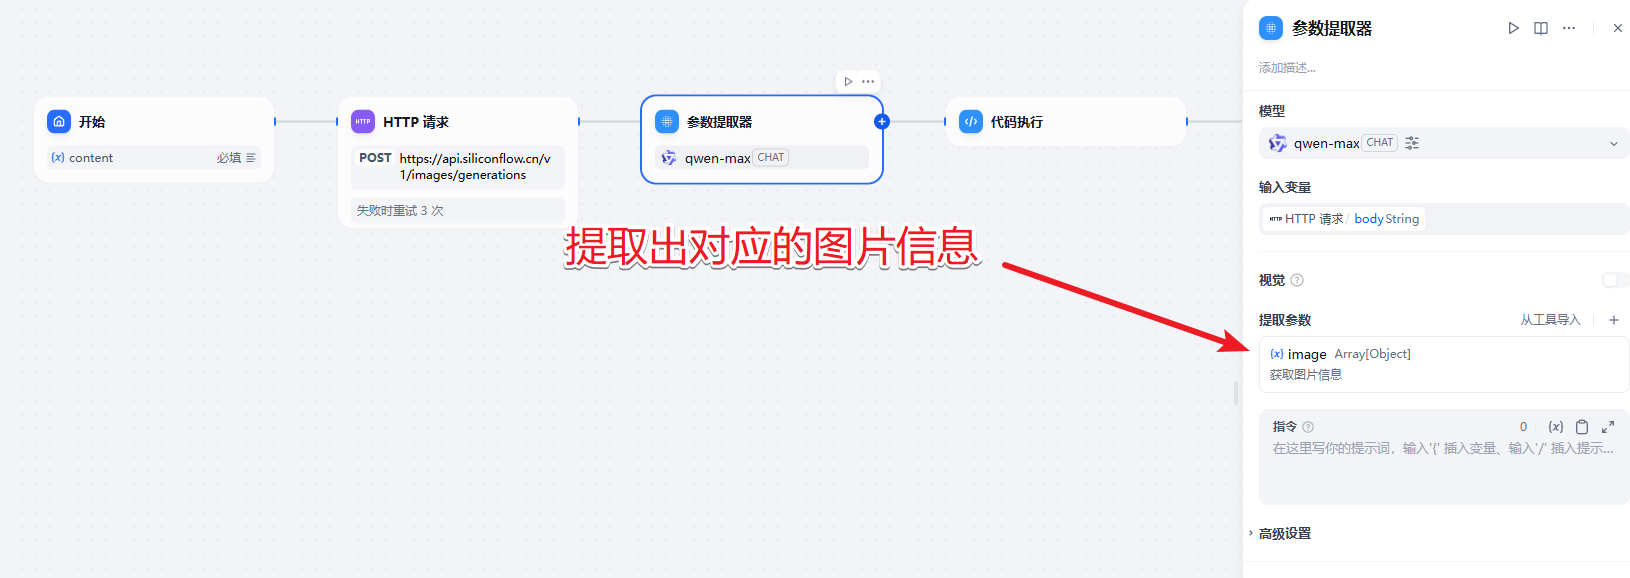
通过然后模型来提取信息
然后是代码执行的逻辑。处理多个图片信息


from typing import Any, Union


def main(data: Any) -> str:
    """
    从复杂数据结构中安全提取第一个URL(优化版)

    :param data: 支持 dict/list/str 的任意嵌套数据结构
    :return: 总是返回字符串类型,找不到时返回空字符串
    """

    def extract_url(value: Union[dict, list, str]) -> str:
        """ 递归提取的核心逻辑 """
        if isinstance(value, str):
            return value if value.startswith(('http://', 'https://', 'data:image')) else ''

        if isinstance(value, dict):
            # 优先检查单数形式字段
            for field in ['url', 'image', 'link', 'src']:
                if field in value:
                    found = extract_url(value[field])
                    if found: return found

            # 检查复数形式字段
            for list_field in ['urls', 'images', 'links', 'sources']:
                if isinstance(value.get(list_field), list):
                    found = extract_url(value[list_field])
                    if found: return found

            # 深度搜索字典值
            for v in value.values():
                found = extract_url(v)
                if found: return found

        if isinstance(value, list):
            for item in value:
                found = extract_url(item)
                if found: return found

        return ''

    return {"result":extract_url(data)}

在结束节点返回图片地址
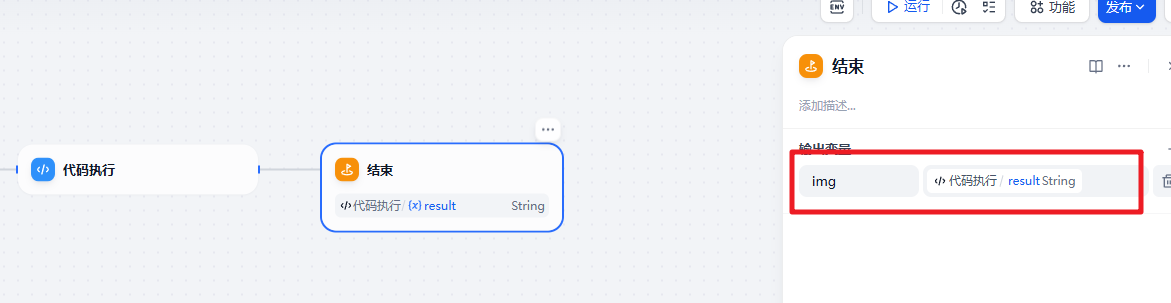
测试效果
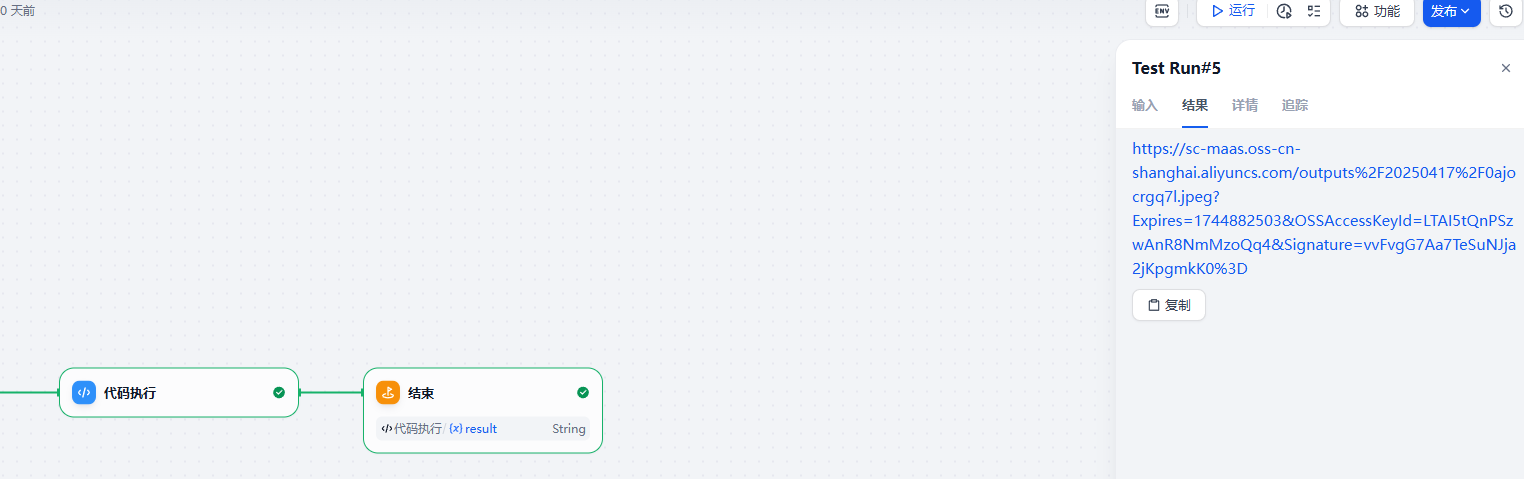
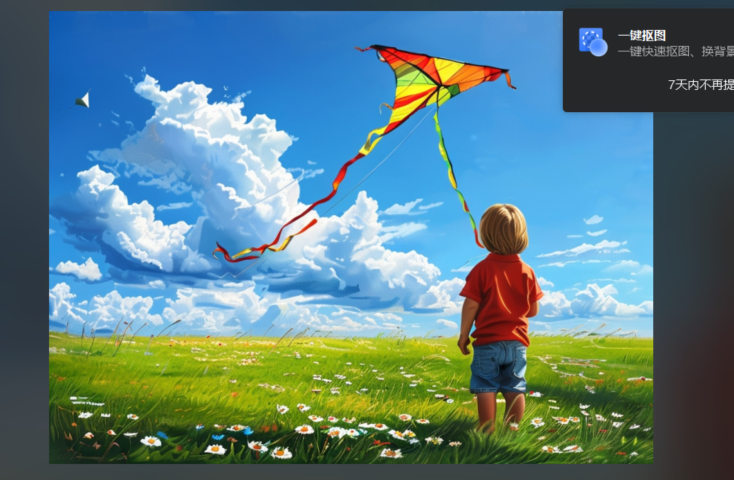
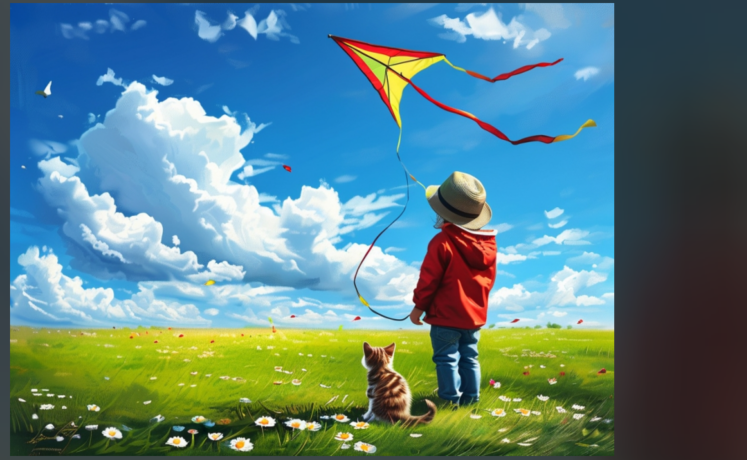
生成的图片效果
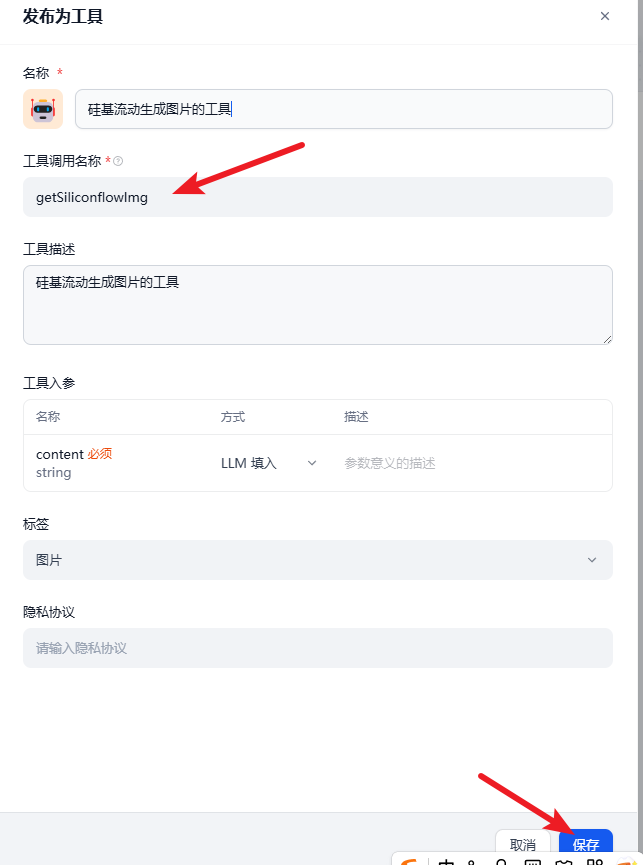
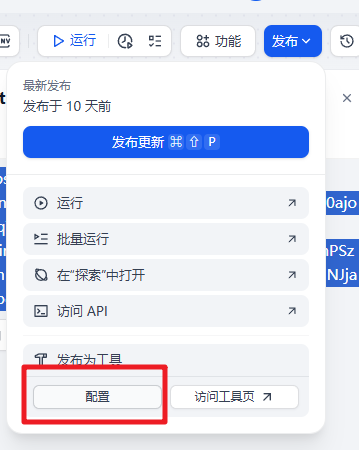
然后可以把这个发布为工具
然后我们就可以来测试下工具的使用了。还是上面的案例
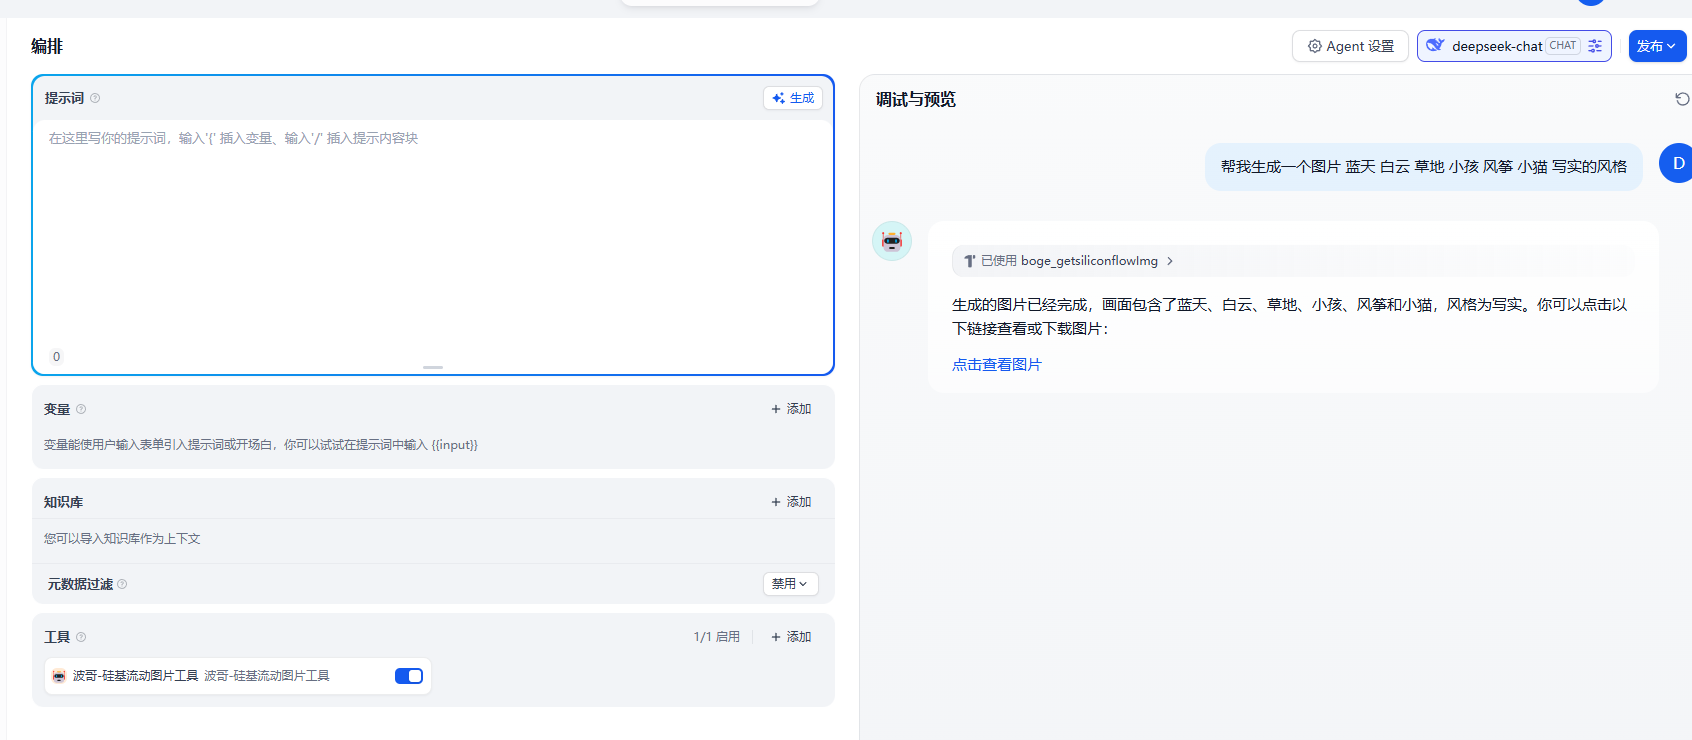
查看具体的图片
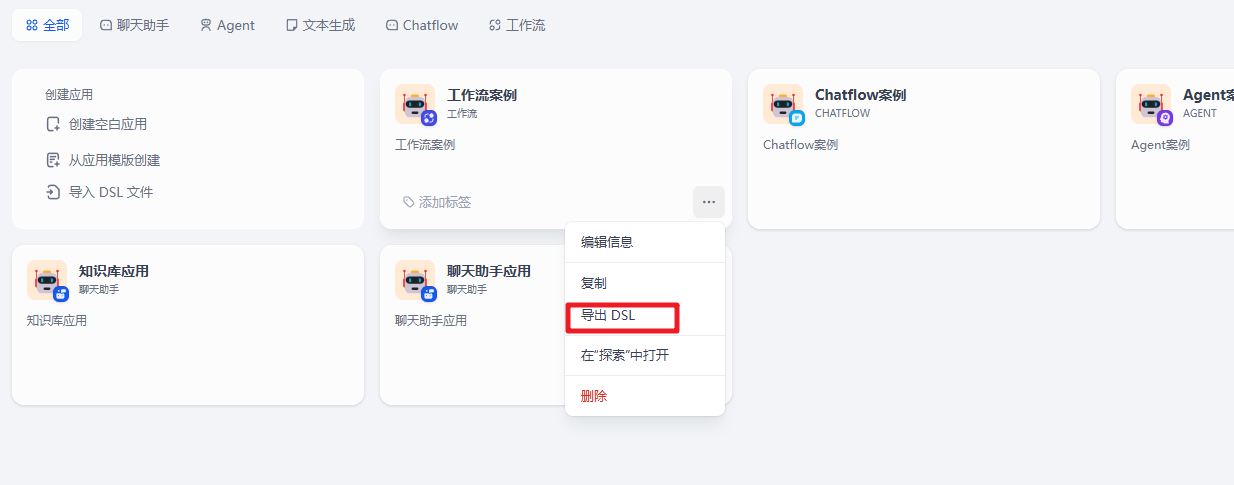
导出DSL

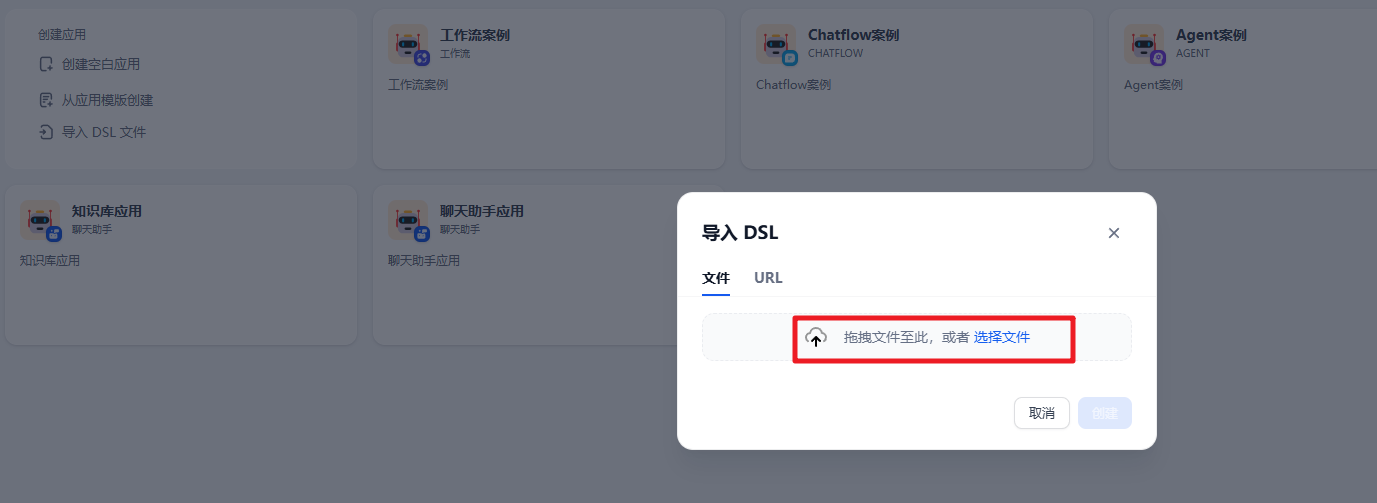
如何分享我们的Dify案例给别人呢?在官方提供了导出DSL的功能,也就是我们只需要选择对应的案例,然后导出对应的DSL文件即可。
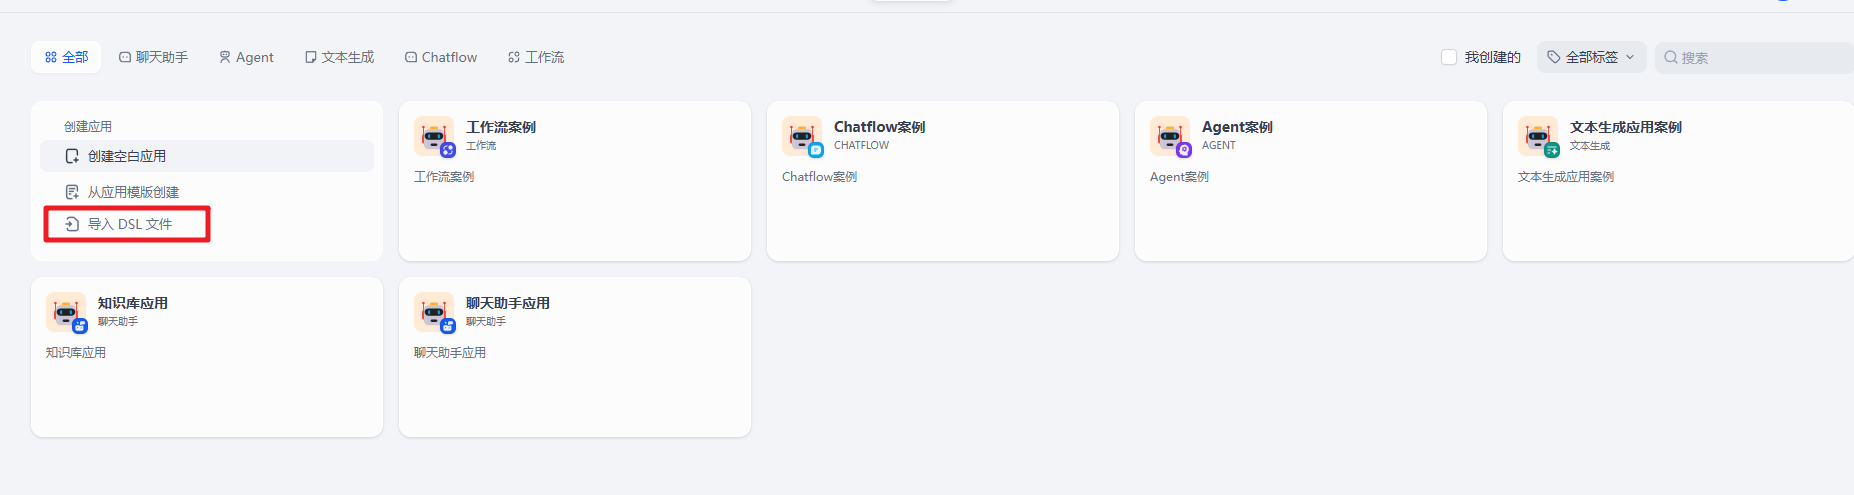
我们获取到这个dsl文件后。我们就可以把这个案例导入到我们自己的Dify工作空间了。
读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用

对于0基础小白入门:

如果你是零基础小白,想快速入门大模型是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。

包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!

2024最新版CSDN大礼包:《AGI大模型学习资源包》免费分享**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版CSDN大礼包:《AGI大模型学习资源包》免费分享

VIP dify平台新手入门指南 通过以上步骤,新手可快速完成Dify的部署与基础应用开发。如需深入探索高级功能(如Agent框架、企业级LLMOps),可参考官方进阶文档或社区案例。首次访问需设置管理员邮箱及密码,完成后登录进入主界面。 开通可读全文·4.7k 阅读·17 点赞·16 收藏 阅读全文

相关推荐

大模型应用开发之Dify入门使用教程-deepseek-R1,只需配置30分钟就能用

Dify 是一款开源的大语言模型(LLM) 应用开发平台。30分钟dify靠谱的详情操作贴,按照步骤,你也可以生成参考知识库内容回答的智能专业客服机器人。

ZZZ_Tong的博客 5558

【2025年看这一篇就够了】Dify从入门到精通

官方中文地址:Dify.AI · 生成式 AI 应用创新引擎产品简介 - Dify Docs开源的 LLM 应用开发平台。提供从 Agent 构建到 AI workflow 编排、RAG 检索、模型管理等能力,轻松构建和运营生成式 AI 原生应用。比 LangChain 更易用。Dify提供的有2个版本,分别是:社区版商业版对于我们来说我们使用社区版本就可以了,因为我们最终还是需要把Dify部署到我们的本地来使用的。官方提供的工具在某些场景下并不能满足我们的需求。

qq_38196449的博客 5万+

别再只盯着MES了!半导体/面板厂CIM系统全家桶(EAP/YMS/SPC)保姆级入门指南

本文深入解析半导体制造中的CIM系统,涵盖EAP、YMS和SPC等关键子系统的协同工作。通过实战案例和技术细节,展示如何利用CIM系统提升生产效率、良率管理和设备维护,为半导体/面板厂提供全面的实施指南和优化策略。

weixin_33693070的博客 456

从零开始之Dify部署篇

Dify传送门。本系列文章从零开始探索Dify的功能及搭建过程。本文的搭建流程是基于Docker Compose进行部署。

u013563715的博客 7万+

潜在图神经网络学习笔记(Latent Graph Neural Networks for Human Skeleton-based Action Recognition)

在本文中,我们从一个新的角度来解决这个问题,通过将非结构化的骨架数据映射到潜在空间,如图2所示,这里称为潜在特征空间或嵌入空间,其中一组项嵌入在一个流形中[ 1 ],并且在潜在空间中彼此更相似的项被放置在彼此更接近的位置。潜在空间中的位置可以被认为是由一组潜在变量定义的,这些潜在变量来源于对象的相似性。将骨架数据嵌入到流形中,消除了远近邻居之间的冗余依赖关系,以解决加权问题。得到具有多尺度聚合特征的稀疏图矩阵结构,以更好地理解骨骼关节的直接加权信息。

qq_45631885的博客 486

基于PCIE8311+FPGA+TMS320F28335 PCIE应用项目开发板PROTEL99设计硬件(原理图+PCB)文件

基于PCIE8311+FPGA+TMS320F28335 PCIE X1应用项目开发板PROTEL99设计硬件(原理图+PCB)文件,Protel 99se 设计的项目工程文件,包括原理图及PCB印制板图,可用Protel或 Altium Designer(AD)软件打开或修改,都已经制板在实际项目中使用,可作为你产品设计的参考。

GJZGRB的博客 573

大模型(deepseek)之运用Dify构建智能体和工作流应用

完成设置后回到主页面,可以看到顶部的4个页面。“探索”页面提供了模板应用程序,用户可参考模板定制自己的应用程序。“工作室”页面用户可创建自己的应用,包括聊天助手、智能体、工作流。“知识库”页面用户可以通过上传自己的文本数据创建知识库增强 LLM 的上下文。“工具”页面是Dify本身集成第三方工具,用户也可自定义工具。

qq_31400983的博客 5万+

生物信息学新手必看:MAFFT多序列比对从安装到实战(附参数优化技巧)

本文为生物信息学新手提供了MAFFT多序列比对工具的完整指南。从Linux环境下的安装部署,到核心算法策略(如FFT-NS-i、L-INS-i)的选择逻辑,再到空位罚分等关键参数的深度解析与优化技巧,手把手教你完成从原始序列到高质量比对结果的实战流程,为后续进化树构建等分析奠定坚实基础。

weixin_29230773的博客 479

【2025版】最新轻松搭建自己的RAG知识库,零基础入门到精通,收藏这篇就够了

Retrieval-Augmented Generation (检索增强生成)

leah126的博客 3035

2026年数学建模国赛论文排版规范:Word与LaTeX终极对比及模板

提前演练:不要等到比赛开始才第一次使用排版工具。至少在赛前一个月完成1-2篇模拟论文的全流程排版练习。建立检查清单:基于国赛规范制定排版检查清单,在提交前逐项核对——公式编号连续?图表引用准确?参考文献完整?页数不超限?善用模板但不止于模板:模板提供的是起点而非终点。根据自身需求调整宏包配置和样式参数,理解每一行配置的含义。关注评审体验:从评委的视角审视论文——重点内容是否突出?逻辑结构是否清晰?视觉层次是否合理?备份与容错:无论使用何种工具,建立多级备份机制。本地、云端、U盘各存一份,且定期保存历史版本。

YOLO 202

SkillClaw:让大模型 Agent skill在多用户生态中实现群体进化的框架

随着大模型应用步入深水区,基于 LLM 的智能体(Agent)正从单一的“沙盒玩具”转变为处理真实世界复杂任务的生产力工具。然而,现有的 Agent 系统通常面临一个致命瓶颈——部署即固化。为了解决这一问题,最近有一篇新论文**《SkillClaw: Let Skills Evolve Collectively with Agentic Evolver》**提出了一种多用户生态 Agent 群体进化框架。

kakaZhui的博客 256

Dify构建智能体和工作流应用(非常详细)零基础入门到精通,收藏这篇就够了

完成设置后回到主页面,可以看到顶部的4个页面。“探索”页面提供了模板应用程序,用户可参考模板定制自己的应用程序。“工作室”页面用户可创建自己的应用,包括聊天助手、智能体、工作流。“知识库”页面用户可以通过上传自己的文本数据创建知识库增强 LLM 的上下文。“工具”页面是Dify本身集成第三方工具,用户也可自定义工具。

Javachichi的博客 1万+

从原理到落地:监控 SAP OData bgRFC 队列的全景实践指南

摘要(150字) 本文系统讲解SAP Gateway/Backend场景中bgRFC队列的监控方法。内容涵盖:1)监控必要性——确保异步可靠传输,及时识别失败消息;2)两种服务质量(EO/EOIO)对监控策略的影响;3)通过事务码SBGRFCMON和SPRO路径访问监控界面;4)关键授权S_BGRFC的配置要求;5)详细操作指南包括筛选条件和动作选项;6)标准巡检脚本;7)三个典型案例(认证错误、顺序阻塞、调度压力)的诊断与修复方案。全文提供完整的监控方法论和实战指导。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 274

2025版最新RAG知识库问答的应用,零基础入门到精通,收藏这篇就够了

在信息爆炸的时代,企业面临着如何有效获取和利用知识的问题。基于RAG(Retrieval-Augmented Generation)知识库问答的应用,正是解决这一挑战的重要手段。RAG结合了信息检索和文本生成的优势,能够在海量数据中快速提取相关信息,并生成高质量的回答。本文将探讨RAG知识库问答的业务方案及其在垂直应用领域的潜力。

leah126的博客 1419

RT-DETR改进有效系列目录 | 包含卷积、主干、RepC3、注意力机制、Neck上百种创新机制

Hello,各位读者们好Hello,各位读者,距离第一天发RT-DETR的博客已经过去了接近两个月,这段时间里我深入的研究了一下RT-DETR在ultralytics仓库的使用,旨在为大家解决为什么用v8的仓库训练的时候模型不收敛,精度差的离谱的问题,我也是成功的找到了解决方案,对于ultralytics仓库进行多处改进从而让其还原RT-DETR官方的实验环境从而达到一比一的效果。同时本人一些讲解视频和包含我所有创新的RT-DETR文档。

Snu77的博客 3万+

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

【2025版】快速搭建dify和deepseek,从零基础到精通,精通收藏这篇就够了!

Ollama的安装基于CPU运行基于GPU运行经测试,DeepSeek R1:7b大模型在10G以上显存的环境可以很流畅,使用GPU需要先配置依赖环境

Javachichi的博客 1387

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

基于 Docker Compose 零基础本地一键快速安装应用 Dify官方最新的Release版本,大模型入门到精通,收藏这篇就足够了!

Dify 开源项目在GitHub上目前已获得了高达110k的Star数。2025年7月28日,dify正式发布了1.7.1版本,这次更新不仅修复了多个关键问题,还带来了许多新功能和性能优化,极大地提升了用户的产品体验与开发效率。

2301_81940605的博客 1589

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

【2025版】最新AI大模型的原理是什么?零基础入门到精通,收藏这篇就够了

AI大模型的原理基于深度学习和神经网络技术。其中,最著名的大模型之一是使用了变种的转换器(Transformer)架构的模型,比如GPT(Generative Pre-trained Transformer)。以下是AI大模型的基本原理:1数据收集和预处理:大模型的训练需要大量的数据。首先,大量的文本数据被收集和预处理,其中可能包括网页内容、书籍、新闻文章、维基百科等。数据可能会经过一定的清理和标准化处理。2模型架构:大模型通常基于深度神经网络架构,如变种的转换器模型。

leah126的博客 1486

【2025版】最新从零手写大模型,零基础入门到精通,收藏这篇就够了

在大模型技术发展迅猛的现在,深入理解其底层原理和实现细节成为很多技术爱好者和从业者的追求。算法博主**“chaofa用代码打点酱油”**发布的LLMs-Zero-to-Hero系列作品,全方位解析从GPT模型结构剖析、代码实践搭建,到数据处理、模型训练与调试优化。视频来源-博主“chaofa用代码打点酱油”视频号整个过程,帮助众多读者在大模型领域实现了从 “小白” 到能独立实践的 “高手” 的华丽转变。# LLMs-Zero-to-Hero,完全从零手写大模型,从数据处理到模型训练,细节拉满。

Javachichi的博客 1648

2025版最新AI大模型的原理是什么?零基础入门到精通,收藏这篇就够了

AI大模型的原理基于深度学习和神经网络技术。其中,最著名的大模型之一是使用了变种的转换器(Transformer)架构的模型,比如GPT(Generative Pre-trained Transformer)。1数据收集和预处理:大模型的训练需要大量的数据。首先,大量的文本数据被收集和预处理,其中可能包括网页内容、书籍、新闻文章、维基百科等。数据可能会经过一定的清理和标准化处理。2模型架构:大模型通常基于深度神经网络架构,如变种的转换器模型。

leah126的博客 1496

2025总结10大构建Agent工具,零基础入门到精通,收藏这篇就够了

后台回复"资料",即可获取整理好的算法面试题(大模型、深度学习、机器学习)Pydantic-AI:类型安全的革命Pydantic-AI 为人工智能生成的输出带来了类型安全和结构化验证。通过与 Pydantic 模型集成,它确保了输出的一致性,减少了幻觉和意外响应。🔥 核心优势:输出质量可靠地符合你定义的模式。⚠️ 潜在问题:更高的 token 消耗意味着你需要留意预算。Pure Python:极简主义者的首选许多资深开发者完全摒弃框架,转而采用纯 Python 实现。

leah126的博客 1369

2025版最新大模型微调方法汇总,零基础入门到精通,收藏这篇就够了

大模型由于计算量过于庞大,所以无论是学术界还是工业界,都很难支撑起来从头训练的成本,所以业界开始研究各种大模型微调方法,下面就给大家汇总下领域常用的微调方法。

Python_0011的博客 1845

2025版最新RAG知识库中文档包含表格数据如何处理?零基础入门到精通,收藏这篇就够了

我们在开发RAG系统中,知识库中的数据格式可能五花八门,而且大多都是非结构化数据内容。比如知识库中的PDF文档大概率会包含表格数据,此时,我们的处理方式需要特别的注意,以确保表格信息能够被正确提取和利用。推荐使用专门的工具或库来解析PDF中的表格内容,例如,PyMuPDF 库可以提取PDF中的表格数据,并将其转换为适合检索的格式,如:Markdown或Pandas DataFrame格式。这种方法能够有效地将表格数据结构化,便于后续的检索和生成任务。

leah126的博客 3432

【2025版】最新大模型就业方向,零基础入门到精通,收藏这篇就够了

大模型就业方向主要集中在以下几个核心领域:数据治理方向:涉及爬虫、数据清洗、ETL、Data Engine、Pipeline等工作,确保数据质量和可用性,支持模型训练和运行。平台搭建方向:负责分布式训练、大模型集群以及工程基建,构建高效的模型运行平台,支持高性能计算。模型算法方向:专注于开发新的预训练模型和优化算法,提升模型的准确性和效率,适用于NLP、语音助手、对话机器人等领域。部署落地方向:包括云端部署和端侧部署,如推理加速平台和嵌入式系统,确保模型在实际应用中的性能和可靠性。

Python_0011的博客 1561

【2025版】最新轻松搭建自己的RAG知识库,(非常详细)零基础入门到精通,收藏这篇就够了

Retrieval-Augmented Generation (检索增强生成)

Libra1313的博客 1262

【2025版】最新RAG知识库之知识库图谱应用,零基础入门到精通,收藏这篇就够了

上篇文章介绍了使用大模型构建生成知识图谱,其实也可不用大模型用其他方式构建生成知识图谱,但RAG要结合知识图谱使用关键还是怎么把图谱的内容查询出来;简单来说可以先查出在关联查出每个Chunk所关联的实体Entity再查询出实体之间的的;这里说的RAG结合知识图谱和微软开源的GraphRAG具体实现是不同的,效果提升会更好。在Neo4j中使用查询语言可以轻松实现图谱数据的查询,通过Chunk元数据fileName以及Document与Chunk节点的关系、Chunk与实体的关系。

Libra1313的博客 1775
上一篇: 什么是多模态大模型?多模态大模型入门指南,看这一篇就够了!
下一篇: 如何学习训练大模型——100条建议(附详细说明)_如何训练自己的大模型

双11狂欢大促

盲盒赢 定制羽绒服

开启惊喜盲盒,抽取你的专属好礼

— 惊喜奖品抢先看 —
leah126
博客等级 码龄4年 1万+粉丝 3727原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值