【MOOC】Python网络爬虫与信息提取-北京理工大学-part 2

限时加码!20+主流AI编程工具免费用 购周边加赠Coding Plan Lite,Claude Code、Cursor等即刻畅享,学习进阶更高效! 阅读详情

【第二周】 网络爬虫之提取

Beautiful Soup库入门

Beautiful Soup库的安装与测试

中文文档:Beautiful Soup 4.4.0 文档
安装方式:pip install beautifulsoup4
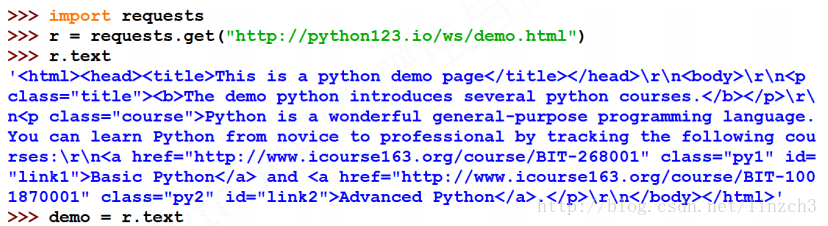
测试网站(http://python123.io/ws/demo.html)的源代码(当然用requests库获取便可):

<html><head><title>This is a python demo page</title></head>
<body>
<p class="title"><b>The demo python introduces several python courses.</b></p>
<p class="course">Python is a wonderful general-purpose programming language. You can learn Python from novice to professional by tracking the following courses:
<a href="http://www.icourse163.org/course/BIT-268001" class="py1" id="link1">Basic Python</a> and <a href="http://www.icourse163.org/course/BIT-1001870001" class="py2" id="link2">Advanced Python</a>.</p>
</body></html>

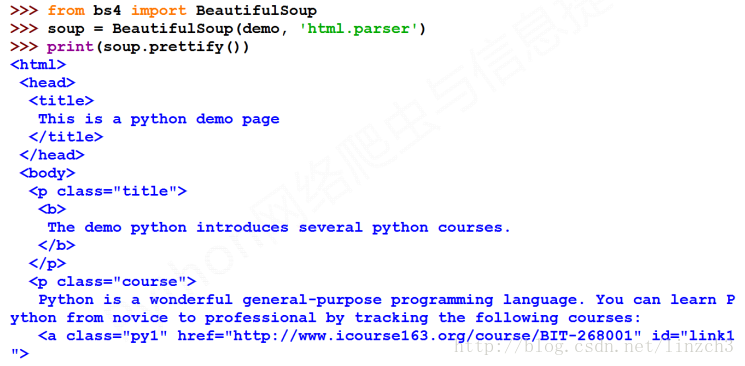
测试代码和对应的部分输出:
这里写图片描述
这里写图片描述
注: prettify函数的作用是:打印一下 soup 对象的内容,进行格式化输出,可以看到上面的该函数的输出的形式很适合我们直接阅读。另外,该函数使用得比较多,因此要多留意一下。更多的细节下面的“基于bs4库的HTML格式输出”章节。

常用使用方法:
这里写图片描述

Beautiful Soup库基本元素

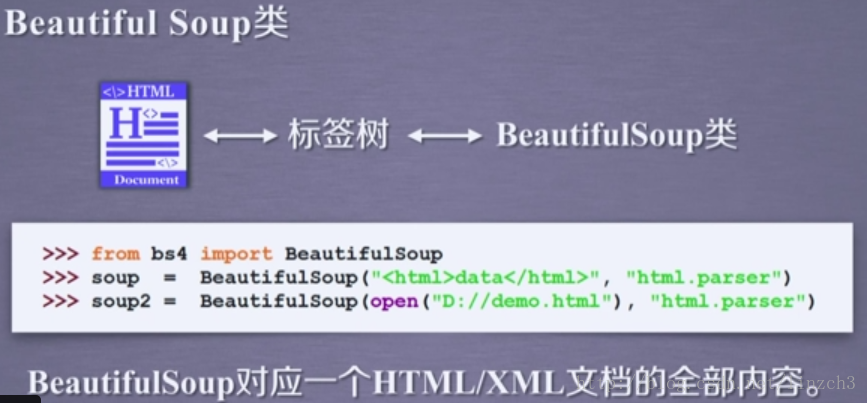
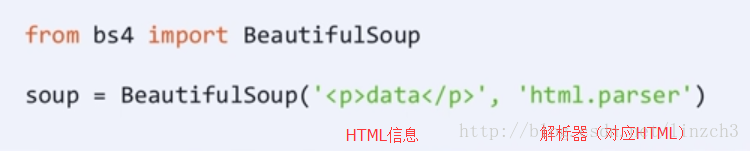
Beautiful Soup库,也叫beautifulsoup4或 bs4,约定引用方式如下,即主要是用BeautifulSoup类:

from bs4 import BeautifulSoup

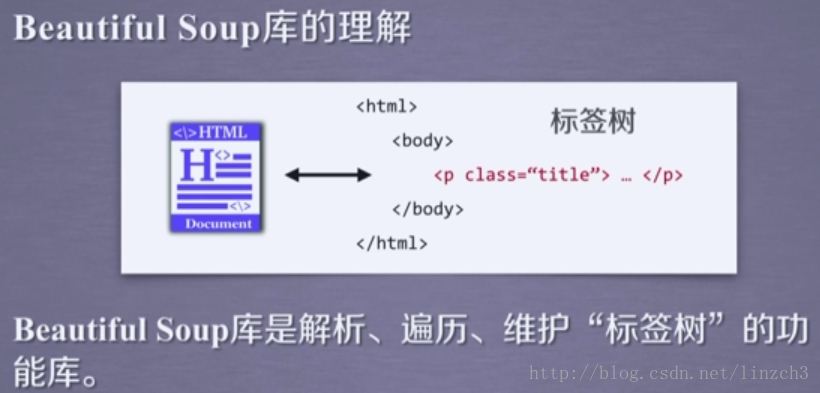
对库的理解:
这里写图片描述

这里写图片描述

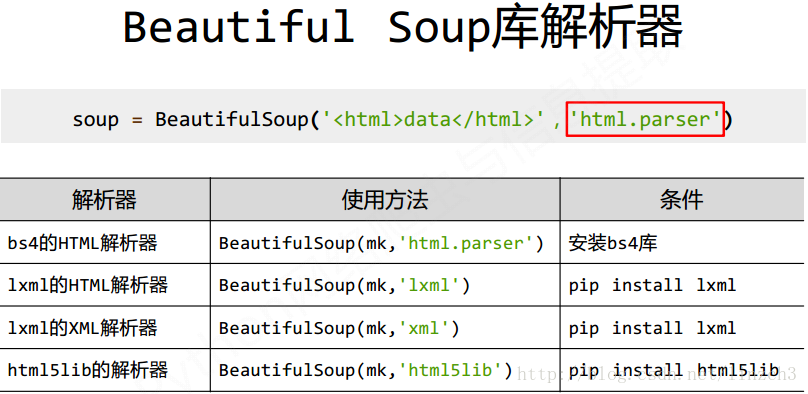
其他解析器:
这里写图片描述

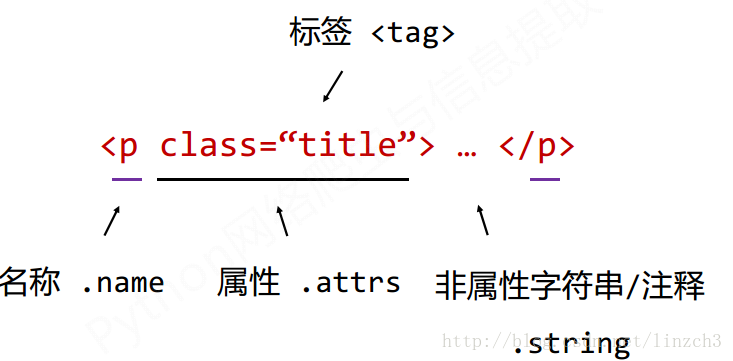
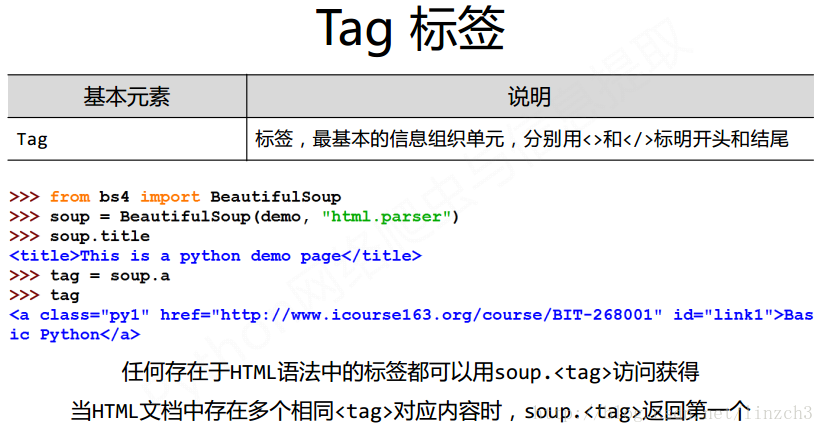
对标签的理解:
这里写图片描述

对标签的进一步说明:
这里写图片描述

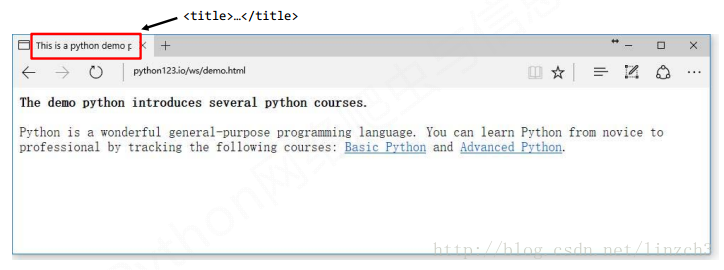
以之前的demo.html为例子:

在浏览器上显示为:
这里写图片描述

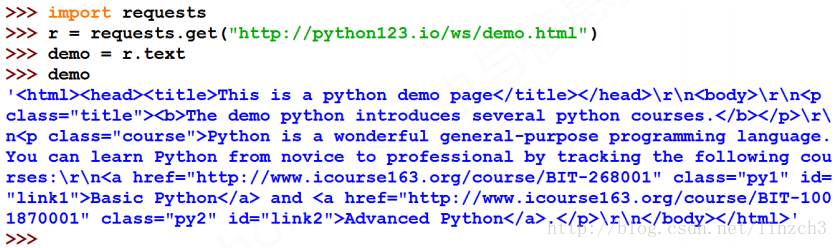
使用requests库爬取的效果:
这里写图片描述

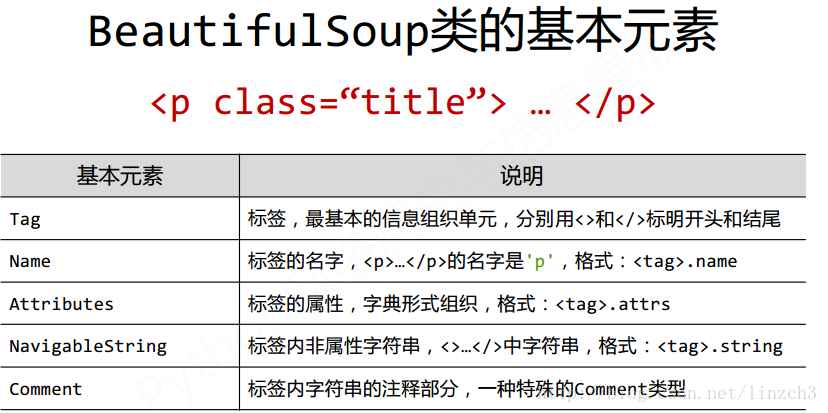
具体分析demo的基本元素:
这里写图片描述

注意:
1.soup.a是指将soup中的名字为a的标签(在HMTL5中 代表 链接标签)提取出来
2.当HTML文档中存在多个相同对应内容时,soup.返回第一个
3.上面的tag的输出是将原先的tag的属性按照属性的字母序重新排列得到的。
原先的是:

<a href="http://www.icourse163.org/course/BIT-268001" class="py1" id="link1">Basic Python</a

SWPU Python123作业题汇总(持续更新) 圆面积的计算 S 说句心里话 A 第二章 字符串逆序输出 格式化输出 计算矩形面积 温度转换 II 重量转换 蟒蛇绘制 C 第三章 a除以b 2的n次方 表达式求值 阶乘 拆分数字 天天向上的力量 B (66.7%,未全对) 字符替换 获取浮点数的整数部分和小数部分 英文字符串单词个数统计 获取月份字符串 判断闰年 求三角形面积 基础训练1 简单程序设计题 计算营业额 计算矩形面积 计算正多边形面积 求解平均值 还是求解平均值 计算圆的面积和周长 计算阶乘 阅读详情

相关推荐

国家精品公开课:Python网络爬虫信息提取+数据分析可视化

Python网络爬虫数据分析是两门课程,上半部分是Python网络爬虫信息提取,下半部分是Python数据分析展示。看完这两门课你可以完整地学习数据获取、清洗、统计、分析、可视化等数据处理周期的主要技术,也可以培养计算思维、数据思维及采用程序设计方法解决计算问题的实战能力。

2201_75362610的博客 1205

Python 高效提取 HTML 文本的方法

在解决自然语言处理问题时,有时你需要获得大量的文本集。互联网是文本的最大来源,但是从任意HTML页面提取文本是一项艰巨而痛苦的任务。 假设我们需要从各种网页中提取全文,并且要剥离所有HTML标记。通常,默认解决方案是使用BeautifulSoup软件包中的get_text方法,该方法内部使用lxml。这是一个经过充分测试的解决方案,但是在处理成千上万个HTML文档时可能会非常慢。 通过用selectolax替换BeautifulSoup,您几乎可以免费获得5-30倍的加速! 这是一个简单的基准测试,可分析.

weixin_46737755的博客 6880

MOOCPython网络爬虫信息提取-北京理工大学-part 1

【第〇周】网络爬虫之前奏课程推荐阅读文章:关于反爬虫,看这一篇就够了网络爬虫”课程内容导学【第一周】网络爬虫之规则1.Requests库入门Requests库英文文档:Requests: HTTP for Humans Requests库中文文档:Requests: 让 HTTP 服务人类注意:中文文档的内容要稍微比英文文档的更新得慢一些,参考时需要关注两种文档对应的Requests库版本。(对于

linzch3的博客 9481

python123 从入门到精通挑战台

python123 挑战台1-4

weixin_58576671的博客 2702

MOOC北京理工大学Python网络爬虫信息提取慕课答案-综合挑出了一些很难评的慕课测验题

原以为这课程的结课是小项目,没想到居然是单选题,没听课盲做掉了,记录了一些有点难评的题。

shandianchengzi的博客 1183

MOOCPython网络爬虫信息提取-北京理工大学-part 4

网络爬虫之框架1.scrapy爬虫框架介绍1.1.scrapy爬虫框架介绍安装方法: 简要地说,Scrapy不是一个函数功能库,而是一个快速功能强大的网络爬虫框架。 (爬虫框架是实现爬虫功能的一个软件结构和功能组件集合,是一个半成品,能够帮助用户实现专业网络爬虫。) scrapy爬虫框架的组成如下: 用户提交的网络请求以及从网络上获取的信息形成数据流,在这些模块间流动。 数据流的路径有:

linzch3的博客 5796

MOOCPython网络爬虫信息提取-北京理工大学-part 3

【第三周】网络爬虫之实战一、Re(正则表达式)库入门1.正则表达式的概念正则表达式是什么正则表达式是用来简洁表达一组字符串的表达式。 使用正则表达式的优势就是:简洁、一行胜千言 一行就是特征(模式)例1:代表一组字符串: 例2:代表一组(无穷个)字符串: 例3:代表一组具有某种特点但是枚举起来很繁琐的字符串: 简单来说: 正则表达式是用来简洁表达一组字符串的表达式 正则表达式是一

linzch3的博客 7792

python中文官网下载安装,python中文版官网有吗

Python123是面向Python初学者和开发者的全方位Python学习平台,网址为。Python123提供了大量Python编程教程、实战项目、在线开发环境和交互式学习体验等丰富的资源,致力于成为Python编程之路的引路人python编程代码复制。下面将从多个方面来介绍Python123。

2301_81896102的博客 955

Python网络爬虫信息提取第四周测验答案

测验4: Python网络爬虫之框架 (第4周) 1. 下面哪个不是“网络爬虫信息提取”相关的技术路线?‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‮‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‮‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬ A bs4-re B requests-bs4-re C requests-re D scrapy...

Divine0的博客 6473

Python123 作业题答案

输入n,输出1+2+...+n的和‪‬‪‬‪‬‪‬‪‬‮‬‪‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‫‬ ‪‬‪‬‪‬‪‬‪‬‮‬‪‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮。打印输出Hello World!

qq_61145525的博客 5万+

Python网络爬虫信息提取(17)—— 题库爬取整理+下载答案

上一节实现了题目的整理,没整理答案是不完整的,所以这一节加上答案的爬取。

qq_37668436的博客 3396

chatgpt赋能Python-python123怎么用

本文由chatgpt生成,文章没有在chatgpt生成的基础上进行任何的修改。以上只是chatgpt能力的冰山一角。作为通用的Aigc大模型,只是展现它原本的实力。对于颠覆工作方式的ChatGPT,应该选择拥抱而不是抗拒,未来属于“会用”AI的人。🧡AI职场汇报智能办公文案写作效率提升教程 🧡专注于AI+职场+办公方向。下图是课程的整体大纲下图是AI职场汇报智能办公文案写作效率提升教程中用到的ai工具。

pythonxxoo的博客 1168

MOOCPython网络爬虫信息提取》(第11次)网络爬虫之提取(第2周)

MOOCPython网络爬虫信息提取》(第11次) 网络爬虫之提取 21.07.31 学习目标 解析HTML页面以及信号标记提取方法 BeautifulSoup库 1个实战项目Projects 目录 文章目录网络爬虫之提取 21.07.31学习目标目录单元4:Beautiful Soup库入门4.1、Beautiful Soup库的安装4.2、Beautiful Soup库的基本元素4.2.1 Beautif Soup库的理解4.2.2 Beautiful Soup库的解析器种类4.2.3 B

小朱.小猪的博客 536

Python isinstance() 函数使用方法简介

isinstance() 函数来判断一个对象是否是一个特定类型,类似于type()函数。 比如 isinstance(tr, bs4.element.Tag) 这一语句可以用来判断tr(一个预先获取或定义的内容)是否属于bs4库中tag类型。 如果是,返回True;如果不是,返回False。 type()== bs4.element.Tag 不同,type()会认为子类类型不同于父类类型,而isinstance()默认子类继承了父类的类型。 如果要判断两个类型是否相同,推荐使用 isinstance()函

freshman_web的博客 1479

python123-Python123

Q1. 考试的时候,都用什么系统,什么软件,需要自己安装吗?Windows 7 操作系统, Python 3.5.3版本,只能用 IDLE 开发环境。做选择题时,键盘锁定不能使用,只能使用鼠标,选择题做完提交后,无法重新作答选择题,开始简答题时键盘解锁。可以使用控制台命令和计算器,但是所使用机器否有此类功能,由于考点不同无法确定,可提前前往考场确认。Q2. 在哪里下载考试需要的 Python 版本...

q6q6q的专栏 5487

Python参考题库1234

1.猜年龄 for i in list(range(10,30)): i3 = i*i*i i4 = i3*i result = 0 if (i3 >= 1000 and i3 <=10000)and(i4 >= 100000 and i4 < 1000000): sum34 = str(i3)+str(i4) for j in list(range(0, 10)): if sum34.count

qq_53934753的博客 7328

python界面登录程序_python的基础程序——简陋的管理员(用户)登录界面

下文即为简陋登陆系统的基本逻辑(即只运行一次),并不能运用于实际生活,如果想将程序运用于生活还需要从中插入循环语句和种种限制语句(例如三次出错即锁定程序等)。print("系统管理员登录界面".center(50,"*"))users=["python","root","teacher_A","desk12"]passwords=["123","tea56","des789","DESK234"]...

weixin_42509197的博客 1639

MOOC嵩天@python123作业

练习4 整数加减和 编写程序计算如下数列的值:‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‭‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‪‬ 1-2+3-4…966‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‭‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‭‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‪‬‪‬ 其中,所...

一只小菜ji的博客 9173

Python编程:使用pythink查询数据库

说下这个pythink模块的作用 背景: 我们公司的主要使用的后端语言有两种,python和php 而且有一个专门的DBA管理数据库,就是说,这个数据库不是你一个人的,有同组的成员和其他组的成员在使用,好像大部分公司都一样。 Python爬虫部分的业务,主要操作是插入;而PHP业务...

218
上一篇: 【MOOC】Python网络爬虫与信息提取-北京理工大学-part 1
下一篇: 理解Python中的with…as…语法
linzch3
博客等级 码龄11年 483粉丝 70原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值