


进程ID简介
一个进程实体对应一个task_struct结构体,关于这个结构体后续的文章会有介绍,这里我们只需要知道通过该结构体我们可以获得该进程使用的所有资源信息。
进程ID顾名思义就是进程的ID,一个进程有四种类型的ID,分别是:
- PID:用于唯一标记一个进程
这句话在以前是完全无误的,但是现在还必须加上一个条件,那就是在一个命名空间内唯一标记一个进程。关于命令空间,下一个章节会有介绍
- TGID:线程组ID
一个进程可能包含多个线程,组成一个线程组,线程组内所有的线程的TGID都等于组长的PID。
- PGID:进程组ID。
多个进程可以组成一个进程组,一个进程组内所有进程的PGID都等于组长的PID。
SID:几个进程组可以组成一个会话组,会话组内所有的进程都有相同的SID。
PID命名空间介绍
Linux的命名空间是一种资源隔离机制,我们拿PID来做说明。

上图是3级namespace,上级和下级之间是父子关系。关于namespace有两点十分关键:
- 各个namespace之间的是相互隔离的,也就是说PID可以重复。如上图各个namespace都有PID为1的进程。
- 在下级namespace中创建的进程,在上级namespace中是可见的。如上图在level2 namespace中创建了进程PID=1,该进程在level 1 namespace中被映射为PID=3的进程,在level0 namespace中被映射为PID=5的进程。
PID数据结构
struct pid
{
	atomic_t count;
	unsigned int level;
	/* lists of tasks that use this pid */
	struct hlist_head tasks[PIDTYPE_MAX];
	struct rcu_head rcu;
	struct upid numbers[1];
};
以上是PID数据结构的定义,有三个成员很重要,下面依次解释:
level:表示该进程处于第几级namespace。
number:表示该进程对应的所有PID成员,比如上图中,进程处于level2 namespace,则该进程有三个PID成员。
tasks[PID_TYPE_MAX]:指向对应的task_struct结构体,以便根据PID找到对应的task_struct。
struct upid {
	/* Try to keep pid_chain in the same cacheline as nr for find_vpid */
	int nr;
	struct pid_namespace *ns;
	struct hlist_node pid_chain;
};
nr:该PID number
ns:该PID所在namespace
pid_chain:将该PID链接到pid_hash的某个成员上去。
为了进一步理清各个结构体之间的关系,我们假设如下场景:在level2 namespace创建了一个进程A,进程A与进程B,C同属于一个进程组,进程A是组长。下面是各个结构体之间的关系图:
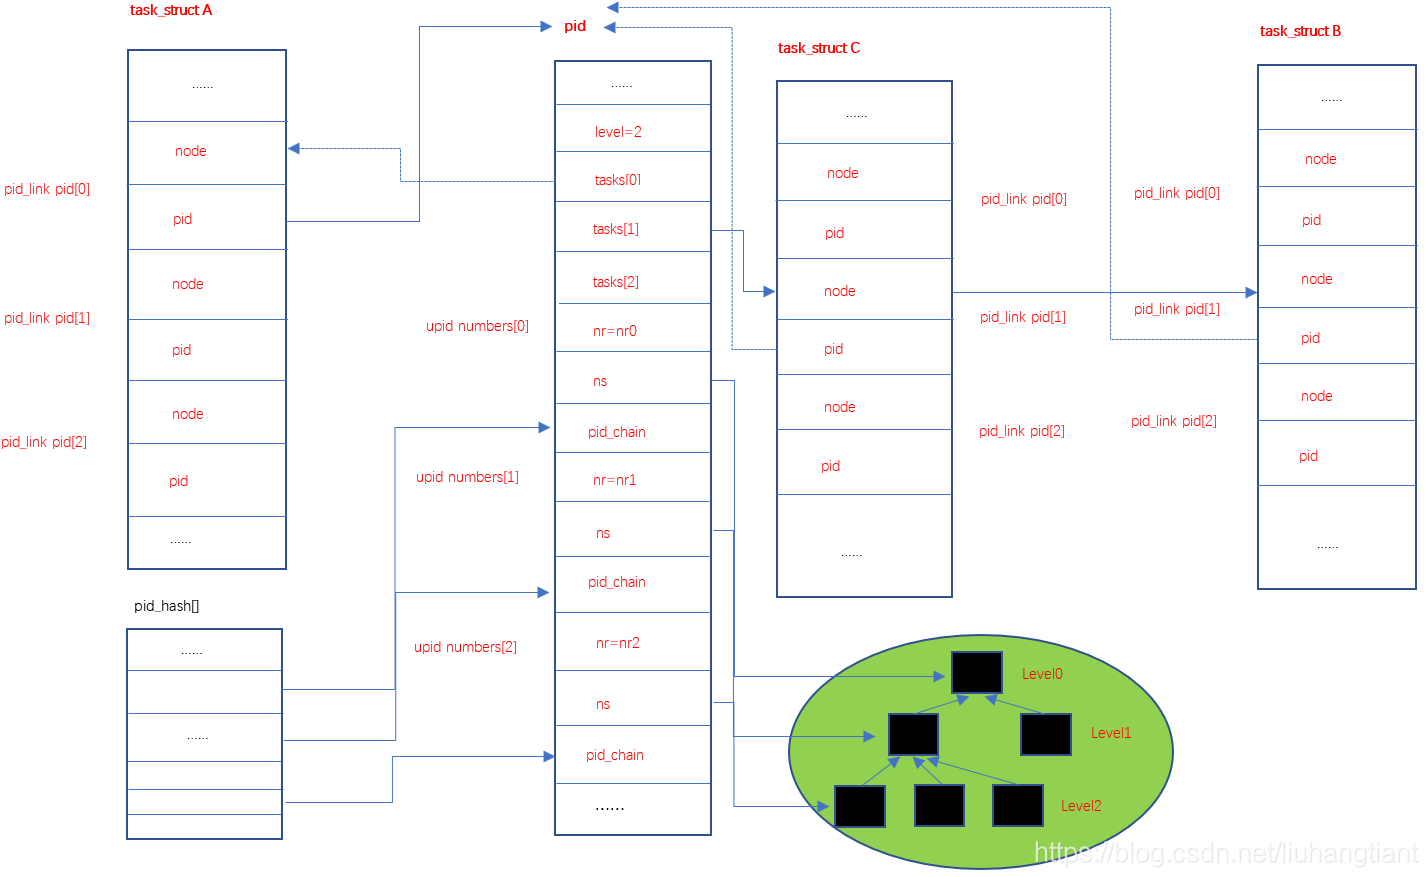
PID相关函数
- 根据task struct获取pid
static inline struct pid *task_pid(struct task_struct *task)
{
   return task->pids[PIDTYPE_PID].pid;
}
- 根据task_struct获取线程组的ID
static inline struct pid *task_tgid(struct task_struct *task)
{
   return task->group_leader->pids[PIDTYPE_PID].pid;
}
线程组ID其实就是线程组组长的PID。
3. 根据task_struct获取进程组的PGID
static inline struct pid *task_tgid(struct task_struct *task)
{
   return task->group_leader->pids[PIDTYPE_PID].pid;
}
跟线程组组长的PGID一致。
4. 根据task_struct获取会话组TPID
static inline struct pid *task_session(struct task_struct *task)
{
   return task->group_leader->pids[PIDTYPE_SID].pid;
}
跟线程组组长的TGID一致。
5. 根据pid和namespace获取局部PID number
pid_t pid_nr_ns(struct pid *pid, struct pid_namespace *ns)
{
	struct upid *upid;
	pid_t nr = 0;

	if (pid && ns->level <= pid->level) {
		upid = &pid->numbers[ns->level];
		if (upid->ns == ns)
			nr = upid->nr;
	}
	return nr;
}
首先判断pid在该namespace中是否可见,即判断ns的level是否小于pid的level。
然后遍历pid中的upid成员,找出ns一致的upid。
- 分配PID
struct pid *alloc_pid(struct pid_namespace *ns)
{
	struct pid *pid;
	enum pid_type type;
	int i, nr;
	struct pid_namespace *tmp;
	struct upid *upid;
	int retval = -ENOMEM;

	pid = kmem_cache_alloc(ns->pid_cachep, GFP_KERNEL);
	if (!pid)
		return ERR_PTR(retval);

	tmp = ns;
	pid->level = ns->level;
	for (i = ns->level; i >= 0; i--) {
		nr = alloc_pidmap(tmp);
		if (nr < 0) {
			retval = nr;
			goto out_free;
		}

		pid->numbers[i].nr = nr;
		pid->numbers[i].ns = tmp;
		tmp = tmp->parent;
	}

	if (unlikely(is_child_reaper(pid))) {
		if (pid_ns_prepare_proc(ns))
			goto out_free;
	}

	get_pid_ns(ns);
	atomic_set(&pid->count, 1);
	for (type = 0; type < PIDTYPE_MAX; ++type)
		INIT_HLIST_HEAD(&pid->tasks[type]);

	upid = pid->numbers + ns->level;
	spin_lock_irq(&pidmap_lock);
	if (!(ns->nr_hashed & PIDNS_HASH_ADDING))
		goto out_unlock;
	for ( ; upid >= pid->numbers; --upid) {
		hlist_add_head_rcu(&upid->pid_chain,
				&pid_hash[pid_hashfn(upid->nr, upid->ns)]);
		upid->ns->nr_hashed++;
	}
	spin_unlock_irq(&pidmap_lock);

	return pid;

out_unlock:
	spin_unlock_irq(&pidmap_lock);
	put_pid_ns(ns);

out_free:
	while (++i <= ns->level)
		free_pidmap(pid->numbers + i);

	kmem_cache_free(ns->pid_cachep, pid);
	return ERR_PTR(retval);
}
分配PID主要分两步:
第一步是在当前namespace以及所有的父namespace中分配PID number,并将信息存入upid。
第二部是将upid链接到pid_hash哈希数组上去。
- 根据pid number以及namespace找到pid
struct pid *find_pid_ns(int nr, struct pid_namespace *ns)
{
	struct upid *pnr;

	hlist_for_each_entry_rcu(pnr,
			&pid_hash[pid_hashfn(nr, ns)], pid_chain)
		if (pnr->nr == nr && pnr->ns == ns)
			return container_of(pnr, struct pid,
					numbers[ns->level]);

	return NULL;
}
主要分三步:
第一步是根据pid number以及namespace索引到pid_hash数组中的某一个。
第二部是循环遍历找到pid number以及namespace匹配的upid。
第三步是根据upid计算得到pid。
本文参考博客:
https://www.cnblogs.com/hazir/p/linux_kernel_pid.html

 369


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


