python实战项目80:采集淘宝商品评论(2025最新稳定版)

python实战项目80:采集淘宝商品评论

一、项目简介

本项目使用的是python的第三方库drissionpage采集淘宝商品的评论,目前淘宝网页端做了更新,drissionpage可以完美解决这一问题。drissionpage是网页自动化技术,结合了requests和Selenium的特性,代码简单,效率较高,稳定性较好,在requests解决不了的情况下,如果对于效率没有过高的需求,drissionpage可以作为一个非常好的选择。drissionpage的使用方法非常简单,如果你看到了这里,说明你自己完全有能力使用好drissionpage,可以借助搜索引擎或者ai智能工具解答,这里不做过多介绍。

二、采集流程介绍

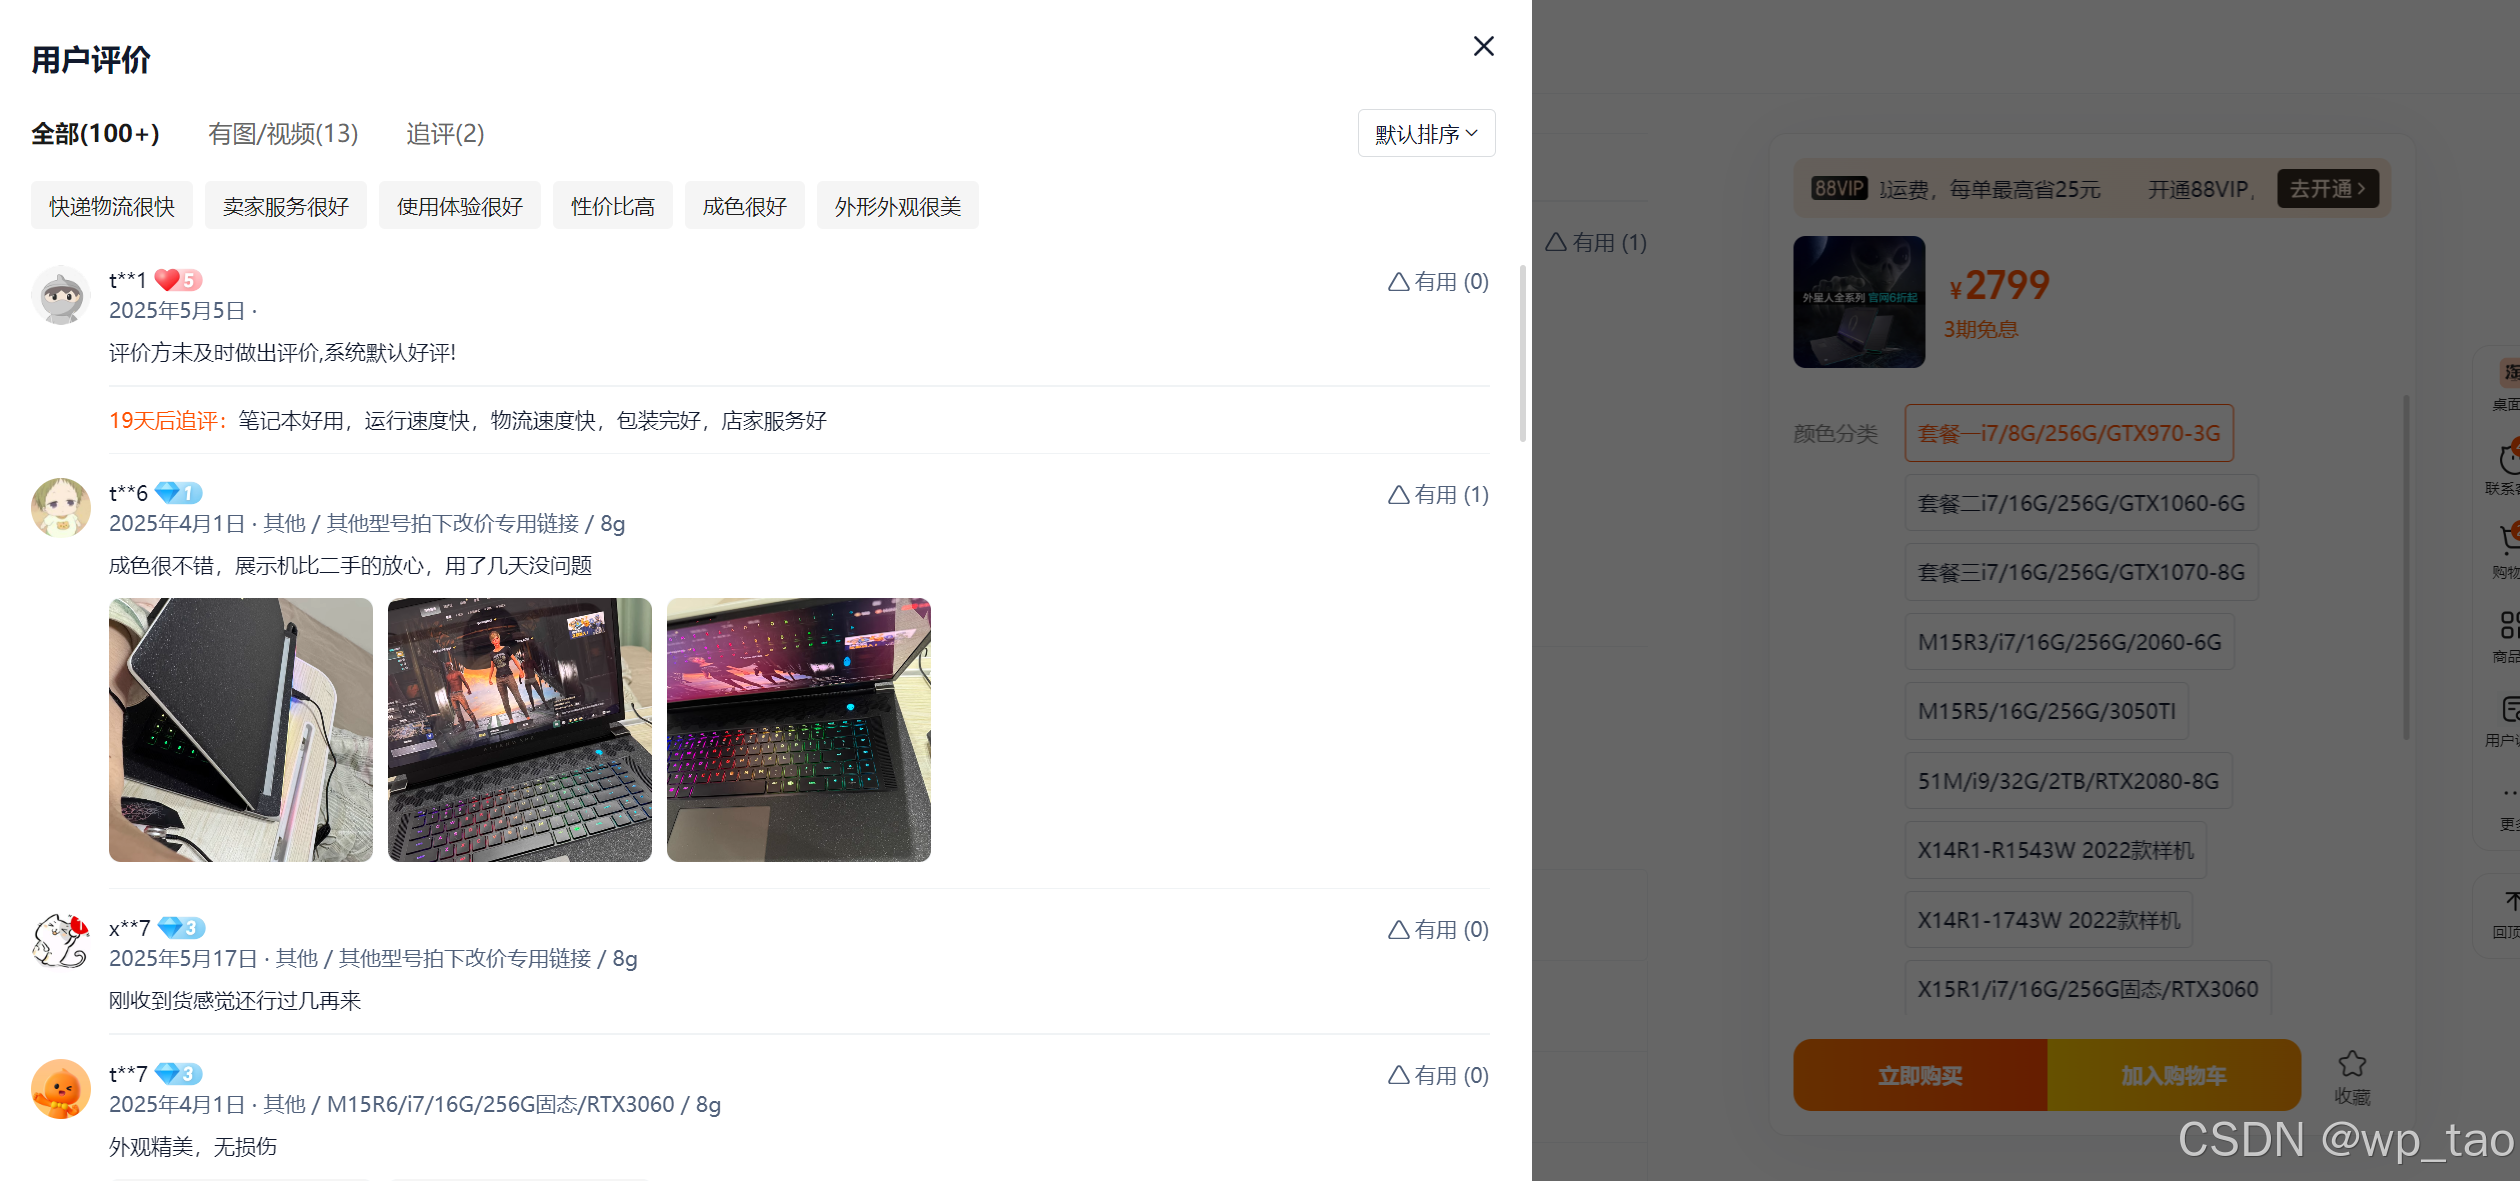
目前淘宝的评论页面是这样的:
在这里插入图片描述
按照正常流程,打开开发者工具,抓包,找到数据接口,可以发现,数据在一个xhr数据包里,这时便可以利用drissionpage的优势,drissionpage可以截获xhr数据包,并可以直接读取为python中类似字典格式的数据,方便数据提取。

三、完整代码

完整代码才是最重要的:

import json
import tim
爬虫(Web Crawler)是一种自动化程序,用于从互联网上收集信息。其主要功能是访问网页、提取数据并存储,以便后续分析或展示。爬虫通常由搜索引擎、数据挖掘工具、监测系统等应用于网络数据抓取的场景。 爬虫的工作流程包括以下几个关键步骤: URL收集: 爬虫从一个或多个初始URL开始,递归或迭代地发现新的URL,构建一个URL队列。这些URL可以通过链接分析、站点地图、搜索引擎等方式获取。 请求网页: 爬虫使用HTTP或其他协议向目标URL发起请求,获取网页的HTML内容。这通常通过HTTP请求库实现,如Python中的Requests库。 解析内容: 爬虫对获取的HTML进行解析,提取有用的信息。常用的解析工具有正则表达式、XPath、Beautiful Soup等。这些工具帮助爬虫定位和提取目标数据,如文本、图片、链接等。 数据存储: 爬虫将提取的数据存储到数据库、文件或其他存储介质中,以备后续分析或展示。常用的存储形式包括关系型数据库、NoSQL数据库、JSON文件等。 遵守规则: 为避免对网站造成过大负担或触发反爬虫机制,爬虫需要遵守网站的robots.txt协议,限制访问频率和深度,并模拟人类访问行为,如设置User-Agent。 反爬虫应对: 由于爬虫的存在,一些网站采取了反爬虫措施,如验证码、IP封锁等。爬虫工程师需要设计相应的策略来应对这些挑战。 爬虫在各个领域都有广泛的应用,包括搜索引擎索引、数据挖掘、价格监测、新闻聚合等。然而,使用爬虫需要遵守法律和伦理规范,尊重网站的使用政策,并确保对被访问网站的服务器负责。
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
