干货|一文学会10大权重计算方法与10大综合评价模型(附算法公式)

2026 大厂面试高频题解:Java 并发与底层 + AI 工程 + 算法 LeetCode 高频 12 题【每题带面试官视角、完整解答与追问链路】 本文聚焦2026大厂Java岗面试核心三科:Java底层与并发、AI工程、算法,精选12道高频真题,以“面试官视角→完整解答→复杂度分析→追问链路”结构精讲。涵盖HashMap原理、ConcurrentHashMap线程安全机制、线程池配置策略、synchronized与ReentrantLock对比、RAG链路设计、幻觉治理、Function Calling安全规范、微调与RAG选型决策,以及反转链表、层序遍历等经典算法手撕题。文末附30天冲刺计划,助你高效通关大厂面试。 阅读详情

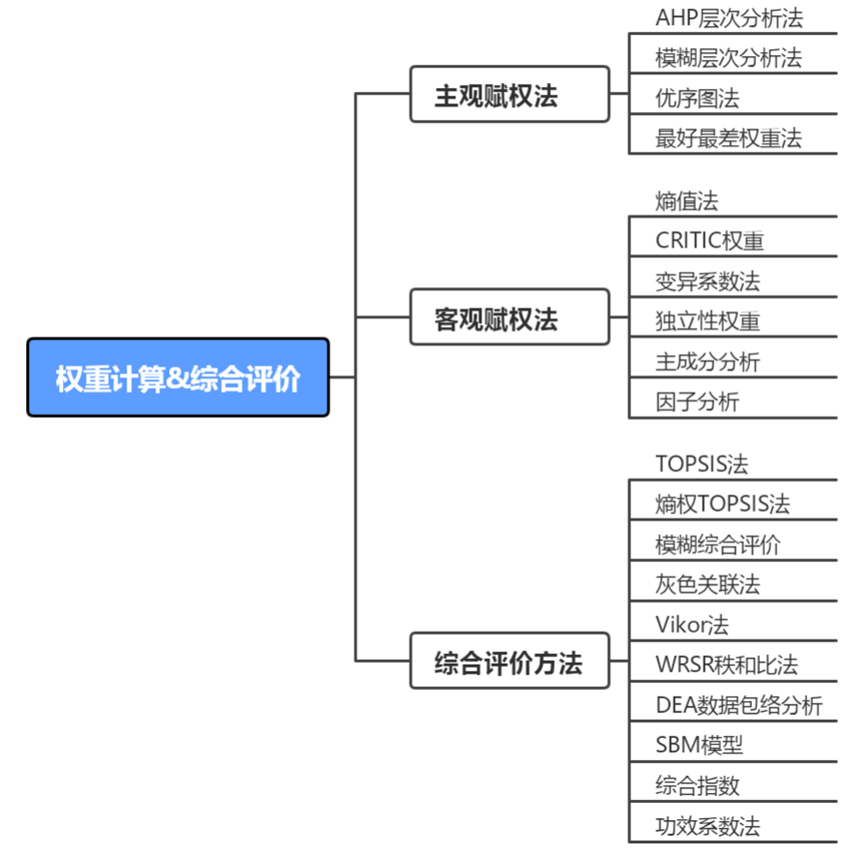
写论文时,评价指标体系的构建会涉及指标权重计算方法与综合评价方法,今天一文将10种权重计算方法与10种综合评价方法汇总整理,大家可以一文学会每种方法的适用场景与软件操作教程。
一、权重计算方法

权重计算,就是通过数据客观确定每个评价指标在综合得分中的重要程度。常用的权重计算方法分为两大类——主观赋权法和客观赋权法,下面分别进行介绍。

1、主观赋权法

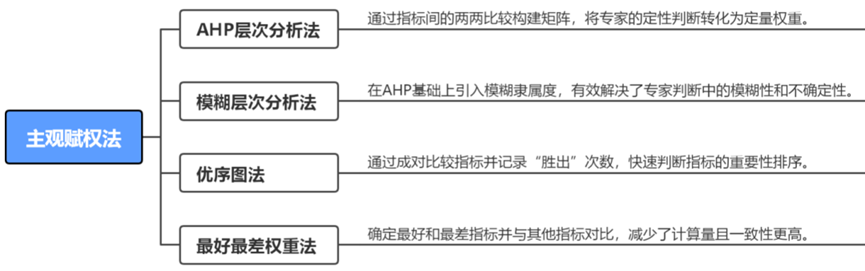
主观赋权法主要依靠专家或决策者的知识、经验或主观判断来确定各项指标的重要性。

  • 优点:能充分体现决策者的意图和行业专家的业务经验,使权重结果符合实际业务逻辑和常识。
  • 缺点:主观性过强,容易受到人为偏见、情绪或专家水平限制的影响,论证过程缺乏客观数据的支撑。

常用方法包括AHP层次分析法、FAHP模糊层次分析法等。
(1)AHP层次分析法

通过建立多层指标体系并进行两两比较,构建判断矩阵来确定权重。它的优点是能将复杂决策定量化,但当指标较多时,专家判断的一致性很难保证。

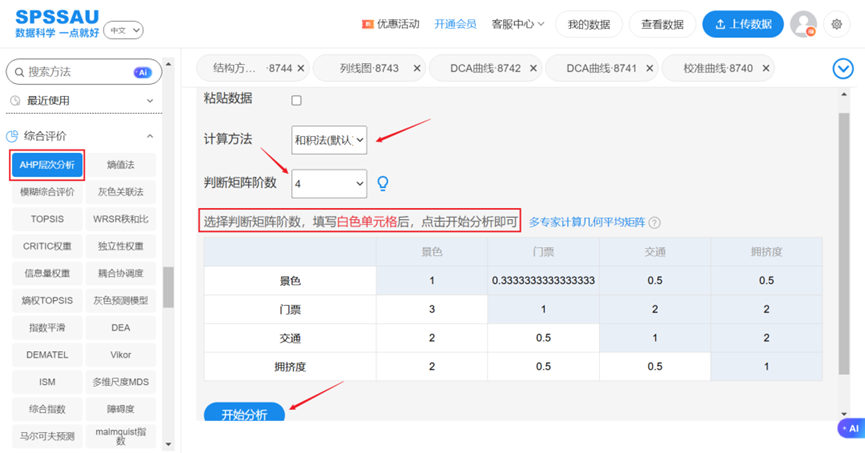
  • SPSSAU软件操作:在SPSSAU【综合评价】模块,选择【AHP层次分析法】,选择计算方法与判断矩阵阶数,填写白色单元格,点击开始分析按钮,即可得到权重计算结果,软件操作如下图:
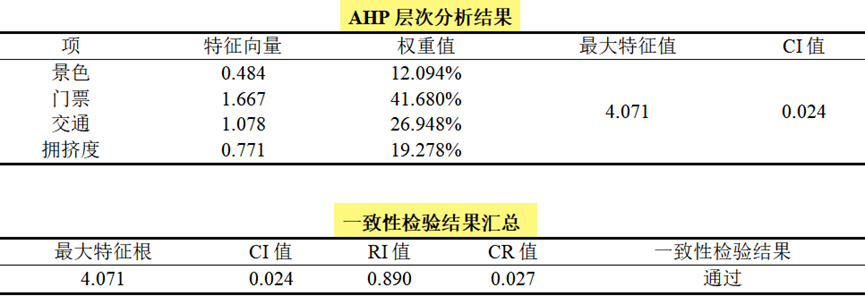
SPSSAU输出层次分析法权重计算和一致性检验结果如下:
更多内容可点击下方链接跳转至SPSSAU帮助手册:

AHP层次分析法

(2)FAHP模糊层次分析法

在AHP基础上引入模糊数学理论,用模糊一致矩阵代替判断矩阵。它能有效解决专家在比较指标时的模糊性和不确定性,使评价结果更贴近人的思维习惯。

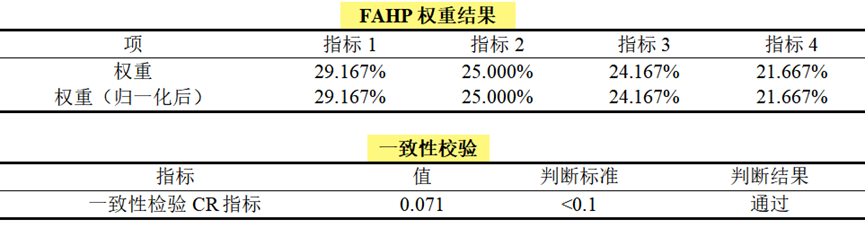
  • SPSSAU软件操作:在【综合评价】模块选择【FAHP模糊层次分析法】,输入或者粘贴模糊互补矩阵,点击开始分析按钮,SPSSAU即可输出FAHP模糊层次分析法权重计算和一致性检验结果如下:
更多内容可点击下方链接跳转至SPSSAU帮助手册:

FAHP模糊层次分析法

(3)优序图法

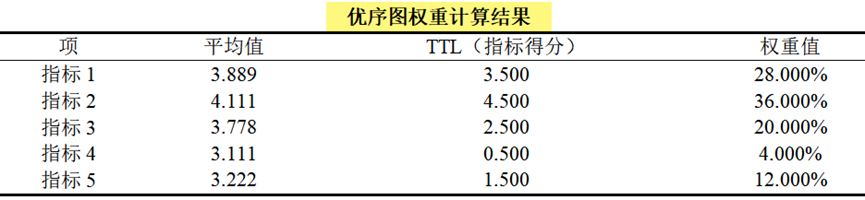
采用0-0.5-1三值评分机制简化权重计算,专家只需判断指标间的相对重要性(不重要/同等/重要)即可生成优先矩阵‌。相比AHP,其操作更简便且避免了一致性检验问题,适合快速权重确定场景‌。

  • SPSSAU软件操作:在【问卷研究】模块选择【权重】,选择【优序图法】,将变量拖拽至右侧分析框,点击开始分析按钮,SPSSAU即可输出优序图法权重计算结果如下:
更多内容可点击下方链接跳转至SPSSAU帮助手册:优序图法帮助手册

(4)最好最差权重BWM

专家只需选出最好和最差指标,并将其余指标分别与这两个极端进行对比。它比AHP所需的比较次数更少,且具有更高的一致性和可靠性。

  • SPSSAU软件操作:在【综合评价】模块选择【最好最差权重BWM】,分别放入BO和OW数据,如果有多个专家则多行放入,点击开始分析按钮,SPSSAU输出最好最差权重计算结果如下:
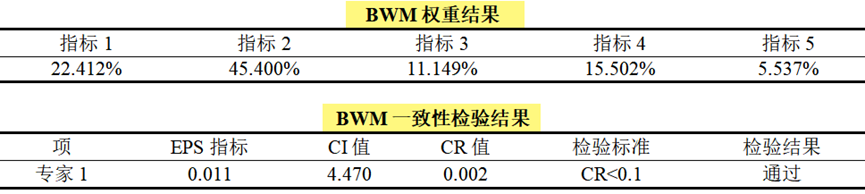
更多内容可点击下方链接跳转至SPSSAU帮助手册:最好最差权重

2、客观赋权法

客观赋权法则完全基于数据本身的统计属性和数学规律来计算权重,不掺杂任何人为的主观偏向。

  • 优点:具有极强的客观性和科学性,能够挖掘出隐藏在数据背后的信息,排除了人为干扰,说服力较强。
  • 缺点:权重结果有时会脱离实际业务意义(例如某个无关紧要的指标因为波动大而被分配了极高权重),且对样本数据的质量和分布依赖度很高。
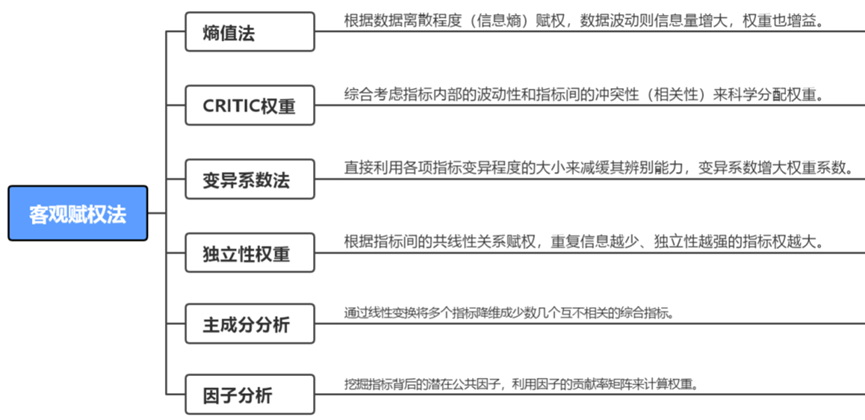
(1)熵值法

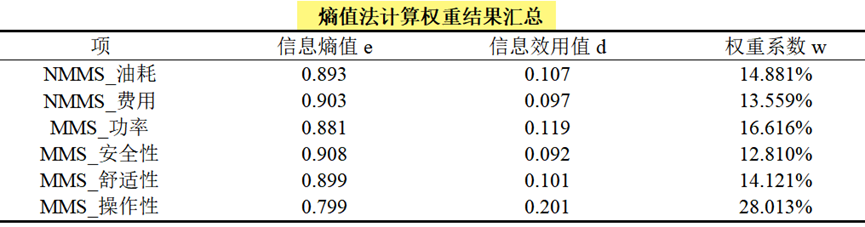
根据指标数据的离散程度来分配权重。指标波动越大,提供的信息量就越多,权重也就越高;反之,数据趋于一致的指标权重较低。

  • SPSSAU软件操作:在SPSSAU【综合评价】模块选择【熵值法】,将处理好的变量拖拽至右侧分析框中,点击开始分析按钮,操作如下图:
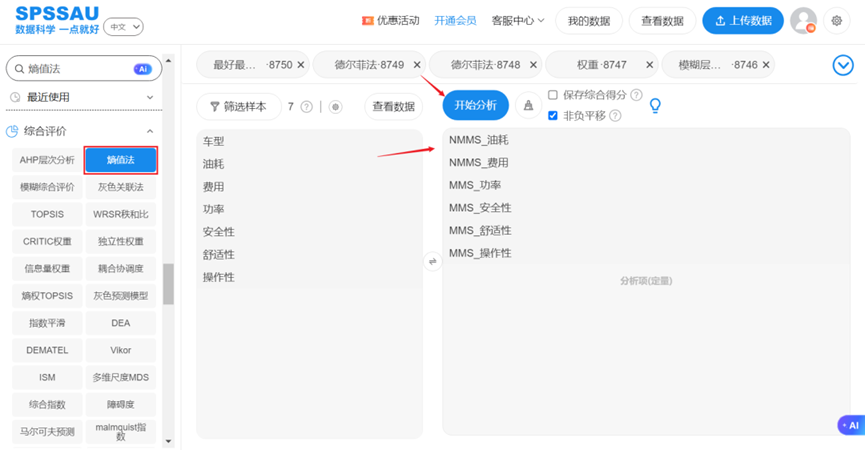
SPSSAU输出熵值法权重计算结果如下:
熵值法帮助手册

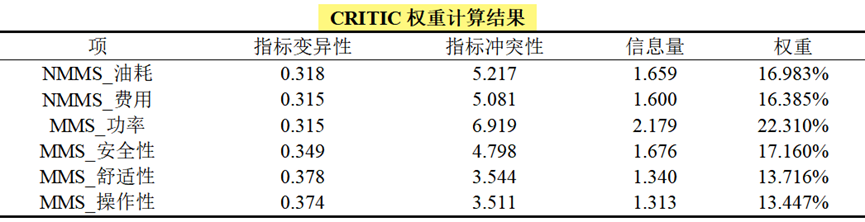
(2)CRITIC权重

一种综合考虑指标波动性和相关性的赋权方法。它不仅关注指标自身的数据差异,还通过冲突性指标衡量指标间的相关程度,从而避免重复信息的过度赋权。

  • SPSSAU软件操作:在SPSSAU【综合评价】模块选择【CRITIC权重】,将处理好的变量拖拽至右侧分析框中,点击开始分析按钮,SPSSAU输出CRITIC权重计算结果如下:
CRITIC权重帮助手册

(3)变异系数法

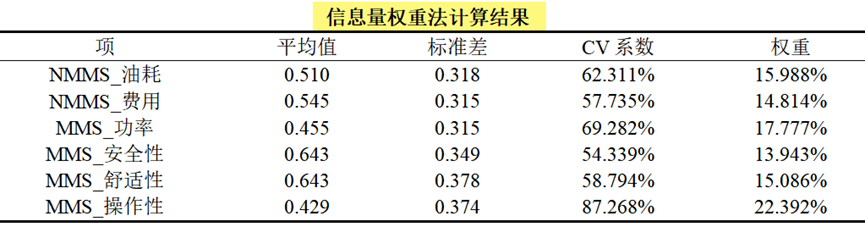
又称信息量权重,直接利用指标原始数据的标准差与平均值的比值(变异系数)来确定权重。它认为变异系数越大,说明该指标在评价体系中的分辨能力越强,因此应赋予更高的权重。

  • SPSSAU软件操作:在SPSSAU【综合评价】模块选择【变异系数法】,将处理好的变量拖拽至右侧分析框中,点击开始分析按钮,SPSSAU输出变异系数法权重计算结果如下:
信息量权重帮助手册

(4)独立性权重

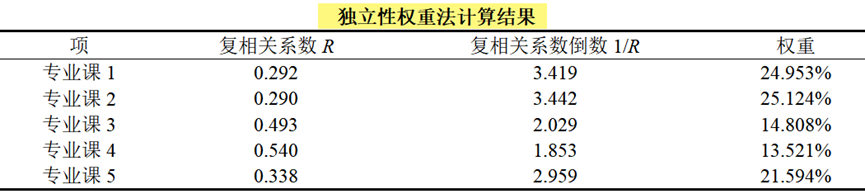
基于指标间的共线性关系进行赋权。该方法通过复相关系数衡量一个指标与其他指标的关联度,如果某个指标被其他指标解释的程度越低,说明其独立性越强,赋予的权重就越大。

  • SPSSAU软件操作:在SPSSAU【综合评价】模块选择【独立性权重】,将变量拖拽至右侧分析框中,点击开始分析按钮,SPSSAU输出独立性权重计算结果如下:
独立性权重帮助手册

(5)主成分分析/因子分析法

权重计算是主成分的一类应用场景,其原理在于使用方差解释率进行主成分权重计算。

  • SPSSAU软件操作:在SPSSAU【进阶方法】模块选择【主成分分析】或【探索性因子】,将变量拖拽至右侧分析框中,点击开始分析按钮,SPSSAU输出方差解释率和累积方差解释率结果如下:
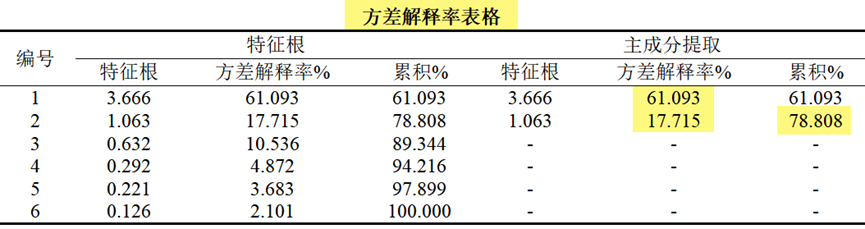
归一化:方差解释率 / 累计方差解释率,即可得到两个主成分的权重:

  • 主成分1权重=61.093%/78.808%=0.775
  • 主成分2权重=17.715%/78.808%=0.225

同时SPSSAU输出各指标权重计算结果如下:
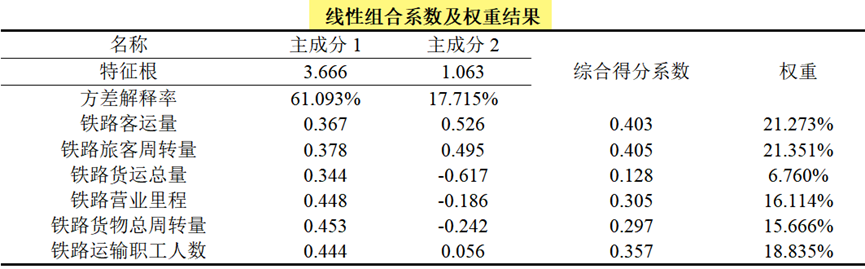
因子分析权重计算原理与主成分分析计算原理类似,在此不再赘述。

主成分分析法帮助手册

因子分析法帮助手册

除单独使用权重计算方法计算指标权重外,比较常见的还有组合赋权法。例如论文中常见的是使用主观赋权法(如AHP层次分析法)与客观赋权法(如熵值法)进行组合权重计算。

二、10种综合评价方法

综合评价是一种利用多个指标对评价对象进行整体评估的统计分析方法。常用的方法包括TOPSIS法、模糊综合评价、灰色关联法等。
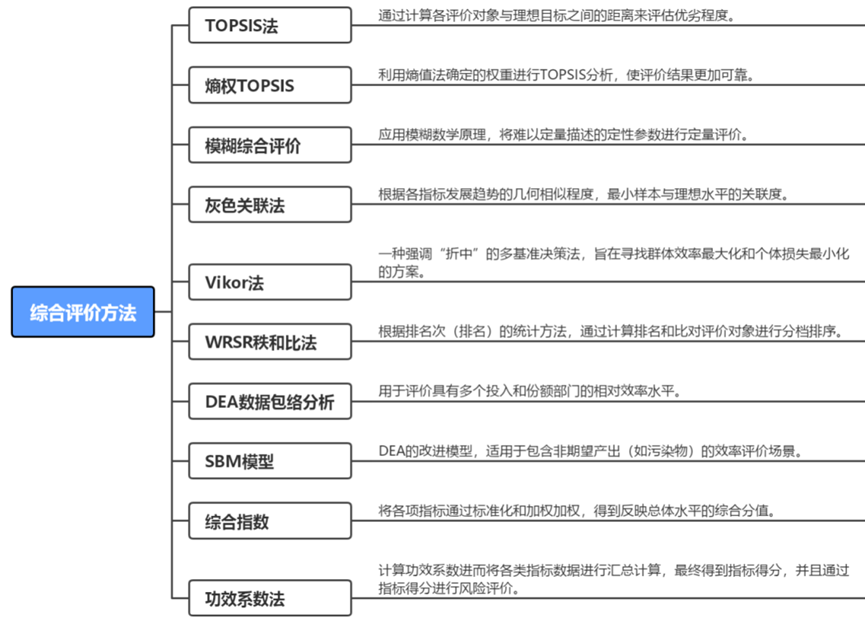
1、TOPSIS法

通过计算各个评价对象与“理想最优解”和“最劣解”的距离来评估优劣。得分越高,代表该对象越接近最优方案且远离最劣方案。

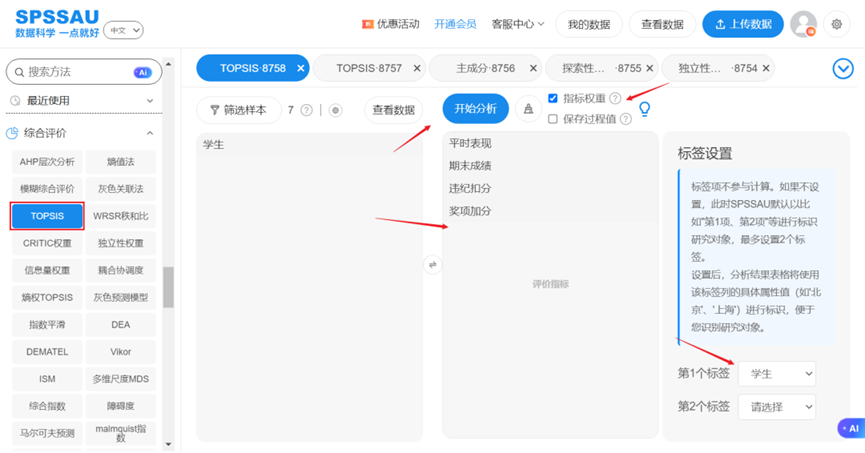
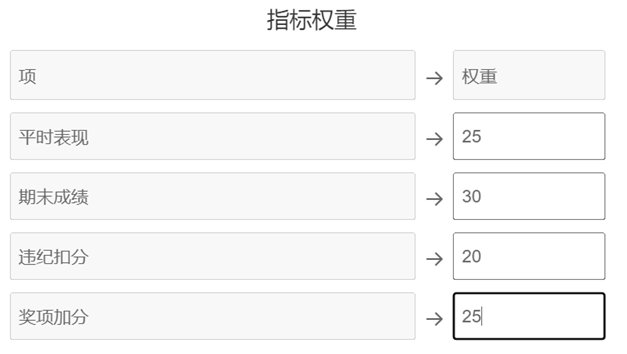
  • SPSSAU软件操作:在SPSSAU【综合评价】模块选择【TOPSIS法】,将处理后的变量拖拽至右侧分析框中,选择标签,若指标之前通过例如熵值法计算得到了指标权重,则在分析页面右侧勾选【指标权重】,输入权重值,操作如下图:
SPSSAU输出TOPSIS法综合评价结果如下:
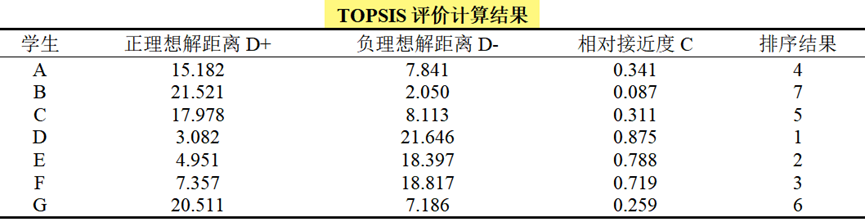
TOPSIS法帮助手册

2、熵权TOPSIS法

熵权TOPSIS法是先使用熵权法得到新数据newdata(数据成熵权法计算得到的权重),然后利用新数据newdata进行TOPSIS法研究。

  • SPSSAU软件操作:在SPSSAU【综合评价】模块选择【熵权TOPSIS】,将变量拖拽至右侧分析框中,选择标签,点击开始分析按钮,即可得到如下分析结果:
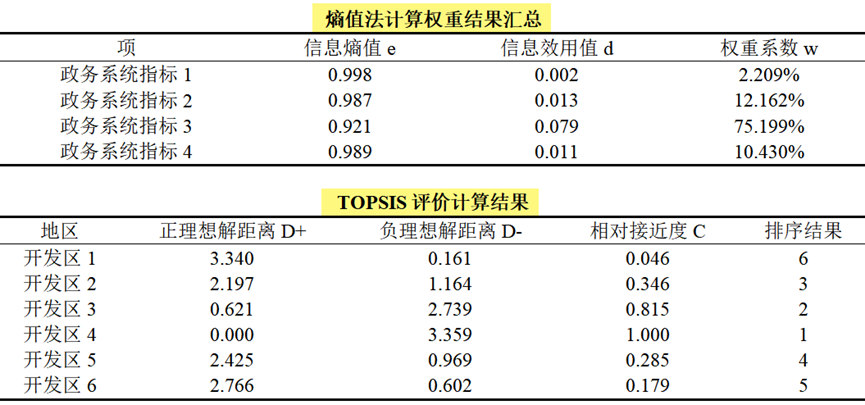
熵权TOPSIS法帮助手册

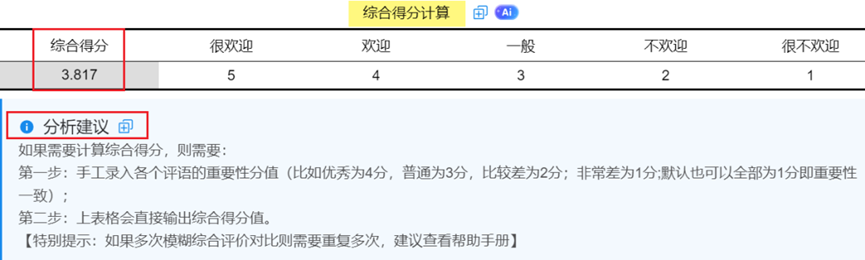
3、模糊综合评价

利用模糊数学理论,将定性评价转化为定量评价。它能很好地处理评价过程中那些边界模糊、难以精确量化的因素(如满意度、安全性)。

  • SPSSAU软件操作:在【综合评价】模块选择【模糊综合评价】,将变量拖拽至右侧对应分析框中,点击开始分析按钮,即可得到如下分析结果:
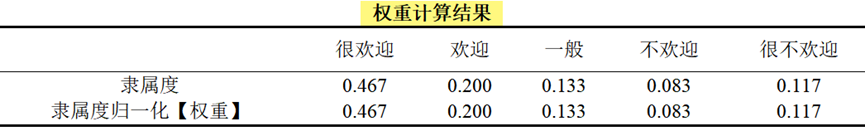
模糊综合评价帮助手册

4、灰色关联法

通过分析各特征序列与母序列在几何形状上的相似程度来判断联系是否紧密。它对数据量要求较小,特别适合处理样本量少或数据完整性较差的情况。

  • SPSSAU软件操作:在【综合评价】模块选择【灰色关联法】,将变量拖拽至右侧对应分析框中,选择量纲化方法,设置指标权重,点击开始分析按钮,即可得到如下分析结果:
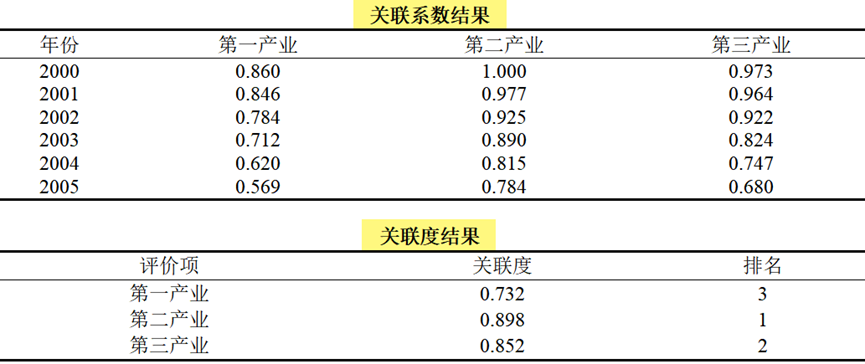
灰色关联法帮助手册

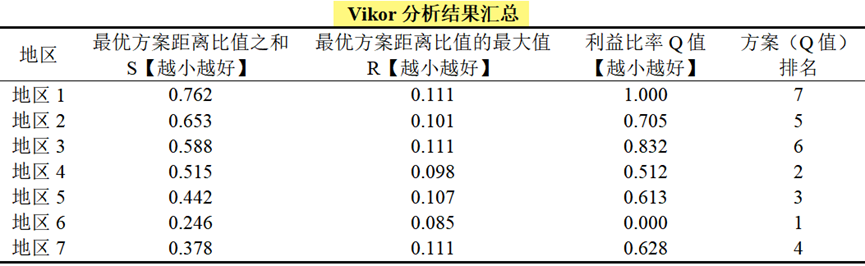
5、Vikor法

VIKOR(折中妥协法)是一种多属性决策方法,其应用于各种方案的优劣排序,与TOPSIS法功能类似。比如对备选的供应商方案排序,备选的应聘者的各项能力综合评价,找出应聘者的优先适合排序等。

  • SPSSAU软件操作:在【综合评价】模块选择【Vikor法】,将变量拖拽至右侧对应分析框中,点击开始分析按钮,即可得到如下分析结果:
VIKOR法帮助手册

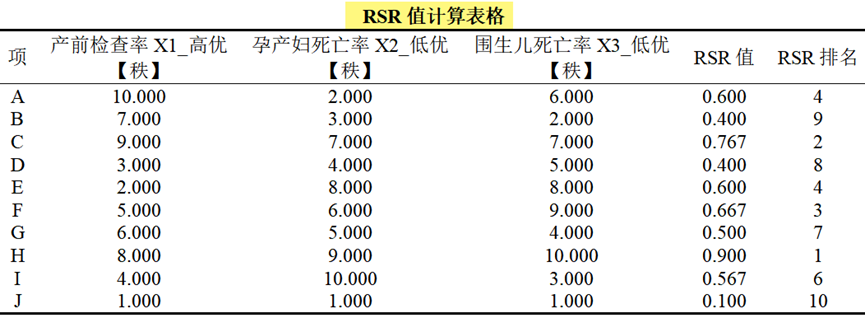
6、WRSR秩和比法

将评价指标转化为“秩次”(排名),通过秩的和值进行统计分析。它不仅能进行排序,还能通过分档将评价对象划分为优、中、差等不同等级。

  • SPSSAU软件操作:在【综合评价】模块选择【WRSR秩和比】,将变量拖拽至右侧对应分析框中,点击开始分析按钮,即可得到如下分析结果:
WRSR秩和比法帮助手册

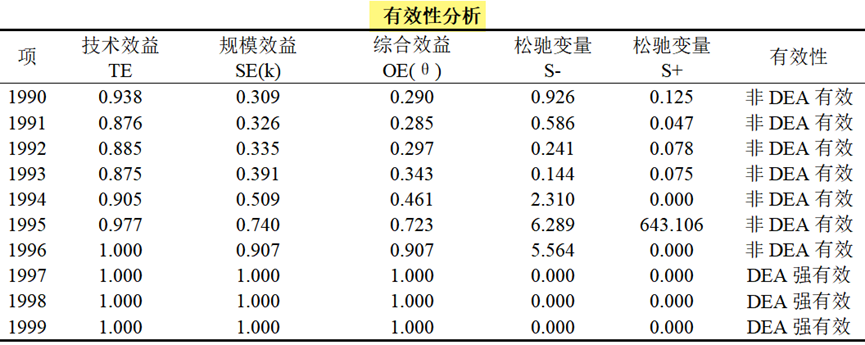
7、DEA数据包络分析

DEA是一种多指标投入和产出评价的研究方法,其应用数学规划模型计算比较决策单元(DMU)之间的相对效率,对评价对象做出评价。它不直接给分,而是判断哪些对象在当前资源投入下达到了产出最大化。

  • SPSSAU软件操作:在【综合评价】模块选择【WRSR秩和比】,将变量拖拽至右侧对应分析框中,点击开始分析按钮,即可得到如下分析结果:
DEA数据包络分析帮助手册

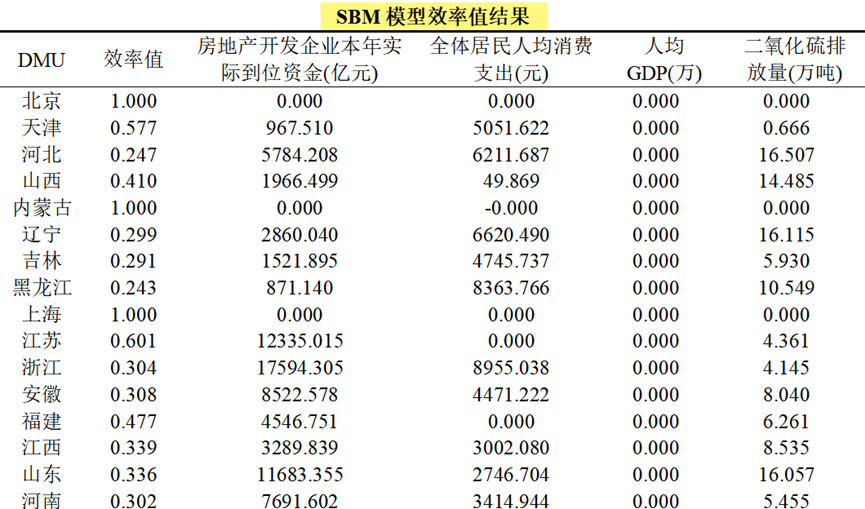
8、SBM模型

非期望SBM模型是DEA衍生模型中的一种。相对传统DEA模型,非期望产出SBM模型不仅避免径向和角度度量引起的偏差,而且考虑生产过程中非期望产出因素的影响,更能反映效率评价的本质。

  • SPSSAU软件操作:在【综合评价】模块选择【SBM】,将变量拖拽至右侧对应分析框中,点击开始分析按钮,即可得到如下分析结果:
SBM模型帮助手册

9、综合指数

通常用来测量某个指标的相对大小(相对数)可称为指数,比如物价指数,环境监控指数等,而综合指数是综合衡量和反映多个指标指数的一种评价方式。通常情况下综合指数可用计算各类社会指数、环境评价或者综合效率等,比如消费指数、环境污染指数,高校或企业管理效率,医院综合指数等。

  • SPSSAU软件操作:在【综合评价】模块选择【综合指数】,将变量拖拽至右侧对应分析框中,点击开始分析按钮,即可得到如下分析结果:
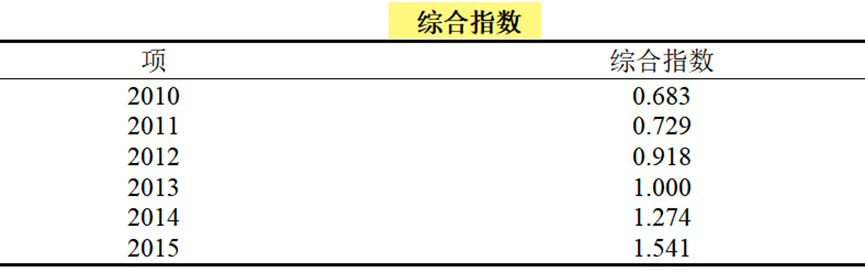
综合指数帮助手册

10、功效系数法

功效系数是一种综合评价方法,其通常用于财务风险预警分析,其通过计算功效系数进而将各类指标数据进行汇总计算,最终得到指标得分,并且通过指标得分进行风险评价。

  • SPSSAU软件操作:在【综合评价】模块选择【功效系数法】,根据页面提示粘贴或修改变量数据后,点击开始分析按钮,操作如下图:
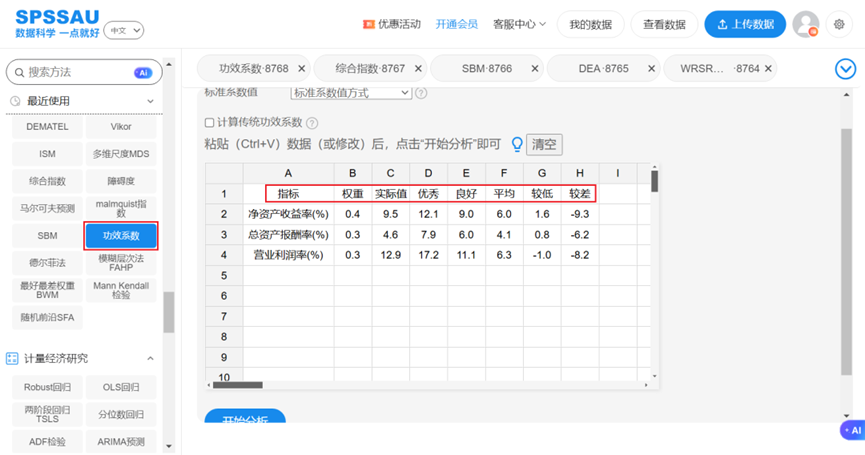
SPSSAU输出功效系数法部分结果如下:
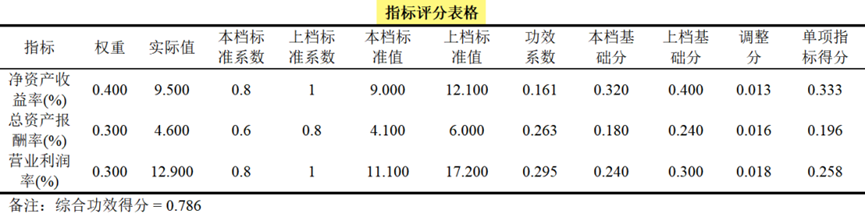
功效系数法帮助手册

三、算法手册免费获取

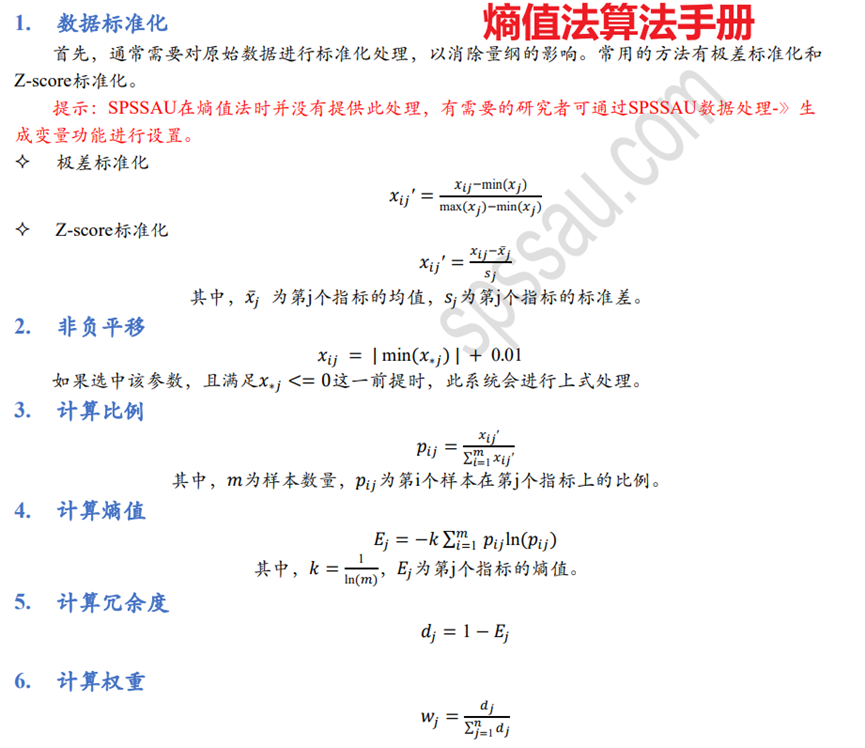
(1)SPSSAU算法手册

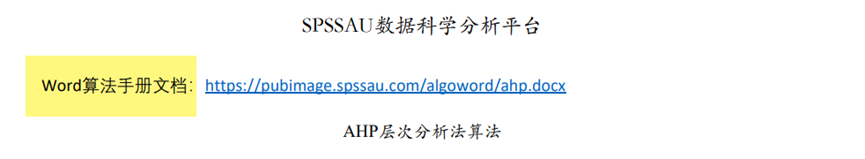
SPSSAU软件进行统计分析时,均基于标准的算法原理与计算流程,确保分析结果的科学性与可复现性。为便于用户深入理解方法原理、规范引用或进行教学研究,SPSSAU提供绝大多数方法详细的算法手册。如下所示分别为AHP层次分析法和熵值法算法手册:
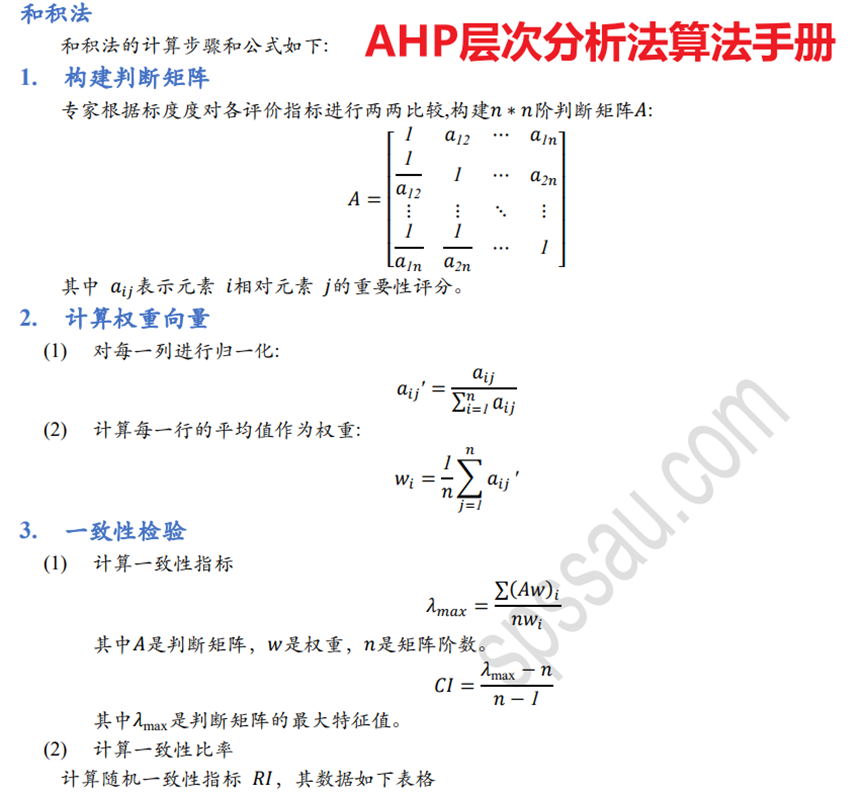
完整的算法手册通常包含SPSSAU操作、SPSSAU数据格式、数学模型、核心计算公式、详细的算法实现步骤以及参考文献,帮助用户清晰把握从数据输入到结果输出的全过程。

(2)算法手册获取

点击SPSSAU页面小灯泡按钮进入任意方法帮助手册,下拉找到【SPSSAU学习】,选择【SPSSAU算法手册】,操作如下图:
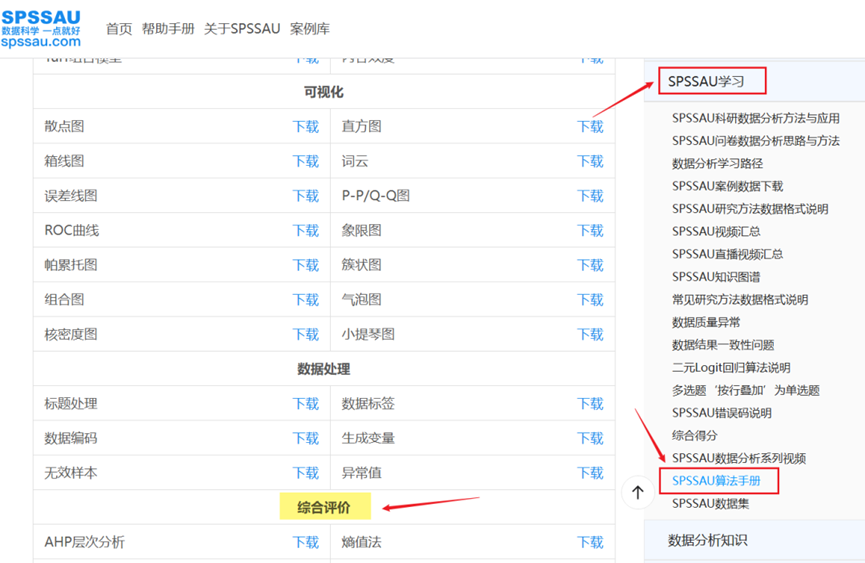
或点击下方链接直接跳转至算法手册:SPSSAU算法手册

  • SPSSAU算法手册提供PDF与Word版:PDF版排版严谨、公式清晰,适合作为技术标准进行查阅与留存。Word版在文档最上方,点击即可下载,方便用户根据自身需求,快速将相关算法步骤或公式逻辑复制并引用到论文的方法学章节中。
自适应动态规划硕士博士论文学习 强化学习关注随机过程中的序贯决策问题,而自适应动态规划关注动态系统的控制问题。吸引域:系统渐近稳定的区域。 阅读详情

相关推荐

FPGA优质开源项目 – UDP万兆光纤以太网通信

本文开源一个FPGA项目:UDP万兆光通信。文章末尾有该工程源码获取方式,有需要的小伙伴可以点赞、分享支持一下~

cjx_csdn的博客 4754

09月28日 pytorch与resnet(三)预训练的Mask R-CNN 模型进行微调

TorchVision 对象检测微调教程 1. 预训练的Mask R-CNN 模型进行微调 我们将说明如何在 torchvision 中使用新功能,以便在自定义数据集上训练实例细分模型。 2. 定义数据集 https://pytorch.org/tutorials/intermediate/torchvision_tutorial.html Penn-Fudan 数据库中对行人检测和分割。 数据集应继承自标准torch.utils.data.Dataset类,并实现__len__和__getitem__。

AbiUni(YY熊) 1360

手把手拆解DGX GB200 NVL72:1个机柜如何塞进72块GPU?详解NVLink Switch铜缆背板设计

本文深度解析英伟达DGX GB200 NVL72系统如何通过NVLink Switch铜缆背板设计,在标准42U机柜中集成72块B200 GPU,实现1800GB/s的超高带宽。文章详细介绍了模块化架构、铜缆互连技术、液冷散热方案和高密度供电系统等核心创新,为AI算力需求提供突破性解决方案。

red88的博客 1537

【优选算法 — 双指针】经典例题题解+算法总结

本文总结了双指针算法在三道经典题中的应用:1)移动零——使用快慢指针将非零元素前移,零元素后移;2)复写零——采用反向回填同向双指针,从右向左复写0,避免覆盖;3)盛水最多容器——运用对撞指针,根据短板原则移动指针,高效求解最大面积。算法时间复杂度均为O(n),显著优于暴力法。文章还归纳了双指针的三类模式:快慢指针、反向回填同向双指针、对撞指针,并附推荐练习题,助力算法学习。

Tsuki_tl的博客 319

STM32 Boot程序实战:从启动流程到安全跳转机制解析

本文深入解析STM32 Boot程序的核心作用与安全跳转机制,涵盖启动流程、内存管理、中断向量表重定向及固件验证等关键环节。通过实战案例分享如何实现可靠的固件升级与故障回退策略,避免设备变砖风险,提升嵌入式系统稳定性。

pluto的博客 771

overleaf导入模板

本文介绍了如何在Overleaf平台导入Springer Nature模板。首先下载所需的模板压缩包,然后在Overleaf中选择"Upload project"上传该压缩包。上传后会显示模板文件,包括EPS格式图像文件、LaTeX源文件、BibTeX参考文献文件、PDF输出文件以及文档类文件。这些文件共同构成了完整的LaTeX模板,可用于学术论文写作和排版。

A2787960542的博客 1145

贪心题目:加油站

个加油站,需要找到可以绕环路行驶一周的出发加油站的编号。,则无论从哪个加油站出发,绕环路行驶一周之后的剩余汽油都是负数,因此不可能绕环路行驶一周,返回。初始时油箱中的汽油是零,如果行驶到一个加油站的剩余汽油是负数,则无法行驶到该加油站。,此时第三段的汽油变化一定是正数,一定可以在第三段找到一个加油站作为起点,在遍历到。,则遍历过程中任意时刻的汽油都是非负数,因此可以绕环路行驶一周。,如果可以绕环路行驶一周,则返回出发时加油站的编号,否则返回。,则一定存在一个加油站作为起点,可以绕环路行驶一周。

stormsunshine的博客 330

第六部分:VTK进阶(第182章 体素化与隐式建模)

本文系统介绍了基于点云构建有符号距离场(SDF)的核心原理与VTK实现方法。主要内容包括:1)SDF的基本概念与算法原理,通过体素网格隐式表达几何表面;2)关键参数配置指南,如体素分辨率、边界范围和影响半径的选择;3)点云法向估计、SDF计算与等值面提取的完整工作流程;4)常见问题解决方案与性能优化建议。文中提供了详细的C++代码示例,展示从随机点云生成SDF并重建曲面的完整过程,特别强调了法向估计、参数调优和后处理等关键环节。该方法适用于点云表面重建、几何处理等应用场景。

仰望星空的博客 521

【算法拾光】双指针|两数之和 II - 输入有序数组 + 三数之和

本文总结双指针核心技巧——相向双指针,适用于有序数组。两数之和II通过左右夹逼实现O(n)时间、O(1)空间解法;三数之和则在排序基础上固定一数,结合双指针与三层去重(固定数、左指针、右指针),避免重复答案,复杂度为O(n²)。核心思想:利用有序数组的单调性,通过指针单向移动高效排除不可能组合,是后续多数问题的基础。

wuqingyigexiaoba的博客 264

Autosar MCAL-S32K324 Fls配置-基于EB

Autosar MCAL Flash配置,基于S32K324,EB软件

赞的博客 1504

SolidWorks软件二次开发:使用C#进行SolidWorks二次开发

SolidWorks 提供的 API(应用程序编程接口)允许开发者使用多种编程语言(如 C#、VB.NET 等)来控制和扩展 SolidWorks 的功能。API 架构基于 COM(组件对象模型),这意味着开发者可以通过引用 SolidWorks 的类型库来访问其对象模型。SolidWorks 的对象模型包括了从文档、零件、装配体到特征、草图等所有 SolidWorks 中可操作的对象。

kkchenjj的博客 3208

优选算法——【双指针算法1】C++实现

双指针算法详细题解思路

2402_87037360的博客 498

手把手教你玩转服务器芯片架构--​​7.1 项目1:基于FPGA的RISC-V软核设计(Verilog实现核心指令执行单元)​

本文介绍了基于FPGA的RISC-V软核设计实践项目。项目采用Verilog实现RV32I指令集核心处理器,包含指令解码、ALU、寄存器堆等关键模块设计,并通过功能仿真验证。在Xilinx Artix-7 FPGA上完成综合与部署,资源利用率控制在5%以内。最后探讨了五级流水线优化、指令集扩展等进阶方案。该实践完整覆盖了从指令集设计、RTL实现到FPGA部署的全流程,可作为学习处理器架构与FPGA开发的典型案例。

MHD0815的博客 172

算法札记:线性筛法乱改乱改内层循环条件有感

该代码为埃拉托斯特尼筛法的优化版本,用于求素数。WA版本未标记1为非素数,导致错误;AC版本添加vis[1]=true,并调整循环边界至N-2,确保正确筛除合数。关键优化在于内层循环中一旦i%p[j]==0即跳出,避免重复标记,提升效率。注意初始化与边界处理是正确性的关键。

Keven_11的博客 101

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

算法--桶思想

谐距下标对;最大 FST 距离

w_zero_one的博客 52

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

算法day1--移动零&&复写零

答案藏在不变量的第二句里:既然。

2401_85340832的博客 375

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

限流算法——固定窗口、滑动窗口、漏桶、令牌桶

本文对比了三种常见限流算法:计数器(固定/滑动窗口)仅关注请求数量,易受临界突刺影响;漏桶算法通过恒定速率输出,实现流量整形,保护下游但响应延迟高;令牌桶则允许突发,空闲时攒令牌,兼顾平滑与效率,适合大多数场景。三者本质区别在于对突发流量的处理策略,选择应基于业务需求。

fancyfor的博客 227

【StrongSort 03】多轨迹算法StrongSort改进点

StrongSORT在DeepSORT基础上提出五项在线改进:NSA(置信度自适应观测噪声)、EMA(特征指数滑动平均)、MC(运动-外观融合代价)、woC(单轮全局匹配)和ECC(相机运动补偿),均默认开启,逐帧完成无后处理。各模块通过参数灵活开关,显著提升跟踪精度与鲁棒性,尤其在相机运动、外观变化场景下表现优异。

Jayson 博客 328

C++ 算法(四)

C++string算法题

2503_94479566的博客 723

GraphRAG的问答大模型算法详解

GraphRAG 的核心算法机制GraphRAG 的流程通常可以拆解为三个阶段:图索引、图检索和图生成。图索引(Graph Indexing)这是 GraphRAG 区别于普通 RAG 的关键前置步骤。对于非结构化文本,系统会调用 LLM 进行实体与关系抽取,将“某公司收购了某品牌”这样的句子,转化为 (公司)-[收购]->(品牌) 的三元组,并存入图数据库。微软的 GraphRAG 项目还在此基础上构建“社区”(community)层级,对紧密连接的实体簇生成摘要,用于回答全局性问题。

qq_42773521的博客 262

从 1024 块 GPU 到 558 万美元:拆解 DeepSeek-V3 的算法-系统协同设计

DeepSeek-V3以671B参数、仅37B激活量和278.8万H800 GPU小时训练成本,打破大模型“堆算力”叙事。其核心在于四重解耦:MoE实现参数与计算分离,MLA低秩压缩KV缓存至576元素,MTP增稠训练信号,DualPipe将通信藏于计算之中。算法与系统协同设计,使资源瓶颈在多维度同时突破。真正的启示不在于模块创新,而是在约束边界上构建可落地的高效方法论——这正是AI工程时代最稀缺的能力。

小相探索IT世界 5359

【算法拾光】二分查找|第一个错误的版本 + H 指数 II

本文总结二分查找的两类经典应用:一是「第一个错误的版本」,利用布尔二段性(好/坏)采用左边界二分模板,关键在于right = mid而非mid-1;二是「H指数II」,通过二分答案结合嵌套二分求最小引用下标,利用单调性寻找最大合法h。两题分别体现二分左边界与二分答案思想,核心均为数据满足二段性即可二分。掌握后可应对多数二分变种问题。

wuqingyigexiaoba的博客 302

leetcode 3644. 排序排列 中等

(允许进行任意次这样的交换)。时,才能进行排序,因为没有更大的。是数组所有元素的一种重新排列。已经是有序的,返回 0。

2401_88085478的博客 98

2026年10月26日 论文中期 简历准备 算法能力建设与GPT讨论

你说自己有时觉得学了很久却没有结果,甚至怀疑自己可能根本不适合算法。我不认为现在就有足够的证据得出这个结论。更准确的判断是:你有一定的大模型知识基础,也经历过真实的 Agent 业务开发,但独立编程、实验设计、结果分析和研究表达这些环节,还没有经过足够完整的训练。这与“你没有算法天赋”不是一回事。另一方面,你也需要接受一个现实:如果继续仅仅阅读资料、浏览新仓库,却没有在未来几个月完成可以检验的实验,你的算法能力不会因为学习时间累积得更多,就自动发生质变。现在已经到了需要用输出检验学习成果的阶段。

victory0431的博客 256

LeetCode 274 H 指数 C 语言解题分析

本文分析LeetCode 274.H指数题中插入排序实现的缺陷,指出初版遗漏写回逻辑、改进版存在越界访问与返回值错误。核心结论:排序方向必须与判定条件一致(降序排列后用citations[i] >= i+1),否则无法正确求解。推荐使用降序插入排序或qsort配合正确判定逻辑,确保返回最大满足条件的论文数量h,而非引用次数或中位数。强调算法需区分“引用次数”与“论文数量”,避免语义混淆。

记录个人成长 173

[GESP202406 六级] 计算得分(含视频)

an​],如果字符串的一个子串由 k(1≤k≤n) 个 abc 首尾相接组成,那么能够得到分数 ak​,并且字符串包含的字符不能够重复计算得分,整个字符串的得分是计分子串的总和。最优的计分方式为 d+abc+abc+abc+abz,总得分为 a1​+a1​+a1​,共 9 分。对于全部数据,保证有 1≤n≤20,1≤m≤105,1≤ai​≤1000。第一行包含一个正整数 n,代表计分序列 A 的长度。小杨想要计算由 m 个小写字母组成的字符串的得分。第三行包含一个正整数 m,代表字符串的长度。

weixin_46127956的博客 103
上一篇: 论文文本分析怎么做?以京东手表评论为例,词云图、情感分析、主题分析等
下一篇: 干货整理|量表问卷数据分析速成,零基础论文模板直接套用
spssau
博客等级 码龄10年 3394粉丝 525原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值