


拿下ABB资源需要多久?
用python告诉你
只需要200秒!
---------------------------------------------------------------------------------
成品预览
资源图片
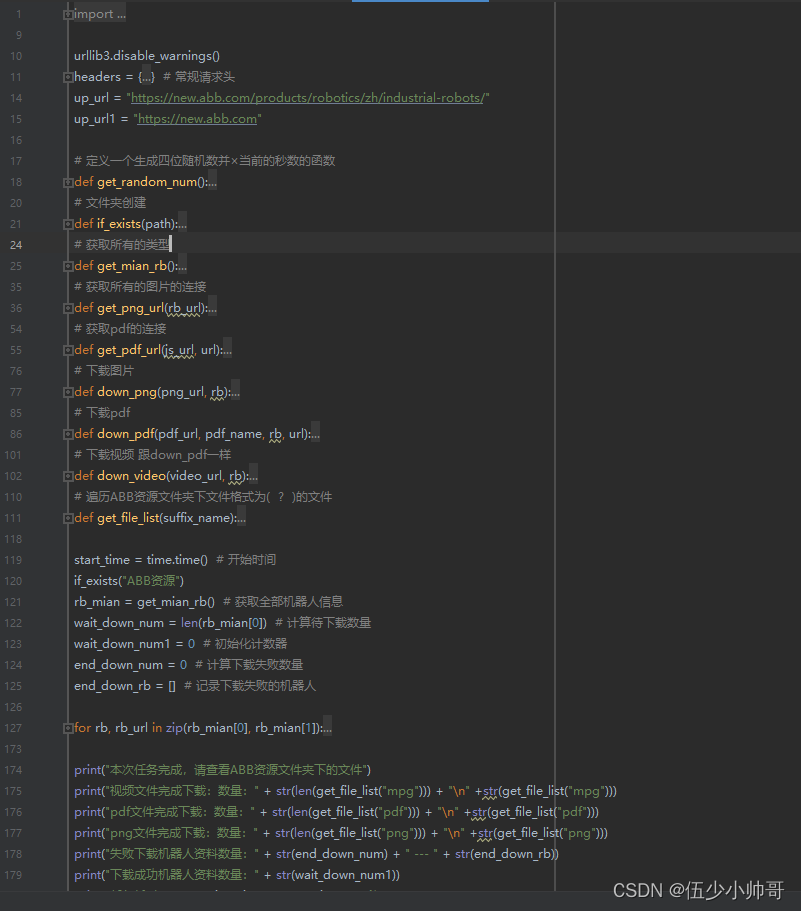
代码块预览
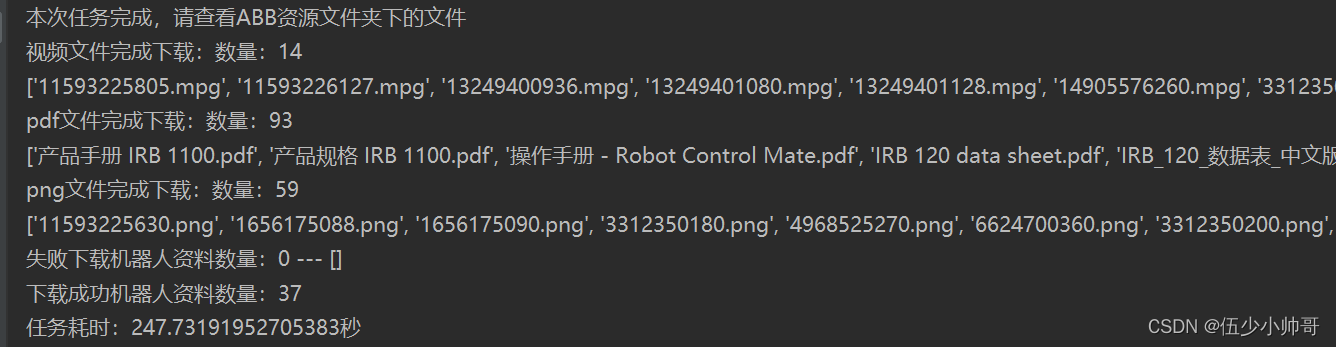
运行成功后代码
过程难点
1.正则匹配时犯的错误
2.爬虫时遇到的反爬机制
3.文件名因为粗心导致debug了两个小时
代码:
import requests
import re
import os
import random
import time
import threading
import urllib3
from urllib.parse import quote

urllib3.disable_warnings()
headers = {


    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36"
}  # 常规请求头
up_url = "https://new.abb.com/products/robotics/zh/industrial-robots/"
up_url1 = "https://new.abb.com"

# 定义一个生成四位随机数并×当前的秒数的函数
def get_random_num():
    return str(random.randint(1, 9) * int(time.time()))
# 文件夹创建
def if_exists(path):
    if not os.path.exists(path):
        os.makedirs(path)
# 获取所有的类型
def get_mian_rb():
    mian_url = "https://new.abb.com/products/robotics/zh/industrial-robots"  # 首页地址
    robot_type_all = requests.get(mian_url, headers=headers, verify=False)
    re_rb = re.findall('<a class="gradientGrayscale1112 inner clickable"[\s\S]*?header3">(.*?)</span>',
                       robot_type_all.text)  # 获取所有的机器人类型
    re_url = re.findall('<a class=".*?" href="(.*?)"[\s\S]*?data-', robot_type_all.text)  # 获取所有的机器人类型的链接
    del re_rb[0]  # 删除第一个元素
    del re_url[0]  # 删除第一个元素
    print("全部机器人已获取成功")
    return re_rb, re_url  # 返回所有的机器人类型和链接
# 获取所有的图片的连接
def get_png_url(rb_url):
    response = requests.get(up_url1 + rb_url, headers=headers, verify=False)
    rb_photo = re.findall(
        "<a class='gradientGrayscale1112 inner mPhotoLB abbHtmlImageLightbox clickable ' href='(.*?)' > ",
        response.text)  # 图片库
    rb_one_photo = re.findall('<h1 class="tile-headline"[\s\S]*?img src="(.*?)" class="stretch',
                              response.text)  # 首页横屏图片
    pid = re.findall('cid":"(.*?)"', response.text)  # 访问js的pid
    if len(rb_photo) != 0:
        print(

 4279


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


