全网爆火的大模型AI知识库,保姆级教程来了

腾讯IMA知识库接入DeepSeek大模型了,快速搭建自己的知识库,不要再花冤枉钱了 最近腾讯又憋了个大招,发布了IMA知识库,这下那些通过给别人使用DeepSeek搭建本地知识库的人慌了,这是在砸他们的生意呀,而且是腾讯这种他们惹不起的存在,废话不多说,我们来看IMA怎么玩?腾讯的IMA知识库(全称ima.copilot)是腾讯推出的以知识库为核心的AI智能工作台,集“搜、读、写”功能于一体,旨在提升用户学习与工作效率,并支持知识的长期沉淀与共享。IMA知识库支持客户端(windows/MAC)及小程序,全网同步。 阅读详情

构建Karpathy大神同款AI知识库

Karpathy 发了一条推文,分享了他近期重点在用 AI 构建个人知识库,短短两天,全网千万人观看。

“我最近发现一件非常有用的事:用 LLMs 为各种研究主题建立个人知识库。这样一来,我最近的大部分 token 使用量更多地用于处理内容,而不是编写或修改代码。”

然后就在昨天,他公开了整个构建的思路:

图片

思路很简单:不要把笔记分散在各种应用里,而是全扔进一个文件夹。然后让 AI 把这些材料整理成个人维基——生成摘要、把内容关联起来、整理文章——之后越用越好用。

你也想要打造大神同款AI知识库么?

博主 Nick Spisak 打造了一套保姆级实现教程,不需要特殊软件,不需要数据库,只要文件夹和文本文件。

图片

第一步:三个文件夹,两分钟搭好

打开终端或文件管理器,在电脑任意位置创建一个项目文件夹。在里面创建三个子文件夹:

my-knowledge-base/   raw/ (你的源材料 - 文章、笔记、截图)   wiki/ (AI 写入整理后内容的地方)   outputs/ (AI 生成的答案、报告和研究) 

就这样。这就是 Karpathy 使用的结构:raw/ 文件夹是你的原始素材收纳箱,wiki/ 文件夹是 AI 帮你理出条理的地方,outputs/ 文件夹存放问题的答案。

第二步:不用整理,什么都往里扔

大多数人在这里卡住了。他们创建了文件夹,然后盯着空空如也的 raw/ 目录,不知道该放什么。

答案是:什么都往里扔。把文章复制粘贴成 .md 或 .txt 文件,截图和图表直接保存,从你现在用的任何应用里导出笔记,会议记录、研究论文、项目文档,还有那些囤了几个月的书签,统统扔进去。

别整理、别重命名、别清理,这些活儿都是 AI 的。

我做 X 内容的时候攒了 17 个原始文件——剪藏的文章、竞品分析、数据报告。没有一个是手工整理的。

但 Karpathy 没提到真正加速这个过程的部分:自动化收集。

第三步:让AI自动把网页存进来

Vercel Labs 刚发布了 agent-browser——一个免费的命令行工具,让你的 AI Agent 操控实际的 Chrome 浏览器。GitHub 上 26K+ 星标。两条命令安装:

第二条命令会下载一个专用的 Chrome 浏览器。现在你的 AI 可以抓取任何网页,提取文本,直接保存到 raw/ 文件夹。

实际操作是这样的:

agent-browser open https://some-article-you-want.com agent-browser get text "article" 

就这样。AI 打开页面,抓取文章文本,你把它导入到 raw/ 里的文件。不需要手动复制粘贴,不需要浏览器扩展。

agent-browser 能处理那些复制粘贴搞不定的页面:JavaScript 动态加载的网站、需要登录才能看的内容、带交互式图表的研究论文,还有那些得不停滚动、点“加载更多”、在菜单里翻来翻去才能看到完整内容的页面。

这个工具比 Playwright MCP 省 82% 的 token,也就是说,同样一轮对话里,你的 AI Agent 能抓 5-6 倍的页面。我用它直接拉竞品文章、热门话题和研究文档,根本不用自己开浏览器。

用在知识库上,流程很简单:看到想要的文章,跟 AI 说一声:「把这个 URL 抓下来存到 raw/」,agent-browser 就搞定了。你的 raw/ 文件夹会自己慢慢填满。

第四步:给AI一份说明书,让它知道怎么干

这是大多数人会跳过的部分,别跳过。

在项目根目录创建一个叫 CLAUDE.md 的文件(或 AGENTS.md 或 README.md——名字不重要,内容才重要)。这个文件让 AI 知道你的知识库是干什么的、该怎么整理。

这是一个你现在就可以复制的起始模板:

# 知识库 Schema  ## 这是什么 一个关于 [你的主题] 的个人知识库。  ## 如何组织 - raw/ 包含未处理的源材料。永远不要修改这些文件。 - wiki/ 包含整理后的维基。完全由 AI 维护。 - outputs/ 包含生成的报告、答案和分析。  ## 维基规则 - 每个主题在 wiki/ 中有自己的 .md 文件 - 每个维基文件以一段摘要开头 - 使用 [[topic-name]] 格式链接相关主题 - 在 wiki/ 中维护一个 INDEX.md,列出每个主题及一行描述 - 当添加新的原始源时,更新相关的维基文章  ## 我的兴趣点 [列出 3-5 个你希望这个知识库关注的方向] 

Karpathy 自己也说了,他的 AGENTS.md 里的 schema “超级简单,完全扁平”:没有数据库,没有插件,只是一个告诉 AI 规则的文本文件。

这个文件相当于我在每个项目中使用 CLAUDE.md 的作用:给 AI 写一份你这个知识库专用的说明书。

第五步:一条指令,AI把笔记编成维基

打开 Claude Code(或 Cursor,或任何能读取文件的 AI 编码工具),打开你的项目文件夹,然后说:

“读取 raw/ 中的所有内容。然后按照 CLAUDE.md 中的规则在 wiki/ 中编译一个维基。先创建 INDEX.md,然后为每个主要主题创建一个 .md 文件。链接相关主题。总结每个源。“

然后走开,让它慢慢跑。

跑完之后你会拿到一个 wiki/ 文件夹,文章都按主题整理好了——帮你串起之前没注意到的关联,补上忘存的内容摘要,再加一份索引文件,想查什么几秒就能找到。

关键是:你不要手动编辑 Wiki,那是 AI 的工作。你只需要阅读它,对它提问,AI 负责更新和维护。

第六步:开始提问,打造活的知识库

一旦你的维基有了 10 篇以上的文章,开始提问:

“基于 wiki/ 中的所有内容,我对 【主题】 理解中最大的三个空白是什么?”“比较源 A 和源 B 对 【概念】 的说法。它们在哪里有分歧?”“仅使用这个知识库中的内容,给我写一份 500 字的 【主题】 简报。”

AI 会读取你的整个维基,根据你自己攒的材料给你答案。

把这些答案保存回知识库。把输出放到 outputs/ 或让 AI 用新见解更新相关的维基文章。每个问题都让下一个答案更好,正循环就转起来了。

第七步:定期检查,不让错误复利

告诉你的 AI:

“审查整个 wiki/ 目录。标记文章之间的任何矛盾。找出提到但从未解释的主题。列出任何没有 raw/ 中源支持的声明。建议 3 篇能填补空白的新文章。”

Karpathy 这条帖子下面,@HFloyd 的回复说到了关键:“当输出被归档回去时,错误也会复利。”这是真的。如果 AI 写了一些稍微错误的东西而你保存了它,下一个答案就会跟着错下去。

解决方法很简单:定期运行健康检查。

工具选择:简单胜过复杂

Karpathy 帖子下一半回复都在安利 Obsidian 插件。

但当有人问起他的设置时,Karpathy 实际上说的是:“我试图保持超级简单和扁平。它只是一个嵌套的 .md 文件目录。”

一个文本文件文件夹和一个 schema 文件就是整个知识库。

我用 Claude Code 从终端运行整个知识系统。你可以用 VS Code,可以用 Obsidian,可以用记事本。

AI 不在乎你用什么应用打开文件,重要的是文件夹结构和 schema。

装了 47 个插件的 Obsidian 又是一个 Notion 陷阱。你花在配置工具上的时间比使用知识库的时间还多。

扁平文件加一个好的 schema,90% 的场景下比花哨的工具栈管用。

写在最后:收藏和真正用起来!

这就是完整系统:三个文件夹、一个 schema 文件、一个浏览器抓取器,以及一个维护一切的 AI。

Karpathy 的帖子有 44K 人收藏。但收藏和真正用起来,差的只是一个周末的动手时间。

选个主题,建好文件夹,把现有内容扔进去。

剩下的交给 AI,就这么简单。

如何学习AI 大模型?(文末获取)

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

一、大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

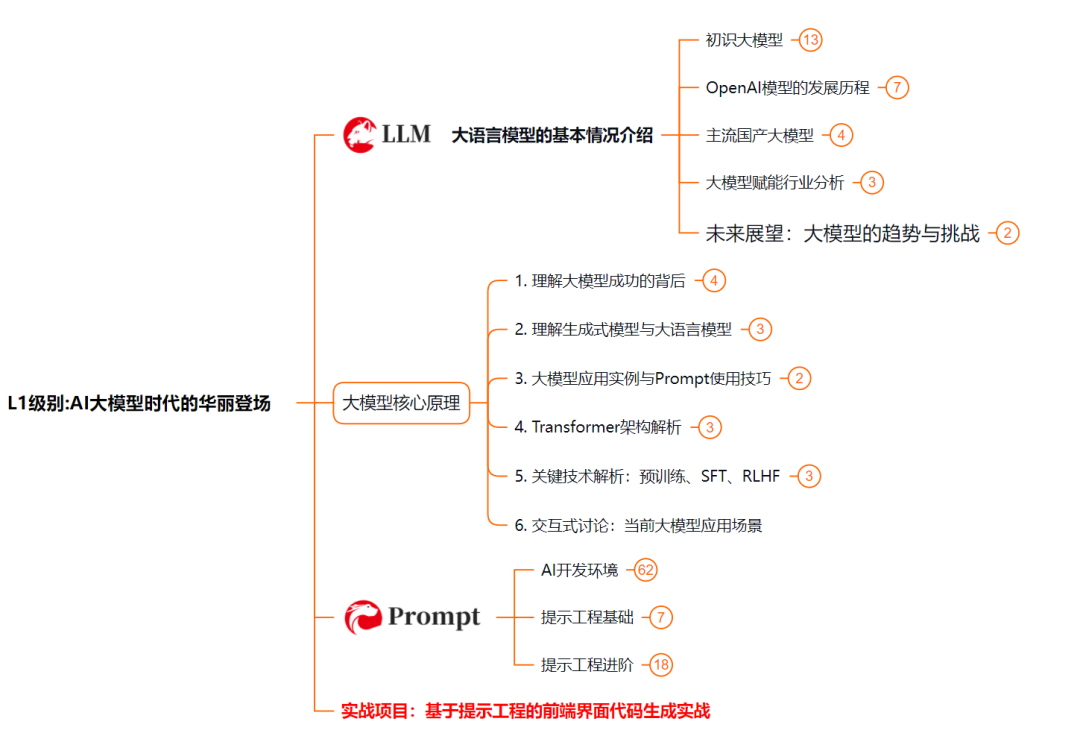
L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。
在这里插入图片描述

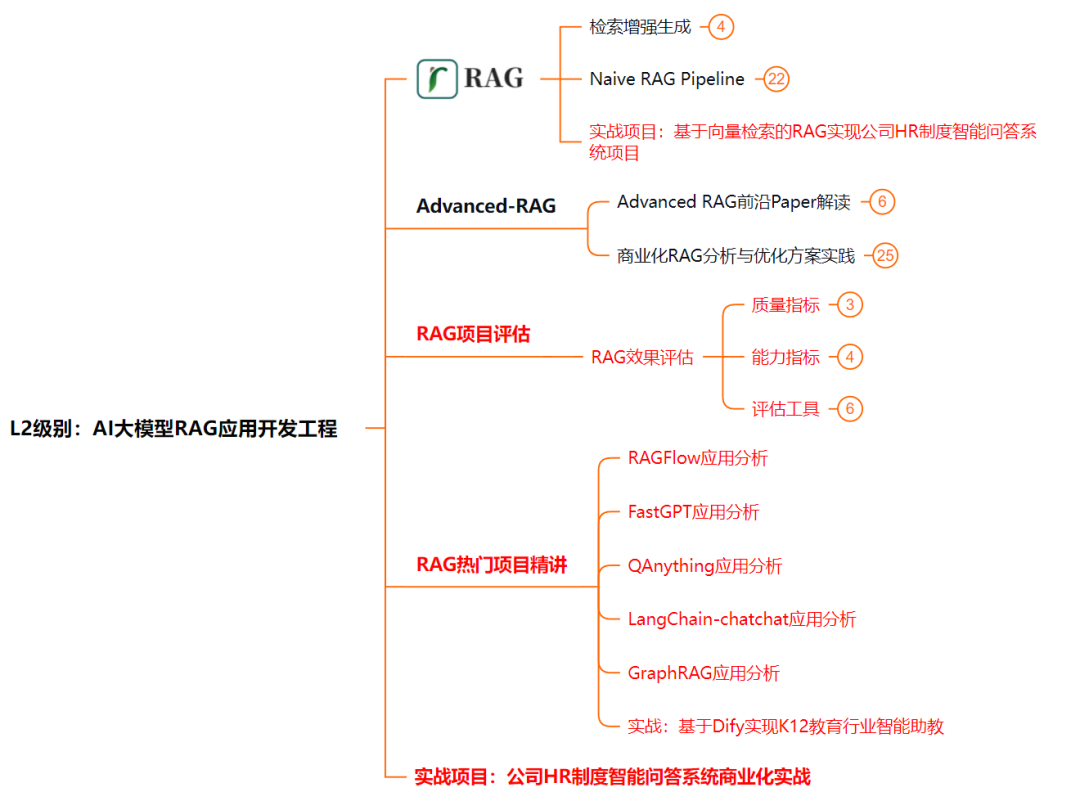
L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive
RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
在这里插入图片描述

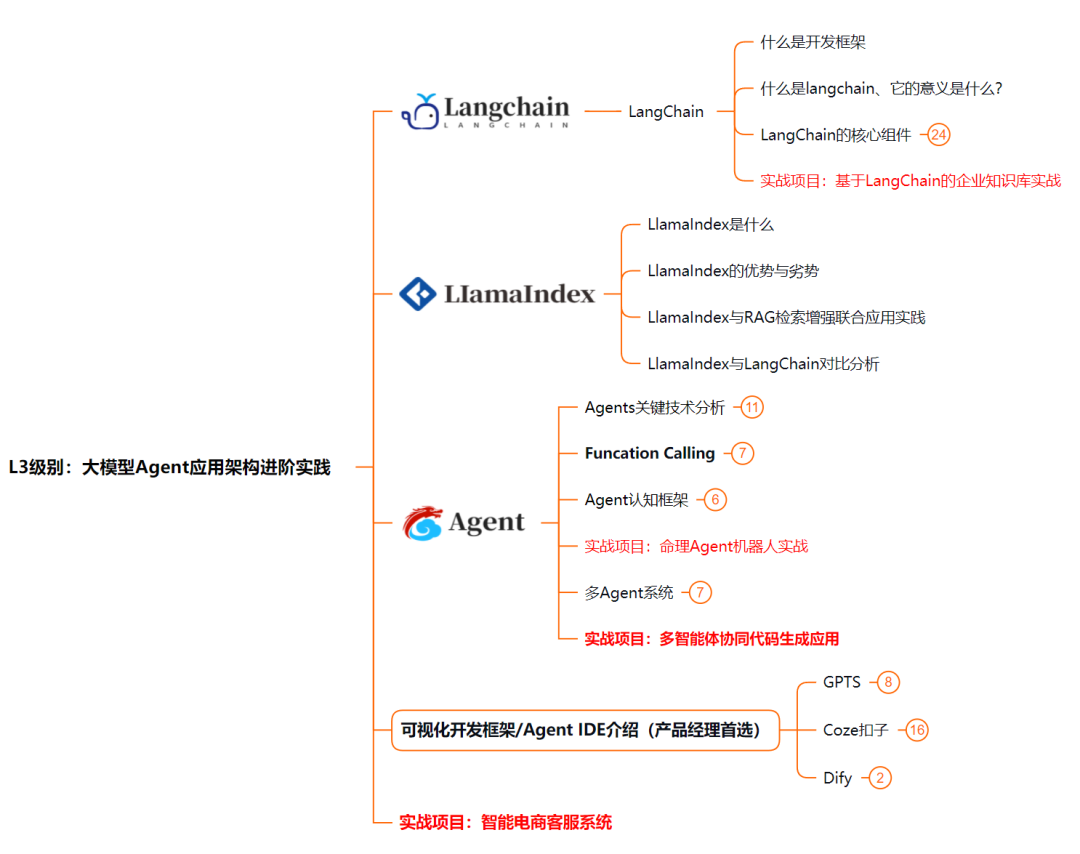
L3级别:大模型Agent应用架构 进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、
MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。
在这里插入图片描述

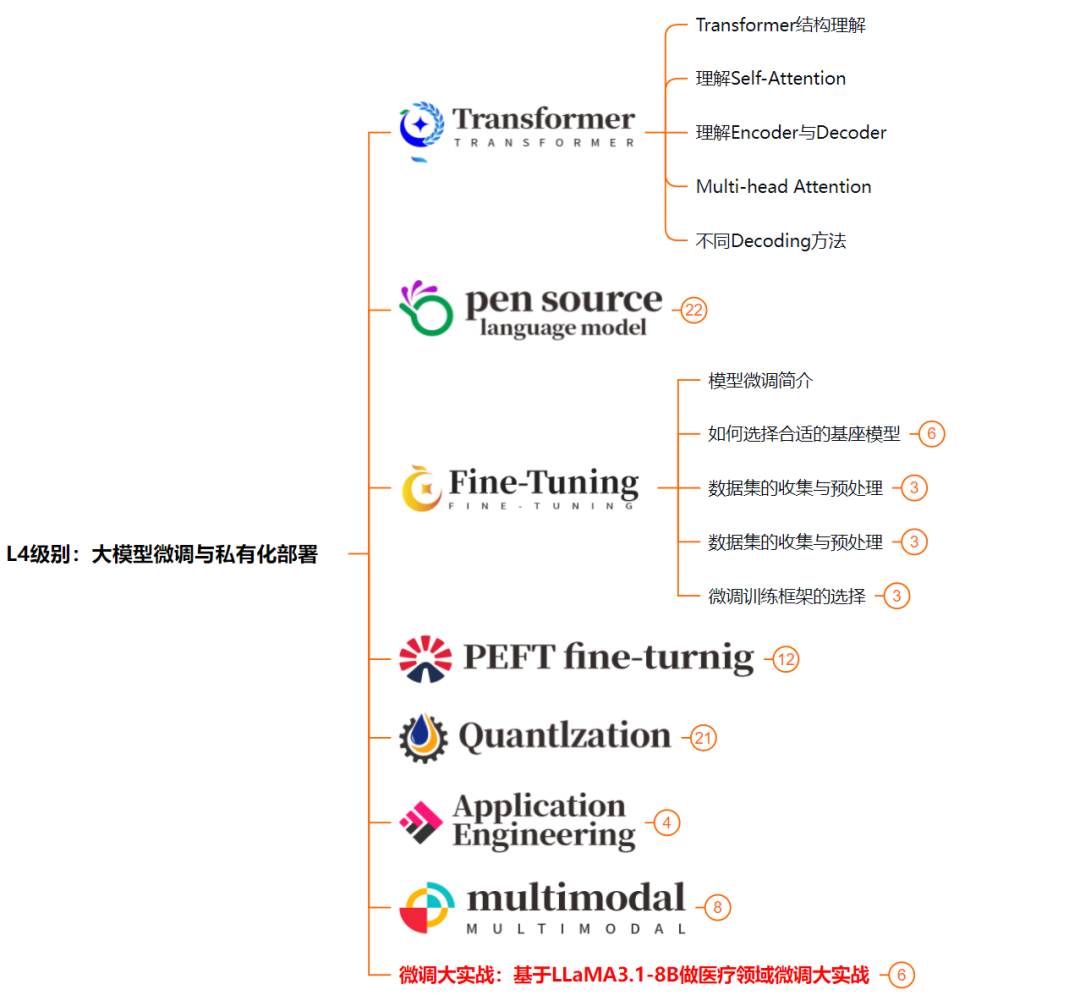
L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam
Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
在这里插入图片描述

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目 实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

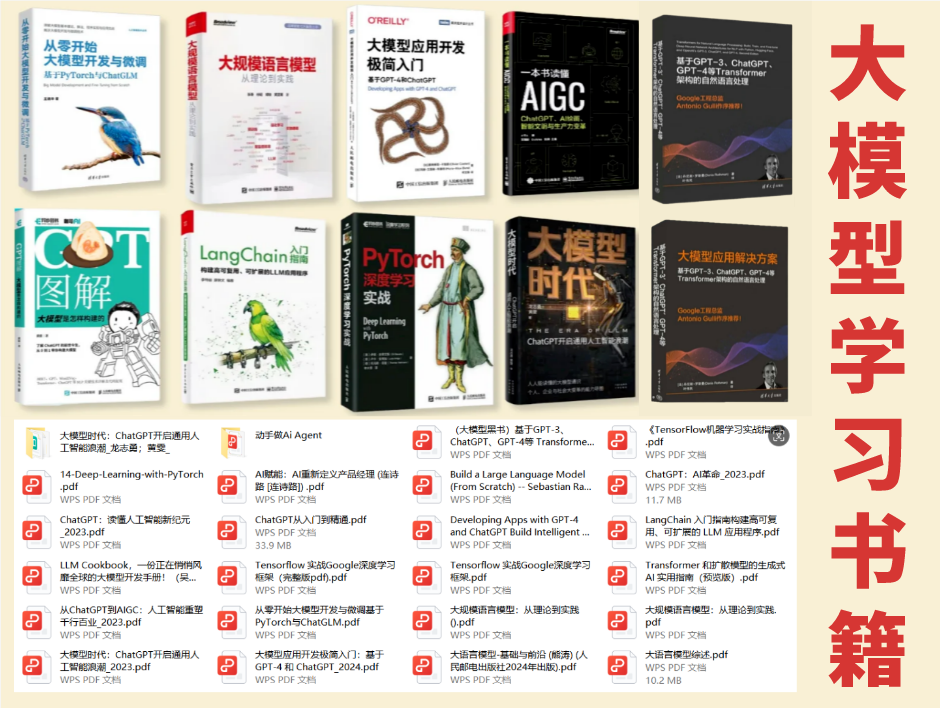
二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)
在这里插入图片描述

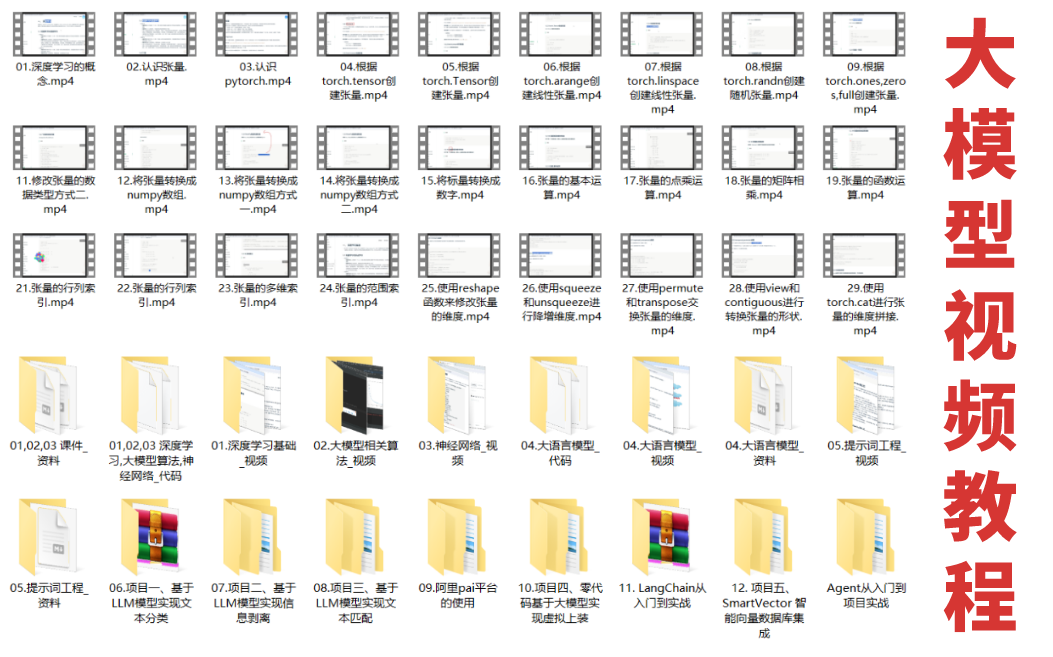
三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。
在这里插入图片描述

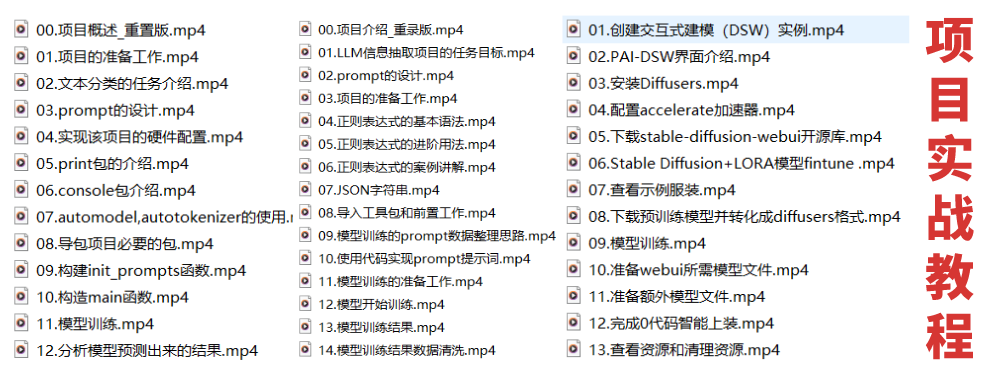
四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。
在这里插入图片描述

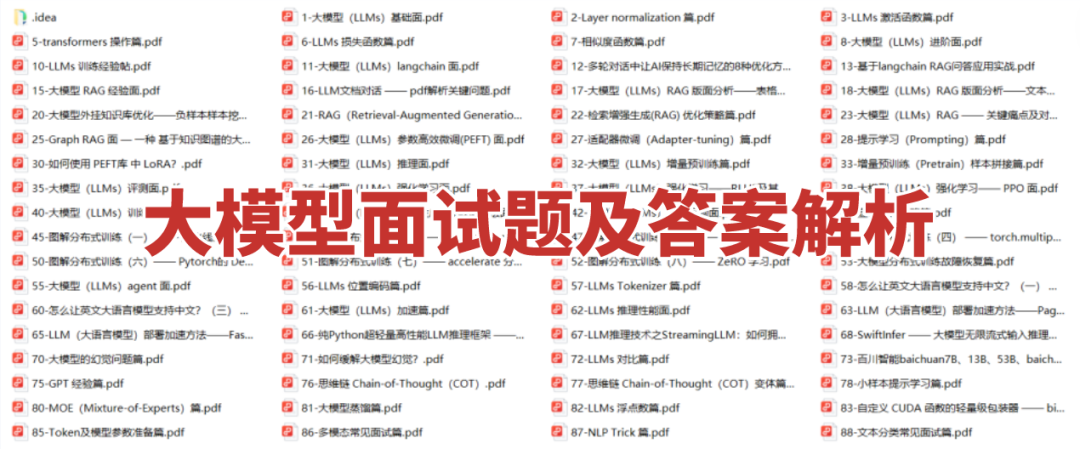
五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。
在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
在这里插入图片描述

领取方式我会放在下面,希望领取了的朋友不要忘了(安全链接,放心点击)

在这里插入图片描述

大模型AI知识库,保姆级教程来了 答案是:什么都往里扔。把文章复制粘贴成 .md 或 .txt 文件,截图和图表直接保存,从你现在用的任何应用里导出笔记,会议记录、研究论文、项目文档,还有那些囤了几个月的书签,统统扔进去。这就是 Karpathy 使用的结构:raw/ 文件夹是你的原始素材收纳箱,wiki/ 文件夹是 AI 帮你理出条理的地方,outputs/ 文件夹存放问题的答案。Karpathy 自己也说了,他的 AGENTS.md 里的 schema “超级简单,完全扁平”:没有数据库,没有插件,只是一个告诉 AI 规则的文本文件。 阅读详情

相关推荐

FPGA图像处理入门 ZYNQ7020 图像中值膨胀腐蚀滤波

图像处理的三种滤波 中值滤波应用较为广泛 综合膨胀和腐蚀可以实现边缘检测。

Coast_的博客 699

大模型技术知识库:从入门到实战,7天精通大模型核心技术(附学习路线)

本文系统介绍了大模型技术从基础到实战的学习路线,涵盖LLM原理、Prompt工程、RAG技术、AI Agent开发、微调与部署等核心内容。重点解析了Transformer架构、三阶段训练流程、Prompt优化技巧、RAG实现路径及15种优化方法,并提供了向量数据库选择、模型部署等实用指导。通过分章节学习(每章1-3天),读者可快速掌握大模型关键技术,并应用于实际场景。内容兼具理论深度与实践价值,为开发者提供了一条高效的学习路径。

m0_65555479的博客 480

CentOS 7下Ollama+Dify+DeepSeek离线部署全攻略(附模型迁移技巧)

本文详细介绍了在CentOS 7无网环境下,从零开始离线部署Ollama、DeepSeek模型与Dify平台的完整实战攻略。内容涵盖基础环境规划、Ollama服务安装、模型文件迁移技巧、Docker引擎离线部署,以及Dify平台与本地Ollama服务的集成配置,为企业内网构建安全、可控的AI应用提供了一套经过验证的解决方案。

weixin_28826521的博客 343

大模型学习路径

在掌握机器学习之前,理解支撑这些算法的基本数学概念非常重要。:这是理解许多算法(特别是深度学习算法)的关键。主要概念包括向量、矩阵、行列式、特征值和特征向量、向量空间以及线性变换。:许多机器学习算法涉及到连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分以及梯度的概念也很重要。:这些知识对于理解模型如何从数据中学习并进行预测至关重要。主要概念包括概率理论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。有的时候临时抱佛脚也是可以的。

lvaolan的博客 2734

语音测试(二)音频标注(praat)

通过点击红线下方的圆点进行区域划分,在区域中标注所属的类别。按住Alt+Backspace 键取消蓝色线条。

beishida123的博客 3705

Xiaojie雷达之路---毫米波雷达基础知识---中频信号的相位

本篇文章主要介绍毫米波雷达的基础知识中的中频信号的相位 文章目录傅里叶变换的快速回顾中频信号的相位中频信号对物体微小位移的灵敏度如何2个chirps来对一个物体的速度进行测量测量一个振动的物体 傅里叶变换的快速回顾 傅里叶变换是将一个信号从时域中转换到频域中,在时域中的一个正弦信号将在频域中产生一个峰值,在大多数情况下,在频域中的一个信号是一个复数(每个值是一个振幅和相位的向量),表示为AejθAe^{j\theta}Aejθ 在频域中峰值的相位等于正弦函数的初始相位 中频信号的相位 上一篇文章中提到,

XiaoJie的博客 1万+

全网爆火的大模型AI知识库,保姆级教程来了:用TaoToken统一Key接入Cline

把 raw/wiki/outputs 三个目录交给 Cline,用 TaoToken 统一 Key 接入大模型,改一份 settings.json 即可跑通个人 AI 知识库。本文给出可复制配置骨架与一次问答验证检索生效的方法,并附常见报错排查,助你用 LLM 把散落笔记编译成维基。官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35752122的博客 8

百度网盘开放平台OAuth 2.0授权全流程解析

本文详细解析了百度网盘开放平台OAuth 2.0授权全流程,包括创建应用、获取凭证、授权码模式详解以及access_token的使用与刷新。通过实际案例和代码示例,帮助开发者快速掌握接口调用技巧,避免常见错误,确保安全高效地接入百度网盘API。

wind6的博客 1258

全网爆火的大模型AI知识库,保姆级教程来了:用TaoToken统一Key打通知识库问答链路

用Python脚本把本地文档切分向量化,通过TaoToken统一Key同时调用embedding与chat接口,跑通个人大模型AI知识库问答链路。文中给出可复制配置、余弦检索实现及401、local proxy failed等报错排查顺序,普通笔记本即可验证。详见官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_34162851的博客 4

AgentScope实战训练营- Java从零开始快速构建Agent完整教程

本文基于阿里巴巴开源的 AgentScope Java 框架,从零开始手把手带你构建 AI 智能体应用。内容涵盖环境搭建、基础对话、工具调用、结构化输出、多Agent流水线、Hook可观测性、会话持久化、MCP协议、RAG知识库集成、多模态工具、技能系统、Spring Boot Web部署等21个核心模块,附带完整可运行代码示例,帮助Java开发者快速掌握Agent开发全流程。

program哲学 834

GoAnywhere MFT 身份验证绕过漏洞(CVE-2024-0204)

GoAnywhere MFT 身份验证绕过漏洞(CVE-2024-0204)

weixin_43567873的博客 382

2026全网最全AI Skill开源合集|从爆火角色蒸馏到全场景生产级技能开箱即用

本文聚焦2026年爆火的AI Skill技术,整合了全网刷屏的26个AI角色蒸馏Skill,以及55条经链接可用性校验、稳定可用的生产级全场景AI Skill资源,所有项目均附完整开源地址。内容覆盖职场人设复刻、名人思维蒸馏,到开发编程、产品运维、网络安全、学术科研等全行业场景,兼顾趣味玩法与企业级生产实用性,同时提供主流AI工具的极简上手指南,帮助读者零门槛实现AI能力定制化复用,适合AI爱好者、开发者与职场人参考。

大鹏的博客 1万+

0基础学习diffusion_model扩散模型【易理解的公式推导】Denoising Diffusion Probabilistic Models

去噪扩散概率模型。本文是笔者在学习扩散模型时的一些笔记与心得,在公式推导过程中能够保证自己是一步一步去推导并且理解了的。概述是我认为比较重要的部分能够帮助理解公式的推导,具体的公式推导在每一小节中进行。1、扩散过程:如上图所示,扩散过程为从右到左X0→XTX0​→XT​的过程,表示对图片逐渐加噪,且Xt1X_{t+1}Xt1​是在XtX_{t}Xt​加躁得到的,其只受XtX_{t}Xt​的影响,因此扩散过程是一个马尔科夫过程。X0X_0。

zik的博客 2389

来了来了!爆火AI工具Dify怎么玩?这绝对是全网最详细的教程(上)

来了来了!爆火AI工具Dify怎么玩?这绝对是全网最详细的教程(上)

Y525698136的博客 2476

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

deepseek+dify零成本部署本地知识库保姆级教程_dify 本地部署

deepseek+dify零成本部署本地知识库保姆级教程

qingkahui24689的博客 1万+

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

来了来了!爆火AI工具Dify怎么玩?这绝对是全网最详细的教程(下)

承接上一篇《来了来了!爆火AI工具Dify怎么玩?这绝对是全网最详细的教程(上)》,今天继续给大家详细介绍下Dify如何使用。先回顾上一篇都讲了什么:1、Dify的安装和启动2、使用Dify前的一些必要配置。3、Dify核心功能介绍。4、知识库实战1:如何在Dify中创建知识库5、知识库实战2:如何在Dify中外连知识库RAGFlow6、智能体实战1:最简单的聊天模式7、智能体实战2:Agent模式8、智能体实战3:整合MCP下面继续开启智能体的其他实战部分。

m0_70486148的博客 1125

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

国产AI智能体Manus一夜爆火

最近,一支来自中国的团队正式对外发布通用型AI Agent产品Manus。这款AI Agent产品,以其强大的功能和惊人的市场反应,瞬间点燃了整个科技界。那么,Manus究竟是如何一夜爆火的呢?Manus的爆火,首先离不开其“全流程执行”的能力。传统的AI助手,大多只能给出建议或答案,而Manus却能更进一步,直接完成任务并交付成果。比如,用户只需告诉Manus“筛选本月程序员简历”,它就能自动解压文件、分析资质,甚至生成Excel排名表。

qq_46094651的博客 1286

2025年科技新书预告 | 全网爆火的大模型神作震撼登场,这些书值得抢先收藏!

2024 年,图灵为大家带来了许多备受欢迎的经典之作。从上市即热销的《大模型应用开发极简入门》,到 GitHub 上收获 99.3K Star 的算法教程《Hello 算法》,再到聚焦前沿技术热点的《ChatGPT高效提问:Prompt技巧大揭秘》和《ChatGPT从入门到精通》,这些实用性极强的科技类图书深受读者喜爱。而 2025 年,图灵依旧诚意满满,带来超多重磅新书。图灵君也迫不及待地跟大家分享一波。

2401_84204413的博客 1554

月薪10万+!DeepSeek的爆火背后的机遇与挑战

春节假期让大家眼前一亮的除了哪吒,估计就是DeepSeek了吧。_对于DeepSeek的一夜爆火,我纠结了很久__从哪些角度去写,能让大家感受更直接。我东拼西凑绞尽脑汁阐述了DeepSeek可能带来的影响,希望对你有用…正文开始😄😄😄⇩⇩⇩01AI市场将被重塑DeepSeek无疑是2025开年AI圈的一匹黑马,在一众AI大模型中,DeepSeek以低价高性能的优势脱颖而出。DeepSeek的上线实现了AI界的又一大突破,各大科技巨头都火速出手,争先抢占DeepSeek大模型的流量风口。

lyy2017175913的博客 1504

DeepSeek 王炸组合:DeepSeek 强推理+全网实时搜索+高质量知识库,秘塔AI这波操作堪称完美!

DeepSeek非常强大,最近因为爆火和美国IP的攻击,导致它的联网搜索经常暂不可用。如今,DeepSeek与秘塔AI搜索的强强联合,**秘塔AI搜索宣布融合了DeepSeek-R1满血版,R1推理能力和链接全网实时信完美集成了,背后也链接上了秘塔的海量论文数据!**实现了“一站式实时联网+知识库+推理”的功能整合,这不仅真正让推理能力走向了大众化,也标志着AI搜索从单一功能点向系统化、全面化的跨越。

m0_59235699的博客 2718

【保姆级教程】AnythingLLM构建专用知识库(问答增加个人文档)

【保姆级教程】AnythingLLM构建专用知识库(问答增加个人文档)

Y525698136的博客 2662

AI大模型真正落地的应用:IMA知识库

大模型结合知识库问答是一个较为常见且实用的应用场景。例如,我曾经尝试过腾讯的IMA应用,该应用背后依托于混元大模型的支持。

huang9604的博客 5171

爆火AI工具Dify怎么玩?这绝对是全网最详细的教程(上)

爆火AI工具Dify怎么玩?这绝对是全网最详细的教程(上)

瓦罗兰特顶级C位的博客 1149
上一篇: 2026年国内AI大模型横评:DeepSeek/通义/文心/豆包/Kimi,到底哪个最好用
下一篇: OfficeAI办公场景「选模型指南」:不同任务,各有「最优解」!
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

