


目录
4.3.2 MMR(Maximal Marginal Relevance)
第四章:文本分类-CSDN博客 https://blog.csdn.net/m0_67804957/article/details/145822178
一、概述
文本聚类:根据文本的语义内容、含义和关系将相似的文本分组。
如下图所示,语义相似的文档聚类不仅有助于高效地对大量非结构化文本进行分类,还能实现快速的探索性数据分析。
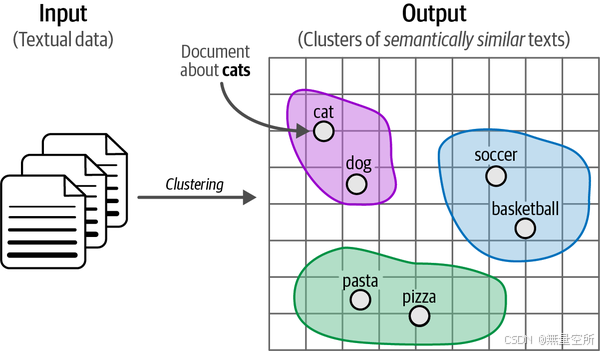
近年来,语言模型的发展使得文本能够以上下文和语义的方式进行表示,这增强了文本聚类的有效性。
文本聚类是一种无监督无标注任务,允许创造性地提出解决方案,并且有多种应用,例如发现异常值、加速标注以及发现错误标注的数据。
主题建模:从文本数据中发现抽象主题,通常使用关键词或关键短语描述,并且理想情况下有一个总体的标签。
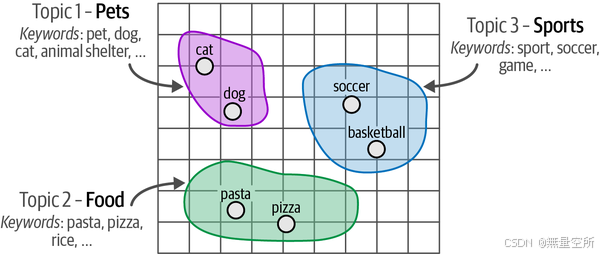
在本章中,我们将首先探索如何使用嵌入模型进行聚类,然后转向一种受文本聚类启发的主题建模方法,即BERTopic。
文本聚类和主题建模探索了将各种不同的语言模型结合起来的创造性方法。我们将探索如何将仅编码器(嵌入)、仅解码器(生成)甚至经典方法(词袋模型)结合起来,从而产生令人惊叹的新技术和流程。
二、获取数据集
在本章中,我们将在ArXiv的文章上运行聚类和主题建模算法。ArXiv是一个开放获取的学术文章平台,主要涵盖计算机科学、数学和物理学等领域。为了与本书的主题保持一致,我们将探索计算与语言领域的文章。数据集包含1991年至2024年从ArXiv的cs.CL(计算与语言)部分的44,949篇摘要。
加载数据,并为每篇文章的摘要、标题和年份创建单独的变量:
# 从Hugging Face加载数据
from datasets import load_dataset
dataset = load_dataset("maartengr/arxiv_nlp")["train"]

# 提取元数据
abstracts = dataset["Abstracts"]
titles = dataset["Titles"]
三、文本聚类的通用流程
文本聚类允许发现你可能熟悉或不熟悉的模式。它可以帮助直观地理解任务(例如分类任务)及其复杂性。因此,文本聚类不仅仅是一种快速的探索性数据分析方法。
尽管文本聚类有多种方法,从基于图的神经网络到基于质心的聚类技术,但一种流行的通用流程涉及三个步骤和算法:
使用嵌入模型将输入文档转换为嵌入向量。
使用降维模型降低嵌入向量的维度。
使用聚类模型找到语义相似的文档组。
3.1 文本转embedding
第一步是将我们的文本数据转换为嵌入,如下图所示。回想一下前面章节的内容,嵌入是文本的数值表示,旨在捕捉其含义。
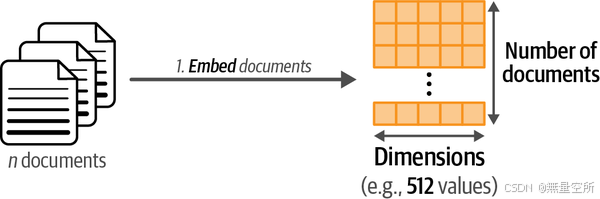
选择针对语义相似性任务优化的嵌入模型对于聚类尤为重要,因为我们试图找到语义相似的文档组。
正如我们在前一章所做的那样,我们将使用MTEB排行榜来选择嵌入模型。我们需要一个在聚类任务上得分不错且足够小以快速运行的嵌入模型。我们不再使用前一章中使用的“sentence-transformers/all-mpnet-base-v2”模型,而是改用“thenlper/gte-small”模型。这是一个更新的模型,在聚类任务上优于之前的模型,并且由于其较小的尺寸,推理速度更快。
from sentence_transformers import SentenceTransformer

# 为每个摘要创建嵌入
embedding_model = SentenceTransformer("thenlper/gte-small")
embeddings = embedding_model.encode(abstracts, show_progress_bar=True)
我们来检查一下每个文档嵌入包含多少个值:
# 检查生成的嵌入的维度
embeddings.shape

>> 输出结果为 (44949, 384)
每个嵌入包含384个值,这些值共同表示文档的语义表示。你可以将这些嵌入视为我们想要聚类的特征。
3.2 降低嵌入的维度
在聚类嵌入之前,我们需要考虑其高维度。随着维度数量的增加,每个维度中可能的值呈指数级增长。在每个维度中找到所有子空间变得越来越复杂。
因此,高维数据对于许多聚类技术来说可能是一个问题,因为识别有意义的聚类变得更加困难。
相反,我们可以利用降维技术。如下图所示,这种技术允许我们将数据从高维空间压缩到低维空间。降维技术的目标是通过找到低维表示来保留高维数据的全局结构。
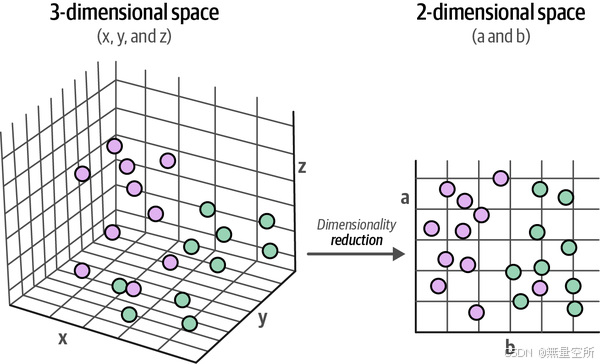
请注意,这是一种压缩技术,底层算法并不是随意删除维度。为了帮助聚类模型创建有意义的聚类,降维是我们聚类流程的第二步,如下图所示。
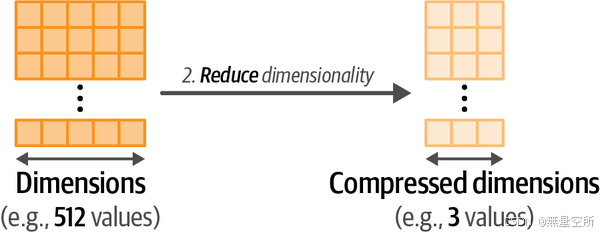
常见的降维方法有主成分分析(PCA)和均匀流形近似与投影(UMAP)。对于这个流程,我们选择UMAP,因为它比PCA更好地处理非线性关系和结构。
注意
降维技术并非完美无缺。它们无法完美地将高维数据压缩到低维表示中。这个过程总会丢失一些信息。在降低维度和保留尽可能多的信息之间需要找到平衡。
为了执行降维,我们需要实例化UMAP类并将生成的嵌入传递给它:
from umap import UMAP

# 将输入嵌入从384维降低到5维
umap_model = UMAP(
    n_components=5, min_dist=0.0, metric='cosine', random_state=42
)
reduced_embeddings = umap_model.fit_transform(embeddings)我们可以使用n_components参数来决定低维空间的形状,即5维。一般来说,5到10之间的值能够很好地捕捉高维全局结构。
min_dist参数是嵌入点之间的最小距离。我们将这个值设置为0,因为这通常会产生更紧密的聚类。我们将metric设置为cosine,因为基于欧几里得距离的方法在处理高维数据时存在问题。
需要注意的是,在UMAP中设置random_state可以使结果在不同会话中可复现,但会禁用并行化,从而减慢训练速度。
3.3 使用聚类算法
第三步是聚类降维后的嵌入,如下图所示。
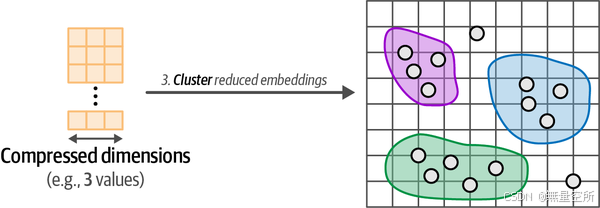
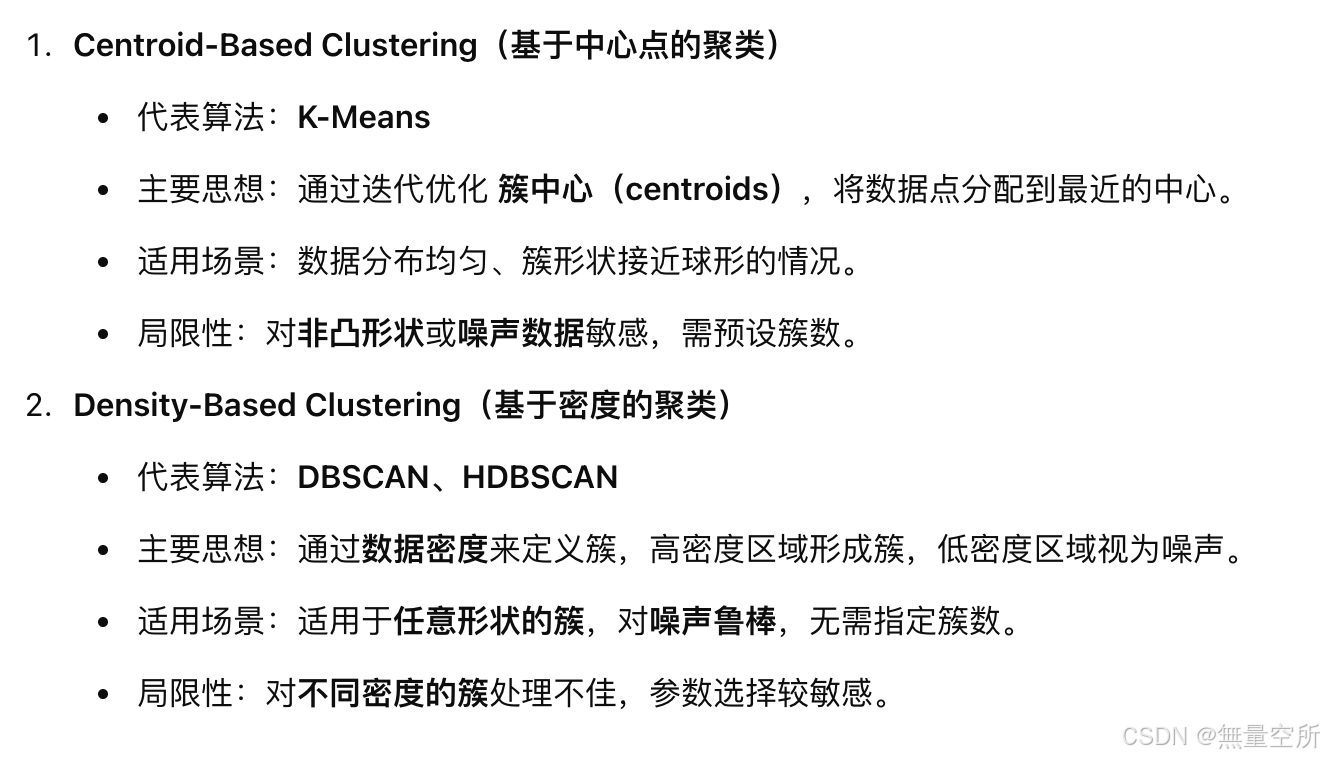
虽然常见的选择是基于质心的算法(如k-means),它需要生成一组聚类,但我们事先不知道聚类的数量。
相反,基于密度的算法可以自由计算聚类的数量,并且不会强迫所有数据点都属于某个聚类,如下图所示。
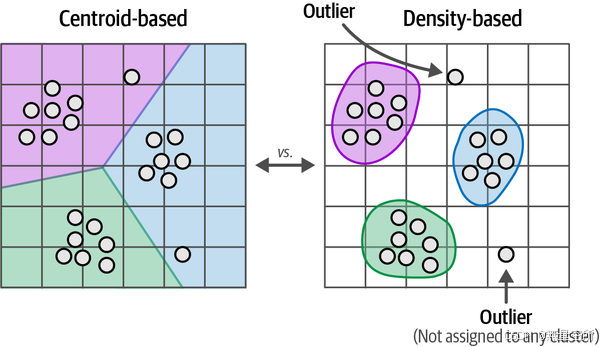
一种常见的基于密度的模型是HDBSCAN。如下图所示
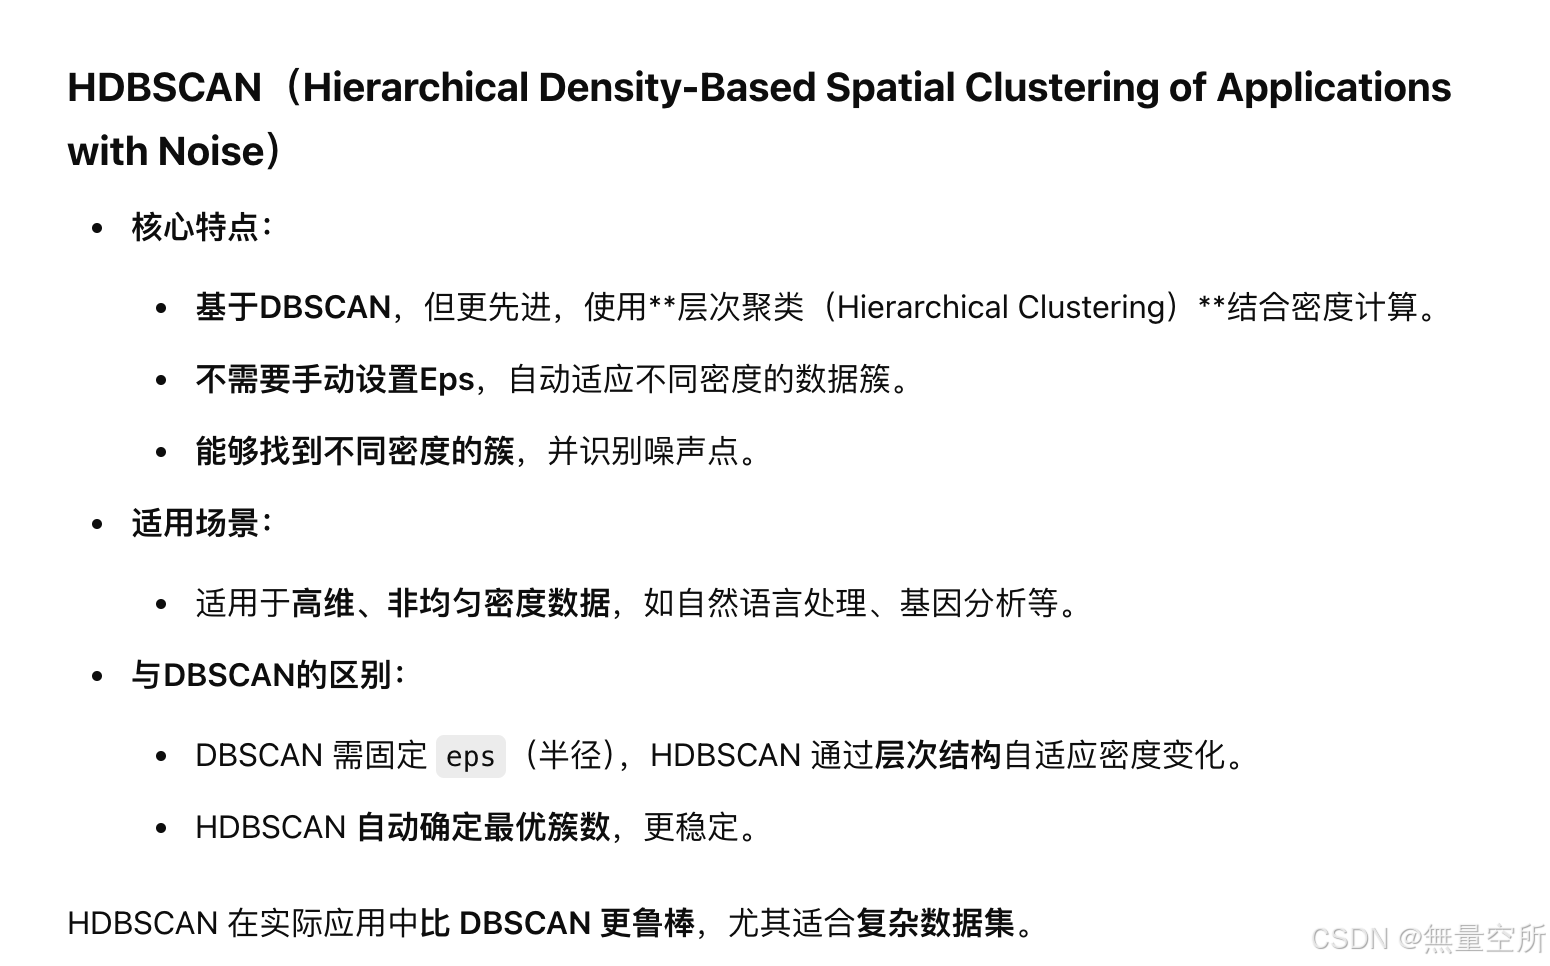
HDBSCAN是DBSCAN聚类算法的层次变体,允许在不需要明确指定聚类数量的情况下找到密集的(微观)聚类。作为一种基于密度的方法,HDBSCAN还可以检测数据中的离群点,这些离群点不属于任何聚类。换句话说,它们会被忽略。由于arXiv文章可能包含一些小众论文,使用能够检测离群点的模型可能会很有帮助。
与前面的包一样,使用HDBSCAN非常简单。我们只需要实例化模型并将降维后的嵌入传递给它:
from hdbscan import HDBSCAN

# 我们拟合模型并提取聚类
hdbscan_model = HDBSCAN(
    min_cluster_size=50, metric="euclidean", cluster_selection_method="eom"
).fit(reduced_embeddings)
clusters = hdbscan_model.labels_

# 我们生成了多少个聚类?
len(set(clusters))

>> 输出结果为 156使用HDBSCAN,我们在数据集中生成了156个聚类。如果想生成更多聚类,我们需要降低min_cluster_size的值,因为它表示聚类可以接受的最小大小。


 1930


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


