YOLO-v3模型参数anchor设置

开发者福利!热门AI工具限时免费用 购周边即赠Coding Plan Lite,Claude Code、Cursor等20+工具畅享,效率翻倍! 阅读详情

1. 背景知识

在YOLO-v2版本中就引入了anchor box的概念,极大增加了目标检测的性能。但是在训练自己数据的时候还是用模型中原有的anchor设置显然是有点不合适的,那么就涉及到根据自己的训练数据来设置anchor。

那么,首先我们需要知道anchor的本质是什么,本质是SPP(spatial pyramid pooling)思想的逆向。而SPP本身是做什么的呢,就是将不同尺寸的输入resize成为相同尺寸的输出。所以SPP的逆向就是,将相同尺寸的输出,倒推得到不同尺寸的输入。

接下来是anchor的窗口尺寸,这个不难理解,三个面积尺寸( 12 8 2 , 25 6 2 , 51 2 2 128^2,256^2,512^2 128225625122),然后在每个面积尺寸下,取三种不同的长宽比例 ( 1 : 1 , 1 : 2 , 2 : 1 ) (1:1,1:2,2:1) 1:1,1:2,2:1.这样一来,我们得到了一共9种面积尺寸各异的anchor。示意图如下:
在这里插入图片描述
那么anchor在目标检测中是怎么使用的呢?那就先来看Faster R-CNN中的运用,下面是整个网络的结构图:
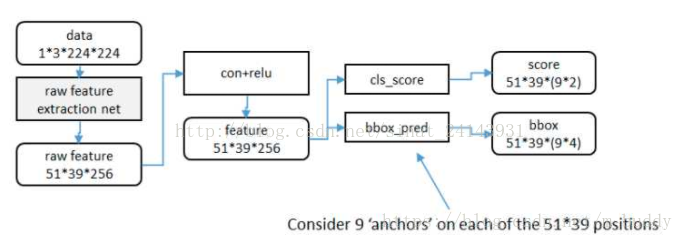
在这里插入图片描述
利用anchor是从第二列这个位置开始进行处理,这个时候,原始图片已经经过一系列卷积层和池化层以及relu,得到了这里的 feature:51x39x256(256是层数:H,W,C)在这个特征参数的基础上,通过一个3x3的滑动窗口,在这个51x39的区域上进行滑动,stride=1,padding=1,这样一来,滑动得到的就是51x39个3x3的窗口。对于每个3x3的窗口,作者就计算这个滑动窗口的中心点所对应的原始图片的中心点。然后作者假定,这个3x3窗口,是从原始图片上通过SPP池化得到的,而这个池化的区域的面积以及长宽比例,就是一个个的anchor。换句话说,对于每个3x3窗口,作者假定它来自9种不同原始区域的池化,但是这些池化在原始图片中的中心点,都完全一样。这个中心点,就是刚才提到的,3x3窗口中心点所对应的原始图片中的中心点。如此一来,在每个窗口位置,我们都可以根据9个不同长宽比例、不同面积的anchor,逆向推导出它所对应的原始图片中的一个区域,这个区域的尺寸以及坐标,都是已知的。而这个区域,就是我们想要的 proposal。所以我们通过滑动窗口和anchor,成功得到了 51x39x9 个原始图片的proposal。接下来,每个proposal我们只输出6个参数:每个 proposal 和 ground truth 进行比较得到的前景概率和背景概率(2个参数)(对应图上的 cls_score);由于每个 proposal 和 ground truth 位置及尺寸上的差异,从 proposal 通过平移放缩得到 ground truth 需要的4个平移放缩参数(对应图上的 bbox_pred)。

2. Anchor先验参数计算

这里计算训练数据的anchor先验直接使用的是转好的数据,即是已经转好的可直接训练的数据。这里使用的代码参考的是这个仓库kmeans-anchor-boxes。各位可以到仓库里面下载里面的KMeans文件就可以了,这里给出我使用的部分代码:

# -*- coding=utf-8 -*-
import glob
import os
import sys
import xml.etree.ElementTree as ET
import numpy as np
from kmeans import kmeans, avg_iou

# 根文件夹
ROOT_PATH = '/data/DataBase/YOLO_Data/V3_DATA/'
# 聚类的数目
CLUSTERS = 6
# 模型中图像的输入尺寸,默认是一样的
SIZE = 640

# 加载YOLO格式的标注数据
def load_dataset(path):
    jpegimages = os.path.join(path, 'JPEGImages')
    if not os.path.exists(jpegimages):
        print('no JPEGImages folders, program abort')
        sys.exit(0)
    labels_txt = os.path.join(path, 'labels')
    if not os.path.exists(labels_txt):
        print('no labels folders, program abort')
        sys.exit(0)

    label_file = os.listdir(labels_txt)
    print('label count: {}'.format(len(label_file)))
    dataset = []

    for label in label_file:
        with open(os.path.join(labels_txt, label), 'r') as f:
            txt_content = f.readlines()

        for line in txt_content:
            line_split = line.split(' ')
            roi_with = float(line_split[len(line_split)-2])
            roi_height = float(line_split[len(line_split)-1])
            if roi_with == 0 or roi_height == 0:
                continue
            dataset.append([roi_with, roi_height])
            # print([roi_with, roi_height])

    return np.array(dataset)

data = load_dataset(ROOT_PATH)
out = kmeans(data, k=CLUSTERS)

print(out)
print("Accuracy: {:.2f}%".format(avg_iou(data, out) * 100))
print("Boxes:\n {}-{}".format(out[:, 0] * SIZE, out[:, 1] * SIZE))

ratios = np.around(out[:, 0] / out[:, 1], decimals=2).tolist()
print("Ratios:\n {}".format(sorted(ratios)))

经过运行之后得到一组如下数据:

[[0.21203704 0.02708333]
 [0.34351852 0.09375   ]
 [0.35185185 0.06388889]
 [0.29513889 0.06597222]
 [0.24652778 0.06597222]
 [0.24861111 0.05347222]]
Accuracy: 89.58%
Boxes:
 [135.7037037  219.85185185 225.18518519 188.88888889 157.77777778
 159.11111111]-[17.33333333 60.         40.88888889 42.22222222 42.22222222 34.22222222]

其中的Boxes就是得到的anchor参数,以上面给出的计算结果为例,最后的anchor参数设置为

anchors = 135,17,  219,60,  225,40,  188,42,  157,42,  159,34

由于KMeans算法的结果对于初始点的选取敏感,因而每次运行的结果并不相同,只有Accuracy结果比较稳定点。至于那个anchor参数好,只有自己去尝试了。但是在使用的时候,没改过anchor经过一段时间的训练之后网络也能够适应,至于会不会对检测的精度有影响,暂时还没验证,-_-||。。。

为什么YOLOv2和YOLOv3的anchor大小有明显区别?
在YOLOv2中,作者用最后一层feature map的相对大小来定义anchor大小。也就是说,在YOLOv2中,最后一层feature map大小为13X13(不同输入尺寸的图像最后的feature map也不一样的),相对的anchor大小范围就在(0x0,13x13],如果一个anchor大小是9x9,那么其在原图上的实际大小是288x288。

而在YOLOv3中,作者又改用相对于原图的大小来定义anchor,anchor的大小为(0x0,input_w x input_h]。所以,在两份cfg文件中,anchor的大小有明显的区别。如下是作者自己的解释:

So YOLOv2 I made some design choice errors, I made the anchor box size be relative to the feature size in the last layer. Since the network was down-sampling by 32. This means it was relative to 32 pixels so an anchor of 9x9 was actually 288px x 288px.
In YOLOv3 anchor sizes are actual pixel values. this simplifies a lot of stuff and was only a little bit harder to implement
https://github.com/pjreddie/darknet/issues/555#issuecomment-376190325

3. 参考

  1. K-means 计算 anchor boxes
Yolov2 训练时anchor是如何使用的?build_target 0.简略描述 1.将真值检测框变换到特征图尺度上 2.计算以特征图每个网格中心为中心点时所有锚框与真值检测框的交并比 3.取与真值检测框交并比最大的锚框的id,及真值检测框中心所在cell的id,有此,可将真值检测框与预测结果对应起来 4.计算位置回归损失,置信度损失,分类损失 1,网络的输出 图1 yolov2 网络对于检测框位置大小的输出是: 对于1个batch网络的输出的shape为[batch_size, H*W*num_anchors, 5+num_classes], 其中: num_ 阅读详情

相关推荐

yolov5的anchor详解

一直对yolov5的检测过程怎么完成的,利用anchor加速学习,在损失时与GT比较,加速收敛。

anny_jra的博客 2万+

(20)目标检测算法之YOLOv5计算预选框、详解anchor计算

目标检测算法之YOLOv5计算预选框、详解anchor计算

yohnyang的博客 9635

YOLO v2算法详解

论文: YOLO9000:Better,Faster,Stronger 论文链接:https://arxiv.org/abs/1612.08242 YOLO9000是CVPR2017的最佳论文提名。首先讲一下这篇文章一共介绍了YOLO v2和YOLO9000两个模型,二者略有不同。前者主要是YOLO的升级版(关于YOLO v1的介绍可以参考:YOLO v1算法详解),后者的主要检测网络也是YO...

AI之路 6万+

YOLOv3Anchor理解

首先可以把anchor理解为:多尺度滑动窗口。 传统的检测过程是: 1、生成图像金字塔,因为待检测的物体的scale是变化的。 2、用滑动窗口在图片的特征金字塔上面滚动生成很多候选区域。 3、各种特征提取hog和分类器svm来对上面产生的候选区域中的图片信息来分类。 4、NMS非极大值抑制得到最后的结果。 但由于cnn具有强大的提取特征的能力,可以替代第三步,但第一第二步独立于cnn之...

奔跑的小仙女 2万+

yolov3详解

每个边界框的中心点坐标均为相对于其对应的cell左上点坐标的偏移,此时即保证每个边界框的中心点均落在其对应的cell中。其计算公式如下: 上式中: 即为预测的边界框bounding box在feature map中的中心点坐标和长宽; 即为网络学习的相对于先验框(prior,anchor)的offsets; 是各个cell的左上点坐标;即为先验框(prior,anchor)相对于...

yzy的博客 6192

yolov5s.yaml(v6.0) 添加注释】

【代码】【yolov5s.yaml(v6.0) 添加注释】

weixin_50994614的博客 312

链接 - YOLO训练的配置文件参数解释和计算anchor脚本

http://blog.csdn.net/fate_fjh/article/details/70598510 这篇文章的作者详细的解释了YOLOv2的配置文件中各个参数的意义,尤其有帮助的是,其中包含了计算锚点anchor的脚本。 github链接是:https://github.com/Jumabek/darknet_scripts/ 如果链接失效了,也许是作者修改了他的目录结构,可以ht

zhongtai35005的博客 1390

YOLO v3 中关于 anchor 的 k-means 聚类代码

1. k-means 聚类代码 我使用的代码是:https://github.com/lars76/kmeans-anchor-boxes 另一个代码是:https://github.com/qqwweee/keras-yolo3/blob/master/kmeans.py 输入是存放 xml标签文件的文件夹: 只需要更改 example.py 中的一行代码: ANNOTATIONS_PATH =...

轮子去哪儿了 5623

Anchor based and Anchor free(无锚VS有锚)【总结】

anchor-based方法使用不同大小和形状的anchor框来回归和分类目标,例如faster rcnn、retinanet和yolo等。anchor-free,例如fcos、atss和cornernet等。anchor-free方法比anchor-based方法更简单和灵活,但可能存在召回率或定位精度低的问题。

深度学习 3万+

fastrcnn、yolo输出层的比较,以及anchor是啥

一、Fastrcnn里的anchor是啥 https://blog.csdn.net/as472780551/article/details/81227408 所谓anchor,就是特征图上的点预测的大小和长宽比例不同的K个框,这些框以该点对应到原图上的坐标点为中心。在Fastrcnn中,一个点预测9个框(9个anchor),这9个框的大小和比例都是事先设定好的。 二、Fastrcnn...

china026的博客 2250

YOLO V2解析

YOLO V2是YOLO系列的第二版,在YOLO V1的基础上加以改进,改善了YOLO V1定位不准的问题,又保证了检测的速度,可谓集准确性与速度于一身(YOLO V2获得了CVPR2017的最佳论文提名)。YOLO V2的原文提出了两个模型:YOLO V2和YOLO9000,本文主要着重YOLO V2,下面让我们一同走进YOLO V2的世界。 Outlines: YOLO V2 vs V1;...

lanran2的博客 5054

anchor设置 yolo_你一定从未看过如此通俗易懂的YOLO系列(从v1到v5)模型解读 (中)

本文原创,转载请注明出处。上篇文章我们介绍了YOLO v1的设计和演变过程(下面的链接),从本文开始我们继续介绍YOLO series接下来的工作,但是因为YOLO下面的工作内容太多,所以本文只介绍YOLO v2 v3 v4 v5对于检测头head和损失函数loss的优化,剩下的backbone方面的优化留到下一篇文章吧。科技猛兽:你一定从未看过如此通俗易懂的YOLO系列(从v1到v5)模型解读 ...

weixin_32459211的博客 1679

anchor设置 yolo_目标检测中Anchor(先验框)的作用

目标检测网络(Faster RCNN、SSD、YOLO v2&v3等)中,均有先验框的说法,Faster RCNN中称之为anchor(锚点),SSD称之为prior bounding box(先验框),实际上是一个概念。Anchor设置的合理与否,极大的影响着最终模型检测性能的好坏。1. 什么是Anchor?一句话概括——提前在图像上预设好的不同大小,不同长宽比的框,先验框示意如下:同一...

weixin_34693059的博客 7071

YOLO v1~v3学习心得

#YOLO v1 #YOLO v2 #YOLO v3

8000的博客 2785

目标检测中的anchor-base与anchor-free

前言 本文参考目标检测阵营 | Anchor-Base vs Anchor-Free 如何评价zhangshifeng最新的讨论anchor based/ free的论文? - 知乎 基础知识 | 目标检测中Anchor的认识及理解 目标检测领域的发展从anchor-free到anchor-base,现在又有回到anchor-free的趋势,学术界技术的迭代更新也引导着工业界的变革。今天我们就从anchor出发,分析对比基于anchor-base和anchor-free的检测算法及优劣特.

m0_61899108的博客 1万+

yolov3损失函数改进_YOLO V3 深度解析 (下)

1. 前言距离上次YOLO V3深度解析(上) ,隔了很久了,其实自己忙着自己的论文+专利+学习任务,在写文章这块也是有点懈怠了,但是事儿不能做一半就结束了(也有小伙伴催更了),所以接着对YOLO V3进行解析,代码是基于Tensorflow的。上一节讲到了YOLO V3模型的搭建,模型生成了三个特征图feature_map_1, feature_map_2, feature_map_3。接下来我...

weixin_39579127的博客 1974

yolo迭代次数_你一定从未看过如此通俗易懂的YOLO系列(从v1到v5)模型解读 (中)

来自 | 知乎作者 |科技猛兽链接 |https://zhuanlan.zhihu.com/p/183781646编辑 | 深度学习这件小事公众号本文仅作学术交流,如有侵权,请联系后台删除。上篇文章我们介绍了YOLO v1的设计和演变过程(你一定从未看过如此通俗易懂的YOLO系列(从v1到v5)模型解读 (上)),从本文开始我们继续介绍YOLO series接下来的工作,但是因为...

weixin_39876514的博客 3683

(yolo v3)使用自己数据集k-means聚类产生的anchor效果反而变差解决方法

(yolo v3)使用自己数据集k-means聚类产生的anchor效果反而变差解决方法 最近在使用yolo v3训练自己的数据集时,先使用k-means聚类出自己数据集anchors,然后训练自己数据集,最后结果发现预测的效果并不好,预测框得分很低,且容易误检,而使用COCO数据集都感觉效果更好一点,这就让我很怀疑使用k-means聚类产生anchor这个方法是否有效了。 而经过观察发现,原...

恩泽君的博客 1万+

YOLO_v2讲解

YOLO_v2

weixin_43702653的博客 7054
上一篇: Caffe添加Center_Loss layer
下一篇: CTC(Connectionist Temporal Classification)论文笔记
m_buddy
m_buddy 领域专家: 人工智能技术领域 领域专家: 人工智能技术领域
博客等级 码龄11年 2354粉丝 551原创
评论 79
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值