


文章目录
一. 实验目的
掌握Hadoop集群集群安装部署技术。
二. 实验内容
安装Hadoop集群并完成分布式实例。
参考:http://dblab.xmu.edu.cn/blog/install-hadoop-cluster/
三. 实验步骤及结果分析
1. 安装Hadoop集群
说明:将实验二中创建的K1.ubuntukylin14.04(简称K1)系统完全克隆,生成独立的K2.ubuntukylin14.04(简称K2)系统,本实验在这两个系统上完成,其中K1为Master主节点,K2为Slave副节点。
1.1 网络配置
修改主机名。启动K1和K2虚拟机系统,在K2中打开终端,输入sudo vim /etc/hostname命令打开存放主机名的hostname文件,修改主机名为K2,重启后生效。


修改IP映射。分别在K1和K2输入ifconfig命令查看各自的IP地址,分别输入sudo vim /etc/hosts命令打开存放IP和主机名映射关系的hosts文件,删除其中除了127.0.0.1 localhost之外的映射关系,并将K1和K2的IP和主机名映射关系填上,如下所示:


测试连通性。分别在K1和K2输入ping K1 -c 3命令和ping K2 -c 3命令查看是否能够连通,正确的话会显示以下内容:


1.2 SSH无密码登录配置
在K1终端输入cd ~/.ssh命令和rm ./id_rsa*命令删除之前的公匙,输入ssh-keygen -t rsa命令并回车生成新的公匙,输入cat ./id_rsa.pub >> ./authorized_keys命令将公匙加入系统授权,输入scp ~/.ssh/id_rsa.pub mcf14@K2:/home/mcf14/命令将公匙从K1传输到K2上,需要输入yes和K2的密码admin。
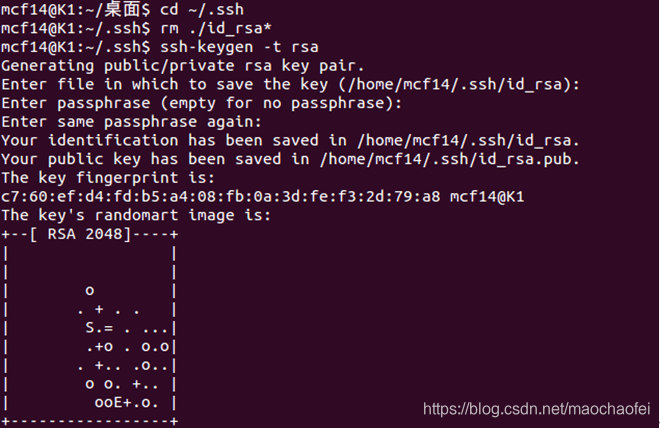
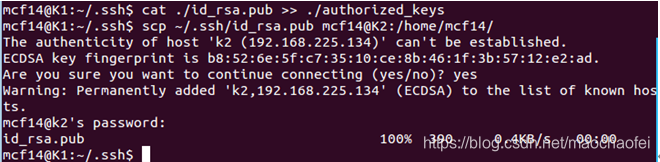
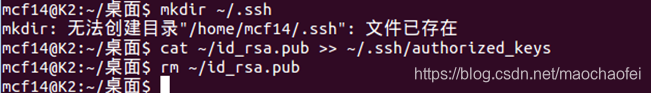
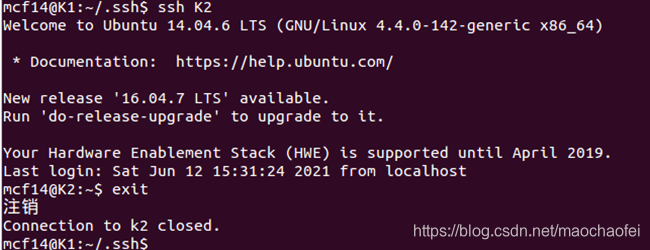
在K2终端输入mkdir ~/.ssh命令创建SSH文件夹(若已创建则忽略),输入cat ~/id_rsa.pub >> ~/.ssh/authorized_keys命令将K1传输过来的公匙加入系统授权,然后输入rm ~/id_rsa.pub命令删除公匙,此时,在K1终端输入ssh K2命令登录K2节点就无须密码验证了,输入exit命令退出。
1.3 集群分布式环境配置
集群/分布式模式必须修改五个配置文件slaves、core-site.xml、hdfs-site.xml、mapred-site.xml和yarn-site.xml,均位于/usr/local/hadoop/etc/hadoop 中。
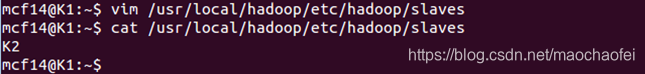
slaves文件内容默认为localhost,每行一个主机名,在伪分布式配置时K1既作为NameNode 也作为 DataNode。集群分布式配置可以保留localhost让K1主节点也作为DataNode;也可以删除localhost让K2副节点作为DataNode、K1主节点作为Namenode。在本次实验中删除localhost添加K2即只让K2作为DataNode。在K1终端输入vim /usr/local/hadoop/etc/hadoop/slaves命令打开slaves文件,删除localhost添加K2保存并退出。
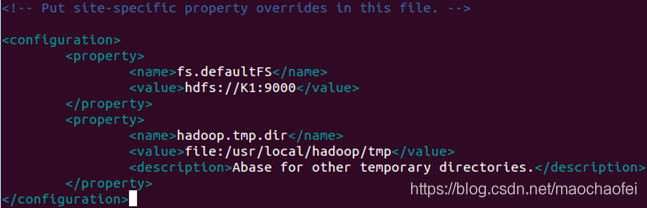
core-site.xml文件。在K1终端输入vim /usr/local/hadoop/etc/hadoop/core-site.xml命令打开core-site.xml文件,将文件末尾改为以下配置内容:
<configuration>
        <property>
                <name>fs.defaultFS</name>
                <value>hdfs://K1:9000</value>
        </property>
        <property>
                <name>hadoop.tmp.dir</name>
                <value>file:/usr/local/hadoop/tmp</value>
                <description>Abase for other temporary directories.</description>
        </property>
</configuration>

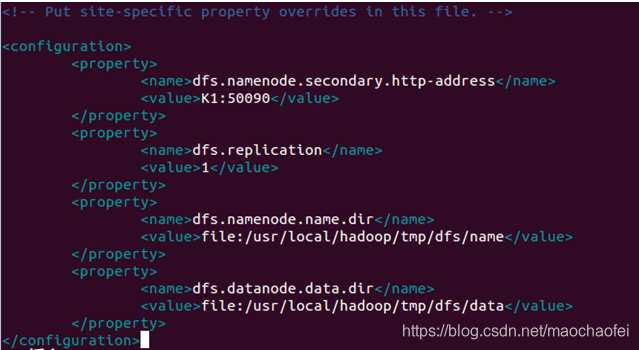
hdfs-site.xml文件。在K1终端输入vim /usr/local/hadoop/etc/hadoop/hdfs-site.xml命令打开hdfs-site.xml文件,将文件末尾改为以下配置内容:
<configuration>
        <property>
                <name>dfs.namenode.secondary.http-address</name>
                <value>K1:50090</value>
        </property>
        <property>
                <name>dfs.replication</name>
                <value>1</value>
        </property>
        <property>
                <name>dfs.namenode.name.dir</name>
                <value>file:/usr/local/hadoop/tmp/dfs/name</value>
        </property>
        <property>
                <name>dfs.datanode.data.dir</name>
                <value>file:/usr/local/hadoop/tmp/dfs/data</value>
        </property>
</configuration>

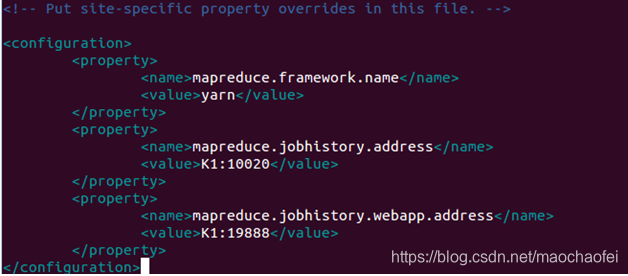
mapred-site.xml文件。输入mv /usr/local/hadoop/etc/hadoop/mapred-site.xml.template /usr/local/hadoop/etc/hadoop/mapred-site.xml命令将默认文件名 mapred-site.xml.template改为mapred-site.xml后,在K1终端输入vim /usr/local/hadoop/etc/hadoop/mapred-site.xml命令打开hdfs-site.xml文件,将文件末尾改为以下配置内容:
<configuration>
        <property>
                <name>mapreduce.framework.name</name>
                <value>yarn</value>
        </property>
        <property>
                <name>mapreduce.jobhistory.address</name>
                <value>K1:10020</value>
        </property>
        <property>
                <name>mapreduce.jobhistory.webapp.address</name>
                <value>K1:19888</value>
        </property>
</configuration>

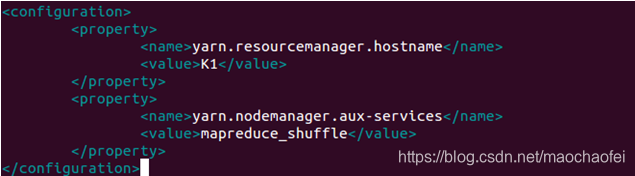
yarn-site.xml文件。在K1终端输入vim /usr/local/hadoop/etc/hadoop/yarn-site.xml命令打开yarn-site.xml文件,将文件末尾改为以下配置内容:
<configuration>
        <property>
                <name>yarn.resourcemanager.hostname</name>
                <value>K1</value>
        </property>
        <property>
                <name>yarn.nodemanager.aux-services</name>
                <value>mapreduce_shuffle</value>
        </property>
</configuration>

1.4 配置文件传输至节点
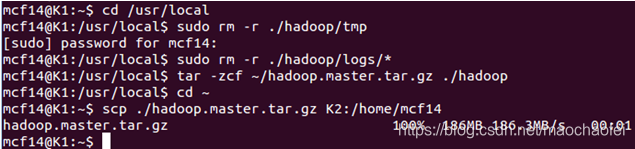
将K1上的/usr/local/hadoop文件夹复制到各个节点上。在K1终端输入cd /usr/local命令和sudo rm -r ./hadoop/tmp命令删除Hadoop临时文件,输入sudo rm -r ./hadoop/logs/*命令删除Hadoop日志文件;输入tar -zcf ~/hadoop.master.tar.gz ./hadoop命令将hadoop文件夹先压缩再复制为hadoop.master.tar.gz压缩包,存放在mcf14用户主目录下;输入cd ~命令和scp ./hadoop.master.tar.gz K2:/home/mcf14命令将其发送到K2副节点上。
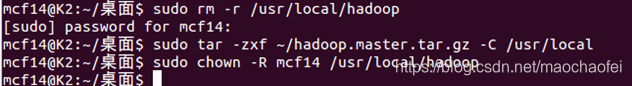
在K2终端输入sudo rm -r /usr/local/hadoop命令删除旧的hadoop文件夹(没有则忽略),输入sudo tar -zxf ~/hadoop.master.tar.gz -C /usr/local命令将从K1传输过来的hadoop.master.tar.gz压缩包解压到/usr/local中,输入sudo chown -R mcf14 /usr/local/hadoop命令将解压后的hadoop文件夹权限为用户mcf14所有。
1.5 启动Hadoop集群
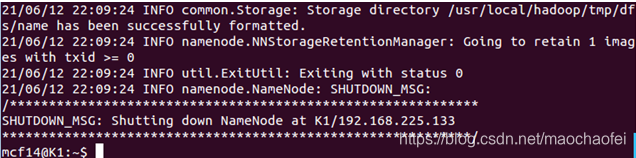
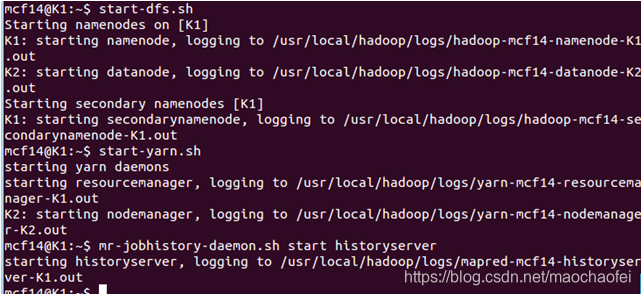
首次启动需要先在K1主节点执行NameNode的格式化。在K1终端输入hdfs namenode -format命令进行格式化(注意!以后尽量不要格式化),如下所示即为正常,然后输入start-dfs.sh、start-yarn.sh、mr-jobhistory-daemon.sh start historyserver三个命令启动Hadoop集群。然后分别在K1和K2上输入jps命令查看进程,如下所示即为成功。


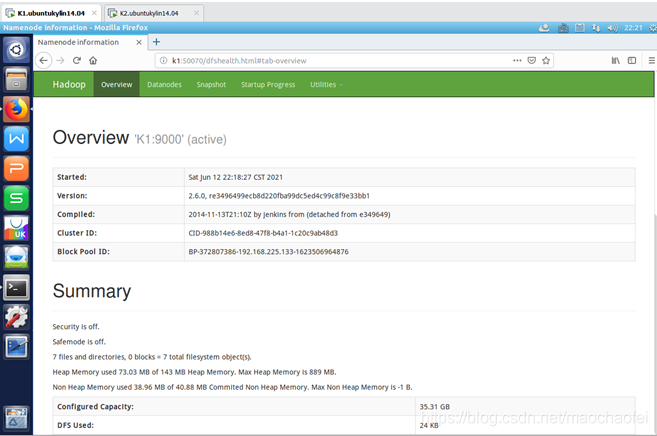
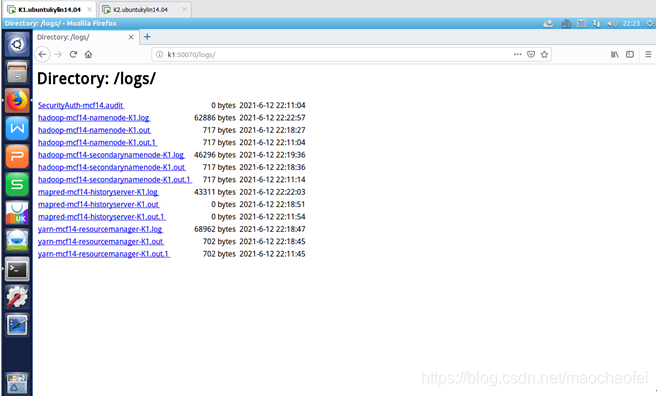
可以通过Web页面查看DataNode和NameNode的状态:http://K1:50070/ 。如果不成功,可以通过启动日志排查原因,一般通过查看日志可以解决很多问题。
2. 完成分布式实例
2.1 在HDFS上创建用户目录
在K1终端启动Hadoop集群后,输入hdfs dfs -mkdir -p /user/mcf14命令在HDFS上创建mcf14用户目录。

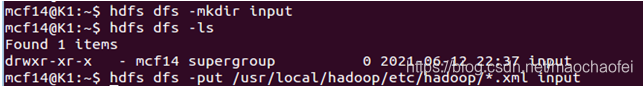
输入hdfs dfs -mkdir input命令在HDFS中创建input输入目录,输入hdfs dfs -put /usr/local/hadoop/etc/hadoop/*.xml input命令将/usr/local/hadoop/etc/hadoop中的配置文件作为输入文件复制到分布式文件系统中。
2.2 运行MapReduce作业分布式实例
输入hadoop jar /usr/local/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-*.jar grep input output 'dfs[a-z.]+'命令就能运行程序,过程中会显示MapReduce Job的进度,实例运行完后输入hdfs dfs -cat output/*命令可以查看输出结果。

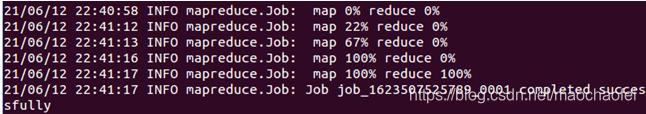
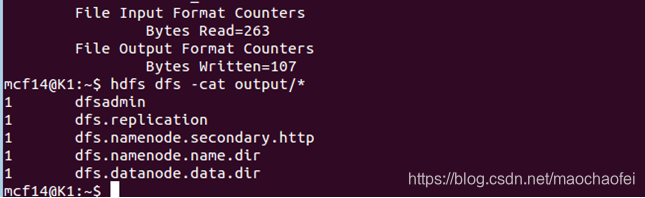
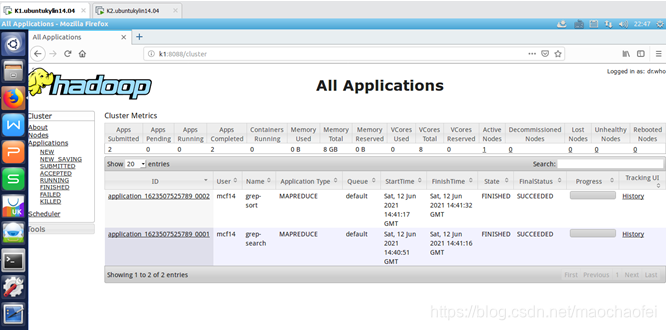
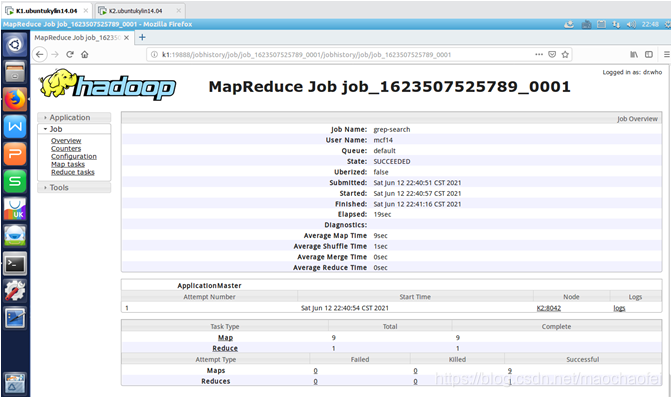
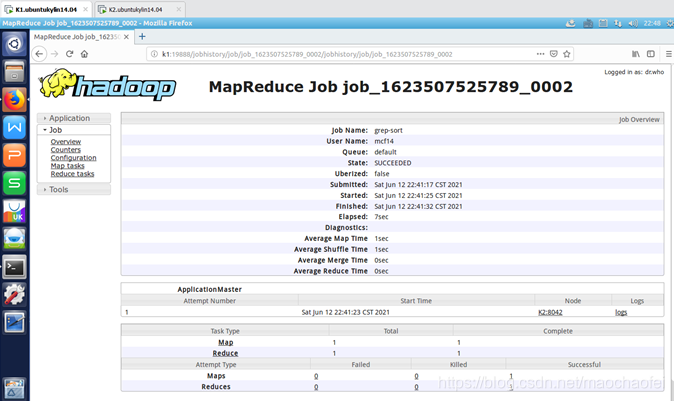
可以通过Web界面查看任务进度:http://K1:8088/cluster ,在Web界面点击“Tracking UI”这一列的History连接,可以看到任务的运行信息。
 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


